

Přepis zprávy z roku 2015 od Ilji Kosmoděmjanského "Ladění Linuxu pro zlepšení výkonu PostgreSQL"
Upozornění: Upozorňuji, že tato zpráva je datována k listopadu 2015 — uplynulo více než 4 roky a mnoho času. Verze 9.4, která je v prezentaci projednávána, již není podporována. Během uplynulých 4 let byly vydány 5 nové verze PostgreSQL a 15 verzí jádra Linuxu. Pokud bychom změnili tato místa, vznikla by z toho nakonec jiná zpráva. Nicméně, zde je probráno základní ladění Linuxu pro PostgreSQL, které je relevantní i nyní.
Jmenuji se Ilja Kosmoděmjanský. Pracuji ve společnosti PostgreSQL-Consulting. A nyní vám řeknu něco o tom, co dělat s Linuxem v souvislosti s databázemi obecně a s PostgreSQL konkrétně, protože principy jsou do určité míry podobné.
O čem se bude mluvit? Pokud komunikujete s PostgreSQL, do určité míry musíte být administrátorem UNIXu. Co to znamená? Pokud porovnáme Oracle a PostgreSQL, v Oracle musíte být z 80 % DBA administrátorem databáze a z 20 % administrátorem Linuxu.
S PostgreSQL je to o něco složitější. Musíte mít mnohem lepší představu o tom, jak Linux funguje. A zároveň trochu běžet za vlakem, protože v poslední době se všechno dost rychle aktualizuje. Nová jádra vycházejí, objevuje se nová funkcionalita, výkon se zlepšuje atd.
Proč mluvíme o Linuxu? Ne proto, že jsme na konferenci Linux Pítr, ale protože v současných podmínkách je jedním z nejlépe odůvodněných operačních systémů pro využití s databázemi obecně a s PostgreSQL konkrétně – Linux. Protože FreeBSD, bohužel, se vyvíjí nějakým velmi zvláštním směrem. A budou problémy jak s výkonem, tak s mnoha dalšími věcmi. Výkon PostgreSQL na Windows – to je vůbec samostatné tvrdé téma, s tím, že Windows nemá takovou sdílenou paměť jako UNIX, a PostgreSQL na tom všem závisí, protože je to víceprocesní systém.
A exotika jako Solaris, myslím, zajímá méně lidí, takže pojďme na to.
Současná distribuce Linuxu má více než 1 000 syctl parametrů, v závislosti na tom, jak je jádro sestaveno. Kromě toho, pokud se podíváme na různé šrouby, může se ještě mnoha způsoby něco přizpůsobit. Existují parametry souborových systémů, jak je montovat. Pokud jde o otázky, jak spustit: co zapnout v BIOSu, jak nastavit hardware atd.
Jedná se o velmi rozsáhlé téma, o kterém by se dalo mluvit několik dní, nikoli pouze v krátké prezentaci, ale nyní se zaměřím na důležité body, jak se vyhnout úskalím, která vám zaručeně znemožní správný chod databáze na Linuxu, pokud je neopravíte. Je také důležité, že mnoho parametrů je ve výchozím nastavení zapnuto s nesprávnými hodnotami pro databázi. Tedy ve výchozím nastavení bude fungovat špatně nebo vůbec.
Jaké tradiční cíle ladění existují v Linuxu? Myslím, že protože se všichni zabýváte administrací Linuxu, není třeba podrobně vysvětlovat, co to cíle znamená.
Lze ladit:
- CPU.
- Paměť.
- Úložiště.
- Jiné. O tom si promluvíme na závěr jako o delikatesě. Například politiku úspory energie může velmi nepředvídatelně a nepříjemně ovlivnit výkon.
Jaké specifika má PostgreSQL a databáze obecně? Problém je v tom, že nelze ladit pouze nějaký jednotlivý aspekt a čekat, že výkon se výrazně zlepší.
Ano, takové aspekty tu jsou, ale databáze je složitá záležitost. Interaguje se všemi zdroji, které má server, a preferuje plné využití. Když se podíváte na současná doporučení společnosti Oracle, jak používat hostitelský operační systém, bude to jako v anekdotě o mongolském kosmonautovi – nakrmit psa a nic jiného neměnit. Poskytneme databázi všechny zdroje a databáze si to sama zařídí.
V zásadě, do určité míry je situace s PostgreSQL stejná. Rozdíl je v tom, že databáze si ne vždy dokáže vzít všechny zdroje sama, takže někde je potřeba na úrovni Linuxu to vše řídit manuálně.
Hlavní myšlenka je nevybírat si nějaký jediný cíl a začít ho ladit, například paměť, CPU nebo něco podobného, ale analyzovat zátěž a pokusit se maximalizovat propustnost, aby zatížení, které nám vytvořili dobří programátoři, včetně našich uživatelů, mohlo databází procházet co nejefektivněji.
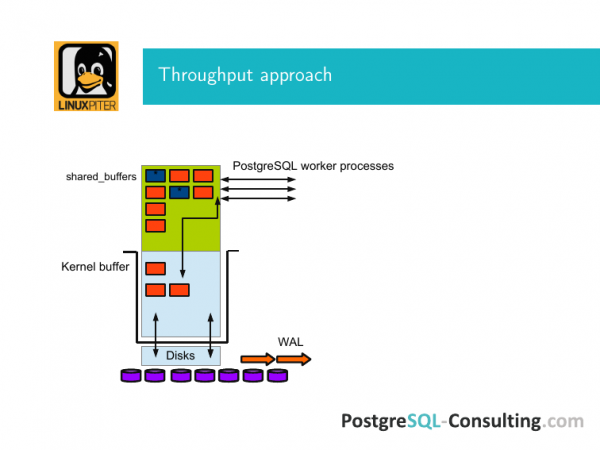
Toto je obrázek pro vysvětlení toho, co to je. Existuje buffer OS Linux, sdílená paměť a sdílené buffery PostgreSQL. PostgreSQL na rozdíl od Oracle pracuje přímo pouze přes buffer jádra, t. j. aby se stránka z disku dostala do jeho sdílené paměti, musí projít přes kernel buffer a zpět je to stejná situace.
Pod tímto systémem žijí disky. Nakreslil jsem to jako disky. Ve skutečnosti tam může být RAID kontrolér atd.
A tento vstup-výstup se tak či onak děje přes tuto záležitost.
PostgreSQL je klasická databáze. Uvnitř jsou stránky. A celý vstup-výstup se děje pomocí stránek. Stránkami zvedáme bloky do paměti. A pokud se nic nestane, jednoduše jsme je přečetli, postupně se z této cache, ze sdílených bufferů utopí a dostanou zpět na disk.
Pokud jsme někde něco nahradili, celá stránka se označí jako špinavá. Označil jsem je zde modrou barvou. To znamená, že tato stránka musí být synchronizována s blokovým úložištěm. T. j. když jsme ji udělali špinavou, udělali jsme zápis do WAL. A v nějakém krásném okamžiku se objevila záležitost zvaná checkpoint. A do tohoto logu se zapsala informace o tom, že přišel. A to znamená, že všechny špinavé stránky, které zde byly v ten okamžik v těchto sdílených bufferech, se synchronizovaly s diskem úložiště pomocí fsync přes kernel buffer.
Proč se to dělá? Pokud nám vypadne napájení, nedostaneme se do situace, že všechna data zmizela. Persistující paměť, o které nám všichni vyprávěli, je zatím v teorii databází – to je jasná budoucnost, ke které se samozřejmě snažíme a která se nám líbí, ale zatím žije ještě v mínus 20 letech. A samozřejmě, na toto všechno je třeba dávat pozor.
A úlohou maximalizace propustnosti je optimalizovat na všech těchto etapách, aby to všechno rychle jezdilo tam a zpět. Sdílená paměť je převážně stránkový cache. V PostgreSQL jsme poslali dotaz select něco, on tyto data získal z disku. Dostali se do sdílených bufferů. Odpovídajícím způsobem, aby to fungovalo lépe, musí být hodně paměti.
Aby to všechno fungovalo dobře a rychle, musíte správně nastavit operační systém ve všech fázích. Musíte také vybrat vyvážený hardware, protože pokud bude někde nerovnováha, můžete mít spoustu paměti, ale její služba nebude dostatečně rychlá.
Projdeme si každý z těchto bodů.
Aby se tyto stránky rychle přenášely tam a zpět, je potřeba dosáhnout následujícího:
- Za prvé, musíte efektivněji pracovat s pamětí.
- Za druhé, musí být efektivnější tento přechod, když se stránky z paměti dostávají na disk.
- A za třetí, měly by být dobré disky.
Pokud máte 512 GB operační paměti v serveru a všechno to nakonec přijde na SATA pevný disk bez jakéhokoli cache, celý databázový server se promění v něco víc než dýni, ale v dýni se SATA rozhraním. S tím se budete muset přímo potýkat. A nic vás nezachrání.
Pokud jde o první bod s pamětí, existují tři věci, které mohou život značně zkomplikovat.
První z nich je NUMA. NUMA je věc navržená pro zlepšení výkonu. V závislosti na zátěži lze optimalizovat různé věci. A ve svém novém současném stavu není příliš dobrá pro aplikace, jako jsou databáze, které intenzivně používají sdílené bufry cache.
Jednoduše řečeno. Jak poznat, že s NUMA je něco v nepořádku? Máte nějaký nepříjemný šum, náhle zjistíte, že je nějaký CPU přetížený. Přitom analyzujete dotazy v PostgreSQL a vidíte, že tam nic takového není. Tyto dotazy by neměly tak intenzivně zatěžovat CPU. Může to být obtížné odhalit. Snazší je od začátku využít správné doporučení, jak nastavit NUMA pro PostgreSQL.
Co se ve skutečnosti děje? NUMA je Non-Uniform Memory Access. O co jde? Máte CPU, vedle něj je jeho místní paměť. A tato paměť může propojovat paměť z jiných CPU.
Pokud spustíte numactl --hardware, dostanete takový velký výpis. Mezi jiným tam bude pole distances. Budou tam čísla – 10-20, něco takového. Tato čísla jsou ničím jiným než počtem skoků, aby se tato vzdálená paměť mohla připojit a používat lokálně. V zásadě je to dobrý nápad. To významně zrychluje výkon při určitých zátěžích.
Představte si, že máte jeden CPU, který se nejprve snaží používat svou lokální paměť, a pak se pokouší přetáhnout další paměť přes interconnect pro něco jiného. A do této CPU se dostává celý váš page cache PostgreSQL – několik gigabajtů. Vždy se dostáváte do nejhorší situace, protože na CPU je přímo v tomto modulu paměti obvykle málo. A veškerá paměť, která je obsluhována, prochází těmito interconnecty. To je pomalé a smutné. A máte procesor, který obsluhuje tento uzel, trvale přetížený. A čas přístupu k této paměti je špatný, pomalý. Tohle je situace, které se chcete vyhnout, pokud používáte toto pro databázi.
Proto je pro databáze správnější, aby operační systém Linux vůbec nevěděl, co se tam děje. Aby se k paměti choval tak, jak se má.
Proč je to tak? Na první pohled by se to mělo zdát naopak. Důvod je prostý: potřebujeme hodně paměti pro page cache – desítky, stovky gigabajtů.
A pokud jsme to všechno alokovali a naše data si tam cacheujeme, zisk z použití cache bude podstatně větší než zisk z takového chytrého přístupu k paměti. Tímto způsobem získáme nesrovnatelně více v porovnání s tím, že bychom efektivněji přistupovali do paměti pomocí NUMA.
Dosud existují dva přístupy, dokud nenastane jasná budoucnost, kdy databáze nebude umět sama rozpoznat, na jakých CPU pracuje a odkud něco potřebuje přetáhnout.
Proto je správný přístup úplně vypnout NUMA, například při restartování. Ve většině případů jsou zisky takové, že se vůbec neobjevuje otázka, jak je to lepší.
Existuje jiná možnost. Tu používáme častěji než tu první, protože když k nám v podpore přijde klient, restart serveru je pro něj velká záležitost. Je tam jeho podnikání. A problémy kvůli NUMA zažívají. Proto se snažíme ji vypnout méně invazivními způsoby než restartováním, ale tady opatrně zkontrolujte, že byla skutečně vypnuta. Protože, jak ukazuje zkušenost, když NUMA vypínáme u rodičovského procesu PostgreSQL, je to dobré, ale zdaleka to nemusí fungovat. Musíte kontrolovat a sledovat, že se skutečně vypnula.
Existuje dobrý post od Roberta Haase. Je to jeden z komitérů PostgreSQL, jeden z klíčových vývojářů všech nízkoúrovňových komponent. A pokud se podíváte na odkazy z tohoto příspěvku, popisuje několik poutavých příběhů o tom, jak lidem NUMA komplikovala život. Podívejte se, prostudujte kontrolní seznam pro administrátory, co je třeba nastavit na serveru, aby naše databáze fungovala dobře. Tyto nastavení je třeba zaznamenat a kontrolovat, protože jinak to nebude příliš dobře.
Rád bych upozornil, že se to týká všech nastavení, o kterých budu hovořit. Obvykle se databáze sestavují v režimu master-slave pro zajištění dostupnosti. Nezapomeňte provést tato nastavení na slave, protože v jeden krásný okamžik může dojít k havárii a přepnete na slave, který se stane mistrem.
V havarijní situaci, kdy je všechno velmi špatné, vám neustále zvoní telefon a šéf běží s velkým kladivem, nebudete mít čas přemýšlet o kontrole. A výsledky mohou být velmi katastrofální.
Další věc – to jsou obrovské stránky. Obrovské stránky se komplikují odděleně testovat, a ani to nedává smysl, ačkoliv existují benchmarky, které to dokážou. Ty se snadno najdou.
O co jde? Máte server, který není příliš drahý, ale má hodně operační paměti, například více než 30 GB. Obrovské stránky se nepoužívají. To znamená, že určitě máte overhead při využívání paměti. A tento overhead není zrovna příjemný.
Proč to tak je? A co se děje? Operační systém přiděluje paměť po malých kouscích. Je to pohodlné, tak to historicky vzniklo. A pokud se ponoříte do podrobností, tak OS musí převádět virtuální adresy na fyzické. A tento proces není zrovna jednoduchý, proto hasil OS výsledek této operace ukládá do vyrovnávací paměti Translation Lookaside Buffer (TLB).
A protože TLB je vyrovnávací paměť, v takové situaci vznikají všechny problémy, které vyrovnávací paměť má. Za prvé, pokud máte velmi hodně operační paměti a ta je celá přidělená po malých kouscích, tak se tento buffer stává velmi velkým. A pokud je vyrovnávací paměť velká, tak se v ní hledá pomaleji. Overhead je značný a sám zabírá místo, tj. operační paměť spotřebovává něco nesprávného. To je první problém.
Dvě – čím více se v této situaci rozrůstá cache, tím větší je pravděpodobnost, že dojde k cache miss. A efektivita této cache rychle klesá s nárůstem její velikosti. Proto v operačních systémech vymysleli jednoduchý přístup. V Linuxu se již dlouho používá. Ve FreeBSD se nedávno objevil. Ale mluvíme o Linuxu. To jsou huge pages.
A tady je třeba poznamenat, že myšlenka huge pages byla původně prosazena komunitami, které zahrnovaly Oracle a IBM, tedy výrobci databází důkladně přemýšleli o tom, že to bude užitečné, včetně databází.
A jak to sladit s PostgreSQL? Za prvé, v jádru Linuxu musí být zapnuty huge pages.
Za druhé, musejí být výslovně uvedeny parametrem sysctl – kolik jich je. Čísla jsou z nějakého starého serveru. Můžete spočítat, kolik přibližně máte shared buffers, aby se do huge pages vešly.
A pokud máte celý server věnovaný PostgreSQL, dobrý výchozí bod je buď 25 % operační paměti věnovat na shared buffery, nebo 75 %, pokud si jste jisti, že ve skutečně 75 % se vaše databáze jistě vejde. První výchozí bod. A spočítejte, pokud máte 256 GB operační paměti, odpovídajících 64 GB bude vašich shared bufferů. Spočítejte přibližně s nějakou rezervou – na co byste tuto číslici měli nastavit.
Do verze 9.2 (pokud se nemýlím, od verze 8.2) bylo možné pomocí externí knihovny sladit PostgreSQL s huge pages. A to je vždy potřeba udělat. Za prvé, potřebujete, aby jádro umělo správně alokovat huge pages. A za druhé, aby aplikace, která s nimi pracuje, mohla využít jejich potenciál. Jen tak je nevyužije. Protože PostgreSQL alokoval paměť ve stylu system 5, to bylo možné provést pomocí libhugetlbfs – to je celé jméno knihovny.
Ve verzi 9.3 byla zlepšena výkonnost PostgreSQL při práci s pamětí a byl opuštěn systém 5 pro alokaci paměti. Všichni byli velmi rádi, protože jinak se snažíte spustit dva instance PostgreSQL na jednom stroji, a on říká, že mu chybí sdílená paměť. A říká, že je třeba upravit sysctl. A ten sysctl je takový, že je potřeba ještě restartovat atd. Celkově bylo hodně radosti. Ale alokace paměti mmap rozbila použití huge pages. Většina našich klientů používá velké sdílené buffery. A my důrazně doporučujeme, abyste nepřecházeli na 9.3, protože tam overhead začínal dosahovat značných procent.
Ale komunita si této problémy všimla a ve verzi 9.4 to velmi dobře přepracovali. A ve verzi 9.4 se objevila možnost v postgresql.conf, kde můžete nastavit try, on nebo off.
Try je nejbezpečnější nastavení. Při startu PostgreSQL, když alokuje sdílenou paměť, snaží se získat tuto paměť z huge pages. A pokud se to nepodaří, vrátí se k běžné alokaci. A pokud máte FreeBSD nebo Solaris, můžete nastavit try, to je vždy bezpečné.
Pokud je nastaveno on, tak se prostě nespustí, pokud se mu nepodaří alokovat z huge pages. Tady už jde o to, co je pro vás milé. Ale pokud máte nastaveno try, měli byste zkontrolovat, zda se vám opravdu alokovalo to, co potřebujete, protože prostor pro chyby je zde značný. Tento funkčnost nyní funguje pouze na Linuxu.
Ještě jednota malá poznámka, než půjdeme dál. Transparent huge pages zatím nejsou o PostgreSQL. Nemůže je využít normálně. A při použití Transparent huge pages pro takové workloady, kdy potřebujete velký kus sdílené paměti, se výhody dostavují pouze při opravdu velkých objemech. Pokud máte terabyty paměti, může to hrát roli. Pokud mluvíme o více běžných aplikacích, kdy máte 32, 64, 128, 256 GB paměti na stroji, tak běžné huge pages jsou v pořádku, a transparentní prostě vypínáme.
A poslední věc, která se týká paměti, není přímo spojena s propustností, ale může velmi ztížit život. Celá propustnost bude silně ovlivněna tím, že server neustále swapuje.
A to bude velmi nepříjemné v několika ohledech. Hlavní nepříjemnost spočívá v tom, že v moderních jádrech se chování mírně liší od starších jader Linuxu. A na to se velmi těžko došlápne, protože když mluvíme o nějaké práci se swapem, končí to pozdním příchodem OOM-killera. A OOM-killer, který přišel pozdě a zabil PostgreSQL, je opravdu nepříjemné. O tom se dozví všichni, tj. až po posledního uživatele.
Co se děje? Máte tam velké množství paměti, vše funguje dobře. Ale z nějakého důvodu server visí ve swapu a kvůli tomu zpomaluje. Zdálo by se, že paměti je dostatek, ale takto se to děje.
Dříve jsme doporučovali nastavit vm.swappiness na nulu, tj. vypnout swap. Dříve se zdálo, že 32 GB operační paměti a odpovídající sdílené buffery – to je obrovské množství. Hlavním účelem swapu je poskytovat místo, kam se dá dát jádro, když selže. A to už moc nefungovalo. A co pak s tím jádrem udělat? To už je úkol, u kterého není jasné, proč je swap tak velký potřebný.
Ale v modernějších, tj. ve třetích verzích jader, se chování změnilo. A pokud nastavíte swap na nulu, tj. vypnete ho, dříve či později, i při ponechané určité operační paměti, k vám přijde OOM-killer, aby zabil nejintenzivnější spotřebitele. Protože bude považovat, že při této zátěži nám ještě trošku zbývá a vyskočí, tj. nezabil systémový proces, ale zabil něco méně důležitého. Tím méně důležitým se ukáže být intenzivní spotřebitel sdílené paměti, konkrétně postmaster. A po tom bude dobře, pokud nebude nutné obnovovat databázi.
Proto nyní defaultně, pokud si pamatuji, většina distribucí je někde okolo 6, tj. v jakém okamžiku začít používat swap v závislosti na tom, kolik paměti zbývá. Nyní doporučujeme nastavit vm.swappiness = 1, protože to prakticky vypíná, ale nedává takové efekty, jako když OOM-killer přijde nečekaně a vše zabil.
Co dál? Když mluvíme o výkonu databází a postupně se dostáváme k diskům, všichni se chytají za hlavu. Protože pravda o tom, že disk je pomalý a paměť rychlá, je všem známá od dětství. A všichni vědí, že v databázi budou problémy s diskovým výkonem.
Hlavní problém s výkonem PostgreSQL, spojený s výkyvy při kontrolních bodech, nevzniká kvůli tomu, že je disk pomalý. Je to spíše proto, že propustnost paměti a disku není vyvážená. Ta může být nevyvážená na různých místech. PostgreSQL není nakonfigurováno, operační systém není nakonfigurován, hardware není nakonfigurován a hardware je nesprávný. K této problému nedochází jen tehdy, když je všechno nastavené správně, tj. buď není zátěž, nebo jsou nastavení a hardware dobře přizpůsobené.
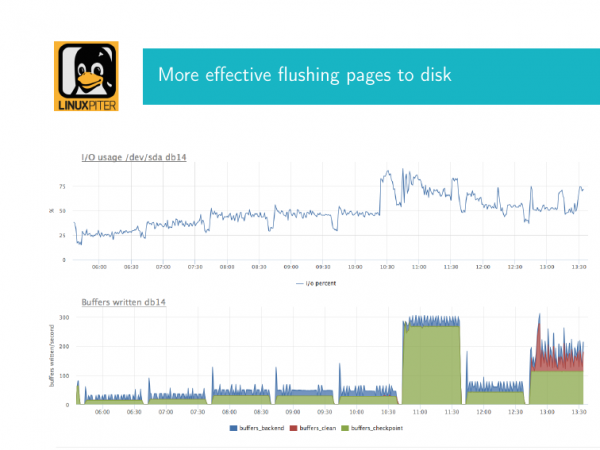
Co to je a jak to vypadá? Obvykle lidé, kteří pracují s PostgreSQL, se do této záležitosti dostali opakovaně. Vysvětlím. Jak jsem říkal, PostgreSQL pravidelně provádí kontrolní body, aby uložil špinavé stránky ze sdílené paměti na disk. Pokud máme velký objem sdílené paměti, kontrolní bod začne intenzivně ovlivňovat disk, protože zapisuje tyto stránky pomocí fsync. Dosažené data putují do jádra bufferu a zapisují se na disky za pomoci fsync. A pokud je objem tohoto procesu velký, můžeme pozorovat nepříjemný efekt, a to velmi vysokou využitelnost disků.
Tady mám dvě obrázky. Teď vysvětlím, co to je. To jsou dva grafy korelované podle času. První graf – to je využitelnost disku. V tuto chvíli dosahuje téměř 90 %. Pokud máte databázovou zátěž s fyzickými disky, s RAID řadičem, a využitelnost je pod 90 %, to jsou špatné zprávy. To znamená, že ještě kousek a dosáhnete 100 a vstup-výstup se zastaví.
Pokud máte diskový arraj, je to trochu jiný příběh. Závisí to na tom, jak je nastaven, jaký to je arraj atd.
Současně je zde nakonfigurován graf z interní postgresové pohledu, který ukazuje, jak probíhá checkpoint. A zelenou barvou je zde indikováno, kolik bufferů, těchto špinavých stránek, v tuto chvíli dorazilo v tomto checkpointu k synchronizaci. A to je hlavní, co zde potřebujete vědět. Vidíme, že zde máme spoustu stránek, a v nějakém okamžiku jsme narazili na limit, tedy jsme psali-psali, zde je zřejmé, že diskový systém je velmi silně zatížen. A náš checkpoint má velmi silný dopad na disk. Ideálně by situace měla vypadat spíše takto, tedy zde by bylo méně zápisu. A pomocí nastavení to můžeme opravit, abychom to tak měli i nadále. Tedy, zatížení je malé, ale někde něco zde zapisujeme.
Co je potřeba udělat, abyste tento problém vyřešili? Pokud se vám zastavilo IO pod databází, znamená to, že všichni uživatelé, kteří přišli vykonávat své dotazy, budou čekat.
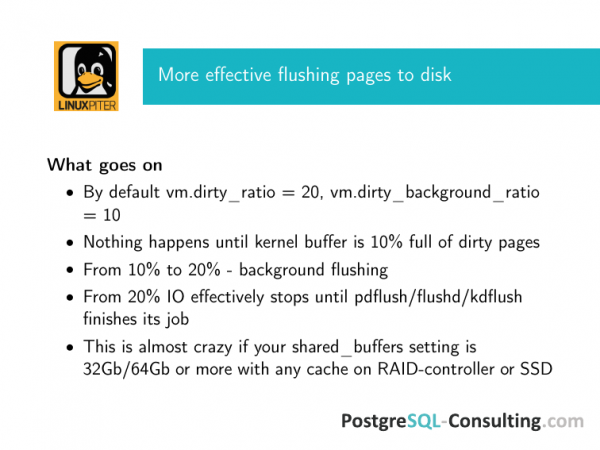
Pokud se podíváte z pohledu Linuxu, pokud máte dobrý hardware, správně ho nastavíte a normálně nastavíte PostgreSQL, aby tyto checkointy dělalo méně často, rozprostřelo je v čase mezi sebou, narazíte na výchozí parametry Debianu. Pro většinu distribucí Linuxu platí následující obrázek: vm.dirty_ratio=20, vm.dirty_background_ratio=10.
Co to znamená? Od jádra 2.6 se objevil jeden demon pro vymazání. Pgflush, v závislosti na tom, kdo co používá, který se zabývá backgroundním vymazáváním špinavých stránek z jádra bufferu a vymazáváním, kdykoliv je to nutné, dokud backgroundní vymazávání nepomáhá.
Kdy nastává background? Když 10 % z celé operační paměti, která je na serveru, je obsazeno špinavými stránkami v kernel bufferu, je zavolána speciální funkce pro vymazání na pozadí. Proč je to backgroundní? Přijímá jako parametr, kolik stránek vymazat. A například vymazává N stránek. A na nějakou dobu tato věc usne. A pak se znovu vrátí a vymazává nějaký další počet stránek.
To je nesmírně jednoduchý příběh. Je to jako s bazénem, když do jedné trubky teče voda, do druhé zase odtéká. Náš checkpoint přišel a pokud poslal málo špinavých stránek na vymazání, tak se postupně z kernel bufferu pgflush vše tohle jemně rozplyne.
Pokud se tyto špinavé stránky nadále hromadí, dosahují až 20 %, poté je prioritou operačního systému je zapsat na disk, protože dojde k výpadku napájení a vše dopadne špatně. Ztratíme tato data, například.
Jaký je trik? Trik spočívá v tom, že tyto parametry, které představují 20 a 10 % z celé operační paměti v zařízení, jsou z hlediska propustnosti jakéhokoli diskového systému naprosto monstrózní.
Představte si, že máte 128 GB operační paměti. 12,8 GB se dostane do vašeho diskového systému. A bez ohledu na to, jaký máte tam cache nebo pole, to nevydrží.
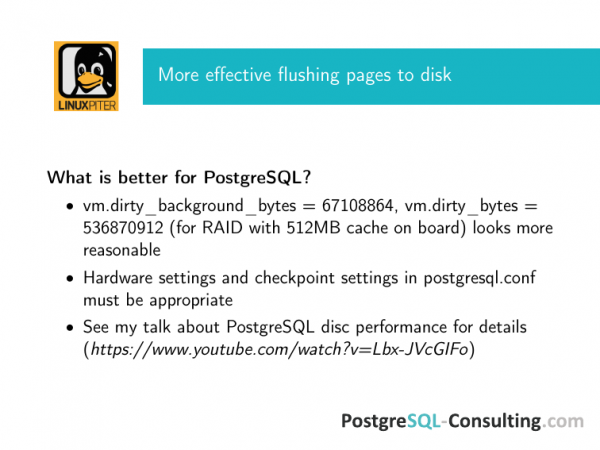
Proto doporučujeme tyto čísla hned nastavit podle schopností vašeho RAID řadiče. Mám zde ihned doporučení pro řadič, který má 512 MB cache.
Všechno se počítá velmi jednoduše. Můžete nastavit vm.dirty_background v bajtech. A tato nastavení ruší předchozí dvě. Ať už poměr podle defaultu, nebo aktivované ty s bajty, tedy budou fungovat ty s bajty. Ale jelikož jsem DBA konzultant a pracuji s různými klienty, snažím se pokrýt všechny možnosti, a proto, pokud v bajtech, tak v bajtech. Nikdo nezaručil, že hodný admin nepřidá paměť serveru, nepřevede ho zpět, a číslo zůstane stejné. Jednoduše počítejte ta čísla tak, aby se všechno vlezlo s jistotou.
Co se stane, pokud se nevejdete? Je uvedeno, že efektivně se zastavuje jakékoli flushování, ale ve skutečnosti je to obrazný výraz. Operační systém má velký problém – má hodně špinavých stránek, takže efektivně se zastavuje ten IO, který generují vaši klienti, tj. aplikace, která posílá SQL dotaz do databáze, čeká. Jakýkoli vstup-výstup do ní je v nejnižší prioritě, protože databáze je zaneprázdněna checkpointem. A kdy to dokončí, není jasné. A když dosáhnete ne-fondu, ne-pozadí flushingu, znamená to, že veškeré IO je tímto zaneprázdněno. A dokud to neskončí, nic neuděláte.
Je tu ještě dva důležité momenty, které přesahují tento referát. Tato nastavení musí odpovídat nastavením v postgresql.conf, tj. nastavení checkpointů. A váš diskový systém musí být adekvátně nastaven. Pokud máte cache na RAID, měla by na něm být baterie. Lidé kupují RAID s dobrým cache bez baterie. Pokud máte SSD v RAID, musí to být serverové, měly by tam být kondenzátory. Tady je podrobný checklist. Na tomto odkazu je moje zpráva o nastavení výkonu disku v PostgreSQL. Tam jsou všechny tyto checklisty.
Co ještě může velmi zkomplikovat život? To jsou dva parametry. Jsou relativně nové. Mohou být ve výchozím nastavení zapnuty v různých aplikacích. A mohou zkomplikovat život nejen v případě, že budou nesprávně zapnuty.
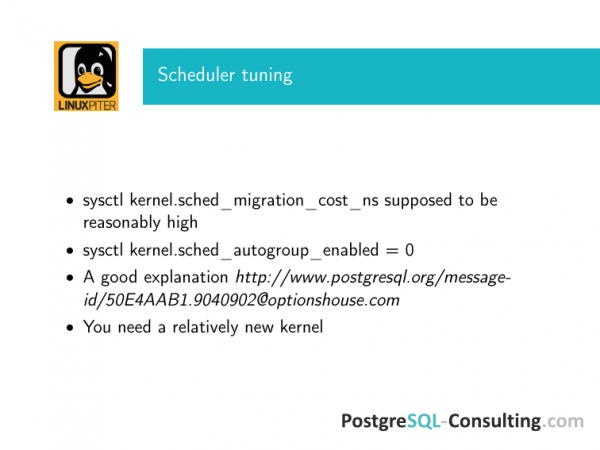
Existují dvě relativně nové věci. Objevily se již ve třetích jádrech. To je sched_migration_cost v nanosekundách a sched_autogroup_enabled, která je ve výchozím nastavení zapnuta.
A jak zhoršují život? Co je sched_migration_cost? Linuxový plánovač může migrovat proces z jednoho CPU na druhý. A pro PostgreSQL, které vykonává dotazy, je migrace na jiný CPU zcela nepochopitelná. Z pohledu operačního systému, když přepínáte okna mezi openoffice a terminálem, to může být užitečné, ale pro databázi – to je velmi špatné. Proto je rozumná politika nastavit migration_cost na nějakou vysokou hodnotu, alespoň několik tisíc nanosekund.
Co to bude znamenat pro plánovač? Bude se domnívat, že po tuto dobu je tento proces stále aktivní. Tedy pokud má nějakou dlouhou transakci, která něco dlouho dělá, plánovač to pochopí. Bude se domnívat, že dokud neuplyne tento časový limit, nemá důvod tento proces migrovat. Pokud tento proces něco dělá, nebude migrován, klidně dokončí svou práci na tom CPU, které mu bylo přiděleno. A výsledek je skvělý.
Druhá věc – to je autogroup. Je to dobrý nápad pro specifické pracovní zátěže, které nemají nic společného se moderními databázemi – skupinovat procesy podle virtuálního terminálu, ze kterého byly spuštěny. To je užitečné pro určité úkoly. Ve skutečnosti je PostgreSQL mnohoprocessní systém s preforkem, který se spouští z jednoho terminálu. Máte zamknutého zapisovače, checkpoint a všechny vaše klientské požadavky se shromáždí na jednom plánovači, na jednom CPU. A budou tam trpělivě čekat, až se uvolní, aby si navzájem překáželi a zabírali ho co nejdéle. To je příběh, který je naprosto zbytečný při takovém zatížení, a proto to je třeba vypnout.
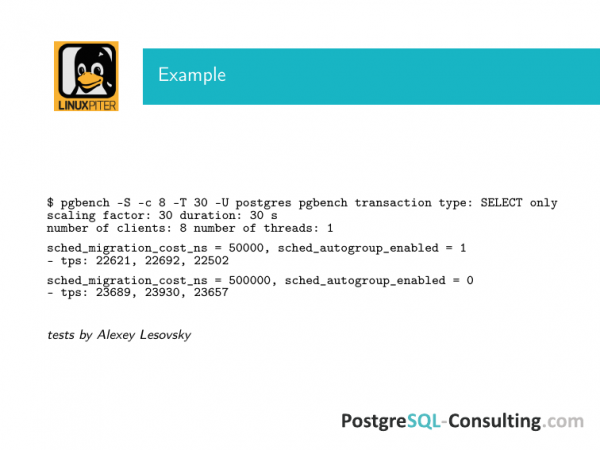
Můj kolega Alexej Lesovskij prováděl testy se základním pgbench, kde zvýšil o řád migration_cost a vypnul autogroup. Rozdíl na špatném hardwaru činil téměř 10 %. Existuje diskuse v poštovní skupině PostgreSQL, kde lidé uvádějí výsledky, jak podobné změny ovlivnily rychlost požadavku o 50 %. Takových příběhů je docela hodně.
A nakonec o politice úspory energie. Je dobré, že nyní lze Linux používat na notebooku. A údajně by měl dobře spotřebovávat baterii. Ale náhle se ukazuje, že na serveru to také může být.
Navíc, pokud si pronajímáte servery od nějakého poskytovatele, ti "hodní" hostitelé se nestarají o to, abyste měli lepší výkon. Jejich úkolem je zajistit, aby jejich hardware byl maximálně efektivně využíván. Proto mohou mít ve výchozím nastavení na operačním systému zapnutý režim úspory energie pro notebooky.
Pokud na serveru s databází pod intenzivní zátěží používáte toto vybavení, vaší volbou je acpi_cpufreq + performance. I s ondemandem už budou problémy.
Intel_pstate je už trochu jiný ovladač. A v současnosti se dává přednost tomuto, protože je novější a lépe funguje.
A podle toho je guvernér jen performance. Ondemand, powersave a všechno ostatní – to není pro vás.
Výsledky z explain analyze PostgreSQL se mohou lišit o několik řádů, pokud zapnete powersave, protože prakticky váš CPU bude plánován zcela nepředvídatelným způsobem pod databází.
Tyto věci mohou být zapnuty ve výchozím nastavení. Pozorně se podívejte – nezapnuli je náhodou ve výchozím nastavení. To může být opravdu velký problém.
A nakonec bych chtěl poděkovat klukům z našeho DBA týmu PosgreSQL-Consulting, konkrétně Maxovi Bohukovi a Alexejovi Lesovskému, kteří se každý den učí z různých situací. Pro naše klienty se snažíme udělat všechno co nejlépe, aby to pořádně fungovalo. Je to jako s instrukcemi pro leteckou bezpečnost. Všechno je psáno krví. Každá z těchto matiček byla objevena během nějakého problému. S radostí se s vámi o ně podělím.
Otázky:
Děkuji! Pokud například chce firma ušetřit a umístit databázi a aplikační logiku na jeden server, nebo pokud firma následuje moderní trend mikroservisních architektur, kde PostgreSQL běží v kontejneru. Jaký je v tom háček? Sysctl ovlivňuje všechna jádra globálně. Neslyšel jsem, že by sysctl nějak virtualizovali, aby fungovaly v různých kontejnerech. Existují pouze cgroup, a tam je kontrola jen na část. Jak s tím můžete žít? Nebo pokud chcete výkon, spusťte PostgreSQL na samostatném fyzickém serveru a optimalizujte ho?
Na vaši otázku jsme odpověděli přibližně třemi způsoby. Pokud se nejedná o fyzický server, který můžete optimalizovat atd., buďte klidní, bez těchto nastavení to bude fungovat dobře. Pokud máte takovou zátěž, že je třeba dělat tato nastavení, fyzický server potřebujete dříve, než se dostanete k těmto nastavením.
V čem je problém? Pokud je to virtuální stroj, pravděpodobně budete mít spoustu problémů, například s tím, že na většině virtuálních strojů je latence disku dost nekonzistentní. I když je propustnost disků dobrá, jedna selhávající transakce operace vstupu-výstupu, která nemá velký vliv na průměrnou propustnost, a která nastala v okamžiku checkpointu nebo při zápisu do WAL, způsobí, že databáze utrpí. To si všimnete dříve, než narazíte na tyto problémy.
Pokud bude NGINX na stejném serveru, bude to mít stejný problém. Bude se prát o sdílenou paměť. Až se dostanete k problémům, které jsou zde popsány.
Na druhou stranu, některé z těchto parametrů pro vás budou stále relevantní. Například, s nastavením sysctl dirty_ratio, aby nebylo až tak šílené – v každém případě to pomůže. Tak či onak, dojde k interakci s diskem. A ta bude fungovat podle nesprávného schématu. To jsou ve skutečnosti výchozí parametry, které jsem ukazoval. A v každém případě je lepší je změnit.
S NUMA mohou být problémy. Například VmWare dobře funguje s NUMA s úplně opačnými nastaveními. A tady je třeba si vybrat – fyzický server nebo nefyzičký.
Mám otázku ohledně Amazon AWS. Mají přednastavené image. Jedním z nich se nazývá Amazon RDS. Mají tam nějaké vlastní nastavení pro jejich operační systém?
Jsou tam nastavení, ale to jsou jiná nastavení. Tady nastavujeme operační systém z pohledu toho, jak databáze tohle použije. A tam jsou parametry, které určují, kam teď jít, jaký shaping. Tedy potřebujeme tolik zdrojů, které teď potřebujeme čerpat. Po tom Amazon RDS tyto zdroje připojuje, a tam výkon klesá. Existují samostatné příběhy, jak lidé s tím začnou experimentovat. Někdy i docela úspěšně. Ale to nemá nic společného s nastavením OS. To je vlastně hacking cloudu. To je jiný příběh.
Proč Transparent huge pages nedávají efekt v porovnání s Huge TLB?
Nedávají. To lze vysvětlit mnoha způsoby. Ale fakticky prostě nedávají. Jaká je historie PostgreSQL? Při spuštění vyčleňuje velký kus sdílené paměti. Transparentní nebo ne transparentní – naprosto nezáleží. Skutečnost, že se vyčleňují při spuštění, to všechno vysvětluje. A pokud je paměti velmi mnoho a je nutné přeorganizovat segment shared_memory, pak bude Transparent huge pages relevantní. U PostgreSQL je to prostě na začátku vyčleněno obrovským kusem a nic zvláštního se dál neděje. Samozřejmě jej lze použít, ale existuje riziko poškození shared_memory, kdy se pokusí přeallocovat něco. PostgreSQL o tom přece neví.
Zdroj: habr.com
