

Ahoj, lidi! Jmenuji se Oleg Anastasyev, pracuji na Odnoklassnikách v týmu Platformy. Kromě mě pracuje na Odnoklassnikách spousta techniky. Máme čtyři datová centra, v nichž je asi 500 racků s více než 8000 servery. V určitém okamžiku jsme si uvědomili, že zavedení nového systému řízení nám umožní efektivněji využít techniku, usnadnit správu přístupů, automatizovat (pře)rozdělování výpočetních zdrojů, zrychlit spuštění nových služeb a zrychlit reakce na masivní havárie.
Co z toho vzniklo?
Kromě mě a spousty techniky jsou tu ještě lidé, kteří s touto technikou pracují: inženýři, kteří jsou přímo v datových centrech; síťaři, kteří nastavují síťovou infrastrukturu; administrátoři, tedy SRE, kteří zajišťují odolnost infrastruktury; a týmy vývojářů, z nichž každá odpovídá za část funkcí portálu. Software, který vytvářejí, funguje takto:
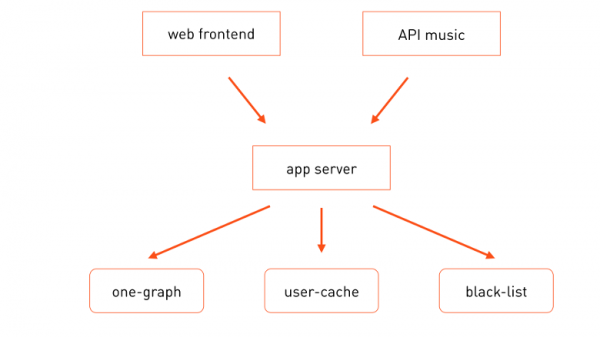
Žádosti uživatelů přicházejí jak na fronty hlavního portálu , tak i na další, například na fronty API hudby. Pro zpracování obchodní logiky vyvolávají server aplikací, který při zpracování žádosti volá potřebné specializované mikroservisy - one-graph (graf sociálních vazeb), user-cache (cache uživatelských profilů) atd.
Každá z těchto služeb je nasazena na mnoha strojích a každá z nich má zodpovědné vývojáře, kteří odpovídají za správu modulů, jejich provoz a technologický rozvoj. Všechny tyto služby se spouštějí na fyzických serverech a až do nedávna jsme spouštěli přesně jednu úlohu na jeden server, tj. byl specializován pro konkrétní úkol.
Proč tomu tak bylo? Tento přístup měl několik výhod:
- Usnadňuje masivní správu. Předpokládejme, že úloha vyžaduje nějaké knihovny, nějaká nastavení. A pak je server přiřazen pouze jedné konkrétní skupině, popisuje se politika cfengine pro tuto skupinu (nebo už je popsána) a tato konfigurace je centrálně a automaticky nasazena na všechny servery této skupiny.
- Zjednodušuje diagnostiku. Představte si, že sledujete zvýšenou zátěž procesoru a uvědomujete si, že tuto zátěž mohla vygenerovat pouze ta úloha, která běží na tomto fyzickém procesoru. Hledání viníka končí velmi rychle.
- Zjednodušuje monitoring. Pokud je se serverem něco v nepořádku, monitor o tom informuje a vy přesně víte, kdo je za to odpovědný.
Služba složená z více replik získává několik serverů — po jednom na každou. Výpočetní zdroje pro službu jsou tedy přiřazeny velmi jednoduše: kolik serverů služba má, tolik maximálních zdrojů může spotřebovat. "Jednoduše" tady neznamená, že je to snadné použít, ale že rozdělení zdrojů probíhá ručně.
Takový přístup nám také umožnil provádět specializované hardwarové konfigurace pod úlohu, která běží na tomto serveru. Pokud úloha uchovává velká množství dat, použijeme 4U server s šasi pro 38 disků. Pokud je úloha čistě výpočetní, můžeme zakoupit levnější 1U server. To je efektivní z pohledu výpočetních zdrojů. Tento přístup nám také umožňuje používat čtyřikrát méně strojů při zátěži srovnatelné s jednou přátelskou sociální sítí.
Taková efektivita využití výpočetních zdrojů by měla zajistit i ekonomickou efektivitu, pokud vycházíme z předpokladu, že nejdražší jsou servery. Dlouho to bylo právě hardwarová zařízení, která stála nejvíce, a věnovali jsme mnoho úsilí s cílem snížit náklady na hardware vymýšlením algoritmů pro zajištění odolnosti proti poruchám za účelem snížení požadavků na spolehlivost zařízení. Dnes jsme se dostali do fáze, kdy cena serveru již přestala být určující. Pokud nebereme v úvahu čerstvou exotiku, konkrétní konfigurace serverů v racku nemá zásadní význam. Nyní máme jiný problém — cena místa, které server zabírá v datovém centru, tedy místa v racku.
Když jsme si uvědomili, že je to tak, rozhodli jsme se spočítat, jak efektivně využíváme racky.
Vzali jsme cenu nejsilnějšího serveru z ekonomicky výhodných a spočítali, kolik takových serverů se vejde do racků, kolik úloh bychom na něm spustili na základě starého modelu „jeden server = jedna úloha“ a jak by takové úlohy mohly využívat hardware. Spočítali jsme to – a rozplakali se. Ukázalo se, že efektivita využití racků je u nás kolem 11 %. Závěr je jasný: je potřeba zvyšovat efektivitu využití datových center. Řešení se zdá být evidentní: na jednom serveru spustit více úloh. Ale zde nastávají komplikace.
Hromadná konfigurace se drasticky komplikuje — nyní není možné přiřadit serveru nějakou jednu skupinu. Na jednom serveru mohou být spuštěny různé úlohy různých týmů. Dále může být konfigurace konfliktující pro různé aplikace. Diagnostika je také složitější: pokud vidíte zvýšenou spotřebu procesorů nebo disků na serveru, nevíte, která z úloh způsobuje problémy.
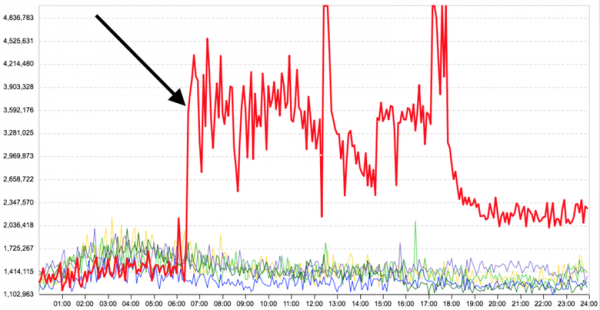
Ale hlavní je, že mezi úlohami spuštěnými na jednom stroji není izolace. Například graf průměrné doby odezvy serverové úlohy před a po spuštění dalšího, zcela nesouvisejícího výpočtového programu na stejném serveru – doba odezvy hlavní úlohy se výrazně zvýšila.
Je zřejmé, že úlohy by měly být spouštěny buď v kontejnerech, nebo ve virtuálních strojích. Protože téměř všechny úlohy běží pod jedním operačním systémem (Linux) nebo jsou mu přizpůsobeny, nepotřebujeme podporovat řadu různých operačních systémů. Vzhledem k tomu nebude virtualizace potřebná, protože kvůli dodatečným nákladům bude méně efektivní než kontejnerizace.
Docker je dobrým kandidátem pro implementaci kontejnerů pro spouštění úloh přímo na serverech. Obrazy souborových systémů dobře řeší problémy s konfliktujícími konfiguracemi. To, že obrazy mohou být složeny z několika vrstev, nám umožňuje značně snížit objem dat potřebný pro jejich nasazení na infrastrukturě, když společné části oddělíme do samostatných základních vrstev. Základní (a nejobjemnější) vrstvy se pak dostatečně rychle ukládají do cache v celé infrastruktuře a pro dodání mnoha různých typů aplikací a verzí bude potřeba přenášet pouze malé objemové vrstvy.
Navíc, hotový registr a tagování obrazů v Dockeru nám poskytují připravené primitivy pro verzování a dodávání kódu do produkce.
Docker, jako každá jiná podobná technologie, nám z boxu poskytuje určitý stupeň izolace kontejnerů. Například izolace podle paměti — každému kontejneru je přidělen limit na používání paměti stroje, nad kterým nezpotřebuje více. Také je možné izolovat kontejnery podle použití CPU. Pro nás však standardní izolace byla nedostatečná. Ale o tom dále.
Přímé spouštění kontejnerů na serverech je jen část problémů. Další část se týká umístění kontejnerů na serverech. Je třeba pochopit, který kontejner může být umístěn na který server. To není tak jednoduchý úkol, protože kontejnery je třeba umístit na servery co nejhustěji, aniž by se snížila rychlost jejich práce. Takové umístění může být složité i z hlediska odolnosti proti výpadkům. Často chceme umisťovat repliky stejné služby do různých skříní nebo dokonce do různých sálů datového centra, abychom při výpadku skříně nebo sálu neztratili okamžitě všechny repliky služby.
Ruční rozdělování kontejnerů není možnost, když máš 8 tisíc serverů a 8—16 tisíc kontejnerů.
Kromě toho jsme chtěli dát vývojářům větší samostatnost v rozdělování zdrojů, aby mohli sami umisťovat své služby do produkce, bez pomoci administrátora. Přitom jsme chtěli zachovat kontrolu, aby nějaká vedlejší služba nezpotřebovala všechny zdroje našich datových center.
Je zřejmé, že potřebujeme řídicí vrstvu, která by se tímto automaticky zabývala.
Tak jsme se dostali k jednoduchému a srozumitelnému obrázku, který mají všichni architekti rádi: tři čtverce.
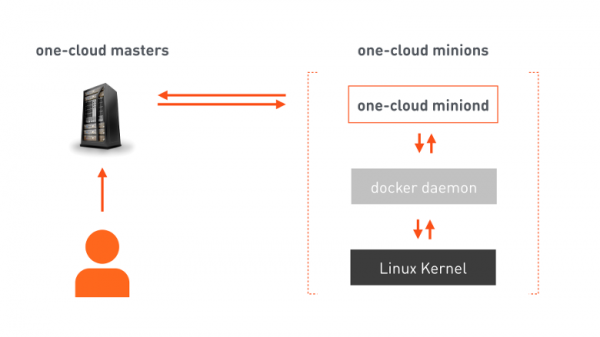
one-cloud masters — vysoce dostupný cluster odpovědný za orchestraci cloudu. Developer posílá do masteru manifest, který obsahuje všechny potřebné informace pro nasazení služby. Master na jeho základě dává příkazy vybraným minionům (strojům určeným k spuštění kontejnerů). Na minionech je náš agent, který přijímá příkaz, vydává už své příkazy Dockeru a Docker konfiguruje linuxový kernel pro spuštění odpovídajícího kontejneru. Kromě vykonávání příkazů agent neustále informuje mastera o změnách stavu jak stroje-miniona, tak spuštěných na ní kontejnerů.
Rozdělení zdrojů
A nyní se podíváme na úkol složitějšího rozdělení zdrojů pro více minionů.
Výpočetní zdroj v one-cloud — to je:
- Výpočetní výkon procesoru spotřebovaný konkrétním úkolem.
- Objem paměti dostupný úkolu.
- Síťový provoz. Každý z minionů má konkrétní síťové rozhraní s omezenou šířkou pásma, takže nelze distribuovat úkoly bez zohlednění objemu dat přenášených po síti.
- Disky. Kromě, očividně, místa pro data úkolu, také vyčleňujeme typ disku: HDD nebo SSD. Disky mohou obsluhovat konečný počet požadavků za sekundu — IOPS. Proto pro úkoly, které generují více IOPS, než může jeden disk obsloužit, také vyčleňujeme „spindly“ — tedy disková zařízení, která je třeba výhradně rezervovat pro úkol.
Tak pro nějakou službu, například user-cache, můžeme zapsat spotřebovávané zdroje tímto způsobem: 400 procesorových jader, 2,5 Tč paměti, 50 Gb/s provozu oběma směry, 6 Tč místa na HDD umístěného na 100 spindlech. Nebo v nám známější formě takto:
alloc:
    cpu: 400
    mem: 2500
    lan_in: 50g
    lan_out: 50g
    hdd:100x6T
Zdroje služby user-cache spotřebovávají pouze část všech dostupných zdrojů v produkční infrastruktuře. Proto chceme zajistit, aby náhle, kvůli chybě operátora nebo ne, user-cache nespotřeboval více zdrojů, než mu bylo přiděleno. To znamená, že musíme limitovat zdroje. Ale na co bychom mohli navázat kvótu?
Pojďme se vrátit k naší značně zjednodušené schémě interakce komponent a překreslit ji s větším množstvím detailů — takto:
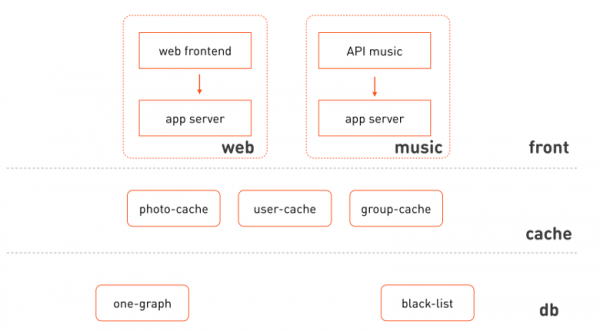
Co okamžitě zasáhne:
- Webový frontend a hudba používají izolované klastrové instance stejného aplikačního serveru.
- Lze vyčlenit logické vrstvy, do kterých tyto clustery patří: fronty, kešování, úložiště a správa dat.
- Frontend není homogenní, skládá se z různých funkčních subsystémů.
- Kešování lze také rozptýlit podle subsystému, jehož data kešují.
Znovu překreslíme obrázek:
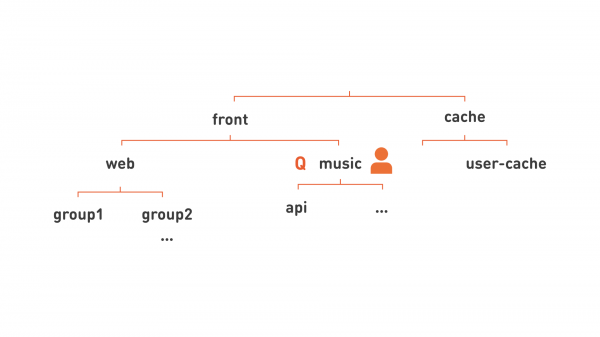
Aha! Vidíme hierarchii! To znamená, že můžeme rozdělit zdroje ve větších celcích: přiřadit odpovědného vývojáře ke uzlu této hierarchie, odpovídajícího funkčnímu subsystému (jako je "music" na obrázku), a k této úrovni hierarchie také přiřadit kvótu. Taková hierarchie nám také umožňuje flexibilněji organizovat služby pro usnadnění správy. Například všechny webové služby, jelikož se jedná o velmi velkou skupinu serverů, rozdělujeme na několik menších skupin, které jsou na obrázku zobrazeny jako group1, group2.
Odstraněním zbytečných čar můžeme zapsat každý uzel našeho obrázku v plochější podobě: group1.web.front, api.music.front, user-cache.cache.
Tak se dostáváme k pojmu "hierarchická fronta". Má své jméno, například "group1.web.front". Na tuto frontu se přiřazuje kvóta na zdroje a práva uživatelů. Člověku z DevOps udělíme práva na odesílání služby do fronty, a takový zaměstnanec může spouštět něco ve frontě, zatímco člověku z OpsDev udělíme administrátorská práva, takže nyní může frontu spravovat, přiřazovat do ní lidi, udělovat těmto lidem práva atd. Služby spouštěné v této frontě budou vykonávány v rámci kvóty fronty. Pokud výpočetní kvóty fronty nestačí pro současné provedení všech služeb, budou se vykonávat sekvenčně, a tím se vytvoří skutečná fronta.
Podívejme se na služby podrobněji. Služba má plné jméno, které vždy zahrnuje jméno fronty. Tak služba webového frontu bude mít název ok-web.group1.web.front. A služba aplikačního serveru, na kterou se obrací, bude mít název ok-app.group1.web.front. Každá služba má manifest, ve kterém jsou uvedeny všechny potřebné informace pro nasazení na konkrétních strojích: kolik zdrojů tato úloha potřebuje, jaká konfigurace je pro ni potřebná, kolik replik by mělo být, vlastnosti pro zpracování selhání této služby. A po nasazení služby přímo na strojích se objevují její instance. Ty jsou také jednoznačně pojmenovány — jako číslo instance a název služby: 1.ok-web.group1.web.front, 2.ok-web.group1.web.front, …
To je velmi pohodlné: podívejte se pouze na název spuštěného kontejneru, ihned z něj můžeme zjistit mnoho informací.
A nyní se blíže seznamme s tím, co vlastně tyto instance dělají: s úlohami.
Třídy izolace úloh
Všechny úlohy v OK (a pravděpodobně i jinde) lze rozdělit do skupin:
- Úlohy s krátkým zpožděním — prod. Pro takové úlohy a služby je velmi důležité zpoždění odpovědi (latency), jak rychle bude každý z požadavků zpracován systémem. Příklady úloh: webové fronty, cache, aplikační servery, OLTP úložiště atd.
- Úlohy výpočetní — batch. Zde není důležitá rychlost zpracování každého konkrétního požadavku. Důležité je, kolik celkových výpočtů za určené (velké) časové období tato úloha provede (throughput). Takové budou jakékoli úlohy MapReduce, Hadoop, strojové učení, statistika.
- Úlohy na pozadí — idle. Pro takové úlohy nejsou důležitá ani latency, ani throughput. Sem patří různé testy, migrace, přepočty, konverze dat z jednoho formátu do druhého. Z jedné strany se podobají výpočetním, z druhé strany nám není příliš jedno, jak rychle dokončí.
Podívejme se, jak takové úlohy spotřebovávají zdroje, například centrální procesor.
Úlohy s krátkým zpožděním. Tato úloha bude mít vzor spotřeby CPU podobný tomuto:
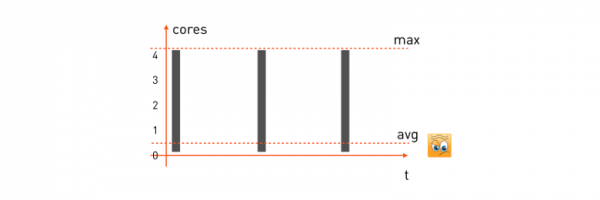
Na zpracování přijde požadavek od uživatele, úloha začne používat všechny dostupné jádra CPU, zpracovává, vrací odpověď, čeká na další požadavek a je v klidu. Další požadavek přišel — opět zabralo vše, co bylo, vypočítalo, čekáme na další.
Abychom zajistili minimální zpoždění pro takovou úlohu, musíme vzít maximum spotřebovávaných zdrojů a rezervovat potřebný počet jader na minionu (stroji, který bude úlohu vykonávat). Pak bude vzorec rezervace pro naši úlohu vypadat takto:
alloc: cpu = 4 (max)A pokud máme minion s 16 jádry, můžeme na něm umístit přesně čtyři takové úlohy. Je třeba zdůraznit, že průměrná spotřeba procesoru u těchto úloh je často velmi nízká — což je očividné, protože většinu času je úloha v očekávání požadavku a nic nedělá.
Výpočtové úlohy. Jejich vzor bude poněkud odlišný:
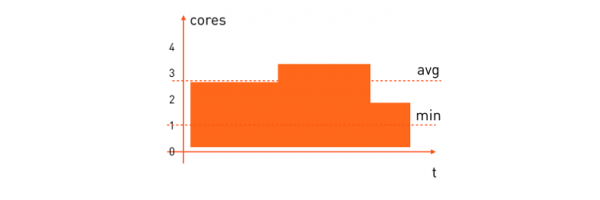
Průměrná spotřeba procesorových zdrojů u těchto úloh je dost vysoká. Často chceme, aby výpočtová úloha byla dokončena za určitou dobu, proto je potřeba rezervovat minimální počet procesorů, které potřebuje, aby celý výpočet skončil v přijatelném čase. Její rezervační vzorec bude vypadat takto:
alloc: cpu = [1,*)„Umísti prosím na minion, kde je alespoň jedno volné jádro, a pak ať se spotřebuje, kolik je potřeba.“
Zde je efektivita využití již výrazně lepší než u úloh s krátkým zpožděním. Ale zisk bude mnohem větší, pokud zkombinujeme oba typy úloh na jednom minionu a budeme dynamicky rozdělovat její zdroje. Když úloha s krátkým zpožděním potřebuje procesor — dostane ho okamžitě, a když zdroje nebudou potřebné — předávají se výpočtové úloze, tedy nějak takto:
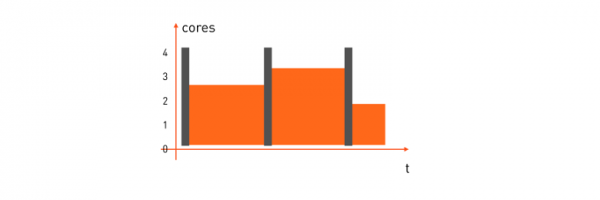
Ale jak to udělat?
Nejdříve se zaměříme na prod a jeho alloc: cpu = 4. Musíme rezervovat čtyři jádra. V Docker run lze toho dosáhnout dvěma způsoby:
- Pomocí volby
--cpuset=1-4, tedy vyčlenit úloze čtyři konkrétní jádra na stroji. - Použít
--cpuquota=400_000 --cpuperiod=100_000, přidělit kvótu na procesorový čas, tedy uvést, že každých 100 ms skutečného času úloha spotřebovává maximálně 400 ms procesorového času. Získáváme stejná čtyři jádra.
Ale který z těchto způsobů bude vhodný?
Poměrně atraktivně vypadá cpuset. Úloha má čtyři vyhrazená jádra, což znamená, že procesorové cache budou fungovat maximálně efektivně. To má však i svou nevýhodu: museli bychom se postarat o distribuci výpočtů na nezatížená jádra stroje místo operačního systému, což je poměrně netriviální úkol, zvlášť když se pokusíme umístit na tento stroj batch-úlohy. Testy ukázaly, že tady lépe funguje varianta s kvótou: tak má operační systém více svobody při výběru jádra pro vykonání úlohy v aktuálním okamžiku a procesorový čas se rozděluje efektivněji.
Pojďme si objasnit, jak v Dockeru zajistit rezervaci na minimální počet jader. Kvóta pro batch-úlohy už není použitelná, protože omezovat maximum není potřeba, stačí pouze zajistit minimum. A tady dobře zapadá možnost docker run --cpushares.
Dohodli jsme se, že pokud batch vyžaduje zaručení min na jednom jádře, tak uvedeme --cpushares=1024, a pokud minimum na dvou jádrech, tak uvedeme --cpushares=2048. Cpu shares nijak nezasahují do rozdělení procesorového času, dokud ho je dostatek. Takže pokud prod v daném okamžiku nevyužívá všechna čtyři jádra – nic neomezuje batch-úlohy, a ty mohou využít další procesorový čas. Naopak v situaci nedostatku procesoru, pokud prod spotřeboval všechna čtyři jádra a narazil na kvótu – zbývající procesorový čas bude rozdělen proporcionálně podle cpushares, t.j. v situaci tří volných jader jedno dostane úloha se 1024 cpushares a zbývající dvě úlohy se 2048 cpushares.
Ale použití kvóty a shares není dostatečné. Musíme zajistit, aby úloha s krátkou latencí měla prioritu před batch-úlohou při rozdělování procesorového času. Bez takové prioritizace by batch-úloha zabrala veškerý procesorový čas ve chvíli, kdy ho potřebuje prod. V Docker run nejsou žádné možnosti prioritizace kontejnerů, ale pomoci přicházejí politiky plánovače centrálního procesoru v Linuxu. O nich si můžete podrobněji přečíst , a v rámci tohoto článku si je projdeme stručně:
- SCHED_OTHER
Standardně dostávají všechny běžné uživatelské procesy na Linuxovém stroji. - SCHED_BATCH
Určeno pro náročné procesy. Při umístění úlohy do procesoru se zavádí tzv. trest za aktivaci: taková úloha s menší pravděpodobností získá procesorové zdroje, pokud je právě v tu chvíli procesorem obsazena úloha se SCHED_OTHER. - SCHED_IDLE
Pozadí proces s velmi nízkou prioritou, dokonce nižší než nice –19. Používáme naši knihovnu s otevřeným zdrojovým kódem. , aby byla stanovena nezbytná politika při spuštění kontejneru voláním
one.nio.os.Proc.sched_setscheduler( pid, Proc.SCHED_IDLE )Ale i pokud neprogramujete v Javě, to samé lze udělat pomocí příkazu chrt:
chrt -i 0 $pidShrneme všechny naše úrovně izolace do jedné tabulky pro přehlednost:
Třída izolace
Příklad alloc
Možnosti Docker run
sched_setscheduler chrt*
Prod
cpu = 4
--cpuquota=400000 --cpuperiod=100000
SCHED_OTHER
Batch
Cpu = [1, * )
--cpushares=1024
SCHED_BATCH
Idle
Cpu= [2, *)
--cpushares=2048
SCHED_IDLE
*Pokud provádíte chrt uvnitř kontejneru, může být potřeba capability sys_nice, protože standardně Docker tuto capability při spuštění kontejneru odebere.
Ale úlohy spotřebovávají nejen procesor, ale také provoz, který má ještě větší vliv na zpoždění síťové úlohy než nesprávné rozdělení procesorových zdrojů. Proto samozřejmě chceme získat identický obraz i pro provoz. Tedy, když prod-úloha posílá nějaké pakety do sítě, kvotujeme maximální rychlost (vzorec alloc: lan=[*,500mbps) ), s jakou prod může toto dělat. A pro batch garantujeme pouze minimální propustnost, ale neomezením maximální (vzorec alloc: lan=[10Mbps,*) ) V tomto případě by měl provoz prod mít prioritu před batch-úlohami.
Zde Docker nemá žádné primitiva, která bychom mohli použít. Ale pomoci nám přichází . Dokázali jsme dosáhnout požadovaného výsledku díky disciplíně . S jejíž pomocí vyčleňujeme dvě třídy provozu: vysoce prioritní prod a nízko prioritní batch/idle. Nakonec konfigurace pro odchozí provoz vypadá takto:
zde 1:0 — „kořenový qdisc“ disciplíny hsfc; 1:1 — podřízená třída hsfc se sdíleným limitem šířky pásma 8 Gbit/s, pod který spadají podřízené třídy všech kontejnerů; 1:2 — podřízená třída hsfc společná pro všechny batch a idle úkoly s „dynamickým“ limitem, o kterém se níže zmiňujeme. Další podřízené třídy hsfc jsou vyhrazené třídy pro aktuálně běžící prod kontejnery s limity odpovídajícími jejich manifestům — 450 a 400 Mbit/s. Každé třídě hsfc je přiřazena qdisc fronta fq nebo fq_codel, v závislosti na verzi jádra Linuxu, aby se předešlo ztrátám paketů při spikách v provozu.
Obvykle disciplíny tc slouží pouze k prioritizaci odchozího provozu. Ale chceme prioritizovat i příchozí provoz — nějaký batch úkol by mohl snadno zabrat celou příchozí linku, například získáním velkého balíku vstupních dat pro map&reduce. K tomu používáme modul , který vytváří virtuální rozhraní ifbX pro každé síťové rozhraní a přesměrovává příchozí provoz z rozhraní do odchozího na ifbX. Pro ifbX pak fungují všechny stejné disciplíny pro kontrolu odchozího provozu, pro které bude konfigurace hsfc velmi podobná:
Během experimentů jsme zjistili, že nejlepší výsledky hsfc ukazuje, když je třída 1:2 nepřednostního batch/idle provozu omezena na strojích-minionech na maximálně určitou volnou šířku pásma. Jinak nepřednostní provoz příliš silně ovlivňuje zpoždění prod úkolů. Aktuální velikost volné šířky pásma určuje miniond každou sekundu měřením průměrné spotřeby provozu všemi prod úkoly daného miniona  a odečítáním ji od šířky pásma síťového rozhraní
 s malou rezervou, t. j.

Šířky pásma jsou určovány pro příchozí a odchozí provoz nezávisle. A podle nových hodnot miniond znovu konfiguruje limit nepřednostní třídy 1:2.
Tímto způsobem jsme implementovali všechny tři třídy izolace: prod, batch a idle. Tyto třídy mají silný vliv na charakteristiky vykonávání úkolů. Proto jsme se rozhodli umístit tento znak na vrchol hierarchie, abychom při pohledu na název hierarchické fronty okamžitě pochopili, s čím máme co do činění:
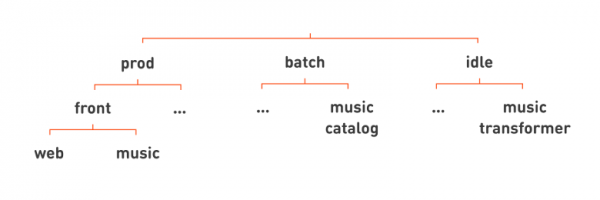
Všichni naši známí web a music fronty jsou pak umístěny v hierarchii pod prod. Například pod batch umístíme službu music catalog, který pravidelně sestavuje katalog skladeb ze souborů mp3 nahraných do „Odnoklassniki“. Příkladem služby pod idle může být hudební transformátor, normalizující úroveň hlasitosti hudby.
Opět odstraněním nadbytečných řádků můžeme zapsat názvy našich služeb více ploše, přidáním třídy izolace úkolu na konec úplného názvu služby: web.front.prod, catalog.music.batch, transformer.music.idle.
A nyní, když se podíváme na název služby, chápeme nejen to, jakou funkci plní, ale i její třídu izolace, což znamená její kritičnost atd.
Všechno je skvělé, ale je tu jedna hořká pravda. Úplně izolovat úkoly běžící na jednom stroji není možné.
Co se nám podařilo dosáhnout: pokud batch intenzivně spotřebovává pouze prostředky procesoru, vestavěný plánovač CPU Linux se svou úlohou velmi dobře vyrovnává a vliv na prod-úkol prakticky není. Ale pokud tento batch-úkol začne aktivně pracovat s pamětí, vzájemný vliv už se projeví. Děje se to proto, že z prod-úkolu „vymizely“ procesorové cache paměti — nakonec se v cache zvyšují prohřešky a procesor zpracovává prod-úkol pomaleji. Takový batch-úkol může zvýšit latenci našeho typického prod-kontejneru o 10 %.
Izolovat provoz je ještě složitější, protože moderní síťové karty mají interní frontu paketů. Pokud se paket z batch-úkolu dostal dovnitř jako první, bude také předán přes kabel jako první, a s tím se nedá nic dělat.
Navíc se nám zatím podařilo vyřešit pouze problém prioritizace TCP-provozu: pro UDP přístup s hsfc nefunguje. A i v případě TCP-provozu, pokud batch-úkol generuje mnoho provozu, to také zvyšuje latenci prod-úkolu o přibližně 10 %.
Odolnost proti výpadkům
Jedním z cílů při vývoji one-cloud bylo zlepšení odolnosti Odnoklassniki. Proto bych se chtěl podrobněji podívat na možné scénáře selhání a havárie. Začněme jednoduchým scénářem — selháním kontejneru.
Kontejner může selhat několika způsoby. Může to být experiment, chyba nebo problém v manifestu, kvůli kterému produkční úloha začne spotřebovávat více zdrojů, než je uvedeno v manifestu. Měli jsme případ, kdy vývojář implementoval složitý algoritmus, několikrát ho přetvářel, až se sám zamotal, což vedlo k tomu, že úloha se začala nečekaně cyklit. A protože produkční úloha má vyšší prioritu než všechny ostatní na stejných minionech, začala spotřebovávat všechny dostupné procesorové zdroje. V této situaci nám pomohla izolace, přesněji řečeno kvóta na procesorový čas. Pokud je úloze přidělena kvóta, nespotřebuje více. Proto si dávková a další produkční úlohy, které pracovaly na stejné mašině, ničeho nevšimly.
Druhou možnou nepříjemností je pád kontejneru. A zde nás zachraňuje restartovací politika, kterou všichni znají, Docker s tím skvěle pracuje. Prakticky všechny produkční úlohy mají politiku restartu always. Někdy používáme on_failure pro dávkové úlohy nebo pro ladění produkčních kontejnerů.
Co se dá dělat, když je celá mašina nedostupná?
Je jasné, že je třeba spustit kontejner na jiném stroji. Nejzajímavější je, co se stane s IP adresou (adresami) přidělenými kontejneru.
Můžeme přidělovat kontejnerům stejné IP adresy jako mají stroje-miniony, na kterých jsou tyto kontejnery spuštěny. Pak při spuštění kontejneru na jiném stroji se jeho IP adresa změní a všichni klienti musí pochopit, že kontejner se přestěhoval, nyní je potřeba se obrátit na jinou adresu, což vyžaduje samostatnou službu pro objevování služeb.
Objevování služeb je praktické. Na trhu je mnoho řešení různých stupňů výpadkovosti pro organizaci registru služeb. Často v těchto řešeních je realizována logika vyvažovače zátěže, ukládání dalších konfigurací ve formě KV storage a podobně.
Rádi bychom se však obešli bez nutnosti zavádět samostatný registr, protože by to znamenalo zavést kritický systém, který používají všechny služby v produkci. To znamená potenciální bod selhání, a je třeba vybírat nebo vyvíjet velmi spolehlivé řešení, což je zjevně velmi složité, časově náročné a drahé.
A další velkou nevýhodou je, že abychom naši starou infrastrukturu spojili s novou, museli bychom přepsat všechny úkoly pro použití nějakého systému Service Discovery. Práce by bylo OPRAVDU hodně, a místy by to bylo téměř nemožné, zejména když se jedná o nízkoúrovňová zařízení, která pracují na úrovni jádra OS nebo přímo s hardwarem. Implementace této funkčnosti pomocí osvědčených vzorů řešení, jako například by znamenala místy dodatečné zatížení, jindy — ztížení provozu a další scénáře selhání. Chtěli jsme se vyhnout komplikacím, a proto jsme se rozhodli udělat použití Service Discovery volitelným.
V one-cloud IP následuje kontejner, tj. každý exemplář úlohy má svou vlastní IP adresu. Tato adresa je „statická“: je přidělena každému exempláři v okamžiku první odeslání služeb do cloudu. Pokud měl během své existence služba různý počet exemplářů — nakonec bude mít tolik IP adres, kolik bylo maximálně exemplářů.
Tyto adresy se následně nemění: jsou přiděleny jednorázově a zůstávají platné po celou dobu existence služby v produkci. IP adresy následují za kontejnery přes síť. Pokud je kontejner přesunut na jiný minion, pak adresa převezme s ním.
Takže mapování názvu služby na seznam jejích IP adres se mění velmi zřídka. Pokud se ještě jednou podíváme na názvy exemplářů služby, které jsme zmínili na začátku článku (1.ok-web.group1.web.front.prod, 2.ok-web.group1.web.front.prod, …), si všimneme, že připomínají FQDN používané v DNS. A skutečně, pro zobrazení názvů instancí služeb v jejich IP adresách používáme protokol DNS. Tento DNS navíc vrací všechny rezervované IP adresy všech kontejnerů — jak běžících, tak zastavených (předpokládejme, že se používají tři repliky, a máme pět adres rezervovaných — všech pět bude vráceno). Klienti, kteří získají tyto informace, se pokusí navázat spojení se všemi pěti replikami — a tím zjistí, které fungují. Tento způsob určování dostupnosti je výrazně spolehlivější, nezapojuje do něj ani DNS, ani Service Discovery, což znamená, že neexistují složité problémy s udržováním aktuálnosti informací a odolností těchto systémů. Navíc u kritických služeb, na kterých závisí fungování celého portálu, můžeme vůbec nepoužívat DNS, ale prostě zadat IP adresy do konfigurace.
Realizace takového přenosu IP za kontejnery může být netriviální — a zastavíme se u toho, jak to funguje, na následujícím příkladu:
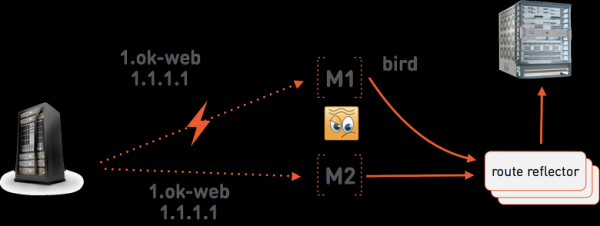
Představme si, že master one-cloud dává pokyn minionu M1 spustit 1.ok-web.group1.web.front.prod s adresou 1.1.1.1. Na minionu běží , který oznamuje tuto adresu speciálním serverům . Ti mají BGP relaci se síťovým zařízením, do které se retransmituje cesta adresy 1.1.1.1 na M1. M1 pak směruje pakety do kontejneru pomocí prostředků Linuxu. Serverů route reflector jsou tři, protože to je velmi kritická část infrastruktury one-cloud — bez nich by síť v one-cloud nefungovala. Umísťujeme je do různých skříní, pokud možno umístěných v různých sálech datacentra, abychom snížili pravděpodobnost současného selhání všech tří.
Předpokládejme nyní, že spojení mezi masterem one-cloud a minionem M1 se přerušilo. Master one-cloud nyní bude jednat na základě předpokladu, že M1 zcela selhal. To znamená, že dá pokyn minionu M2 spustit web.group1.web.front.prod se stejnou IP adresou 1.1.1.1. Nyní máme dvě konfliktní trasy v síti pro 1.1.1.1: na M1 a na M2. Pro řešení těchto konfliktů používáme Multi Exit Discriminator, který je uveden v BGP oznámení. Toto číslo ukazuje váhu inzerované trasy. Z konfliktujících se vybere trasa s menší hodnotou MED. Master one-cloud podporuje MED jako integrální část IP adres kontejnerů. Poprvé je adresa vypsána s dostatečně vysokým MED = 1 000 000. V případě nouzového přesunu kontejneru master snižuje MED a M2 obdrží příkaz inzerovat adresu 1.1.1.1 s MED = 999 999. Instance běžící na M1 zůstane bez spojení a její další osud nás příliš nezajímá do doby obnovení spojení s masterem, kdy bude zastavena jako starý dvojník.
Havárie
Všechny systémy správy datových center vždy adekvátně zvládají drobné výpadky. Selhání kontejneru je normou prakticky všude.
Podívejme se, jak zvládáme havárii, například výpadek energie v jedné nebo více místnostech datového centra.
Co znamená havárie pro systém správy datového centra? V první řadě to je masivní jednorázové selhání mnoha strojů a systém správy musí současně migrovat velké množství kontejnerů. Ale pokud je havárie velmi rozsáhlá, může se stát, že všechny úkoly nebudou moci být přesunuty na jiné miniony, protože kapacita datového centra klesne pod 100 % zatížení.
Havárie často provází selhání i řídící vrstvy. To může nastat kvůli selhání jejích zařízení, ale častěji kvůli tomu, že havárie nejsou testovány, a řídící vrstva sama selhává z důvodu zvýšené zátěže.
Co s tím vším lze udělat?
Masivní migrace znamenají, že v infrastruktuře vzniká velké množství akcí, migrací a umístění. Každá z migrací může zabrat nějaký čas, který je potřeba k dodání a rozbalení obrazů kontejnerů na minionech, spuštění a inicializaci kontejnerů atd. Proto je žádoucí, aby důležitější úkoly byly spuštěny před méně důležitými.
Znovu se podívejme na naši známou hierarchii služeb a pokusme se rozhodnout, které úkoly chceme spustit jako první.
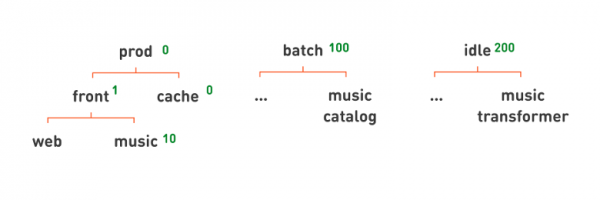
Samozřejmě, to jsou ty procesy, které se přímo podílejí na zpracování požadavků uživatelů, tj. prod. Uvádíme to pomocí priorita umístění — číslo, které může být přiřazeno frontě. Pokud má nějaká fronta vyšší prioritu, její služby se umisťují jako první.
Na prod přiřazujeme vyšší priority, 0; na batch — o něco nižší, 100; na idle — ještě nižší, 200. Priority se aplikují hierarchicky. Všechny úkoly nižší v hierarchii budou mít odpovídající prioritu. Pokud chceme, aby se v rámci prod cache spouštěly před frontami, nastavíme priority pro cache = 0 a pro front podřízené = 1. Pokud například chceme, aby se z front spouštěl jako první hlavní portál a až poté music front, můžeme poslednímu přiřadit nižší prioritu — 10.
Dalším problémem je nedostatek zdrojů. Takže nám selhalo velké množství zařízení, celé sály datového centra, a my jsme spustili tolik služeb, že nyní není dostatek zdrojů pro všechny. Musíme rozhodnout, kterým úkolům obětovat, aby fungovaly hlavní kritické služby.
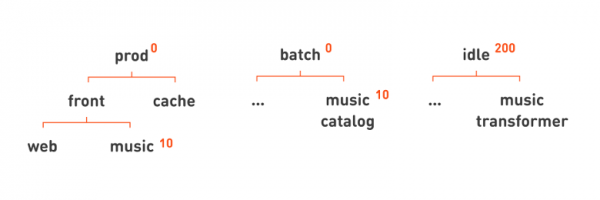
Na rozdíl od priority umístění nemůžeme obecně obětovat všechny batch-úkoly, některé z nich jsou důležité pro fungování portálu. Proto jsme vyčlenili zvlášť prioritu vykazování úloh. Při umístění úkol s vyšší prioritou může vykázat, t.j. zastavit úkol s nižší prioritou, pokud již nejsou k dispozici žádní minioni. Přitom úkol s nízkou prioritou pravděpodobně zůstane neumištěný, tj. pro něj již nebude vhodný minion s dostatečným počtem volných zdrojů.
V naší hierarchii je velmi snadné nastavit takovou prioritu vykazování, aby prod- a batch-úkoly vykazovaly nebo zastavovaly idle-úkoly, ale nezastavovaly navzájem, přičemž pro idle nastavíme prioritu rovnající se 200. Stejně jako v případě priority umístění můžeme využít naši hierarchii k popisu složitějších pravidel. Například můžeme uvést, že obětujeme funkci hudby, pokud nám nebude stačit zdrojů pro hlavní webový portál, a nastavíme odpovídající uzly s nižší prioritou: 10.
Havárie DDC úplně
Proč může selhat celé datové centrum? Přírodní katastrofa. Byl dobrý příspěvek, jak . Elementem lze považovat bezdomovce, kteří kdysi zapálili optiku v kanalizaci a datové centrum úplně ztratilo spojení s ostatními lokalitami. Příčinou výpadku může být i lidský faktor: operátor vydá takový příkaz, že celé datové centrum spadne. To se může stát kvůli velké chybě. Obecně platí, že datová centra padají — to není nic neobvyklého. U nás k tomu dochází jednou za několik měsíců.
A tady je to, co děláme, aby nikdo #okživí nepostoval na Twitter.
První strategie — izolace. Každý instance one-cloud je izolovaná a může spravovat stroje pouze jedné datové centrum. To znamená, že ztráta cloudu kvůli chybám nebo chybnému příkazu operátora — je to ztráta pouze jednoho datového centra. Na to jsme připraveni: máme politiku zálohování, kdy jsou repliky aplikace a dat umístěny ve všech datových centrech. Používáme odolné databáze a pravidelně testujeme výpadky.
Protože dnes máme čtyři datová centra, máme také čtyři úplně izolované instance one-cloud.
Takový přístup nejen chrání před fyzickým selháním, ale může také chránit před chybami operátora.
A co dalšího lze udělat s lidským faktorem? Když operátor vydává cloudu nějaký podivný nebo potenciálně nebezpečný příkaz, může být náhle požádán, aby vyřešil malý úkol, aby ověřil, jak dobře o tom přemýšlel. Například, pokud jde o hromadné zastavení mnoha replik nebo prostě podivný příkaz — snížení počtu replik nebo změna názvu obrazu, a ne pouze čísla verze v novém manifestu.
Závěry
Vlastnosti one-cloud:
- Hierarchická a přehledná schéma pojmenování služeb a kontejnerů, která umožňuje velmi rychle zjistit, o jaký úkol jde, k čemu se vztahuje a jak funguje a kdo za něj odpovídá.
- Používáme svou techniku kombinování prod- a batch-úkolů na minionech, abychom zvýšili efektivitu sdílení strojů. Místo cpuset používáme CPU kvóty, podíly, politiky plánovače CPU a Linux QoS.
- Úplně izolovat kontejnery běžící na jednom stroji se nám nepodařilo, ale jejich vzájemný vliv zůstává v rozmezí do 20%.
- Organizace služeb do hierarchie pomáhá při automatickém odstraňování havárií pomocí priorit umístění a vytěsnění.
ČASTO KLADENÉ OTÁZKY
Proč jsme nezvolili hotové řešení.
- Různé třídy izolace úloh vyžadují odlišnou logiku při umisťování na minionech. Zatímco úlohy v produkci lze umisťovat jednoduchým rezervováním zdrojů, pro dávkové a nečinné úlohy je nutné umisťovat je s ohledem na skutečné využití zdrojů na strojích-minionech.
- Nutnost sledovat spotřebovávané zdroje úloh, jako jsou:
- šířka pásma sítě;
- typy a 'spindly' disků.
- Nutnost uvádět priority služeb při odstraňování havárií, práva a kvóty týmů na zdroje, což se řeší pomocí hierarchických front v one-cloud.
- Nutnost mít lidská názvosloví pro kontejnery, aby se zkrátila doba reakcí na havárie a incidenty.
- Nemožnost současného plošného nasazení Service Discovery; nutnost dlouho koexistovat s úlohami umístěnými na fyzických hostech — což se řeší 'statickými' IP adresami navazujícími na kontejnery, a tím i nutnost unikátní integrace s rozsáhlou síťovou infrastrukturou.
Všechny tyto funkce by si vyžádaly významné úpravy stávajících řešení, a po zhodnocení množství práce jsme si uvědomili, že budeme schopni vyvinout naše řešení s přibližně stejným pracovním úsilím. Ale naše řešení bude podstatně jednodušší na provoz a rozvoj — neobsahuje žádné nadbytečné abstrakce podporující pro nás nepotřebnou funkcionalitu.
Děkujeme všem, kteří přečetli poslední řádky, za trpělivost a pozornost!
Zdroj: habr.com
