

V předchozím článku jsem se zmínil o základech DATA VAULT, popsal hlavní prvky DATA VAULT a jejich účel. Tématu DATA VAULT však nelze považovat za vyčerpané; je třeba probrat další fáze evoluce DATA VAULT.
V tomto článku se zaměřím na rozvoj DATA VAULT a přechod na BUSINESS DATA VAULT nebo jednoduše BUSINESS VAULT.
Důvody vzniku BUSINESS DATA VAULT
Je třeba zdůraznit, že DATA VAULT, i když má určité silné stránky, není bez nedostatků. Jedním z těchto nedostatků je složitost při psaní analytických dotazů. Dotazy obsahují značné množství JOINů, což dělá kód dlouhý a nešikovný. Navíc data, která vstupují do DATA VAULT, nejsou podrobena žádným transformacím, takže z hlediska podnikání DATA VAULT v čisté podobě nemá bezpodmínečnou hodnotu.
Právě za účelem odstranění těchto nedostatků byla metodologie DATA VAULT rozšířena o prvky jako:
- PIT (point in time) tabulky;
- BRIDGE tabulky;
- PREDEFINED DERIVATIONS.
Pojďme si podrobněji přiblížit účel těchto prvků.
PIT tabulky
Obvykle může mít jeden obchodní objekt (HUB) data s různou frekvencí aktualizace. Například pokud hovoříme o údajích charakterizujících člověka, můžeme říci, že informace o telefonním čísle, adrese nebo e-mailu mají vyšší frekvenci aktualizace než například jméno a příjmení, údaje o pasu, rodinném stavu nebo pohlaví.
Proto při určování satellite by se mělo brát v úvahu, jak často se aktualizují. Proč je to důležité?
Pokud bychom v jedné tabulce uchovávali atributy s různou frekvencí aktualizace, museli bychom přidávat řádky do tabulky při každé aktualizaci nejčastěji měněného atributu. Důsledkem je nárůst objemu diskového prostoru a zvýšení doby vykonání dotazů.
Nyní, když jsme rozdělili satellite podle frekvence aktualizace a můžeme do nich načítat data nezávisle, je třeba zajistit možnost získávání aktuálních dat. Lépe bez zbytečných JOINů.
Vysvětlím, například je potřeba získat aktuální (podle data poslední aktualizace) informace z satellitech s různou frekvencí aktualizace. K tomu je potřeba nejen provést JOIN, ale také vytvořit několik vnořených dotazů (pro každý satelit obsahující informace) s výběrem maximálního data aktualizace MAX(Datum aktualizace). S každým novým JOINem se tento kód rozrůstá a velmi rychle se stává složitým k pochopení.
PIT tabulka je určena k zjednodušení takových dotazů, PIT tabulky se vyplňují současně se zápisem nových dat do DATA VAULT. PIT tabulka:
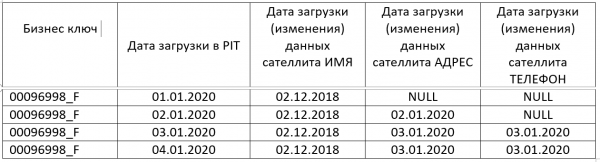
Tím máme informace o aktuálnosti dat ze všech satellitech k jakémukoli časovému okamžiku. Použitím JOINů k PIT tabulce můžeme zcela vyloučit vnořené dotazy, samozřejmě za podmínky, že se PIT vyplňuje každý den a bez výpadků. I když výpadky v PIT existují, lze získat aktuální data pouze pomocí jednoho vnořeného dotazu na samotný PIT. Jeden vnořený dotaz bude fungovat rychleji než vnořené dotazy na každý satelit.
BRIDGE
Tabulky typu BRIDGE jsou také používány k zjednodušení analytických dotazů. Rozdílem oproti PIT je, že slouží k zjednodušení a urychlení dotazů mezi různými huby, linkami a jejich satellitech.
Tabulka obsahuje všechny potřebné klíče pro všechny satelity, které jsou často používány v dotazech. Kromě toho, v případě potřeby mohou být hashované business klíče doplněny klíči v textové podobě, pokud jsou názvy klíčů potřebné pro analýzu.
O co jde, je, že bez použití BRIDGE, při získávání dat nacházejících se v satellitech patřících různým hubům, bude potřeba provést JOIN nejen mezi samými satelity, ale i mezi linkami spojujícími huby.
Přítomnost nebo nepřítomnost BRIDGE je určena konfigurací úložiště a potřebou optimalizace rychlosti provádění dotazů. Obecný příklad BRIDGE se těžko vymýšlí.
PREDEFINED DERIVATIONS
Dalším typem objektů, který nás přibližuje k BUSINESS DATA VAULT, jsou tabulky obsahující předem vypočtené ukazatele. Tyto tabulky jsou opravdu důležité pro byznys, obsahují informace agregované podle stanovených pravidel a umožňují snadný přístup k těmto údajům.
Architektonické PREDEFINED DERIVATIONS představují nic jiného než další satelit určitého hubu. Stejně jako běžný satelit obsahuje podnikový klíč a datum vytvoření záznamu v satelitu. Tím však podobnosti končí. Další související atributy takového „specializovaného“ satelitu jsou určovány obchodními uživateli na základě nejžádanějších, předem vypočítaných ukazatelů.
Například hub obsahující informace o zaměstnanci může zahrnovat satelit s takovými ukazateli, jako jsou:
- Minimální plat;
- Maximální plat;
- Průměrný plat;
- Kumulativní součet vyplacené mzdy atd.
Je logické zahrnout PREDEFINED DERIVATIONS do PIT tabulky tohoto stejného hubu, poté je možné snadno získat datové řezy o zaměstnanci k výběru konkrétní datum.
ZÁVĚRY
Jak ukazuje praxe, používání DATA VAULT obchodními uživateli je poněkud problematické z několika důvodů:
- Kód dotazů je složitý a objemný;
- Hojnost JOIN’ů ovlivňuje rychlost dotazů;
- Pro psaní analytických dotazů je vyžadováno vynikající znalosti struktury úložiště.
Aby se usnadnil přístup k datům, DATA VAULT se rozšiřuje o další objekty:
- PIT (point in time) tabulky;
- BRIDGE tabulky;
- PREDEFINED DERIVATIONS.
V následující plánuji vyprávět, podle mého názoru, to nejzajímavější pro ty, kteří pracují s BI. Představím způsoby vytváření tabulek – faktů a tabulek – dimenzí na základě DATA VAULT.
Materiály článku jsou založeny na:
- Na Kenta Graciana, která kromě podrobného popisu obsahuje schémata modelu;
- Kniha: „Building a Scalable Data Warehouse with DATA VAULT 2.0“;
- Článek .
Zdroj: habr.com
