

Na podzim roku 2019 došlo v iOS týmu Mail.ru k dlouho očekávanému události. Hlavní databázovou základnou pro trvalé uchovávání stavu aplikace se stala poměrně exotická pro mobilní svět. (LMDB). Následuje podrobný přehled ve čtyřech částech. Nejprve si povíme o důvodech tak netradičního a složitého výběru. Poté se zaměříme na tři pilíře architektury LMDB: paměťově mapované soubory, B+-strom a přístup copy-on-write pro implementaci transakčnosti a multi-versioning. Nakonec si na závěr ukážeme praktickou část. V ní prozkoumáme, jak navrhnout a implementovat schéma databáze s více tabulkami, včetně indexu, nad nízkou úrovní key-value API.
Obsah
3.1.
3.2.
3.3.
4.1.
4.2.
4.3.
1. Motivace k implementaci
Jednou v roce 2015 jsme se zaměřili na měření, jak často naše aplikace zpomaluje. Nezačali jsme to dělat jen tak. Častěji jsme dostávali stížnosti, že aplikace občas přestane reagovat na akce uživatele: tlačítka se nezmáčknou, seznamy se nescrollují atd. O mechanice měření jsem. na AvitoTech, takže zde uvádím jen pořadí čísel.
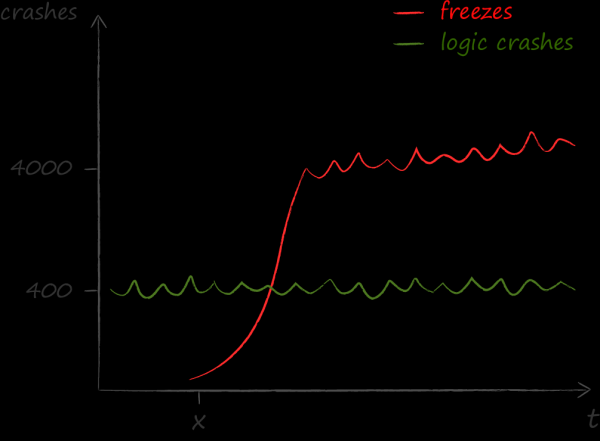
Výsledky měření pro nás byly studenou sprchou. Ukázalo se, že problémů způsobených zamrzáním je mnohem více než jakýchkoli jiných. Pokud před uvědoměním si této skutečnosti byla hlavním technickým ukazatelem kvality absence pádů, po ní se fokus. na absenci zamrzání.
Postavili jsme a provedli a analýzu jejich příčin, což přivedlo k pochopení hlavního nepřítele — složité obchodní logiky, vykonávané v hlavním vlákně aplikace. Přirozenou reakcí na tento chaos bylo silné přání rozdělit ji mezi pracovní vlákna. Pro systémové řešení tohoto úkolu jsme použili vícerozměrnou architekturu založenou na lehkých aktérech. Její adaptaci pro svět iOS jsem věnoval. na kolektivním Twitteru a . V rámci tohoto vyprávění chci zdůraznit ty aspekty řešení, které ovlivnily výběr databáze.
Aktorový model organizace systému předpokládá, že multithreading se stává jeho druhou podstatou. Objekty modelu v něm rády překračují hranice vláken. A to nejen občas a kdesi, ale prakticky neustále a všude.
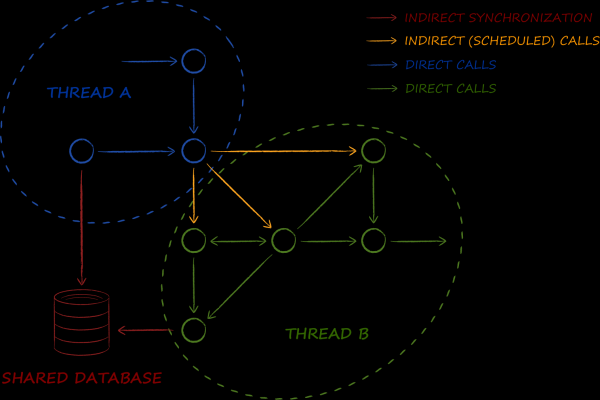
Databáze je jednou z klíčových komponent v předloženém schématu. Jejím hlavním úkolem je realizace makropatternu . Pokud v podnikatelském světě pomocí ní organizují synchronizaci dat mezi službami, v případě aktorové architektury jde o data mezi vlákny. Takže jsme potřebovali takovou databázi, jejíž práce v multithreadovém prostředí nezpůsobuje ani minimální potíže. To znamená, že objekty získané z ní by měly být minimálně thread-safe a ideálně i imutabilní. Jak je známo, ty poslední lze používat současně z několika vláken, aniž by bylo třeba jakýchkoli zámků, což má pozitivní vliv na výkon.
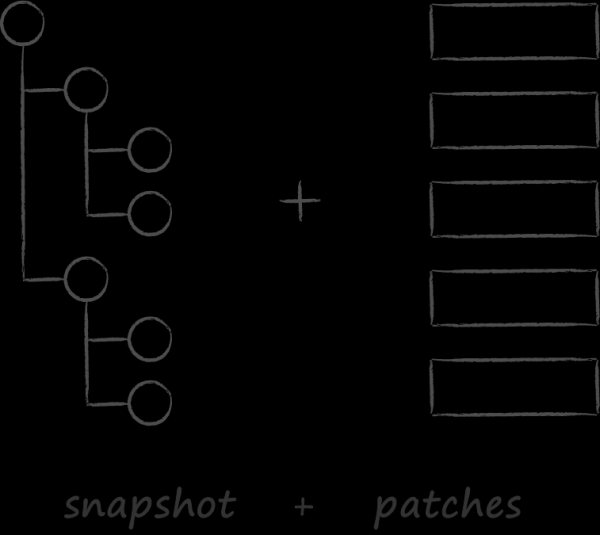 Druhým významným faktorem, který ovlivnil volbu databáze, bylo naše cloudové API. Bylo inspirováno přístupem ke synchronizaci, který byl přijat v git. Stejně jako on jsme mířili na , které pro cloudové klienty vypadá více než vhodně. Předpokládalo se, že jednou stáhnou kompletní stav cloudu a poté bude synchronizace v převážném počtu případů probíhat prostřednictvím aplikace změn. Bohužel, tato možnost je stále jen v teoretické zóně, a klienti se zatím nenaučili pracovat s patchemi. Na to existuje řada objektivních důvodů, které, abychom nezdržovali úvod, ponecháme stranou. V současnosti však představují mnohem větší zajímavost poučné závěry z lekce o tom, co se stane, když API řeklo „A“, a jeho uživatel neřekl „B“.
Pokud si představíte git, který při provádění příkazu pull místo aplikace patchů na místní snímek porovnává jeho úplný stav s úplným stavem na serveru, budete mít dost přesnou představu o tom, jak probíhá synchronizace v cloudových klientech. Není těžké odhadnout, že pro její provedení je třeba alokovat v paměti dvě DOM stromy s metainformacemi o všech serverových a místních souborech. To znamená, že pokud uživatel uchovává v cloudu 500 tisíc souborů, je nutné zrekonstruovat a zničit dva stromy se 1 milionem uzlů. A každý uzel je agregát, který obsahuje graf podobjektů. V tomto ohledu se výsledky profilování ukázaly jako očekávané. Ukázalo se, že i bez zohlednění algoritmiky sloučení vás už samotný postup vytváření a následného ničení obrovského množství drobných objektů může vyjít draho. Situaci zhoršuje skutečnost, že základní operace synchronizace je zahrnuta do mnoha uživatelských scénářů. Výsledkem je, že zafixujeme druhý důležitý kriterium při výběru databáze — schopnost realizace operací CRUD bez dynamické alokace objektů.
Další požadavky jsou více tradiční a jejich seznam vypadá následovně.
- Thread safety.
- Multiprocessnost. Vychází ze záměru použít stejný instance databáze pro synchronizaci stavu nejen mezi vlákny, ale také mezi hlavní aplikací a rozšířeními iOS.
- Možnost představovat uložené entity jako neměnné objekty.
- Absence dynamických alokací v rámci operací CRUD.
- Podpora transakcí základních vlastností : atomicita, konzistence, izolace a spolehlivost.
- Rychlost v nejpopulárnějších případech použití.
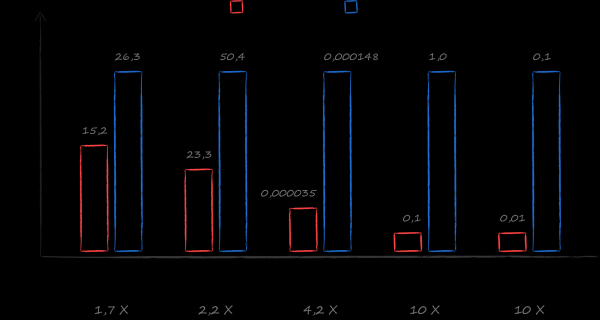
Dobrou volbou s těmito požadavky byl a zůstává SQLite. Nicméně v rámci zkoumání alternativ mi do ruky přišla kniha Pod jejím vedením byl napsán benchmark, který srovnával rychlost práce s různými databázemi v rámci skutečných cloudových scénářů. Výsledek překonal i ta nejsmělejší očekávání. V nejpopulárnějších případech — získání kurzoru na seřazený seznam všech souborů a seřazený seznam všech souborů pro daný adresář — byla LMDB desetkrát rychlejší než SQLite. Volba byla jasná.
2. Pozicování LMDB
LMDB je knihovna, velmi malá (pouze 10K řádků), která implementuje nejnižší základní vrstvu databází — úložiště.
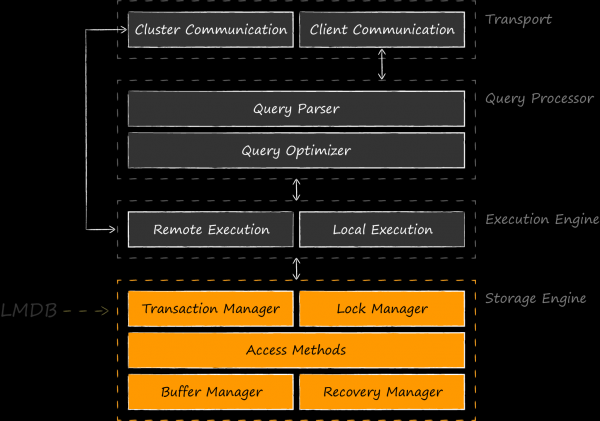
Zobrazená schéma ukazuje, že srovnávat LMDB se SQLite, které implementuje také vyšší úrovně, není vlastně správné, tak jako porovnávat SQLite s Core Data. Jako rovnocenné konkurenty bude spravedlivější uvést podobné úložné motory — BerkeleyDB, LevelDB, Sophia, RocksDB a další. Existují dokonce vývojové projekty, kde LMDB působí jako komponenta storage engine pro SQLite. První takový experiment byl proveden v roce 2012. autor LMDB . se ukázaly být natolik zajímavými, že jeho úsilí bylo převzato nadšenci OSS a našlo pokračování ve formě . V lednu 2020 autor tohoto projektu Den Shearer je představil na LinuxConfAu.
Hlavním použitím LMDB se stává motor pro aplikační databáze. Svým vznikem knihovna vděčí vývojářům , kteří byli velmi nespokojeni s BerkeleyDB jako základem svého projektu. Odrazivše se od skromné knihovny , Howard Chu se podařilo vytvořit jednu z dnes nejpopulárnějších alternativ. Tuto historii a také vnitřní strukturu LMDB věnoval svému velmi zajímavému přednášce . Dobrým příkladem ovládnutí úložiště se podělil Leonid Jurjev (aka ) z Positive Technologies ve své přednášce na Highload 2015 . V ní hovoří o LMDB v kontextu podobné úlohy implementace ReOpenLDAP, zatímco byla podrobena srovnávací kritice LevelDB. Po zavedení se v Positive Technologies dokonce objevil aktivně se rozvíjející fork s velmi atraktivními funkcemi, optimalizacemi a .
LMDB je často používán také jako úložiště as is. Například prohlížeč Mozilla Firefox ho pro celou řadu potřeb, a počínaje 9. verzí, Xcode němu před SQLite pro ukládání indexů.
Motor se objevuje i ve světě mobilního vývoje. Stopy jeho využití lze v iOS klientu pro Telegram. LinkedIn šel ještě dál a zvolil LMDB jako výchozí úložiště pro domácí caching framework Rocket Data, o čemž ve svém článku z roku 2016.
LMDB úspěšně bojuje o místo na slunci v nika, kterou opustil BerkeleyDB po převzetí pod kontrolu Oracle. Knihovna je oblíbená pro svou rychlost a spolehlivost i v porovnání s podobnými. Jak je známo, nic není zadarmo, a chtěl bych zdůraznit trade-off, se kterým se budete muset potýkat při výběru mezi LMDB a SQLite. Schéma výše názorně ukazuje, jak je dosaženo vyšší rychlosti. Za prvé, neplatíme za další vrstvy abstrakce nad diskovým úložištěm. Je jasné, že v dobré architektuře bez nich se stejně neobejdeme, a ty se nevyhnutelně objeví v kódu aplikace, avšak budou mnohem tenčí. Nebudou obsahovat funkce, které konkrétní aplikace nevyžaduje, například podporu SQL dotazů. Za druhé, vzniká možnost optimálně realizovat mapping aplikačních operací na dotazy k diskovému úložišti. Pokud SQLite vychází z průměrných potřeb průměrné aplikace, pak jako aplikační vývojář máte dobré povědomí o hlavních scénářích zatížení. Za výkonnější řešení budete muset zaplatit vyššími náklady jak na vývoj původního řešení, tak na jeho následnou podporu.
3. Tři pilíře LMDB
Podívali jsme se na LMDB z výšky, nyní je čas se ponořit hlouběji. Následující tři sekce budou věnovány analýze hlavních pilířů, na kterých spočívá architektura úložiště:
- Obrázkové soubory v paměti jako mechanismus práce s diskem a synchronizace vnitřních datových struktur.
- B+-strom jako organizace struktury uložených dat.
- Copy-on-write jako přístup k zajištění vlastností ACID transakcí a multiverzionality.
3.1. Pilíř č. 1. Soubory mapované do paměti
Zobrazované v paměti soubory jsou natolik důležitým architektonickým prvkem, že se dokonce objevují v názvu úložiště. Otázky cachování a synchronizace přístupu k uloženým informacím jsou plně svěřeny operačnímu systému. LMDB neobsahuje žádné cache. To je vědomé rozhodnutí autora, protože čtení dat přímo z zobrazených souborů umožňuje zkrátit mnoho ohybů v implementaci enginu. Níže uvádím rozhodně neúplný seznam některých z nich.
- Udržování konzistence dat v úložišti při práci s ním z více procesů se stává povinností operačního systému. V následující části je tato mechanika podrobně probrána s obrázky.
- Absence cache zcela zbavuje LMDB režijních nákladů spojených s dynamickými alokacemi. Čtení dat je v praxi představováno nastavením ukazatele na správnou adresu ve virtuální paměti a nic víc. Zní to jako fantazie, ale ve zdrojích úložiště jsou všechny výzvy salloc soustředěny ve funkci konfigurace úložiště.
- Absence cache znamená také absenci zámků spojených se synchronizací jejich přístupu. Čtenáři, jichž může existovat libovolné množství, nenarážejí na své cestě k datům na žádný mutex. Díky tomu má rychlost čtení ideální lineární škálovatelnost podle počtu CPU. V LMDB jsou synchronizovány pouze modifikační operace. Písař může být v každém okamžiku pouze jeden.
- Minimální logika cachování a synchronizace zbavuje kód extrémně složitých chyb spojených s prací v multithreadovém prostředí. Na konferenci Usenix OSDI 2014 byly dvě zajímavé studie databází: a . Z nich lze čerpat informace jak o bezprecedentní spolehlivosti LMDB, tak o prakticky bezchybném provedení ACID vlastností transakcí, které překonávají totéž v SQLite.
- Minimalistická povaha LMDB umožňuje strojnímu zobrazení jejího kódu plně se umístit do L1 cache procesoru, s vyplývajícími rychlostními charakteristikami.
Bohužel v iOS není práce s mapovanými do paměti soubory tak bezproblémová, jak bychom si přáli. Abychom mohli lépe diskutovat o jejich nedostatcích, musíme si připomenout obecné principy implementace tohoto mechanismu v operačních systémech.
Obecné informace o mapovaných do paměti souborech
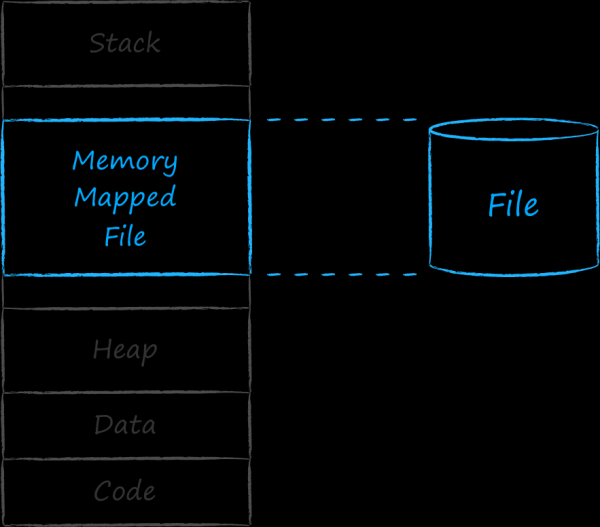 Každé spuštěné aplikaci přiřazuje operační systém entitu nazvanou proces. Každému procesu je přidělena kontinuální oblast adres, ve které umisťuje všechno, co potřebuje k práci. Na nejnižších adresách se nacházejí sekce s kódem a hardcoded daty a prostředky. Následuje nahoru rostoucí blok dynamického adresního prostoru, který velmi dobře známe pod názvem heap. V něm se nacházejí adresy entit, které se objevují během běhu programu. V horní části je oblast paměti, kterou využívá zásobník aplikace. Ten roste a zmenšuje se, jinými slovy jeho velikost má také dynamickou povahu. Aby se zásobník a heap navzájem neprovokovaly a nebránily si, jsou rozloženy na opačných koncích adresního prostoru. Mezi dvěma dynamickými sekcemi nahoře a dole je mezera. Adresy v této střední části operační systém využívá k přiřazení různých entit k procesu. Konkrétně může přiřadit určitému kontinuálnímu bloku adres soubor na disku. Takovýto soubor se nazývá mapovaný do paměti.
Vyhrazený adresní prostor procesům je obrovský. Teoreticky je počet adres omezen pouze velikostí ukazatele, která se určuje podle bitovosti systému. Kdyby byla 1-na-1 přiřazena fyzické paměti, první proces by okamžitě spotřeboval celou RAM a o žádné vícetréninkovosti nemohlo být ani řeči.
Nicméně ze své zkušenosti víme, že moderní operační systémy mohou současně vykonávat libovolný počet procesů. To je možné díky tomu, že procesům přidělují spoustu paměti pouze na papíře a ve skutečnosti do hlavní fyzické paměti načítají pouze tu část, která je právě potřebná. Proto se paměť asociovaná s procesem nazývá virtuální.
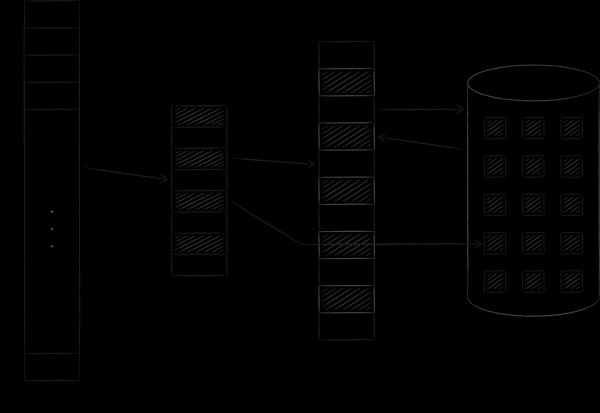
Operační systém organizuje virtuální a fyzickou paměť ve formě stránek určité velikosti. Jakmile je nějaká stránka virtuální paměti potřebná, operační systém ji načte do fyzické paměti a vytvoří mezi nimi odpovídající vazbu ve speciální tabulce. Pokud nejsou volné sloty, jedna z dříve načtených stránek se zkopíruje na disk a požadovaná stránka zaujme její místo. Tento proces, ke kterému se brzy vrátíme, se nazývá swapping. Obrázek níže ilustruje popsaný proces. Na něm byla stránka A s adresou 0 načtena a umístěna na stránku hlavní paměti s adresou 4. Tento fakt se odráží v tabulce shod v buňce číslo 0.
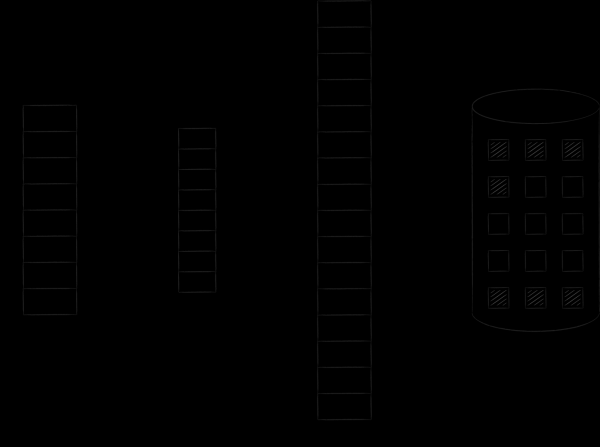
S zobrazenými v paměti soubory je historie naprosto stejná. Logicky jsou jakoby nepřetržitě a celkově umístěny v virtuálním adresním prostoru. Nicméně do fyzické paměti se dostávají stránkově a pouze na požádání. Modifikace těchto stránek je synchronizována se souborem na disku. Tímto způsobem lze provádět souborový vstup/výstup, jednoduše tím, že pracujeme s bajty v paměti — všechny změny budou automaticky přeneseny jádrem operačního systému k původnímu souboru.
Obrázek níže ukazuje, jak LMDB synchronizuje svůj stav při práci s databází z různých procesů. Pokud mapujeme virtuální paměť různých procesů na jeden a ten samý soubor, de facto nutíme operační systém tranzitivně synchronizovat mezi sebou určité bloky jejich adresních prostorů, na které LMDB nahlíží.
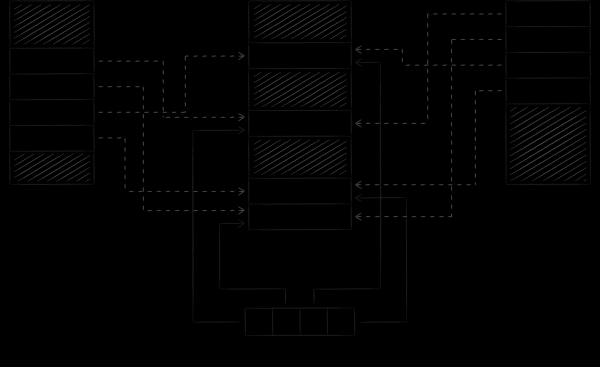
Důležitý aspekt spočívá v tom, že LMDB ve výchozím nastavení modifikuje soubor s daty prostřednictvím mechanismu systémového volání write, a samotný soubor zobrazuje v režimu pouze pro čtení. Tento přístup má dvě důležité důsledky.
Prvním důsledkem je něco, co platí pro všechny operační systémy. Jeho podstatou je přidání ochrany proti neúmyslnému poškození databáze nesprávným kódem. Jak je známo, vykonávané instrukce procesu mají volnost při přístupu k datům z jakéhokoliv místa jejího adresního prostoru. Zároveň, jak jsme právě zmínili, zobrazení souboru v režimu pro čtení a zápis znamená, že jakákoliv instrukce může tento soubor navíc také modifikovat. Pokud tak učiní omylem, například se pokusí přepsat prvek pole neexistujícím indexem, může tak náhodou změnit mapovaný soubor na tuto adresu, což povede k poškození databáze. Pokud je soubor zobrazen v režimu pouze pro čtení, pokus o změnu odpovídajícího adresního prostoru povede k havarijnímu ukončení programu se signálem SIGSEGV, a soubor zůstane v celistvosti.
Druhý důsledek je specifický pro iOS. Ani autor, ani žádné jiné zdroje o něm výslovně nezmiňují, ale bez něj by LMDB nebyla použitelná v tomto mobilním operačním systému. Jeho zkoumání je věnována následující kapitola.
Specifika paměťově mapovaných souborů v iOS
Na WWDC 2018 byla skvělá prezentace . V ní se uvádí, že v iOS všechny stránky umístěné ve fyzické paměti patří do jednoho z 3 typů: dirty, compressed a clean.
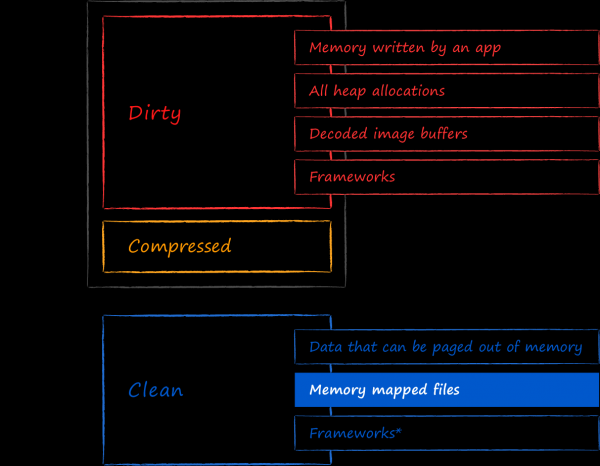
Čistá paměť je souhrn stránek, které mohou být bezbolestně uvolněny z fyzické paměti. Data na nich se mohou podle potřeby znovu načíst z jejich původních zdrojů. Souborové paměťově mapované soubory spadají právě do této kategorie. iOS se nebojí kdykoliv vyložit z paměti stránky zobrazené na souboru, protože jsou zaručeně synchronizovány se souborem na disku.
V dirty paměti se nacházejí všechny modifikované stránky, bez ohledu na to, kde se původně nacházely. Zvláštně budou takto klasifikovány také paměťově mapované soubory, které byly změněny zápisem do s nimi asociované virtuální paměti. Otevřením LMDB s příznakem MDB_WRITEMAP, po provedení změn v ní se o tom lze přesvědčit osobně.
Jakmile aplikace začne zabírat příliš mnoho fyzické paměti, iOS podrobuje její dirty stránky kompresi. Součet paměti, který zabírají dirty a komprimované stránky, tvoří takzvanou paměťovou stopu aplikace. Po dosažení určitého prahového hodnoty přichází ke procesu systémový démon OOM killer a násilně ho ukončuje. To je zvláštnost iOS ve srovnání s desktopovými operačními systémy. Na rozdíl od nich není v iOS předvídané snižování paměťové stopy prostřednictvím swapování stránek z fyzické paměti na disk. O příčinách můžeme pouze spekulovat. Možná je proces intenzivního přesunu stránek na disk a zpět příliš energeticky náročný pro mobilní zařízení, nebo iOS šetří kapacitu přepisování buněk na SSD discích, nebo snad návrháře neuspokojovala celková výkon systému, kde se vše neustále swapuje. Ať tak či onak, fakt zůstává faktem.
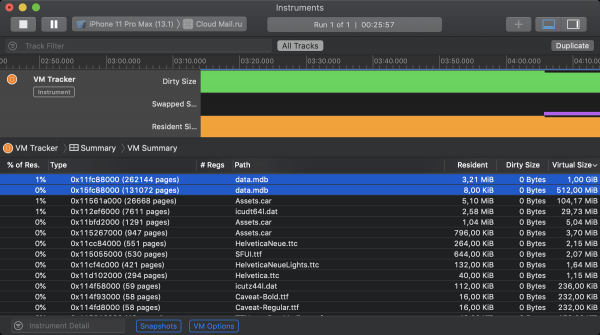
Dobrá zpráva, již dříve zmíněná, je, že LMDB standardně nepoužívá mechanismus mmap pro aktualizaci souborů. Z toho vyplývá, že vykreslená data jsou klasifikována iOS jako clean memory a nepřispívají k paměťové stopě. Toho lze dosáhnout pomocí nástroje Xcode s názvem VM Tracker. Na níže uvedeném snímku obrazovky je zobrazen stav virtuální paměti iOS aplikace Oblačnost během jejího chodu. Na začátku bylo inicializováno 2 instance LMDB. První měl povolení mapovat svůj soubor na 1GiB virtuální paměti, druhý na 512MiB. I když obě úložiště zabírají určité množství rezidentní paměti, žádné z nich nepřispívá do dirty size.
A nyní je čas na špatné zprávy. Díky mechanismu swapování v 64-bitových desktopových operačních systémech může každý proces zabírat tolik virtuálního adresního prostoru, kolik dovoluje volný prostor na pevném disku pro jeho potenciální swap. Nahrazení swapování kompresí v iOS radikálně snižuje teoretický maximální limit. Nyní musí všechny aktivní procesy vejít do hlavní (čti operační) paměti, a všechny, které se nevejdou, podléhají násilnému ukončení. O tom se hovoří jak v již zmíněném , tak i v . V důsledku toho iOS striktně omezuje velikost paměti dostupné pro alokaci přes mmap. Tady lze zkoumat empirické limity objemů paměti, které bylo možné alokovat na různých zařízeních pomocí tohoto systémového volání. Na nejmodernějších modelech smartphonů iOS je k dispozici 2 gigabajty, zatímco na špičkových verzích iPadu dokonce 4. V praxi se ovšem musíme orientovat na nejlevnější podporované modely zařízení, kde je situace mnohem smutnější. Ještě hůř, pokud se podíváme na stav paměti aplikace ve VM Trackeru, můžeme zjistit, že LMDB není jediná, kdo usiluje o paměť mapovanou s důrazem na stránky. Dobré části paměti zabírají systémoví alokátoři, soubory s prostředky, frameworky pro práci s obrázky a další menší predátoři.
Na základě výsledků experimentů v Cloudu jsme dospěli k následujícím kompromisním hodnotám přidělované paměti LMDB: 384 megabajtů pro 32bitová zařízení a 768 pro 64bitová. Po vyčerpání tohoto objemu začínají jakékoli modifikační operace končit s kódem MDB_MAP_FULL. Takové chyby jsme zaznamenali v našem monitorování, ale je jich dost málo, abychom je v tuto chvíli mohli ignorovat.
Nepřímou příčinou nadměrné spotřeby paměti úložiště mohou být dlouhožijící transakce. Pro pochopení, jak jsou tyto dvě jevy propojeny, nám pomůže prozkoumat zbývající dva pilíře LMDB.
3.2. Pilíř č. 2. B+-strom
Pro simulaci tabulek nad key-value úložištěm je nutné, aby jeho API obsahovalo následující operace:
- Vložení nového prvku.
- Vyhledání prvku se zadaným klíčem.
- Odstranění prvku.
- Iterování podle intervalů klíčů v pořadí jejich třídění.
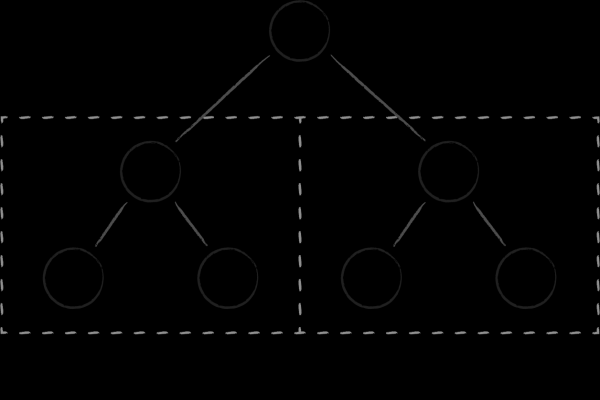 Nejjednodušší datovou strukturou, se kterou lze snadno realizovat všechny čtyři operace, je binární vyhledávací strom. Každý jeho uzel představuje klíč, rozdělující celé podmnožství podřízených klíčů na dvě podstromy. V levém jsou shromážděny klíče, které jsou menší než rodičovský, zatímco v pravém jsou ty, které jsou větší. Získání seřazené množiny klíčů se dosahuje jedním z klasických průchodů stromem.
Binární stromy mají dvě zásadní nevýhody, které jim brání být efektivní jako diskové datové struktury. Za prvé, jejich úroveň vyváženosti je nepředvídatelná. Existuje značné riziko, že získáte stromy, ve kterých se výška různých větví může výrazně lišit, což značně zhoršuje algoritmickou složitost hledání ve srovnání s očekáváním. Za druhé, hojnost křížových odkazů mezi uzly zbavuje binární stromy lokalizace v paměti. Blízké uzly (z pohledu vztahů mezi nimi) mohou být umístěny na zcela různých stránkách ve virtuální paměti. V důsledku toho může být i pro jednoduché procházení několika sousedními uzly ve stromě nutné navštívit srovnatelný počet stránek. To je problém i když mluvíme o efektivitě binárních stromů jako in-memory datové struktury, protože neustálá rotace stránek v cache procesoru není levná záležitost. Když se pak hovoří o častém načítání stránek souvisejících s uzly z disku, situace se stává ještě horším. .
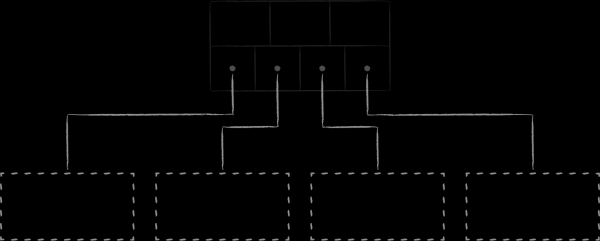 B-stromy, jako evoluce binárních stromů, řeší v předchozím odstavci uvedené problémy. Za prvé, jsou samobalancující. Za druhé, každý jejich uzel rozděluje množství podřízených klíčů ne na 2, ale na M uspořádaných podmnožin, přičemž číslo M může být poměrně velké, v řádech stovek, nebo dokonce tisíců.
Díky tomu:
- V každém uzlu se nachází velké množství již uspořádaných klíčů a stromy se stávají velmi nízkými.
- Strom získává vlastnost lokalizace umístění v paměti, protože blízké hodnoty klíčů se přirozeně nacházejí vedle sebe na jednom nebo sousedních uzlech.
- Snižuje se počet přechodných uzlů při sestupu po stromě během operace vyhledávání.
- Snižuje se počet čtených cílových uzlů při range dotazech, protože v každém z nich se již nachází velké množství uspořádaných klíčů.
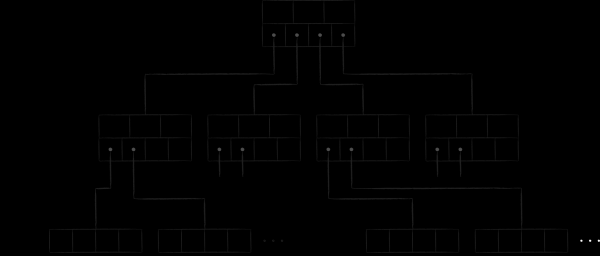
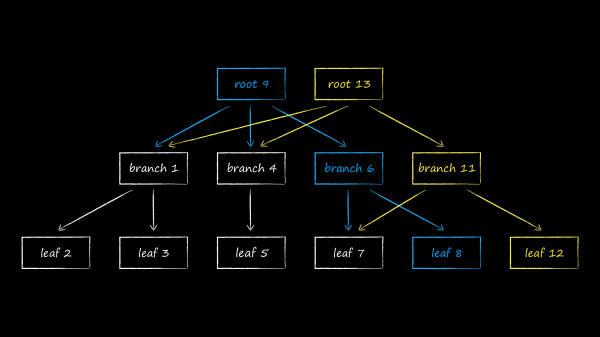
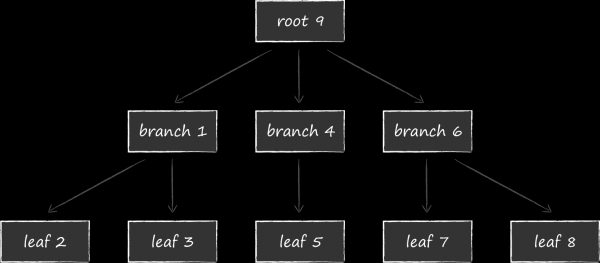
V LMDB se pro ukládání dat používá jedna z variant B-stromu nazývaná B+-strom. Na schématu výše jsou znázorněny tři typy uzlů, které se v něm vyskytují:
- Na vrcholu se nachází kořen (root). Ten představuje nic jiného než koncept databáze uvnitř úložiště. Uvnitř jednoho instance LMDB lze vytvářet několik databází, které si vzájemně dělí mapované virtuální adresové prostory. Každá z nich začíná svým vlastním kořenem.
- Na nejnižší úrovni se nacházejí listy (leaf). Právě ty a jenom ty obsahují uchovávané v databázi páry klíč-hodnota. Mimochodem, v tom spočívá zvláštnost B+-stromů. Zatímco běžný B-strom uchovává části hodnoty ve vrcholech všech úrovní, B+-variace pouze na nejnižší úrovni. Po potvrzení tohoto faktu budeme dále používat podtyp stromu použitý v LMDB jednoduše nazývat B-stromem.
- Mezi kořenem a listy se nachází 0 a více technických úrovní s navigačními (branch) uzly. Jejich úkolem je rozdělit seřazenou množinu klíčů mezi listy.
Fyzicky jsou uzly bloky paměti předem určené délky. Jejich velikost je násobkem velikosti stránek paměti v operačním systému, o kterých jsme se zmínili výše. Níže je uvedena struktura uzlu. V hlavičce se nacházejí metadata, z nichž nejzřejmější pro příklad - to je kontrolní součet. Dále následují informace o offsetech, podle nichž se nacházejí buňky s daty. Jako data mohou sloužit buď klíče, pokud mluvíme o navigačních uzlech, nebo celé páry klíč-hodnota v případě listů. O struktuře stránek se můžete dočíst podrobněji v práci .
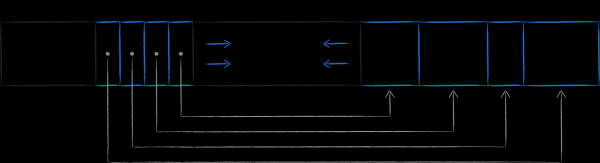
Poté, co jsme si objasnili vnitřní obsah uzlů-stránek, budeme dále zjednodušeně prezentovat B-strom LMDB v následujícím podání.
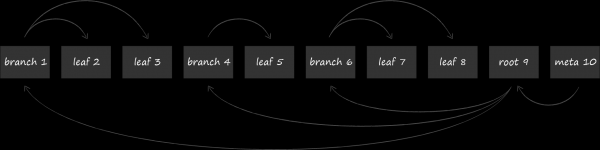
Stránky s uzly se postupně ukládají na disk. Stránky s vyšším číslem se nacházejí blíže ke konci souboru. Takzvaná meta-stránka (meta page) obsahuje informace o offsetech, podle nichž lze nalézt kořeny všech stromů. Při otevření souboru LMDB stránkově skenuje soubor od konce k začátku za účelem nalezení platné meta-stránky a prostřednictvím ní nalezne existující databáze.
Nyní, když máme představu o logické a fyzické struktuře organizace dat, můžeme přejít k prozkoumání třetího pilíře LMDB. To je právě ten nástroj, který umožňuje, aby všechny modifikace úložiště probíhaly transakčně a izolovaně od sebe, čímž celkové databázi poskytuje také vlastnost multiversionality.
3.3. Pilíř č. 3. Copy-on-write
Některé operace s B-stromy zahrnují provedení celé série změn v jejich uzlech. Jedním z příkladů je přidání nového klíče do uzlu, který již dosáhl maximální kapacity. V takovém případě je nutné jednak rozdělit uzel na dva, a jednak přidat odkaz na nový odstřižený poduzel do jeho rodiče. Tento proces je potenciálně velmi nebezpečný. Pokud z nějakého důvodu (pád, výpadek napájení atd.) dojde pouze k části změn ze série, zůstane strom v nekonzistentním stavu.
Jedním z tradičních řešení, jak zajistit databázi odolnost vůči chybám, je přidání vedle B-stromu další diskové struktury dat — logu transakcí, známého také jako write-ahead log (WAL). Je to soubor, do kterého se přísně před modifikací samotného B-stromu zapisují plánované operace. Tímto způsobem, pokud se během sebediagnózy zjistí poškození dat, databáze se konzultuje s logem, aby se napravila.
LMDB vybrala pro zajištění odolnosti vůči chybám jiný způsob, nazvaný copy-on-write. Jeho podstata spočívá v tom, že místo aktualizace dat na existující stránce se nejdříve celá zkopíruje a všechny modifikace se provádějí již na kopii.
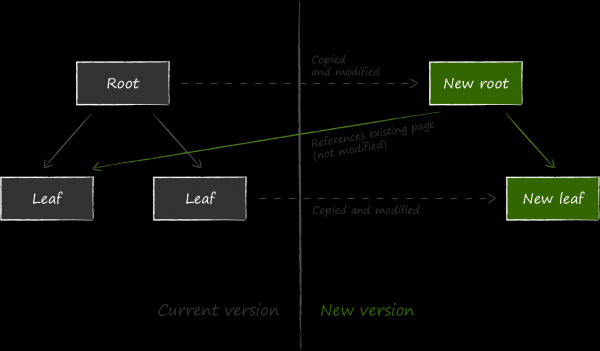
Aby byla aktualizovaná data k dispozici, je nutné změnit odkaz na aktuální uzel v rodičovském uzlu. Protože je také třeba ho modifikovat, musí být nejdříve také zkopírován. Proces pokračuje rekurzivně až k samotnému kořeni. Poslední změny se provádějí na meta-stránce.
Pokud během procesu aktualizace dojde k neočekávanému ukončení, nová meta-stránka se buď nevytvoří, nebo nebude zapsána na disk až do konce, a její kontrolní součet bude nesprávný. V obou těchto případech budou nové stránky nedostupné, zatímco staré nebudou poškozeny. To zbavuje LMDB nutnosti vést write ahead log pro udržení konzistence dat. De-facto struktura ukládání dat na disku, popsaná výše, současně plní i tuto funkci. Nepřítomnost transakčního logu v jasné podobě je jedním z rysů LMDB, který zajišťuje vysokou rychlost čtení dat.
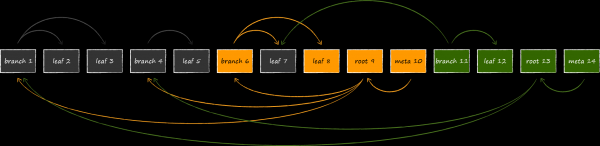
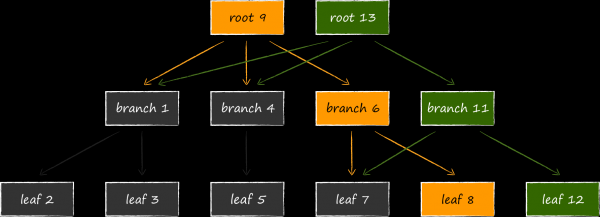
Výsledná konstrukce nazvaná append-only B-tree přirozeně zajišťuje izolaci transakcí a multiverznost. V LMDB je s každou otevřenou transakcí spojena aktuální kořen stromu. Dokud není transakce dokončena, stránky související s tímto stromem nebudou nikdy změněny ani znovu použity pro nové verze dat. Takto lze pracovat neomezeně dlouho pouze s tím souborem dat, který byl aktuální v okamžiku otevření transakce, i když úložiště v tuto dobu aktivně pokračuje v aktualizaci. To je podstatou multiverznosti, která činí LMDB ideálním zdrojem dat pro nás všechny oblíbené. UICollectionViewOtevřením transakce není třeba zvyšovat paměťovou náročnost aplikace, rychle vyčerpávající aktuální data v nějaké in-memory struktuře, ze strachu, že zůstaneme s prázdnýma rukama. Tato vlastnost výrazně odlišuje LMDB od SQLite, který takovou úplnou izolací pochlubit nemůže. Otevřením dvou transakcí v posledně zmíněném a odstraněním určitého záznamu v rámci jedné z nich, tento záznam již nelze získat ani v rámci druhé zbývající.
Rubem třetích stran ohrožuje potenciálně výrazně vyšší spotřebu virtuální paměti. Na snímku je zobrazeno, jak bude vypadat struktura databáze, pokud dojde k její modifikaci současně se třemi otevřenými transakcemi pro čtení, které se dívají na různé verze databáze. Protože LMDB nemůže znovu použít uzly dosažitelné z kořenů spojených s aktuálními transakcemi, úložišti nezbývá nic jiného, než umístit do paměti další čtvrtý kořen a znovu klonovat modifikovatelné stránky.
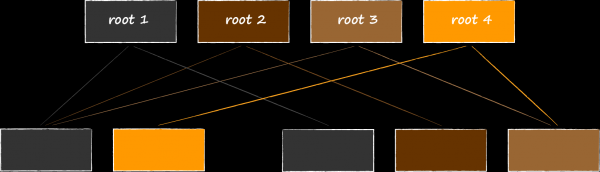
Zde není na škodu vzpomenout na sekci o souborech mapovaných do paměti. Zdá se, že další spotřeba virtuální paměti by nás nemusela příliš trápit, protože nepřispívá k paměťové stopě aplikace. Nicméně bylo zjištěno, že iOS je velmi skoupý na její přidělování a nemůžeme jako na serveru nebo desktopu bezstarostně poskytnout LMDB region o velikosti 1 terabajt a na tuto vlastnost vůbec nemyslet. Je třeba se snažit udržet dobu trvání transakcí co nejsvnější.
4. Navrhování datového schématu nad rozhraním key-value API
Rozbor API zahájíme pohledem na základní abstrakce poskytované LMDB: prostředí a databáze, klíče a hodnoty, transakce a kurzory.
Poznámka k výpisům kódu
Všechny funkce v veřejném API LMDB vracejí výsledek své činnosti ve formě kódu chyby, ale v následujících výpisech je kontrola opomenuta ve prospěch stručnosti. V praxi jsme i pro interakci s úložištěm používali svůj C++ wrapper , ve kterém se chyby materializují ve formě C++ výjimek.
Jako nejrychlejší způsob, jak připojit LMDB k projektu pro iOS nebo macOS, navrhuji svůj CocoaPod .
4.1. Základní abstrakce
Prostředí (environment)
Struktura MDB_env je úložištěm vnitřního stavu LMDB. Rodina funkcí s prefixem mdb_env umožňuje konfigurovat některé jeho vlastnosti. V nejjednodušším případě vypadá inicializace motoru následujícím způsobem.
mdb_env_create(env);
mdb_env_set_map_size(*env, 1024 * 1024 * 512)
mdb_env_open(*env, path.UTF8String, MDB_NOTLS, 0664);V aplikaci OblaMail.ru jsme měnili výchozí hodnoty pouze u dvou parametrů.
Prvním z nich je velikost virtuálního adresního prostoru, na který se mapuje úložiště. Bohužel i na stejném zařízení se konkrétní hodnota může výrazně lišit od spuštění ke spuštění. Abychom zohlednili tuto zvláštnost iOS, maximální velikost úložiště nastavujeme dynamicky. Začínáme s určitou hodnotou a postupně ji dělíme na polovinu, dokud funkce mdb_env_open nevrátí výsledek jiný než ENOMEM. Teoreticky existuje také opačný přístup — nejprve alokovat minimální množství paměti pro engine a poté, při chybách, ji zvyšovat. Tento postup je však mnohem složitější. Důvodem je, že procedura opětovného mapování paměti (remap) pomocí funkce MDB_MAP_FULLmdb_env_set_map_size invaliduje všechny entity (kurzory, transakce, klíče a hodnoty), které byly dříve získány od enginu. Zohlednění této situace v kódu by výrazně zkomplikovalo jeho strukturu. Pokud je však virtuální paměť pro vás velmi důležitá, mohl by to být důvod k prozkoumání pokročilého forku, kde mezi deklarovanými funkcemi je „automatické přizpůsobení velikosti databáze za běhu“. Druhý parametr, jehož výchozí hodnota nám nevyhovovala, reguluje mechaniku zajištění thread safety. Bohužel minimálně v iOS 10 existují problémy s podporou thread local storage. Z tohoto důvodu je v příkladu výše úložiště otevřeno s flagem
MDB_NOTLS . Kromě toho bylo zapotřebí takéforkovat , abychom odstranili proměnné s tímto atributem i v něm. Databáze představuje samostatnou instanci B-stromu, o kterém jsme hovořili výše. Její otevření probíhá uvnitř transakce, což se na první pohled může zdát poněkud zvláštní.
Databáze
MDB_txn *txn; MDB_dbi dbi; mdb_txn_begin(env, NULL, MDB_RDONLY, &txn); mdb_dbi_open(txn, NULL, MDB_CREATE, &dbi); mdb_txn_abort(txn);
Skutečně, transakce v LMDB je entitou úložiště, nikoli konkrétní databáze. Tento koncept umožňuje provádět atomární operace nad entitami nacházejícími se v různých databázích. Teoreticky to otvírá možnost modelování tabulek jako různých databází, ale já jsem se v té době vydal jinou cestou, která je podrobně popsána níže.Klíče a hodnoty
MDB_val
Struktura MDB_val modeluje koncept klíče i hodnoty. Sklad nemá žádné znalosti o jejich semantice. Pro něj je cokoliv jiného než jen pole bytů dané velikosti. Maximální velikost klíče je 512 bytů.
typedef struct MDB_val {
size_t mv_size;
void *mv_data;
} MDB_val;Pomocí komparátoru sklad seřazuje klíče vzestupně. Pokud nebude nahrazen vlastním, použije se výchozí, který je třídí po bytech v lexikografickém pořadí.
Transakce
Zařízení transakcí je podrobně popsáno v , proto zde krátce zopakuji jejich hlavní vlastnosti:
- Podpora všech základních vlastností : atomární, konzistentní, izolované a spolehlivé. Musím zmínit, že v části durability na macOS a iOS existuje chyba, která byla opravena v MDBX. Více se můžete dočíst v jejich .
- Přístup k vícetránkování je popsán schématem „jeden zapisovatel / více čtenářů“. Zapisovatelé si vzájemně blokují přístup, ale neblokují čtenáře. Čtenáři neblokují ani zapisovatele, ani sebe navzájem.
- Podpora vnořených transakcí.
- Podpora vícenásobné verze.
Vícenásobná verze v LMDB je natolik skvělá, že ji chci demonstrovat v akci. Z níže uvedeného kódu je vidět, že každá transakce pracuje výhradně s tou verzí databáze, která byla aktuální v okamžiku jejího otevření, a je zcela izolována od všech následných změn. Inicializace skladu a přidání testovacího záznamu nepředstavují nic zajímavého, a proto byly tyto rituály ponechány pod spoilerem.
Přidání testovacího záznamu
MDB_env *env;
MDB_dbi dbi;
MDB_txn *txn;

mdb_env_create(&env);
mdb_env_open(env, ".\/testdb", MDB_NOTLS, 0664);

mdb_txn_begin(env, NULL, 0, &txn);
mdb_dbi_open(txn, NULL, 0, &dbi);
mdb_txn_abort(txn);

char k = 'k';
MDB_val key;
key.mv_size = sizeof(k);
key.mv_data = (void *)&k;

int v = 997;
MDB_val value;
value.mv_size = sizeof(v);
value.mv_data = (void *)&v;

mdb_txn_begin(env, NULL, 0, &txn);
mdb_put(txn, dbi, &key, &value, MDB_NOOVERWRITE);
mdb_txn_commit(txn);
MDB_txn *txn1, *txn2, *txn3;
MDB_val val;
// Otevření 2 transakcí, z nichž každá se dívá
// na verzi databáze s jedním záznamem.
mdb_txn_begin(env, NULL, 0, &txn1); // read-write
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn2); // read-only
// V rámci první transakce odstraníme z databáze existující záznam.
mdb_del(txn1, dbi, &key, NULL);
// Potvrdíme odstranění.
mdb_txn_commit(txn1);
// Otevření třetí transakce, která se dívá na
// aktuální verzi databáze, kde záznam již neexistuje.
mdb_txn_begin(env, NULL, MDB_RDONLY, &txn3);
// Ujistíme se, že záznam podle hledaného klíče již neexistuje.
assert(mdb_get(txn3, dbi, &key, &val) == MDB_NOTFOUND);
// Ukončujeme transakci.
mdb_txn_abort(txn3);
// Ujistíme se, že v rámci druhé transakce, otevřené v době
// existence záznamu v databázi, je stále možné jej najít podle klíče.
assert(mdb_get(txn2, dbi, &key, &val) == MDB_SUCCESS);
// Kontrolujeme, že podle klíče jsme získali validní data.
assert(*(int *)val.mv_data == 997);
// Ukončujeme transakci, pracující s i když zastaralou, ale konzistentní databází.
mdb_txn_abort(txn2);Doporučuji pokusit se o podobný trik se SQLite a uvidíte, co se stane.
Víceverzionnost přináší do života iOS vývojáře velmi příjemné výhody. Pomocí této vlastnosti lze snadno a pohodlně regulovat rychlost aktualizace zdroje dat (data source) pro obrazové formuláře, vycházející z hlediska uživatelské zkušenosti. Pro příklad vezměme takovou funkci aplikace OblaCloud Mail.ru, jako je automatické načítání obsahu z systémové mediální galerie. Při dobrém připojení je klient schopen nahrávat na server několik fotografií za sekundu. Pokud po každém nahrání aktualizujeme UICollectionView mediální obsah v cloudu uživatele, můžeme zapomenout na 60 fps a plynulé rolování během tohoto procesu. Aby se zabránilo častým aktualizacím obrazovky, je nutné nějak omezit rychlost změny dat na pozadí. UICollectionViewDataSource.
Pokud databáze nepodporuje multiverznost a umožňuje pracovat pouze se současným aktuálním stavem, je pro vytvoření stabilního snapshotu údajů nutné jej zkopírovat buď do nějaké in-memory datové struktury, nebo do dočasné tabulky. Obě tyto metody jsou velmi nákladné. V případě in-memory úložiště máme náklady na paměť spojené se skladováním konstruovaných objektů, a také s časovými náklady spojenými s nadbytečnými ORM transformacemi. Co se týče dočasné tabulky, to je ještě dražší potěšení, které dává smysl pouze v netradičních případech.
Multiverznost LMDB elegantně řeší problém udržení stabilního zdroje dat. Stačí jednoduše otevřít transakci a voilà — dokud ji neuzavřeme, máme data garantována. Logika rychlosti jeho aktualizace je nyní zcela v rukou prezentační vrstvy, s naprosto zanedbatelnými náklady na významné zdroje.
Kurzy
Kurzy poskytují mechanismus pro uspořádané iterování přes páry klíč-hodnota prostřednictvím procházení B-stromu. Bez nich by nebylo možné efektivně modelovat tabulky v databázi, ke kterým se nyní přechází.
4.2. Modelování tabulek
Vlastnost uspořádanosti klíčů umožňuje konstruovat nad základními abstrakcemi takovou vysoce úrovňovou strukturu, jako je tabulka. Podívejme se na tento proces na příkladu hlavní tabulky cloudového klienta, ve které je uložena informace o všech souborech a složkách uživatele.
Schéma tabulky
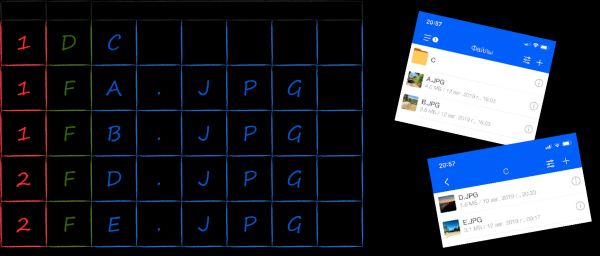
Jedním z častých scénářů, pro který by měla být struktura tabulky s adresářovým stromem přizpůsobena, je výběr všech prvků nacházejících se uvnitř zadaného adresáře. Dobrou modelovou organizací dat pro efektivní dotazy takového druhu je . Pro její implementaci nad key-value úložištěm je nutné seřadit klíče souborů a složek tak, aby byly seskupeny na základě příslušnosti k nadřazenému adresáři. Dále, aby bylo možné zobrazit obsah adresáře v běžném zobrazení pro uživatele Windows (nejprve složky, pak soubory, přičemž obě jsou seřazeny abecedně), je nutné do klíče zahrnout příslušná další pole.
Na obrázku níže je uvedeno, jak může vypadat zobrazení klíčů jako pole bytů na základě zadaného úkolu. Nejdříve jsou umístěny byty s identifikátorem rodičovského adresáře (červené), poté s typem (zelené) a nakonec se jménem (modré). Když jsou seřazené výchozím komparátorem LMDB v lexikografickém pořadí, jsou uspořádány požadovaným způsobem. Sekvenční procházení klíčů se stejným červeným prefixem nám dává související hodnoty v pořadí, v jakém by měly být zobrazeny v uživatelském rozhraní (vpravo), bez potřeby dodatečné postprocessing.
Serializace klíčů a hodnot
Na světě bylo vymyšleno mnoho metod serializace objektů. Protože naším jediným požadavkem byla rychlost, zvolili jsme pro sebe nejrychlejší možnou volbu — dump paměti, kterou zaujímá instance struktury jazyka C. Takto lze klíč prvku adresáře modelovat následující strukturou NodeKey.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Pro uložení NodeKey v úložišti je třeba umístit ukazatel na data na adresu začátku struktury a velikost vypočítat funkcí MDB_val sizeof MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; }.
V první kapitole o kritériích výběru databáze jsem jako důležitý faktor výběru zmínil minimalizaci dynamických alokací během operací CRUD. Kód funkceserialize ukazuje, jak je možné v případě LMDB zcela se vyhnout při vkládání nových záznamů do databáze dynamickým alokacím. Přijaté pole bytů ze serveru je nejprve transformováno na zásobníkové struktury a poté jsou triviálně dumpovány do úložiště. Vzhledem k tomu, že v LMDB také nejsou žádné dynamické alokace, lze dosáhnout fantastické situace z hlediska iOS — využít k práci s daty na celé jejich cestě od sítě k disku pouze zásobníkovou paměť! Uspořádání klíčů binárním komparátorem
Uspořádání klíčů binárním komparátorem
Pořadí klíčů se určuje speciální funkcí nazývanou komparátor. Protože motor neví nic o semantice bajtů, které obsahují, defaultní komparátor nemá jinou možnost, než seřadit klíče lexikograficky pomocí jejich porovnání po bajtech. Používat jej pro řazení struktur je něco jako holení s pily. Přesto v jednodušších případech považuji tento způsob za přijatelný. Alternativa je popsána níže, ale zde zmíním pár nástrah na této cestě.
První, na co je třeba myslet, je reprezentace primitivních datových typů v paměti. Na všech Apple zařízeních jsou celočíselné proměnné uloženy ve formátu . To znamená, že nejméně významný bajt bude na vlevo, a seřadit celá čísla pomocí jejich porovnání po bajtech nebude možné. Například pokus se to provést se sadou čísel od 0 do 511 povede k následujícímu výsledku.
// value (hex dump)
000 (0000)
256 (0001)
001 (0100)
257 (0101)
...
254 (fe00)
510 (fe01)
255 (ff00)
511 (ff01)
Abychom tento problém vyřešili, musí být celá čísla uložena v klíči v formátu, který vyhovuje bajtovému komparátoru. Potřebné převody pomohou funkce z rodiny hton* (zejména htons pro dvoubajtová čísla z příkladu).
Formát reprezentace řetězců v programování je, jak známo, celá věda. Pokud semantika řetězců a také použité kódování pro jejich reprezentaci v paměti předpokládá, že na symbol může připadat více než jeden bajt, je lepší hned se vzdát myšlenky na použití defaultního komparátoru. Druhá věc, na kterou je třeba myslet —
principy zarovnání packed Řazení klíčů externím komparátorem.
Logika porovnávání klíčů může být příliš složitá pro binární komparátor. Jedním z mnoha důvodů je existence technických polí uvnitř struktur. Ilustruji jejich vznik na příkladu již známého klíče pro prvek adresáře.
Logika porovnávání klíčů může být příliš složitá pro binární komparátor. Jedním z mnoha důvodů je přítomnost technických polí uvnitř struktur. Ilustruji jejich vznik na příkladu již známého klíče pro prvek adresáře.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameBuffer[256];
} NodeKey;Ačkoliv je velmi jednoduchý, většinou spotřebovává příliš mnoho paměti. Vyrovnávací paměť na název zabírá 256 bajtů, přičemž průměrné názvy souborů a složek zřídka přesahují 20-30 znaků.
Jednou ze standardních metod optimalizace velikosti záznamu je jeho "oříznutí" na skutečnou velikost. Podstata spočívá v tom, že obsah všech proměnných délky se ukládá do vyrovnávací paměti na konci struktury, zatímco jejich délky jsou uloženy v samostatných proměnných. V souladu s tímto přístupem se klíč NodeKey transformuje následujícím způsobem.
typedef struct NodeKey {
EntityId parentId;
uint8_t type;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeKey;Dále při serializaci je jako velikost dat uvedena nikoli MDB_val serialize(NodeKey * const key) { return MDB_val { .mv_size = sizeof(NodeKey), .mv_data = (void *)key }; } celé struktury, ale velikost všech polí s pevných délkou plus velikost skutečně používané části vyrovnávací paměti.
MDB_val serialize(NodeKey * const key) {
    return MDB_val {
        .mv_size = offsetof(NodeKey, nameBuffer) + key->nameLength,
        .mv_data = (void *)key
    };
}
Jako výsledek provedeného refaktoringu jsme získali značnou úsporu místa zabraného klíči. Nicméně z důvodu technického pole nameLength, výchozí binární komparátor již více nevyhovuje pro porovnávání klíčů. Pokud jej nenahradíme vlastním, délka názvu bude prioritnějším faktorem při třídění než samotný název.
LMDB umožňuje každé databázi nastavit vlastní funkci porovnávání klíčů. To se provádí pomocí funkce mdb_set_compare přísně před otevřením. Zřejmě z jasných důvodů ji nelze během života databáze měnit. Jako vstup do komparátoru se dostanou dva klíče ve svém binárním formátu a na výstupu vrátí výsledek porovnání: menší (-1), větší (1) nebo rovny (0). Pseudokód pro NodeKey vypadá takto.
int compare(MDB_val * const a, MDB_val * const b) {
NodeKey * const aKey = (NodeKey * const)a->mv_data;
NodeKey * const bKey = (NodeKey * const)b->mv_data;
return // ...
}Pokud mají všechny klíče v databázi stejný typ, je absolutní převod jejich bajtové reprezentace na typ aplikační struktury klíče legitimní. Existuje však jeden nuance, která bude probrána níže v pododdílu "Čtení záznamů".
Serializace hodnot
S klíči uložených záznamů LMDB pracuje extrémně intenzivně. Jejich vzájemné porovnávání se provádí v rámci jakékoliv aplikační operace a od rychlosti komparátoru závisí výkon celého řešení. V ideálním světě by pro porovnávání klíčů měl stačit výchozí binární komparátor, ale pokud musíte použít svůj vlastní, pak by postup deserializace klíčů měl být co nejrychlejší.
Hodnotovou částí záznamu (value) se databáze zvlášť nezabývá. Její převod z byteového formátu na objekt se provádí pouze tehdy, když to aplikační kód skutečně vyžaduje, například pro zobrazení na obrazovce. Vzhledem k tomu, že k tomu dochází relativně zřídka, nejsou požadavky na rychlost tohoto postupu tak kritické a při jeho implementaci jsme ve velké míře svobodní orientovat se na pohodlí. Například pro serializaci metadat o ještě nenačtených souborech používáme NSKeyedArchiver.
NSData *data = serialize(object);
MDB_val value = {
.mv_size = data.length,
.mv_data = (void *)data.bytes
};Nicméně se občas stávají případy, kdy výkon skutečně má význam. Například při ukládání metainformací o struktuře složek uživatelského cloudu využíváme stále ten samý dump paměti objektů. Zajímavostí úkolu při vytváření jejich serializovaného zobrazení je fakt, že prvky adresáře jsou modelovány hierarchií tříd.
Pro její implementaci v jazyce C jsou specifická pole dědiců umístěna do samostatných struktur a jejich vazba na základní je nastavena prostřednictvím pole typu union. Aktuální obsah unie je určen technickým atributem type.
typedef struct NodeValue {
EntityId localId;
EntityType type;
union {
FileInfo file;
DirectoryInfo directory;
} info;
uint8_t nameLength;
uint8_t nameBuffer[256];
} NodeValue;Přidání a aktualizace záznamů
Serializované klíč a hodnota lze přidávat do úložiště. K tomu se používá funkce mdb_put.
// key и value имеют тип MDB_val
mdb_put(..., &key, &value, MDB_NOOVERWRITE);V době konfigurace úložiště lze povolit nebo zakázat ukládání více záznamů se stejným klíčem. Pokud je duplikace klíčů zakázána, při vložení záznamu lze určit, zda je možné aktualizovat už existující záznam. Pokud přepsání může nastat pouze v důsledku chyby v kódu, lze se proti němu chránit nastavením příznaku NOOVERWRITE.
Čtení záznamů
Pro čtení záznamů v LMDB je určena funkce mdb_get. Pokud je pár klíč-hodnota již zastoupen předchozím dumpovanými strukturami, vypadá tento postup následujícím způsobem.
NodeValue * const readNode(..., NodeKey * const key) {
    MDB_val rawKey = serialize(key);
    MDB_val rawValue;
    mdb_get(..., &rawKey, &rawValue);
    return (NodeValue * const)rawValue.mv_data;
}
Předložený výpis ukazuje, jak serializace přes dumpování struktur umožňuje zbavit se dynamických alokací nejen při zápisu, ale i při čtení dat. Ukazatel získaný z funkce mdb_get ukazuje přesně na tu adresu virtuální paměti, kde databáze uchovává bajtové zobrazení objektu. Ve skutečnosti máme takřka ORM, které prakticky zdarma zajišťuje velmi vysokou rychlost čtení dat. Přes krásu tohoto přístupu je třeba pamatovat na několik souvisejících vlastností.
- Pro readonly transakci zůstane ukazatel na strukturu-hodnotu zaručeně platný pouze do chvíle, než bude transakce uzavřena. Jak bylo uvedeno dříve, stránky B-stromu, na kterých se nachází objekt, díky principu copy-on-write zůstávají nezměněny, dokud na ně odkazuje alespoň jedna transakce. Na druhou stranu, jakmile poslední související transakce skončí, mohou být stránky znovu použity pro nová data. Pokud je nutné, aby objekty přežily transakci, která je vytvořila, bude je potřeba zkopírovat.
- Pro readwrite transakci bude ukazatel na získanou strukturu-hodnotu platný pouze do prvního modifikujícího úkonu (zápis nebo odstranění dat).
- I když struktura
NodeValuenení plnohodnotná, ale oříznutá (viz podsekce „Usměrňování klíčů externím komparátorem“), přes ukazatel lze v klidu přistupovat k jejím polím. Hlavně ho neod dereferencovat! - V žádném případě nelze modifikovat strukturu přes získaný ukazatel. Všechny změny by měly být prováděny pouze prostřednictvím metody
mdb_put. Nicméně, i kdybyste se o to snažili, nebude to možné, protože oblast paměti, kde se tato struktura nachází, je mapována v režimu readonly. - Remapování souboru do adresního prostoru procesu za účelem, například, zvýšení maximální velikosti úložiště pomocí funkce
invaliduje všechny entity (kurzory, transakce, klíče a hodnoty), které byly dříve získány od enginu. Zohlednění této situace v kódu by výrazně zkomplikovalo jeho strukturu. Pokud je však virtuální paměť pro vás velmi důležitá, mohl by to být důvod k prozkoumání pokročilého forku,zcela invaliduje všechny transakce a s nimi spojené entity obecně a ukazatele na přečtené objekty konkrétně.
Nakonec, další vlastnost je natolik zrádná, že rozkrytí její podstaty se prostě nevejde do dalšího bodu. V kapitole o B-stromu jsem uvedl schéma uspořádání jeho stránek v paměti. Z ní vyplývá, že adresa začátku bufferu se serializovanými daty může být zcela libovolná. Kvůli tomu ukazatel na ně, získaný ve struktuře MDB_val a převedený na ukazatel na strukturu, se v obecné rovině stává nevyrovnaným. Zároveň architektury některých čipů (v případě iOS je to armv7) vyžadují, aby adresa jakýchkoli dat byla dělitelná velikostí strojového slova, nebo jinými slovy, bitnosti systému (pro armv7 — to je 32 bitů). Jinými slovy, operace jako *(int *foo)0x800002 je považována za únik a vede k rozsudku EXC_ARM_DA_ALIGN. Tomu lze předejít dvěma způsoby.
První spočívá v předchozím kopírování dat do předem vyrovnané struktury. Například, na vlastním komparátoru to bude mít následující podobu.
int compare(MDB_val * const a, MDB_val * const b) {
    NodeKey aKey, bKey;
    memcpy(&aKey, a->mv_data, a->mv_size);
    memcpy(&bKey, b->mv_data, b->mv_size);
    return // ...
}
Alternativní cesta — předem informovat kompilátor, že struktury s klíčem a hodnotou mohou být nevyrovnané pomocí atributu aligned(1). Na ARM lze stejný efekt dosáhnout zvyšuje náklady na operace přístupu k datům. typedef struct __attribute__((packed)) NodeKey { uint8_t parentId; uint8_t type; uint8_t nameLength; uint8_t nameBuffer[256]; } NodeKey;
Rozsahové dotazyRange-zap requests
Pro iteraci po skupině záznamů v LMDB je k dispozici abstrakce kurzoru. O tom, jak s ním pracovat, se podíváme na příkladu již známé tabulky s metadaty uživatelského cloudu.
V rámci zobrazení seznamu souborů v adresáři je nutné najít všechny klíče, se kterými jsou asociovány jeho podřízené soubory a složky. V předchozích podkapitolách jsme řadili klíče NodeKey tak, aby byly nejprve seřazeny podle identifikátoru nadřazeného adresáře. Takže technicky úkol získání obsahu složky spočívá v nastavení kurzoru na horní hranici skupiny klíčů se zadaným prefixem s následnou iterací až k dolní hranici.
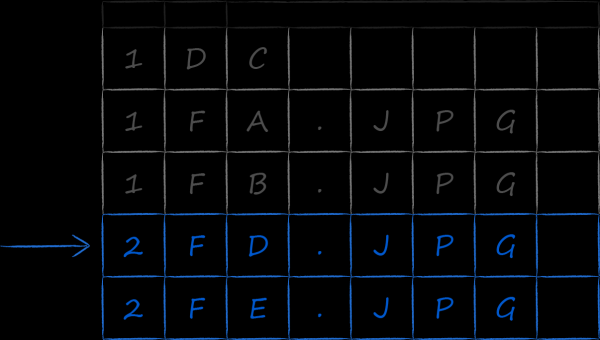
Horní hranici lze najít "přímo" sekvenčním hledáním. K tomu se kurzor nastaví na začátek celého seznamu klíčů v databázi a poté se inkrementuje, dokud pod ním není klíč s identifikátorem nadřazeného adresáře. Tento přístup má 2 zjevné nevýhody:
- Lineární složitost hledání, přičemž, jak je známo, v stromech obecně a v B-stromech konkrétně lze to provést logaritmickým časem.
- Zbytečně se načítají ze souboru do hlavní paměti všechny stránky předcházející hledanému, což je velmi nákladné.
Naštěstí v API LMDB je k dispozici efektivní způsob počátečního umístění kurzoru. K tomu je třeba vytvořit takový klíč, jehož hodnota bude zaručeně menší nebo rovna klíči, který se nachází na horní hranici intervalu. Například ve vztahu k seznamu na výše uvedeném obrázku můžeme vytvořit takový klíč, ve kterém pole parentId bude rovno 2, a všechna ostatní budou vyplněna nulami. Takový částečně vyplněný klíč bude podán jako vstup do funkce mdb_cursor_get s uvedením operace MDB_SET_RANGE.
NodeKey upperBoundSearchKey = {
.parentId = 2,
.type = 0,
.nameLength = 0
};
MDB_val value, key = serialize(upperBoundSearchKey);
MDB_cursor *cursor;
mdb_cursor_open(..., &cursor);
mdb_cursor_get(cursor, &key, &value, MDB_SET_RANGE);Pokud je horní hranice skupiny klíčů nalezena, pak dále iterujeme po ní, dokud nenarazíme buď na klíč s jiným parentId, nebo dokud klíče vůbec neskončí.
do {
rc = mdb_cursor_get(cursor, &key, &value, MDB_NEXT);
// zpracování...
} while (MDB_NOTFOUND != rc && // zkontrolovat konec tabulky
IsTargetKey(key)); // zkontrolovat konec skupiny klíčůCo je příjemné, v rámci iterace pomocí mdb_cursor_get získáváme nejen klíč, ale i hodnotu. Pokud je pro splnění podmínek dotazu potřeba zkontrolovat i pole z value části záznamu, jsou zcela dostupná bez dalších komplikací.
4.3. Modelování vztahů mezi tabulkami
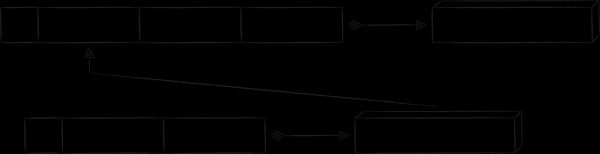
Do současného okamžiku se nám podařilo prozkoumat všechny aspekty návrhu a práce s jednatabulkovou databází. Lze říci, že tabulka je soubor seřazených záznamů skládajících se z homogenních párů klíč-hodnota. Pokud zobrazíme klíč jako obdélník a jeho související hodnotu jako kvádr, získáme vizuální schéma databáze.

Nicméně v reálném životě se jen zřídka podaří obejít takto malými náklady. Často je v databázi zapotřebí, za prvé, mít několik tabulek, a za druhé, provádět výběry v pořadí odlišném od primárního klíče. Těmto otázkám vytváření a vzájemného provazování tabulek se věnuje tato poslední kapitola.
Indexové tabulky
V cloudové aplikaci existuje sekce „Galerie“. V ní je zobrazen mediální obsah z celého cloudu, seřazený podle data. Pro optimální realizaci takového výběru je vedle hlavní tabulky potřeba vytvořit další tabulku s novým typem klíčů. Tyto klíče budou zahrnovat pole s datem vytvoření souboru, které bude sloužit jako primární kritérium pro řazení. Vzhledem k tomu, že nové klíče odkazují na tažná data jako klíče v hlavní tabulce, nazývají se indexovými. Na obrázku níže jsou zvýrazněny oranžovou barvou.
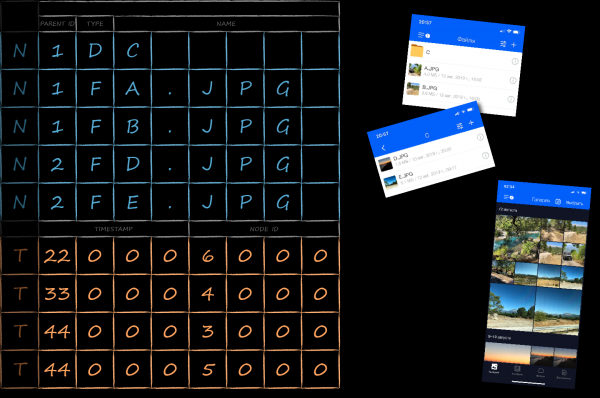
Abychom uvnitř jedné databáze oddělili klíče různých tabulek, bylo jim všem přidáno další technické pole tableId. Pokud jej učiníme nejprioritnějším pro sortování, dosáhneme seskupení klíčů nejprve podle tabulek a už uvnitř tabulek podle vlastních pravidel.
Indexový klíč odkazuje na tažná data jako primární. Přímočará realizace této vlastnosti prostřednictvím asociace s kopií value části primárního klíče není efektivní z více hledisek.
- Z hlediska zabraného prostoru, protože metadata mohou být velmi bohatá.
- Z hlediska výkonu, protože při aktualizaci metadat bude třeba provádět zápis na dvou klíčích.
- Z pohledu podpory kódu, jakmile zapomeneme aktualizovat údaje u jednoho z klíčů, obdržíme těžko odhalitelnou chybu nekonzistence údajů ve skladu.
Dále se podíváme, jak tyto nedostatky eliminovat.
Organizace vazeb mezi tabulkami
Pro spojení indexové tabulky s hlavní tabulkou se dobře hodí vzor „klíč jako hodnota“. Jak název napovídá, jako část value indexového záznamu slouží kopie hodnoty primárního klíče. Tento přístup eliminuje všechny výše uvedené nedostatky spojené s uchováváním kopie value části primárního záznamu. Jedinou nevýhodou je, že pro získání hodnoty podle indexového klíče je potřeba provést 2 dotazy na databázi místo jednoho. Schématicky získaná struktura databáze vypadá takto.
Dalším vzorem organizace vazeb mezi tabulkami je „nadbytečný klíč“. Jeho podstata spočívá v přidání dodatečných atributů do klíče, které nejsou potřeba pro třídění, ale pro rekonstrukci propojeného klíče. V aplikaci Oblačnosti Mail.ru existují skutečné příklady jeho použití, nicméně, abych se vyhnul hlubokému ponoření do kontextu specifických iOS rámců, uvedu výmysl, ale zato jasnější příklad.
V cloudových mobilních klientech existuje stránka, kde se zobrazují všechny soubory a složky, ke kterým uživatel poskytl přístup jiným lidem. Protože takových souborů je relativně málo, ale různých specifických informací o jejich veřejnosti je mnoho (komu byl poskytnut přístup, s jakými právy atd.), nebude rozumné zatěžovat value část záznamu v hlavní tabulce. Pokud však chceme tyto soubory zobrazit offline, je nutné je někde uchovávat. Přirozeným řešením je vytvoření samostatné tabulky. Na schématu níže má její klíč prefix „P“ a placeholder „propname“ může být nahrazen konkrétnější hodnotou „veřejné informace“.
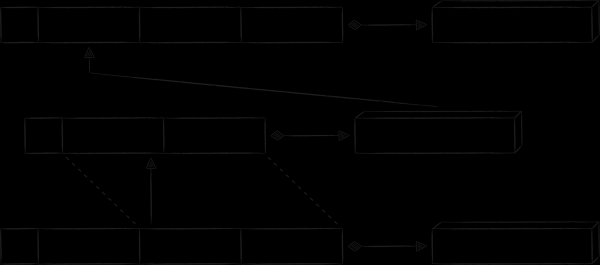
Veškerá unikátní metadata, pro jejichž uchovávání byla zřízena nová tabulka, jsou uvedena ve value části záznamu. Zároveň bychom nechtěli duplicovat data o souborech a složkách, která již jsou uložena v hlavní tabulce. Místo toho jsou do klíče „P“ přidána redundantní data v podobě polí „node ID“ a „timestamp“. Díky nim lze konstruovat indexový klíč, podle něhož získat primární klíč, a konečně tak získat metadata uzlu.
Závěr
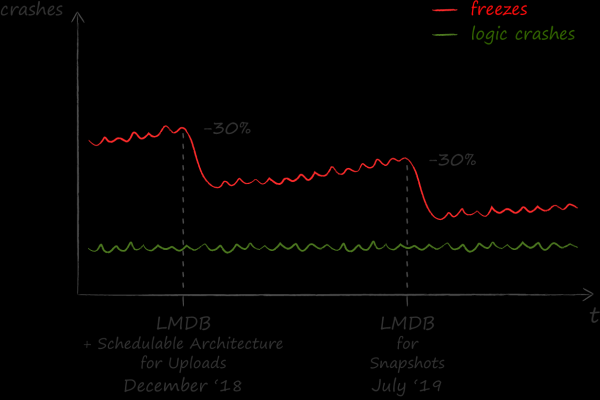
Výsledky implementace LMDB hodnotíme pozitivně. Po jeho zavedení klesl počet zatuhnutí aplikace o 30%.
Výsledky vykonané práce zaznamenaly odezvu i mimo tým iOS. V současné době se jeden z hlavních oddílů „Soubory“ v aplikaci pro Android také přešel na použití LMDB a další části jsou na cestě. Jazyk C, ve kterém je implementováno key-value úložiště, byl dobrou oporou pro původní vybudování aplikačního obalu okolo něj multiplatformně v jazyce C++. Pro bezproblémové propojení vzniklé C++ knihovny s platformním kódem v Objective-C a Kotlin byl použit generátor kódu. od Dropboxu, ale to je už úplně jiný příběh.
Zdroj: habr.com
