

Kapacitní úroveň (nebo jak ji nazýváme interně, kaptir) byla představena již v době Veeam Backup and Replication 9.5 Update 4 pod názvem Archivní úroveň. Jejím cílem je umožnit přesun záloh, které překročily takzvané okno pro obnovu, na objektové úložiště. To pomáhá uvolnit diskový prostor uživatelům, kteří ho mají nedostatek. Tato možnost se nazývá Move Mode.
K provedení této jednoduché (jak se zdá) akce stačilo splnit dvě podmínky: všechny body z přesouvané zálohy musí být za hranicemi výše zmíněného okna pro obnovu, které je v UI explicitně nastaveno. A druhé: řetězec musí být v takzvaném «zap sealed» (sealed backup chain nebo Inactive Backup Chain). To znamená, že v tomto řetězci během času nedochází k žádným změnám.
Ale ve VBR v10 byla koncepce doplněna o nové funkce - vznikl Copy Mode, Sealed Mode a mechanismus se složitým názvem Immutability.
O těchto fascinujících věcech si dnes budeme povídat. Nejprve o tom, jak to fungovalo ve VBR9.5u4, a poté o změnách v desáté verzi.
A ať mi prominou zastánci čistého jazyka, ale příliš mnoho termínů není možné přeložit.
Takže tady bude hromada anglicismů.
A spousta gifů.
A obrázků.
- Bez jakýchkoliv výčitek. Autor článku.
Jak bylo
Tak co, začneme rozborem okna pro obnovu a sealed backup (nebo jak se v dokumentaci nazývá Inactive Backup Chain). Bez jejich pochopení nelze pokračovat s dalším vysvětlením.
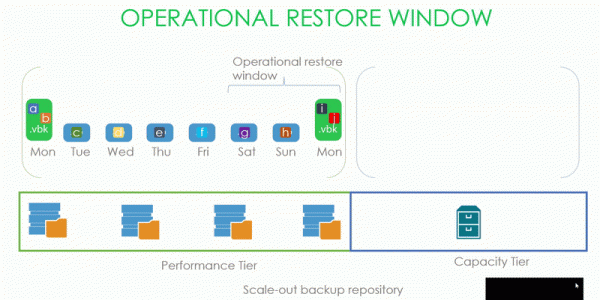
Jak vidíme na obrázku, máme nějaký záložní řetězec s datovými bloky, který se nachází na Performance tier SOBR úložiště, k němuž je připojen Kapacitní Tier. Naše okno pro operativní zálohu činí tři dny.
Příslušně, záloha vytvořená v pondělí .vbk uzavírá předchozí řetězec, jehož okno je nastaveno na tři dny. A to znamená, že lze bez obav začít převážet do kapacitní úrovně vše, co je starší než tyto tři dny.
Ale co se přesně rozumí pod sealed řetězcem a co mohlo být odesláno do kapacitní úrovně v update 4?
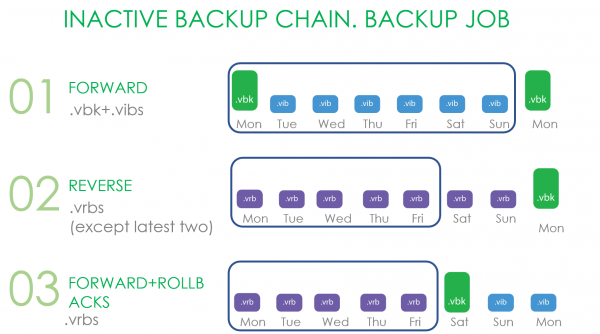
Pro Forward Incremental je znakem uzavření řetězce vytvoření nové plné zálohy. A nezáleží na tom, jak je tato plná záloha získána: zahrnují se jak syntetické plné, tak aktivní plné zálohy.
V případě Reverse to jsou všechny soubory, které nepatří do operačního okna.
V případě Forward increment s roll-backy se všechny roll-backy a .vbk, pokud na performance extentu existuje další .vbk
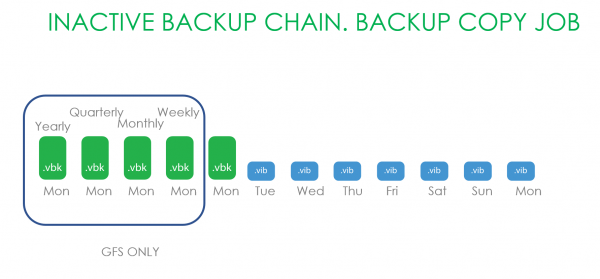
Nyní se podívejme na variantu práce se skupinami Backup Copy. Zde se ukládalo pouze to, co spadalo pod GFS retenci. Protože všechno, co je uloženo v novějších skupinách backup copy, může být jakýmkoliv způsobem změněno.
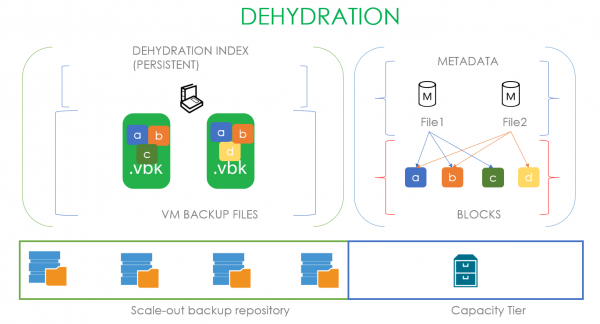
Nyní nahlédneme pod pokličku. Probíhá zde proces zvaný dehydratace — ponechání prázdných záložních souborů na extentu a přesouvání bloků z těchto souborů do kapacitního tieru. Pro optimalizaci tohoto procesu se používá takzvaný index dehydratace, který umožňuje nekopírovat bloky, které již byly zkopírovány do kapacitního tieru.
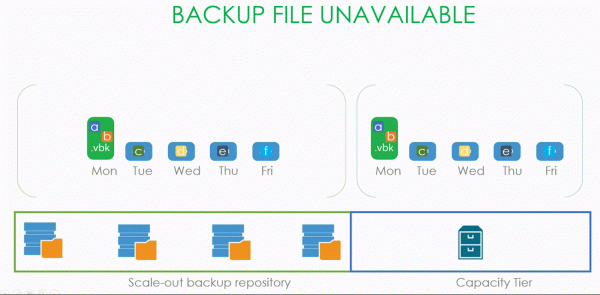
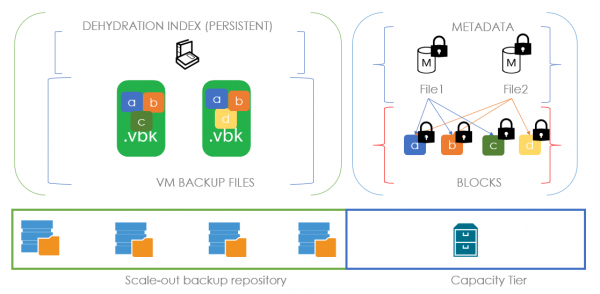
Podívejme se, jak to vypadá na příkladu: předpokládejme, že máme .vbk, který vyšel z provozního okna a patří uzavřené skupině. To znamená, že máme plné právo přesunout ho do kapacitního tieru. V okamžiku přesunu se vytváří soubor metadat v kapacitním tieru a bloky převáženého souboru. V souboru metadat na úrovni odkazů je popsáno, z jakých bloků se náš soubor skládá. Na obrázku se náš první soubor skládá z bloků a, b, c a v metadatech jsou umístěny odkazy na tyto bloky. Když máme druhý .vbk soubor, připravený k přesunu a skládající se z bloků a, b a d, analyzujeme index dehydratace a chápeme, že je potřeba přesunout pouze blok d. A jeho soubor metadat bude obsahovat odkazy na dva předchozí bloky a jeden nový.
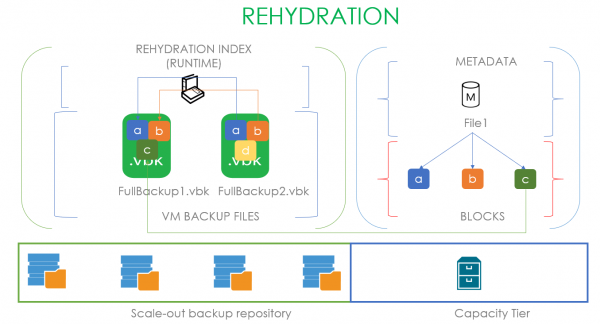
Proces zpětného doplnění těchto prázdnot daty se nazývá rehydratace. Zde se už používá vlastní index rehydratace, který se opírá o nejstarší .vbk soubor na místním performance extentu. To znamená, že pokud uživatel chce vrátit soubor z kapacitního tieru, nejprve vytvoříme index bloků nejstaršího plného zálohy a přesuneme z kapacitního tieru pouze chybějící bloky. V případě znázorněném na obrázku, abychom rehydratovali FullBackup1.vbk podle indexu rehydratace, nám chybí pouze blok C, který vezmeme z kapacitního tieru. Pokud jako kapacitní tier slouží cloudové objektové úložiště, umožňuje to ušetřit obrovské peníze.
Zde se může zdát, že tato technologie je identická s tou, která se používá v WAN akcelerátorech, ale to je jen dojem. V akcelerátorech se provádí globální deduplikace, zatímco zde se používá lokální deduplikace pro každý soubor na určitém offsetu. To je způsobeno rozdílností úkolů, které je třeba řešit: zde potřebujeme kopírovat velké soubory plných záloh, a podle našich výzkumů i když mezi nimi uplyne delší časový úsek, takový deduplikační algoritmus dává lepší výsledek.
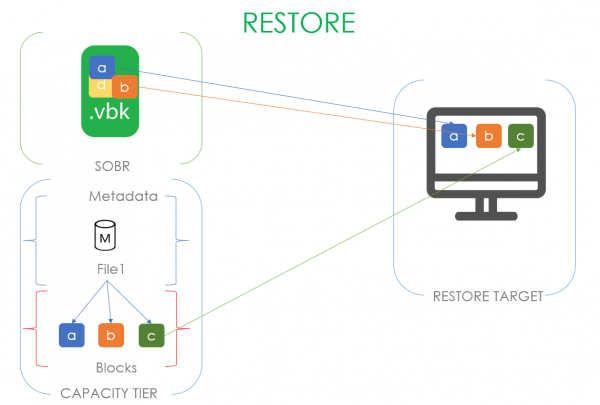
Ale víc indexů bohu indexů! Existuje také index pro obnovu dat! Když spustíme obnovu stroje umístěného v kapacitním tieru, čteme pouze jedinečné bloky dat, které nejsou v performance tieru.
Jak to bylo
Na tomto úvodním části je vše. Je docela podrobná, ale jak bylo zmíněno výše, bez těchto podrobností nebude možné vysvětlit, jak nové funkce fungují. Proto bez zbytečných předmluv přejděme k prvnímu.
Režim kopírování
Značně se zakládá na existujících technologiích, nicméně nese zcela jinou logiku využití.
Cílem tohoto režimu je zajistit, že všechna data umístěná na lokálním extentu mají kopii v kapacitním tieru.
Pokud porovnáme režimy Move a Copy přímo, dopadne to takto:
- Přesouvat lze pouze zapečetěný řetězec. V případě režimu kopírování se dávají všechny, bez ohledu na to, co se děje v záložní úloze.
- Přesun se aktivuje, když soubory překročí hranice okna provozní zálohy, zatímco kopírování se aktivuje ihned, jakmile se objeví záložní soubor.
- Sledování nových dat pro kopírování probíhá neustále, zatímco pro přesun se aktivovalo každé 4 hodiny.
Při zvažování nového režimu navrhuji jít od jednoduchých příkladů ke složitějším.
V tom nejbanálnějším případě se nám jednoduše objevují nové soubory s inkrementy a my je prostě kopírujeme do kapacitního tieru. Bez ohledu na to, jaký režim se používá v záložní úloze, bez ohledu na to, zda patří k zapečetěné části řetězce nebo ne, bez ohledu na to, zda uplynulo naše provozní okno. Jednoduše jsme vzali a zkopírovali.
Proces za tímto je stále dehydratace ve formě, jak bylo popsáno výše. V režimu kopírování také sleduje, aby nedocházelo ke kopírování bloků, které již existují v našem objektovém úložišti. Jediný rozdíl je ten, že pokud v režimu přesunu jsme nahrazovali skutečné soubory prázdnými soubory, zde je ani nijak nezasahujeme a necháváme vše tak, jak je. Jinak je to stále stejný index dehydratace, který pečlivě usiluje o úsporu vašich peněz a času.
Objevuje se otázka – pokud se podíváme na UI, existuje možnost vybrat obě možnosti najednou. Jak bude fungovat tento kombinovaný režim?
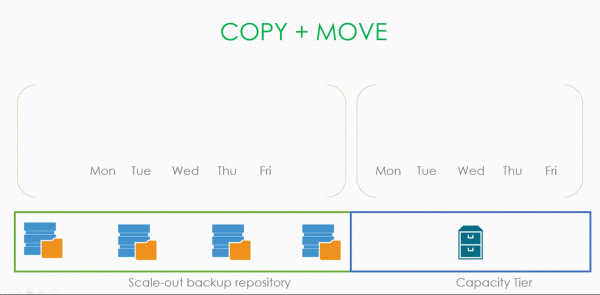
Pojďme se na to podívat.
Začátek je standardní: vytvoří se záložní soubor a okamžitě zkopíruje. K němu se vytvoří inkrement a také se zkopíruje. To se děje až do okamžiku, kdy pochopíme, že soubory vypadly z našeho operačního okna a objevila se zapečetěná řetězová vazba. V tom okamžiku provádíme operaci dehydratace a nahrazujeme tyto soubory prázdnými. Samozřejmě, znovu na kapacitním úložišti nic nekopírujeme.
Za celou tuto fascinující logiku odpovídá jediná zaškrtávací políčko v rozhraní: Copy backups to object storage as soon as they are created.
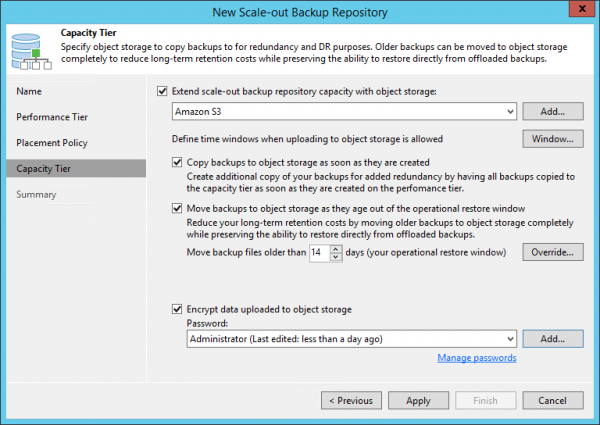
A proč potřebujeme tento režim Copy?
Lepší je přefrazovat otázku takto – jakých rizik se tímto chráníme? Jaký problém nám pomáhá řešit?
Odpověď je jasná: samozřejmě, je to obnova dat. Pokud máme v objektovém úložišti plnou kopii místních dat, nezáleží na tom, co se stane s naším produktem, vždy můžeme obnovit data ze souborů uložených v podmíněném Amazonu.
Takže se pojďme podívat na možné scénáře, od nejjednoduššího po složitější.
Nejjednodušší pohroma, která nám může spadnout na hlavu – to je nedostupnost jednoho ze souborů v záložním řetězci.
Smutnější příběh – jeden z extents našeho SOBR úložiště se nám rozbil.
Ještě hůře, když je celé SOBR úložiště nedostupné, ale kapacitní úložiště funguje.
A úplně špatně – to je, když umírá záložní server a vaše první přání je zkusit běžet na kanadskou hranici za deset minut.
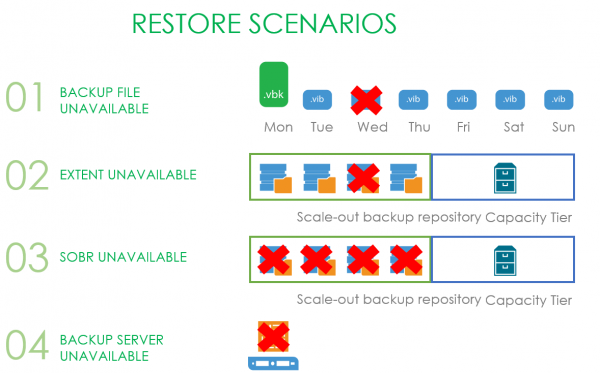
A nyní se podívejme na každou situaci zvlášť.
Když ztratíme jeden (ať už s ním, i několik) záložních souborů, stačí spustit proces znovuskenování úložiště a ztracený soubor bude nahrazen prázdným souborem. A pomocí procesu regenerace (o kterém bylo na začátku článku) si uživatel může stáhnout data z kapacity do místního úložiště.
Teď je situace složitější. Předpokládejme, že náš SOBR se skládá ze dvou extentů, které pracují v režimu Performance, což znamená, že naše .vbk a .vib jsou rozloženy na nich docela nerovnoměrně. A v určitém okamžiku se jeden z extentů stane nedostupným, a uživatel potřebuje urgentně obnovit stroj, jehož část dat leží právě na tomto extentu.
Uživatel spustí průvodce obnovy, vybere bod, na který chce obnovit, a během práce průvodce si uvědomí, že všechny potřebné pro obnovu data nemá lokálně a musí je stáhnout z kapacity. Přičemž bloky, které zbyly na místním úložišti, se z cloudu stahovat nebudou. Díky restore indexu (ano, o tom také bylo na začátku článku).
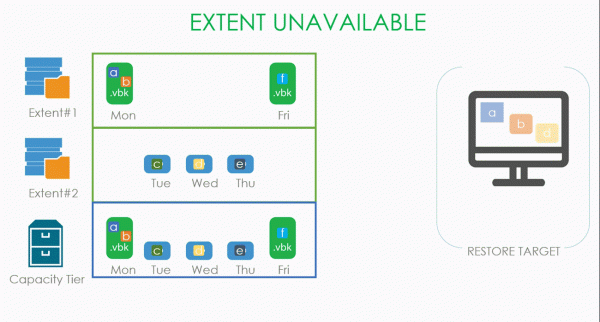
Podtyp této situace — nedostupný je celý SOBR repozitář. V takovém případě nemáme co kopírovat z místních úložišť a všechny bloky se stahují z cloudu.
A nejzajímavější situace — selhal záložní server. Zde jsou dvě varianty: administrátor je šikovný a dělá konfigurační zálohy, nebo administrátor sám sobě zlobný Buřtík a nedělal konfigurační zálohu.
V prvním případě mu bude stačit jednoduše někde rozbalit čistou instalaci VBR a obnovit jeho databázi ze zálohy běžnými prostředky. Na konci tohoto procesu se vše vrátí na své místo. Nebo bude obnoveno podle jednoho z výše uvedených scénářů.
Ale pokud je administrátor sám sobě nepřítelem nebo záloha konfigurace také potkala historickou neúspěch, tak ani tady ho nenecháme na holičkách. Pro tento případ jsme zavedli novou proceduru, která se nazývá Import Object Storage. Umožňuje přeskočit manuální proces obnovy SOBR úložiště a jeho připojení k kapacitním tierům s následným rescanem, a jednoduše přidat objektové úložiště do rozhraní Vima a spustit proceduru Import Storage Repository. Jedinou překážkou mezi vámi a vašimi zálohami může být požadavek na zadání hesla, pokud byly vaše zálohy zašifrovány.
Tímto končíme s Copy Mode, a nyní přecházíme k
Sealed Mode
Hlavní myšlenka — na vybraném extentu SOBR úložiště nemohou vznikat nové zálohy. Až do verze 10 jsme měli pouze Maintenance Mode, kdy byla zcela zakázána jakákoliv práce s úložištěm. Takový hardcorový režim vyřazení úložiště z provozu, kde byla dostupná pouze tlačítko Evacuate, které jednorázově přesouvalo zálohy na jiný extent.
Sealed mode — to je jakási "měkčí" varianta: zakazujeme vytváření nových záloh a postupně odstraňujeme staré podle vybraného retenčního období, ale v průběhu neztrácíme možnost obnovy z uložených bodů. Velmi užitečná věc, když nám končí životnost hardwaru a je třeba jej vyměnit, nebo je třeba uvolnit místo pro něco důležitějšího, a není kam to všechno jednorázově přesunout. Nebo to nelze odstranit.
Princip fungování je tedy velmi jednoduchý: je třeba zakázat všechny write operace (vznik nových dat), s ponecháním read (obnovy) a delete (retenční).
Oba režimy lze používat současně, jen je třeba mít na paměti, že Maintenance má vyšší prioritu.
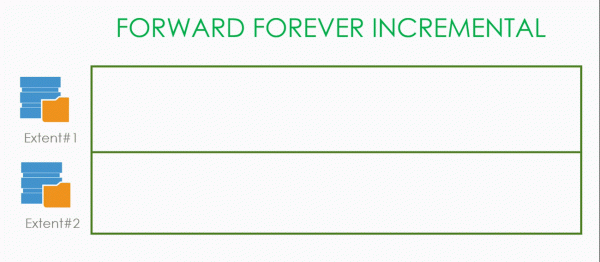
Jako příklad zvažme SOBR složené ze dvou extentů. Předpokládejme, že první čtyři dny jsme vytvářeli zálohy v režimu Forward Forever Incremental, a poté jsme uzavřeli extent. To vede k tomu, že iniciujeme vytvoření nového aktivního fullu na druhém dostupném extentu. Pokud je naše retenční období čtyři, pak když celá řetězec umístěný na uzavřeném extentu překročí jeho limit, je s klidným svědomím odstraněn.
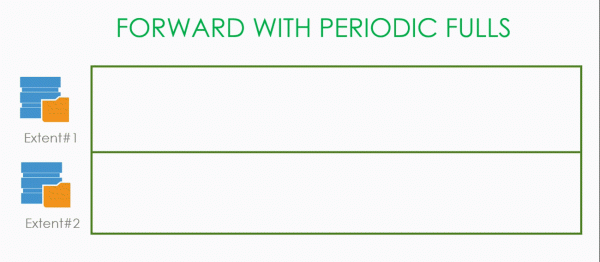
Existují situace, kdy dochází k odstranění dříve. Například to je Forward incremental s periodickými fully. Pokud jsme za první dva dny vytvořili full zálohy, a ve čtvrtek se rozhodneme uzavřít úložiště, v pátek, kdy se vytvoří nový full, bude soubor ze pondělí odstraněn, protože k této verzi nejsou žádné závislosti. A sama verze na nikom nezávisí. Poté čekáme, až budou vytvořeny čtyři verze na dostupném rozsahu a odstraníme zbývající tři, které nemohou být odstraněny nezávisle na sobě.
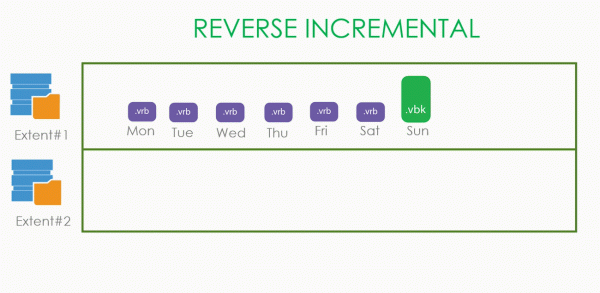
S Reverse Incremental je situace jednodušší. Nejstarší verze na ničem nezávisí a mohou být bez obav odstraněny. Jakmile tedy bude vytvořen nový .vbk na novém rozsahu, staré .vrb budou jednotlivě odstraňovány.
Mimochodem, proč každýkrát vytváříme nový .vbk: pokud bychom ho nevytvářeli a pokračovali ve starém řetězci inkrementů, starý .vbk by visel nekonečně dlouho v jakémkoli režimu, což by bránilo jeho odstranění. Proto bylo rozhodnuto, že jakmile je úložiště uzavřeno, vytvoříme full zálohu na volném rozsahu.
Situace se komplikuje s kapacity tierem.
Nejprve se podívejme na copy mode. Předpokládejme, že jsme čtyři dny aktivně vytvářeli zálohy a pak byl kapacity tier uzavřen. Nic neodstraňujeme, ale trpělivě dodržujeme retenční politiku, po které odstraníme data z kapacity tieru.
Podobné se děje i v move mode — vyčkáme na retenční politiku, odstraníme staré v lokálním úložišti a odstraníme to, co je uloženo v object storage.
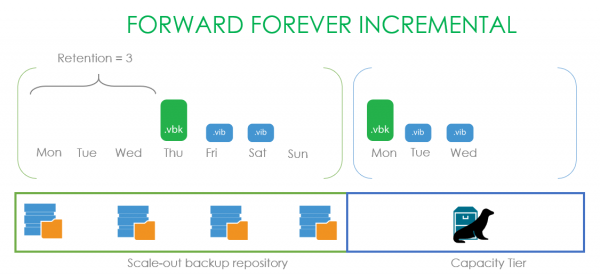
Zajímavý příklad je s Forever forward incremental. Nastavíme retenční politiku na tři verze a začneme v pondělí vytvářet zálohy, které se spolehlivě kopírují do cloudového úložiště. Po uzavření úložiště zálohy pokračují v tvorbě a dodržují tři verze, ale data uložená v kapacity tieru zůstávají závislá a nelze je odstranit. Proto čekáme až do čtvrtka, kdy náš .vbk překročí retenční politiku, a až poté bez obav odstraníme celý uložený řetězec.
A malá poznámka: všechny příklady zde jsou uvedeny s jedním strojem. Pokud jich máte v záloze více, bude se jejich retenční politika lišit v závislosti na tom, zda byla provedena Active Full nebo ne.
A tímto je v podstatě vše. Takže přecházíme k té nejtěžší funkci —
Immutability
Jak u předchozích bodů, nejprve si povíme, jaký problém tato funkce řeší. Jakmile exportujeme naše zálohy na externí úložiště, okamžitě vzniká touha zaručit jejich bezpečnost, tedy fyzicky zakázat jejich odstranění a jakoukoliv modifikaci po určitou dobu retention. To zahrnuje i administrátory, a to i pod jejich root účty. To chrání před náhodným nebo záměrným poškozením. Ti, kdo pracují s AWS, už se mohli setkat s podobnou funkcí pod názvem Object Lock.
Nyní se podívejme na režim obecně, a pak se ponoříme do detailů. V našem příkladu bude Immutability zapnuto pro náš kapacitní tier s retencí na čtyři dny. A v záloze bude zapnut režim Copy.
Immutability nijak neinteraguje s celkovou retencí. Například nepřidává žádné další body nebo něco podobného. Po dobu čtyř dnů nemůže uživatel odstranit soubory záloh. Pokud se v pondělí vytvoří záloha, bude možné soubor odstranit až v pátek.
Všechny dříve vysvětlené koncepty dehydratace, indexů a metadat fungují přesně tak, jak byly. Ale s jednou podmínkou — blok se uplatňuje nejen na data, ale i na metadata. To je uděláno pro případ, že by zlý útočník chtěl smazat naši databázi metadat a aby bloky s daty neztratily svou hodnotu a nestaly se zbytečnou binární kaší.
A nyní nastal skvělý okamžik pro vysvětlení naší technologie generování bloků. Nebo block generation. Proto si proberme situaci, která vedla k jejímu vzniku.
Vezmeme časovou osu na šest dní a níže budeme vyznačovat čas očekávaného vypršení immutability. Vytvoříme v první den soubor složený z bloku a a jeho metadata. Pokud je immutability nastavena na tři dny, je logické předpokládat, že čtvrtý den budou data odblokována a odstraněna. Druhý den přidáme nový file2, složený z bloku b se stejnými nastaveními. Blok a by měl být stále odstraněn čtvrtý den. Ale třetí den se stane hrozné — vytvoří se soubor File3, skládající se z nového bloku d a odkazu na starý blok a. To znamená, že pro blok a by měl být jeho flag immutability nastaven na novou dobu, která se posune na šestý den. A tady vzniká problém — v reálných zálohách těchto bloků vzniká obrovské množství. A abychom prodloužili jejich immutability období, musíme pokaždé provést obrovské množství požadavků. A ve skutečnosti to bude téměř nekonečný každodenní proces, protože s velkou pravděpodobností při každém kopírování nalezneme obrovské hromady deduplikačních bloků. A co znamená velké množství požadavků u poskytovatelů objektového úložiště? Správně! Obrovský účet na konci měsíce.
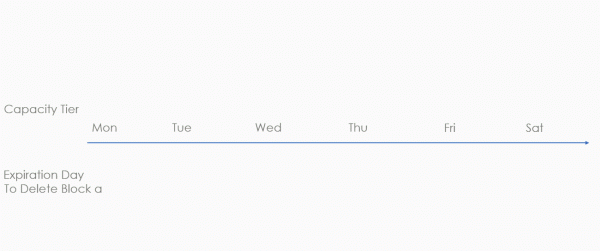
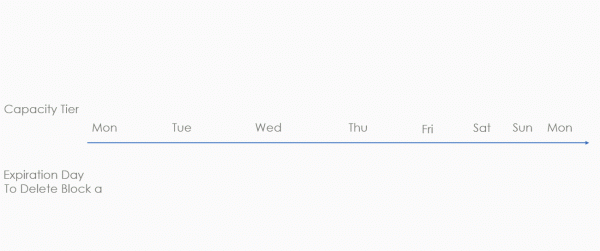
A aby se v žádném případě neopravdu nezhanobili své oblíbené klienty na slušné peníze, byl vynalezen mechanismus generování bloků. To je dodatečné období, které přidáváme k nastavenému období immutability. V níže uvedeném příkladu je toto období rovno dvěma dnům. Ale to je pouze pro příklad. Ve skutečnosti se tam používá vlastní formule, která dává přibližně deset dodatečných dní při měsíčním zámku.
Pokračujeme ve zkoumání téže situace, ale s generováním bloků. Vytváříme v prvním dni file1 z bloku a metadat. Skládáme období generování a neměnnost – to znamená, že možnost smazání souboru bude až šestý den. Pokud druhý den vytvoříme File2, který se skládá z bloku b a odkazu na blok a, očekávaný datum smazání se nemění. Stále zůstává na šestý den. Snažíme se tím pádem šetřit peníze na počtu dotazů. Jediná situace, kdy se termín může posunout, je, pokud vypršelo období generování. To znamená, že pokud třetí den nový File3 bude obsahovat odkaz na blok a, bude přidán generování 2, protože Gen1 už vypršelo. A očekávané datum smazání bloku a se posune na osmý den. To nám umožňuje dramaticky snížit počet dotazů na prodloužení životnosti deduplikovaných bloků, což šetří spoustu peněz pro zákazníky.
Samotná technologie je dostupná uživatelům S3 a S3-kompatibilního hardwaru, jehož výrobci zaručují, že jejich implementace se neliší od té od Amazonu. Odtud odpověď na legitimní otázku, proč není podporováno Azure – mají podobnou funkci, ale ta funguje na úrovni kontejnerů, nikoli jednotlivých objektů. Mimochodem, v samotném Amazonu existuje Object Lock ve dvou režimech: compliance a governance. V druhém případě zůstává možnost, že ten největší admin nad adminy a root nad rooty, navzdory Object Lock, přesto smaže data. V případě compliance je všechno přibito hřebíky a nikdo nemůže zálohy smazat. Dokonce ani administrátoři Amazonu (podle jejich oficiálních prohlášení). Podporujeme právě tento režim.
A tradičně, několik užitečných odkazů:
- O ve všech podrobnostech.
- Všechny informace o v nejlepším provedení
- O v detailech
Zdroj: habr.com
