

Netflix — lídr na trhu internetového televizního vysílání — společnost, která vytvořila a aktivně rozvíjí tento segment. Netflix je známý nejen rozsáhlým katalogem filmů a seriálů dostupných téměř z jakéhokoli místa na světě a na jakémkoli zařízení s displejem, ale také spolehlivou infrastrukturou a unikátní inženýrskou kulturou.
Příklad přístupu Netflixu k vývoji a podpoře složitých systémů představil — ředitel pro vývoj v Netflixu. Absolvent Fakulty výpočetní techniky NNGU im. Lobachevského, Sergej je jedním z prvních inženýrů v Open Connect — CDN týmu v Netflixu. Vytvořil systémy pro monitorování a analýzu videodat, spustil populární službu pro měření rychlosti internetového připojení FAST.com a posledních několik let pracuje na optimalizaci internetových požadavků, aby aplikace Netflix fungovala co nejrychleji pro uživatele.
Prezentace získala nejlepší hodnocení od účastníků konference a připravili jsme pro vás textovou verzi.
V prezentaci Sergej podrobně hovořil
- o tom, co ovlivňuje zpoždění internetových požadavků mezi klientem a serverem;
- jak toto zpoždění snížit;
- jak navrhovat, udržovat a monitorovat odolné systémy proti chybám;
- jak dosahovat výsledků ve zkrácených časových lhůtách a s minimálním rizikem pro podnikání;
- jak analyzovat výsledky a učit se na chybách.
Odpovědi na tyto otázky jsou potřebné nejen těm, kteří pracují ve velkých korporacích.
Předložené principy a techniky by měl znát a praktikusovat každý, kdo vyvíjí a podporuje internetové produkty.
Dále — vyprávění z pohledu řečníka.
Důležitost rychlosti internetu
Rychlost internetových požadavků je přímo spojena s podnikáním. Zvažme oblast nakupování: společnost Amazon v roce 2009 , že zpoždění o 100 ms vede ke ztrátě 1% prodeje.
Počet mobilních zařízení stále roste, a s nimi také mobilní weby a aplikace. Pokud se vaše stránka načítá déle než 3 sekundy, ztrácíte přibližně polovinu uživatelů. Od Google bere v úvahu rychlost načítání vaší stránky při vyhledávání: čím rychleji se stránka načítá, tím vyšší je její pozice v Google.
Rychlost připojení je také důležitá ve finančních institucích, kde je zpoždění kritické. V roce 2015 společnost Hibernia Networks položka kabelu mezi New Yorkem a Londýnem v hodnotě 400 milionů dolarů, která má snížit latenci mezi městy o 6 ms. Představte si, 66 milionů dolarů za 1 ms snížení latence!
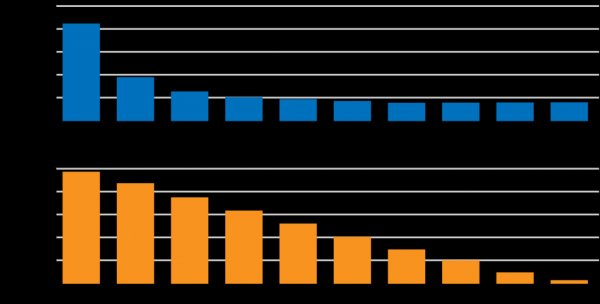
Podle , rychlost připojení nad 5 Mbit/s přestává mít přímý vliv na rychlost načítání typické webové stránky. Nicméně existuje lineární závislost mezi latencí připojení a rychlostí načítání stránky:
Netflix však není typický produkt. Vliv latence a rychlosti na uživatele je aktivní oblastí analýzy a vývoje. Existuje načítání aplikace a výběr obsahu, které závisí na latenci, ale načítání statických prvků a streaming také závisí na rychlosti připojení. Analýza a optimalizace klíčových faktorů ovlivňujících kvalitu služby pro uživatele je aktivní oblastí vývoje několika týmů v Netflixu. Jedním z úkolů je snížení latence požadavků mezi zařízeními Netflix a cloudovou infrastrukturou.
Ve zprávě se zaměříme zejména na snížení latence (latency) na příkladu infrastruktury Netflix. Uvidíme, jak přistupovat k procesům návrhu, vývoje a provozu složitých distribuovaných systémů a trávit čas inovacemi a výsledky, nikoli diagnostikou provozních problémů a poruch.
Uvnitř Netflixu
Tisíce různých zařízení podporují aplikace Netflix. Na jejich vývoji pracují čtyři různé týmy, které vytvářejí samostatné verze klienta pro Android, iOS, TV a webové prohlížeče. A my velmi investujeme do vylepšení a personalizace uživatelského rozhraní. Za tímto účelem provádíme současně stovky A/B testů.
Personalizace je podporována stovkami mikroslužeb v cloudu AWS, které poskytují personalizovaná data pro uživatele, zpracování požadavků, telemetrii, Big Data a Encoding. Vizualizace provozu vypadá takto:
Vlevo se nachází bod vstupu, a poté se provoz distribuuje mezi několika stovkami mikroslužeb, které podporují různé backend týmy.
Další důležitou součástí naší infrastruktury je Open Connect CDN, která doručuje statický obsah koncovému uživateli — videa, obrázky, kód pro klienty atd. CDN je umístěna na zakázkových serverech (OCA — Open Connect Appliance). Uvnitř jsou pole SSD a HDD disků spravovaných optimalizovaným FreeBSD, s NGINX a sadou služeb. Navrhujeme a optimalizujeme hardwarové a softwarové komponenty tak, aby mohl tento CDN server posílat co nejvíce dat uživatelům.
„Stěna“ těchto serverů na bodě výměny internetového provozu (Internet eXchange — IX) vypadá takto:
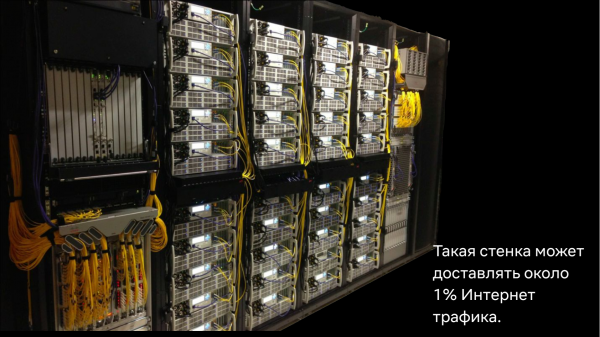
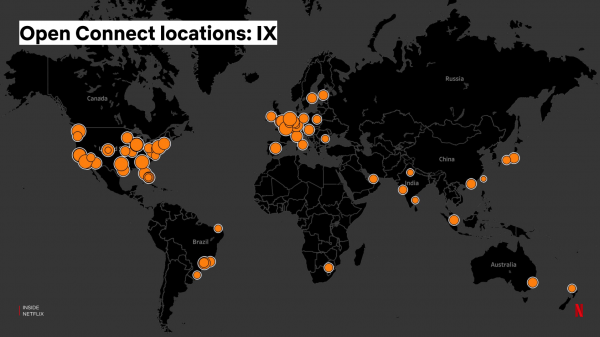
Internet Exchange poskytuje možnost internetovým poskytovatelům a dodavatelům obsahu „připojit se“ navzájem pro přímější výměnu dat na internetu. Po celém světě je přibližně 70-80 Internet Exchange bodů, kde jsou umístěny naše servery, a my se o jejich instalaci a údržbu postaráme sami:
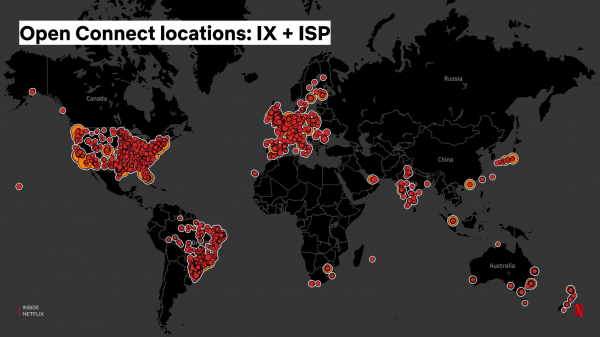
Kromě toho také poskytujeme servery přímo internetovým poskytovatelům, kteří je instalují do své sítě, čímž zlepšují lokalizaci Netflix provozu a kvalitu streamingu pro uživatele:
Sada služeb AWS je zodpovědná za směrování video požadavků od klientů k CDN serverům, stejně jako za konfiguraci samotných serverů — aktualizaci obsahu, software, nastavení atd. K tomu jsme také vybudovali backbone síť, která propojuje servery v bodě Internet Exchange s AWS. Backbone síť představuje globální síť optických kabelů a routerů, které můžeme navrhovat a konfigurovat podle našich potřeb.
Podle , naše CDN infrastruktura doručuje v době špičky přibližně ⅛ světového internetového provozu a ⅓ provozu v Severní Americe, kde Netflix existuje nejdéle. Působivá čísla, ale pro mě jedním z nejúžasnějších úspěchů je, že celý systém CDN je vyvíjen a udržován týmem méně než 150 lidí.
Původně byla CDN infrastruktura navržena pro doručování video dat. Postupem času jsme však zjistili, že ji můžeme využít také pro optimalizaci dynamických požadavků od klientů do AWS cloudu.
O zrychlení internetu
Dnes má Netflix 3 regiony AWS a zpoždění požadavků v cloudu bude záviset na tom, jak daleko je klient od nejbližšího regionu. K tomu máme řadu serverů CDN, které se používají pro dodávku statického obsahu. Můžeme nějak využít tuto infrastrukturu, abychom urychlili dynamické požadavky? Bohužel tyto požadavky nelze cacheovat — API jsou personalizovaná a každý výsledek je unikátní.
Pojďme vytvořit proxy na serveru CDN a začít skrze něj procházet provoz. Bude to rychlejší?
Technické základy
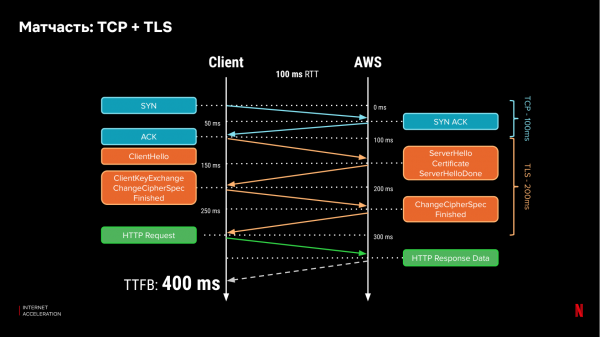
Vzpoměňme si, jak fungují síťové protokoly. Dnes většina provozu na internetu používá HTTPS, který závisí na protokolech nižší úrovně TCP a TLS. Aby se klient připojil k serveru, provádí handshake, a pro navázání zabezpečeného spojení musí klient vyměnit zprávy se serverem třikrát a ještě alespoň jednou, aby předal data. Při zpoždění jednoho výměny (RTT) 100 ms potřebujeme 400 ms, abychom získali první bit dat:
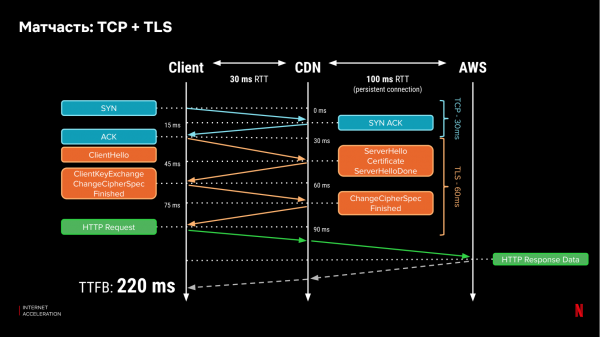
Pokud umístíme certifikáty na server CDN, můžeme výrazně zkrátit čas takzvaného „podání ruky“ mezi klientem a serverem, pokud je CDN blíže. Předpokládejme, že zpoždění do serveru CDN činí 30 ms. Pak pro získání prvního bitu již potřebujeme 220 ms:
Ale výhody tímto nekončí. Jakmile je spojení již navázáno, TCP zvyšuje congestion window (počet informací, které může paralelně přenášet přes toto spojení). Pokud dojde ke ztrátě datového paketu, potom klasické implementace protokolu TCP (jako TCP New Reno) snižují otevřené „okno“ na polovinu. Růst congestion window a rychlost jeho obnovy po ztrátě opět závisí na zpoždění (RTT) do serveru. Pokud toto spojení jde pouze na server CDN, tato obnova bude rychlejší. Ztráta paketů je přitom běžným jevem, zejména pro bezdrátové sítě.
Internetová propustnost může být snížena, zejména v špičkách kvůli uživatelskému provozu, což může vést k "zácpám". Přitom na internetu neexistuje způsob, jak upřednostnit některé požadavky před jinými. Například upřednostnit malé, objemově malé a na zpoždění citlivé požadavky oproti "těžkým" datovým tokům, které zatěžují síť. Nicméně v našem případě nám vlastní backbone síť umožňuje to provést na části cesty požadavku — mezi CDN a cloudem, a můžeme ji plně konfigurovat. Můžeme zajistit, aby malé a na zpoždění závislé pakety měly prioritu, zatímco velké datové toky by šly trochu později. Čím blíže je CDN k klientovi, tím větší je efektivita.
Na zpoždění také ovlivňují protokoly aplikační úrovně (OSI úroveň 7). Nové protokoly, jako je HTTP/2, umožňují optimalizovat výkon paralelních požadavků. Nicméně máme Netflix jako klienty, kteří používají stará zařízení, která novými protokoly nepodporují. Ne všechny klienty je možné aktualizovat nebo optimálně nastavit. Mezi CDN proxy a cloudem však máme plnou kontrolu a možnost využít nové, optimální protokoly a nastavení. Neefektivní část se starými protokoly bude fungovat pouze mezi klientem a CDN serverem. Navíc můžeme multiplexovat požadavky na již navázané spojení mezi CDN a cloudem, čímž zlepšíme využití spojení na úrovni TCP:
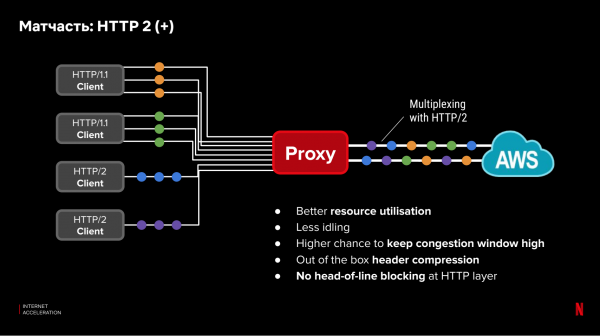
Měříme
I když teorie slibuje zlepšení, nepouštíme se hned do spuštění systému v produkci. Místo toho musíme nejprve dokázat, že myšlenka bude fungovat v praxi. Za tímto účelem je třeba odpovědět na několik otázek:
- Rychlost: Bude proxy rychlejší?
- Spolehlivost: Bude se častěji porouchávat?
- Složitost: Jak integrovat s aplikacemi?
- Náklady: Kolik stojí nasazení dodatečné infrastruktury?
Podívejme se podrobně na náš přístup k hodnocení prvního bodu. Ostatní se vyhodnocují podobným způsobem.
Pro analýzu rychlosti požadavků chceme získat data pro všechny uživatele, utrácet málo času na vývoj a nezlomit produkci. K tomu existuje několik přístupů:
- RUM, nebo pasivní měření požadavků. Měříme dobu vykonávání aktuálních požadavků od uživatelů a zajišťujeme úplné pokrytí uživatelů. Nevýhodou je, že signál není příliš stabilní kvůli mnoha faktorům, jako jsou rozměry požadavků, doba zpracování na serveru a klientovi. Kromě toho nelze otestovat novou konfiguraci bez vlivu na produkci.
- Laboratorní testy. Speciální servery a infrastruktura, které simulují klienty. S jejich pomocí provádíme potřebné testy. Tímto způsobem získáváme plnou kontrolu nad výsledky měření a jasný signál. Ale není k dispozici úplné pokrytí zařízení a umístění uživatelů (zejména se službou po celém světě a podporou tisíců modelů zařízení).
Jak lze spojit výhody obou metod?
Náš tým našel řešení. Napsali jsme malý kousek kódu – zkušební úryvek – který jsme integrovali do našeho aplikace. Tyto úryvky nám umožňují provádět plně kontrolované síťové testy z našich zařízení. Funguje to následovně:
- Krátce po načtení aplikace a dokončení úvodních aktivit spouštíme naše úryvky.
- Klient provede požadavek na server a obdrží "recept" testu. Recept představuje seznam URL adres, na které je třeba provést HTTP(s) požadavek. Kromě toho recept konfiguruje parametry požadavků: zpoždění mezi požadavky, objem požadovaných dat, HTTP(s) hlavičky atd. Přitom můžeme paralelně testovat několik různých receptů — při požadavku na konfiguraci náhodně určíme, který recept vydáme.
- Čas spuštění úryvku je vybrán tak, aby nekolidoval s aktivním využíváním síťových zdrojů na klientovi. V podstatě se vybírá čas, kdy je klient neaktivní.
- Po obdržení receptu provádí klient požadavky na každou z URL adres paralelně. Požadavek na každou adresu může být opakován — tzv. „pulzy“. Při prvním pulzu měříme, kolik času bylo potřeba pro navázání spojení a stažení dat. Při druhém pulzu měříme dobu načítání dat již navázaném spojení. Před třetím můžeme nastavit zpoždění a změřit rychlost navázání opakovaného spojení atd.
Během testu měříme všechny parametry, které může zařízení získat:
- čas DNS dotazu;
- čas pro navázání TCP připojení;
- čas pro navázání TLS připojení;
- čas pro příjem prvního bajtu dat;
- celkový čas načítání;
- status kód výsledku.
- Po dokončení všech pulsů vzorek načte výsledky všech měření pro analýzu.
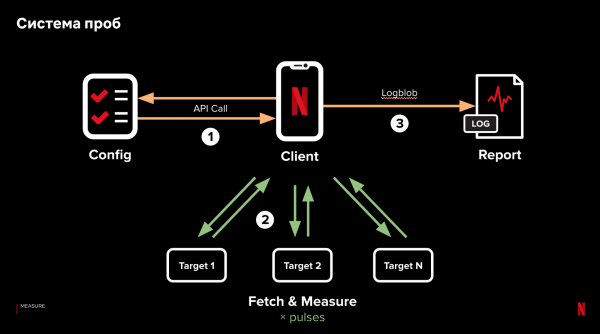
Klíčovými momenty jsou minimální závislost na logice na klientské straně, zpracování dat na serveru a měření paralelních dotazů. Tímto způsobem získáme možnost izolovat a testovat vliv různých faktorů ovlivňujících výkon dotazů, variabilně je měnit v rámci jednoho receptu a získávat výsledky z reálných klientů.
Taková infrastruktura se ukázala jako užitečná nejen pro analýzu výkonu dotazů. V tomto okamžiku máme 14 aktivních receptů, více než 6000 vzorků za sekundu, získávající data ze všech koutů světa s plným pokrytím zařízení. Kdyby Netflix nakupoval podobnou službu od externích společností, stálo by to miliony dolarů ročně, a to s mnohem horším pokrytím.
Ověřujeme teorii v praxi: prototyp
S takovým systémem jsme získali možnost ocenit efektivitu CDN proxy na latenci dotazů. Nyní je potřeba:
- vytvořit prototyp proxy;
- umístit prototyp na CDN;
- určit, jak směrovat klienty k proxy na konkrétním CDN serveru;
- srovnat výkon s dotazy na AWS bez proxy.
Úkolem je co nejrychleji posoudit efektivitu navrhovaného řešení. Pro realizaci prototypu jsme zvolili Go, díky přítomnosti kvalitních síťových knihoven. Na každém CDN serveru jsme nainstalovali prototyp proxy jako statický binární soubor, abychom minimalizovali závislosti a usnadnili integraci. V počáteční realizaci jsme co nejvíce využili standardní komponenty a drobné úpravy pro HTTP/2 connection pooling a request multiplexing.
Pro vyvážení mezi regiony AWS jsme použili geografickou databázi DNS, kterou používáme také pro vyvážení klientů. K výběru CDN serveru pro klienta používáme TCP Anycast pro servery v Internet Exchange (IX). V tomto scénáři používáme jednu IP adresu pro všechny CDN servery, přičemž klient bude směrován na CDN server s nejmenším počtem IP hops. U CDN serverů, které jsou umístěny u poskytovatelů internetových služeb (ISP), nemáme kontrolu nad routerem pro nastavení TCP Anycast, proto využíváme , podle které jsou klienti směrováni k internetovým poskytovatelům pro videostreaming.
Máme tedy tři typy cest pro požadavek: do cloudu přes veřejný internet, přes CDN server v IX nebo přes CDN server umístěný u poskytovatele internetových služeb. Naším cílem je pochopit, která cesta je nejlepší a jaké výhody má proxy ve srovnání s tím, jak jsou požadavky směrovány do produkce. K tomu používáme systém testů následujícím způsobem:
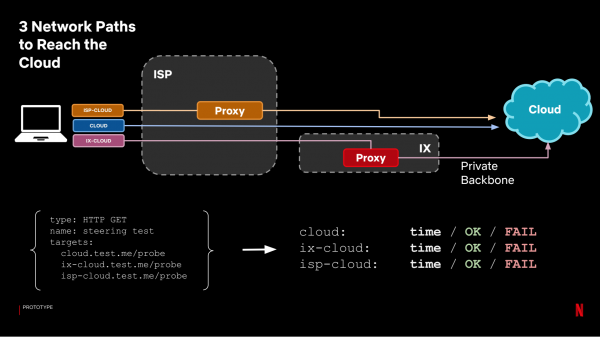
Každá z cest se stává samostatným cílem a my sledujeme čas, který jsme získali. Pro analýzu slučujeme výsledky proxy do jedné skupiny (vybíráme nejlepší čas mezi proxy IX a ISP) a porovnáváme jej s časem požadavků do cloudu bez proxy:
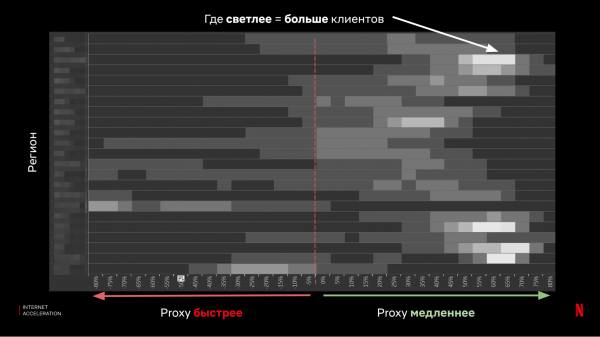
Jak je vidět, výsledky jsou nejednoznačné — v většině případů proxy poskytuje dobré zrychlení, ale je také dostatek klientů, pro které se situace výrazně zhorší.
Nakonec jsme udělali několik důležitých věcí:
- Odhadli jsme očekávaný výkon požadavků od klientů do cloudu přes CDN proxy.
- Získali jsme data od skutečných klientů ze všech typů zařízení.
- Pochopili jsme, že teorie nebyla stoprocentní a původní návrh s CDN proxy pro nás nefunguje.
- Neriskovali jsme — neměnili jsme konfigurace produkce pro klienty.
- Nerozbili jsme nic.
Prototyp 2.0
Vrátíme se tedy zpět k návrhu a proces zopakujeme.
Myšlenka je taková, že místo 100% proxy určíme pro každého klienta nejrychlejší cestu a budeme tam směrovat požadavky — tedy uděláme to, čemu se říká řízení klienta.
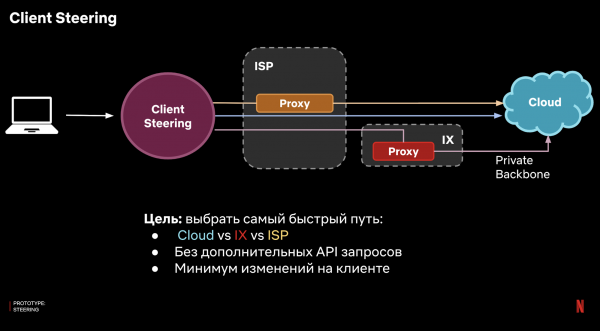
Jak to realizovat? Nemůžeme použít logiku na straně serveru, protože cílem je připojit se k tomuto serveru. Je potřeba to nějak provést na klientovi. A ideálně to udělat s minimálním množstvím složité logiky, abychom se nemuseli zabývat integrací s širokým spektrem klientských platforem.
Odpověď je použití DNS. V našem případě máme vlastní DNS infrastrukturu a můžeme nastavit doménovou zónu, pro kterou budou naše servery autoritativní. Funguje to takto:
- Klient posílá dotaz na DNS server pomocí hostitele, například api.netflix.com.
- Dotaz přichází na náš DNS server.
- DNS server ví, jaká cesta je pro tohoto klienta nejrychlejší, a vydává odpovídající IP adresu.
V řešení je další složitost: autoritativní DNS poskytovatelé nevidí IP adresu klienta a mohou pouze považovat IP adresu rekursivního resolveru, který klient používá.
Nakonec náš autoritativní resolver musí činit rozhodnutí ne pro jednotlivého klienta, ale pro skupinu klientů na základě rekursivního resolveru.
Pro řešení používáme stejné vzorky, agregujeme výsledky měření od klientů pro každý rekursivní resolver a rozhodujeme, kam tuto skupinu nasměrovat - proxy přes IX pomocí TCP Anycast, přes ISP proxy nebo přímo do cloudu.
Dostáváme takový systém:
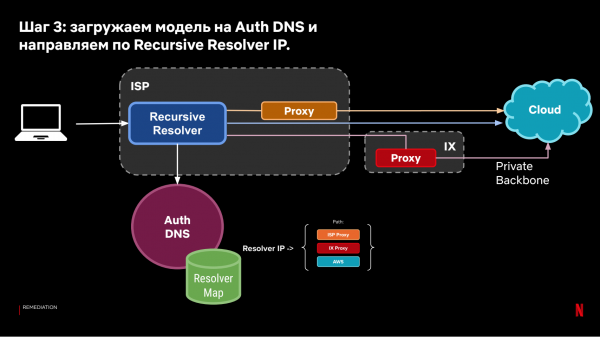
Získaný model DNS steering umožňuje směrovat klienty na základě historických pozorování rychlosti spojení od klientů do cloudu.
Opět otázka - jak efektivně bude takový přístup fungovat? Pro odpověď znovu využijeme náš vzorkovací systém. Nastavíme konfiguraci recent, kde jedno z cílů jde podle směrování DNS a druhé jde přímo do cloudu (aktuální produkce).
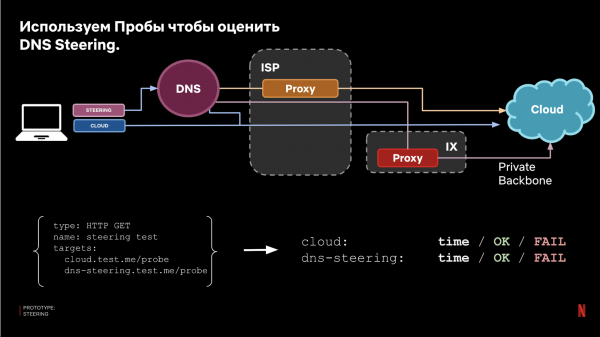
Nakonec porovnáme výsledky a získáme hodnocení efektivity:
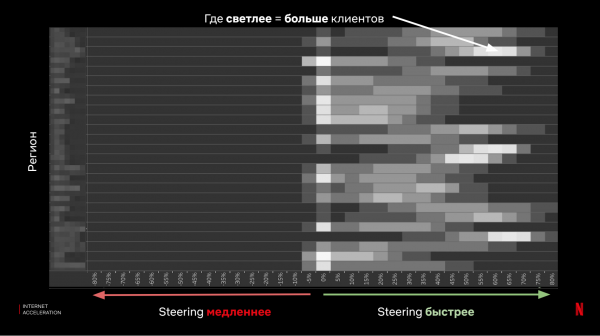
Na konci jsme se dozvěděli několik důležitých věcí:
- Vyhodnotili jsme očekávaný výkon dotazů od klientů do cloudu pomocí DNS Steering.
- Získali jsme data od skutečných klientů ze všech typů zařízení.
- Dokázali jsme efektivitu navrhované myšlenky.
- Neriskovali jsme — neměnili jsme konfigurace produkce pro klienty.
- Nerozbili jsme nic.
Teď k obtížnému - spouštíme v produkci.
Nejlehčí část je nyní za námi – máme funkční prototyp. Nyní nastává složitější úkol – spustit řešení pro veškerý provoz Netflixu, nasadit ho na 150 milionů uživatelů, tisíce zařízení, stovky mikroslužeb a neustále se měnící produkt a infrastrukturu. Na servery Netflixu přicházejí miliony požadavků za sekundu, a je snadné službu rozbít neopatrným krokem. Přejeme si také dynamicky směrovat provoz přes tisíce CDN serverů na internetu, kde se něco neustále mění a pokazí se to v nejméně vhodném okamžiku.
A přesto, v týmu jsou 3 inženýři odpovědní za vývoj, nasazení a plnou podporu systému.
Proto budeme nyní mluvit o klidném a zdravém spánku.
Jak pokračovat ve vývoji a nepromarnit veškerý čas na podporu? Základem našeho přístupu jsou 3 principy:
- Snižujeme potenciální rozsah poruch (blast radius).
- Připravujeme se na překvapení – očekáváme, že se něco pokazí, navzdory testování a osobní zkušenosti.
- Postupná degradace (graceful degradation) – pokud něco nefunguje správně, mělo by se to opravovat automaticky, i když ne nejefektivnějším způsobem.
Ukázalo se, že v našem případě, s takovým přístupem k problému, lze najít jednoduché a efektivní řešení a výrazně zjednodušit podporu systému. Uvědomili jsme si, že můžeme do klienta přidat malý kousek kódu a sledovat chyby síťových požadavků způsobené problémy s připojením. Při síťových chybách provádíme fallback přímo do cloudu. Takové řešení nevyžaduje velké úsilí od klientských týmů, ale výrazně snižuje riziko nečekaných poruch a překvapení pro nás.
Samozřejmě, navzdory fallbacku, se i nadále řídíme jasnou disciplínou v průběhu vývoje:
- Test na vzorcích.
- A/B testování nebo Canaries.
- Postupné vydání (progressive rollout).
Přístup k testování vzorků byl popsán – změny jsou nejprve testovány pomocí nastaveného receptu.
Pro canary testing potřebujeme získat srovnatelné páry serverů, na kterých lze srovnávat, jak systém funguje před a po změnách. Za tímto účelem vybíráme páry serverů z našich četných CDN stránek, které přijímají srovnatelný provoz:
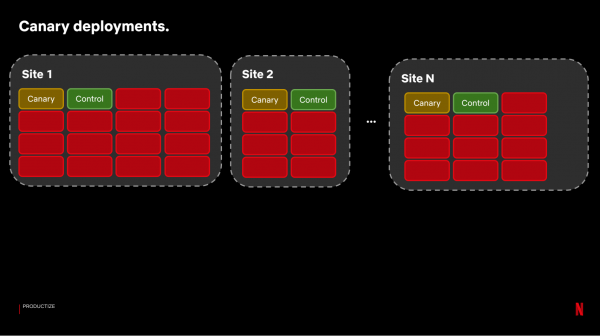
Poté nasazujeme sestavení se změnami na Canary servery. Pro vyhodnocení výsledků spouštíme systém, který porovnává přibližně 100–150 metrik se vzorkem Control serverů:
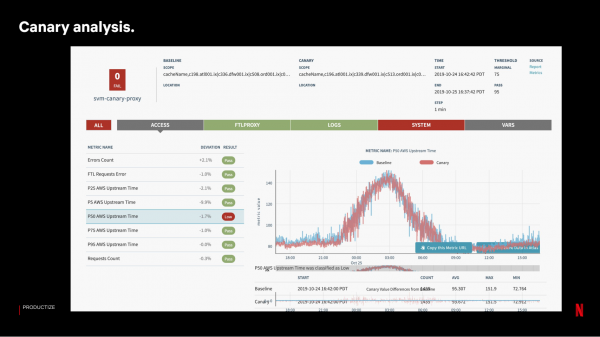
Pokud Canary testování proběhne úspěšně, vydáváme verzi postupně, v několika vlnách. Na každém z webů neaktualizujeme servery současně — ztráta celého webu v případě problémů má větší dopad na službu pro uživatele, než ztráta stejného počtu serverů, ale na různých místech.
Celkově účinnost a bezpečnost tohoto přístupu závisí na množství a kvalitě shromážděných metrik. Pro náš systém urychlení žádostí shromažďujeme metriky ze všech možných komponentů:
- od klientů — počet relací a požadavků, fallback rates;
- proxy — statistiky o počtu a čase žádostí;
- DNS — počet a výsledky žádostí;
- cloud edge — počet a čas zpracování žádostí v cloudu.
To vše se shromáždí do jednotného pipeline a v závislosti na potřebách rozhodujeme, které metriky posílat na real-time analytiku a které do Elasticsearch nebo Big Data pro podrobnější diagnostiku.
Monitorujeme
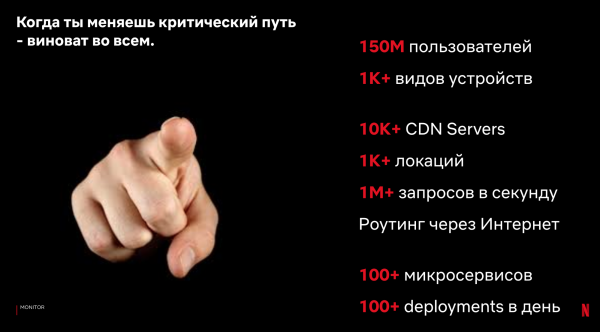
V našem případě činíme změny na kritické cestě požadavků mezi klientem a serverem. Přitom množství různých komponentů na klientovi, na serveru a na cestě přes internet je obrovské. Změny na klientovi a serveru probíhají neustále — v průběhu práce desítek týmů a přirozených změn v ekosystému. Jsme uprostřed — při diagnostice problémů je velká šance, že se na tom budeme podílet. Proto musíme jasně rozumět, jak určit, shromažďovat a analyzovat metriky pro rychlou lokalizaci problémů.
Ideálně — úplný přístup ke všem typům metrik a filtrům v reálném čase. Ale metrik je opravdu hodně, takže vyvstává otázka nákladů. V našem případě dělíme metriky a vývojové nástroje následujícím způsobem:
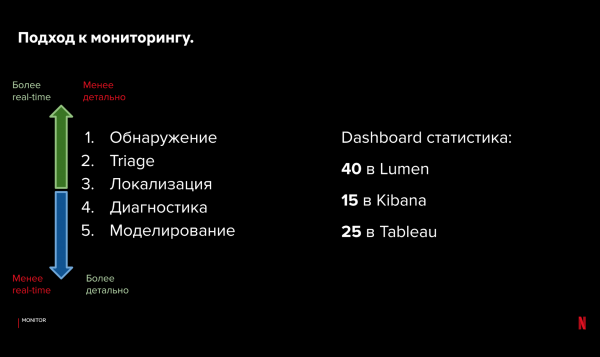
Pro odhalování a triage problémů používáme vlastní real-time systém s otevřeným zdrojovým kódem a — pro vizualizaci. Uchovává agregované metriky v paměti, je spolehlivý a integruje se s alerting systémem. Pro lokalizaci a diagnostiku máme přístup k logům z Elasticsearch a Kibana. Pro statistickou analýzu a modelování využíváme big data a vizualizaci v Tableau.
Zdá se, že s takovým přístupem je velmi obtížné pracovat. Nicméně při hierarchické organizaci metrik a nástrojů můžeme rychle analyzovat problém, určit typ problému a poté se hlouběji zaměřit na podrobné metriky. Na identifikaci zdroje poruchy obvykle potřebujeme asi 1-2 minuty. Poté již pracujeme s konkrétním týmem na diagnostice — od desítek minut po několik hodin.
I když je diagnostika prováděna rychle, nechceme, aby se to dělo často. Ideálně bychom chtěli dostávat kritické upozornění pouze v případě, že má významný dopad na službu. Pro náš systém urychlení požadavků máme pouze 2 upozornění, která nás budou informovat:
- procento Client Fallback — hodnocení chování zákazníků;
- procento Probe errors — data o stabilitě síťových komponent.
Tato kritická upozornění sledují, zda systém funguje pro většinu uživatelů. Sledujeme, kolik zákazníků využilo fallback, pokud se jim nepodařilo získat urychlení požadavků. V průměru máme méně než 1 kritické upozornění týdně, i když v systému se děje ohromné množství změn. Proč nám to stačí?
- Existuje client fallback v případě, že naše proxy nefunguje.
- Existuje automatický steering systém, který reaguje na problémy.
O posledním podrobněji. Náš systém pro probe a systém automatického určení optimální cesty pro požadavky od klienta do cloudu umožňují automaticky zvládat některé problémy.
Vraťme se k naší konfiguraci pro probe a 3 kategoriím cest. Kromě doby načítání můžeme sledovat i samotný fakt doručení. Pokud se data nepodařilo načíst, můžeme podle výsledků z různých cest zjistit, kde a co se pokazilo, a zda můžeme automaticky opravit, změnou cesty požadavku.
Příklady:
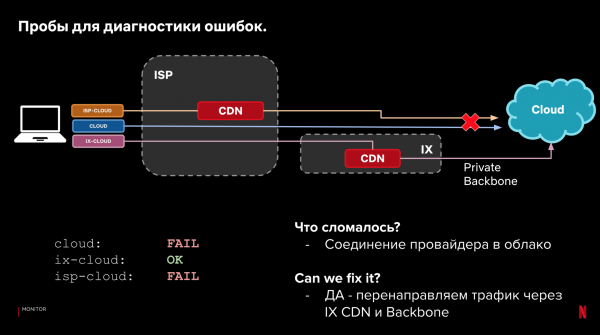
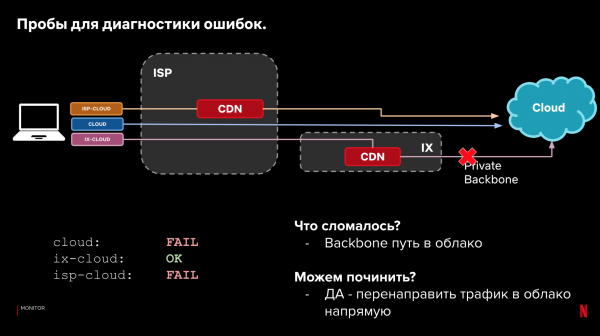
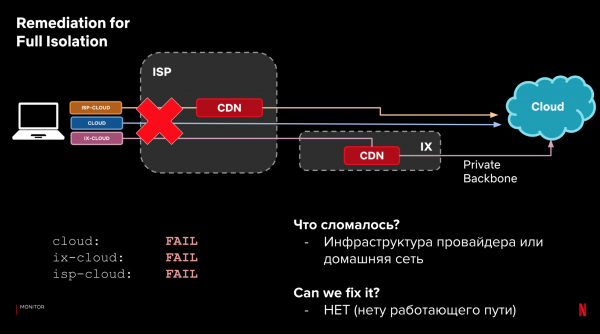
Tento proces lze automatizovat. Zahrnout ho do steering-systému. A naučit ho reagovat na problémy s výkonem a spolehlivostí. Pokud se něco začne porouchávat — reagovat, pokud je lepší možnost. Přičemž okamžitá reakce není kritická díky fallbacku na klientech.
Principy podpory systému lze tedy formulovat takto:
- snižujeme měřítko poruch;
- sbíráme metriky;
- automaticky opravujeme poruchy, pokud můžeme;
- pokud nemůžeme — oznámíme;
- pracujeme na dashboardech a nástrojích pro triage pro rychlou reakci.
Získané lekce
K vytvoření prototypu není potřeba mnoho času. V našem případě byl připraven už za 4 měsíce. S ním jsme získali nové metriky, a po 10 měsících od začátku vývoje jsme dostali první produkční provoz. Poté začala nudná a velmi složitá práce: postupně produktizovat a škálovat systém, migrovat hlavní provoz a učit se na chybách. Tento efektivní proces nebude lineární — navzdory veškerému úsilí nelze všechno předpovědět. Mnohem efektivnější je rychlá iterace a reagování na nová data.
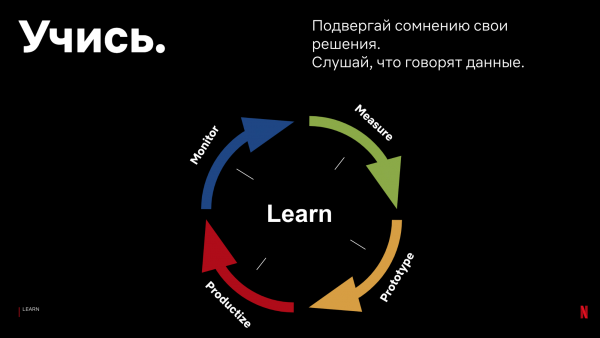
Na základě našich zkušeností vám můžeme doporučit následující:
- Nevěřte intuici.
Naše intuice nás neustále zrazovala, navzdory obrovskému zkušenostem členů týmu. Například jsme špatně předpověděli očekávané zrychlení od používání proxy CDN, nebo chování TCP Anycast.
- Získávejte data z produkce.
Je důležité co nejrychleji získat alespoň malé množství produkčních dat. Počet unikátních případů, konfigurací a nastavení v laboratorních podmínkách je prakticky nemožné dosáhnout. Rychlý přístup k výsledkům vám umožní rychleji se dozvědět o potenciálních problémech a zohlednit je v architektuře systému.
- Nesledujte cizí rady a výsledky — sbírejte svá vlastní data.
Dodržujte principy sběru a analýzy dat, ale neberte slepě cizí výsledky a tvrzení. Jen vy můžete přesně vědět, co funguje pro vaše uživatele. Vaše systémy a vaši klienti se mohou výrazně lišit od ostatních firem. Naštěstí jsou nyní nástroje pro analýzu dostupné a snadno použitelné. Vaše získané výsledky nemusí odpovídat tomu, co uvádějí Netflix, Facebook, Akamai a další společnosti. V našem případě se výkonnost TLS, HTTP2 nebo statistiky DNS dotazů liší od výsledků Facebooku, Uberu, Akamai — protože máme jiná zařízení, klienty a datové toky.
- Nesnažte se bezdůvodně a bez posouzení účinnosti následovat módní trendy.
Začněte s jednoduchým. Lépe je vytvořit jednoduchý funkční systém za krátký čas, než trávit ohromné množství času vývojem komponent, které nepotřebujete. Řešte úkoly a problémy, které jsou důležité na základě vašich měření a výsledků.
- Buďte připraveni na nová použití.
Tak jako je obtížné předpovědět všechny problémy, je těžké předem odhadnout výhody a použití. Berte si příklad ze startupů — jejich schopnost přizpůsobit se potřebám klientů. Ve vašem případě můžete objevit nové problémy a jejich řešení. V našem projektu jsme si dali za cíl snížit prodlevu žádostí. Nicméně během analýzy a diskuzí jsme si uvědomili, že proxy servery můžeme také využívat:
- pro vyvažování provozu mezi regiony AWS, a snížení nákladů;
- pro modelování stability CDN;
- pro konfiguraci DNS;
- pro konfiguraci TLS/TCP.
Závěr
Ve zprávě jsem popsal, jak Netflix řeší problém zrychlování internetových žádostí mezi klienty a cloudem. Jak shromažďujeme data pomocí systému vzorkování u klientů a používáme shromážděná historická data k nasměrování produkčních žádostí od klientů nejrychlejší cestou na internetu. Jak využíváme principy fungování síťových protokolů, naši CDN infrastrukturu, backbone síť a DNS servery k dosažení tohoto cíle.
Nicméně naše řešení je pouze příkladem toho, jak jsme takový systém v Netflixu implementovali. Co fungovalo pro nás. Aplikační část mé zprávy pro vás — principy vývoje a údržby, kterými se řídíme a dosahujeme dobrých výsledků.
Naše řešení problému vám nemusí vyhovovat. Nicméně teorie a principy vývoje zůstávají, i když nemáte vlastní CDN infrastrukturu, nebo pokud se podstatně liší od naší.
Dále zůstává důležitost rychlosti žádostí pro podnikání. A i pro jednoduchou službu je třeba učinit rozhodnutí: mezi „cloudovými“ poskytovateli, umístěním serverů, CDN a DNS poskytovateli. Vaše volba ovlivní efektivitu internetových žádostí pro vaše klienty. A pro vás je důležité toto vliv měřit a chápat.
Začněte jednoduchými řešeními, pečujte o to, jak měníte produkt. Učte se během procesu a zlepšujte systém na základě dat od vašich klientů, vaší infrastruktury a vašeho podnikání. Myslete na možnost nečekaných poruch během návrhu. A pak budete moci urychlit váš proces vývoje, zlepšit efektivitu řešení, vyhnout se nadměrné zátěži na podporu a spát klidně.
V tomto roce v online formátu. Budete moci položit otázky jednomu z otců DevOps, samotnému Johnu Willisi!
Zdroj: habr.com
