

Ahoj všichni, jmenuji se Sergej Emeljancič. Jsem vedoucím společnosti Audit-Telecom, hlavním vývojářem a autorem systému Veliam. Rozhodl jsem se napsat článek o tom, jak jsme s přítelem zakládali outsourcingovou společnost, vyvinuli software pro sebe a následně ho začali rozšiřovat všem zájemcům formou SaaS. Mluvím o tom, jak jsem kategoricky nevěřil tomu, že je to možné. V článku bude nejen příběh, ale i technické detaily ohledně vývoje produktu Veliam, včetně některých částí zdrojového kódu. Podělím se o chyby, které jsme udělali, a o to, jak jsme je následně opravovali. Měl jsem pochybnosti, zda takový článek publikovat. Ale pak jsem si řekl, že je lepší to udělat, získat zpětnou vazbu a poučit se, než článek nezveřejnit a přemýšlet o tom, jaké by to bylo…
Pozadí
Pracoval jsem v jedné firmě jako IT zaměstnanec. Firma byla poměrně velká s rozsáhlou síťovou strukturou. Nebudu se zaměřovat na své pracovní povinnosti, řeknu jen, že mezi nimi rozhodně nebylo navrhování něčeho nového.
Měli jsme monitoring, ale čistě z akademického zájmu jsem chtěl zkusit napsat svůj nejjednodušší. Nápad byl takový: chtěl jsem, aby to bylo ve webovém provedení, abych se mohl bez instalace jakýchkoli klientů snadno přihlásit a zjistit, co se děje se sítí z jakéhokoli zařízení, včetně mobilního zařízení přes Wi-Fi, a také jsem chtěl rychle pochopit, v jaké místnosti se nachází zařízení, které „onemocnělo“, protože existovaly velmi přísné požadavky na dobu reakce na podobné problémy. Nakonec se mi v hlavě zrodil plán napsat jednoduchou webovou stránku, na které by bylo pozadí JPEG se schématem sítě, vyříznout na tomto obrázku zařízení s jejich IP adresami a nad obrázkem v potřebných souřadnicích zobrazit dynamický obsah ve formě zeleného nebo blikajícího červeného IP adresy. Úkol je stanoven, začínáme.
Dříve jsem se zabýval programováním v Delphi, PHP, JS a velmi povrchně v C++. Poměrně dobře rozumím fungování sítí. VLAN, směrování (OSPF, EIGRP, BGP), NAT. To bylo dostatečné k napsání prototypu primitivního monitoringu samostatně.
Napsal jsem to, co jsem měl na mysli, v PHP. Server Apache a PHP běžel na Windows, protože mi Linux v té době přišel jako něco nepochopitelného a velmi složitého. Jak se později ukázalo, hodně jsem se mýlil a v mnoha ohledech je Linux mnohem jednodušší než Windows, ale to je jiná téma a všichni víme, kolik vášní se o tom vede. Plánovač úloh Windows spouštěl s malým intervalem (přesně si nepamatuji, ale něco jako jednou za tři sekundy) PHP skript, který prováděl jednoduchou pingovou kontrolu všech objektů a ukládal stav do souboru.
system("ping -n 3 -w 100 {$ip_address}");
Ano, práce s databázemi v té době pro mě také nebyla zvládnutá. Nevěděl jsem, že je možné paralelizovat procesy, a procházení všemi uzly sítě zabralo hodně času, protože to probíhalo v jednom vlákně. Zejména problémy nastávaly, když několik uzlů nebylo dostupných, protože každý z nich zdržoval skript o 300 ms. Na straně klienta byla jednoduchá cyklická funkce, která s několika sekundovými intervaly stahovala aktualizované informace ze serveru pomocí Ajaxového dotazu a aktualizovala uživatelské rozhraní. A pak po třech neúspěšných pinge po sobě, pokud byla na počítači otevřená webová stránka s monitorováním, hrála veselá melodie.
Když všechno vyšlo, byl jsem velmi inspirován výsledkem a přemýšlel jsem, co bych tam mohl přidat (s ohledem na své znalosti a možnosti). Ale nikdy se mi nelíbily systémy s milionem grafů, které jsem tehdy považoval, a považuji do dnešního dne, většinou za zbytečné. Chtěl jsem přidávat jen to, co by mi skutečně pomáhalo v práci. Tento princip až dodnes zůstává jako zásadní při vývoji Veliam. Dále jsem si uvědomil, že by bylo skvělé, kdybych nemusel mít otevřený monitoring a vědět o problémech, a když už by problém nastal, otevřít stránku a podívat se, kde se nachází problematický prvek sítě a co s ním dále dělat. E-mail jsem tehdy nijak nečetl, jednoduše jsem ho nepoužíval. Narazil jsem na internetu na SMS brány, na které lze poslat GET nebo POST požadavek a oni mi pošlou SMS na mobil s textem, který napíšu. Hned jsem pochopil, že to velmi chci. A začal jsem studovat dokumentaci. Po nějaké době se mi to podařilo a nyní jsem dostával SMS o problémech v síti na mobil s názvem "zhrouceného objektu". Ačkoli systém byl primitivní, byl napsán mnou samotným, a co mě tehdy nejvíce motivovalo k jeho rozvoji — to, že je to aplikace, která mi skutečně pomáhá v práci.
A nastal den, kdy v práci selhal jeden z internetových kanálů, a má monitorovací zařízení mi o tom nijak nedalo najevo. Google DNS byly stále vynikající. Přišel čas přemýšlet, jak monitorovat, zda je komunikační kanál živý. Bylo několik různých nápadů, jak to udělat. K některému zařízení jsem měl omezený přístup. Musel jsem vymyslet, jak zjistit, který z kanálů je živý, aniž bych měl možnost se na to podívat přímo na samotném síťovém vybavení. Tehdy mě kolega navrhl, že možná sledování trasy k veřejným serverům se může lišit v závislosti na tom, kterým kanálem se nyní komunikovalo na internet. Ověřil jsem to a bylo to tak. Při sledování trasy byly různé trasy.
system(“tracert -d -w 500 8.8.8.8”);
Tak vznikl další skript, a vlastně byla trasa z nějakého důvodu přidána na konec téhož skriptu, který pingoval všechna zařízení v síti. Bylo to další dlouhý proces, který probíhal ve stejném vláknu a zpomaloval celou práci skriptu. Ale tehdy to nebylo tak zřejmé. Ale tak či onak, plnil svou úlohu, v kódu bylo tvrdě napsáno, jaká by měla být trasa pro každý z kanálů. Tak začal fungovat systém, který již monitoroval (pěkně řečeno, protože se nezbíraly žádné metriky, pouze ping) síťová zařízení (routery, switche, wifi atd.) a komunikační kanály se světem. SMS zprávy přicházely pravidelně a na schématu bylo vždy dobře vidět, kde je problém.
Dále, v běžné práci jsem se musel zabývat krosováním. A každou chvíli jsem musel vstupovat do Cisco switchů, abych zjistil, který interface použít, což mě už nudilo. Jak by bylo skvělé kliknout na monitorování na objekt a vidět seznam jeho rozhraní s popisy. Ušetřilo by mi to čas. A v tomto schématu by nebylo potřeba spouštět Putty nebo SecureCRT, zadávat přihlašovací údaje a příkazy. Jednoduše jsem kliknul v monitorování, uviděl, co potřebuji, a šel dělat svou práci. Začal jsem hledat, jak mohu interagovat se switchem. Na první pohled byly hned dvě možnosti: SNMP nebo se přihlásit na switch přes SSH, zadat potřebné příkazy a analyzovat výsledek. SNMP jsem zavrhl kvůli složitosti implementace, neměl jsem trpělivost na čekání na výsledek. Se SNMP bych musel dlouho procházet MIB, na základě těchto dat vytvářet informace o rozhraních. Existuje úžasný příkaz v CISCO.
show interface statusUkazuje přesně to, co potřebuji pro křížové odkazy. K čemu se mučit s SNMP, když chci jen vidět výstup tohoto příkazu, pomyslel jsem si. Po nějaké době jsem tuto možnost realizoval. Klikl jsem na objekt na webové stránce. Aktivovala se událost, na kterou AJAX klient volal server, a ten se naopak připojil přes SSH k potřebnému přepínači (přihlašovací údaje byly zakódovány v kódu, neměl jsem chuť to zdobit, dělat nějaké samostatné nabídky, kde bych mohl měnit účty z rozhraní, potřeboval jsem výsledek a co nejrychleji) vložil jsem tam výše uvedený příkaz a poslal ho zpět do prohlížeče. Tak jsem začal vidět informace o rozhraních jedním kliknutím myši. Bylo to nesmírně pohodlné, zvlášť když jsem musel tyto informace sledovat na různých přepínačích najednou.
Monitorování kanálů na základě trasování se nakonec ukázalo jako ne nejlepší nápad, protože se někdy prováděly práce na síti a trasování se mohlo měnit a monitorování začalo křičet, že jsou problémy s kanálem. Po strávení spousty času analýzou jsem si uvědomil, že všechny kanály fungují, a moje monitorování mě klamalo. Nakonec jsem požádal kolegy, kteří spravovali kanálové přepínače, aby mi jednoduše posílali syslog, kdy se měnilo stav viditelnosti sousedů (neighbor). Bylo tedy mnohem jednodušší, rychlejší a pravdivější než trasování. Přišla událost typu neighbor lost a okamžitě jsem udělal oznámení o pádu kanálu.
Dále se na kliknutí na objekt objevilo ještě několik příkazů a přidal se SNMP pro sběr některých metrik, no a tím to vlastně skončilo. Systém se dále nijak nevyvíjel. Dělal vše, co jsem potřeboval, byl to dobrý nástroj. Mnozí čtenáři mi jistě řeknou, že pro řešení těchto úloh je už spousta softwaru na internetu. Ale ve skutečnosti jsem tehdy nenašel žádné bezplatné produkty a velmi jsem chtěl rozvíjet programovací dovednosti, a co může lépe k tomu povzbuzovat než reálný praktický úkol. Tím byla první verze monitorování dokončena a dále nebyla modifikována.
Založení společnosti Audit-Telecom
Jak čas plynul, začal jsem si přivydělávat v dalších firmách, což mi pracovní rozvrh umožňoval. Práce v různých společnostech rychle zvyšuje dovednosti v různých oblastech a dobře rozšiřuje obzory. Existují firmy, kde, jak se říká, jsi i švec, i žnec a na dudách hraješ. Z jedné strany je to složité, ale na druhé straně, pokud se nezapomeneš snažit, stáváš se specialistou širokého profilu, což umožňuje rychleji a efektivněji řešit úkoly, protože víš, jak funguje příbuzná oblast.
Můj přítel Pavel (také IT odborník) se mě neustále snažil přimět k vlastnímu byznysu. Bylo nespočet nápadů s různými variantami vlastního podnikání. Tohle se diskutovalo více než rok. A nakonec to nikam nevedlo, protože jsem skeptik a Pavel snílek. Každýkrát, když navrhl nějaký nápad, nikdy jsem mu nevěřil a odmítal jsem se zapojit. Ale moc jsme toužili otevřít si vlastní byznys.
Nakonec jsme dokázali najít variantu, která vyhovovala nám oběma, a věnovali jsme se tomu, co umíme. V roce 2016 jsme se rozhodli založit IT firmu, která bude pomáhat podnikům s řešením IT úkolů. To zahrnuje nasazení IT systémů (1C, terminálové servery, poštovní servery atd.), jejich údržbu, klasický HelpDesk pro uživatele a správu sítě.
Upřímně řečeno, když jsme firmu zakládali, nevěřil jsem v ni asi 99,9 %. Ale nějakým způsobem mě Pavel přiměl to zkusit, a jak se ukázalo, měl pravdu. Přispěli jsme si s Pavlem po 300 000 rublů, zaregistrovali novou společnost „Audit-Telecom“, pronajali maličkou kancelář, udělali super vizitky, no zkrátka, jako asi většina nezkušených začínajících podnikatelů, a začali hledat klienty. Hledání klientů – to je vůbec samostatný příběh. Možná napíšeme samostatný článek v rámci firemního blogu, pokud to někoho bude zajímat. Studené telefonáty, letáky a podobně. To nedávalo žádné výsledky. Jak teď čtu v mnoha příbězích o byznysu, v mnohém záleží na štěstí. Měli jsme štěstí. A doslova pár týdnů po založení firmy se k nám obrátil můj bratr Vladimír, který přivedl prvního klienta. Nebudu unavovat detaily spolupráce s klienty, článek o tom není, řeknu pouze, že jsme jeli na audit, odhalili kritická místa a ta místa se rozpadla, zatímco se rozhodovalo, zda s námi trvale spolupracovat jako s outsourcery. Poté bylo okamžitě přijato pozitivní rozhodnutí.
Dále, většinou prostřednictvím doporučení od známých, začaly přicházet další firmy, které jsme obsluhovali. Helpdesk byl v jednom systému. Připojení k síťovému vybavení a serverům v jiném, přesněji řečeno u každého jinak. Někdo si uchovával zástupce, někdo používal adresáře RDP. Monitorování bylo další samostatný systém. Pracovat pro tým v roztroušených systémech je velmi nepohodlné. Důležité informace jsou ztraceny z dohledu. Například, terminálový server u klienta se stal nedostupným. Okamžitě přicházejí žádosti od uživatelů tohoto klienta. Specialista podpory zakládá žádost (přijala se po telefonu). Kdyby byly incidenty a žádosti registrovány v jednom systému, specialista podpory by okamžitě viděl, v čem je problém uživatele, a mohl by mu to říct, zatímco by se už připojoval k potřebnému objektu pro řešení situace. Všichni jsou informováni o taktickém stavu a pracují koordinovaně. Takový systém, který by to všechno spojil, jsme nenašli. Bylo jasné, že je třeba vytvořit vlastní produkt.
Pokračování práce na našem systému monitorování
Bylo jasné, že systém, který byl napsán dříve, vůbec nevyhovuje aktuálním úkolům. Ani z hlediska funkčnosti, ani z hlediska kvality. Bylo tedy přijato rozhodnutí napsat systém úplně od začátku. Graficky to mělo vypadat zcela jinak. Mělo to být hierarchické uspořádání, aby bylo možné rychle a pohodlně otevírat potřebné objekty u potřebného klienta. Schéma, jaké bylo v první verzi, se v tomto případě ukázalo jako zcela neopodstatněné, protože klienti byli různí a vůbec nezáleželo na tom, v jakých prostorách je zařízení umístěno. To již bylo přeneseno na dokumentaci.
Takže úkoly:
- Hierarchická struktura;
- Nějaká serverová část, kterou lze umístit u klienta ve formě virtuálního stroje pro sběr potřebných metrik a odesílání na centrální server, který to vše shrne a zobrazí nám;
- Upozornění. Taková, která nelze přehlédnout, protože v té době nebyla možnost, aby někdo jen seděl a sledoval monitor;
- Systém žádostí. Začali se objevovat klienti, kterým jsme zajišťovali nejen serverové a síťové vybavení, ale i pracovní stanice;
- Možnost rychle se připojit k serverům a zařízením z systému;
Úkoly jsou stanoveny, začínáme psát. Současně zpracováváme žádosti od klientů. V té době nás již bylo 4. Začali jsme psát obě části, jak centrální server, tak server pro instalaci u klientů. V tomto okamžiku už nám Linux nebyl cizí a bylo přijato rozhodnutí, že virtuální stroje, které budou u klientů, budou na Debianu. Nebudou žádné instalátory, prostě uděláme projekt serverové části na jednom konkrétním virtuálním stroji a pak ji jednoduše zklonujeme k potřebnému klientovi. To byla další chyba. Později se ukázalo, že v takovém schématu nebyl vůbec propracován mechanismus aktualizací. Tedy přidali jsme nějakou novou funkci, a pak byl velký problém ji rozšířit na všechny servery klientů, ale k tomu se vrátíme později, vše po pořádku.
Vytvořili jsme první prototyp. Byl schopný pingovat potřebná síťová zařízení našich klientů a servery a posílat tato data na náš centrální server. Ten následně aktualizoval tato data v celkovém souhrnu na centrálním serveru. Tady budu psát nejen příběh o tom, jak a co se podařilo, ale také jaké amatérské chyby byly učiněny a jak jsme za to museli platit časem. Tak tedy, celé stromové objekty byly uchovávány v jednom jediném souboru ve formě serializovaného objektu. Dokud jsme do systému připojili několik klientů, všechno bylo víceméně v pořádku, ačkoli se občas objevily nějaké artefakty, které byly zcela nepochopitelné. Ale když jsme do systému připojili desítku serverů, začaly se dít zázraky. Někdy, z neznámého důvodu, všechny objekty v systému prostě zmizely. Je důležité poznamenat, že servery, které měl klient, posílaly data na centrální server každých několik sekund prostřednictvím POST požadavku. Pozorný čtenář a zkušený programátor už určitě tuší, že vznikal problém s víc než jedním přístupem k tomu samému souboru, ve kterém byl uchováván serializovaný objekt, z různých vláken současně. A právě když k tomu docházelo, objevovaly se zázraky s mizícími objekty. Soubor se prostě stal prázdným. Ale toto všechno se neobjevilo hned, ale až v průběhu provozu s několika servery. Během této doby byla přidána funkčnost pro skenování portů (servery posílaly na centrální nejen informace o dostupnosti zařízení, ale i o otevřených na nich portech). To bylo provedeno pomocí vyvolání příkazu:
$connection = @fsockopen($ip, $port, $errno, $errstr, 0.5);
výsledky často nebyly správné a skenování trvalo velmi dlouho. Úplně jsem zapomněl na ping, ten byl prováděn přes fping:
system("fping -r 3 -t 100 {$this->ip}");
To všechno také nebylo paralelizováno, a proto byl proces velmi dlouhý. Později již do fping byl předán celý seznam potřebných pro kontrolu IP adres a zpět jsme dostali hotový seznam těch, kdo se ozvali. Na rozdíl od nás, fping uměl paralelizovat procesy.
Další běžnou rutinou bylo nastavování různých služeb přes WEB. Například ECP od MS Exchange. V podstatě je to jen odkaz. A rozhodli jsme se umožnit přidávat takové odkazy přímo do systému, abychom nemuseli hledat v dokumentaci nebo jinde, jak se přihlásit do ECP konkrétního klienta. Tak se objevila myšlenka o zdrojových odkazech pro systém, jejich funkčnost je dostupná dodnes a nezměnila se, tedy téměř.
Funkce zdrojových odkazů ve Veliamu
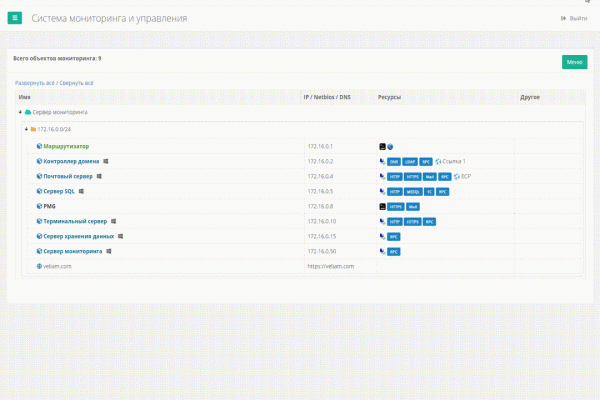
Vzdálená připojení
Takhle to vypadá v akci v aktuální verzi Veliamu
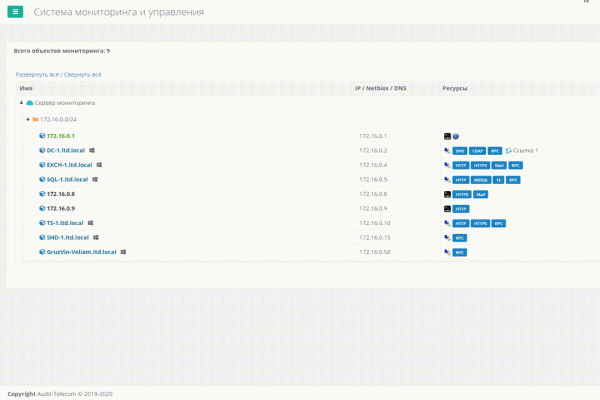
Jedním z cílů bylo rychlé a pohodlné připojení k serverům, kterých už je hodně (více než stovka), a procházení miliony předem uložených RDP zkratek bylo nesmírně nepohodlné. Potřebovali jsme nástroj. Na internetu existuje software, který funguje něco jako adresář pro taková RDP připojení, ale nejsou integrovány se systémem monitorování a účty se nedají uložit. Každý den zadávat údaje pro různé klienty je naprostý chaos, když se připojujete desítkykrát ke různým serverům. U SSH je to o něco lepší, existuje spousta dobrého softwaru, kde můžete taková připojení organizovat do složek a uchovávat údaje. Ale jsou dva problémy. Zaprvé, pro připojení RDP a SSH jsme nenalezli žádný univerzální program. Zadruhé, pokud nejsem u svého počítače a potřebuji se rychle připojit, nebo jsem jednoduše přeinstaloval systém, musím se podívat do dokumentace, abych zjistil účet od tohoto klienta. To je nepohodlné a zbytečná ztráta času.
Potřebná hierarchická struktura podle klientských serverů už byla v našem interním produktu. Jen bylo potřeba vymyslet, jak tam přidat rychlá připojení k potřebnému vybavení. Pro začátek, alespoň uvnitř své sítě.
Vzhledem k tomu, že klientem v našem systému byl prohlížeč, který nemá přístup k místním zdrojům počítače, aby mohl jednoduše spustit požadovanou aplikaci nějakým příkazem, bylo vymyšleno udělat vše přes 'Windows custom url scheme'. Tak vznikl jakýsi 'plugin' do našeho systému, který jednoduše zahrnoval Putty a Remote Desktop Plus a při instalaci jen zaregistroval URI schéma ve Windows. Teď, když jsme chtěli připojit k objektu přes RDP nebo SSH, klikli jsme na tuto akci v našem systému a spustila se práce Custom URI. Spuštěn byl standardní mstsc.exe vestavěný ve Windows nebo putty, který byl součástí 'pluginu'. Beru slovo plugin do uvozovek, protože to není plugin prohlížeče v klasickém smyslu.
To už bylo alespoň něco. Pohodlná adresářová kniha. A u Putty to bylo opravdu dobré, protože jako vstupní parametry bylo možné zadat jak IP připojení, tak uživatelské jméno a heslo. Tedy k Linux serverům v naší síti jsme se už připojovali jedním kliknutím bez zadávání hesel. Ale s RDP to není tak jednoduché. V standardním mstsc nelze poskytnout přihlašovací údaje jako parametry. Na pomoc přišel Remote Desktop Plus. Ten to umožňoval. Teď už se bez něj obejdeme, ale dlouho byl věrným pomocníkem v našem systému. S HTTP(S) weby bylo vše jednoduché, tyto objekty se prostě otevřely v prohlížeči a bylo to. Pohodlné a praktické. Ale to bylo štěstí jen ve vnitřní síti.
Jelikož drtivou většinu problémů jsme řešili vzdáleně z kanceláře, nejjednodušší bylo udělat VPN pro klienty. A pak jsme se z našeho systému mohli připojit i k nim. Ale i tak to bylo poněkud nepohodlné. Pro každého klienta bylo potřeba mít na každém počítači spoustu zapamatovaných VPN připojení a před připojením k nějakému bylo nutné aktivovat příslušný VPN. Takovéto řešení jsme používali poměrně dlouho. Ale množství klientů roste, počet VPN také a všechno to začalo být obtěžující a bylo potřeba s tím něco udělat. Zejména slzy se mi hrnuly do očí po přeinstalaci systému, kdy bylo nutné znovu zadávat desítky VPN připojení do nového profilu Windows. Dostačující, říkal jsem si a začal přemýšlet, co s tím udělat.
Stalo se tradicí, že všichni naši zákazníci měli jako routery zařízení od známé společnosti Mikrotik. Tyto zařízení jsou velmi funkční a pohodlné pro provádění téměř jakýchkoli úkolů. Mezi nevýhodami je, že se často „ukradnou“. Tento problém jsme vyřešili jednoduše tím, že jsme uzavřeli všechny přístupy zvenčí. Bylo však potřeba mít k nim přístup, aniž bychom museli jezdit k zákazníkům na místo, protože to trvá dlouho. Jednoduše jsme vytvořili tunely k těmto Mikrotikům a zařadili je do samostatného poolu, bez jakékoliv routingu, abychom zabránili sloučení naší sítě se sítěmi zákazníků a s jejich mezi sebou.
Přišla mi myšlenka udělat to tak, že když kliknu na požadovaný objekt v systému, centrální monitorovací server, který zná přihlašovací údaje pro SSH všech zákaznických Mikrotiků, se připojí k potřebnému, vytvoří pravidlo pro forwarding na požadovaný hostitel s potřebným portem. Zde je hned několik aspektů. Řešení není univerzální – bude fungovat pouze pro Mikrotik, jelikož syntaktické příkazy u všech routerů jsou různá. Také bylo potřeba nějakým způsobem tyto forwardy následně mazat, a serverová část našeho systému vlastně nemohla sledovat, kdy jsem skončil svou relaci práce přes RDP. No a takový forwarding je také bezpečnostní slabinou pro klienta. Nehonili jsme se ani za univerzálností, protože produkt byl používán pouze v naší společnosti a neměli jsme ani myšlenky ho dostat na veřejnost.
Každý problém byl vyřešen svým způsobem. Když se vytvářelo pravidlo, byl tento forwarding dostupný pouze pro jednu konkrétní externí IP adresu (ze které bylo připojení inicializováno). Takže se podařilo vyhnout bezpečnostním dírám. Ale při každém takovém připojení se přidalo pravidlo na Mikrotik na stránku NAT a nečistilo se. A všichni ví, že čím více tam je pravidel, tím více se zatěžuje procesor routeru. A celkově jsem nemohl přijmout, že jednou vstoupím na nějaký Mikrotik a tam budou stovky mrtvých, nikomu nepoužitelných pravidel.
Pokud náš server nemůže sledovat stav připojení, ať si je sleduje MikroTik sám. Napsal jsem skript, který neustále sledoval všechna pravidla pro přesměrování s daným popisem (description) a kontroloval, zda existuje TCP připojení k odpovídajícímu pravidlu. Pokud nějakou dobu žádné nebylo, pravděpodobně bylo připojení již ukončeno a přesměrování lze odstranit. Všechno fungovalo, skript dobře pracoval.
Nehledě na to, tady je:
global atmonrulecounter {"dontDelete"="dontDelete"}
:foreach i in=[/ip firewall nat find comment~"atmon_script_main"] do={
	local dstport [/ip firewall nat get value-name="dst-port" $i]
	local dstaddress [/ip firewall nat get value-name="dst-address" $i]
	local dstaddrport "$dstaddress:$dstport"
	#log warning message=$dstaddrport
	local thereIsCon [/ip firewall connection find dst-address~"$dstaddrport"]
	if ($thereIsCon = "") do={
		set ($atmonrulecounter->$dstport) ($atmonrulecounter->$dstport + 1)
		#:log warning message=($atmonrulecounter->$dstport)
		if (($atmonrulecounter->$dstport) > 5) do={
			#log warning message="Odstraňuji nat pravidla přidaná automaticky skriptem atmon_script"
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_main_$dstport"]
			/ip firewall nat remove [/ip firewall nat find comment~"atmon_script_sub_$dstport"]
			set ($atmonrulecounter->$dstport) 0
		}
	} else {
		set ($atmonrulecounter->$dstport) 0
	}
}
Určitě by to šlo udělat lépe, rychleji atd., ale fungovalo to, nezatěžovalo MikroTiky a výborně si s tím poradil. Konečně jsme se mohli připojit k serverům a síťovým zařízením zákazníků jen jedním kliknutím myši. Bez VPN a zadávání hesel. Práce se systémem se stala opravdu velmi pohodlnou. Čas na údržbu se zkrátil, a my jsme trávili čas prací, a ne připojením k potřebným objektům.
Zálohování Mikrotik
Měli jsme nastaveno zálohování všech MikroTiků na FTP. A celkově to bylo v pořádku. Ale když bylo potřeba získat zálohu, bylo nutné otevřít toto FTP a hledat ji tam. Měli jsme systém, kde jsou všichni routery zaregistrováni, umíme komunikovat s zařízeními přes SSH. Napadlo mě, proč to neudělat tak, aby systém každodenně stahoval zálohy ze všech MikroTiků. A pustil jsem se do realizace. Připojili jsme se, udělali zálohu a přenesli ji do úložiště.
Kód skriptu v PHP pro získání zálohy z MikroTiku:
<?php

	$IP = '0.0.0.0';
	$LOGIN = 'admin';
	$PASSWORD = '';
	$BACKUP_NAME = 'test';

    $connection = ssh2_connect($IP, 22);

    if (!ssh2_auth_password($connection, $LOGIN, $PASSWORD)) exit;

    ssh2_exec($connection, '\/system backup save name="atmon" password="atmon"');
    stream_get_contents($connection);
    ssh2_exec($connection, '\/export file="atmon.rsc"');
    stream_get_contents($connection);
    sleep(40); \/\/ Waiting bakup makes

    $sftp = ssh2_sftp($connection);

    \/\/ Download backup file
    $size = filesize("ssh2.sftp:\/\/{$sftp}\/atmon.backup");
    $stream = fopen("ssh2.sftp:\/\/{$sftp}\/atmon.backup", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read < $len && ($buf = fread($stream, $len - $read))) {
        $read += strlen($buf);
        $contents .= $buf;
    }
    file_put_contents ($BACKUP_NAME . '.backup',$contents);
    @fclose($stream);

    sleep(3);
    \/\/ Download RSC file
    $size = filesize("ssh2.sftp:\/\/{$sftp}\/atmon.rsc");
    $stream = fopen("ssh2.sftp:\/\/{$sftp}\/atmon.rsc", 'r');
    $contents = '';
    $read = 0;
    $len = $size;
    while ($read
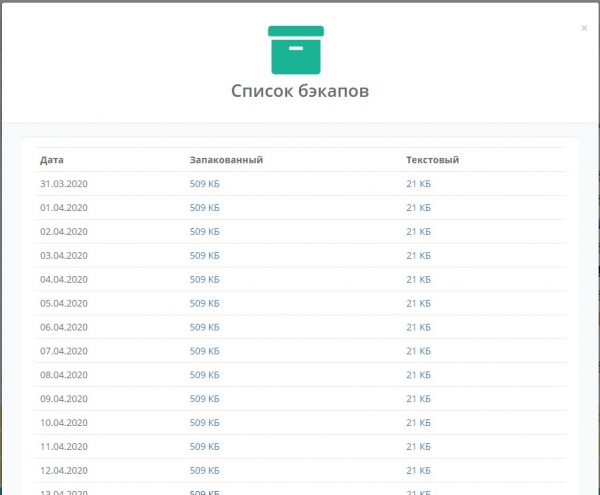
Zálohování probíhá ve dvou podobách — jako binární soubor a textová konfigurace. Binární soubor umožňuje rychlé obnovení potřebné konfigurace, zatímco textová verze pomáhá pochopit, co dělat, pokud dojde k nucené výměně zařízení a binární soubor nelze nahrát. Výsledkem je další užitečná funkce v systému. A při přidávání nových mikrotiků nebylo potřeba nic nastavovat, jednoduše se přidal objekt do systému a zadal se pro něj účet pro SSH. Systém pak automaticky prováděl zálohy. V aktuální verzi SaaS Veliam tato funkce zatím není k dispozici, ale brzy ji portujeme.
Snímky, jak to vypadalo ve vnitřním systému
Přechod na normální uchovávání v databázi
Dříve jsem psal o tom, že se objevovaly artefakty. Někdy celý seznam objektů v systému jednoduše zmizel, někdy při editaci objektu informace nebyla ukládána a musel jsem objekt přejmenovávat třikrát. To všechny strašně rozčilovalo. Zmiznutí objektů se dělo zřídka a dalo se snadno obnovit obnovením souboru, ale selhání při editaci objektů se stávalo docela často. Pravděpodobně jsem to zpočátku neudělal přes databázi, protože jsem si nedokázal představit, jak může být strom se všemi vazbami udržován v ploché tabulce. Ta je plochá, zatímco strom je hierarchický. Dobré řešení pro více přístupů, a později (s komplikací systému) i transakční, je databázový systém. Jsem si jistý, že nejsem první, kdo se s tímto problémem setkal. Začal jsem hledat na Googlu. Ukázalo se, že už bylo všechno vymýšleno přede mnou a existuje několik algoritmů, které staví strom z ploché tabulky. Podíval jsem se na každý z nich a implementoval jsem jeden z nich. Ale to už byla nová verze systému, protože jsem kvůli tomu musel přepsat docela dost. Výsledek byl logický, problémy s náhodným chováním systému zmizely. Někdo může říct, že chyby byly dost amatérské (jednovláknové skripty, uchovávání informací, ke kterým byl vícečetný současný přístup z různých vláken v souboru atd.) v oblasti vývoje softwaru. Možná to tak je, ale moje hlavní práce byla správa a programování bylo vedlejší pro radost, a jednoduše jsem neměl zkušenosti s prací v týmu programátorů, kde by mi takové elementární věci okamžitě doporučili starší kolegové. Proto jsem si všechny tyto šrámy způsobil sám, ale velmi dobře jsem si materiál osvojil. A také, moje práce zahrnovala setkání s klienty, aktivity zaměřené na propagaci firmy, spoustu administrativních záležitostí uvnitř společnosti a mnohé další. Ale ať tak či onak, to, co existovalo, bylo požadováno. Kluci a já sami jsme produkt používali v každodenní práci. Byly i naprosto neúspěšné nápady a řešení, na které bylo vynaloženo čas, a nakonec bylo jasné, že to je nefunkční nástroj, který nikdo nepoužíval a nedostal se do Veliam.
Podpora — HelpDesk
Stojí za to zmínit, jak vznikl HelpDesk. To je vůbec samostatný příběh, protože ve Veliam je to už třetí zcela nová verze, která se liší od všech předchozích. Teď je to jednoduchý systém, intuitivní, bez zbytečných ozdob a fint, s možností integrace s doménou, a také s možností přístupu k tomuto profilu uživatele odkudkoli pomocí odkazu v e-mailu. A co je nejdůležitější, je tu možnost připojit se z jakéhokoli místa (doma nebo v kanceláři) k žadateli prostřednictvím VNC přímo ze žádosti, bez VPN nebo přesměrování portů. Pověděl bych vám, jak jsme k tomu dospěli, co bylo předtím a jaká hrozná řešení jsme měli.
Připojovali jsme se k uživatelům přes všemi známý TeamViewer. Na všech počítačích, jejichž uživatele jsme obsluhovali, byl nainstalován TV. První, co jsme udělali špatně, a posléze to odstranili – byla vazba každého klienta na HWID. Jak se uživatel přihlásil do systému, aby podal žádost? Na všechny počítače, kromě TV, byla nainstalována speciální utilita napsaná v Lazarus (tady mnozí zakroutí hlavou a možná i začnou googlit, co to je, ale nejlépe ze všech kompilovaných jazyků jsem znal Delphi, a Lazarus je téměř totéž, jen zdarma). Každopádně uživatel spustil u sebe speciální dávkový skript, který spustil tuto utilitu, ta zase načetla HWID systému a poté se spustil prohlížeč a došlo k autorizaci. Proč to bylo uděláno? V některých firmách se počet obsluhovaných uživatelů počítá jednotlivě, a cena služby za každý měsíc se tvoří na základě počtu lidí. To je jasné, řeknete, ale proč vazba na hardware? Velmi jednoduše, někteří jednotlivci přišli domů a podali žádost z domácího notebooku ve stylu „udělejte mi to tady všechno hezky“. Kromě načítání HWID systému, utilita vytahovala z registru aktuální ID TeamVieweru a také ho k nám předávala. TeamViewer má API pro integraci. A my jsme tuto integraci udělali. Ale byla jedna překážka. Přes toto API se nedá připojit k počítači uživatele, když jasně neinitioval tuto relaci, a po pokusu o připojení musí ještě stisknout „potvrdit“. V té době se nám to zdálo logické, že bez souhlasu uživatele se nikdo nesmí připojit, a když je osoba u počítače, pak i relaci iniciuje a kladně odpoví na žádost o vzdálené připojení. Všechno se ukázalo jako jinak. Žadatelé zapomínali iniciovat relaci a museli jsme jim to říkat v telefonním rozhovoru. To zabíralo čas a nervovalo obě strany procesu. Navíc, vůbec nebylo neobvyklé, že člověk podává žádost, ale povolí připojení až když odchází na oběd. Protože problém není kritický a nechce, aby byl jeho pracovní proces přerušen. Takže nestiskne žádná tlačítka pro povolení připojení. Tak se objevil další funkce při autorizaci v HelpDesku – načítání ID TeamVieweru. Znali jsme stálé heslo, které se používalo při instalaci TeamVieweru. Spíše, to věděla jenom systém, protože bylo zabudováno do instalátoru, a do našeho systému. Podle toho byla tlačítko připojení z žádosti, na kterou stačilo stisknout, a hned se otevřel TeamViewer a došlo k připojení. Nakonec vznikly dva druhy možných připojení. Přes oficiální API TeamVieweru a naše vlastní. K mému překvapení se první téměř okamžitě přestalo používat, ačkoli bylo nařízení používat jej pouze ve zvláštních případech a když uživatel dává k tomu souhlas. I tak je dnes bezpečnost důležitá. Ale ukázalo se, že žadatelům to není potřeba. Naprosto jim nevadilo, že se k nim připojují bez tlačítka potvrzení. A pokud je to tak, pak i v budoucnu byla funkčnost připojení přes API zrušena pro nepotřebnost.
Přechod na multithreading v Linuxu
Otázka urychlení skenování sítě pro otevřenost předem určeného seznamu portů a jednoduché pingování síťových objektů se už dávno nabízela. První myšlenka, která mě napadla, byla multithreading. Hlavní doba, kterou trávím při pingu, je čekání na návrat paketu, a další ping nemůže začít, dokud se nevrátí předchozí paket. V podnicích, kde je více než 20 serverů a další síťové zařízení, to už fungovalo dost pomalu. Jedním balíčkem může docházet i k výpadkům, takže o tom není možné hned informovat systémového administrátora. Ten takový spam velmi rychle přestane vnímat. Proto je třeba pingovat každý objekt vícekrát, než vyvodíme závěr o nedostupnosti. Pokud se nechceme zabývat podrobnostmi, musíme paralelizovat, protože pokud to neuděláme, pravděpodobně se systémový administrátor dozví o problému od klienta, nikoli od monitorovacího systému.
Sám o sobě PHP nemá multithreading. Umožňuje multiprocesnost, můžeme forkovat. Ale já už měl v podstatě napsaný mechanismus pro dotazování a chtěl jsem udělat to, že bych jednou přečetl všechny potřebné uzly z databáze, pingoval je všechny najednou, počkal na odpověď od každého a teprve poté bych data zapsal. To šetří na počtu čtecích dotazů. Tato myšlenka skvěle zapadala do multithreadingu. Pro PHP existuje modul PThreads, který umožňuje skutečný multithreading, i když jsem musel strávit hodně času jeho nastavením na PHP 7.2, ale bylo to uděláno. Skenování portů a pingování se stalo rychlým. A místo 15 sekund na cyklus to nyní trvá 2 sekundy. To byl dobrý výsledek.
Rychlý audit nových společností
Jak vznikla funkce sběru různých metrik a charakteristik hardwaru? Je to jednoduché. Občas nám objednají jednoduše audit aktuální IKT infrastruktury. A to samé je také potřeba pro urychlení provedení auditu nového klienta. Bylo potřeba něco, co by umožnilo přijít do střední nebo velké společnosti a rychle se zorientovat, co vůbec mají. Ping v interní síti blokují, podle mého názoru, jen ti, kdo si chtějí zkomplikovat život, a takových je podle naší zkušenosti málo. Ale i ti se občas vyskytují. Proto je možné rychle oskenovat sítě na přítomnost zařízení jednoduchým pingem. Dále je lze přidat a oskenovat na otevřené porty, které nás zajímají. V podstatě tato funkce již byla, stačilo pouze přidat příkaz z centrálního serveru na podřízený, aby ten oskenoval určené sítě a přidal do seznamu vše, co najde. Zapomněl jsem zmínit, že se předpokládalo, že máme již hotový obraz s nastaveným systémem (podřízený monitorovací server), který jsme mohli jednoduše nasadit u klienta během auditu a připojit ho k našemu cloudu.
Výsledek auditu obvykle zahrnuje spoustu různých informací, a jedna z nich je — jaká zařízení jsou ve své síti. V první řadě nás zajímaly Windows servery a pracovní stanice Windows v rámci domény. Vzhledem k tomu, že v průměrných a velkých firmách je absence domény pravděpodobně výjimkou, průměrná velikost firmy, jak ji vidím, je 100+ lidí. Bylo potřeba vymyslet způsob, jak shromáždit data ze všech Windows strojů a serverů, znát jejich IP adresy a účet doménového administrátora, ale aniž bychom na každém z nich instalovali nějaký software. Na pomoc přichází rozhraní WMI. Windows Management Instrumentation (WMI) doslovně přeloženo znamená - nástroj pro správu Windows. WMI je jednou ze základních technologií pro centralizovanou správu a sledování fungování různých částí počítačové infrastruktury běžící na platformě Windows. Vzato z wikipedie. Dále jsem musel znovu pracovat na tom, abych sestavil wmic (což je klient WMI) pro Debian. Jakmile bylo vše připraveno, zbývalo pouze dotazovat potřebné uzly přes wmic na požadované informace. Přes WMI lze z Windows počítače získat téměř jakoukoli informaci, a co víc, skrze něj lze také spravovat počítač, například poslat ho na restart. Tak vzniklo shromažďování informací o Windows stanicích a serverech v našem systému. K tomu se přidávaly i aktuální informace o aktuálních ukazatelích zatížení systému. Tyto dotazujeme častěji, zatímco informace o hardwaru méně často. Po tomto se audit stal trochu příjemnějším.
Rozhodnutí o distribuci softwaru
Systém používáme sami každý den a je neustále otevřený pro každého technického zaměstnance. A pomysleli jsme si, že bychom se mohli podělit i s ostatními o to, co už máme. Systém nebyl ještě zcela připraven na distribuci. Bylo potřeba přepracovat velmi mnoho, aby se lokální verze proměnila v SaaS. To zahrnovalo změny různých technických aspektů v práci systému (vzdálené připojení, služba podpory), analýzu modulů co se týče licencování, shardování databází klientů, škálování každé ze služeb a vývoj systémů pro automatické aktualizace všech částí. Ale o tom bude druhá část článku.
Aktualizovat
Zdroj: habr.com
