

V Badoo neustále monitorujeme nové technologie a vyhodnocujeme, zda je náležité je využít v našem systému. Rádi bychom se s komunitou podělili o jedno z těchto zkoumání. Toto se věnuje Loki — systému pro agregaci logů.
Loki je řešení pro ukládání a prohlížení logů, a také tento stack poskytuje flexibilní systém pro jejich analýzu a odesílání dat do Prometheus. V květnu vyšlo nové aktualizace, které aktivně prosazují její tvůrci. Zajímalo nás, co všechno Loki umí, jaké možnosti nabízí a do jaké míry může sloužit jako alternativa k ELK — stacku, který aktuálně používáme.
Co je to Loki
Grafana Loki je sada komponentů pro plnohodnotný systém práce s logy. Na rozdíl od jiných podobných systémů je Loki založen na myšlence indexovat pouze metadata logů — štítky (labels), tak jako v Prometheus, a samotné logy komprimovat do samostatných chunků.
,
Předtím, než přejdeme k popisu toho, co lze dělat pomocí Loki, rád bych objasnil, co se rozumí pod «myšlenkou indexovat pouze metadata». Porovnejme přístup Loki a přístup k indexaci v tradičních řešeních, jako je Elasticsearch, na příkladu řetězce z logu nginx:
172.19.0.4 - - [01/Jun/2020:12:05:03 +0000] "GET /purchase?user_id=75146478&item_id=34234 HTTP/1.1" 500 8102 "-" "Stub_Bot/3.0" "0.001"Tradiční systémy parsují řetězec celý, včetně polí s velkým počtem unikátních hodnot user_id a item_id, a ukládají vše do velkých indexů. Výhodou tohoto přístupu je, že je možné rychle provádět složité dotazy, protože téměř všechna data jsou v indexu. Ale za to se platí tím, že index se stává velkým, což si žádá vyšší paměťové nároky. Nakonec se plnotextový index logů vyrovnává velikosti samotných logů. Aby bylo možné na něm rychle vyhledávat, musí být index nahrán v paměti. A čím více logů je, tím rychleji index roste a tím více paměti potřebuje.
Přístup Loki vyžaduje, aby byla ze stringu extrahována pouze nezbytná data, jejichž množství je malé. Tímto způsobem získáváme malý index a můžeme hledat data filtrací podle času a podle indexovaných polí, a poté skenovat zbývající pomocí regulárních výrazů nebo hledáním podřetězce. Proces se zdá být pomalý, ale Loki dělí dotaz na několik částí a provádí je současně, zpracovávající velké množství dat za krátkou dobu. Počet shardů a paralelních dotazů v nich je konfigurovatelný; tím pádem je množství dat, které lze zpracovat za jednotku času, lineárně závislé na počtu poskytnutých zdrojů.
Tento kompromis mezi velkým rychlým indexem a malým indexem s paralelním úplným průzkumem umožňuje Loki kontrolovat náklady systému. Mohou být flexibilně nastavovány a rozšiřovány podle potřeb.
Loki stack se skládá ze tří komponentů: Promtail, Loki, Grafana. Promtail shromažďuje logy, zpracovává je a odesílá do Loki. Loki je uchovává. A Grafana umí dotazovat data z Loki a zobrazovat je. Vlastně může být Loki použit nejen pro uchovávání logů a jejich vyhledávání. Celý stack poskytuje velké možnosti zpracování a analýzy přicházejících dat s použitím Prometheus way.
Popis procesu instalace lze nalézt .
Vyhledávání v logech
Vyhledávat v logech lze v speciálním rozhraní Grafana — Explorer. Pro dotazy se používá jazyk LogQL, velmi podobný PromQL, který se používá v Prometheus. V zásadě jej lze považovat za distribuovaný grep.
Rozhraní vyhledávání vypadá takto:
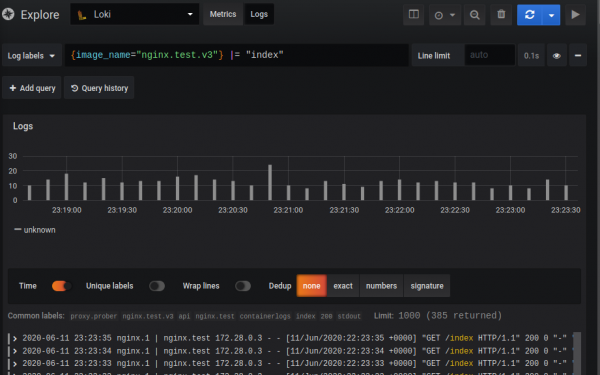
Samotný dotaz se skládá ze dvou částí: selector a filter. Selector je vyhledávání podle indexovaných metadat (labelů), které jsou přiřazeny logům, a filter je vyhledávací řetězec nebo regex, pomocí kterého se filtrují záznamy určené selektorem. V uvedeném příkladu: V složených závorkách — selektor, vše co následuje — filtr.
{image_name="nginx.promtail.test"} |= "index"Kvůli principu fungování Loki nelze provádět dotazy bez selektoru, ale labely lze nastavit jakkoli obecně.
Selector jsou key-value páry ve složených závorkách. Lze kombinovat selektory a zadávat různá vyhledávací kritéria pomocí operátorů =, != nebo regulárních výrazů:
{instance=~"kafka-[23]",name!="kafka-dev"}
// Najde logy s etiketou instance, které mají hodnoty kafka-2, kafka-3, a vyloučí dev
Filtr je text nebo regulární výraz, který filtrování všech dat získaných selektorem.
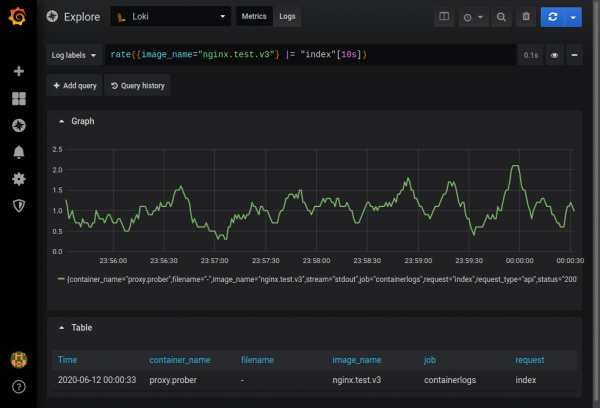
Existuje možnost získání ad-hoc grafů z získaných dat v režimu metrics. Například lze zjistit frekvenci výskytu v logu nginx obsahujícího řetězec index:
Podrobné informace o možnostech naleznete v dokumentaci .
Parsnig logů
Existuje několik způsobů, jak sbírat logy:
- Pomocí Promtail, standardní komponenty stacku pro sběr logů.
- Přímo z docker kontejneru pomocí
- Použití Fluentd nebo Fluent Bit, které umějí posílat data do Loki. Na rozdíl od Promtail mají připravené parsery prakticky pro jakýkoliv typ logu a dokážou se vypořádat i s multiline logy.
Obvykle se pro parsování používá Promtail. Dělá tři věci:
- Hledá zdroje dat.
- Připojuje k nim etikety.
- Odesílá data do Loki.
V současnosti může Promtail číst logy z místních souborů a z systemd journalu. Musí být nainstalován na každém počítači, ze kterého se logy sbírají.
Existuje integrace s Kubernetes: Promtail automaticky zjišťuje stav klastru prostřednictvím Kubernetes REST API a sbírá logy z nody, služby nebo podu, ihned při tom přidává etikety na základě metadat z Kubernetes (název podu, název souboru atd.).
Etikety lze také přidělovat na základě údajů z logu pomocí Pipeline. Pipeline Promtail může obsahovat čtyři typy fází. Podrobnosti naleznete v , zde také poznamenám některé nuance.
- Fáze parsování. Tato fáze se zaměřuje na RegEx a JSON. V této fázi extrahujeme data z logů do takzvané extracted map. Lze extrahovat z JSON jednoduše tím, že kopírujeme potřebná pole do extracted map, nebo prostřednictvím regulárních výrazů (RegEx), kde se v extracted map “mapují” pojmenované skupiny. Extracted map představuje úložiště key-value, kde key je jméno pole a value je jeho hodnota z logů.
- Fáze transformace. Tato fáze má dvě možnosti: transform, kde určujeme pravidla transformace, a source — zdroj dat pro transformaci z extracted map. Pokud v extracted map takové pole není, bude vytvořeno. Tímto způsobem lze vytvářet etiket, které nejsou založeny na extracted map. V této fázi můžeme manipulovat s daty v extracted map, pomocí dostatečně mocné . Dále je třeba mít na paměti, že vytažená mapa je kompletně načtena při analýze, což umožňuje například kontrolovat její hodnotu: "{{if .tag}tag value exists{end}}". Šablona podporuje podmínky, cykly a některé funkce pro manipulaci s řetězci, jako jsou Replace a Trim.
- Akční fáze. V této fázi lze provést něco s extrahovaným:
- Vytvořit štítek z extrahovaných dat, který bude indexován ve službě Loki.
- Změnit nebo nastavit čas události ze záznamu.
- Upravit data (text záznamu), která budou odeslána do Loki.
- Vytvořit metriky.
- Fáze filtrování. Fáze shody, kde lze buď odeslat do /dev/null záznamy, které nejsou potřeba, nebo je směrovat k dalšímu zpracování.
Ukážu na příkladu zpracování standardních nginx logů, jak lze logy analyzovat pomocí Promtail.
Pro test si vezmeme jako nginx-proxy modifikovaný obraz nginx jwilder/nginx-proxy:alpine a malého démona, který umí dotazovat sám sebe přes HTTP. Démona máme naprogramováno s několika end-pointy, na které může poskytovat odpovědi různých velikostí, s různými HTTP statusy a s různým zpožděním.
Budeme sbírat logy z docker kontejnerů, které lze nalézt na cestě /var/lib/docker/containers//-json.log
V docker-compose.yml nastavujeme Promtail a určujeme cestu k konfiguraci:
promtail:
  image: grafana/promtail:1.4.1
 // ...
 volumes:
   - /var/lib/docker/containers:/var/lib/docker/containers:ro
   - promtail-data:/var/lib/promtail/positions
   - ${PWD}/promtail/docker.yml:/etc/promtail/promtail.yml
 command:
   - '-config.file=/etc/promtail/promtail.yml'
 // ...
Přidáme do promtail.yml cestu k logům (v konfiguraci je možnost "docker", která dělá totéž jedním řádkem, ale takto to bude přehlednější):
scrape_configs:
 - job_name: containers

   static_configs:
       labels:
         job: containerlogs
         __path__: /var/lib/docker/containers/*/*log  # pouze pro linux
Pokud se tato konfigurace aktivuje, budou do Loki odeslány logy ze všech kontejnerů. Abychom tomu předešli, měníme nastavení testovacího nginx v docker-compose.yml — přidáváme logování s polem tag:
proxy:
 image: nginx.test.v3
//…
 logging:
   driver: "json-file"
   options:
     tag: "{{.ImageName}}|{{.Name}}"
Upravíme promtail.yml a nastavíme Pipeline. Na vstupu jsou logy následujícího typu:
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /api/index HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.096\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.66740443Z"}
{"log":"u001b[0;33;1mnginx.1    | u001b[0mnginx.test 172.28.0.3 - - [13/Jun/2020:23:25:50 +0000] \"GET /200 HTTP/1.1\" 200 0 \"-\" \"Stub_Bot/0.1\" \"0.000\"n","stream":"stdout","attrs":{"tag":"nginx.promtail.test|proxy.prober"},"time":"2020-06-13T23:25:50.702925272Z"}
Fáze pipeline:
 - json:
     expressions:
       stream: stream
       attrs: attrs
       tag: attrs.tag
Z příchozího JSON pole extrahujeme stream, attrs, attrs.tag (pokud existují) a ukládáme je do extrahované mapy.
 - regex:
     expression: ^(?P([^|]+))|(?P([^|]+))$
     source: "tag"
Pokud se podařilo uložit pole tag do extrahované mapy, pomocí regulárního výrazu extrahujeme názvy obrazů a kontejnerů.
 - labels:
     image_name:
     container_name:
Přiřazujeme štítky. Pokud budou v extrahovaných datech nalezeny klíče image_name a container_name, jejich hodnoty budou přiřazeny odpovídajícím štítkům.
 - match:
     selector: '{job="docker",container_name="",image_name=""}'
     action: drop
Odmítáme všechny logy, u kterých nebyly nalezeny stanovené štítky image_name a container_name.
  - match:
     selector: '{image_name="nginx.promtail.test"}'
     stages:
       - json:
           expressions:
             row: log
Pro všechny logy, u kterých je image_name rovno nginx.promtail.test, extrahujeme z původního logu pole log a ukládáme jej do extrahované mapy pod klíčem row.
  - regex:
         # potlačit barvy forego
         expression: .+nginx.+|.+[0m(?P[a-z_.-]+) +(?P.+)
         source: logrow
Čistíme vstupní řetězec pomocí regulárních výrazů a extrahujeme nginx virtuální hostitele a řetězec nginx logu.
     - regex:
         source: nginxlog
         expression: ^(?P[w.]+) - (?P[^ ]*) [(?P[^ ]+).*] "(?P[^ ]*) (?P[^ ]*) (?P[^ ]*)" (?P[d]+) (?P[d]+) "(?P[^"]*)" "(?P[^"]*)"( "(?P[d.]+)")?
Parsujeme nginx log pomocí regulárních výrazů.
    - regex:
           source: request_url
           expression: ^.+.(?Pjpg|jpeg|gif|png|ico|css|zip|tgz|gz|rar|bz2|pdf|txt|tar|wav|bmp|rtf|js|flv|swf|html|htm)$
     - regex:
           source: request_url
           expression: ^/photo/(?P[^/?.]+).*$
       - regex:
           source: request_url
           expression: ^/api/(?P[^/?.]+).*$
Analyzujeme request_url. Pomocí regulárních výrazů určujeme účel požadavku: na statiku, pro fotografie, k API a nastavujeme v extrahované mapě odpovídající klíč.
       - template:
           source: request_type
           template: "{{if .photo}}photo{{else if .static_type}}static{{else if .api_request}}api{{else}}other{{end}}"
Pomocí podmínkových operátorů v šabloně kontrolujeme nastavena pole v extrahované mapě a nastavujeme pro pole request_type potřebné hodnoty: photo, static, API. Přidělujeme other, pokud se to nepodaří. Nyní request_type obsahuje typ požadavku.
       - labels:
           api_request:
           virtual_host:
           request_type:
           status:
Nastavujeme štítky api_request, virtual_host, request_type a stav (HTTP status) na základě toho, co se podařilo uložit do extrahované mapy.
       - output:
           source: nginx_log_row
Změňte výstup. Nyní se do Loki odesílá vyčištěný nginx log z extrahované mapy.
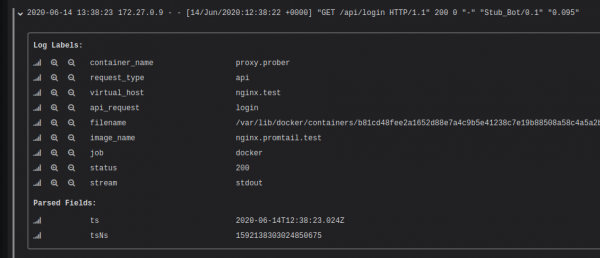
Po spuštění uvedené konfigurace lze vidět, že každé záznamu byly přiřazeny štítky na základě údajů z logu.
Je třeba mít na paměti, že extrakce štítků s vysokým počtem hodnot (cardinality) může značně zpomalit práci Loki. To znamená, že byste neměli indexovat například user_id. Více informací o tom najdete v článku „”. Ale to neznamená, že nelze hledat podle user_id bez indexů. Je třeba použít filtry při hledání („grepovat” data), přičemž index zde funguje jako identifikátor toku.
Vizualizace logů
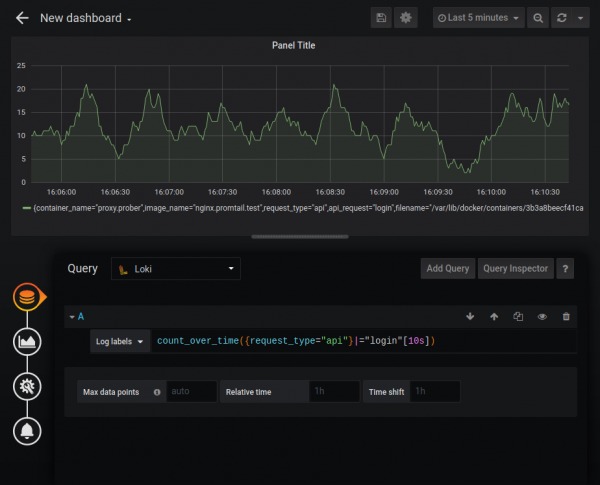
Loki může sloužit jako zdroj dat pro grafy Grafana, používající LogQL. Podporovány jsou následující funkce:
- rate — počet záznamů za sekundu;
- count over time — počet záznamů v daném rozsahu.
Dále jsou k dispozici agregační funkce Sum, Avg a další. Je možné vytvářet poměrně složité grafy, například graf počtu HTTP chyb:
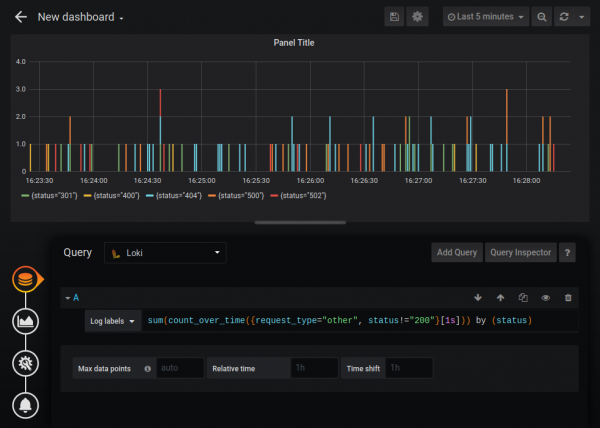
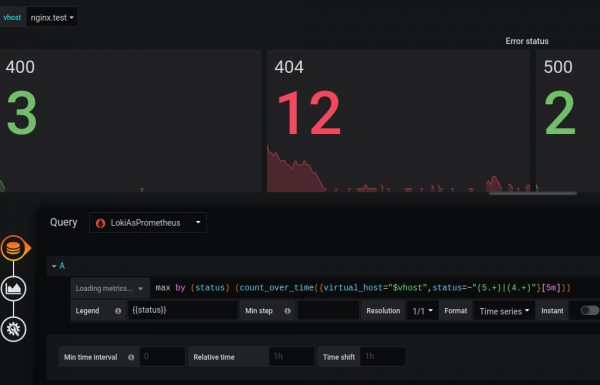
Standardní data source Loki má o něco omezenější funkce ve srovnání se zdrojem dat Prometheus (například nelze měnit legendu), ale Loki lze připojit jako zdroj s typem Prometheus. Nejsem si jistý, zda je to dokumentované chování, ale podle odpovědi vývojářů „”, například je to zcela legální a Loki je plně kompatibilní s PromQL.
Přidáváme Loki jako data source s typem Prometheus a dopisujeme URL /loki:

A můžeme vytvářet grafy, jako bychom pracovali s metrikami z Prometheus:
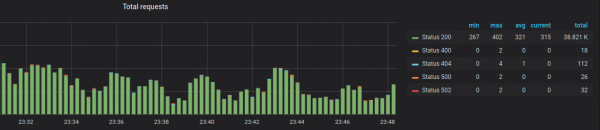
Myslím, že rozdíl ve funkčnosti je dočasný a vývojáři to v budoucnosti opraví.
Metriky
V Loki je k dispozici možnost extrakce číselných metrik z logů a odeslání je do Prometheus. Například v logu nginx se nachází počet bajtů na odpověď, a také při určité modifikaci standardního formátu logu čas ve vteřinách, který byl potřebný na odpověď. Tato data lze extrahovat a odeslat do Prometheus.
Přidáváme další sekci do promtail.yml:
- match:
   selector: '{request_type="api"}'
   stages:
     - metrics:
         http_nginx_response_time:
           type: Histogram
           description: "čas odpovědi ms"
           source: response_time
           config:
             buckets: [0.010,0.050,0.100,0.200,0.500,1.0]
- match:
   selector: '{request_type=~"static|photo"}'
   stages:
     - metrics:
         http_nginx_response_bytes_sum:
           type: Counter
           description: "součet odpovědních bytů"
           source: bytes_out
           config:
             action: add
         http_nginx_response_bytes_count:
           type: Counter
           description: "počet odpovědních bytů"
           source: bytes_out
           config:
             action: inc
Tato volba umožňuje definovat a aktualizovat metriky na základě dat z extracted map. Tyto metriky nejsou odesílány do Loki — objevují se na Promtail /metrics endpoint. Prometheus musí být nakonfigurován tak, aby získával data z této fáze. V uvedeném příkladu pro request_type="api" shromažďujeme metriky histogramu. S tímto typem metrik je pohodlné získávat percentily. Pro statické soubory a fotografie shromažďujeme součet bytů a počet řádků, ve kterých jsme obdrželi byty, abychom vypočítali průměr.
Více o metrikách si přečtěte .
Otevíráme port na Promtail:
promtail:
     image: grafana/promtail:1.4.1
     container_name: monitoring.promtail
     expose:
       - 9080
     ports:
       - "9080:9080"
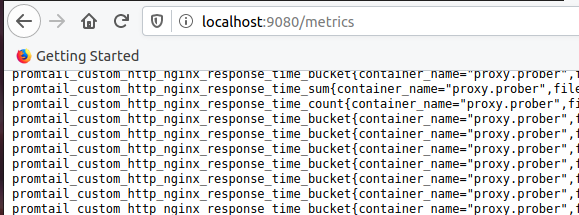
Ujistěte se, že metriky s prefixem promtail_custom se objevily:
Nastavujeme Prometheus. Přidáváme job promtail:
- job_name: 'promtail'
 scrape_interval: 10s
 static_configs:
   - targets: ['promtail:9080']
A vykreslíme graf:
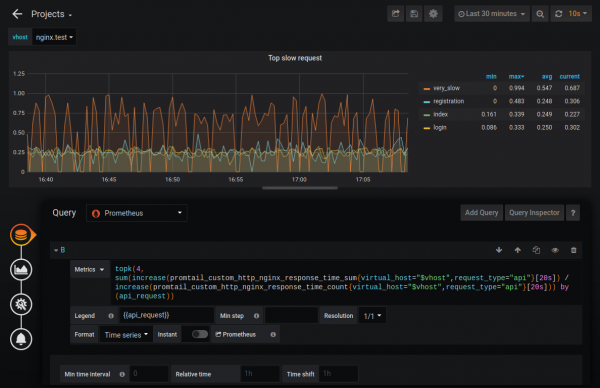
Tímto způsobem můžeme zjistit například čtyři nejpomalejší dotazy. Na základě těchto metrik lze také nastavit monitorování.
Škálování
Loki může běžet buď v režimu single binary (jediný binární režim), nebo v shardovatelném (horizontálně škálovatelném) režimu. Ve druhém případě může ukládat data do cloudu, přičemž chunk a index jsou uloženy odděleně. V verzi 1.5 byla implementována možnost ukládání na jednom místě, ale v produkci ji zatím není doporučeno používat.
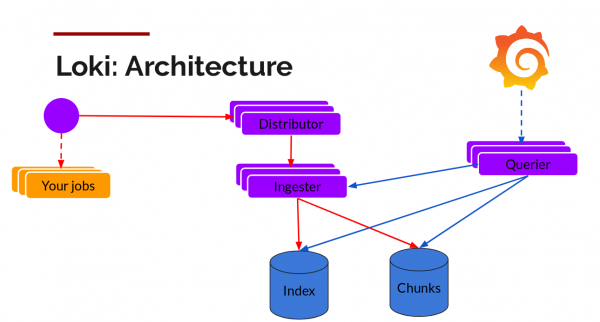
Chunky lze ukládat do úložiště kompatibilního s S3, pro ukládání indexů lze použít horizontálně škálovatelné databáze: Cassandra, BigTable nebo DynamoDB. Další části Loki — Distribuční (pro zápis) a Querier (pro dotazy) — jsou stateless a také se horizontálně škálují.
Na konferenci DevOpsDays Vancouver 2019 jeden z účastníků Callum Styan uvedl, že s Lokim má jeho projekt petabyty logů s indexem menším než 1% z celkové velikosti: “”.
Srovnání Loki a ELK
Velikost indexu
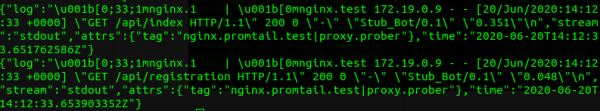
Pro testování získané velikosti indexu jsem vzal logy z kontejneru nginx, pro který byl nastaven Pipeline, uvedený výše. Soubor s logy obsahoval 406 624 řádků s celkovým objemem 109 MB. Logy byly generovány po dobu jedné hodiny, téměř 100 záznamů za sekundu.
Příklad dvou řádků z logu:
Při indexaci ELK to dalo velikost indexu 30,3 MB:
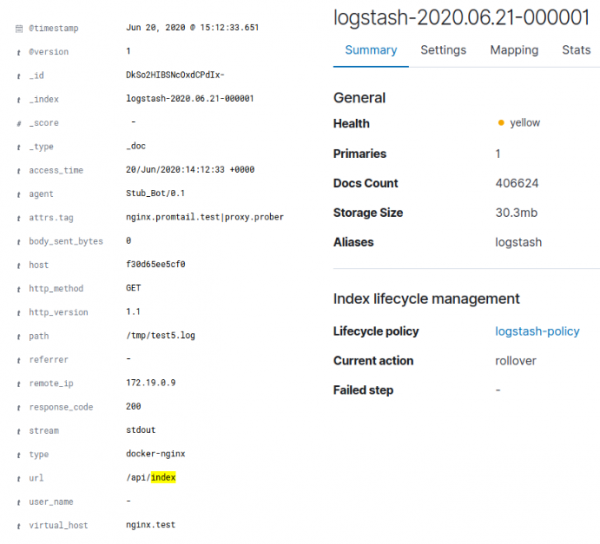
V případě Loki to dalo přibližně 128 kB indexu a přibližně 3,8 MB dat v blocích. Je třeba poznamenat, že log byl uměle vygenerován a neměl příliš velkou rozmanitost dat. Jednoduchý gzip na původním dockerovém JSON-logu s daty poskytoval kompresi 95,4 %, a jelikož se do samotného Loki posílal pouze vyčištěný nginx-log, je komprese na 4 MB vysvětlitelná. Celkový počet unikátních hodnot pro štítky Loki byl 35, což vysvětluje malou velikost indexu. Pro ELK byl log také očištěn. Takže Loki zmenšil původní data o 96 %, zatímco ELK o 70 %.
Spotřeba paměti
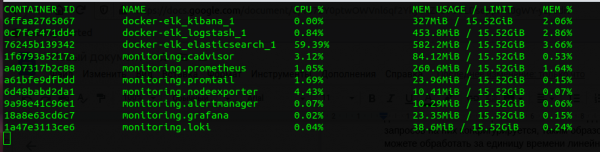
Pokud porovnáme celý stack Prometheus a ELK, Loki "jí" několikrát méně. Je jasné, že služba napsaná v Go spotřebovává méně než služba napsaná v Javě, a porovnání velikosti JVM Heap Elasticsearch a vyhrazené paměti pro Loki není korektní, ale přesto je třeba poznamenat, že Loki používá mnohem méně paměti. Jeho výhoda v CPU není tak zřejmá, ale také existuje.
Rychlost
Loki rychleji "žere" logy. Rychlost závisí na mnoha faktorech — jaké logy máme, jak sofistikovaně je parsujeme, síť, disk atd. — ale rozhodně je vyšší než u ELK (v mém testu přibližně dvakrát). To se vysvětluje tím, že Loki ukládá mnohem méně dat do indexu a tím pádem tráví méně času indexováním. Na druhou stranu, pokud jde o rychlost vyhledávání, je situace opačná: Loki se výrazně zpomaluje na datech o velikosti přes několik gigabytů, zatímco u ELK rychlost vyhledávání nezávisí na velikosti dat.
Vyhledávání v logech
Loki výrazně zaostává za ELK, pokud jde o možnosti vyhledávání v logách. Grep s regulárními výrazy je silná věc, ale standardní databázi to nenahradí. Nedostatek range-dotazů, agregace pouze podle štítků, neschopnost vyhledávat bez štítků — to všechno nás omezuje v hledání zajímavých informací v Loki. To ale neznamená, že s pomocí Loki nelze nic najít, ale určuje to tok práce s logy, kdy nejprve naleznete problém na grafech Promethea a poté podle těchto štítků hledáte, co se stalo v logách.
Rozhraní
Zaprvé, je to hezké (omlouvám se, nemohl jsem se zdržet). Grafana má příjemné rozhraní, ale Kibana je mnohem funkčnější.
Výhody a nevýhody Loki
Mezi výhody patří, že Loki se integruje s Prometheus, takže metriky a upozornění získáváme přímo. Je vhodný pro shromažďování a uchovávání logů z Kubernetes Pods, protože zdědil od Prometheus objevování služeb a automaticky přidává štítky.
Mezi nevýhody patří slabá dokumentace. Některé věci, jako jsou specifika a možnosti Promtail, jsem objevil až během studia kódu, naštěstí open-source. Další nevýhodou jsou slabé možnosti parsování. Například Loki neumí parsovat multiline logy. Také mezi nedostatky lze zmínit, že Loki je relativně nová technologie (verze 1.0 byla vydána v listopadu 2019).
Závěr
Loki je 100% zajímavá technologie, která se hodí pro malé a střední projekty, umožňující řešit řadu úloh agregace logů, hledání v logách, monitorování a analýzu logů.
Nepoužíváme Loki v Badoo, protože máme ELK stack, který nám vyhovuje a který za mnoho let získal různá vlastní řešení. Pro nás je problém hledání v logách. S téměř 100 GB logů denně je pro nás důležité být schopen najít vše a ještě něco navíc a dělat to rychle. Pro vytváření grafů a monitorování používáme jiná řešení, která jsou přizpůsobena našim potřebám a jsou navzájem integrována. Stack Loki má znatelné výhody, ale neposkytne nám víc, než co máme, a jeho přednosti rozhodně nepřekryjí náklady na migraci.
A přestože po výzkumu bylo jasné, že Loki nemůžeme použít, doufáme, že vám tento příspěvek pomůže při výběru.
Repozitář s kódem použitým v článku se nachází .
Zdroj: habr.com
