

VictoriaMetrics, TimescaleDB a InfluxDB byly porovnány v datasetu s miliardou datových bodů patřících 40K unikátním časovým řadům.
Před několika lety byla éra Zabbix. Každý bare metal server měl maximálně několik ukazatelů – využití procesoru, využití operační paměti, využití disku a využití sítě. Takto mohly metriky z tisíců serverů zaplnit 40 tisíc unikátních časových řad, a Zabbix mohl použít MySQL jako backend pro data časových řad 🙂
V současnosti jeden s výchozími konfiguracemi poskytuje více než 500 metrik na průměrném hostiteli. Existuje mnoho pro různé databáze, webové servery, hardwarové systémy atd. Všechny poskytují množství užitečných ukazatelů. Vše začínají vystavovat různé ukazatele. Existuje Kubernetes s klastry a podíleními, které odhalují množství metrik. To vede k tomu, že servery vystavují tisíce unikátních metrik na hostiteli. Takže unikátní časový řad 40K už není vysokou kapacitou. Stává se běžným jevem, který by měl být snadno zpracován jakoukoli moderní TSDB na jednom serveru.
Co je nyní velké množství unikátních časových řad? Snad 400K nebo 4M? Nebo 40M? Pojďme porovnat moderní TSDBs s těmito čísly.
Nastavení benchmarku
je skvělý nástroj pro benchmarkování TSDBs. Umožňuje generovat libovolné množství metrik tím, že předáte potřebný počet časových řad, rozdělených na 10 – příznak (dříve -scale-var). 10 – to je počet měření (metrik), generovaných na každém hostiteli, serveru. Následující datové sady byly vytvořeny pomocí TSBS pro benchmarking:
- 400K unikátní časový řad, 60 sekund interval mezi datovými body, data pokrývají celé 3 dny, ~1.7B celkový počet datových bodů.
- 4M unikátní časový řad, interval 600 sekund, data pokrývají celé 3 dny, ~1.7B celkový počet datových bodů.
- 40M unikátní časový řad, interval 1 hodina, data pokrývají celé 3 dny, ~2.8B celkový počet datových bodů.
Klient a server byly spuštěny na vyhrazených instancích v cloudu Google. Tyto instance měly následující konfigurace:
- vCPUs: 16
- RAM: 60 GB
- Úložiště: standardní pevný disk s kapacitou 1 TB. Zaručuje propustnost pro čtení/zápis 120 Mb/s, 750 operací čtení za sekundu a 1,5K operací zápisu za sekundu.
TSDB byly staženy z oficiálních obrazů docker a spuštěny v dockeru s následujícími konfiguracemi:
VictoriaMetrics:
docker run -it --rm -v /mnt/disks/storage/vmetrics-data:/victoria-metrics-data -p 8080:8080 valyala/victoria-metricsHodnoty InfluxDB (-e jsou povinné pro podporu vysokého výkonu. Podrobnosti viz ):
docker run -it --rm -p 8086:8086
-e INFLUXDB_DATA_MAX_VALUES_PER_TAG=4000000
-e INFLUXDB_DATA_CACHE_MAX_MEMORY_SIZE=100g
-e INFLUXDB_DATA_MAX_SERIES_PER_DATABASE=0
-v /mnt/disks/storage/influx-data:/var/lib/influxdb influxdb
TimescaleDB (konfigurace byla převzata z souboru):
MEM=`free -m | grep "Mem" | awk '{print $7}'`
let "SHARED=$MEM/4"
let "CACHE=2*$MEM/3"
let "WORK=($MEM-$SHARED)/30"
let "MAINT=$MEM/16"
let "WAL=$MEM/16"
docker run -it --rm -p 5432:5432
--shm-size=${SHARED}MB
-v /mnt/disks/storage/timescaledb-data:/var/lib/postgresql/data
timescale/timescaledb:latest-pg10 postgres
-cmax_wal_size=${WAL}MB
-clog_line_prefix="%m [%p]: [%x] %u@%d"
-clogging_collector=off
-csynchronous_commit=off
-cshared_buffers=${SHARED}MB
-ceffective_cache_size=${CACHE}MB
-cwork_mem=${WORK}MB
-cmaintenance_work_mem=${MAINT}MB
-cmax_files_per_process=100
Zpracovatel dat byl spuštěn s 16 paralelními vlákny.
Tento dokument obsahuje pouze výsledky pro měřítka vkládání. Výsledky průzkumného benchmarku budou zveřejněny v samostatném článku.
400K jedinečných časových řad
Začněme s jednoduchými prvky — 400K. Výsledky benchmarku:
- VictoriaMetrics: 2,6M datových bodů za sekundu; využití paměti: 3 GB; konečná velikost dat na disku: 965 MB
- InfluxDB: 1.2M datových bodů za sekundu; využití paměti: 8.5 GB; konečná velikost dat na disku: 1.6 GB
- Timescale: 849K datových bodů za sekundu; využití paměti: 2,5 GB; konečná velikost dat na disku: 50 GB
Jak můžete vidět z výše uvedených výsledků, VictoriaMetrics vítězí v rychlosti vkládání a úrovni komprese. Timescale vítězí v využití paměti, ale spotřebovává hodně místa na disku — 29 bajtů na datový bod.
Níže jsou grafy využití procesoru (CPU) pro každý z TSDBs během benchmarku:
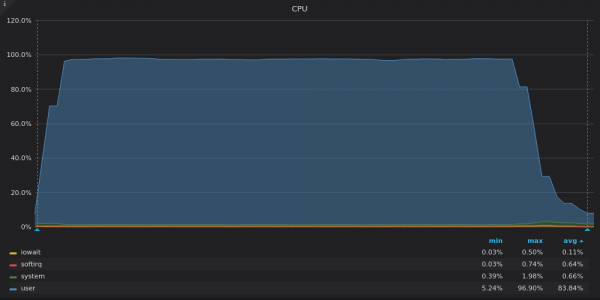
Výše snímek obrazovky: VictoriaMetrics — Využití CPU během testu vkládání pro unikátní metriku 400K.
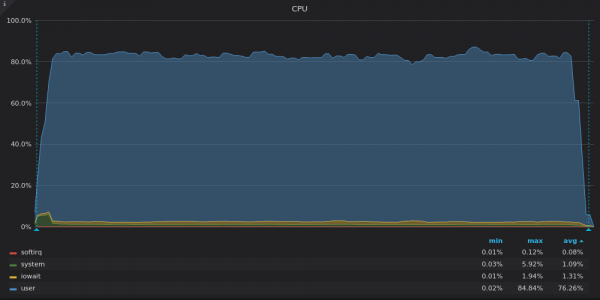
Výše snímek obrazovky: InfluxDB — Využití CPU během testu vkládání pro unikátní metriku 400K.
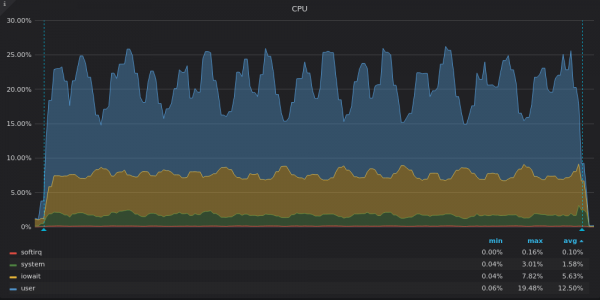
Výše snímek obrazovky: TimescaleDB — Využití CPU během testu vkládání pro unikátní metriku 400K.
VictoriaMetrics využívá všechny dostupné vCPUs, zatímco InfluxDB využívá pouze ~2 z 16 vCPUs.
Timescale využívá pouze 3-4 z 16 vCPUs. Vysoké podíly iowait a system na grafu časových škál TimescaleDB naznačují úzké místo v subsystému vstupu a výstupu (I/O). Podívejme se na grafy využití propustnosti disku:
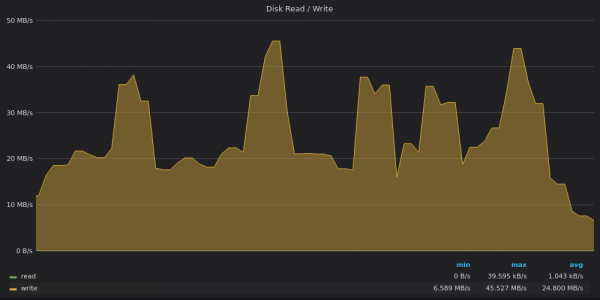
Výše je screenshot: VictoriaMetrics — Využití propustnosti disku při testu zápisu pro unikátní metriky 400K.
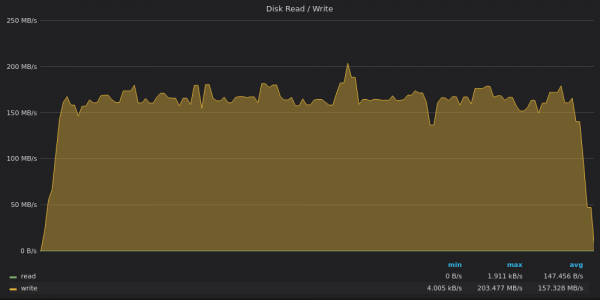
Výše je screenshot: InfluxDB — Využití propustnosti disku při testu zápisu pro unikátní metriky 400K.
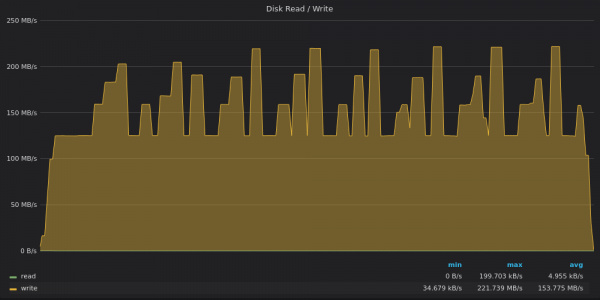
Výše je screenshot: TimescaleDB — Využití propustnosti disku při testu zápisu pro unikátní metriky 400K.
VictoriaMetrics zapisuje data rychlostí 20 Mbit/s s vrcholy až 45 Mbit/s. Tyto vrcholy odpovídají velkým částečným sloučením ve stromu. .
InfluxDB zapisuje data rychlostí 160 MB/s, zatímco 1 TB disk propustností zápisu 120 MB/s.
TimescaleDB je omezena propustností zápisu 120 Mbit/s, ale občas tento limit porušuje a dosahuje 220 Mbit/s v pikových hodnotách. Tyto vrcholy odpovídají propadům nedostatečného zatížení CPU na předchozím grafu.
Podívejme se na grafy využití I/O:
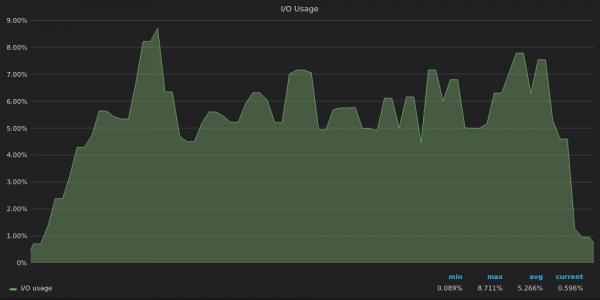
Výše je screenshot: VictoriaMetrics — Využití I/O při testu zápisu pro 400K unikátních metrik.
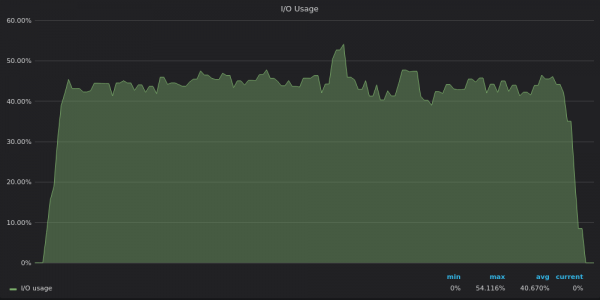
Výše je screenshot: InfluxDB — Využití I/O při testu zápisu pro 400K unikátních metrik.
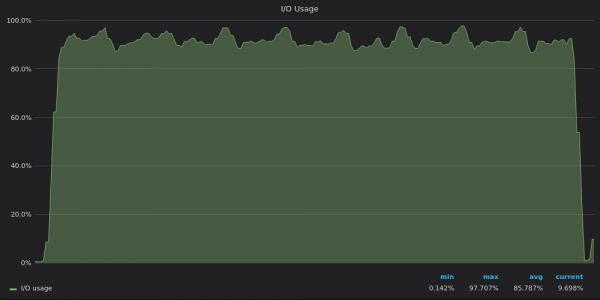
Výše je screenshot: TimescaleDB — Využití I/O při testu zápisu pro 400K unikátních metrik.
Nyní je jasné, že TimescaleDB dosahuje limitu I/O, a proto nemůže využít zbývajících 12 vCPUs.
4M unikátních časových řad
4M časové řady vypadají trochu náročně. Ale naši konkurenti tuto zkoušku úspěšně zvládají. Výsledky benchmarku:
- VictoriaMetrics: 2,2M bodů dat za sekundu; využití paměti: 6 GB; konečná velikost dat na disku: 3 GB.
- InfluxDB: 330K bodů dat za sekundu; využití paměti: 20,5 GB; konečná velikost dat na disku: 18,4 GB.
- TimescaleDB: 480K bodů dat za sekundu; využití paměti: 2,5 GB; konečná velikost dat na disku: 52 GB.
Výkon InfluxDB klesl z 1,2 milionu datových bodů za sekundu pro 400K časovou řadu na 330 tisíc datových bodů za sekundu pro 4M časovou řadu. To je výrazná ztráta výkonu ve srovnání s ostatními konkurenty. Podívejme se na grafy využití CPU, abychom pochopili příčinu této ztráty:
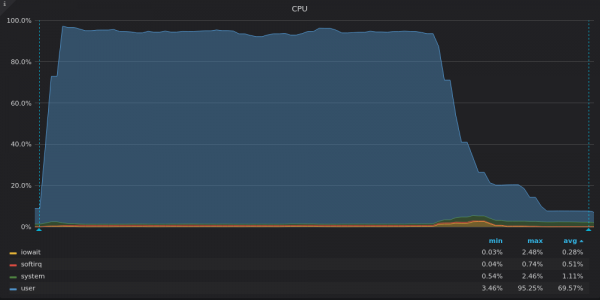
Výše uvedený screenshot: VictoriaMetrics — Využití CPU při testu vkládání pro unikátní časovou řadu 4M.
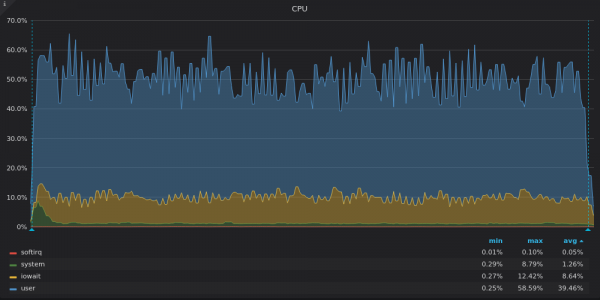
Výše uvedený screenshot: InfluxDB — Využití CPU při testu vkládání pro unikátní časovou řadu 4M.
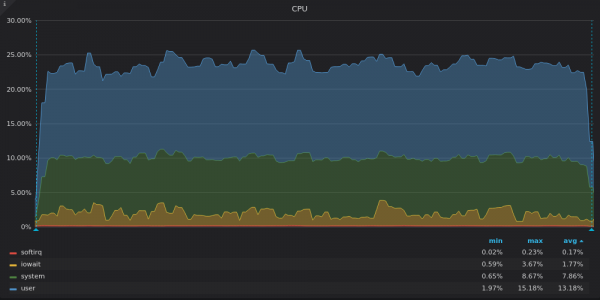
Výše uvedený screenshot: TimescaleDB — Využití CPU při testu vkládání pro unikátní časovou řadu 4M.
VictoriaMetrics využívá téměř veškerou procesorovou sílu (CPU). Pokles na konci odpovídá zbývajícím LSM sloučením po vložení všech dat.
InfluxDB využívá pouze 8 ze 16 vCPU, zatímco TimescaleDB využívá 4 ze 16 vCPU. Co mají jejich grafy společného? Vysoký podíl iowait, což opět naznačuje úzké místo v plošné propustnosti.
TimescaleDB má vysoký podíl systém. Domníváme se, že vysoká přetíženost vedla k mnoha systémovým voláním nebo k mnoha .
Podívejme se na grafy propustnosti disku:
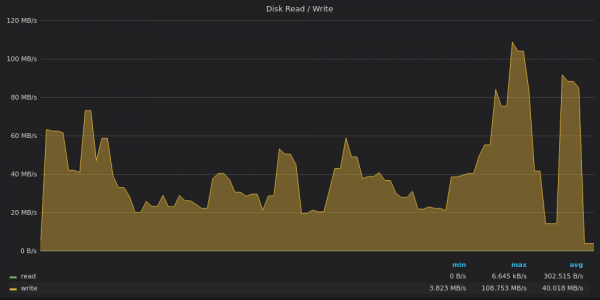
Výše uvedený screenshot: VictoriaMetrics — Využití šířky pásma disku pro vložení 4M unikátních metrik.
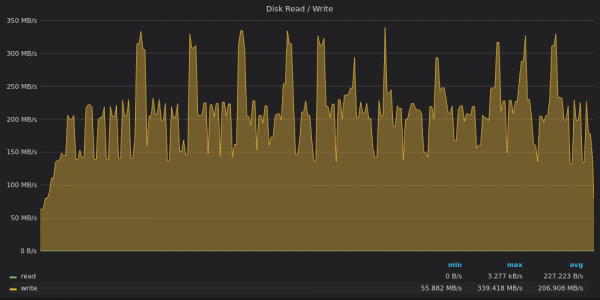
Výše uvedený screenshot: InfluxDB — Využití šířky pásma disku pro vložení 4M unikátních metrik.
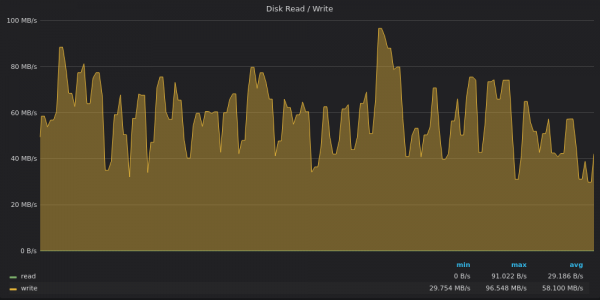
Výše uvedený screenshot: TimescaleDB — Využití šířky pásma disku pro vložení 4M unikátních metrik.
VictoriaMetrics dosáhli limitu 120 MB/s v maximu, zatímco průměrná rychlost zápisu činila 40 MB/s. Pravděpodobně během maxima probíhalo několik náročných sloučení LSM.
InfluxDB opět dosahuje průměrné propustnosti zápisu 200 MB/s s maximy až 340 MB/s na disku s limitem zápisu 120 MB/s 🙂
TimescaleDB již není omezena diskem. Zdá se, že je omezena něčím jiným souvisejícím s vysokým podílem systémového zatížení CPU.
Podívejme se na grafy využití IO:
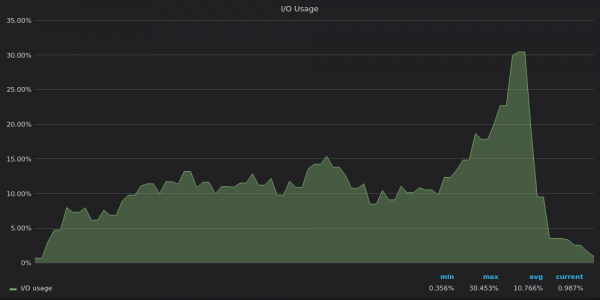
Výše uvedený screenshot: VictoriaMetrics — Využití vstupu a výstupu během testu vkládání pro unikátní časovou řadu 4M.
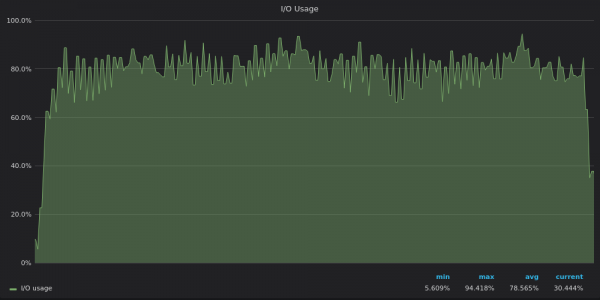
Výše uvedený screenshot: InfluxDB — Využití vstupu a výstupu během testu vkládání pro unikátní časovou řadu 4M.
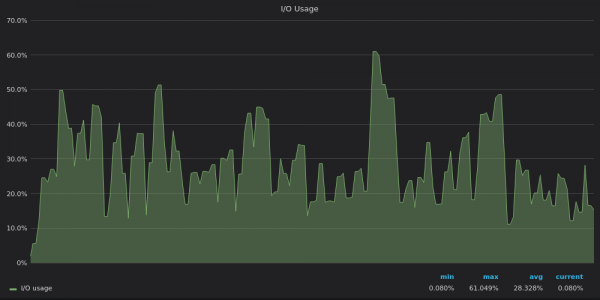
Výše uvedený screenshot: TimescaleDB — Využití vstupu a výstupu během testu vkládání pro unikátní časovou řadu 4M.
Grafy využití IO odpovídají grafům využití diskové šířky pásma — InfluxDB je limitována IO, zatímco VictoriaMetrics a TimescaleDB mají rezervy pro vstupně-výstupní operace.
40M unikátních časových řad
40M unikátních časových řad bylo příliš velkých pro InfluxDB 🙁
Výsledky benchmarku:
- VictoriaMetrics: 1,7M datových bodů za sekundu; využití paměti: 29 GB; využití diskového prostoru: 17 GB.
- InfluxDB: nedokončeno, protože to vyžadovalo více než 60 GB RAM.
- TimescaleDB: 330K datových bodů za sekundu, využití paměti: 2,5 GB; využití diskového prostoru: 84GB.
TimescaleDB vykazuje mimořádně nízké a stabilní využití paměti – 2,5 GB — stejně jako pro unikátní metriky 4M a 400K.
VictoriaMetrics pomalu zvyšoval rychlost o 100 tisíc datových bodů za sekundu, dokud nebylo zpracováno všech 40M metrických názvů s tagy. Poté dosáhl stabilní rychlosti vkládání 1,5-2,0M datových bodů za sekundu, takže konečný výsledek činil 1,7M datových bodů za sekundu.
Grafy pro 40M unikátních časových řad jsou podobné grafům pro 4M unikátních časových řad, takže je přeskočíme.
Závěry
- Moderní TSDBs jsou schopny zpracovávat vkládání pro miliony unikátních časových řad na jednom serveru. V dalším článku prozkoumáme, jak dobře TSDBs provádějí dotazy na miliony unikátních časových řad.
- Nedostatečné využití CPU obvykle naznačuje úzké místo v IO. Také to může ukazovat na příliš hrubé zamykání, kdy může současně běžet pouze několik vláken.
- Úzké místo v IO skutečně existuje, zejména v úložištích bez SSD, jako jsou virtualizovaná bloková zařízení cloudových poskytovatelů.
- VictoriaMetrics poskytuje nejlepší optimalizaci pro pomalá úložiště s nízkou IO. Nabízí nejlepší rychlost a nejlepší míru komprese.
Stáhněte si a vyzkoušejte jej na svých datech. Příslušný statický binární soubor je k dispozici na .
Více o VictoriaMetrics si přečtěte v tomto .
aktualizaci: byla publikována s reprodukovatelnými výsledky.
Aktualizace#2: Přečtěte si také .
Aktualizace #3: !
Telegramový chat:
Zdroj: habr.com
