

Ahoj, Habr!
Dnes bych chtěl hovořit o našich zkušenostech s automatizací zálohování velkých datových úložišť Nextcloud v různých konfiguracích. Pracuje jako CTO ve společnosti „Molyne AK“, kde se zabýváme konfiguračním řízením IT systémů, pro ukládání dat používáme Nextcloud. To zahrnuje také distribuovanou strukturu s replikací.
Problémy vyplývající z charakteristik instalací spočívají v tom, že dat je mnoho. Verziování, které poskytuje Nextcloud, zálohování, subjektivní důvody a další vytvářejí mnoho duplicit.
Pozadí
Při administraci Nextcloudu se akutně objevuje problém organizace efektivní zálohy, kterou je nutné šifrovat, protože data jsou cenná.
Nabízíme možnosti ukládání záloh u nás nebo u zákazníka na jeho samostatných strojích mimo Nextcloud, což vyžaduje flexibilní automatizovaný přístup k administraci.
Klientů je mnoho, všichni mají různé konfigurace a jsou na svých platformách s vlastními specifiky. Standardní metodika, kdy celá platforma patří vám, a zálohy se provádějí z cron zarízení, zde špatně funguje.
Nejprve se podívejme na vstupní data. Potřebujeme:
- Škálovatelnost v otázce jedné nebo více uzlů. Pro velké instalace používáme jako úložiště minio.
- Zjišťovat problémy při provádění zálohy.
- Musíme uchovávat zálohy u klientů a/nebo u nás.
- Rychle a snadno se vypořádat s problémy.
- Klienti a instalace se velmi liší jeden od druhého — dosáhnout jednotnosti se nedaří.
- Rychlost obnovení by měla být minimální ve dvou scénářích: úplné obnovení (katastrofa), jedna složka — omylem smazána.
- Funkce deduplikace je povinná.
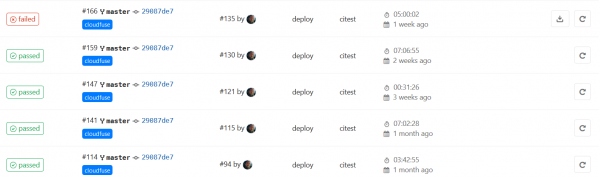
Pro řešení úkolu správy záloh jsme připojili GitLab. Podrobněji níže.
Bezpochyby nejsme první, kdo řeší podobný problém, ale domníváme se, že naše praktické, tvrdě získané zkušenosti by mohly být zajímavé a jsme připraveni se o ně podělit.
Protože v naší společnosti platí politika opensource, hledali jsme řešení s otevřeným zdrojovým kódem. Na oplátku sdílíme naše vývojové projekty a zveřejňujeme je. Například na GitHubu je , který instalujeme klientům a posiluje ochranu dat v případě náhodného nebo úmyslného smazání.
Zálohovací nástroje
Hledání metod řešení jsme začali výběrem nástroje pro zálohování.
Obvyklý tar + gzip funguje špatně – data se duplicují. Inkrement často obsahuje velmi málo změn v reálu, a většina dat uvnitř jednoho souboru se opakuje.
Existuje ještě jeden problém – redundantnost distribuovaného úložiště dat. Používáme Minio a jeho data jsou v zásadě redundantní. Buď je potřebné zálohovat přímo přes Minio – zatěžovat ho a využívat všechny vrstvy mezi souborovým systémem, a co je také důležité, je riziko zapomenout na část bucketů a meta-informací. Nebo použít deduplikaci.
Nástroje pro zálohování s deduplikací existují v open-source (bylo na Habru ) a našimi finalisty se stali a . O našem srovnání dvou aplikací níže, ale zatím povíme, jak jsme zorganizovali celou schéma.
Řízení vytváření záloh
Borg a Restic jsou dobré, ale ani jeden z těchto produktů nemá centralizovaný mechanismus řízení. Pro účely správy a kontroly jsme zvolili nástroj, který už máme zaveden, bez kterého si nedovedeme představit naši práci, včetně automatizace – je to známý CI/CD – GitLab.
Myšlenka je následující: na každou uzel ukládající data Nextcloud se instaluje gitlab-runner. Runner spouští podle plánu skript sledující proces zálohování, a ten запускает Borg nebo Restic.
Co jsme získali? Zpětnou vazbu z provedení, snadnou kontrolu změn, podrobnosti v případě chyby.
Tady jsme zveřejnili příklady skriptu pro různé úkoly, a my jsme ho nakonec připojili k zálohování nejen Nextcloudu, ale také mnoha dalších služeb. Tam je také plánovač, pokud se vám nechce ho nastavovat ručně (a nám se nechce) a .gitlab-ci.yml
V API GitLabu zatím není možnost měnit timeout CI/CD, a ten je tam malý. Je třeba ho zvýšit, dejme tomu na 1d.
GitLab naštěstí umí spouštět nejen na základě commitu, ale také podle plánu, to je přesně to, co potřebujeme.
Teď o skriptu-wrapperu.
Pro tento skript jsme stanovili takové podmínky:
- Musí být spouštěn jak runnerem, tak ručně z konzole se stejnou funkcionalitou.
- Musí mít zpracovatele chyb:
- kód návratu.
- hledání řetězce v logu. Například, pro nás může být chybou zpráva, kterou program za fatální nepokládá.
- Zpracování timeoutu. Doba provedení by měla být rozumná.
- Potřebujeme podrobný protokol. Ale pouze v případě chyby.
- Také se provádí řada testů před zahájením.
- Malé vylepšení pro pohodlí, které jsme považovali za užitečné při podpoře:
- Začátek a konec se zaznamenává do systémového logu místního zařízení. To pomáhá spojit systémové chyby a práci zálohy.
- Část logu chyb, pokud nějaké budou, se zobrazuje na stdout, celý log se zapisuje do samostatného souboru. Je pohodlné se ihned podívat do CI a vyhodnotit chybu, pokud je triviální.
- Režimy pro ladění.
Úplný log se uchovává jako artefakt v GitLab, pokud není chyba, log se maže. Skript píšeme v bash.
Rádi uvítáme jakékoli návrhy a poznámky k open-source — vítejte.
Jak to funguje
Na zálohované uzlu se spouští runner s bashovým executor. Plánovač v speciálním repozitáři spouští job CI/CD. Runner spouští skript, univerzální obálku pro takové úkoly, v něm probíhá ověřování platnosti repozitáře zálohy, bodů montování a všeho, co chceme, poté se provádí zálohování a čištění starého. Hotová záloha je pak odeslána na S3.
Pracujeme podle takového schématu — to je externí poskytovatel AWS nebo ruský analog (to je rychlejší a data neopouštějí RF). Nebo klientovi nainstalujeme samostatný minio cluster na jeho místě pro tyto účely. Obvykle tak činíme z bezpečnostních důvodů, když klient zcela nechce, aby data opustila jejich obvod.
Funkci odesílání zálohy přes ssh jsme nevyužili. To nezvyšuje bezpečnost a síťové možnosti poskytovatele S3 jsou mnohem vyšší než jedna naše ssh stroj.
Abychom se chránili před hackerem na místním zařízení — může smazat data na S3, je nutné zapnout verzování.
Zálohovací systém vždy šifruje zálohu.
Borg má režim bez šifrování, noneale kategoricky nedoporučujeme jeho povolení. V tomto režimu nebude nejen šifrování, ale také není vypočítáván kontrolní součet toho, co se zapisuje, takže integritu lze ověřit pouze nepřímo, podle indexů.
Podle samostatného plánovače se provádí kontrola záloh na integritu indexů a obsahu. Kontrola probíhá pomalu a dlouho, proto ji spouštíme samostatně jednou za měsíc. Může trvat několik dní.
Čti mě v ruštině
Hlavní funkce
připravitpřípravatestcheckkontrola připravenostihlavní příkazhlavní příkazforcepostscriptfunkce, která se spouští na konci nebo při chybě. Používá se k odpojení oddílu.
Služební funkce
cleanupzapisujeme chyby nebo mažeme logovací soubor.checklogparsujeme log na přítomnost řetězce s chybou.retexit handler.checktimeoutkontrola na časový limit.
Prostředí
VERBOSE=1vysíláme chyby okamžitě na obrazovku (stdout).SAVELOGSONSUCCES=1uchováváme log při úspěchu.INIT_REPO_IF_NOT_EXIST=1Vytváříme repozitář, pokud neexistoval. Ve výchozím nastavení je vypnuto.TIMEOUTmaximální čas pro hlavní operaci. Můžete ho nastavit jako 'm', 'h' nebo 'd' na konci.
Režim uchovávání starých kopií. Ve výchozím nastavení:
KEEP_DAILY=7KEEP_WEEKLY=4KEEP_MONTHLY=6
Proměnné uvnitř skriptu
ERROR_STRING— řetězec pro kontrolu v logu pro chybu.EXTRACT_ERROR_STRING— výraz pro zobrazení řetězce, pokud dojde k chybě.KILL_TIMEOUT_SIGNAL— signál pro zabití, pokud vyprší časový limit.TAIL— kolik řetězců s chybami na obrazovce.COLORMSG— barva zprávy (výchozí žlutá).
Ten skript, který se nazývá wordpress, se označuje jako podmíněný, jeho funkcí je, že zálohuje databázi MySQL. A to znamená, že může být používán pro jednorázové instalace Nextcloud, kde lze rovněž zálohovat databázi. Pohodlí nespočívá jen v tom, že vše je na jednom místě, ale také obsah databáze je blízko obsahu souborů, protože rozdíl v čase je minimální.
Restic vs Borg
Srovnání Borg a Restic je také , a neměli jsme za úkol udělat prostě další, ale své. Bylo pro nás důležité, jak to bude vypadat na našich datech, s naší specifičností. Přivedeme je.
Naše kritéria výběru, kromě již zmíněných (deduplikace, rychlé zotavení atd.):
- Odolnost vůči nedokončené práci. Kontrola na kill -9.
- Velikost na disku.
- Požadavky na zdroje (CPU, paměť).
- Velikost uchovávaných blobů.
- Práce s S3.
- Kontrola integrity.
Pro testování jsme vzali jednoho klienta s reálnými daty a celkovou velikostí 1,6TB.
Podmínky.
Borg neumí přímo pracovat s S3, a my jsme to montovali jako fuse disk, přes . Restic posílal do S3 sám.
Goofys funguje velmi rychle a dobře, a k němu je , což ještě více urychluje práci. Je v betě, a přiznám se, že nám spadl se ztrátou dat na testech (jiných). Ale pohodlí spočívá v tom, že samotný proces zálohy nevyžaduje velké čtení, ale hlavně zápis, takže cache používáme pouze během kontroly integrity.
Abychom snížili vliv sítě, použili jsme místního poskytovatele — Yandex Cloud.
Výsledky testování srovnání.
- Kill -9 s následným restartem, obě akce proběhly úspěšně.
- Velikost na disku. Borg umí komprimovat, takže očekávané výsledky.
Zálohovací systém
Velikost
Borg
562 Gb
Restic
628 Gb
- Podle CPU
Borg sám o sobě spotřebovává málo, s výchozí kompresí, ale je třeba hodnotit společně s procesem goofys. V součtu jsou srovnatelní a využívají asi 1,2 jádra na stejné testovací virtuální mašině. - Paměť. Restic přibližně 0,5 Gb, Borg asi 200 Mb. Ale to vše je zanedbatelné ve srovnání se souborovou cache systému. Takže je dobré vyčlenit více paměti.
- Rozdíl ve velikosti blobů byl překvapivý.
Zálohovací systém
Velikost
Borg
přibližně 500 Mb
Restic
přibližně 5 Mb
- Práce s S3 od Restic je skvělá. Práce Borg přes goofys nevytváří žádné otázky, ale bylo zaznamenáno, že je žádoucí po dokončení zálohy provést umount, aby se úplně vymazala cache. Specifikum práce S3 je, že nedokončené chunky nikdy nebudou odeslány do bucketu, takže nedosáhnout kompletních dat vede k velkým poškozením.
- Ověření integrity funguje dobře v obou případech, ale rychlost se výrazně liší.
Restic – 3,5 hodiny.
Borg, s cache souborů 100 Gb SSD – 5 hodin. Přibližně stejný výsledek rychlosti, pokud jsou data uložena na místním disku.
Borg čte přímo z S3 bez cache 33 hodin. Hrozně dlouho.
V konečném důsledku Borg umí komprimovat a má větší blob, což dělá ukládání a operace GET/PUT v S3 levnějšími. Ale za to se platí složitějším a pomalejším ověřováním. Co se týče rychlosti obnovy — žádný rozdíl jsme nezaznamenali. Následující zálohy (po první) restic provádí o něco déle, ale ne zásadně.
Velmi důležitým faktorem při výběru byl také rozměr komunity.
A my jsme vybrali Borg.
Pár slov o kompresi
Borg disponuje vynikajícím novým kompresním algoritmem — zstd. Co do kvality komprese není horší než gzip, ale je výrazně rychlejší. A je porovnatelné rychlostí s výchozím lz4.
Například dump MySQL databáze se komprimuje dvakrát lépe než lz4 při stejné rychlosti. Nicméně, zkušenosti s reálnými daty ukazují, že rozdíl ve stupni komprese na nodě Nextcloud je velmi malý.
V Borg je také zajímavý režim komprese — pokud má soubor vysokou entropii, komprese se vůbec neprovádí, což zvyšuje rychlost práce. Aktivuje se volbou při vytváření
-C auto,zstd
pro algoritmus zstd
Takže s touto volbou v porovnání s výchozí kompresí jsme získali
560 Gb a 562 Gb. Jak jsem zmínil výše, bez komprimace činí výsledek 628 Gb. Výsledný rozdíl 2 Gb nás celkem překvapil, ale rozhodli jsme se přece jen vybrat. auto,zstd.
Metodika ověřování záloh
Podle plánu se virtuální stroj spouští přímo u poskytovatele nebo u klienta, což významně snižuje síťovou zátěž. Minimálně je to levnější než zprovozňovat u sebe a posílat data.
goofys --cache "--free:5%:\/mnt\/cache" -o allow_other --endpoint https:\/\/storage.yandexcloud.net --file-mode=0666 --dir-mode=0777 xxxxxxx.com \/mnt\/goofys
export BORG_PASSCOMMAND="cat \/home\/borg\/.borg-passphrase"
borg list \/mnt\/goofys\/borg1\/
borg check --debug -p --verify-data \/mnt\/goofys\/borg1\/
Podle stejného schématu kontrolujeme soubory antivirem (post factum). Uživatelé nahrávají různé soubory do Nextcloudu a ne všichni mají antivirus. Provádět kontrolu při nahrávání zabere příliš mnoho času a brání podnikání.
Škálovatelnosti dosahujeme spuštěním runnerů na různých nodech s různými tagy.
V našem monitoringu shromažďujeme stavy záloh přes API GitLab na jednom okně, a pokud je to nutné, problémy se snadno rozpoznají a také snadno lokalizují.
Závěr
Jako výsledek přesně víme, že zálohy děláme, že naše zálohy jsou validní, a problémy, které s nimi vznikají, zabírají málo času a řeší se na úrovni pohotovostního administrátora. Zálohy skutečně zabírají málo prostoru ve srovnání s tar.gz nebo Bacula.
Zdroj: habr.com
