

Ahoj všichni! Jsem vývojář CV ve společnosti KROK. Již 3 roky realizujeme projekty v oblasti CV. Během této doby jsme udělali spoustu věcí, například: monitorovali jsme řidiče, aby při jízdě nepili, nekouřili, netelefonovali, dívali se na silnici a ne na sny nebo mraky; zaznamenávali jsme ty, co jezdí po vyhrazených pruzích a zabírají více míst na parkovišti; sledovali jsme, zda zaměstnanci nosí přilby, rukavice atd.; identifikovali jsme pracovníka, který se chce dostat na místo; a počítali jsme vše, co se dalo.
K čemu to vše říkám?
Při realizaci projektů jsme se setkali s mnoha problémy, některé z nich znáte vy nebo se s nimi setkáte v budoucnu.
Modelujeme situaci
Představme si, že jsme se zaměstnali v mladé firmě "N", jejíž činnost je spojena s ML. Pracujeme na ML (DL, CV) projektu, pak se z nějakého důvodu přepneme na jinou práci, prostě si uděláme pauzu a vrátíme se ke své nebo cizí neuronové síti.
- Nastal okamžik pravdy, musíme si nějak zapamatovat, na čem jsme skončili, jaké hyperparametry jsme zkoušeli a co je nejdůležitější, k jakým výsledkům vedly. Může existovat mnoho variant, jak kdo uchovával informace o všech spuštěních: v hlavě, v konfiguračních souborech, v notese, v pracovní cloudové prostředí. Viděl jsem variantu, kdy byly hyperparametry uchovávány jako komentované řádky v kódu, prostě co to vyvolalo. A teď si představte, že se vracíte nejen k vlastnímu projektu, ale k projektu někoho, kdo firmu opustil, a zdědili jste kód a model nazvaný model_1.pb. Pro úplnost a předání veškeré bolesti si představte, že jste také začínající odborník.
- Pokračujme dál. Abychom spustili kód, musíme my a všichni, kdo s ním budou pracovat, vytvořit prostředí. Často se stává, že nám ani to z nějakého důvodu také nezanechali. To se také může stát netriviální úlohou. Nechceme na tento krok utrácet čas, že?
- Trénujeme model (například detektor automobilů). Dospějeme k okamžiku, kdy se stává velmi užitečným — je čas uložit výsledek. Pojmenujeme ho car_detection_v1.pb. Poté trénujeme ještě jeden — car_detection_v2.pb. O nějaký čas později naši kolegové nebo my sami trénujeme další a další, používáme různé architektury. Nakonec se vytváří halda artefaktů, informace o kterých je třeba pečlivě sbírat (ale to uděláme později, máme přece nyní priority).
- Tak a je to! Máme model! Můžeme začít trénovat další model, vyvíjet architekturu pro řešení nového úkolu, nebo si jít udělat čaj? A kdo bude nasazovat?
Identifikujeme problémy
Práce na projektu nebo produktu je úsilím mnoha lidí. Jak čas plyne, lidé přicházejí a odcházejí, projektů přibývá a samotné projekty se stávají složitějšími. Tak či onak se situace z popsaného cyklu (a nejen to) v různé kombinaci objevují od iterace k iteraci. To vše vede k plýtvání časem, zmatku, nervům, možná — nespokojenosti zákazníka a nakonec — k ušlým penězům. I když obvykle klopýtáme na starých hrabech, nikdo z nás přece nechce opakovaně prožívat tyto situace.
Takže jsme prošli jedním cyklem vývoje a vidíme, že jsou zde problémy, které je třeba vyřešit. K tomu je třeba:
- pohodlně uchovávat výsledky práce;
- zjednodušit proces zapojení nových zaměstnanců;
- usnadnit proces nasazení vývojového prostředí;
- nastavit proces verzování modelů;
- mít pohodlný způsob validace modelů;
- najít nástroj pro správu stavu modelů;
- najít způsob dodání modelů do produkce.
Je zřejmě třeba vymyslet workflow, který by umožňoval snadno a pohodlně spravovat tento životní cyklus? Taková praxe má název MLOps
MLOps, nebo DevOps pro strojové učení, umožňuje týmům odborníků na zpracování a analýzu dat a IT specialistů spolupracovat a zvyšovat tempo vývoje a nasazení modelů pomocí monitorování, testování a systému správy pro modely strojového učení.
Můžete , co o tom všem myslí kluci z Google. Z článku je jasné, že MLOps je poměrně obsáhlá záležitost.
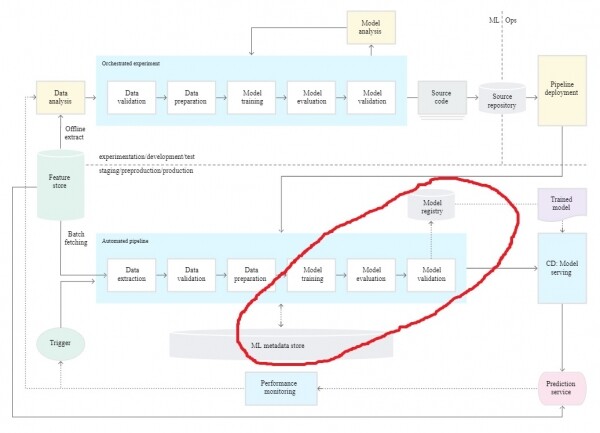
V dalším článku popíšu pouze část procesu. Pro implementaci využiji nástroj MLflow, protože je to projekt s otevřeným zdrojovým kódem, vyžadující malé množství kódu pro připojení a má integraci s populárními ml-framery. Můžete si na internetu hledat další nástroje, například Kubeflow, SageMaker, Trains atd., a možná si vybrat ten, který lépe vyhovuje vašim potřebám.
"Budujeme" MLOps na příkladu využití nástroje MLFlow
MLFlow je platforma s otevřeným zdrojovým kódem pro správu životního cyklu ml modelů ().
MLflow zahrnuje čtyři komponenty:
- MLflow Tracking — řeší otázky uchovávání výsledků a parametrů, které k těmto výsledkům vedly;
- MLflow Project — umožňuje zabalit kód a reprodukovat ho na jakékoliv platformě;
- MLflow Models — zodpovídá za nasazení modelů do produkce;
- MLflow Registry — umožňuje uchovávat modely a řídit jejich stav v centralizovaném úložišti.
MLflow pracuje se dvěma entitami:
- běh — to je kompletní cyklus učení, parametry a metriky, které chceme registrovat;
- experiment — to je "téma", kolem kterého jsou spojeny běhy.
Všechny kroky příkladu jsou realizovány na operačním systému Ubuntu 18.04.
1. Rozbalení serveru
Abychom mohli snadno spravovat náš projekt a získávat veškeré potřebné informace, nainstalujeme server. MLflow tracking server má dvě hlavní komponenty:
- backend store — zodpovídá za uchovávání informací o registrovaných modelech (podporuje 4 DBMS: mysql, mssql, sqlite a postgresql);
- artifact store — zodpovídá za uchovávání artefaktů (podporuje 7 variant úložiště: Amazon S3, Azure Blob Storage, Google Cloud Storage, FTP server, SFTP server, NFS, HDFS).
Jako artifact store pro jednoduchost vezmeme sftp server.
- vytvoření skupiny
$ sudo groupadd sftpg - přidání uživatele a nastavení mu hesla
$ sudo useradd -g sftpg mlflowsftp $ sudo passwd mlflowsftp - úprava několika nastavení přístupu
$ sudo mkdir -p /data/mlflowsftp/upload $ sudo chown -R root.sftpg /data/mlflowsftp $ sudo chown -R mlflowsftp.sftpg /data/mlflowsftp/upload - přidání několika řádků do /etc/ssh/sshd_config
Match Group sftpg ChrootDirectory /data/%u ForceCommand internal-sftp - restartování služby
$ sudo systemctl restart sshd
Jako backend store vezmeme postgresql.
$ sudo apt update
$ sudo apt-get install -y postgresql postgresql-contrib postgresql-server-dev-all
$ sudo apt install gcc
$ pip install psycopg2
$ sudo -u postgres -i
# Vytvořte nového uživatele: mlflow_user
[postgres@user_name~]$ createuser --interactive -P
Zadejte název role, kterou chcete přidat: mlflow_user
Zadejte heslo pro novou roli: mlflow
Zadejte ho znovu: mlflow
Bude nová role superuživatelská? (y/n) n
Bude nová role moci vytvářet databáze? (y/n) n
Bude nová role moci vytvářet další nové role? (y/n) n
# Vytvořte databázi mlflow_bd vlastněnou mlflow_user
$ createdb -O mlflow_user mlflow_db
K spuštění serveru je nutné nainstalovat následující python balíčky (doporučuji vytvořit samostatné virtuální prostředí):
pip install mlflow
pip install pysftp
Spouštíme náš server
$ mlflow server
                 --backend-store-uri postgresql://mlflow_user:mlflow@localhost/mlflow_db
                 --default-artifact-root sftp://mlflowsftp:mlflow@sftp_host/upload
                --host server_host
                --port server_port
2. Přidání sledování
Aby výsledky našich tréninků nezmizely, budoucí generace vývojářů chápaly, co se vlastně dělo, a starší kolegové a vy mohli pokojně analyzovat proces učení, musíme přidat sledování. Pod sledováním rozumíme uchování parametrů, metrik, artefaktů a jakýchkoli dalších informací o spuštění tréninku, v našem případě, na serveru.
Pro příklad jsem vytvořil malý na Keras pro segmentaci všeho, co existuje v . Pro přidání sledování jsem vytvořil soubor mlflow_training.py.
Zde jsou řádky, ve kterých se děje to nejzajímavější:
def run(self, epochs, lr, experiment_name):
        # získání ID experimentu, vytvoření experimentu v jeho nepřítomnosti
        remote_experiment_id = self.remote_server.get_experiment_id(name=experiment_name)
        # vytváření "běhu" a získání jeho ID
        remote_run_id = self.remote_server.get_run_id(remote_experiment_id)

        # indikujeme, že chceme uložit výsledky na vzdáleném serveru
        mlflow.set_tracking_uri(self.tracking_uri)
        mlflow.set_experiment(experiment_name)

        with mlflow.start_run(run_id=remote_run_id, nested=False):
            mlflow.keras.autolog()
            self.train_pipeline.train(lr=lr, epochs=epochs)

        try:
            self.log_tags_and_params(remote_run_id)
        except mlflow.exceptions.RestException as e:
            print(e)
Zde self.remote_server je malý obal nad metodami mlflow.tracking. MlflowClient (udělal jsem to pro pohodlí), pomocí kterých vytvářím experiment a spuštění na serveru. Dále udávám, kam mají výsledky spuštění směřovat (mlflow.set_tracking_uri(self.tracking_uri)). Aktivuju automatické logování mlflow.keras.autolog(). V současnosti MLflow Tracking podporuje automatické logování pro TensorFlow, Keras, Gluon XGBoost, LightGBM, Spark. Pokud jste svůj rámec nebo knihovnu nenašli, vždy je můžete logovat explicitně. Spouštíme školení. Registrováme tagy a vstupní parametry na vzdáleném serveru.
Pár řádků a vy, stejně jako všichni ostatní, máte přístup k informacím o všech spuštěních. Super?
3. Vytváříme projekt
Nyní uděláme to, aby spuštění projektu bylo co nejjednodušší. K tomu přidáme do kořenového adresáře soubor MLproject a conda.yaml.
MLproject
name: flow_segmentation
conda_env: conda.yaml

entry_points:
  main:
    parameters:
        categories: {help: 'seznam kategorií z datasetu coco'}
        epochs: {type: int, help: 'počet epoch při školení'}

        lr: {type: float, default: 0.001, help: 'učení rychlost'}
        batch_size: {type: int, default: 8}
        model_name: {type: str, default: 'Unet', help: 'Unet, PSPNet, Linknet, FPN'}
        backbone_name: {type: str, default: 'resnet18', help: 'příklad resnet18, resnet50, mobilenetv2 ...'}

        tracking_uri: {type: str, help: 'adresa serveru'}
        experiment_name: {type: str, default: 'My_experiment', help: 'název experimentu na vzdáleném a místním serveru'}
    command: "python mlflow_training.py
            --epochs={epochs}
            --categories={categories}
            --lr={lr}
            --tracking_uri={tracking_uri}
            --model_name={model_name}
            --backbone_name={backbone_name}
            --batch_size={batch_size}
            --experiment_name={experiment_name}"
MLflow Project má několik vlastností:
- Name — název vašeho projektu;
- Environment — v mém případě conda_env ukazuje na to, že pro spuštění se používá Anaconda a popis závislostí se nachází v souboru conda.yaml;
- Entry Points — ukazuje, které soubory a s jakými parametry můžeme spustit (všechny parametry při spuštění školení jsou automaticky logovány)
conda.yaml
name: flow_segmentation
channels:
  - defaults
  - anaconda
dependencies:
  - python==3.7
  - pip:
    - mlflow==1.8.0
    - pysftp==0.2.9
    - Cython==0.29.19
    - numpy==1.18.4
    - pycocotools==2.0.0
    - requests==2.23.0
    - matplotlib==3.2.1
    - segmentation-models==1.0.1
    - Keras==2.3.1
    - imgaug==0.4.0
    - tqdm==4.46.0
    - tensorflow-gpu==1.14.0
Jako prostředí pro spuštění můžete použít docker, pro podrobnější informace se obraťte na .
4. Spouštíme školení
Klonomujeme projekt a přecházíme do adresáře projektu:
git clone https://github.com/simbakot/mlflow_example.git
cd mlflow_example/
Pro spuštění je nutné nainstalovat knihovny
pip install mlflow
pip install pysftp
Protože v příkladu používám conda_env, musí být na vašem počítači nainstalována Anaconda (ale to lze obejít instalováním všech potřebných balíků samostatně a experimentováním s parametry spuštění).
Všechny přípravné kroky jsou hotové a můžeme přistoupit k spuštění trénování. Z kořenového projektu:
$ mlflow run -P epochs=10 -P categories=cat,dog -P tracking_uri=http://server_host:server_port .Po zadání příkazu se automaticky vytvoří conda prostředí a spustí se trénink.
V příkladu výše jsem předal počet epoch pro trénink a kategorie, na které chceme segmentovat (úplný seznam lze zobrazit ) a adresu našeho vzdáleného serveru.
Úplný seznam možných parametrů lze zobrazit v souboru MLproject.
5. Zhodnocení výsledků trénování
Po skončení trénování se můžeme v prohlížeči připojit k adrese našeho serveru
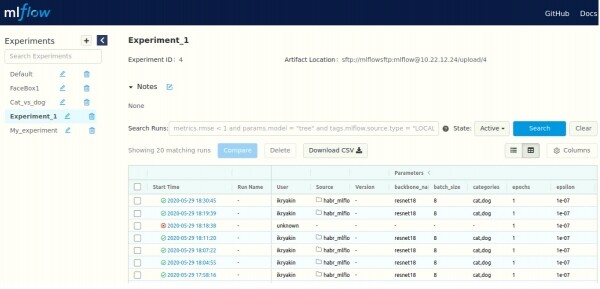
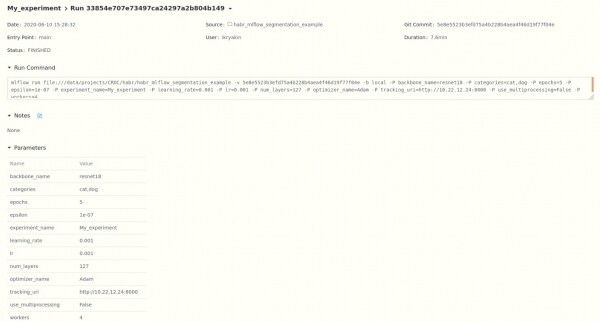
Zde vidíme seznam všech experimentů (nalevo nahoře), stejně jako informace o spuštěních (uprostřed). Můžeme se podívat na podrobnější informace (parametry, metriky, artefakty a nějaké další informace) k každému spuštění.
U každé metriky můžeme sledovat historii změn.
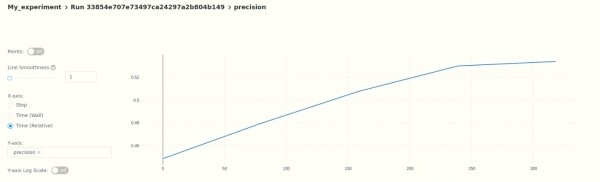
To znamená, že v současné době můžeme analyzovat výsledky v "ručním" režimu, také můžete nastavit automatickou validaci pomocí MLflow API.
6. Registrace modelu
Poté, co jsme analyzovali náš model a rozhodli jsme se, že je připraven do akce, přistoupíme k jeho registraci. K tomu vybereme potřebné spuštění (jak bylo ukázáno v předchozím bodě) a posuneme se dolů.
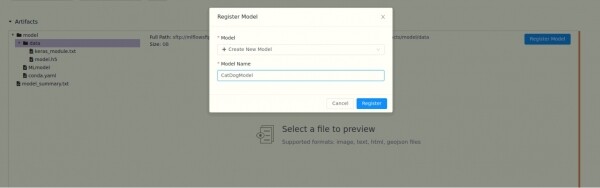
Jakmile jsme dali našemu modelu jméno, získá verzi. Při uložení jiného modelu se stejným jménem se verze automaticky zvýší.
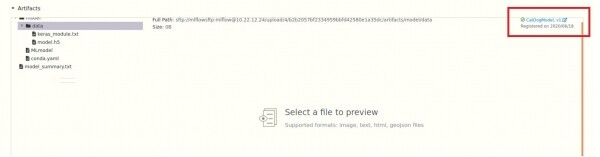
Pro každý model můžeme přidat popis a vybrat jeden ze tří stavů (Staging, Production, Archived), následně se pomocí API můžeme odkazovat na tyto stavy, což společně s verzováním poskytuje dodatečnou flexibilitu.
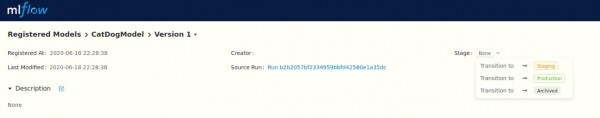
Také máme pohodlný přístup ke všem modelům
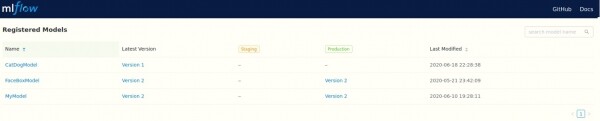
a jejich verzím.
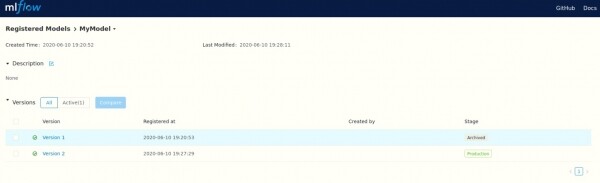
Stejně jako v předchozím bodě lze všechny operace provést pomocí API.
7. Nasazení modelu
V tuto chvíli máme již natrénovaný (keras) model. Příklad, jak ho lze použít:
class SegmentationModel:
    def __init__(self, tracking_uri, model_name):

        self.registry = RemoteRegistry(tracking_uri=tracking_uri)
        self.model_name = model_name
        self.model = self.build_model(model_name)

    def get_latest_model(self, model_name):
        registered_models = self.registry.get_registered_model(model_name)
        last_model = self.registry.get_last_model(registered_models)
        local_path = self.registry.download_artifact(last_model.run_id, 'model', '.\/')
        return local_path

    def build_model(self, model_name):
        local_path = self.get_latest_model(model_name)

        return mlflow.keras.load_model(local_path)

    def predict(self, image):
        image = self.preprocess(image)
        result = self.model.predict(image)
        return self.postprocess(result)

    def preprocess(self, image):
        image = cv2.resize(image, (256, 256))
        image = image / 255.
        image = np.expand_dims(image, 0)
        return image

    def postprocess(self, result):
        return result
Tady self.registry je opět malá obálka nad mlflow.tracking.MlflowClient pro pohodlnější použití. Podstatou je, že se obracím na vzdálený server a hledám tam model se zadaným názvem, přičemž žádám o nejnovější produkční verzi. Následně stahuji artefakt lokálně do složky .\/model a sestavuji model z tohoto adresáře mlflow.keras.load_model(local_path). A teď můžeme použít náš model. Vývojáři CV (ML) se mohou v klidu zabývat vylepšováním modelu a publikováním nových verzí.
Na závěr
Představil jsem systém, který umožňuje:
- centralizovaně uchovávat informace o ML modelech, průběhu a výsledcích trénování;
- rychle zprovoznit vývojové prostředí;
- sledovat a analyzovat průběh práce na modelech;
- pohodlně řídit verze a spravovat stav modelů;
- snadno deployovat získané modely.
Tento příklad je jednoduše ukázkový a slouží jako výchozí bod pro vybudování vašeho vlastního systému, který možná bude zahrnovat automatizaci hodnocení výsledků a registraci modelů (p.5 a p.6 příslušně), nebo přidáte verziování datasetů, nebo něco jiného? Snažil jsem se vyjádřit myšlenku, že potřebujete MLOps jako celek, MLflow je pouze prostředek k dosažení cíle.
Napište, jaké problémy, se kterými jste se potýkali, jsem nezmínil?
Co byste do systému přidali, aby pokrýval vaše potřeby?
Jaké nástroje a přístupy používáte, abyste pokryli všechny nebo část problémů?
P.S. Zanechám pár odkazů:
github projekt —
MLflow —
Má pracovní e-mail pro dotazy — ikryakin@croc.ru
Naše společnost pravidelně organizuje různé akce pro IT specialisty, například: 8. července v 19:00 SELČ se uskuteční online meetup na téma CV, pokud máte zájem, můžete se zúčastnit, registrace. .
Zdroj: habr.com
