

Překlad článku byl vyhotoven před začátkem kurzu .
Jak ušetřit na cloudových nákladech při práci s Kubernetes? Neexistuje jediné správné řešení, ale v tomto článku je popsáno několik nástrojů, které vám pomohou efektivněji spravovat zdroje a snížit náklady na cloudové výpočty.
Tento článek jsem napsal s ohledem na Kubernetes pro AWS, ale bude se (téměř) stejně vztahovat i na jiné cloudové poskytovatele. Předpokládám, že váš cluster(y) již má nastavené automatické škálování (). Odstranění zdrojů a zmenšení rozsahu nasazení povede k úsporám pouze tehdy, pokud také sníží váš park pracovních uzlů (instancí EC2).
V tomto článku budou zvažovány:
- čištění nepoužívaných zdrojů ()
- snížení škálování mimo pracovní dobu ()
- využití horizontálního automatizovaného škálování (HPA),
- snížení nadbytečného rezervování zdrojů (, VPA)
- využití Spot instancí
Úklid nepoužívaných zdrojů
Práce v rychle se měnícím prostředí je skvělá. Chceme, aby technické organizace . Rychlejší dodání softwaru také znamená více PR nasazení, předběžných prostředí, prototypů a analytických řešení. Všechno je nasazeno na Kubernetes. Kdo má čas ručně uklízet testovací nasazení? Snadno se zapomene na odstranění experimentu starého týden. Účet za cloud nakonec poroste, protože jsme zapomněli uzavřít:
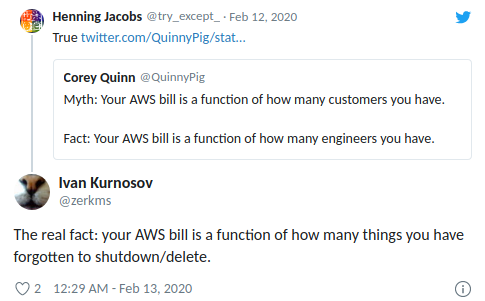
(Henning Jacobs:
Život:
(cituje) Cory Quinn:
Mýtus: Váš AWS účet je funkcí závislosti na počtu vašich uživatelů.
Fakt: Váš AWS účet je funkcí závislosti na počtu vašich inženýrů.
Ivan Kurnosov (v odpovědi):
Skutečný fakt: Váš AWS účet je funkcí závislosti na počtu věcí, které jste zapomněli vypnout/odstranit.)
(kube-janitor) pomáhá vyčistit váš cluster. Konfigurace janitoru je flexibilní jak pro globální, tak pro lokální použití:
- Obecná pravidla pro celý cluster mohou určovat maximální dobu života (TTL – time-to-live) pro PR/testovací nasazení.
- Jednotlivé zdroje mohou být anotovány pomocí janitor/ttl, například pro automatické odstranění spike/prototypu po 7 dnech.
Obecná pravidla jsou určena v YAML souboru. Jeho cesta je předána přes parametr --rules-file v kube-janitor. Zde je příklad pravidla pro odstranění všech prostorů názvů s -pr- v názvu za dva dny:
- id: cleanup-resources-from-pull-requests
  resources:
    - namespaces
  jmespath: "contains(metadata.name, '-pr-')"
  ttl: 2d
Další příklad reguluje použití štítku application na Deployment a StatefulSet podech pro všechny nové Deployments/StatefulSet v roce 2020, ale zároveň umožňuje provádět testy bez tohoto štítku po dobu jednoho týdne:
- id: require-application-label
  # odstranit deployments a statefulsets bez štítku "application"
  resources:
    - deployments
    - statefulsets
  # viz http://jmespath.org/specification.html
  jmespath: "!(spec.template.metadata.labels.application) && metadata.creationTimestamp > '2020-01-01'"
  ttl: 7d
Spuštění časově omezené ukázky po dobu 30 minut v clusteru, kde běží kube-janitor:
kubectl run nginx-demo --image=nginx
kubectl annotate deploy nginx-demo janitor/ttl=30m
Dalším zdrojem rostoucích nákladů jsou trvalé svazky (AWS EBS). Při odstraňování Kubernetes StatefulSet se jeho trvalé svazky (PVC — PersistentVolumeClaim) neodstraňují. Nepoužívané objemy EBS mohou snadno vést k nákladům v řádu stovek dolarů měsíčně. Kubernetes Janitor má funkci pro čištění nepoužívaných PVC. Například toto pravidlo odstraní všechna PVC, která nejsou připojena modulem a na která se nevztahuje StatefulSet nebo CronJob:
# удалить все PVC, которые не смонтированы и на которые не ссылаются StatefulSets
- id: remove-unused-pvcs
  resources:
  - persistentvolumeclaims
  jmespath: "_context.pvc_is_not_mounted && _context.pvc_is_not_referenced"
  ttl: 24h
Kubernetes Janitor vám může pomoci udržet váš cluster v "čistotě" a zabránit pomalému hromadění nákladů na cloudové výpočty. Pro pokyny k nasazení a nastavení sledujte v .
Snížení škálování mimo pracovní dobu
Testovací a interimní systémy obvykle potřebují fungovat pouze během pracovní doby. Některé výrobní aplikace, jako je back-office/nástroje pro správu, vyžadují také pouze omezenou dostupnost a mohou být večer vypnuty.
(kube-downscaler) umožňuje uživatelům a operátorům snižovat měřítko systému během nepracovního času. Nasazení a StatefulSets mohou být škálována až na nulové repliky. CronJobs mohou být pozastaveny. Kubernetes Downscaler se nastavuje pro celý cluster, jedno nebo více jmenných prostorů nebo jednotlivé zdroje. Lze nastavit buď „čas nečinnosti“, nebo „čas provozu“. Například pro maximální snížení škálování v noci a o víkendech:
image: hjacobs/kube-downscaler:20.4.3
args:
  - --interval=30
  # neodpojujte komponenty infrastruktury
  - --exclude-namespaces=kube-system,infra
  # neodpojujte kube-downscaler, a také nechte Postgres Operator, aby bylo možné spravovat vyloučené DB
  - --exclude-deployments=kube-downscaler,postgres-operator
  - --default-uptime=Po-Pá 08:00-20:00 Evropa/Berlín
  - --include-resources=deployments,statefulsets,stacks,cronjobs
  - --deployment-time-annotation=deployment-time
Toto je graf škálování pracovních uzlů clusteru o víkendech:
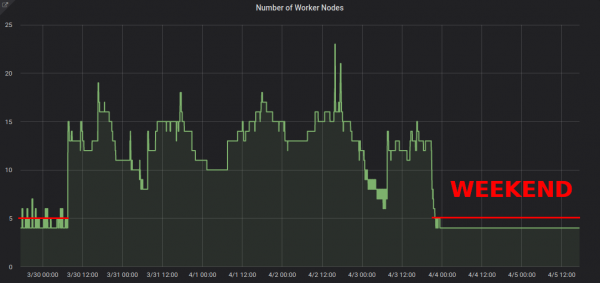
Snížení měřítka z ~13 na 4 pracovní uzly zjevně znamená významný rozdíl v účtu AWS.
Ale co když potřebuji pracovat během „času nečinnosti“ clusteru? Některá nasazení mohou být trvale vyloučena ze škálování přidáním anotace downscaler/exclude: true. Nasazení mohou být dočasně vyloučena pomocí anotace downscaler/exclude-until s absolutním časovým razítkem ve formátu RRRR-MM-DD HH:MM (UTC). Pokud je to nutné, může být celý cluster znovu škálován nasazením podu s anotací downscaler/force-uptime, například spuštěním nginx šablony:
kubectl run scale-up --image=nginx
kubectl annotate deploy scale-up janitor/ttl=1h # odstranit nasazení za hodinu
kubectl annotate pod $(kubectl get pod -l run=scale-up -o jsonpath="{.items[0].metadata.name}") downscaler/force-uptime=true
Viz , pokud máte zájem o instrukce k nasazení a další možnosti.
Použijte horizontální automatické škálování
Mnoho aplikací/služeb se vypořádává s dynamickým vzorem zatížení: někdy jejich moduly nepracují, a někdy pracují na plný výkon. Práce s trvalým parkem podů, aby se vyrovnala s maximálním špičkovým zatížením, není úsporná. Kubernetes podporuje horizontální automatické škálování prostřednictvím zdroje (HPA). Použití CPU je často dobrým ukazatelem pro škálování:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: my-app
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: my-app
  minReplicas: 3
  maxReplicas: 10
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        averageUtilization: 100
        type: Utilization
Zalando vytvořil komponentu pro jednoduché připojení uživatelských metrik pro škálování: (kube-metrics-adapter) je univerzální adaptér metrik pro Kubernetes, který může shromažďovat a zpřístupňovat uživatelské a externí metriky pro horizontální automatické škálování podů. Podporuje škálování na základě metrik Prometheus, front SQS a dalších nastavení. Například pro škálování nasazení podle uživatelské metriky, kterou aplikace poskytuje ve formátu JSON na /metrics, použijte:
apiVersion: autoscaling/v2beta2
kind: HorizontalPodAutoscaler
metadata:
  name: myapp-hpa
  annotations:
    # metric-config.../
    metric-config.pods.requests-per-second.json-path/json-key: "$.http_server.rps"
    metric-config.pods.requests-per-second.json-path/path: /metrics
    metric-config.pods.requests-per-second.json-path/port: "9090"
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: myapp
  minReplicas: 1
  maxReplicas: 10
  metrics:
  - type: Pods
    pods:
      metric:
        name: requests-per-second
      target:
        averageValue: 1k
        type: AverageValue
Nastavení horizontálního automatického škálování pomocí HPA by mělo být jedním z výchozích kroků pro zvýšení efektivity pro služby bez ohledu na stav. Spotify má prezentaci se svými zkušenostmi a doporučeními pro HPA: .
Snížení nadbytečného rezervování zdrojů
Pracovní zátěže Kubernetes určují své potřeby na CPU/paměť pomocí „požadavků na zdroje“ (resource requests). Zdroje CPU se měří ve virtuálních jádrech nebo častěji v „milikoře“ (millicores), například 500m znamená 50% vCPU. Zdroje paměti se měří v bajtech a lze používat běžné přípony, například 500Mi, což znamená 500 megabajtů. Požadavky na zdroje „uzamykají“ objem na pracovních uzlech, tj. modul s požadavkem CPU 1000m na uzlu se 4 virtuálními CPU nechá pouze 3 virtuální CPU k dispozici pro jiné moduly.
Slack (nadbytek rezervy) — je to rozdíl mezi požadovanými zdroji a skutečným využitím. Například pod, který požaduje 2 GiB paměti, ale používá pouze 200 MiB, má ~ 1,8 GiB „nadbytečné“ paměti. Nadbytek něco stojí. Lze hrubě odhadnout, že 1 GiB nadbytečné paměti stojí ~ 10 dolarů měsíčně.
(kube-resource-report) zobrazuje nadbytečné rezervy a může vám pomoci určit potenciální úspory:
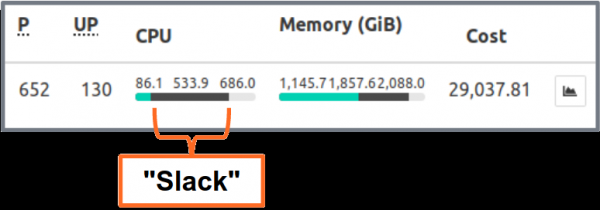
ukazuje nadbytek agregovaný podle aplikace a týmu. To umožňuje najít místa, kde mohou být požadavky na zdroje sníženy. Vygenerovaná HTML zpráva poskytuje pouze snímek využití zdroje. Měli byste sledovat využití CPU/paměti v průběhu času, aby se určily adekvátní požadavky na zdroje. Zde je graf Grafana pro „typickou“ službu s vysokou zátěží na CPU: všechny pody používají výrazně méně než 3 požadovaná jádra CPU:
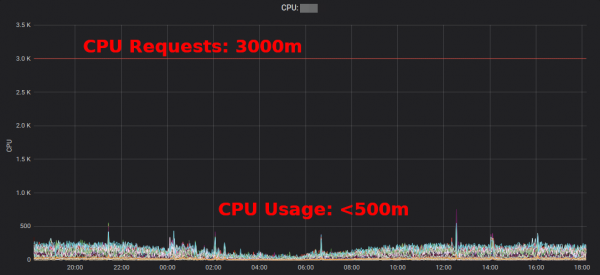
Snížení požadavku CPU z 3000m na ~400m uvolňuje zdroje pro jiné pracovní zátěže a umožňuje zmenšení clusteru.
„Průměrné využití CPU instancí EC2 se často pohybuje v rozmezí jednociferných procent,“ — . Zatímco pro EC2 , změna některých požadavků na zdroje Kubernetes v YAML souboru se provádí snadno a může přinést obrovské úspory.
Ale opravdu chceme, aby lidé měnili hodnoty v YAML souborech? Ne, stroje to mohou udělat mnohem lépe! Kubernetes (VPA) se tím právě zabývá: přizpůsobuje požadavky na zdroje a limity podle pracovní zátěže. Zde je příklad grafu požadavků CPU Prometheus (tenká modrá čára), přizpůsobených VPA v průběhu času:
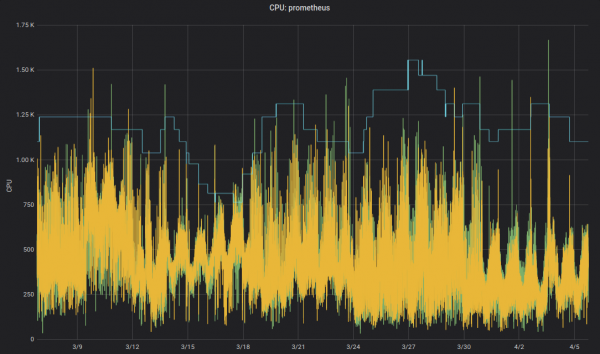
pro komponenty infrastruktury. Nekritické aplikace mohou také využívat VPA.
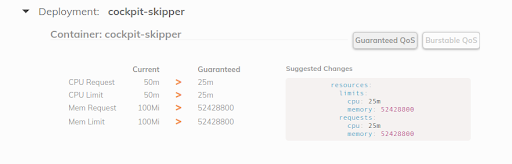
od Fairwind — je nástroj, který vytváří VPA pro každé nasazení v prostoru názvů a poté zobrazuje doporučení VPA na své nástěnce. Může pomoci vývojářům nastavit správné požadavky na CPU/paměť pro jejich aplikace:
Napsal jsem malý v roce 2019, a nedávno na .
Použití instancí EC2 Spot
Nakonec, což není méně důležité, náklady AWS EC2 lze snížit použitím Spot instancí jako pracovních uzlů Kubernetes. . Spot instance jsou k dispozici se slevou až 90 % oproti cenám na vyžádání. Spuštění Kubernetes na EC2 Spot je skvělá kombinace: musíte specifikovat více různých typů instancí pro vyšší dostupnost, což znamená, že můžete získat větší uzel za stejnou nebo nižší cenu, a zvýšená kapacita může být využita kontejnery Kubernetes.
Jak spustit Kubernetes na EC2 Spot? Existuje několik možností: použít třetí stranu, jako je SpotInst (nyní se jmenuje „Spot“, neptáte se mě proč), nebo jednoduše přidat Spot AutoScalingGroup (ASG) do vašeho clusteru. Například zde je kousek CloudFormation pro „kapacitně optimalizovanou“ Spot ASG s několika typy instancí:
MySpotAutoScalingGroup:
 Properties:
   HealthCheckGracePeriod: 300
   HealthCheckType: EC2
   MixedInstancesPolicy:
     InstancesDistribution:
       OnDemandPercentageAboveBaseCapacity: 0
       SpotAllocationStrategy: capacity-optimized
     LaunchTemplate:
       LaunchTemplateSpecification:
         LaunchTemplateId: !Ref LaunchTemplate
         Version: !GetAtt LaunchTemplate.LatestVersionNumber
       Overrides:
         - InstanceType: "m4.2xlarge"
         - InstanceType: "m4.4xlarge"
         - InstanceType: "m5.2xlarge"
         - InstanceType: "m5.4xlarge"
         - InstanceType: "r4.2xlarge"
         - InstanceType: "r4.4xlarge"
   LaunchTemplate:
     LaunchTemplateId: !Ref LaunchTemplate
     Version: !GetAtt LaunchTemplate.LatestVersionNumber
   MinSize: 0
   MaxSize: 100
   Tags:
   - Key: k8s.io/cluster-autoscaler/node-template/label/aws.amazon.com/spot
     PropagateAtLaunch: true
     Value: "true"
Některé poznámky k používání Spot s Kubernetes:
- Musíte zpracovávat ukončení Spot, například odebráním uzlu při zastavení instance.
- Zalando používá oficiální automatizaci škálování clusteru s prioritami uzlového poolu.
- Uzly Spot přijímat “registrace” pracovních zátěží pro spuštění v Spot.
Shrnutí
Doufám, že některé z uvedených nástrojů najdete užitečné pro snížení vašich nákladů na cloudové služby. Většinu obsahu článku můžete také najít v .
Jaké jsou vaše nejlepší praktiky pro úsporu nákladů na cloud na Kubernetes? Prosím, dejte vědět na .
Ve skutečnosti zbývají méně než 3 virtuální CPU, které budou použitelné, protože šířka pásma uzlu klesá v důsledku rezervovaných systémových zdrojů. Kubernetes rozlišuje mezi fyzickou kapacitou uzlu a „alokovanými“ zdroji ().
Příklad výpočtu: jeden příklad m5.large s 8 GiB paměti stojí přibližně 84 USD měsíčně (eu-central-1, On-Demand), což znamená, že blokování 1/8 uzlu stojí přibližně 10 USD měsíčně.
Existuje také mnoho dalších způsobů, jak snížit váš EC2 účet, například rezervované instance, plán úspor atd. — o těchto tématech se zde nebudu rozepisovat, ale určitě byste se o nich měli dozvědět!
Zdroj: habr.com
