

Nedávno jsme čelili otázce výběru ETL nástroje pro práci s BigData. Předchozí řešení Informatica BDM nám nevyhovovalo kvůli omezené funkčnosti. Jeho použití se zúžilo na rámec pro spouštění příkazů spark-submit. Na trhu nebylo příliš mnoho analogů, schopných pracovat s objemem dat, se kterými se setkáváme každý den. Nakonec jsme zvolili Ab Initio. Během pilotních demonstrací produkt prokázal velmi vysokou rychlost zpracování dat. Informací o Ab Initio v ruštině je téměř nedostatek, a proto jsme se rozhodli podělit se o naše zkušenosti na Habru.
Ab Initio obsahuje řadu klasických a neobvyklých transformací, jejichž kód může být rozšířen pomocí vlastního jazyka PDL. Pro malé podniky může tento mocný nástroj být pravděpodobně nadbytečný, a většina jeho funkcí se může zdát drahá a nevyužitá. Ale pokud se vaše rozsahy blíží těm z Sberbank, pak by vás Ab Initio mohl zajímat.
Pomáhá podnikům globálně shromažďovat znalosti a rozvíjet ekosystém, a vývojářům umožňuje zlepšovat své dovednosti v ETL, zdokonalovat znalosti v shellu, poskytuje možnost osvojení jazyka PDL, dává vizuální obraz načítacích procesů a usnadňuje vývoj díky bohatství funkčních komponentů.
V příspěvku se podělím o možnosti Ab Initio a uvedu srovnávací charakteristiky jeho práce s Hive a GreenPlum.
- Popis rámce MDW a práce na jeho doladění pro GreenPlum
- Srovnávací charakteristiky výkonu Ab Initio při práci s Hive a GreenPlum
- Práce Ab Initio s GreenPlum v režimu Near Real Time
Funkčnost tohoto produktu je velmi široká a vyžaduje značné množství času na své osvojování. Nicméně, při odpovídajících dovednostech a správných nastaveních výkonu jsou výsledky zpracování dat velmi působivé. Použití Ab Initio pro vývojáře může poskytnout zajímavé zkušenosti. Je to nový pohled na ETL vývoj, hybrid mezi vizuálním prostředím a vývojem načítacích skriptů na jazykové bázi.
Obchody rozvíjejí své ekosystémy a tento nástroj se jim hodí jako nikdy předtím. S pomocí Ab Initio lze shromažďovat znalosti o aktuálním podnikání a využívat tyto poznatky k rozšiřování stávajícího a otevírání nových podniků. Alternativami k Ab Initio jsou vizuální vývojová prostředí jako Informatica BDM a nevizualizační prostředí – Apache Spark.
Popis Ab Initio
Ab Initio, jako ostatní ETL nástroje, představuje sadu produktů.
Ab Initio GDE (Graphical Development Environment) je prostředí pro vývojáře, ve kterém nastavuje transformace dat a spojuje je do datových toků ve formě šipek. Taková sada transformací se nazývá graf:
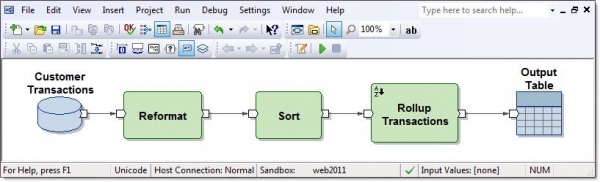
Vstupní a výstupní spojení funkčních komponentů jsou porty a obsahují pole, která jsou vypočítána uvnitř transformací. Několik grafů, propojených toky ve formě šipek v pořadí jejich vykonání, se nazývá plán.
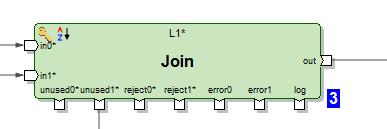
Existuje několik stovek funkčních komponentů, což je velmi mnoho. Mnoho z nich je vysoce specializovaných. Možnosti klasických transformací v Ab Initio jsou širší než v jiných ETL nástrojích. Například Join má několik výstupů. Kromě výsledku spojení datových sad lze na výstupu získat záznamy vstupních datových sad, podle klíčů, podle kterých se nepodařilo spojit. Také lze získat rejects, errors a log práce transformace, který lze ve stejném grafu přečíst jako textový soubor a zpracovat dalšími transformacemi:
Nebo například lze materializovat příjemce dat ve formě tabulky a ve stejném grafu z něj číst data.
Existují originální transformace. Například transformace Scan má funkčnost, jako mají analytické funkce. Existují transformace s výmluvnými názvy: Create Data, Read Excel, Normalize, Sort within Groups, Run Program, Run SQL, Join with DB a další. Grafy mohou používat parametry spouštění, včetně možnosti přenášet parametry z operačního systému nebo do operačního systému. Soubory s hotovým souborem předávaných parametrů grafu se nazývají parameter sets (psets).
Jak se patří, Ab Initio GDE má svůj repozitář, nazývaný EME (Enterprise Meta Environment). Vývojáři mají možnost pracovat s lokálními verzemi kódu a provádět check in svých vývojů do centrálního repozitáře.
Během vykonávání nebo po vyhotovení grafu je možné kliknout na jakékoli spojení transformace toku a zobrazit data, která prošla mezi těmito transformacemi:
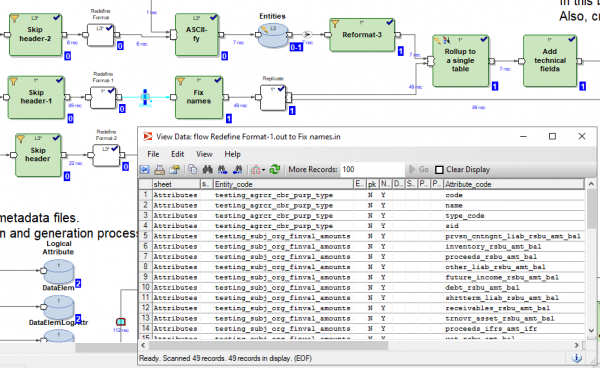
Je také možné kliknout na jakýkoli tok a zobrazit podrobnosti sledování – kolik paralel bylo použito při transformaci, kolik řádků a bajtů se načetlo v které paralelní větvi:
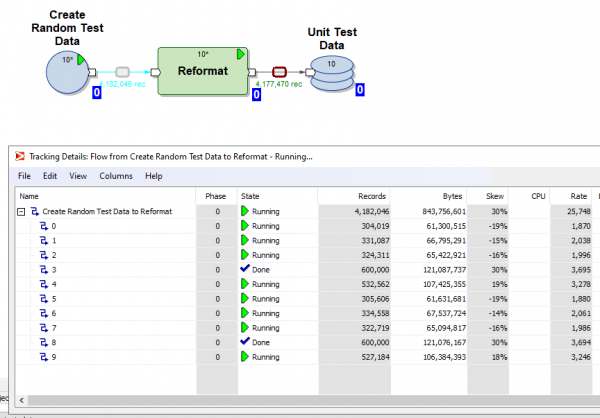
Existuje možnost rozdělit vykonání grafu do fází a označit, které transformace se mají vykonávat nejdříve (v nulté fázi), následující v první fázi, další ve druhé fázi atd.
U každé transformace si můžete vybrat takzvaný layout (kde se provede): bez paralel nebo v paralelních tocích, jejichž počet můžete určit. Přitom dočasné soubory, které Ab Initio vytváří při práci s transformacemi, lze umístit jak do souborového systému serveru, tak do HDFS.
V každé transformaci na základě šablony lze defaultně vytvořit vlastní skript v jazyce PDL, který poněkud připomíná shell.
Pomocí jazyka PDL můžete rozšiřovat funkčnost transformací a zejména můžete dynamicky (během vykonávání) generovat libovolné fragmenty kódu v závislosti na parametrech vykonání.
Také v Ab Initio je silně rozvinuta integrace s operačními systémy prostřednictvím shellu. Konkrétně v Sberbank se používá linux ksh. Můžete si vyměňovat s shell proměnné a používat je jako parametry grafů. Můžete přes shell spouštět vykonání grafů Ab Initio a spravovat Ab Initio.
Kromě Ab Initio GDE se dodává mnoho dalších produktů. Existuje vlastní Co>Operation System, která si klade za cíl být operačním systémem. Existuje Control>Center, ve kterém lze naplánovat a monitorovat toky načítání. Existují produkty pro vývoj na primitivnější úrovni, než jakou umožňuje Ab Initio GDE.
Popis rámce MDW a práce na jeho doladění pro GreenPlum
Společně se svými produkty dodává dodavatel i produkt MDW (Metadata Driven Warehouse), který představuje konfigurátor grafů určený k podpoře typických úloh pro naplňování datových skladů nebo data vaults.
Obsahuje uživatelské (specifické pro projekt) parsery metadat a hotové generátory kódu „z krabice“.
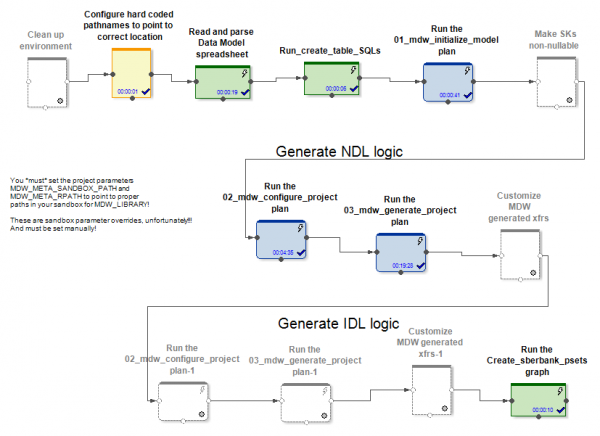
Na vstupu MDW obdrží model dat, konfigurační soubor pro nastavení připojení k databázi (Oracle, Teradata nebo Hive) a některá další nastavení. Specifická část pro projekt například nasazuje model do databáze. Standardní část produktu generuje grafy a konfigurační soubory pro ně na základě načítání dat do tabulek modelu. Při tom jsou vytvářeny grafy (a psets) pro několik režimů iniciační a inkrementální práce na aktualizaci entit.
V případech Hive a RDBMS se generují různorodé grafy pro iniciační a inkrementální aktualizaci dat.
V případě Hive jsou přijatá data delta spojena prostřednictvím Ab Initio Join s daty, která byla v tabulce před aktualizací. Načítací aplikace v MDW (jak v Hive, tak v RDBMS) nejen vkládají nová data z delty, ale také uzavírají období platnosti dat podle primárních klíčů, ke kterým byla delta přijata. Kromě toho je nutné znovu přepsat nezměněnou část dat. Ale to je nezbytné, protože v Hive neexistují operace delete nebo update.
V případě RDBMS vypadají grafy pro inkrementální aktualizaci dat optimalizovaněji, protože RDBMS mají skutečné možnosti aktualizace.
Přijatá delta je načtena do pomocné tabulky v databázi. Poté dochází ke spojení delty s daty, která byla v tabulce před aktualizací. Tohoto se dosahuje pomocí SQL prostřednictvím vygenerovaného SQL dotazu. Dále pomocí SQL příkazů delete+insert dochází k vložení nových dat z delty do cílové tabulky a uzavření období platnosti dat podle primárních klíčů, ke kterým byla delta přijata.
Není nutné přepisovat nezměněná data.
Takto jsme dospěli k závěru, že v případě Hive musí MDW přistoupit k přepsání celé tabulky, protože Hive nemá funkci aktualizace. A nebylo vymysleno nic lepšího než úplné přepsání dat při aktualizaci. V případě RDBMS však tvůrci produktu považovali za potřebné svěřit spojení a aktualizaci tabulek používání SQL.
Pro projekt ve Sberbanku jsme vytvořili novou opakovaně použitelnou implementaci databázového loaderu pro GreenPlum. To bylo provedeno na základě verze, kterou MDW generuje pro Teradata. Právě Teradata, a ne Oracle, byla pro toto lepší a nejblíže, protože je také MPP systémem. Způsoby práce a také syntaxe Teradata a GreenPlum se ukázaly jako podobné.
Příklady kritických rozdílů mezi různými RDBMS pro MDW jsou následující. V GreenPlum, na rozdíl od Teradata, při vytváření tabulek je třeba napsat klauzuli
distributed byV Teradata se píše
odstranit <table> all, a v GreenPlum se píše
smazat z <table>V Oracle se z důvodů optimalizace píše
delete from t where rowid in ()
, a v Teradata a GreenPlum se píše
delete from t where exists (select * from delta where delta.pk=t.pk)Ještě bychom měli poznamenat, že pro práci Ab Initio s GreenPlum bylo nutné nainstalovat klienta GreenPlum na všechny uzly clusteru Ab Initio. To je proto, že jsme se připojili k GreenPlum současně ze všech uzlů našeho clusteru. A aby čtení z GreenPlum bylo paralelní a každý paralelní tok Ab Initio četl svou část dat z GreenPlum, bylo třeba do sekce „where“ SQL dotazů umístit pro Ab Initio srozumitelné konstrukce
where ABLOCAL()a definovat hodnotu této konstrukce, přičemž transformaci čtoucí z DB se zadává parametr
ablocal_expr=„string_concat("mod(t.", string_filter_out("{$TABLE_KEY}","{}"), ",", (decimal(3))(number_of_partitions()),")=", (decimal(3))(this_partition()))„, která se zkompiluje na něco jako
mod(sk,10)=3, tedy je třeba poskytnout GreenPlum explicitní filtr pro každou partition. Pro jiné databáze (Teradata, Oracle) může Ab Initio tuto paralelizaci provést automaticky.
Srovnávací charakteristiky výkonu Ab Initio při práci s Hive a GreenPlum
Ve Sberbank byl proveden experiment porovnání výkonu generovaných MDW grafů aplikovatelných na Hive a GreenPlum. V rámci experimentu měl Hive 5 uzlů na tom samém clusteru jako Ab Initio, zatímco GreenPlum měl 4 uzly na samostatném clusteru. Tedy Hive měl určitou výhodu nad GreenPlum „z hlediska hardwaru“.
Byly zváženy dva páry grafů, které vykonávaly stejný úkol aktualizace dat v Hive a GreenPlum. Spouštěly se grafy generované konfigurátorem MDW:
- inicializační načítání + inkrementální načítání náhodně generovaných dat do tabulky Hive
- inicializační načítání + inkrementální načítání náhodně generovaných dat do stejné tabulky GreenPlum
Ve všech případech (Hive a GreenPlum) byly spuštěny načítání ve 10 paralelních vláknech na stejné klastru Ab Initio. Meziprodukty pro výpočty byly uloženy v HDFS (v termínech Ab Initio byl použit MFS layout using HDFS). Jedna řádka náhodně generovaných dat zabírala v obou případech 200 bytů.
Výsledek byl následující:
Hive:
Iniciační načítání v Hive
Vloženo řádků
6 000 000
60 000 000
600 000 000
Délka iniciačního
načítání v sekundách
41
203
1 601
Inkrementální načítání v Hive
Počet řádků, které byly v
cílové tabulce na začátku experimentu
6 000 000
60 000 000
600 000 000
Počet řádků delta, které byly použity v
cílové tabulce během experimentu
6 000 000
6 000 000
6 000 000
Délka inkrementálního
načítání v sekundách
88
299
2 541
GreenPlum:
Iniciační načítání v GreenPlum
Vloženo řádků
6 000 000
60 000 000
600 000 000
Délka iniciačního
načítání v sekundách
72
360
3 631
Inkrementální načítání v GreenPlum
Počet řádků, které byly v
cílové tabulce na začátku experimentu
6 000 000
60 000 000
600 000 000
Počet řádků delta, které byly použity v
cílové tabulce během experimentu
6 000 000
6 000 000
6 000 000
Délka inkrementálního
načítání v sekundách
159
199
321
Vidíme, že rychlost iniciačního načítání jak v Hive, tak v GreenPlum lineárně závisí na objemu dat, a z důvodů lepšího hardwaru je mírně rychlejší pro Hive než pro GreenPlum.
Inkrementální načítání v Hive také lineárně závisí na objemu předem nahraných dat v cílové tabulce a probíhá poměrně pomalu se zvyšujícími se objemy. To je způsobeno nutností kompletně přeepisovat cílovou tabulku. To znamená, že uplatnění malých změn na obrovských tabulkách není pro Hive příliš dobrá praxe.
Inkrementální načítání v GreenPlum má slabou závislost na objemu předem nahraných dat v cílové tabulce a probíhá dostatečně rychle. K tomu došlo díky SQL Joins a architektuře GreenPlum, která umožňuje operaci delete.
Takže GreenPlum vkládá delta metodou delete+insert, a v Hive nejsou operace delete ani update, a proto byl celý datový blok při inkrementální aktualizaci nucen být přepsán. Nejvýznamnější je srovnání tučně vyznačených buněk, protože odpovídají nejčastějšímu způsobu využití náročných načítání. Vidíme, že GreenPlum v tomto testu vyhrál nad Hive 8x.
Práce Ab Initio s GreenPlum v režimu Near Real Time
V tomto experimentu ověříme, zda Ab Initio může provádět aktualizaci tabulky GreenPlum náhodně generovanými dávkami dat v režimu blízkém k reálnému času. Podíváme se na tabulku GreenPlum dev42_1_db_usl.TESTING_SUBJ_org_finval, se kterou se bude pracovat.
Budeme používat tři grafy Ab Initio k práci s ní:
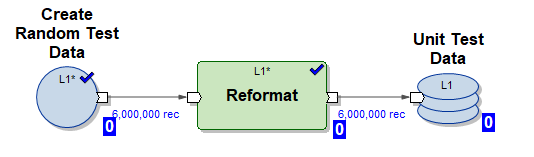
1) Graf Create_test_data.mp – vytváří v 10 paralelních vláknech soubory s daty v HDFS s 6 000 000 řádky. Data jsou náhodná, jejich struktura je organizována pro vložení do naší tabulky.
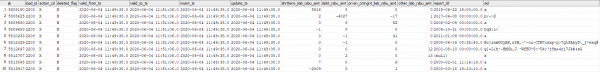
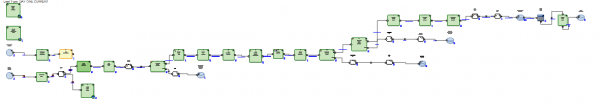
2) Graf mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset – generovaný MDW graf pro inicializační vložení dat do naší tabulky v 10 paralelních vláknech (používají se testovací data, generovaná grafem (1)).
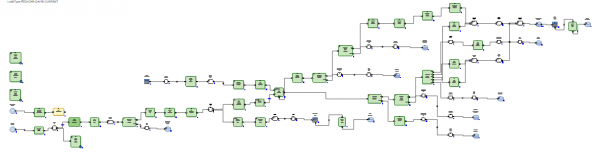
3) Graf mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset – generovaný MDW graf pro inkrementální aktualizaci naší tabulky v 10 paralelních vláknech s použitím porce čerstvých přicházejících dat (delta), generovaných grafem (1).
Spustíme níže uvedený scénář v režimu NRT:
- vygenerovat 6 000 000 testovacích řádků.
- provést inicializační načtení vložením 6 000 000 testovacích řádků do prázdné tabulky.
- opakovat 5krát inkrementální načtení.
- vygenerovat 6 000 000 testovacích řádků.
- provést inkrementální vložení 6 000 000 testovacích řádků do tabulky (starým datům se nastaví čas vypršení platnosti valid_to_ts a vkládají se novější data se stejným primárním klíčem).
Takový scénář emuluje režim skutečné práce nějakého podnikové systému – v reálném čase se objeví dostatečně objemná porce nových dat a okamžitě se integruje do GreenPlum.
Nyní se podívejme na log práce scénáře:
Start Create_test_data.input.pset at 2020-06-04 11:49:11
Finish Create_test_data.input.pset at 2020-06-04 11:49:37
Start mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:49:37
Finish mdw_load.day_one.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:50:42
Start Create_test_data.input.pset at 2020-06-04 11:50:42
Finish Create_test_data.input.pset at 2020-06-04 11:51:06
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:51:06
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:53:41
Start Create_test_data.input.pset at 2020-06-04 11:53:41
Finish Create_test_data.input.pset at 2020-06-04 11:54:04
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:54:04
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:56:51
Start Create_test_data.input.pset at 2020-06-04 11:56:51
Finish Create_test_data.input.pset at 2020-06-04 11:57:14
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:57:14
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 11:59:55
Start Create_test_data.input.pset at 2020-06-04 11:59:55
Finish Create_test_data.input.pset at 2020-06-04 12:00:23
Start mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:00:23
Finish mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset at 2020-06-04 12:03:23
Start Create_test_data.input.pset at 2020-06-04 12:03:23
Finish Create_test_data.input.pset at 2020-06-04 12:03:49
Spusťte mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset dne 2020-06-04 12:03:49
Dokončete mdw_load.regular.current.dev42_1_db_usl_testing_subj_org_finval.pset dne 2020-06-04 12:06:46
Vypadá to takto:
Graf
Čas zahájení
Čas dokončení
Délka
Vytvořte_test_data.input.pset
04.06.2020 11:49:11
04.06.2020 11:49:37
00:00:26
mdw_load.day_one.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:49:37
04.06.2020 11:50:42
00:01:05
Vytvořte_test_data.input.pset
04.06.2020 11:50:42
04.06.2020 11:51:06
00:00:24
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:51:06
04.06.2020 11:53:41
00:02:35
Vytvořte_test_data.input.pset
04.06.2020 11:53:41
04.06.2020 11:54:04
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:54:04
04.06.2020 11:56:51
00:02:47
Vytvořte_test_data.input.pset
04.06.2020 11:56:51
04.06.2020 11:57:14
00:00:23
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 11:57:14
04.06.2020 11:59:55
00:02:41
Vytvořte_test_data.input.pset
04.06.2020 11:59:55
04.06.2020 12:00:23
00:00:28
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:00:23
04.06.2020 12:03:23
00:03:00
Vytvořte_test_data.input.pset
04.06.2020 12:03:23
04.06.2020 12:03:49
00:00:26
mdw_load.regular.current.
dev42_1_db_usl_testing_subj_org_finval.pset
04.06.2020 12:03:49
04.06.2020 12:06:46
00:02:57
Vidíme, že 6 000 000 řádků inkrementu je zpracováno za 3 minuty, což je dost rychlé.
Data v cílové tabulce byla rozdělena následujícím způsobem:
select valid_from_ts, valid_to_ts, count(1), min(sk), max(sk) from dev42_1_db_usl.TESTING_SUBJ_org_finval group by valid_from_ts, valid_to_ts order by 1,2; 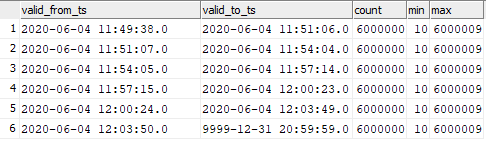
Můžeme vidět odpovídající vztah mezi vloženými daty a okamžiky spuštění grafů.
To znamená, že můžeme spouštět v Ab Initio inkrementální nahrávání dat do GreenPlum s velmi vysokou frekvencí a sledovat vysokou rychlost vkládání těchto dat do GreenPlum. Samozřejmě, spuštění každou sekundu nebude možné, protože Ab Initio, jako každý ETL nástroj, vyžaduje při spuštění čas na "rozběh".
Závěr
Nyní se Ab Initio používá ve Sberbank pro vytvoření Jednotného sémantického datového vrstvy (ESS). Tento projekt zahrnuje vybudování jediné verze stavu různých bankovních obchodních entit. Informace přicházejí z různých zdrojů, jejichž repliky jsou připravovány na Hadoop. Na základě potřeb podnikání se připraví datový model a popisují se transformace dat. Ab Initio nahrává informace do ESS a nahraná data nejenže sama o sobě představují zájem pro podnikání, ale také slouží jako zdroj pro vytváření datových vitrín. Přitom funkce produktu umožňuje používat jako příjemce různé systémy (Hive, Greenplum, Teradata, Oracle), což umožňuje bez větších obtíží připravit data pro podnikání v různých formátech, které potřebuje.
Možnosti Ab Initio jsou široké, například přiložený rámec MDW umožňuje vytvářet technickou a obchodní historii dat „z krabice“. Pro vývojáře Ab Initio umožňuje „neobjevovat kolo“ a využívat množství existujících funkčních komponentů, které v podstatě představují knihovny potřebné při práci s daty.
Autor — expert profesionální komunity Sberbank SberProfi DWH/BigData. Profesionální komunita SberProfi DWH/BigData je odpovědná za rozvoj kompetencí v oblastech jako ekosystém Hadoop, Teradata, Oracle DB, GreenPlum, a také BI nástroje Qlik, SAP BO, Tableau a další.
Zdroj: habr.com
