

Takto vypadá redundance
Kódy redundance* se široce používají v počítačových systémech pro zvýšení spolehlivosti ukládání dat. V Yandexu se používají v mnoha projektech. Například použití kódů redundance místo replikace v našem interním objektovém úložišti šetří miliony bez snížení spolehlivosti. Přesto je pochopitelné vysvětlení toho, jak kódy redundance fungují, velmi vzácné. Zájemci se často potýkají s následujícím (z ):
Jmenuji se Vadim, v Yandexu se zabývám vývojem interního objektového úložiště MDS. V tomto článku jednoduše popíšu teoretické základy kódů redundance (kódů Reed-Solomon a LRC). Vysvětlím, jak to funguje, bez složité matematiky a vzácné terminologie. Na konci uvedu příklady použití kódů redundance v Yandexu.
Některé matematické detaily nebudu podrobně rozebírat, ale poskytnu odkazy pro ty, kteří se chtějí ponořit hlouběji. Rád bych také poznamenal, že některé matematické definice nemusí být striktní, protože článek není zaměřen na matematiky, ale na inženýry, kteří chtějí pochopit podstatu problému.
* V anglicky mluvící literatuře se kódy redundance často nazývají erasure codes.
1. Podstata kódů redundance
Podstata všech kódů redundance je maximálně jednoduchá: uchovávat (nebo přenášet) data tak, aby nezmizela při vzniku chyb (poruchách disků, chybách přenosu dat atd.).
Ve většině* kódů redundance jsou data rozdělena na n bloků, pro které se počítá m bloků kódů redundance, celkem tedy vznikne n + m bloků. Kódy redundance jsou konstruovány tak, aby bylo možné obnovit n bloků dat, přičemž je třeba pouze část z n + m bloků. Dále se budeme zabývat pouze blokovými kódy redundance, tedy takovými, kde jsou data rozdělena na bloky.
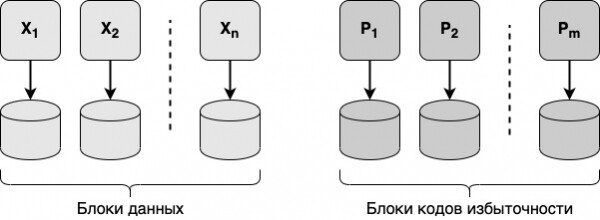
Aby obnovili všechna n datové bloky, je třeba mít alespoň n z n + m bloků, protože není možné získat n bloků, pokud máte pouze n-1 blok (v takovém případě byste museli 1 blok vzít z «vzduchu»). Stačí n libovolných bloků z n + m bloků k obnovení všech dat? To závisí na typu redundatních kódů, například Reed-Solomonovy kódy umožňují obnovit všechna data pomocí libovolných n bloků, zatímco LRC redundatní kódy to ne vždy umožňují.
Ukládání dat
V systémech pro ukládání dat jsou obvykle každý z bloků dat a bloky redundatních kódů zapisovány na jednotlivé disky. Pak při poruše libovolného disku je možné základní data stále obnovit a přečíst. Data lze obnovit i při souběžném selhání více disků.
Přenos dat
Redundatní kódy lze použít pro spolehlivý přenos dat v nespolehlivé síti. Přenášená data se dělí na bloky a pro ně se počítají redundatní kódy. Přes síť se přenášejí jak bloky dat, tak bloky redundatních kódů. Při vzniku chyb v libovolných blocích (až do určitého počtu bloků) lze data i tak bezchybně přenést po síti. Reed-Solomonovy kódy se například používají pro přenos dat po optických linkách a v satelitní komunikaci.
* Existují také redundatní kódy, kde se data nedělí na bloky, například Hammingovy kódy a CRC kódy, které jsou široce aplikovány pro přenos dat v sítích Ethernet. Jsou to kódy pro kódování odolné vůči poruchám, které slouží k detekci chyb, nikoliv k jejich opravě (Hammingův kód také umožňuje částečnou opravu chyb).
2. Reed-Solomonovy kódy
Reed-Solomonovy kódy jsou jedny z nejrozšířenějších redundatních kódů, které byly vynalezeny už v 60. letech a poprvé se široce používaly v 80. letech při sériové výrobě kompaktních disků.
Dva klíčové otázky pro pochopení Reed-Solomonových kódů jsou: 1) jak vytvářet bloky redundatních kódů; 2) jak obnovit data pomocí bloků redundatních kódů. Najdeme na ně odpovědi.
Abychom to zjednodušili, budeme dále předpokládat, že n=6 a m=4. Ostatní schémata se posuzují analogicky.
Jak vytvářet bloky redundatních kódů
Každý blok kódů redundance se považuje za nezávislý na ostatních. Pro výpočet každého bloku se používá všech n bloků dat. Na schématu níže X1-X6 jsou bloky dat, P1–P4 jsou bloky kódů redundance.
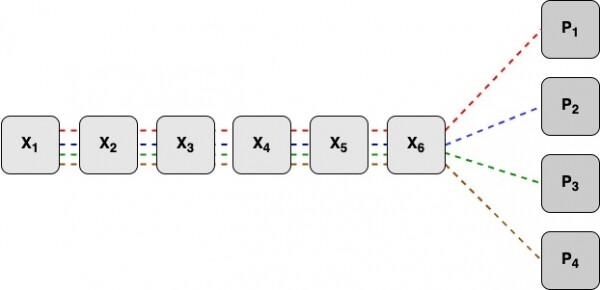
Všechny bloky dat musí mít stejnou velikost, pro zarovnání je možné použít nulové bity. Získané bloky kódů redundance budou mít stejnou velikost jako bloky dat. Všechny bloky dat se dělí na slova (například po 16 bitech). Předpokládejme, že jsme rozdělili bloky dat na k slov. Poté budou všechny bloky kódů redundance také rozděleny na k slov.
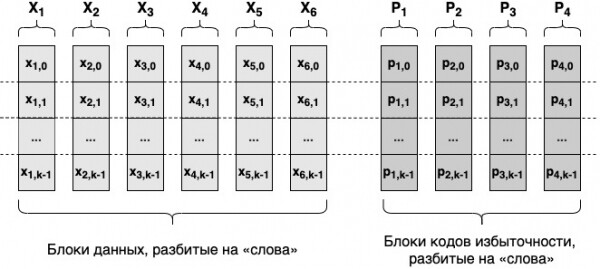
Pro výpočet i-tého slova každého bloku redundance se použijí i-tá slova všech bloků dat. Ta se spočítají podle následujícího vzorce:
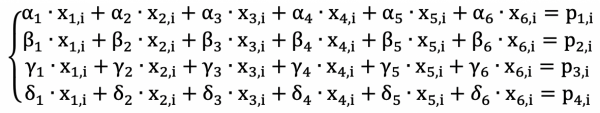
Zde hodnoty x představují slova bloků dat, p představují slova bloků kódů redundance, všechny alfa, beta, gamma a delta jsou speciálně vybraná čísla, která jsou stejná pro všechna i. Je nutné říci, že všechny tyto hodnoty nejsou běžná čísla, ale prvky Galoisova pole, operace +, -, *, / – nejsou to obvyklé operace, jak je známe, ale speciální operace zavedené nad prvky Galoisova pole.
Proč jsou potřeba Galoisova pole
Na první pohled to vypadá jednoduše: rozdělíme data na bloky, bloky na slova, a pomocí slov bloků dat spočítáme slova bloků kódů redundance – získáme bloky kódů redundance. Celkově to tak funguje, ale čert je v detailech:
- Jak je uvedeno výše, velikost slova je fixní, v našem příkladu 16 bitů. Vzorce výše pro kódy Reed-Solomon jsou takové, že při použití běžných celých čísel může být výsledek výpočtu p nepředstavitelný pomocí slova povolené velikosti.
- Při obnově dat budou výše uvedené vzorce považovány za soustavu rovnic, kterou je třeba vyřešit pro obnovení dat. Při řešení se může objevit potřeba provést dělení celých čísel mezi sebou, jehož výsledkem bude reálné číslo, které nelze přesně reprezentovat v počítačové paměti.
Tyto problémy brání použití celých čísel pro Reed-Solomonovy kódy. Řešení problému je originální a lze ho popsat takto: vymysleme speciální čísla, která lze reprezentovat pomocí slov potřebné délky (například 16 bitů), a výsledek všech operací prováděných s nimi (sčítání, odčítání, násobení, dělení) bude také reprezentován v počítačové paměti pomocí slov potřebné délky.
Taková "speciální" čísla již dlouho zkoumá matematika a nazývají se poli. Pole je množina prvků se specifickými operacemi sčítání, odčítání, násobení a dělení.
Galoisova pole* jsou pole, pro která existuje a je jedinečný výsledek každé operace (+, -, *, /) pro libovolné dva prvky pole. Galoisova pole lze sestavit pro čísla, která jsou mocninami 2: 2, 4, 8, 16 atd. (ve skutečnosti mocninami jakéhokoli prvočísla p, ale v praxi nás zajímají pouze mocniny 2). Například pro slova o velikosti 16 bitů je toto pole, které obsahuje 65 536 prvků, pro každou dvojici kterých lze nalézt výsledek libovolné operace (+, -, *, /). Hodnoty x, p, alfa, beta, gama, delta v uvedených rovnicích pro výpočty budou považovány za prvky Galoisova pole.
Tímto způsobem máme soustavu rovnic, pomocí které lze sestavit bloky kódů redundance napsáním odpovídající počítačové programy. Pomocí této soustavy rovnic lze také provést obnovení dat.
* To není striktní definice, spíše popis.
Jak obnovit data
Obnovení je potřeba, když z n + m bloků chybí část bloků. Může se jednat jak o bloky dat, tak o bloky kódů redundance. Chybějící bloky dat a/nebo bloky kódů redundance budou znamenat, že v uvedených rovnicích jsou neznámé příslušné proměnné x a/nebo p.
Rovnice pro Reed-Solomonovy kódy lze považovat za soustavu rovnic, v níž jsou všechny hodnoty alfa, beta, gama, delta konstanty, všechny x a p odpovídající dostupným blokům jsou známé proměnné, a ostatní x a p jsou neznámé.
Například, pokud jsou bloky dat 1, 2, 3 a blok kódů redundance 2 nedostupné, pak pro i-tou skupinu slov bude následující soustava rovnic (neznámé označeny červeně):
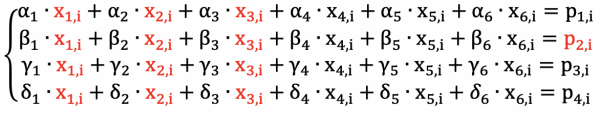
Máme systém čtyř rovnic se čtyřmi neznámými, což znamená, že jej můžeme vyřešit a obnovit data!
Z tohoto systému rovnic vyplývá řada závěrů o obnově dat pro kódy Reed-Solomon (n bloků dat, m bloků redundance):
- Data lze obnovit při ztrátě jakýchkoli m bloků nebo méně. Při ztrátě více než m bloků (m + 1 a více) nelze data obnovit: nelze vyřešit systém m rovnic s m + 1 neznámými.
- Pro obnovu i jednoho bloku dat je nutné použít jakékoli n z zbývajících bloků, přičemž lze použít jakýkoli z kódů redundance.
Co ještě potřebujete vědět
V popisu výše se vyhýbám řadě důležitých otázek, jejichž zkoumání vyžaduje hlubší ponor do matematiky. Zejména nic neříkám o následujících:
- Systém rovnic pro kódy Reed-Solomon musí mít (jediné) řešení při jakýchkoli kombinacích neznámých (ne více než m neznámých). Na základě této podmínky jsou vybírány hodnoty alfa, beta, gamma a delta.
- Systém rovnic je třeba umět automaticky sestavovat (v závislosti na tom, které bloky nejsou k dispozici) a řešit.
- Je třeba vytvořit Galoisovo pole: pro danou délku slova umět najít výsledek jakékoli operace (+, -, *, /) pro jakékoli dva prvky.
Na konci článku jsou odkazy na literaturu k těmto důležitým otázkám.
Volba n a m
Jak prakticky vybrat n a m? V praxi se v systémech ukládání dat používají kódy redundance pro úsporu místa, proto se m vždy vybírá menší než n. Jejich konkrétní hodnoty závisí na řadě faktorů, včetně:
- Spolehlivost ukládání dat. Čím větší je m, tím více poruch disků lze překonat, což znamená vyšší spolehlivost.
- Redundance ukládání. Čím vyšší je poměr m / n, tím vyšší bude redundance ukládání a tím dražší bude systém.
- Čas zpracování dotazů. Čím větší je součet n + m, tím delší bude čas odezvy na dotazy. Protože pro čtení dat (během obnovy) je třeba přečíst n bloků uložených na n různých discích, čas čtení bude určen nejpomalejším diskem.
Kromě toho ukládání dat v několika datových centrech klade další omezení na výběr n a m: při výpadku 1 datového centra musí být data stále dostupná pro čtení. Například při ukládání dat ve 3 datových centrech musí být splněna podmínka: m >= n/2, jinak může nastat situace, kdy data nejsou dostupná pro čtení při výpadku 1 datového centra.
3. LRC — Lokální rekonstrukční kódy
Pro obnovení dat pomocí Reed-Solomonových kódů je nutné použít n libovolných bloků dat. To je velmi významná nevýhoda pro distribuované systémy ukládání dat, neboť k obnovení dat na jednom poškozeném disku je třeba číst data z většiny ostatních, což vytváří velkou dodatečnou zátěž na disky a síť.
Nejčastějšími chybami jsou nedostupnost jednoho bloku dat v důsledku poruchy nebo přetížení jednoho disku. Lze nějak snížit nadbytečnou zátěž pro obnovu dat v takovém (nejčastějším) případě? Odpovědí je ano: existují speciálně pro to navržené LRC nadbytečné kódy.
LRC (lokální rekonstrukční kódy) jsou nadbytečné kódy vymyšlené společností Microsoft pro použití ve Windows Azure Storage. Myšlenka LRC je velmi jednoduchá: rozdělit všechny bloky dat do dvou (nebo více) skupin a počítat část bloků nadbytečných kódů pro každou skupinu zvlášť. Tím bude část bloků nadbytečných kódů vypočtena pomocí všech bloků dat (v LRC se nazývají globálními nadbytečnými kódy), a část — pomocí jedné ze dvou skupin bloků dat (ty se nazývají lokálními nadbytečnými kódy).
LRC je vyjádřeno třemi čísly: n-r-l, kde n je počet bloků dat, r je počet globálních bloků nadbytečných kódů, l je počet lokálních bloků nadbytečných kódů. Pro čtení dat při nedostupnosti jednoho bloku dat je třeba přečíst pouze n/l bloků — což je lkrát méně než u Reed-Solomonových kódů.
Pro příklad vezměme schéma LRC 6-2-2. X1–X6 jsou 6 bloků dat, P1, P2 jsou 2 globální bloky nadbytečnosti, P3, P4 jsou 2 místní bloky nadbytečnosti.
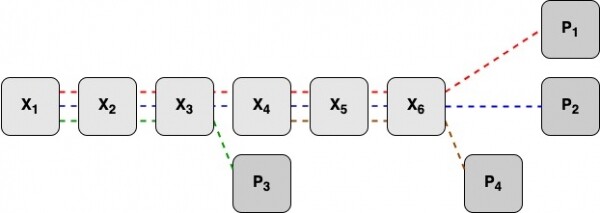
Bloky nadbytečných kódů P1, P2 jsou počítány pomocí všech bloků dat. Blok nadbytečného kódu P3 — pomocí bloků dat X1–X3, blok nadbytečného kódu P4 — pomocí bloků dat X4–X6.
Ostatní se provádí v LRC obdobně jako u Reed-Solomonových kódů. Rovnice pro výpočet počtu slov bloků kódů redundance budou následující:
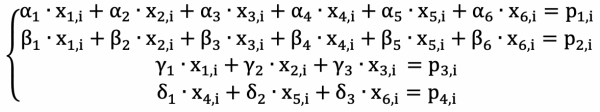
Pro výběr čísel alfa, beta, gama, delta je třeba splnit řadu podmínek, které zaručují možnost obnovy dat (tedy řešení soustavy rovnic). Podrobněji o nich lze прочитать в .
Také v praxi se pro výpočet lokálních kódů redundance P3, P4 používá operace XOR.
Z rovnic pro LRC vyplývá řada závěrů:
- Pro obnovení jakéhokoli 1 bloku dat stačí přečíst n/l bloků (n/2 v našem příkladu).
- Pokud jsou nedostupné r + l bloky a všechny bloky patří do jedné skupiny, data nelze obnovit. To lze snadno vysvětlit na příkladu. Předpokládejme, že bloky X1–X3 a P3 jsou nedostupné: to je r + l bloků z jedné skupiny, 4 v našem případě. Potom máme soustavu 3 rovnic se 4 neznámými, kterou nelze vyřešit.
- Ve všech ostatních případech nedostupnosti r + l bloků (kdy je z každé skupiny dostupný alespoň jeden blok) lze data v LRC obnovit.
Takže LRC převyšuje Reed-Solomonovy kódy v obnově dat po jednotlivých chybách. U Reed-Solomonových kódů je pro obnovu i jediného bloku dat potřeba použít n bloků, zatímco v LRC stačí pro obnovu jednoho bloku dat použít n/l bloků (n/2 v našem příkladu). Na druhé straně však LRC zaostává za Reed-Solomonovými kódy v maximálním počtu povolených chyb. V příkladech výše vzorci Reed-Solomon mohou obnovit data při libovolných 4 chybách, a pro LRC existují 2 kombinace 4 chyb, kdy nelze data obnovit.
Co je důležitější — závisí na konkrétní situaci, ale často úspora redundance, kterou LRC poskytuje, převáží nad mírně menší spolehlivostí uchování.
4. Další kódy redundance
Kromě Reed-Solomonových a LRC kódů existuje mnoho dalších kódů redundance. Různé kódy redundance používají různou matematiku. Zde je několik dalších kódů redundance:
- Kód redundance pomocí operátoru XOR. Operace XOR se provádí na n blocích dat a vzniká 1 blok kódů redundance, což znamená schéma n+1 (n bloků dat, 1 kód redundance). Používá se v , kde jsou bloky dat a kódů redundance cyklicky zapisovány na všechny disky pole.
- Algoritmus even-odd založený na operaci XOR. Umožňuje vytvořit 2 bloky redundantních kódů, tedy schéma n+2.
- Algoritmus STAR, založený na operaci XOR. Umožňuje vytvořit 3 bloky redundantních kódů, tedy schéma n+3.
- Pyramide codes — další redundantní kódy od Microsoftu.
5. Použití v Yandexu
Několik infrastrukturních projektů Yandexu používá redundantní kódy pro spolehlivé uchování dat. Zde je několik příkladů:
- Interní objektové úložiště MDS, o kterém jsem psal na začátku článku.
- — MapReduce systém Yandexu.
- (Yandex DataBase) — distribuovaná databáze newSQL.
V MDS se používají redundantní kódy LRC, schéma 8-2-2. Data s redundantními kódy jsou uložena na 12 různých discích v různých serverech ve 3 různých DC: po 4 servery v každém DC. O tom si můžete přečíst více v .
V YT se používají jak Reid-Solomonovy kódy (schéma 6-3), které byly implementovány jako první, tak redundantní kódy LRC (schéma 12-2-2), přičemž LRC je preferovaný způsob uchovávání.
V YDB se používají redundantní kódy založené na even-odd (schéma 4-2). O redundantních kódech v YDB již .
Použití různých schémat redundantních kódů je podmíněno různými požadavky na systémy. Například v MDS jsou data uchovávaná pomocí LRC umístěna zároveň ve 3 DC. Je pro nás důležité, aby data zůstala dostupná pro čtení při výpadku jakéhokoli DC, proto musí být bloky rozloženy po DC tak, aby při nedostupnosti jakéhokoli DC bylo maximálně nedostupných bloků méně než povolené. V schématu 8-2-2 lze umístit po 4 bloky do každého DC, takže při odpojení jakéhokoli DC budou nedostupné 4 bloky, a data budou moci být čtena. Ať už zvolíme jakékoli schéma při rozložení ve 3 DC, musí platit (r + l) / n >= 0,5, tedy redundance uchovávání bude minimálně 50%.
V YT je situace jiná: každý YT cluster je umístěn zcela v 1 DC (různé cluster v různých DC), takže tam není takové omezení. Schéma 12-2-2 poskytuje redundanci 33%, tedy uchování dat je levnější, přičemž mohou přežít až 4 současné výpadky disků, stejně jako schéma v MDS.
Existuje ještě mnoho dalších aspektů využití kódů redundance v systémech ukládání a zpracování dat: nuance obnovy dat, vliv obnovy na dobu vykonávání dotazů, specifika zápisu dat atd. Plánuji se podrobněji zabývat těmito a dalšími aspekty praktického použití kódů redundance, pokud bude téma zajímavé.
6. Odkazy
- Série článků o Ridu – Solomonových kódech a Galoisových polích:
V nich je matematika podrobněji rozebrána srozumitelným jazykem. - Článek od Microsoftu o LRC:
V oddílu 2 je stručně vysvětlena teorie, následuje zkoumání praktických aplikací LRC. - Schéma even-odd:
- Schéma STAR:
- Pyramidové kódy:
- Kódy redundance v MDS:
- Kódy redundance v YT:
- Kódy redundance v YDB:
Zdroj: habr.com
