

Přehled zprávy Bruce Momjiana z roku 2020 "Odemknutí správce zámků Postgres."
(Poznámka: Všechny SQL dotazy ze snímků si můžete stáhnout na tomto odkazu: )
Ahoj! Je skvělé být tu znovu v Rusku. Omlouvám se, že jsem nemohl přijet minulý rok, ale letos máme s Ivanem velké plány. Doufám, že tady budu mnohem častěji. Mám rád návštěvu Ruska. Navštívím Tyumen a Tver. Jsem velmi rád, že budu mít příležitost být v těchto městech.
Jmenuji se Bruce Momjiana. Pracuji ve společnosti EnterpriseDB a pracuji s Postgres více než 23 let. Žiji v Philadelphii ve Spojených státech. Cestuji asi 90 dní v roce a navštěvuji přibližně 40 konferencí. Můj , která obsahuje snímky, které vám nyní ukážu. Po konferenci si je můžete stáhnout z mé osobní stránky. Obsahuje také kolem 30 prezentací, videa a velké množství příspěvků v blogu, více než 500. Je to poměrně bohatý zdroj, a pokud vás tento materiál zajímá, zvu vás, abyste ho využili.
Dříve jsem byl učitelem, profesorem, než jsem začal pracovat s Postgres. A jsem velmi rád, že vám mohu nyní říct to, co vám chci říct. Je to jedna z mých nejzajímavějších prezentací. Tato prezentace obsahuje 110 snímků. Začneme s jednoduchými věcmi a na konci se prezentace stane stále složitější a složitější.
Je to poměrně nepříjemné téma. Zámky nejsou příliš populární téma. Chceme, aby to zmizelo. Je to jako chodit k zubaři.
- Zámky jsou problém pro mnoho lidí, kteří pracují s databázemi a mají více procesů běžících současně. Potřebují zámky. Tedy dnes vám dám základní znalosti o zámcích.
- Identifikátory transakcí. To je poměrně nudná část prezentace, ale je důležité ji pochopit.
- Dále si povíme o typech zámků. To je dost mechanická část.
- A dále se podíváme na některé příklady zámků. A to bude poměrně obtížné na pochopení.
Pojďme si promluvit o zámcích.
Terminologie je u nás poměrně složitá. Kolik z vás ví, odkud je tento úryvek? Dva lidé. Je to z hry, která se jmenuje „Kolosální dobrodružství v jeskyni“. Byla to textová počítačová hra v 80. letech, myslím. Museli jste vstoupit do jeskyně, do labyrintu a text se měnil, ale obsah byl přitom zhruba stejný pokaždé. Tak si pamatuji tuto hru.
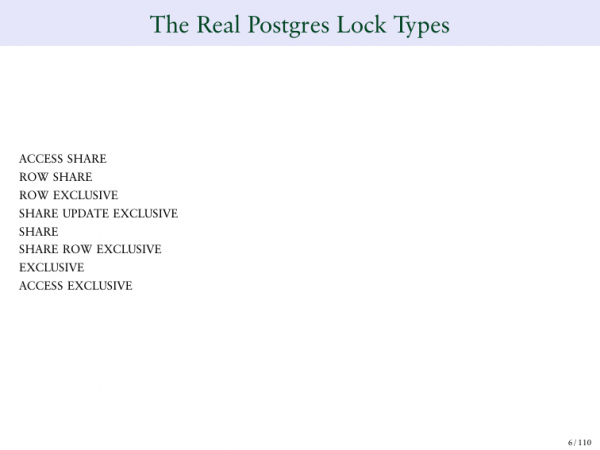
A zde vidíme názvy zámků, které přišly k nám z Oracle. Používáme je.
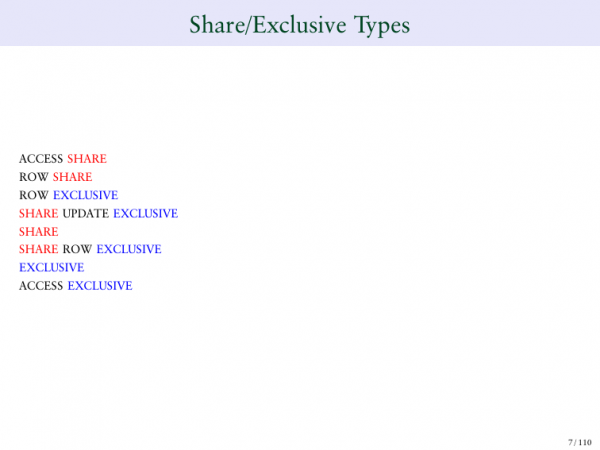
Zde vidíme termíny, které mi příliš nevyhovují. Například SHARE UPDATE EXCLUSIVE. Dále SHARE RAW EXCLUSIVE. Řeknu upřímně, tato označení nejsou příliš srozumitelná. Pokusíme se je podrobněji prozkoumat. Některé obsahují slovo „share“, což znamená – oddělit se. Některé obsahují slovo „exclusive“ — exkluzivní. Některé obsahují obě tato slova. Rád bych začal tím, jak tyto zámky fungují.
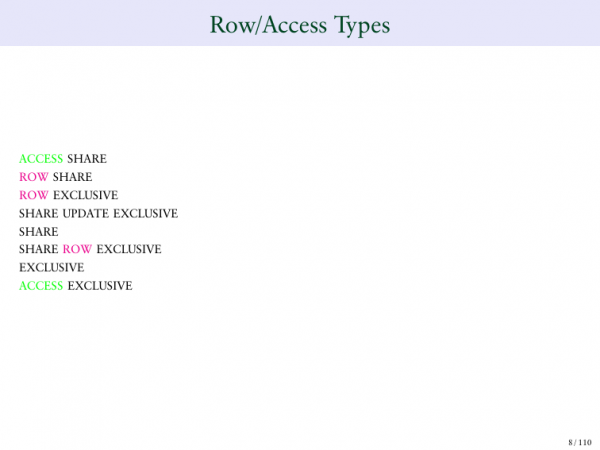
A také je velmi důležité slovo „přístup“ — access. A slova „row“ — řádek. T. j. rozdělení přístupu, rozdělení řádků.
Ještě jedno téma, které je třeba pochopit v Postgresu, o kterém, bohužel, nebudu moci mluvit ve svém vystoupení, je MVCC. Mám na toto téma samostatnou prezentaci na svých webových stránkách. A pokud si myslíte, že tato prezentace je složitá, pak MVCC je pravděpodobně moje nejkomplexnější. A pokud máte zájem, můžete se na ni podívat na webu. Můžete se podívat na video.
Ještě jedna věc, kterou musíme pochopit – to jsou identifikátory transakcí. Mnoho transakcí nemůže fungovat bez unikátních identifikátorů. A zde máme vysvětlení, co je to transakce. V Postgresu existují dva systémy číslování transakcí. Vím, že to není příliš hezké řešení.
Také mějte na paměti, že slidy budou pro vnímání poměrně složité, takže na to, co je zvýrazněno červenou barvou, na to se musíte soustředit.
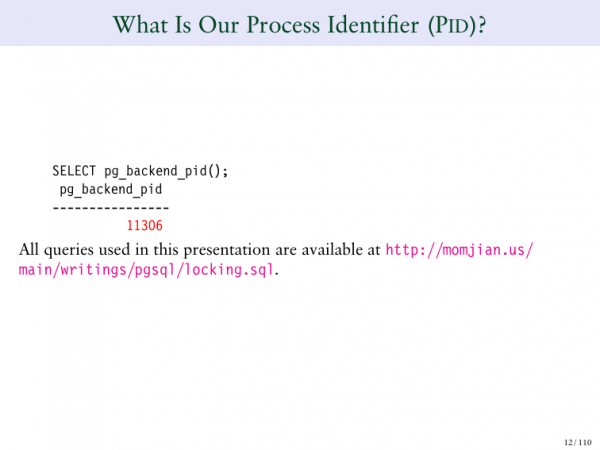
Podíváme se. Červenou barvou je zvýrazněno číslo transakce. Zde je zobrazena funkce SELECT pg_back. Ta vrací mou transakci a ID této transakce.
Ještě jedna věc, pokud se vám tato prezentace líbí a chcete ji spustit ve své databázi, můžete přejít na tento odkaz, vyznačený růžovou barvou, a stáhnout SQL pro tuto prezentaci. A můžete ji jednoduše spustit ve vašem PSQL a vše se okamžitě objeví na vašem displeji. Nebude obsahovat barvy, ale alespoň ji budeme moci vidět.
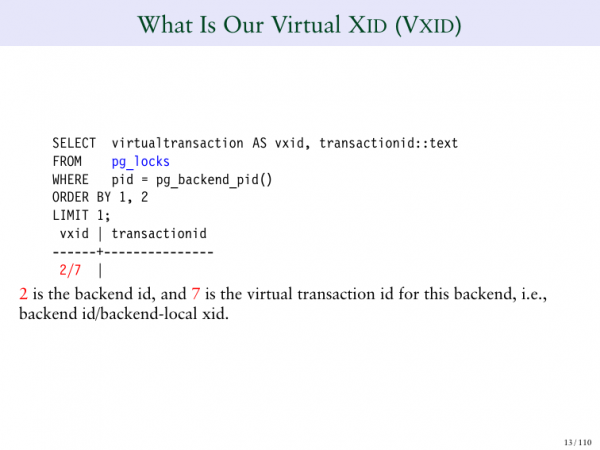
V tomto případě vidíme ID transakce. To je číslo, které jsme jí přiřadili. A existuje také jiný typ ID transakce v Postgresu, které se nazývá virtuální ID transakce.
A musíme tomu rozumět. To je velmi důležité, jinak nebudeme schopni pochopit zamykání v Postgresu.
Virtuální ID transakce je ID transakce, které neobsahuje trvalé hodnoty. Například pokud spustím příkaz SELECT, pravděpodobně nebudu měnit databázi, nic nezamknu. Proto, když spouštíme jednoduchý SELECT, této transakci nedáváme trvalé ID. Dáváme jí pouze virtuální ID.
A to zvyšuje výkon Postgresu, zlepšuje možnosti pro údržbu, takže virtuální ID transakce se skládá ze dvou čísel. První číslo před lomítkem je ID backendu. A napravo vidíme jednoduše čítač.
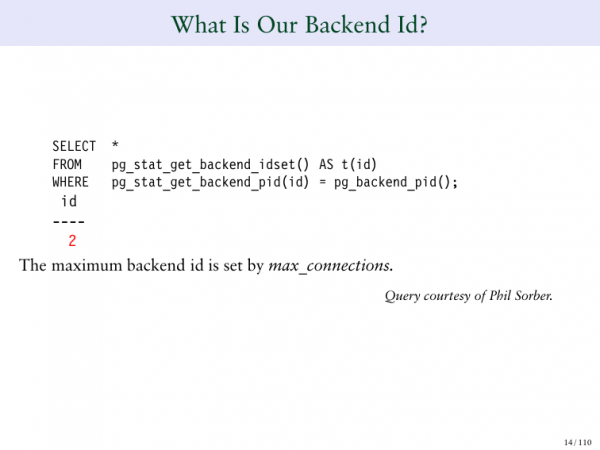
Proto, pokud spouštím dotaz, říká, že ID backend je 2.
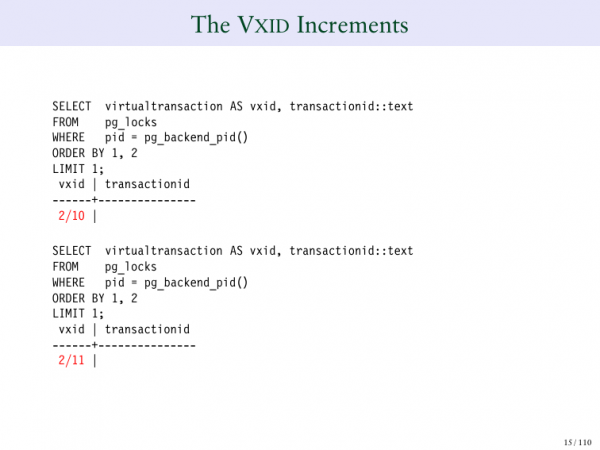
A pokud spouštím sérii takových transakcí, vidíme, že čítač se pokaždé zvyšuje, když spouštím dotaz. Například, když spouštím dotaz 2/10, 2/11, 2/12 atd.
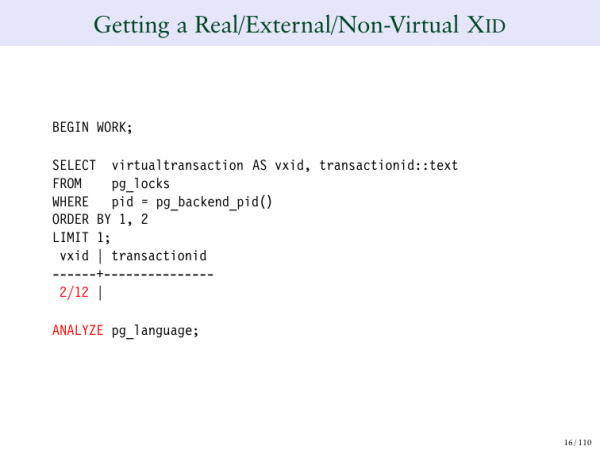
Vezměte na vědomí, že zde jsou dvě sloupce. Vlevo vidíme virtuální ID transakce – 2/12. A napravo máme trvalé ID transakce. A toto pole je prázdné. A tato transakce nemění databázi. Proto jí nepřiděluji trvalé ID transakce.
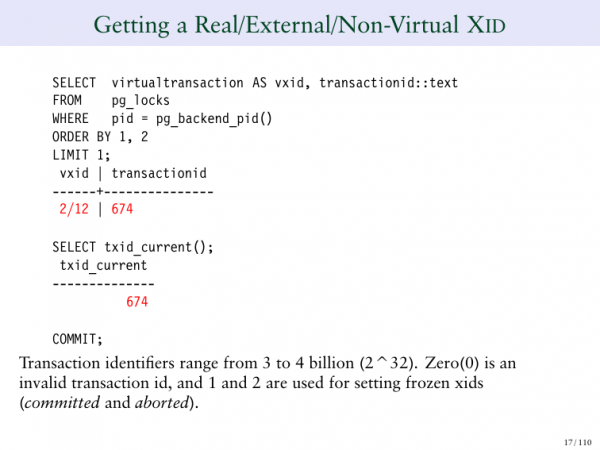
Jakmile spustím příkaz analyzovat (ANALYZE), stejný dotaz mi vrátí trvalé ID transakce. Podívejte se, jak se to změnilo. Dříve jsem neměl toto ID, nyní se objevilo.
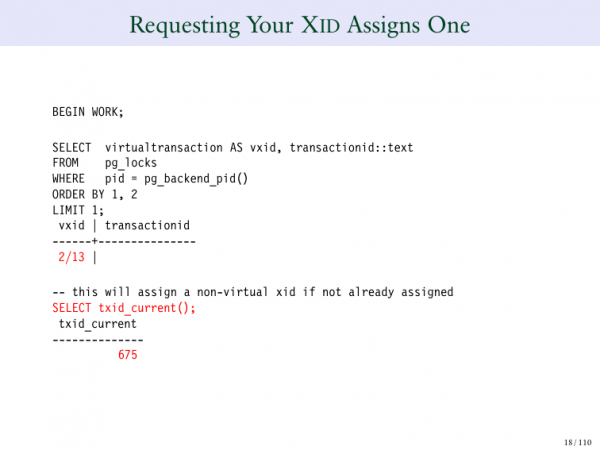
Takže, zde je další dotaz, další transakce. Virtuální číslo transakce – 2/13. A pokud požádám o trvalé ID transakce, když spustím dotaz, dostanu ho.
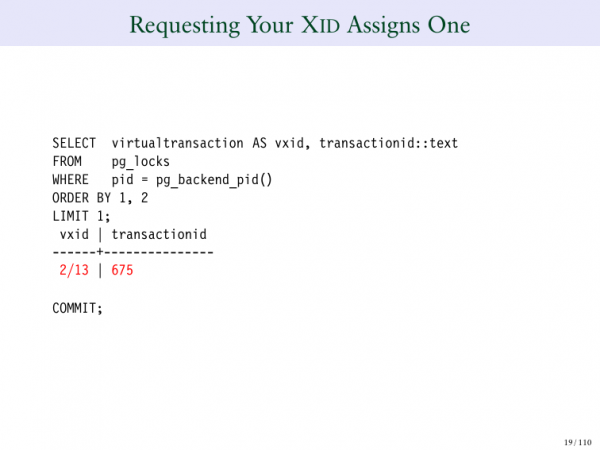
Takže ještě jednou. Máme virtuální ID transakce a trvalé ID transakce. Jen pochopte tuto věc, abyste porozuměli chování Postgresu.
Přejdeme k třetí části. Tady si projdeme různé typy zámků v Postgresu. Není to příliš zajímavé. Poslední část bude mnohem zajímavější. Ale musíme se podívat na základní věci, jinak nepochopíme, co bude dál.
Projdem si tuto část, podíváme se na každý typ zámku. A ukážu vám příklady, jak se nastavují, jak fungují, a ukážu vám některé dotazy, které můžete použít, abyste zjistili, jak zámky fungují v Postgresu.
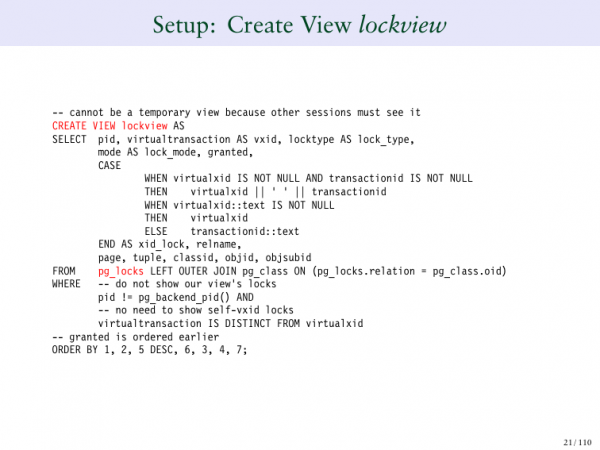
Abychom vytvořili dotaz a zjistili, co se děje v Postgresu, musíme provést dotaz na systémový pohled. V tomto případě máme označeno červeně pg_lock. Pg_lock je systémová tabulka, která nám říká, jaké zámky jsou nyní používány v Postgresu.
Nicméně mi dělá velké potíže ukázat vám pg_lock samotný, protože je to docela složité. Proto jsem vytvořil pohled, který ukazuje pg_locks. A také dělá pro mě určitou práci, která mi pomáhá lépe rozumět. Tedy vylučuje mé zámky, moji vlastní relaci atd. To je prostě standardní SQL a lépe to ukazuje, co se děje.
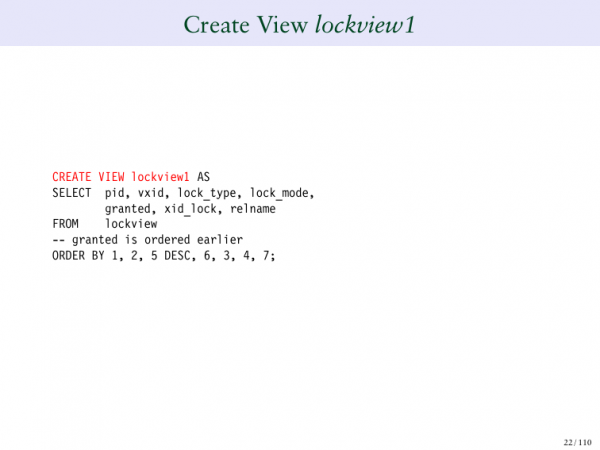
Další problém je, že tento pohled je velmi široký, takže musím vytvořit druhý - lockview2.
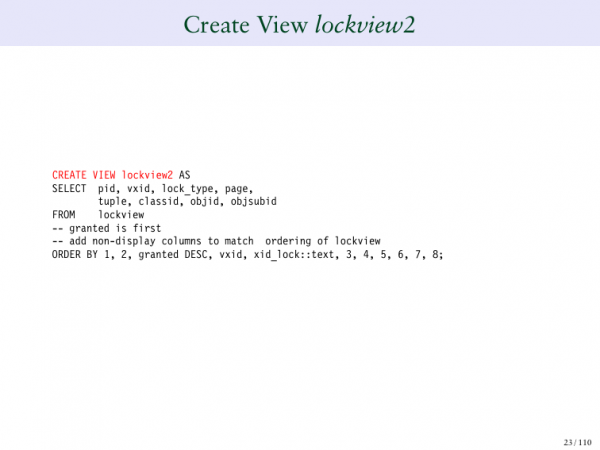 A ten mi ukazuje další sloupce z tabulky. A ještě jeden, který mi ukazuje ostatní sloupce. Je to dost složité, takže jsem se snažil to představit co nejjednodušeji.
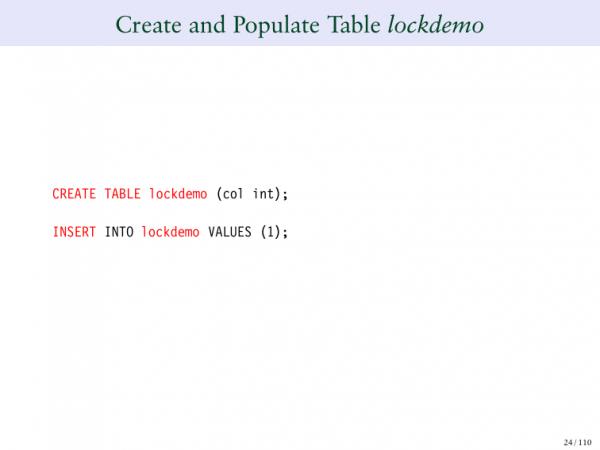
Takže jsme vytvořili tabulku, která se jmenuje Lockdemo. A vytvořili jsme tam jeden řádek. To je naše testovací tabulka. A vytvoříme sekce, abychom vám ukázali příklady zámků.
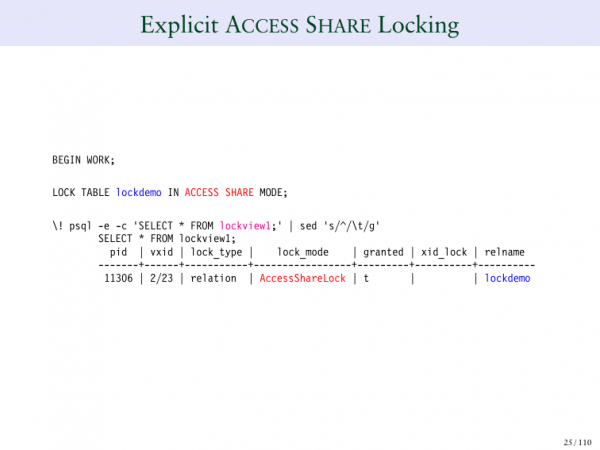
Takže jeden řádek, jeden sloupec. První typ zámku se nazývá ACCESS SHARE. Je to nejméně omezující zámek. To znamená, že téměř nekonfliktuje s ostatními zámky.
A pokud chceme explicitně určit zablokování, spustíme příkaz „lock table“. A ten jasně zablokuje, tj. v režimu ACCESS SHARE spouštíme lock table. A pokud spustím PSQL na pozadí, tak takto spouštím druhou relaci z mé první relace. Tj. co udělám zde? Přecházím k jiné relaci a říkám jí „ukáž mi lockview pro tento dotaz“. A zde mám AccessShareLock v této tabulce. To je přesně to, co jsem žádal. A on říká, že zablokování bylo přiděleno. Velmi jednoduše.
Pokračujme, pokud se podíváme na druhý sloupec, tak tam nic není. Jsou prázdné.
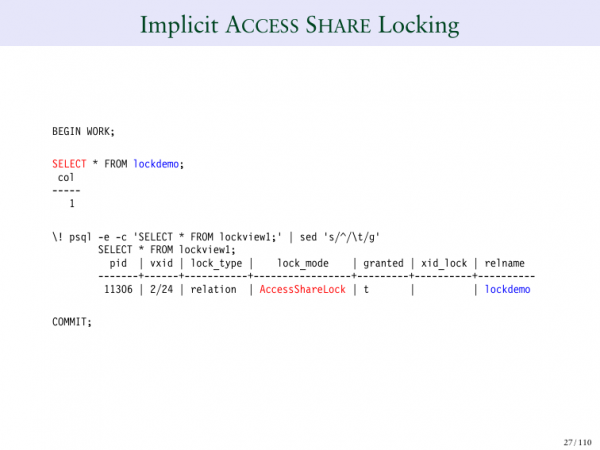
A pokud spustím příkaz „SELECT“, tak to je implicitní (explicitní) způsob, jak požádat o AccessShareLock. Proto uvolním svou tabulku a spustím dotaz, a dotaz vrátí několik řádků. A v jednom z řádků vidíme AccessShareLock. Takže SELECT vyvolává AccessShareLock v tabulce. A prakticky to nekonfliktuje s ničím, protože to je zámek nízké úrovně.
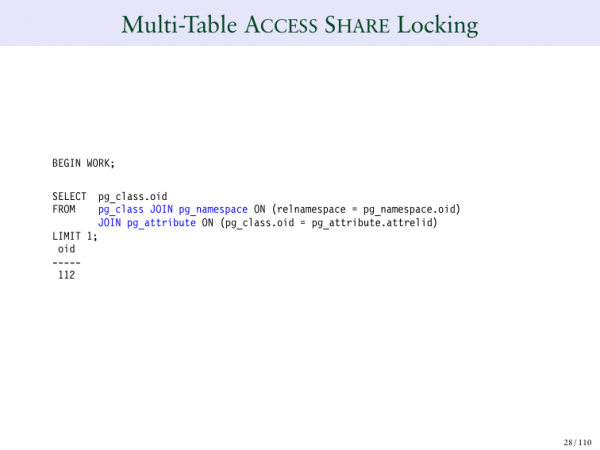
Co když spustím SELECT a budu mít tři různé tabulky? Dříve jsem spouštěl pouze jednu tabulku, nyní spouštím tři: pg_class, pg_namespace a pg_attribute.
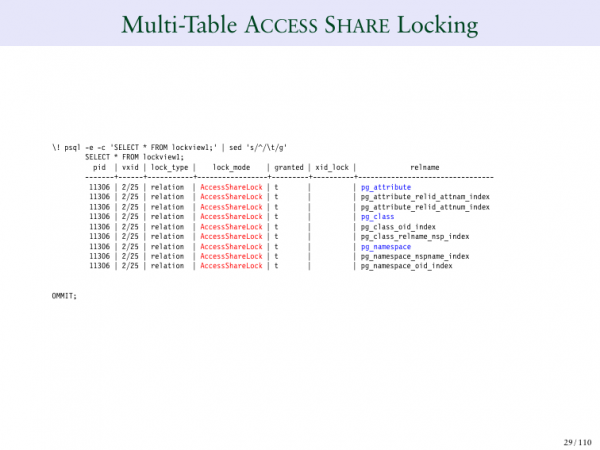
A nyní, když se dívám na dotaz, vidím 9 AccessShareLocks ve třech tabulkách. Proč? Tři tabulky jsou zvýrazněny modře: pg_attribute, pg_class, pg_namespace. Ale také můžete vidět, že všechny indexy, které jsou definovány přes tyto tabulky, také mají AccessShareLock.
A to je zámek, který prakticky nekonfliktuje s jinými. A vše, co dělá, je, že nám jednoduše nedovolí uvolnit tabulku, dokud ji vybíráme. Dává to smysl. Tj. pokud vybíráme tabulku, tak v tu chvíli zmizí, to by bylo špatné, takže AccessShare – to je zámek nízké úrovně, který nám říká „neodstraňujte tuto tabulku, dokud pracuji“.. V podstatě, to je vše, co dělá.
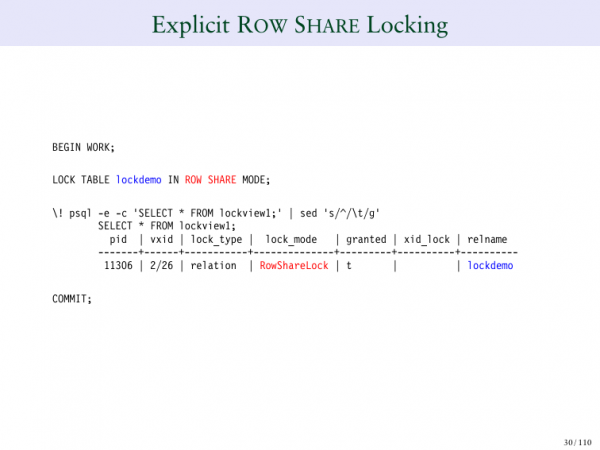
ROW SHARE – tento zámek je trochu odlišný.
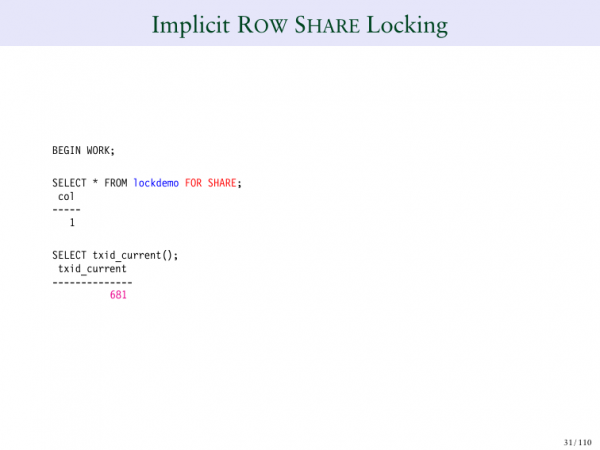
Pojďme si vzít příklad. SELECT ROW SHARE způsob zablokování každého řádku jednotlivě.. Takže nikdo je nemůže odstranit nebo změnit, dokud je sledujeme.
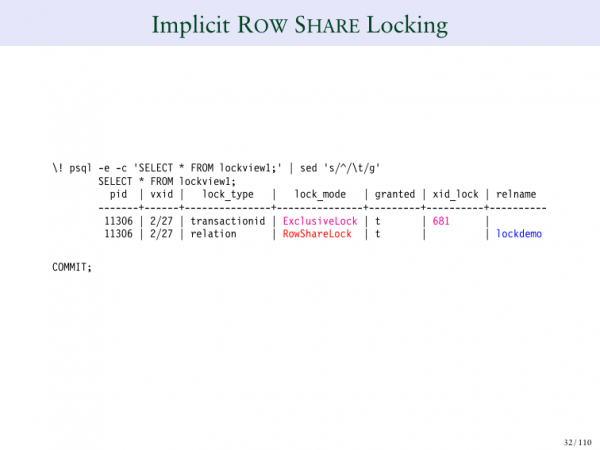 Takže, co dělá SHARE LOCK? Vidíme, že ID transakce je 681 pro SELECT. A to je zajímavé. Co se tady stalo? Poprvé vidíme číslo v poli „Lock“. Bereme ID transakce a to říká, že ji blokuje v exkluzivním režimu. Všechno, co dělá, říká, že mám řádek, který je technicky blokován někde v tabulce. Ale neříká, kde konkrétně. O něco později se na to podíváme podrobněji.
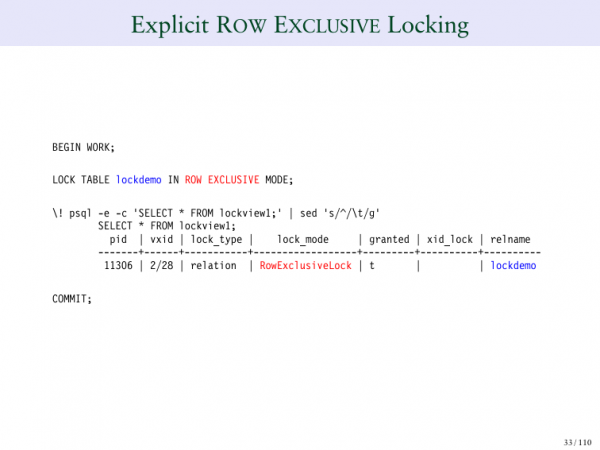
Tady říkáme, že blokace je používána námi.
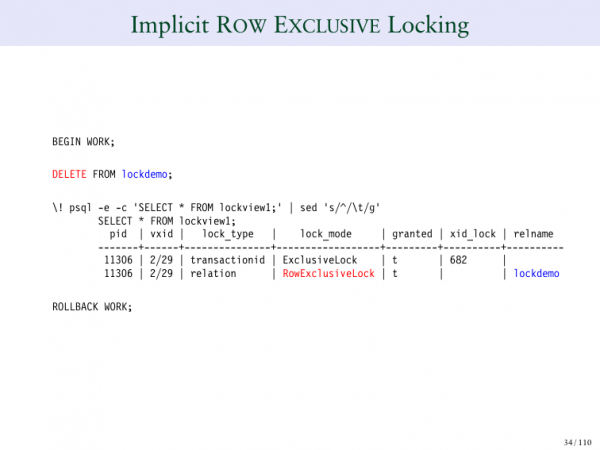
Takže exkluzivní blokace explicitně říká, že je exkluzivní. A také, pokud vymažete řádek v této tabulce, tak se to stane, jak vidíte.
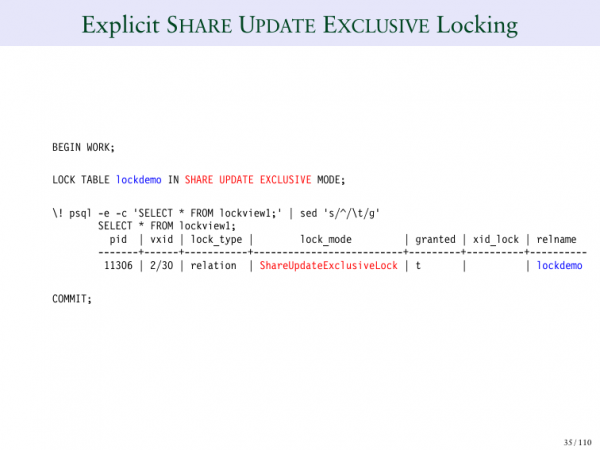
SHARE EXCLUSIVE – to je delší blokace.
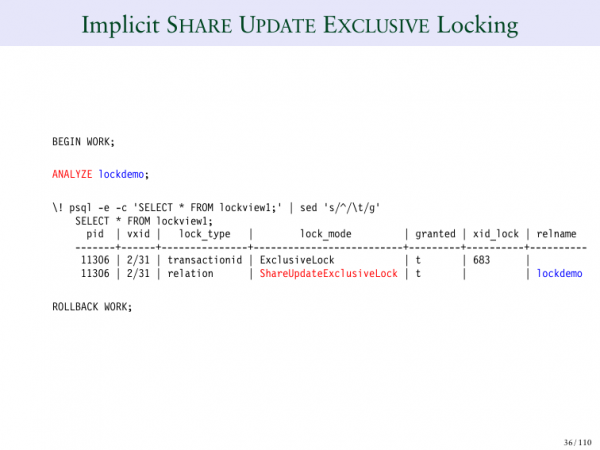
To (ANALYZE) je příkaz analyzátoru, který bude použit.
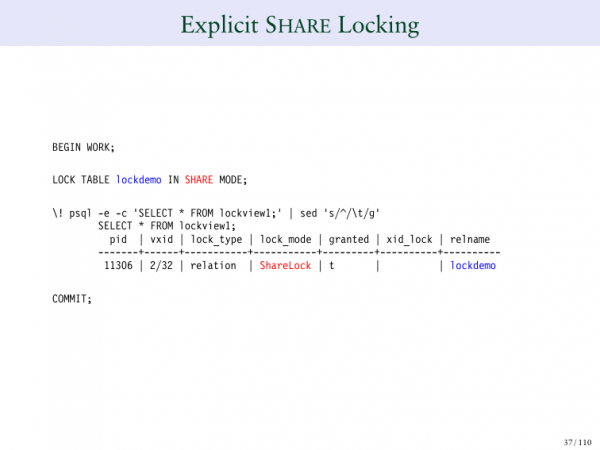
SHARE LOCK – můžete explicitně blokovat v režimu sdílení.
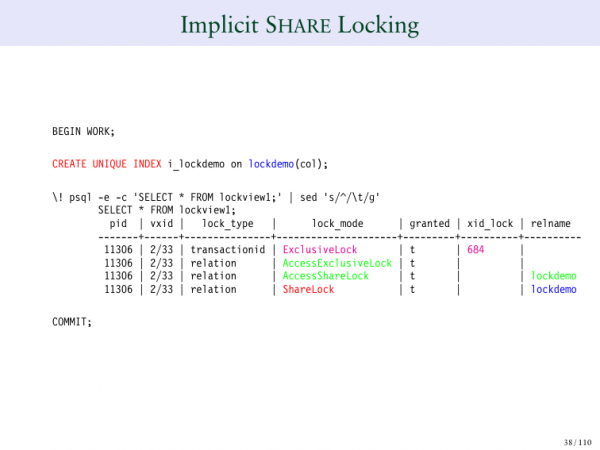
Můžete také vytvořit unikátní index. A tam můžete vidět SHARE LOCK, který je jeho součástí. Tím blokuje tabulku a nastavuje na ni blokaci SHARE LOCK.
Ve výchozím nastavení SHARE LOCK na tabulce znamená, že jiní lidé mohou číst tabulku, ale nikdo ji nemůže měnit. A to se stane, když vytvoříte unikátní index.
Pokud vytvořím unikátní concurrently index, budu mít jiný typ blokace, protože, jak si pamatujete, použití concurrently indexů snižuje požadavek na blokaci. A pokud použiji normální blokaci, normální index, tím zabráním zápisu do indexu tabulky během jeho vytváření. Pokud použiji concurrently index, musím použít jiný typ blokace.
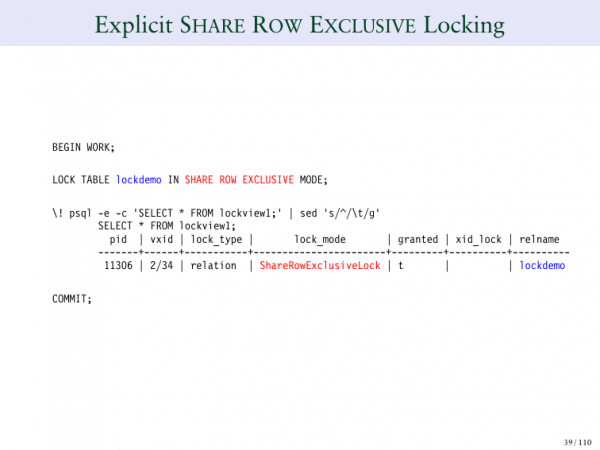
SHARE ROW EXCLUSIVE – opět ji lze nastavit explicitně.
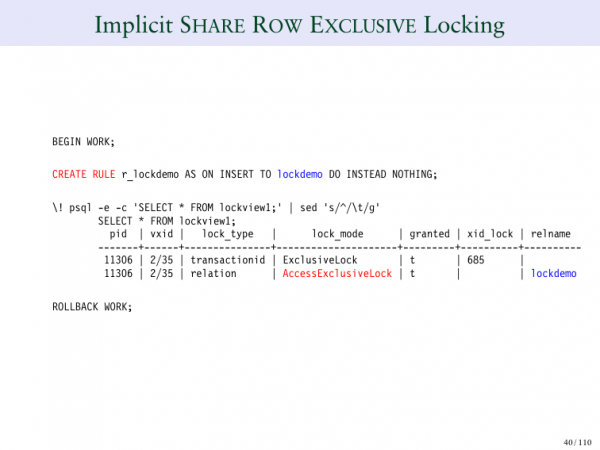
Nebo můžeme vytvořit pravidlo, tj. vzít nějaký konkrétní případ, při kterém bude použita.
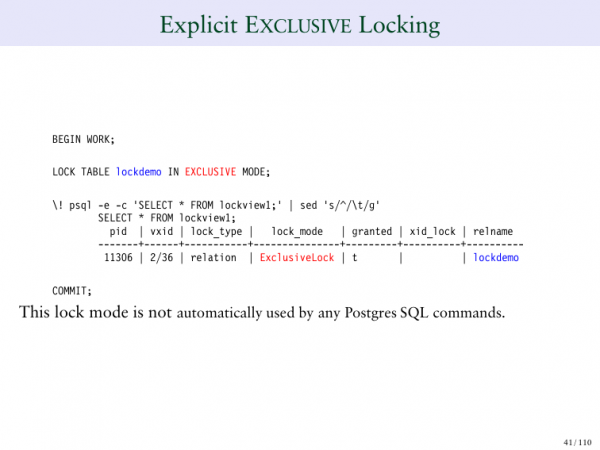
EXCLUSIVE blokace znamená, že nikdo jiný nemůže měnit tabulku.
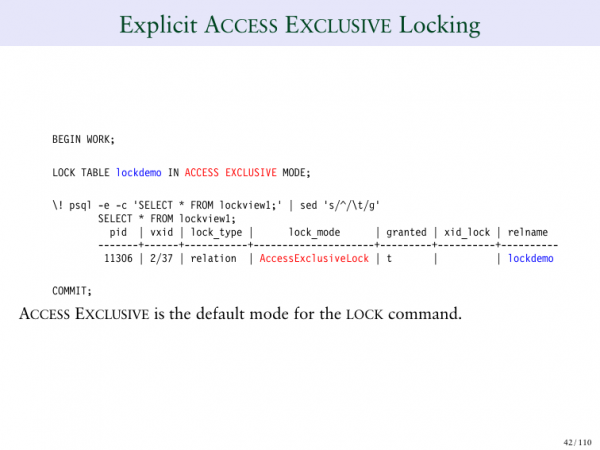
Tady vidíme různé typy blokací.
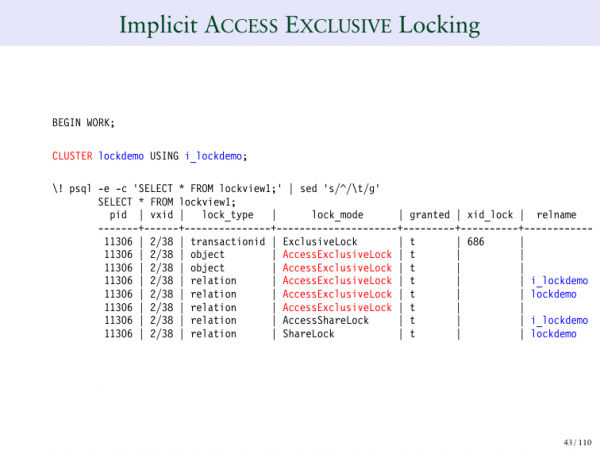
ACCESS EXCLUSIVE, například, to je příkaz blokace. Například, pokud děláte CLUSTER table, to znamená, že nikdo nemůže zapisovat dovnitř. A blokuje nejen samotnou tabulku, ale také indexy.
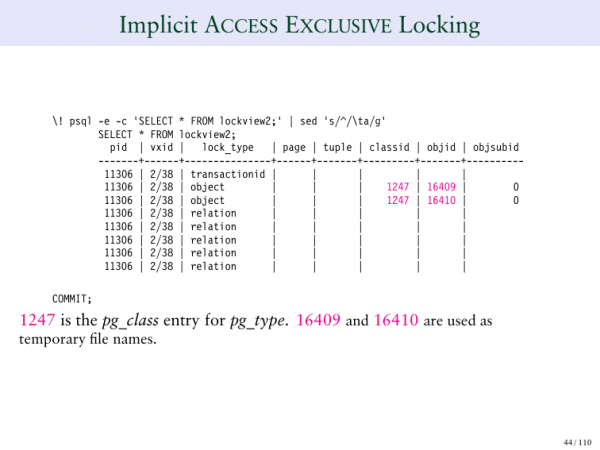
To je druhá stránka blokace ACCESS EXCLUSIVE, kde vidíme konkrétně, co blokuje v tabulce. Blokuje jednotlivé řádky tabulky, což je dost zajímavé.
Tohle jsou všechny základní informace, které jsem chtěl poskytnout. Mluvili jsme o zámcích, o ID transakcích, o virtuálních ID transakcích, o trvalých ID transakcích.
A teď si projdeme příklady zámků. To je nejzajímavější část. Podíváme se na velmi zajímavé případy. Mojí úlohou v této prezentaci je poskytnout vám lepší představu o tom, co Postgres vlastně dělá, když se snaží blokovat určité věci. Myslím, že velmi dobře umí blokovat jednotlivé části.
Podívejme se na konkrétní příklady.
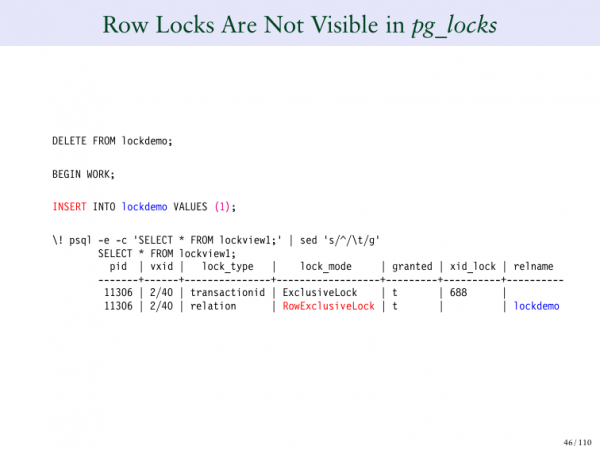
Začneme s tabulkami a s jedním řádkem v tabulce. Když něco vložím, zobrazí se mi ExclusiveLock, ID transakce a ExclusiveLock na tabulce.
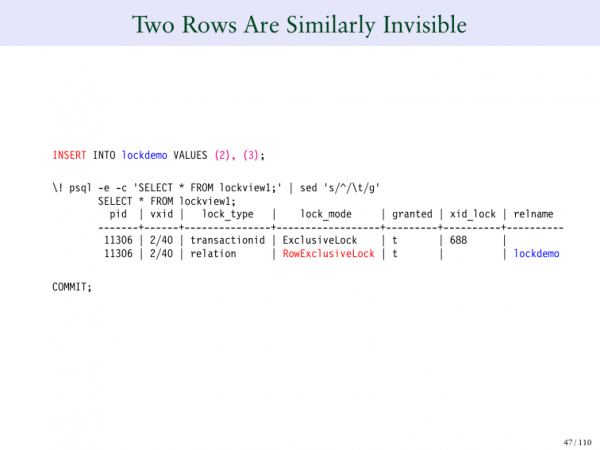
A co se stane, pokud vložím další dva řádky? A nyní máme v naší tabulce tři řádky. Vložil jsem jeden řádek a dostal tohle na výstupu. A pokud vložím další dva řádky, co je tu podivného? Je tu podivnost, protože jsem přidal tři řádky do této tabulky, ale stále mám dva řádky v tabulce zámků. A to je v podstatě základní chování Postgres.
Mnozí si myslí, že pokud v databázi blokujete 100 řádků, bude třeba vytvořit 100 vstupů zámků. Pokud budu blokovat najednou 1 000 řádků, pak budu potřebovat 1 000 takových požadavků. A pokud potřebuji zablokovat milion nebo miliardu. Ale pokud to uděláme takto, nebude to fungovat dobře. Pokud jste používali systém, který vytváří vstupy zámků pro každý jednotlivý řádek, vidíte, že je to složité. Protože musíte určit tabulku zámků, která může přetížit, ale Postgres to nedělá.
A na tomto snímku je velmi důležité, že zde je jasně demonstrováno, že existuje další systém, který funguje uvnitř MVCC, který blokuje jednotlivé řádky. Takže když blokujete miliardy řádků, Postgres nevytváří miliardu jednotlivých příkazů na blokaci. A to má velmi pozitivní vliv na výkon.
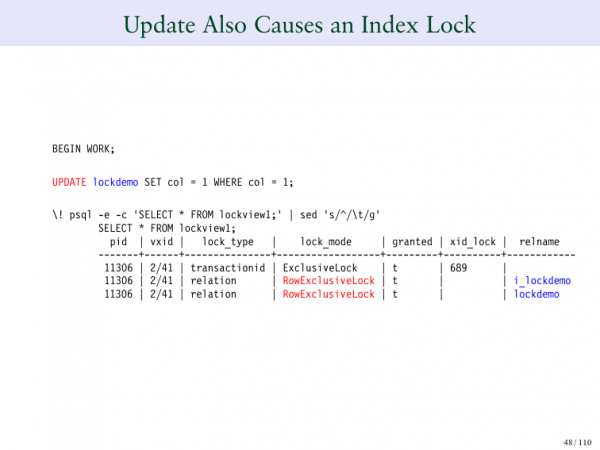
A co aktualizací? Právě aktualizuji řadu a můžete si všimnout, že okamžitě vykonal dvě různé operace. Zablokoval tabulku, ale také zablokoval index. A musel zablokovat index, protože na této tabulce existují unikátní omezení. A chceme si být jisti, že nikdo ho nemění, proto ho blokujeme.
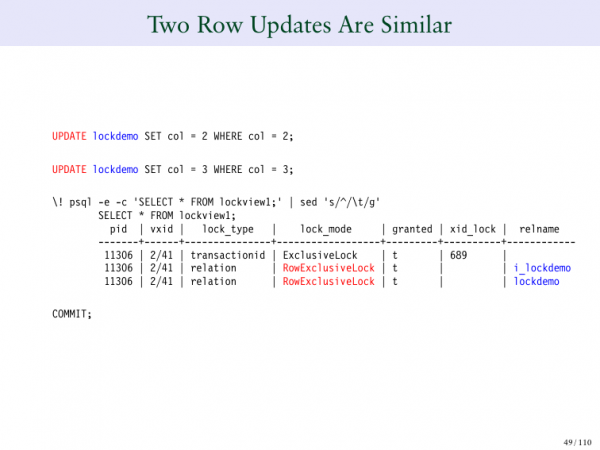
A co se stane, když chci aktualizovat dva řádky? A vidíme, že se chová stejně. Provádíme dvakrát více aktualizací, ale přesně stejné množství blokovaných řádků.
Pokud vás zajímá, jak to Postgres dělá, musíte si poslechnout moje přednášky o MVCC, abyste se dozvěděli, jak Postgres interně značkuje tyto řádky, které mění. A Postgres má způsob, jakým to dělá, ale nedělá to na úrovni blokování tabulek, dělá to na nižší a efektivnější úrovni.
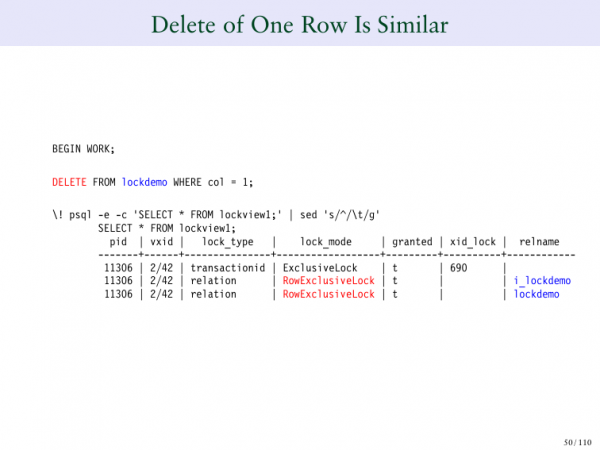
A co když chci něco odstranit? Pokud odstraním například jeden řádek a mám stále své dvě záložní blokace, a i když bych je všechny chtěl odstranit, stále tam budou.
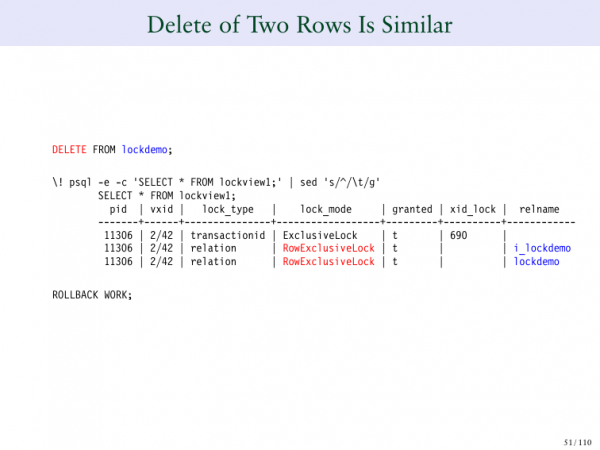
A pokud chci vložit 1 000 řádků, a pak buď odstranit, nebo přidat 1 000 řádků, ty jednotlivé řádky, které přidávám nebo měním, se zde nezapisují. Zapisují se na nižší úrovni uvnitř samotného řádku. A během přednášky o MVCC jsem o tom mluvil podrobně. Ale je velmi důležité, když analyzujete blokace, ujistit se, že máte blokaci na úrovni tabulky a že zde nevidíte, jak se zapisují jednotlivé řádky.
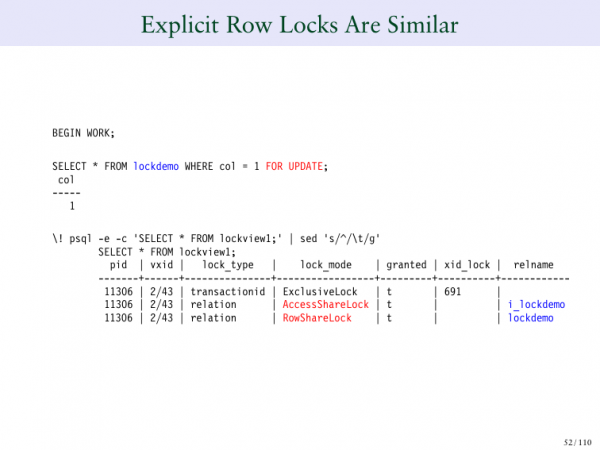
A co explicitní blokace?
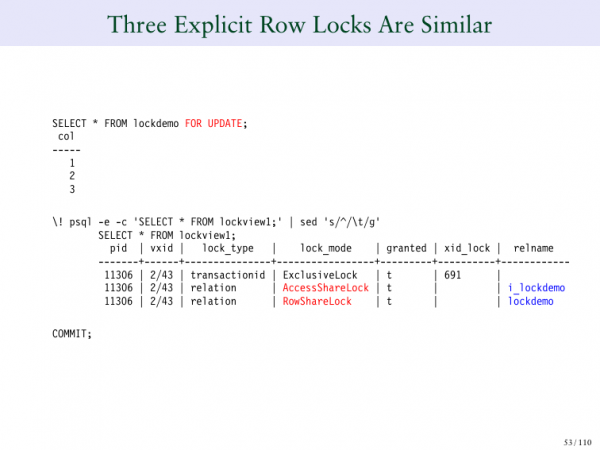
Pokud stisknu "aktualizovat", mám dvě blokované řádky. A pokud je všechny vyberu a stisknu "aktualizovat vše", stále mi zůstávají dvě blokace.
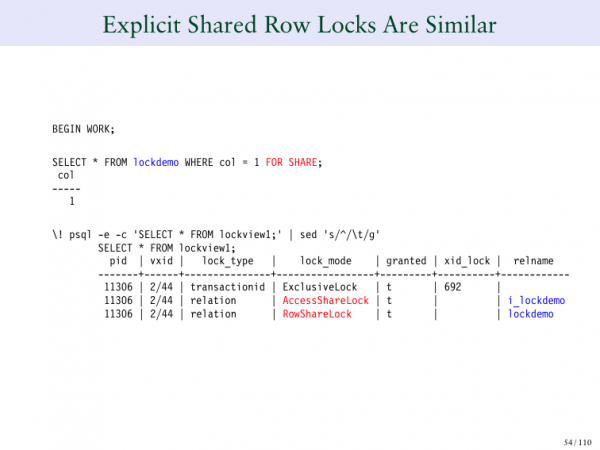
Nevytváříme zvláštní záznamy pro každý jednotlivý řádek. Protože pak klesá výkon, může jich být příliš mnoho. A můžeme se dostat do nepříjemné situace.
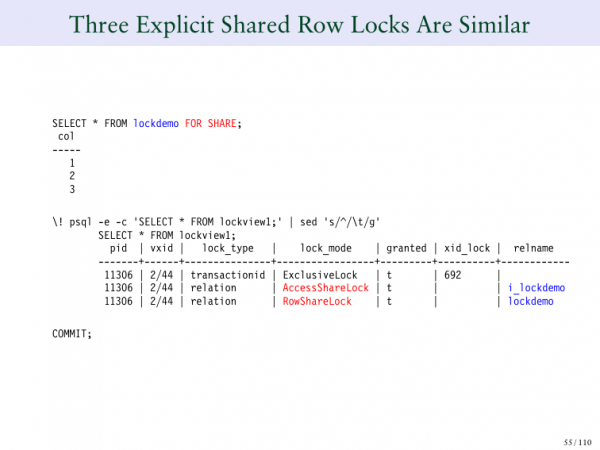
A to samé, pokud děláme shared, můžeme to dělat vše 30krát.
Obnovujeme naši tabulku, všechno mažeme, pak znovu vkládáme jeden řádek.
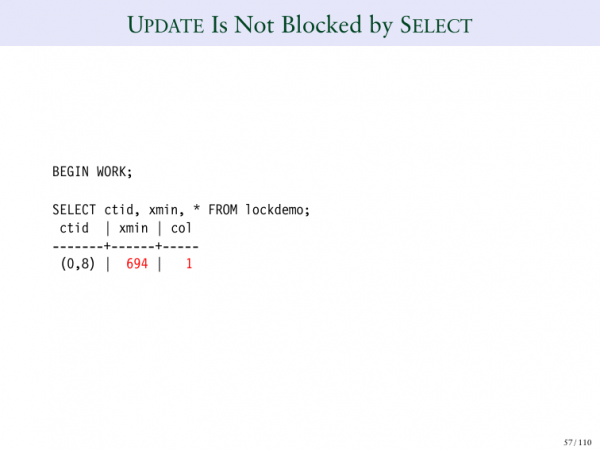
Další typ chování, který vidíte v Postgres, je velmi dobře známé a žádoucí chování – můžete provádět update nebo select. A můžete to dělat současně. Select neblokuje update a naopak. Říkáme, že čtenář neblokuje toho, kdo píše, a ten, kdo píše, neblokuje čtenáře.
Ukážu vám příklad tohoto. Teď provedu výběr. Poté provedeme INSERT. A vy pak uvidíte – 694. Uvidíte ID transakce, která provedla tuto vložení. A takto to funguje.
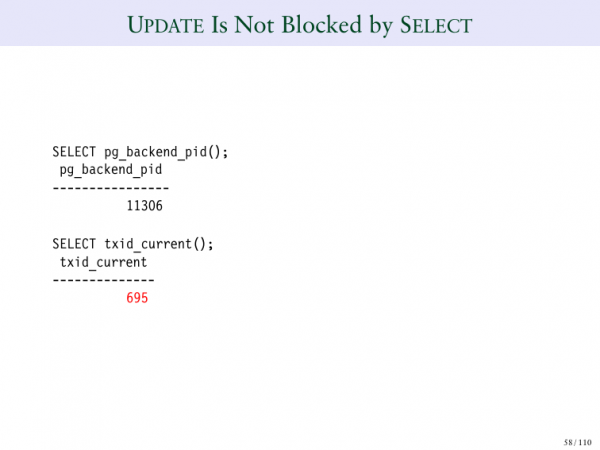
A pokud se teď podívám na své backend ID, je to nyní – 695.
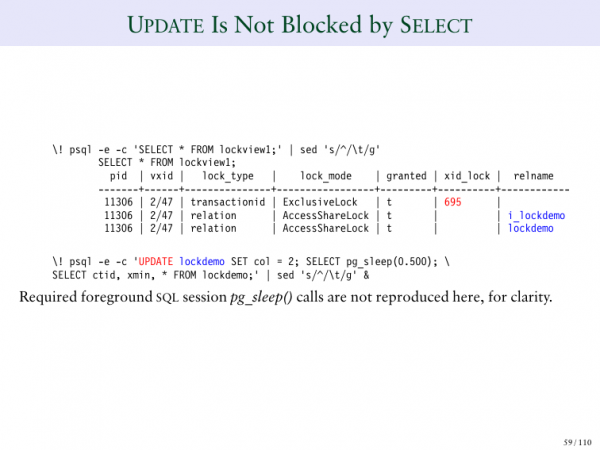
A mohu vidět, že 695 se objevuje v mé tabulce.
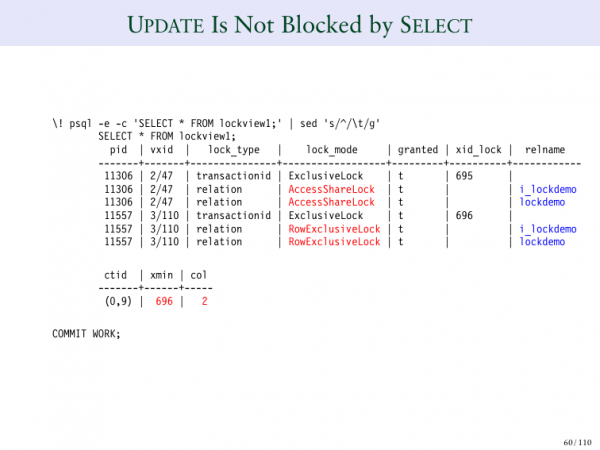
A pokud provádím aktualizaci takto, dostávám jiný případ. V tomto případě je 695 exkluzivní zámek, a u update je to stejné chování, ale mezi nimi nevzniká konflikt, což je dost neobvyklé.
A můžete si všimnout, že nahoře – je to ShareLock, a dole – je to ExclusiveLock. A obě transakce byly úspěšné.
A je potřeba poslouchat můj projev na MVCC, abyste pochopili, jak se to děje. Ale to je ilustrační příklad toho, co můžete dělat současně, tj. zároveň provádět SELECT a UPDATE.
Pojďme resetovat a udělat ještě jednou jednu operaci.
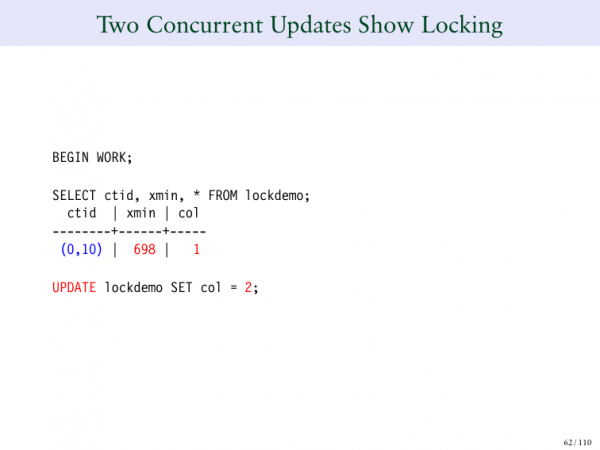
Pokud se pokusíte současně spustit dva update na stejném řádku, bude to zablokováno. A pamatujte, říkal jsem, že čtenář neblokuje autora, a autor neblokuje čtenáře, ale jeden autor blokuje druhého autora. Tj. nemůžeme mít dva lidi, kteří současně aktualizují stejný řádek. Musíme počkat, až někdo z nich dokončí.
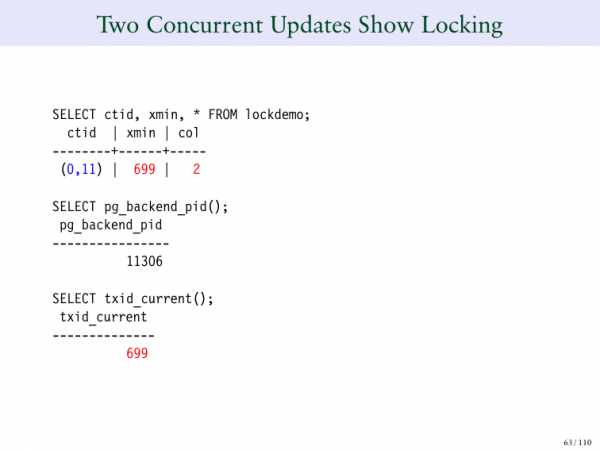
A abych to ilustroval, podívám se na tabulku Lockdemo. A podíváme se na jeden řádek. Na transakci 698.
Aktualizovali jsme to na 2. 699 – to je první aktualizace. A proběhla úspěšně, nebo se nachází v čekající transakci a čeká na naše potvrzení nebo zrušení.
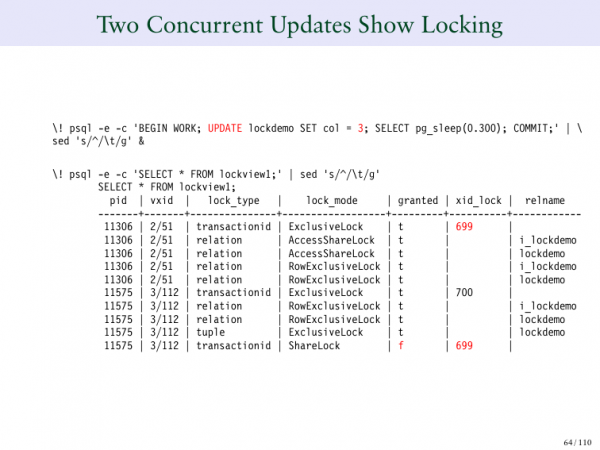
Ale podívejte se na něco jiného – 2/51 – to je naše první transakce, naše první relace. 3/112 – to je druhý požadavek, který se objevil nahoře a který změnil tuto hodnotu na 3. A pokud si všimnete, tak horní část se zablokovala sama o sobě, která byla 699. Ale 3/112 neposkytla zámek. V sloupci Lock_mode je napsáno, že čeká. Čeká na 699. A pokud se podíváte, kde je 699, je výše. A co udělala první relace? Vytvořila exkluzivní zámek na své vlastní transakční ID. Tak to Postgres dělá. Zablokuje své vlastní transakční ID. A pokud chcete čekat, až někdo potvrdí nebo zruší, musíte čekat, až bude čekající transakce. A proto můžeme vidět zvláštní řádku.
Podívejme se znovu. Vlevo vidíme naše zpracovávací ID. Ve druhém sloupci vidíme naše virtuální ID transakce a ve třetím vidíme lock_type. Co to znamená? V podstatě říká, že zablokuje transakční ID. Ale všimněte si, že ve všech řádcích dole je napsáno relation. A proto máte dva typy zámků v tabulce. Existuje zámek relation. A také existuje zámek transactionid, kde zablokujete sami sebe, to je přesně to, co se děje v prvním řádku nebo na samém dně, kde je transationid, kde čekáme, aby 699 dokončil svou operaci.
Sleduji, co se tady děje. A tady se současně dějí dvě věci. Díváte se na zámek podle transakčního ID v prvním řádku, který se blokuje sám. A zablokuje se sám, aby donutil lidi čekat.
Pokud se podíváte na 6. řádek, tak tam je stejný záznam jako v prvním. A proto je transakce 699 blokována. 700 se také blokuje sama. A poté ve spodním řádku uvidíte, že čekáme, až 699 dokončí svou operaci.
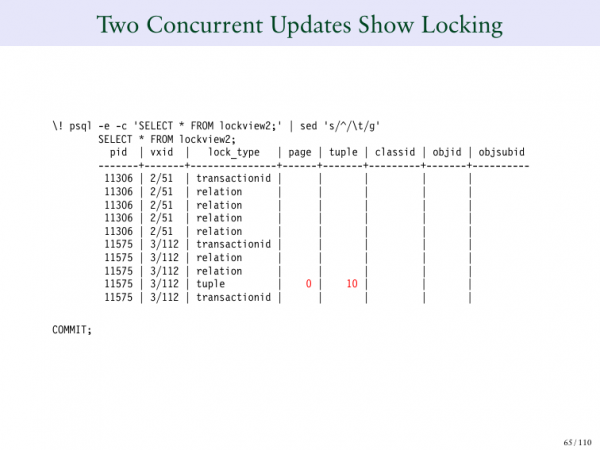
A v lock_type, tuple vidíte čísla.
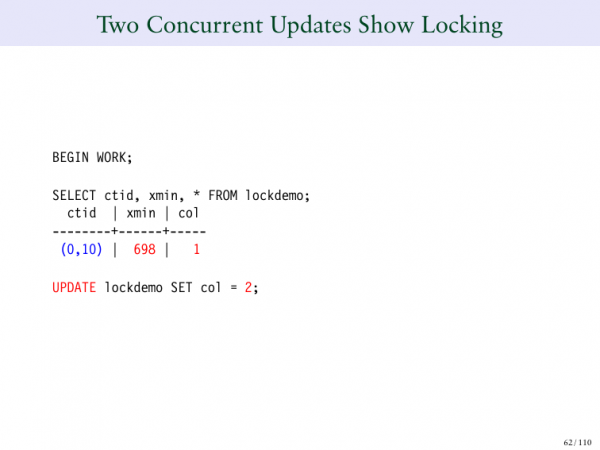
Můžete vidět, že je to 0/10. A to je číslo stránky, a také offset tohoto konkrétního řádku.
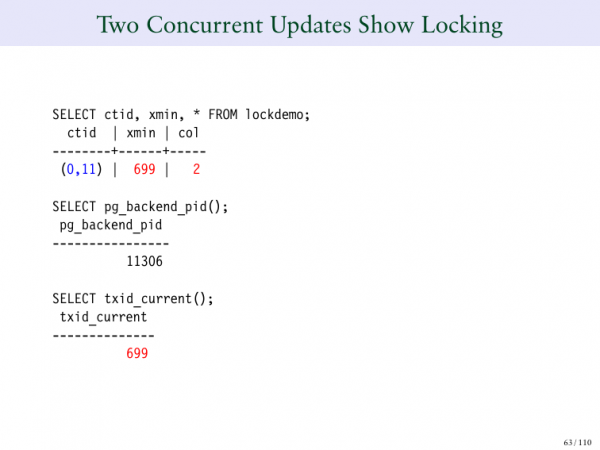
A vidíte, že se stává 0/11, když aktualizujeme.
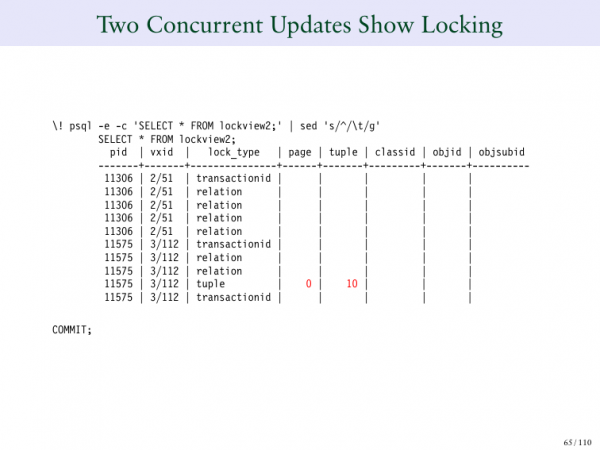
Ale ve skutečnosti – je to 0/10, protože probíhá čekání na tuto operaci. Máme možnost podívat se, co je ten řádek, který čekám, aby potvrdil.
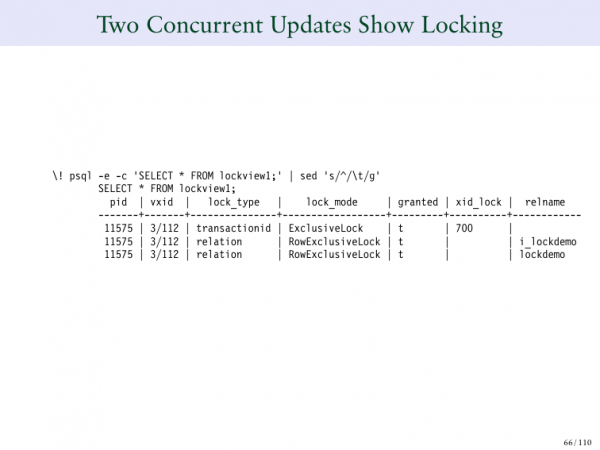
Jakmile jsme to potvrdili a klikli na commit, a když se aktualizace dokončila, dostali jsme tohle znovu. Transakce 700 je jediné zablokování, na nikdo další nečeká, protože byla uložena. Čeká pouze, až transakce skončí. Jakmile 699 skončí, už na nic nečekáme. A nyní transakce 700 říká, že je vše v pořádku, že má všechna zablokování, která potřebuje, ve všech povolených tabulkách.
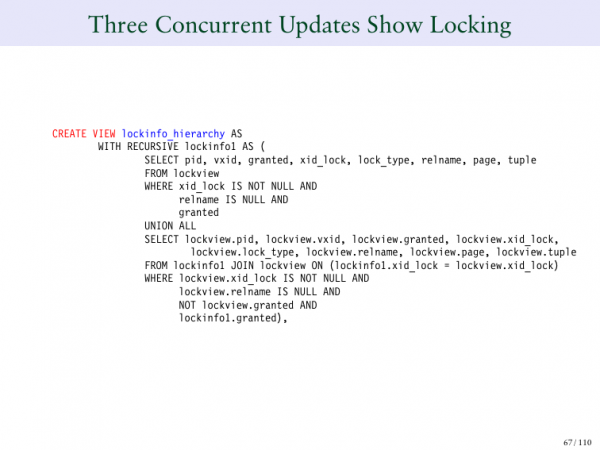
A abychom vše ještě zkomplikovali, vytváříme další pohled, který nám tentokrát poskytne hierarchii. Nečekám, že tento dotaz pochopíte. Ale to nám poskytne jasnější pohled na to, co se děje.
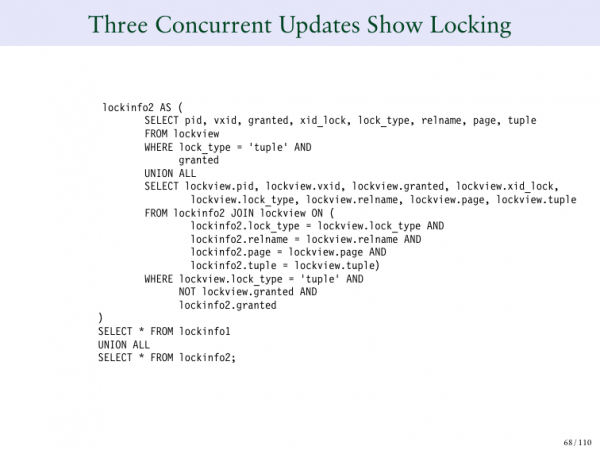
Toto je rekurzivní pohled, který má také další část. A pak znovu vrací vše dohromady. Pojďme to použít.
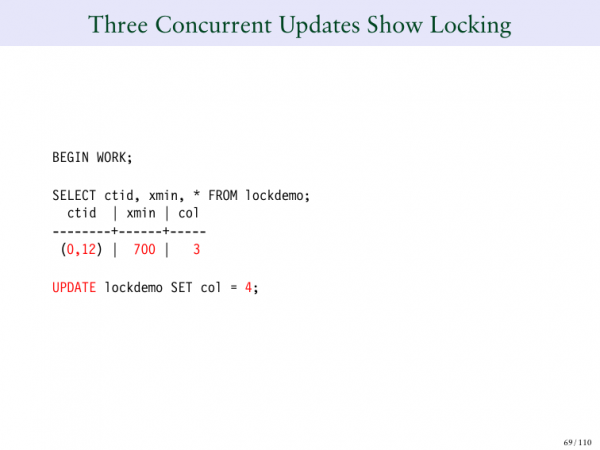
Co kdybychom provedli tři souběžné aktualizace a řekli, že řada má teď hodnotu tři. A změníme 3 na 4.
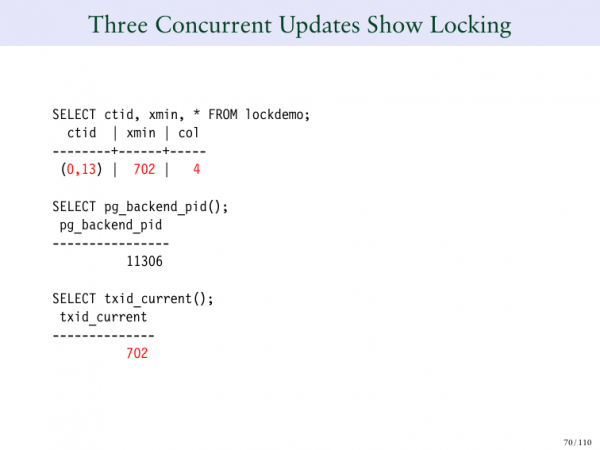
A tady vidíme 4. A transakční ID 702.
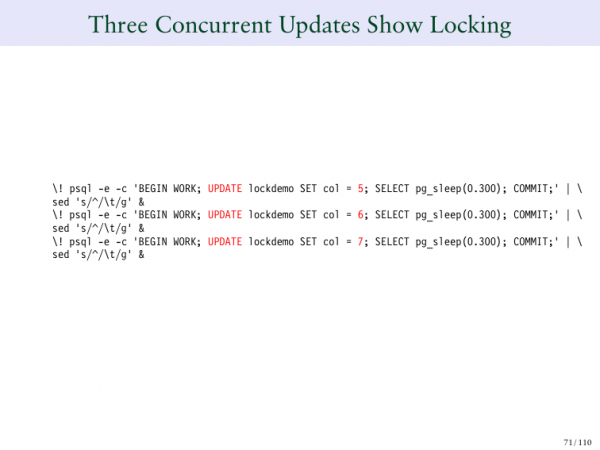
A pak změním 4 na 5. A 5 na 6, a 6 na 7. A já třídím frontu lidí, kteří budou čekat na dokončení této jedné transakce.
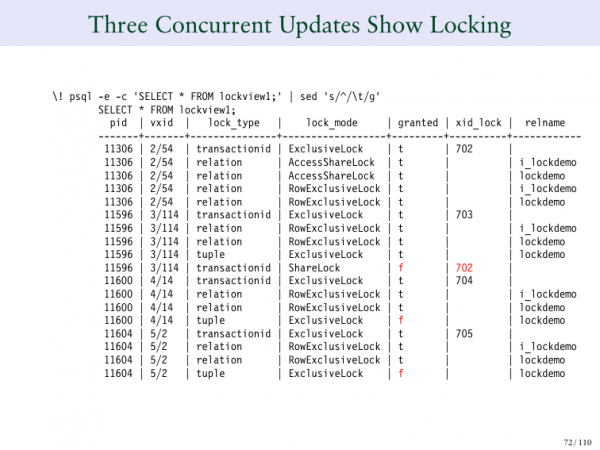
A všechno je jasné. Který je první řada? To je 702. To je transakční ID, které původně nastavilo tuto hodnotu. A co mám napsáno ve sloupci Granted? Mám tam značky f. To jsou moje aktualizace, které (5, 6, 7) nemohou být schváleny, protože čekáme, až transakční ID 702 skončí. Tam máme zablokování transakčního ID. A máme 5 transakčních zablokování ID.
A pokud se podíváte na 704, na 705, tak tam ještě není nic napsáno, protože ještě nevědí, co se děje. Jen píší, že nemají ponětí, co se děje. A prostě usnou, protože čekají, až někdo dokončí a probudí je, když se objeví možnost změnit řadu.
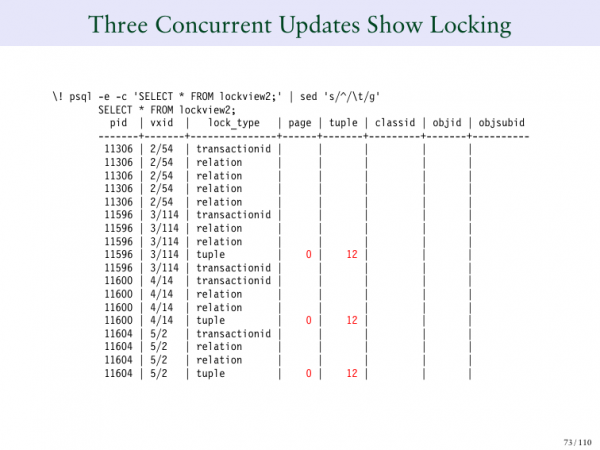
Takto to vypadá. Je jasné, že všichni čekají na 12. řádek.
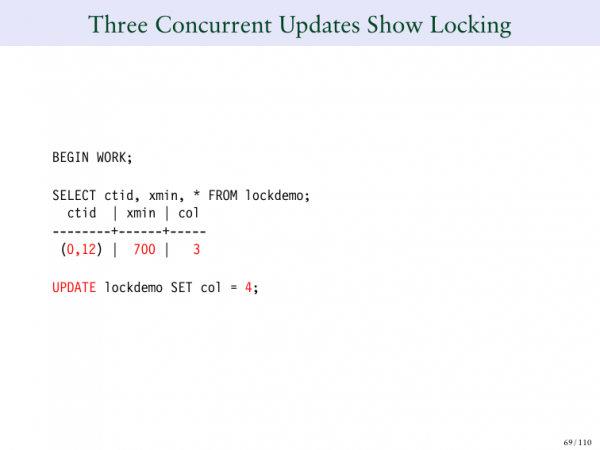
To je to, co jsme viděli zde. Tady je 0/12.
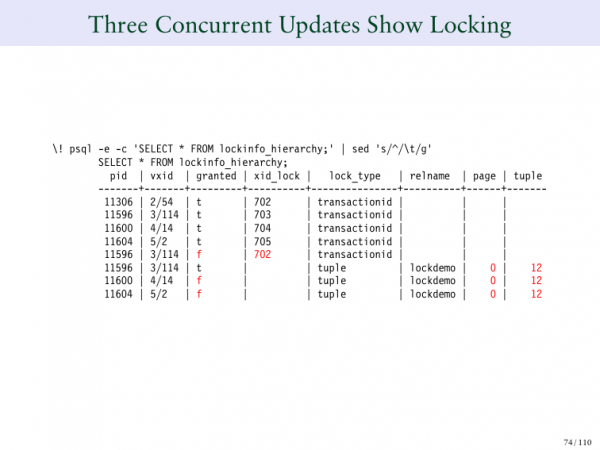
Jakmile je první transakce schválena, můžete zde vidět, jak funguje hierarchie. A teď to všechno dává smysl. Všichni se vyčistí. A ve skutečnosti stále čekají.
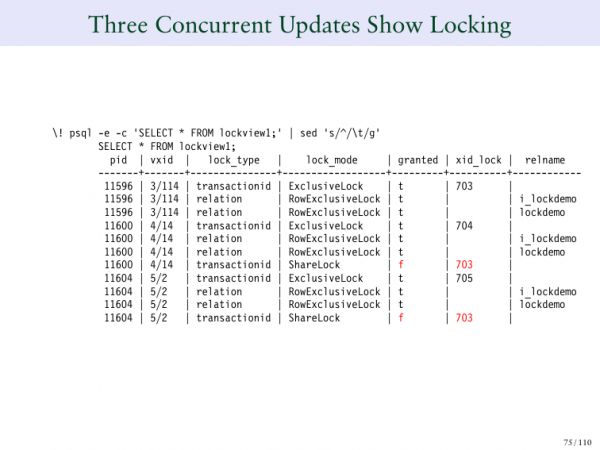
Toto se děje. 702 se zavazuje. A nyní 703 získává toto zablokování řádku, a pak 704 začíná čekat, až se 703 zaváže. A 705 to také očekává. A když se to všechno dokončí, vyčistí se samy. A rád bych upozornil na to, že se všichni postaví do fronty. A to vypadá velmi podobně jako situace v dopravní zácpě, když všichni čekají na první auto. První auto se zastavilo a všichni se postavili do dlouhé řady. Pak se pohnulo, pak může další auto projet vpřed a získat své zablokování, atd.
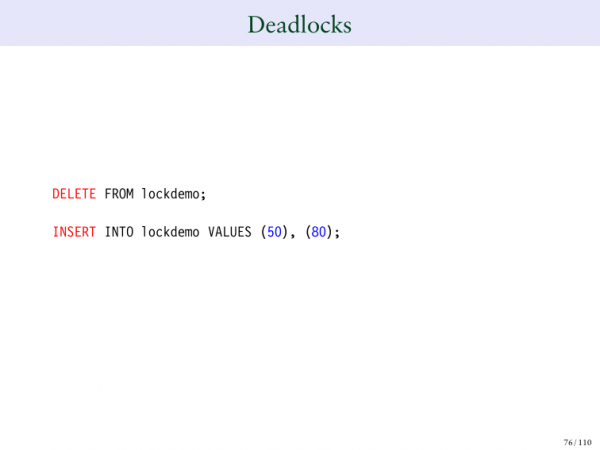
A pokud vám to připadalo nedostatečně složité, nyní si promluvíme o deadlockech. Nevím, kdo z vás se s nimi setkal. Je to poměrně běžný problém v databázových systémech. Ale deadlocky jsou situace, kdy jedna relace čeká na to, aby něco provedla jiná relace. A v ten moment druhá relace čeká na to, aby první relace provedla něco.
Například, pokud říká Ivan: „Dej mi něco“, a já říkám: „Ne, dám ti to jen tehdy, pokud mi dáš něco jiného“. A on říká: „Ne, nedám ti to, pokud mi to nedáš“. A dostáváme se do situace mrtvého zablokování. Jsem si jistý, že Ivan to neudělá, ale rozumíte smyslu, že máme dvě osoby, které chtějí něco získat a nejsou ochotny to dát, dokud jim druhá osoba nedá to, co chtějí. A tady není žádné řešení.
A vlastně vaše databáze to musí odhalit. A pak je nutné odstranit nebo uzavřít jednu z relací, protože jinak zůstanou navždy. A vidíme to v databázích, vidíme to v operačních systémech. A na všech místech, kde máme paralelní procesy, se to může stát.
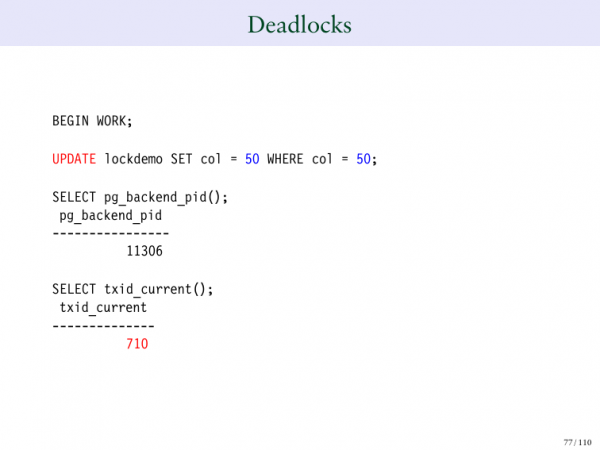
A nyní umístíme dvě mrtvá zablokování. Umístíme 50 a 80. V první řadě provedu aktualizaci z 50 na 50. Bude mít číslo transakce 710.
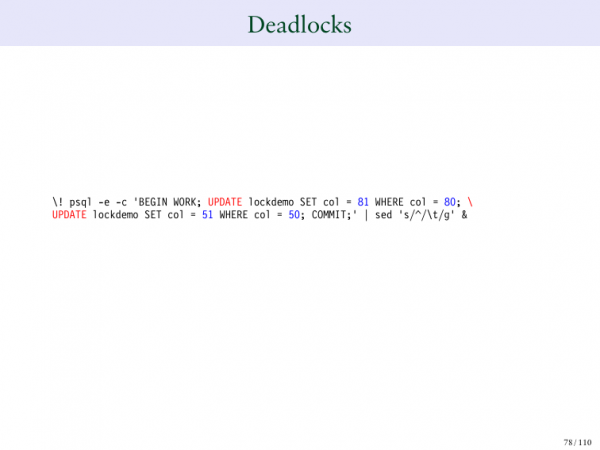
A poté vyměním 80 za 81 a 50 za 51.
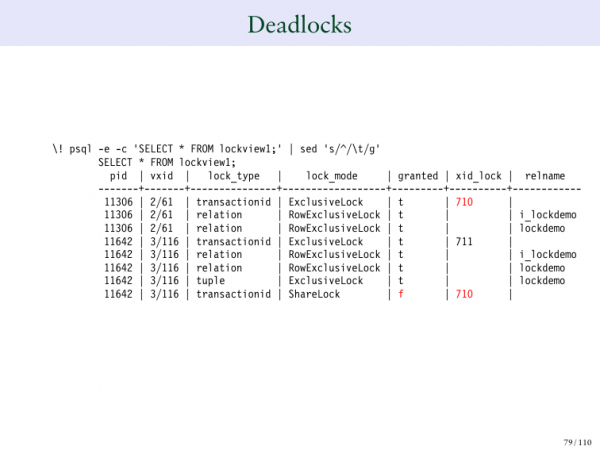
A takto to bude vypadat. A proto má 710 zablokování řádku, a 711 čeká na potvrzení. Viděli jsme to, když jsme aktualizovali. 710 je vlastníkem našeho řádku. A 711 čeká, až 710 dokončí transakci.
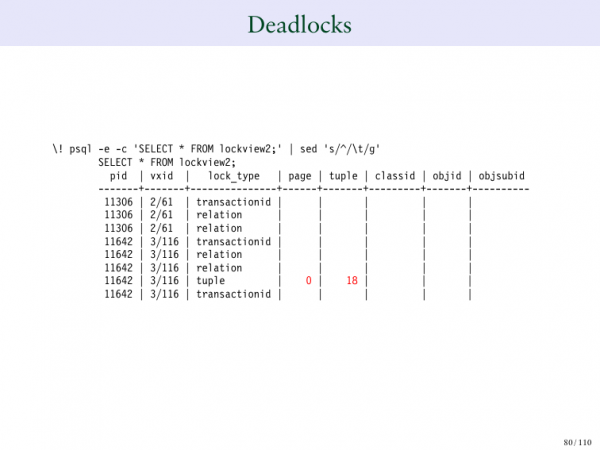
A je tam dokonce napsáno, na jakém konkrétním řádku máme mrtvá zablokování. A zde se to začíná stávat podivným.
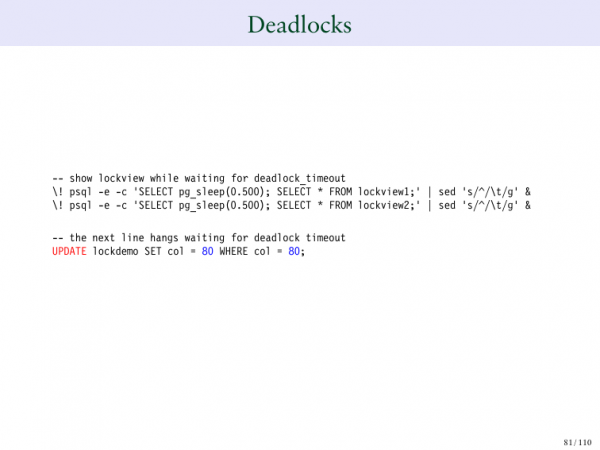
Nyní aktualizujeme 80 na 80.
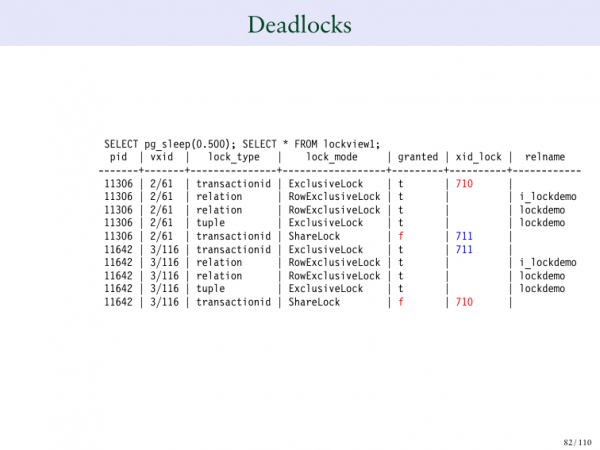
A tady začínají deadlocky. 710 čeká na odpověď od 711, zatímco 711 čeká na 710. A to nepovede k dobrému konci. A není z toho východiska. A budou si vzájemně čekat na odpovědi.
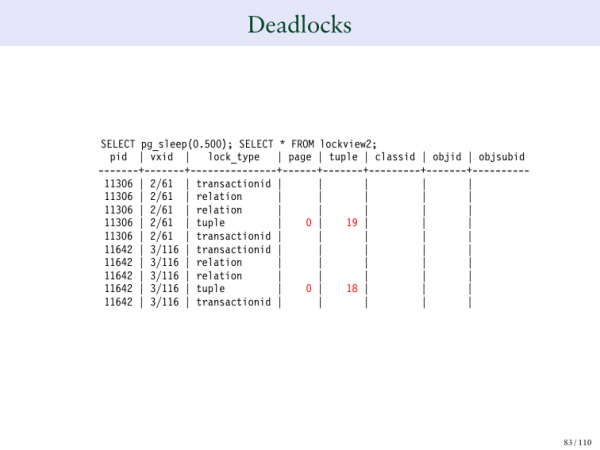
A to všechno začne zpožďovat. A to nechceme.
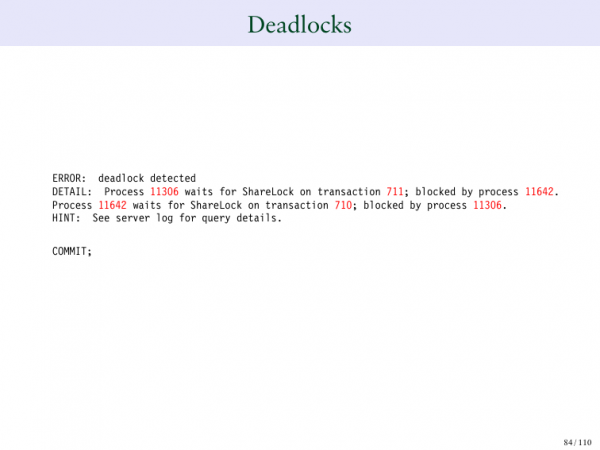
A v Postgres jsou způsoby, jak zjistit, kdy k tomu dochází. A když k tomu dojde, dostanete takovou chybu. Z toho jasně vyplývá, že nějaký proces čeká na SHARE LOCK od jiného procesu, t.j. který je blokován procesem 711. Ten proces čekal, že dostane SHARE LOCK na nějakém transakčním ID a byl blokován nějakým jiným procesem. Proto zde nastává situace deadlocku.
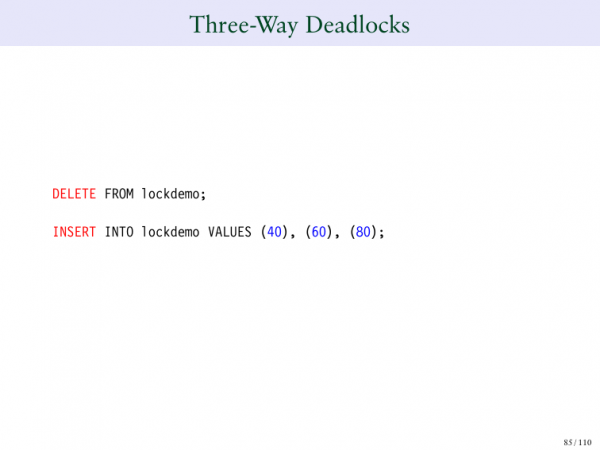
Ale existují i trojstranné deadlocky? Je to možné? Ano.
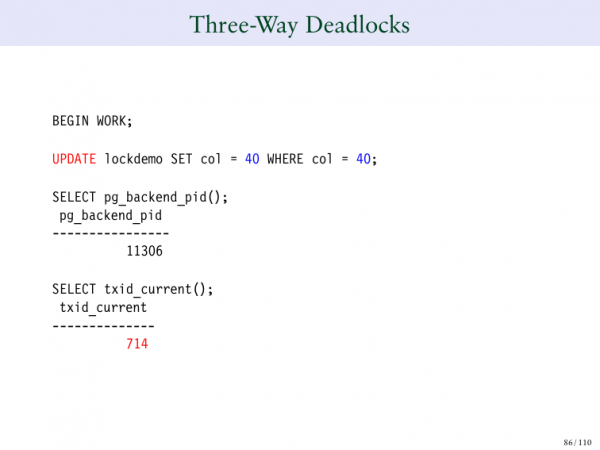
Zadáváme tato čísla do tabulky. Měníme 40 na 40, děláme zámek.
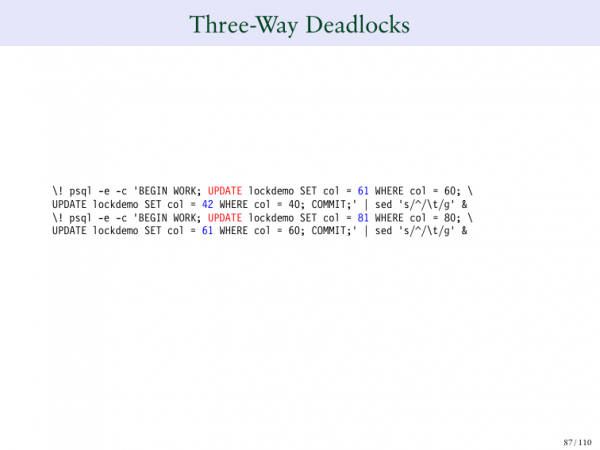
Měníme 60 na 61, 80 na 81.
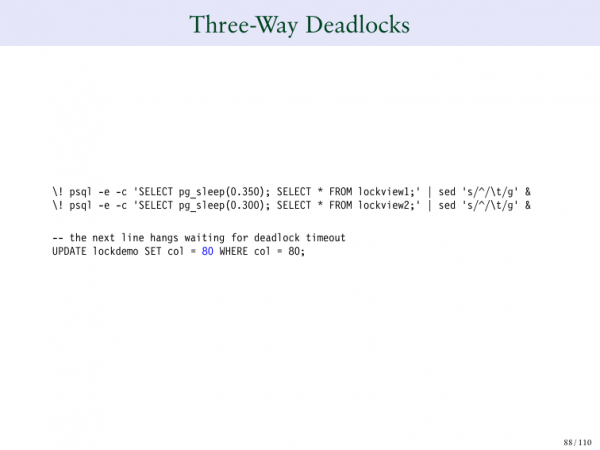
A pak měníme 80, a pak – bum!
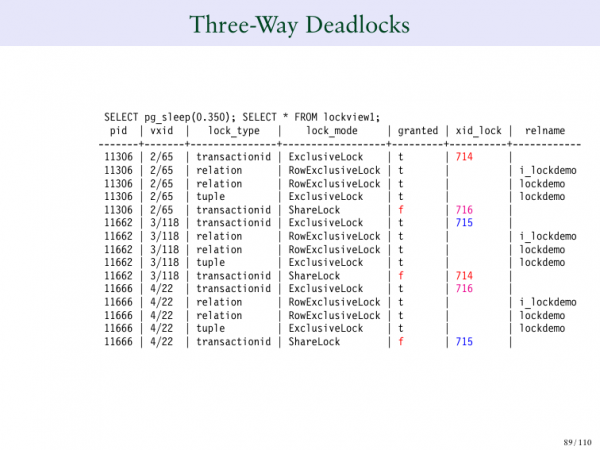
A 714 nyní čeká na 715. 716. čeká na 715. A s tím už nic neuděláte.
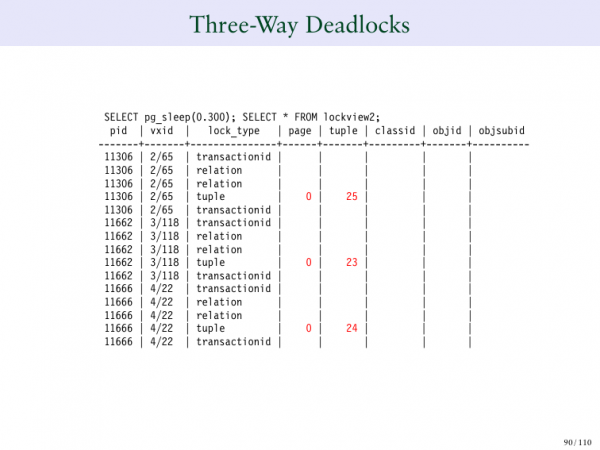
Tady už nejsou dva lidé, tady jsou už tři lidé. Chci něco od tebe, ten chce něco od třetí osoby a třetí osoba chce něco ode mě. Dostáváme se do trojstranného čekání, protože všichni čekáme, až ten druhý dokončí, co má udělat.
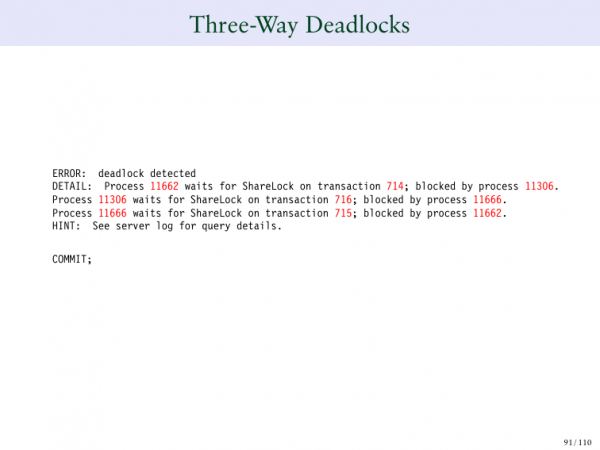
A Postgres ví, na kterém řádku k tomu dochází. A proto vám vydá následující zprávu, která ukazuje, že máte problém, kde si tři procesy vzájemně blokují.
Další problém – serializovatelnost.
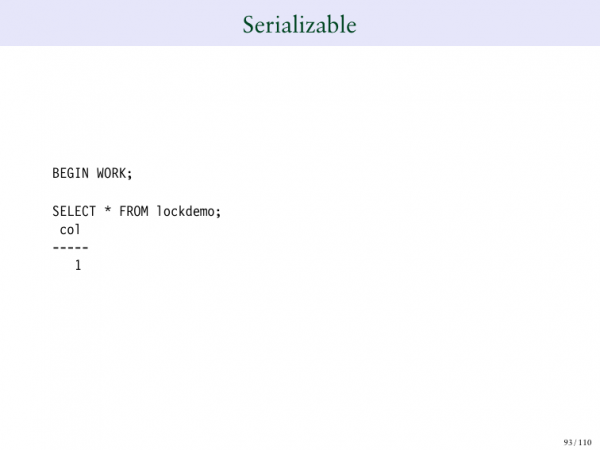
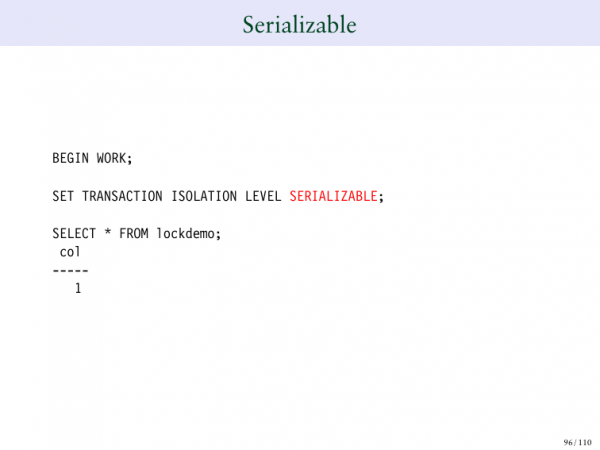
Pokud je speciální serializovatelný zámek.
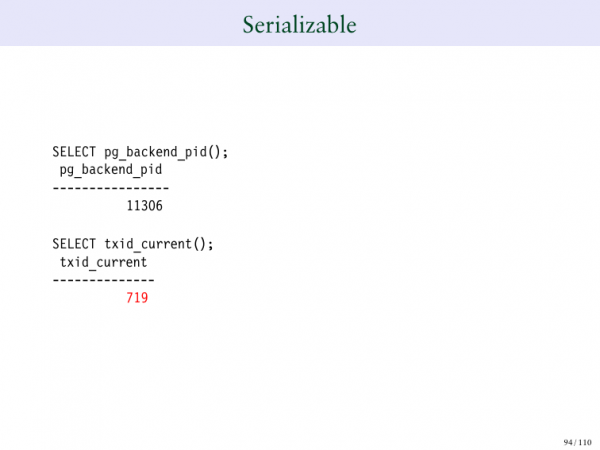
A vracíme se k 719. Má naprosto normální výstup.
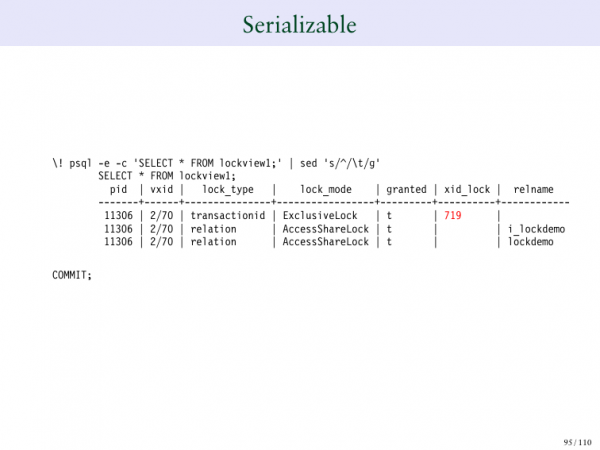
A můžete stisknout, abyste provedli transakci z serializovatelného.
A uvědomujete si, že nyní máte jiný typ zámku SA – to znamená serializovatelný.
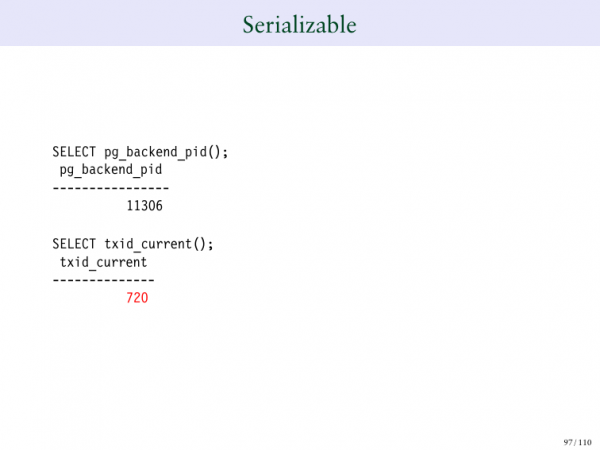
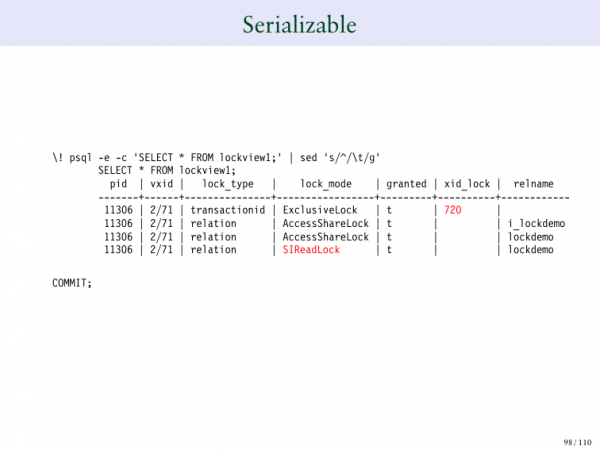
A proto máme nový typ zámku, který se nazývá SARieadLock, což je seriálový zámek a umožňuje zadávat sériové čísla.
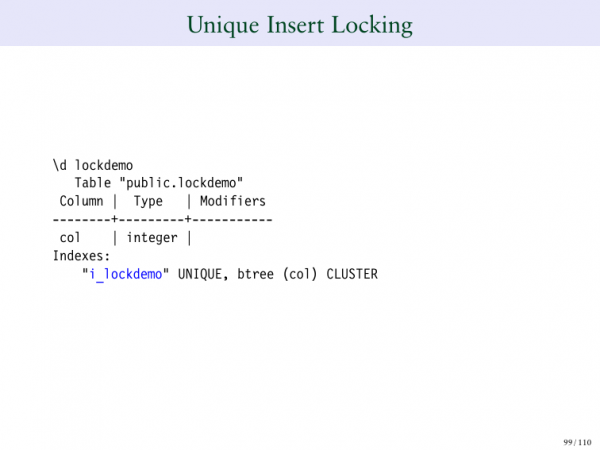
A také můžete vkládat unikátní indexy.
V této tabulce máme unikátní indexy.
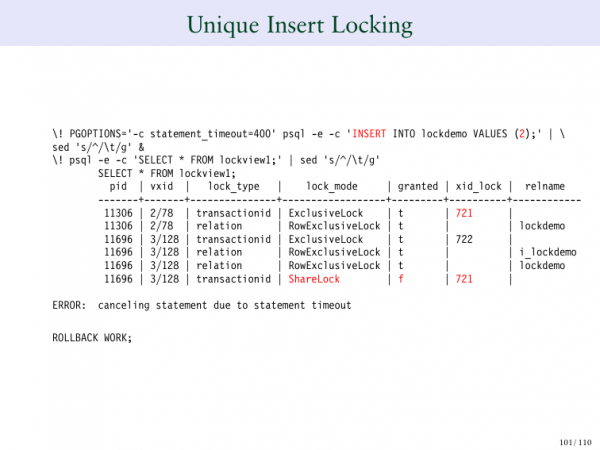
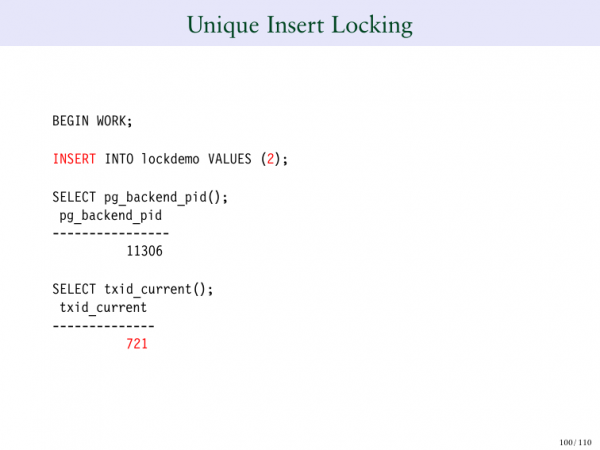
Takže pokud sem zadám číslo 2, mám 2. Ale úplně nahoře vkládám další 2. A můžete vidět, že 721 má exkluzivní zámek. Ale nyní 722 čeká, aby 721 dokončil svou operaci, protože nemůže vložit 2, dokud neví, co se stane s 721.
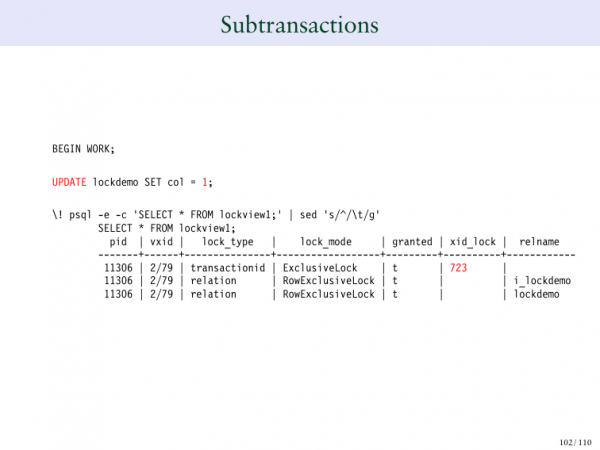
A pokud děláme subtransakci.
Tady máme 723.
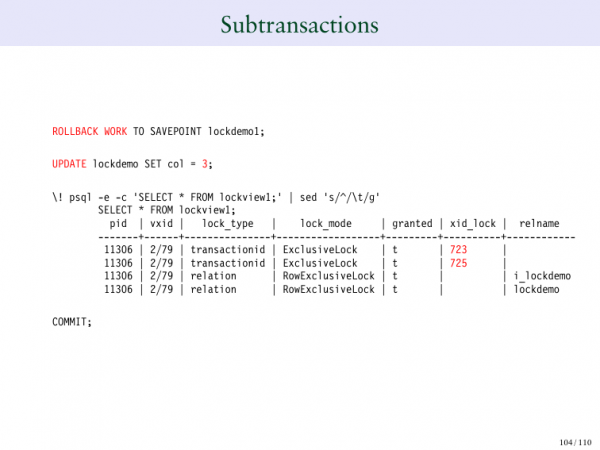
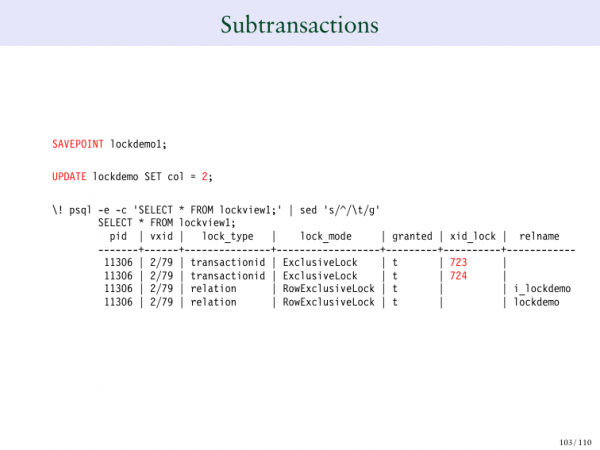
A pokud si uchováváme bod a poté ho aktualizujeme, získáme nový transakční ID. To je další chování, které byste měli znát. Pokud to vrátíme, transakční ID zmizí. 724 zmizí. Ale nyní máme 725.
A co se zde snažím udělat? Snažím se vám ukázat příklady neobvyklých zámků, které můžete najít: ať už se jedná o serializable zámky nebo SAVEPOINT – to jsou různé typy zámků, které se objeví v tabulce zámků.
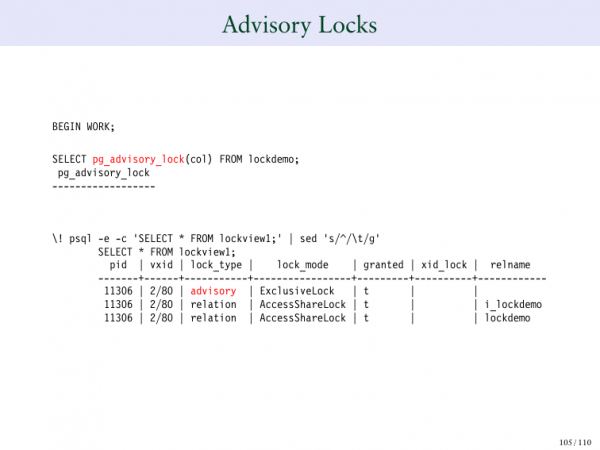
To je vytváření explicitních (jasných) zámků, které mají pg_advisory_lock.
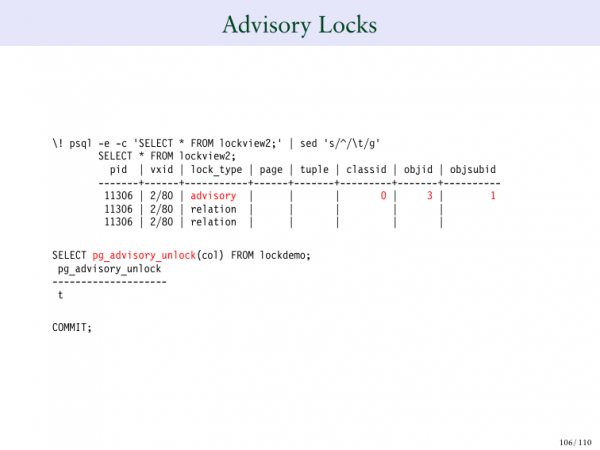
A vidíte, že typ zámku je zde uveden jako advisory. A tady je napsáno červeně „advisory“. A můžete takto zároveň zablokovat s pg_advisory_unlock.
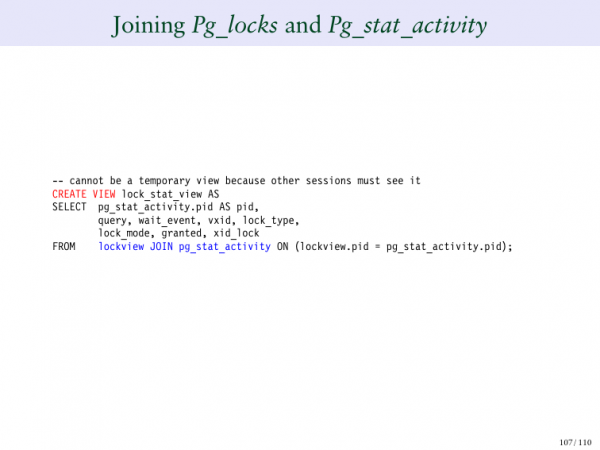
A na závěr bych vám chtěl ukázat ještě jednu zajímavou věc. Vytvořím další typ. Ale spojím tabulku pg_locks s tabulkou pg_stat_activity. A proč to chci udělat? Protože mi to umožní podívat se a vidět všechny aktuální relace a to, jaké zámky očekávají. A to je docela zajímavé, když spojíme tabulku zámků a tabulku dotazů.
A tady vytváříme pg_stat_view.
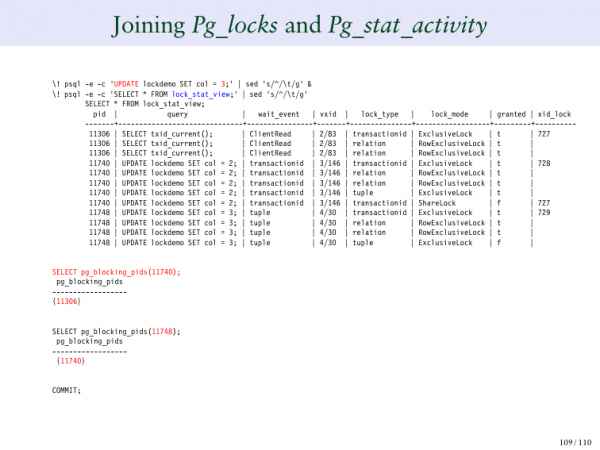
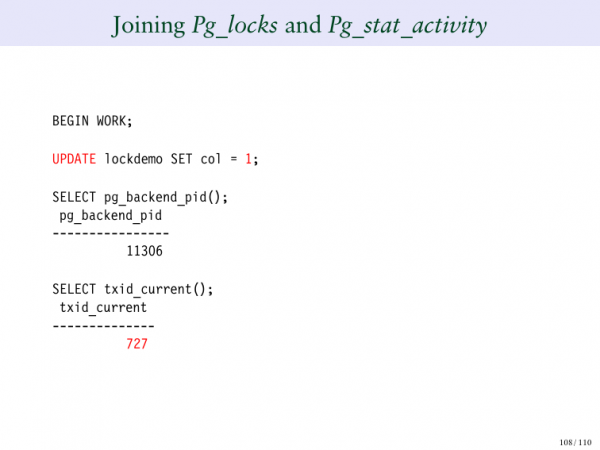
A aktualizujeme řádek o jeden. A zde vidíme 724. A poté aktualizujeme náš řádek na tři. A co vidíte nyní? To jsou dotazy, tedy vidíte celý seznam dotazů, které jsou vyjmenovány ve levém sloupci. A pak na pravé straně můžete vidět zámky a to, co vytvářejí. A to může být pro vás srozumitelnější, abyste nemuseli pokaždé znovu navštěvovat každou relaci a zjišťovat, zda se k ní připojit, nebo ne. To za nás dělají.
Další funkce, která je velmi užitečná – to je pg_blocking_pidsMožná jste o ní nikdy neslyšeli. Co dělá? Umožňuje nám říct, které ID procesů očekává pro tuto relaci 11740. Můžete vidět, že 11740 očekává 724. A 724 je na vrcholu. A 11306 je váš ID proces. V podstatě tato funkce prochází vaší tabulkou zámků. A vím, že je to trochu složité, ale rozumíte tomu. V podstatě tato funkce prochází touto tabulkou zámků a pokouší se najít, kde je tento ID proces, s ohledem na ty zámky, které očekává. Také se pokouší vypočítat, který přesně proces ID má ten proces, který čeká na zámek. Proto můžete spustit tuto funkci. pg_blocking_pids.
A to může být velmi užitečné. Přidali jsme to až od verze 9.6, takže tato funkce má pouhých 5 let, ale je velmi a velmi užitečná. To samé platí pro druhý dotaz. Ukazuje přesně to, co potřebujeme vidět.
To je to, o čem jsem chtěl s vámi mluvit. A jak jsem očekával, vyčerpali jsme celý náš čas, protože bylo obrovské množství slidů. Slidy jsou k dispozici ke stažení. Chtěl bych vám poděkovat, že jste byli tady. Jsem si jistý, že si užijete zbytek konference, děkuji!
Otázky:
Například, pokud se snažím aktualizovat řádky a druhá relace se snaží odstranit celý tabulku. Jak jsem pochopil, mělo by tam být něco jako intent lock. Existuje něco takového v Postgresu?
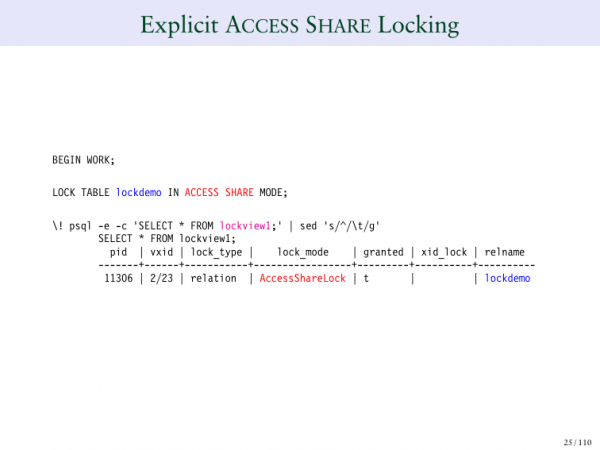
Vraťme se na počátek. Možná si pamatujete, že když děláte cokoliv, například SELECT, udělíme AccessShareLock. A to brání odstranění tabulky. Takže pokud se například chcete aktualizovat řádek v tabulce nebo odstranit řádek, někdo nemůže odstranit celou tabulku současně s tím, protože držíte tento AccessShareLock nad celou tabulkou a nad řádkem. A jakmile dokončíte, mohou to odstranit. Ale dokud něco měníte, nemohou to udělat.
Pojďme to říct ještě jednou. Přejděme k příkladu s odstraněním. A vidíte, že na řádku je exkluzivní zámek nad celou tabulkou.
Bude to vypadat jako exkluzivní zámek, že?
Ano, to vypadá takto. Chápu, o čem mluvíte. Říkáte, že když provedu SELECT, budu mít ShareExclusive a pak to převedu do stavu Row Exclusive, je to problém? Překvapivě to ale nečiní žádný problém. Je to jako zvýšení úrovně zámku, ale v podstatě mám zámek, který brání vymazání. A teď, když tento zámek posiluji, stále brání vymazání. Takže to není tak, že bych zvyšoval úroveň. Tj. bránil tomu i na nižší úrovni, takže když ji zvyšuji, stále to brání odstranění tabulky.
Rozumím, o čem mluvíte. Nejedná se o situaci, kdy byste se snažili zrušit jeden zámek, abyste zavedli silnější zámek. Tady to prostě všude zvyšuje tuto prevenci, takže to nezpůsobuje žádný konflikt. Ale to je dobrá otázka. Děkuji, že jste se na to zeptali!
Co potřebujeme udělat, abychom se vyhnuli situaci deadlocku, když máme mnoho relací, velké množství uživatelů?
Postgres automaticky detekuje situace deadlocku. A automaticky odstraní jednu z relací. Jediný způsob, jak se vyhnout situacím s mrtvými zámky, je zamykat lidi ve stejném pořadí. Takže když se podíváte na svou aplikaci, často příčina deadlocků… Představme si, že chci zamknout dvě různé věci. Jedna aplikace zamkne tabulku 1, druhá aplikace zamkne 2 a pak tabulku 1. A nejjednodušší způsob, jak se vyhnout deadlockům, je podívat se na svou aplikaci a snažit se zajistit, aby zamykání probíhalo ve stejném pořadí ve všech aplikacích. A to obvykle odstraní 80 % problémů, protože různí lidé tyto aplikace píší. A pokud je zamykáte ve stejném pořadí, nesetkáte se se situací deadlocku.
Děkuji vám za vaše vystoupení! Mluvili jste o vacuum full a pokud tomu dobře rozumím, vacuum full deformuje pořadí záznamů v jednotlivých úložištích, takže aktuální záznamy zůstávají nezměněny. Proč vacuum full vyžaduje exkluzivní zámek a proč to konfliktuje s operacemi zápisu?
To je dobrá otázka. Důvod spočívá v tom, že vacuum full zabírá tabulku. V podstatě vytváříme novou verzi tabulky. A tabulka bude nová. To znamená, že to bude zcela nová verze tabulky. A problém je v tom, že když to děláme, nechceme, aby lidé to četli, protože potřebujeme, aby viděli novou tabulku. A proto to souvisí s předchozí otázkou. Kdybychom mohli číst současně, nemohli bychom ji přesunout a nasměrovat lidi na novou tabulku. Museli bychom čekat, aby každý dokončil čtení této tabulky, a proto je to v podstatě situace lock exclusive.
Jednoduše říkáme, že blokujeme úplně na začátku, protože víme, že na konci budeme potřebovat exkluzivní uzamčení, abychom mohli všechny přesunout na novou kopii. Takže potenciálně můžeme to umožnit. A děláme to s paralelním indexováním. Ale je to mnohem složitější udělat. A to se výrazně vztahuje k vaší předchozí otázce o lock exclusive.
Je možné nastavit timeout pro zámky v PostgreSQL? V Oracle mohu například napsat „select for update“ a čekat 50 sekund na aktualizaci. To bylo dobré pro aplikaci. Ale v PostgreSQL buď musím udělat to ihned a vůbec nečekat, nebo čekat do určitého času.
Ano, můžete zvolit timeout pro vaše zámky. Můžete také vydat příkaz no way, který bude …, pokud nezískáte zámek okamžitě. Takže buď lock timeout, nebo něco jiného, co vám to umožní. Nedělá se to na syntaktické úrovni. Dělá se to jako proměnná na serveru. Někdy to nelze použít.
Můžete otevřít 75. snímek?
Ano.
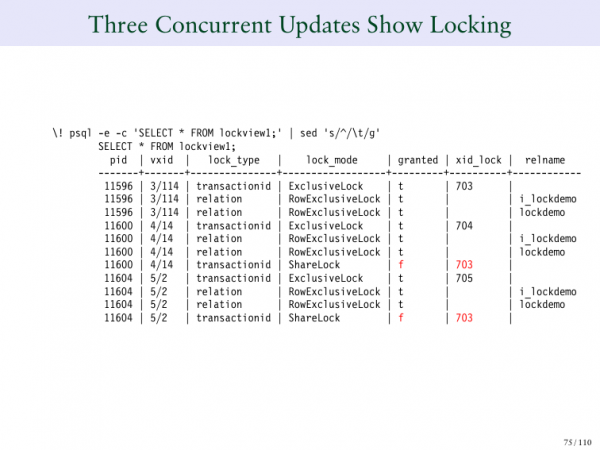
A moje otázka zní: Proč oba procesy aktualizace čekají na 703?
A to je skvělá otázka. Omlouvám se, ale nechápu, proč to Postgres dělá. Když byl 703 vytvořen, očekával 702. A když se objeví 704 a 705, vypadá to, že nevědí, co mají očekávat, protože tam ještě nic není. A Postgres to dělá takto: když nemůžete získat zámek, napíše "A proč bych vás měl zpracovávat?", protože už na někoho čekáte. Takže mu prostě necháme viset ve vzduchu, nezaktualizuje to vůbec. Co se tedy zde stalo? Jakmile 702 dokončil proces a 703 získal svůj zámek, systém se vrátil zpět. A řekl, že nyní máme dvě osoby, které čekají. A pak je oba aktualizujeme společně. A uvedeme, že oba čekají.
Nevím, proč to Postgres dělá. Ale je tu problém, který se nazývá f… Mám pocit, že to není termín v češtině. To je, když všichni čekají na jeden zámek, i když je tu 20 instancí, které na zámek čekají. A najednou se všichni probudí najednou. A všichni se snaží reagovat. Ale systém to udělá tak, že všichni čekají na 703. Protože na všechny čekají a okamžitě je všechny seřadíme do fronty. A pokud se objeví jakýkoli jiný nový požadavek, který byl vytvořen po tom, například 707, tak tam opět bude prázdnota.
Mám pocit, že tohle se dělá proto, aby bylo možné říct, že v tomto kroku 702 čeká na 703, a všichni, kdo přijdou po něm, nebudou mít žádný záznam v tomto poli. Ale jakmile první čekající odejde, a všichni, kdo čekali v tom okamžiku před aktualizací, dostanou stejný označovač. A proto mám pocit, že je to uděláno, abychom mohli zpracovávat v pořadí, aby byly správně seřazeny.
Vždycky jsem se na to díval jako na dost zvláštní fenomén. Protože zde například je vůbec nezmiňujeme. Ale mám pocit, že pokaždé, když dáme nový zámek, tak koukáme na všechny ty, kdo jsou v čekacím procesu. Potom je všechny seřadíme do fronty. A potom jakýkoli nový, který přijde, se dostane do fronty až když ten další člověk dokončí zpracování. Odpověď je velmi dobrá. Děkuji vám mnohokrát za otázku!
Myslím, že je mnohem logičtější, když 705 čeká na 704.
Ale problém je následující. Technicky můžete probudit buď jedno, nebo druhé. A proto probudíme to nebo ono. Ale co se děje v práci systému? Vidíte, jak 703 na samém vrcholu zablokoval svůj vlastní transakční ID. To je, jak Postgres funguje. A 703 je blokován svým vlastním transakčním ID, takže pokud někdo chce počkat, bude čekat na 703. A vlastně, 703 končí. A až po jeho dokončení se nějaký z procesů probudí. A nevíme, který proces to bude. Poté postupně zpracováváme všechny. Ale není jasné, který proces se probudí jako první, protože to může být kterýkoli z těchto procesů. V zásadě jsme měli plánovač, který říkal, že nyní můžeme probudit kterýkoli z těchto procesů. Jednoduše vybereme jeden náhodně. Proto je třeba označit oba, protože můžeme probudit kterýkoli z nich.
A problém je v tom, že máme CP-nekonečno. A proto je velmi pravděpodobné, že můžeme probudit pozdější. A pokud například budeme probouzet pozdější, pak budeme očekávat toho, kdo právě získal zámek, takže nevíme, kdo bude probuzen jako první. Vytváříme jednoduše takovou situaci a systém je bude probouzet v náhodném pořadí.
Existuje . Podívejte se, také jsou zajímavé a užitečné. Téma je samozřejmě děsivě složité. Děkuji mnohokrát, Bruci!
Zdroj: habr.com
