

Často lidé, kteří se pohybují v oblasti Data Science, mají nerealistická očekávání, co je čeká. Mnozí si myslí, že začnou skvěle psát neuronové sítě, vytvoří hlasového asistenta na úrovni Iron Mana, nebo porazí všechny na finančních trzích.
Ale práce Data Scientista je zaměřena na data, a jedním z nejdůležitějších a časově náročných úkolů je zpracování dat před tím, než jsou předložena neuronové síti nebo analyzována určitým způsobem.
V tomto článku náš tým popíše, jak lze snadno a rychle zpracovat data pomocí podrobného návodu a kódu. Snažili jsme se, aby byl kód dostatečně flexibilní a aby jej bylo možné aplikovat na různé datové soubory.
Mnoho profesionálů možná nenajde nic mimořádného v tomto článku, ale začínající si mohou odnést něco nového, a také každý, kdo dlouho snil o vytvoření vlastního notebooku pro rychlé a strukturované zpracování dat, si může zkopírovat kód a přizpůsobit ho svým potřebám, nebo
Obdrželi jsme dataset. Co dál?
Takže standard: je třeba pochopit, s čím máme co do činění, obecný obrázek. K tomu použijeme pandas, abychom jednoduše zjistili různé typy dat.
import pandas as pd #importujeme pandas
import numpy as np  #importujeme numpy
df = pd.read_csv("AB_NYC_2019.csv") #čteme dataset a ukládáme ho do proměnné df
df.head(3) #podíváme se na první 3 řádky, abychom zjistili, jak vypadají hodnoty 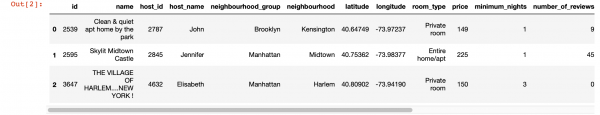
df.info() #Zobrazujeme informace o sloupcích 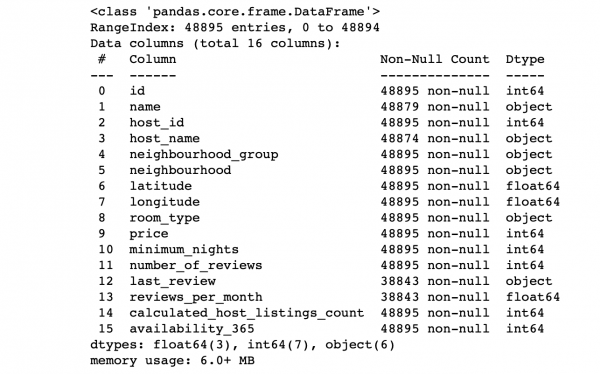
Podíváme se na hodnoty sloupců:
- Odpovídá počet řádků v každém sloupci celkovému počtu řádků?
- Jaká je podstata dat v každém sloupci?
- Který sloupec chceme udělat target, abychom pro něj prováděli predikce?
Odpovědi na tyto otázky umožní analyzovat dataset a přibližně nakreslit plán následujících kroků.
Také, pro hlubší pohled na hodnoty v každém sloupci, můžeme použít funkci pandas describe(). Pravda, nevýhodou této funkce je, že nedává informace o sloupcích s hodnotami string. S nimi se vyřešíme později.
df.describe() 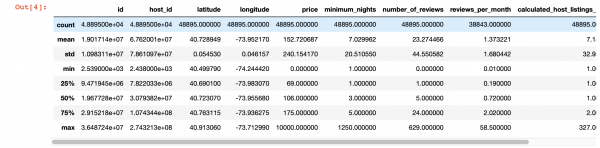
Kouzelná vizualizace
Podíváme se na to, kde nám úplně chybí hodnoty:
import seaborn as sns
sns.heatmap(df.isnull(),yticklabels=False,cbar=False,cmap='viridis') 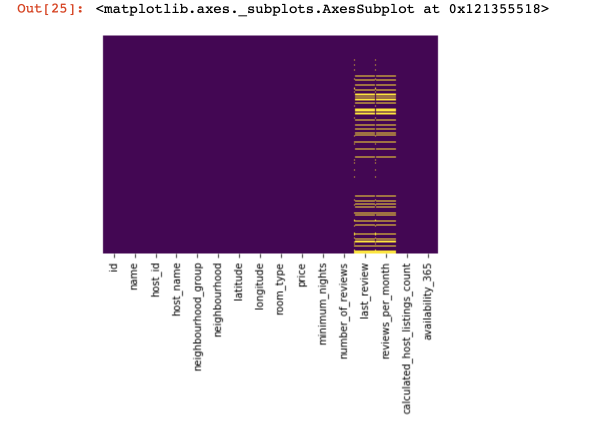
To byl malý pohled z vrchu, nyní se pustíme do zajímavějších věcí.
Pokud možno zkusíme najít a odstranit sloupce, které mají pouze jednu hodnotu ve všech řádcích (ty nebudou mít žádný vliv na výsledek):
df = df[[c for c
        in list(df)
        if len(df[c].unique()) > 1]] # Přepisujeme dataset, abychom ponechali pouze ty sloupce, ve kterých je více než jedna unikátní hodnota
Teď se chráníme a zajišťujeme úspěch našeho projektu před duplicitními řádky (řádky, které obsahují stejnou informaci ve stejném pořadí jako již existující řádky):
df.drop_duplicates(inplace=True) # Děláme to, pokud to považujeme za nutné.
                                 # V některých projektech nestojí za to tyto data odstraňovat hned na začátku.
Rozdělujeme dataset na dva: jeden s kvalitativními hodnotami a druhý — s kvantitativními.
Zde je třeba udělat malé upřesnění: pokud si řádky s chybějícími daty u kvalitativních a kvantitativních údajů vzájemně silně neodpovídají, bude nutné rozhodnout, čím obětujeme — všemi řádky s chybějícími daty, pouze jejich částí nebo určitými sloupci. Pokud si však řádky odpovídají, máme plné právo rozdělit dataset na dva. V opačném případě bude nejprve nutné zjistit, jak si vzájemně neodpovídají chybějící data u kvalitativních a kvantitativních, a až poté rozdělit dataset na dva.
df_numerical = df.select_dtypes(include = [np.number])
df_categorical = df.select_dtypes(exclude = [np.number])
Děláme to, abychom usnadnili zpracování těchto dvou různých typů dat — později pochopíme, jak nám to usnadňuje život.
Pracujeme s kvantitativními daty.
První, co je třeba udělat, je zjistit, zda v kvantitativních datech nejsou "špehovské sloupce". Tyto sloupce nazýváme tak, protože se vydávají za kvantitativní data, ale chovají se jako kvalitativní.
Jak je můžeme rozpoznat? Očividně to závisí na povaze dat, která analyzujete, ale většinou takové sloupce mohou mít málo unikátních hodnot (v rozmezí 3-10 unikátních hodnot).
print(df_numerical.nunique())Poté, co určíme špehovské sloupce, je přesuneme z kvantitativních dat do kvalitativních:
spy_columns = df_numerical[['sloupec1', 'sloupec2', 'sloupec3']]#vyberte špehovské sloupce a zapište je do samostatného dataframe
df_numerical.drop(labels=['sloupec1', 'sloupec2', 'sloupec3'], axis=1, inplace = True)#vyjměte tyto sloupce z kvantitativních dat
df_categorical.insert(1, 'sloupec1', spy_columns['sloupec1']) #přidejte první špehovský sloupec do kvalitativních dat
df_categorical.insert(1, 'sloupec2', spy_columns['sloupec2']) #přidejte druhý špehovský sloupec do kvalitativních dat
df_categorical.insert(1, 'sloupec3', spy_columns['sloupec3']) #přidejte třetí špehovský sloupec do kvalitativních dat
Nakonec jsme zcela oddělili kvantitativní data od kvalitativních a nyní s nimi můžeme pořádně pracovat. Nejprve je třeba pochopit, kde máme prázdné hodnoty (NaN, a v některých případech bude 0 považováno za prázdnou hodnotu).
for i in df_numerical.columns:
    print(i, df[i][df[i]==0].count())
V této fázi je důležité pochopit, v jakých sloupcích mohou nuly znamenat chybějící hodnoty: souvisí to s tím, jak byla data sbírána? Nebo to může být spojeno s hodnotami dat? Na tyto otázky je třeba odpovědět v každém jednotlivém případě.
Takže pokud jsme se rozhodli, že data mohou chybět tam, kde jsou nuly, měli bychom nuly nahradit NaN, aby bylo snazší potom pracovat s těmito ztracenými daty:
df_numerical[["sloupec 1", "sloupec 2"]] = df_numerical[["sloupec 1", "sloupec 2"]].replace(0, nan)Nyní se podíváme, kde máme chybějící data:
sns.heatmap(df_numerical.isnull(),yticklabels=False,cbar=False,cmap='viridis') # Můžete také použít df_numerical.info() 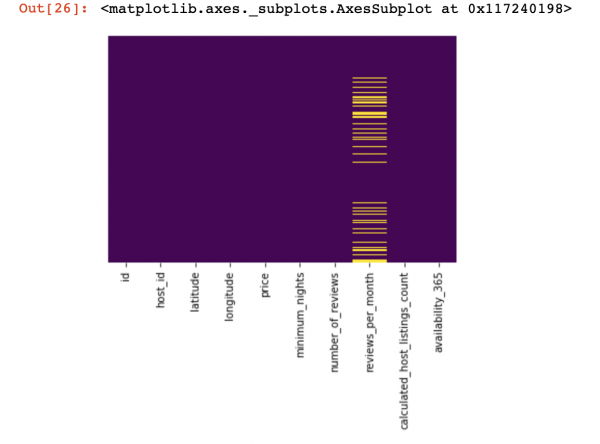
Zde by měly být žlutě označeny ty hodnoty uvnitř sloupců, které chybí. A teď přichází to nejzajímavější — jak se chovat k těmto hodnotám? Smazat řádky s těmito hodnotami nebo sloupce? Nebo vyplnit tyto prázdné hodnoty jinými?
Tady je přibližný plán, který vám může pomoci rozhodnout, co se vůbec dá s prázdnými hodnotami udělat:
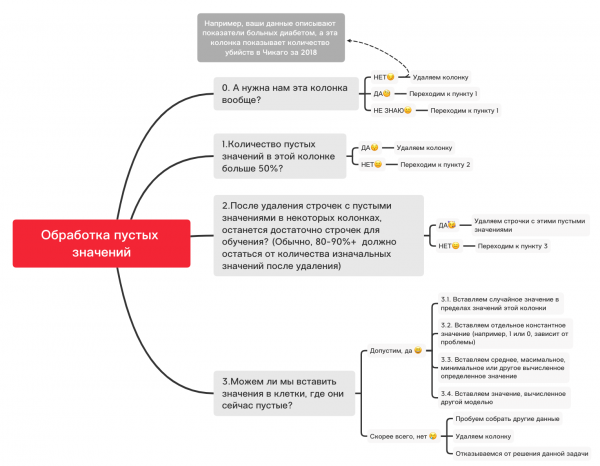
0. Odstraníme nepotřebné sloupce
df_numerical.drop(labels=["sloupec1","sloupec2"], axis=1, inplace=True)1. Je počet prázdných hodnot v tomto sloupci vyšší než 50 %?
print(df_numerical.isnull().sum() / df_numerical.shape[0] * 100)df_numerical.drop(labels=["sloupec1","sloupec2"], axis=1, inplace=True)#Odstraňujeme, pokud nějaký sloupec má více než 50 prázdných hodnot2. Odstraňujeme řádky s prázdnými hodnotami
df_numerical.dropna(inplace=True)#Odstraníme řádky s prázdnými hodnotami, pokud zůstanou dostatečné údaje pro učení3.1. Vložíme náhodnou hodnotu
import random #importujeme random
df_numerical["sloupec"].fillna(lambda x: random.choice(df[df[column] != np.nan]["sloupec"]), inplace=True) #vložíme náhodné hodnoty do prázdných buněk tabulky
3.2. Vložíme konstantní hodnotu
from sklearn.impute import SimpleImputer #importujeme SimpleImputer, který pomůže vložit hodnoty
imputer = SimpleImputer(strategy='constant', fill_value="") #vložíme určitou hodnotu pomocí SimpleImputer
df_numerical[["nový_sloupec1",'nový_sloupec2','nový_sloupec3']] = imputer.fit_transform(df_numerical[['sloupec1', 'sloupec2', 'sloupec3']]) #Aplikujeme to pro naši tabulku
df_numerical.drop(labels = ["sloupec1","sloupec2","sloupec3"], axis = 1, inplace = True) #Odstraníme sloupce se starými hodnotami
3.3. Vložíme průměrnou nebo nejčastější hodnotu
from sklearn.impute import SimpleImputer #importujeme SimpleImputer, který pomůže vložit hodnoty
imputer = SimpleImputer(strategy='mean', missing_values = np.nan) #místo mean lze také použít most_frequent
df_numerical[["nový_sloupec1",'nový_sloupec2','nový_sloupec3']] = imputer.fit_transform(df_numerical[['sloupec1', 'sloupec2', 'sloupec3']]) #Aplikujeme to pro naši tabulku
df_numerical.drop(labels = ["sloupec1","sloupec2","sloupec3"], axis = 1, inplace = True) #Odstraníme sloupce se starými hodnotami
3.4. Vložíme hodnotu, kterou vypočítal jiný model
Někdy lze hodnoty vypočítat pomocí regresních modelů, při použití modelů z knihovny sklearn nebo jiných podobných knihoven. Náš tým věnuje samostatný článek tomu, jak to lze provést v blízké budoucnosti.
Takže zatím bude vyprávění o kvantitativních datech přerušeno, protože existuje mnoho dalších nuancí o tom, jak nejlépe provádět data přípravu a předzpracování pro různé úlohy, a základní věci pro kvantitativní data byly vzaty v úvahu v tomto článku, a teď je nejvyšší čas vrátit se ke kvalitativním datům, která jsme oddělili před několika kroky od kvantitativních. Můžete upravit tento notebook podle svých potřeb, abyste proces datového předzpracování urychlili!
Kvalitativní data
Hlavně pro kvalitativní data se používá metoda One-hot-encoding, aby je formátovala z řetězce (nebo objektu) na číslo. Než se posuneme k této části, využijeme schéma a kód výše, abychom se vyrovnali s prázdnými hodnotami.
df_categorical.nunique()sns.heatmap(df_categorical.isnull(), yticklabels=False, cbar=False, cmap='viridis') 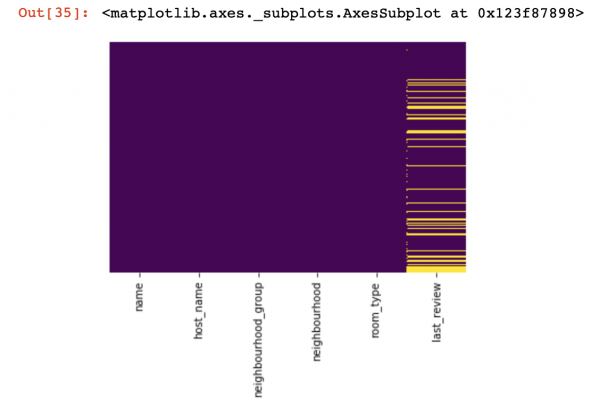
0. Odstraníme nepotřebné sloupce
df_categorical.drop(labels=["sloupec1", "sloupec2"], axis=1, inplace=True)1. Je počet prázdných hodnot v tomto sloupci vyšší než 50 %?
print(df_categorical.isnull().sum() / df_numerical.shape[0] * 100)df_categorical.drop(labels=["sloupec1", "sloupec2"], axis=1, inplace=True) # Odstraňujeme, pokud některý sloupec
# má více než 50% prázdných hodnot2. Odstraňujeme řádky s prázdnými hodnotami
df_categorical.dropna(inplace=True) # Odstraníme řádky s prázdnými hodnotami,
                                   # pokud pak zbude dostatek dat pro trénink
3.1. Vložíme náhodnou hodnotu
import random
df_categorical["sloupec"].fillna(lambda x: random.choice(df[df[column] != np.nan]["sloupec"]), inplace=True)
3.2. Vložíme konstantní hodnotu
from sklearn.impute import SimpleImputer
imputer = SimpleImputer(strategy='constant', fill_value="")
df_categorical[["nový_sloupec1", 'nový_sloupec2', 'nový_sloupec3']] = imputer.fit_transform(df_categorical[['sloupec1', 'sloupec2', 'sloupec3']])
df_categorical.drop(labels=["sloupec1", "sloupec2", "sloupec3"], axis=1, inplace=True)
Tak jsme se konečně popasovali s prázdnými hodnotami v kvalitativních datech. Teď je čas provést one-hot-encoding pro hodnoty, které jsou ve vaší databázi. Tato metoda je velmi často používána, aby váš algoritmus mohl trénovat s ohledem na kvalitativní data.
def encode_and_bind(original_dataframe, feature_to_encode):
    dummies = pd.get_dummies(original_dataframe[[feature_to_encode]])
    res = pd.concat([original_dataframe, dummies], axis=1)
    res = res.drop([feature_to_encode], axis=1)
    return(res)
features_to_encode = ["sloupec1", "sloupec2", "sloupec3"]
for feature in features_to_encode:
df_categorical = encode_and_bind(df_categorical, feature)Tak jsme konečně dokončili zpracování kvalitativních a kvantitativních dat zvlášť — čas je spojit zpátky dohromady
new_df = pd.concat([df_numerical, df_categorical], axis=1)Po spojení datasetů do jednoho můžeme na závěr použít transformaci dat pomocí MinMaxScaler z knihovny sklearn. To naše hodnoty umístí do rozsahu od 0 do 1, což pomůže při trénování modelu v budoucnu.
from sklearn.preprocessing import MinMaxScaler
min_max_scaler = MinMaxScaler()
new_df = min_max_scaler.fit_transform(new_df)
Tato data jsou nyní připravena na vše — na neuronové sítě, standardní ML algoritmy atd!
V tomto článku jsme nezahrnuli práci s daty týkajícími se časových řad, protože pro tato data by měly být použity poněkud odlišné techniky zpracování v závislosti na Vašem úkolu. V budoucnu se náš tým této problematice věnuje v samostatném článku a doufáme, že přinese do Vašeho života něco zajímavého, nového a užitečného, stejně jako tento článek.
Zdroj: habr.com
