

Monitorování se stalo velmi důležitou součástí rostoucích cloudových řešení s rostoucí složitostí distribuovaných systémů. Je nezbytné pro pochopení jejich chování. Jsou potřeba škálovatelné nástroje, které dokážou sbírat data ze všech služeb — a poskytnout specialistům jednotné rozhraní s analýzou výkonu, zobrazením chyb, dostupností a žurnály.
Tyto nástroje musí být také efektivní a výkonné. V tomto článku se podíváme na dvě populární technologie: EFK (Elasticsearch) a PLG (Loki) a vysvětlíme jejich architektury a rozdíly.
EFK stack
Možná jste již slyšeli o velmi populárním ELK nebo EFK. Tento stack se skládá z několika samostatných částí: Elasticsearch (objektové úložiště), Logstash nebo FluentD (sběr a agregace žurnálů) a Kibana pro vizualizaci.
Typická schéma práce vypadá takto:
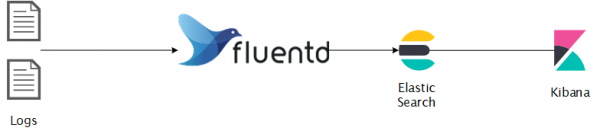
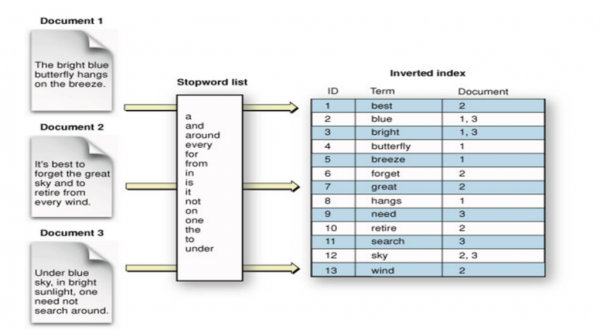
Elasticsearch — distribuované objektové úložiště s vyhledáváním a analýzou v reálném čase. Skvělé řešení pro částečně strukturovaná data, například žurnály. Informace jsou uchovávány ve formě JSON dokumentů, indexovány v reálném čase a distribuovány mezi uzly clusteru. Používá se inverzní index, který obsahuje všechna unikátní slova a s nimi související dokumenty pro fulltextové vyhledávání, které je založeno na vyhledávacím enginu Apache Lucene.
FluentD — je sběrač dat, který provádí unifikaci dat při jejich sběru a využívání. Snaží se co nejvíce uspořádat data do JSON formátu. Jeho architektura je rozšiřitelná, existuje více než , která podporuje komunita, na všechny případy použitelné.
Kibana — nástroj pro vizualizaci dat pro Elasticsearch s různými dalšími funkcemi, například analýzou časových řad, grafy, strojovým učením a dalšími.
Architektura Elasticsearch
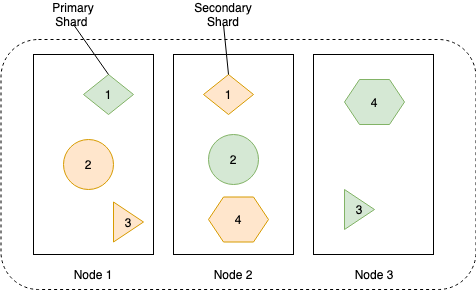
Data clusteru Elasticsearch jsou uložena rozptýlená po všech jeho uzlech. Cluster se skládá z několika uzlů pro zlepšení dostupnosti a odolnosti. Každý uzel může vykonávat všechny role clusteru, ale v rozsáhlých a škálovatelných nasazeních jsou uzlům obvykle přidělovány specifické úkoly.
Typy uzlů clusteru:
- master node — spravuje cluster, potřeba minimálně tři, jeden je vždy aktivní;
- data node — uchovává indexovaná data a provádí s nimi různé úkoly;
- ingest node — organizuje potrubí pro transformaci dat před indexací;
- coordinating node — směrování dotazů, zkracování fáze zpracování vyhledávání, koordinace hromadné indexace;
- alerting node — spouštění úloh pro upozornění;
- machine learning node — zpracování úloh strojového učení.
Na níže uvedeném diagramu je znázorněno, jak jsou data ukládána a replikována mezi uzly pro zajištění vyšší dostupnosti dat.
Data každé repliky jsou uložena v invertovaném indexu, schéma níže ukazuje, jak se to děje:
Instalace
Podrobnosti si můžete prohlédnout , budu používat helm chart:
$ helm install efk-stack stable/elastic-stack --set logstash.enabled=false --set fluentd.enabled=true --set fluentd-elasticsPLG stack
Není divu, pokud tento akronym nemůžete najít, protože je více známý jako Grafana Loki. Tento stack se každopádně stává populárním, protože využívá dobře promyšlená technická řešení. Možná už jste slyšeli o Grafaně, populárním nástroji pro vizualizaci. Její tvůrci, inspirováni Prometheem, vyvinuli Loki, horizontálně škálovatelný vysoce výkonný systém pro agregaci logů. Loki indexuje pouze metadata, nikoli samotné logy, což mu umožnilo být snadno použitelným a ekonomicky výhodným řešením.
Promtail — agent pro odesílání logů z operačního systému do clusteru Loki. Grafana — nástroj pro vizualizaci založený na datech z Loki.
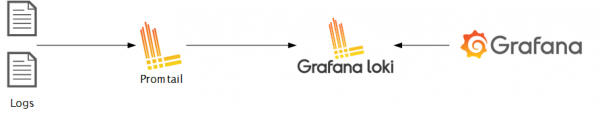
Loki je postaven na stejných principech jako Prometheus, a proto je dobře přizpůsoben pro uchování a analýzu logů Kubernetes.
Architektura Loki
Loki může být spuštěn jak v režimu jednoho procesu, tak v režimu několika procesů, což zajišťuje horizontální škálování.
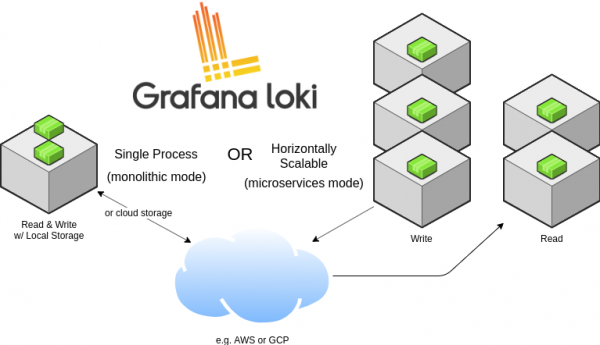
Může také fungovat jak v režimu monolitické aplikace, tak jako mikroslužba. Spuštění jako jednoho procesu může být užitečné pro místní vývoj nebo pro malé monitorování. Pro průmyslové nasazení a škálovatelné zatížení se doporučuje použít variantu mikroslužby. Cesty pro zápis a čtení dat jsou odděleny, takže je možné ho dostatečně jemně nastavit a škálovat podle potřeby.
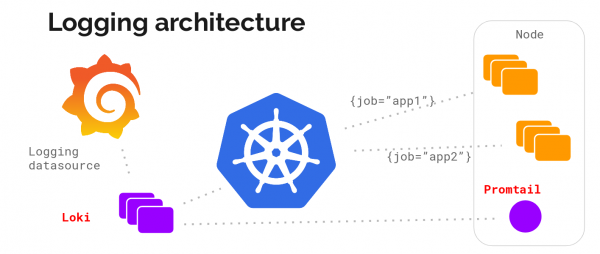
Podívejme se na architekturu systému sběru logů bez podrobností:
A zde — popis (mikroslužbová architektura):
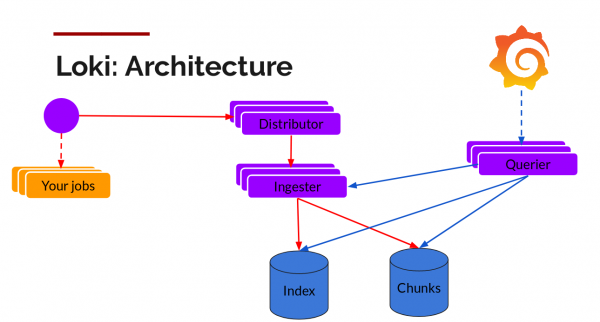
Složky:
Promtail — agent, který je instalován na uzlových počítačích (ve formě sady služeb), shromažďuje protokoly z úloh a volá API Kubernetes k získání metadat, kterými budou protokoly označeny. Poté odesílá protokol na hlavní službu Loki. Pro porovnání metadat platí stejná pravidla pro označování jako v Prometheu.
Distributor — služba distribuování, fungující jako buffer. Pro zpracování milionů záznamů zabalí příchozí data a komprimuje je po blocích, jak přicházejí. Současně pracuje několik příjemců dat, ale protokoly patřící jednomu toku příchozích dat musí být vždy v jednom z nich pro všechny jeho bloky. Je to uspořádáno jako kruh přijímačů a sekvenční hashování. Pro odolnost vůči chybám a redundantnost se to provádí n-krát (3, pokud není nastavena jinak).
Ingester — služba příjemce. Bloky dat přicházejí komprimované spolu s přidanými protokoly. Jakmile je blok dostatečně velký, dojde k jeho uložení do databáze. Metadata jdou do indexu a data z bloku s protokolem končí v Chunks (obvykle se jedná o objektové úložiště). Po uložení příjemce vytvoří nový blok, do kterého budou přidávány nové záznamy.
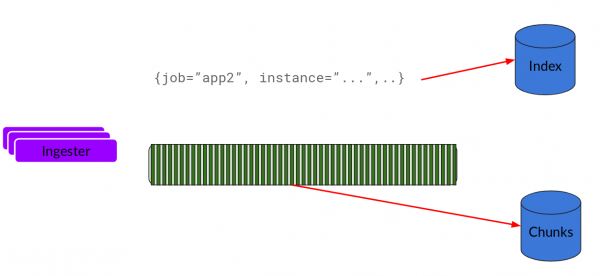
Index — databáze, DynamoDB, Cassandra, Google BigTable a další.
Chunks — bloky protokolů v komprimované podobě, obvykle uložené v objektovém úložišti, například S3.
Querier — čtecí cesta, která vykonává veškerou černou práci. Sleduje časové intervaly a značky, poté prohledává index za účelem nalezení shod. Následně čte bloky dat a filtruje je pro dosažení výsledku.
A nyní se podívejme na vše v akci.
Instalace
Pro instalaci do Kubernetes je nejjednodušší použít helm. Předpokládáme, že jste jej již nainstalovali a nastavili ( pozn. překladatele)
Přidáme repozitář a nainstalujeme stack.
$ helm repo add loki https://grafana.github.io/loki/charts
$ helm repo update
$ helm upgrade --install loki loki/loki-stack --set grafana.enabled=true,prometheus.enabled=true,prometheus.alertmanager.persistentVolume.enabled=false,prometheus.server.persistentVolume.enabled=false
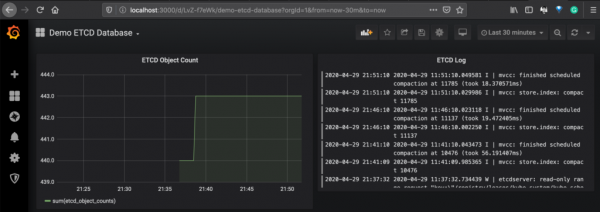
Níže je uveden příklad řídicího panelu, na kterém jsou zobrazeny údaje z Prometheu pro metriky Etcd a Loki pro protokoly podů Etcd.
A nyní proberme architekturu obou systémů a porovnejme jejich možnosti.
Porovnání
Dotazovací jazyk
V Elasticsearch se používá Query DSL a Lucene query language, které umožňují fulltextové vyhledávání. Je to zavedený výkonný vyhledávací engine s širokou podporou operátorů. S jeho pomocí lze vyhledávat na základě kontextu a třídit podle relevance.
Na druhé straně ringu je LogQL, používaný v Loki, nástupce PromQL (Prometheus query language). Využívá štítky protokolů k filtrování a výběru dat protokolů. Je možné použít některé operátory a aritmetiku, jak je popsáno , ale v možnostech zaostává za Elastic language.
Vzhledem k tomu, že dotazy v Loki jsou spojeny se štítky, je snadné je asociovat s metrikami, což usnadňuje organizaci operačního monitorování.
Škálovatelnost
Oba stacky jsou horizontálně škálovatelné, ale s Loki je to jednodušší, protože má oddělené cesty pro čtení a zápis dat a také mikroservisní architekturu. Loki může být přizpůsoben vašim potřebám a může být použit pro velmi velké objemy dat protokolů.
Multi-tenancy
Multi-tenancy klastru je společné téma pro zkrácení OPEX a oba stacky zajišťují multi-tenancy. Pro Elasticsearch existuje několik rozdělení klientů: samostatný index pro každého klienta, směrování na základě klienta, unikátní pole klienta, vyhledávací filtry. V Loki existuje ve formě hlavičky HTTP X-Scope-OrgID.
Náklady
Loki je velmi ekonomicky efektivní, protože neindexuje data, pouze metadata. Tímto se dosahuje a paměti (cache), protože objektové úložiště je levnější než blokové, které se používá v klastrech Elasticsearch.
Závěr
Stack EFK může být využit pro různé účely, což zajišťuje maximální flexibilitu a multifunkční rozhraní Kibana pro analýzu, vizualizaci a dotazy. Může být navíc vylepšen funkcemi strojového učení.
Stack Loki je užitečný v ekosystému Kubernetes díky mechanismu pro objevování metadat. Je snadné přiřadit data pro monitorování založené na časových řadách v Grafana a protokolech.
Pokud jde o náklady a dlouhodobé uchovávání protokolů, Loki je skvělou volbou pro vstup do cloudových řešení.
Na trhu je mnoho alternativ — některé mohou být lepší pro vás. Například pro GKE existuje integrace Stackdriver, která poskytuje skvělé řešení pro monitorování. Nezařadili jsme je do našeho hodnocení v tomto článku.
Odkazy:
Článek byl přeložen a připraven pro Habr zaměstnanci — intenzivní kurzy, video školení a firemní školení od praktikujících odborníků (Kubernetes, DevOps, Docker, Ansible, Ceph, SRE, Agile)
Zdroj: habr.com
