

Úvod
Ahoj!
V tomto článku se podělím o zkušenosti s návrhem mikroslužbové architektury pro projekt využívající neuronové sítě.
Povíme si o požadavcích na architekturu, podíváme se na různé strukturální diagramy, podrobně prozkoumáme jednotlivé komponenty hotové architektury a posoudíme technické metriky řešení.
Příjemné čtení!
Několik slov o úloze a jejím řešení
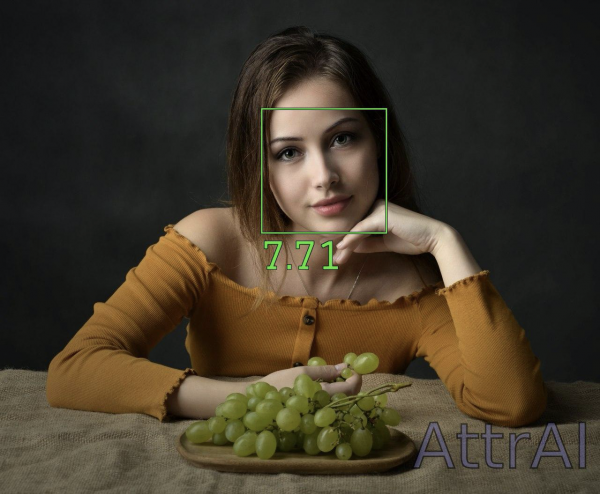
Hlavní myšlenka spočívá v tom, že na základě fotografie poskytneme hodnocení atraktivity člověka na desetibodové škále.
V tomto článku se odchýlíme od popisu jak používaných neuronových sítí, tak procesu přípravy dat a učení. Nicméně, v jedné z dalších publikací se určitě vrátíme k podrobnějšímu zkoumání pipeline hodnocení.
Teď se projdeme po pipeline hodnocení z vyššího pohledu, přičemž se zaměříme na interakci mikroslužeb v kontextu celkové architektury projektu.
Při práci na pipeline hodnocení atraktivity byla úloha rozdělena na následující složky:
- Detekce obličejů na fotografiích
- Hodnocení každého z obličejů
- Renderování výsledku
První úkol je řešen pomocí předtrénovaného . Pro druhý úkol byla naučena konvoluční neuronová síť na PyTorch, kde byl použit jako backbone – z pohledu „kvalita / rychlost inferování na CPU“
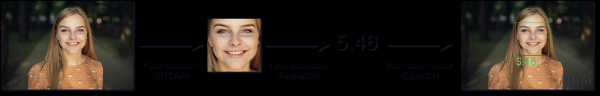
Funkční diagram pipeline hodnocení
Analýza požadavků na architekturu projektu
V životním cyklu projektu jsou fáze práce na architektuře a automatizaci nasazení modelu často jedny z nejvíce časově a zdrojově náročných.
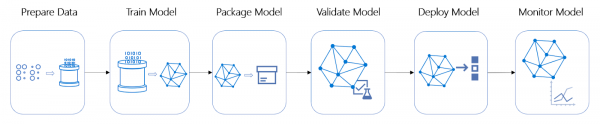
Životní cyklus ML projektu
Tento projekt není výjimkou – bylo rozhodnuto zabalit pipeline hodnocení do online služby, k tomu bylo potřeba proniknout do architektury. Byly stanoveny následující základní požadavky:
- Jednotné úložiště logů – všechny služby by měly zapisovat logy na jedno místo, aby bylo snadné je analyzovat
- Možnost horizontálního škálování služby hodnocení – jakožto nejpravděpodobnějšího bottlenecku
- Pro hodnocení každého obrázku by mělo být vyčleněno stejné množství procesorových zdrojů – aby nedocházelo k výkyvům v rozložení času na inferenci
- Rychlé (pře)nasazení jak konkrétních služeb, tak stacku jako celku
- Možnost využívat společné objekty v různých službách, pokud je to potřeba.
Architektura
Po analýze požadavků se ukázalo, že mikroslužbová architektura se hodí prakticky ideálně.
Abychom se zbavili zbytečných starostí, byl jako front-end zvolen Telegram API.
Nejprve se podíváme na strukturální diagram hotové architektury, poté přejdeme k popisu jednotlivých komponentů a formalizujeme proces úspěšného zpracování obrazu.
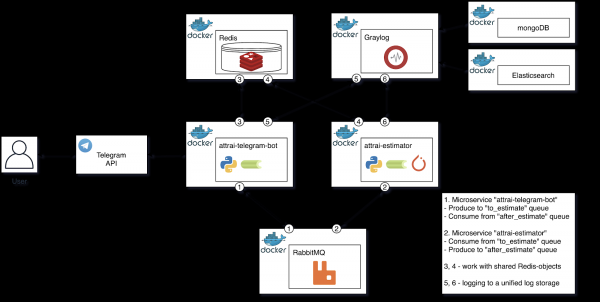
Strukturální diagram hotové architektury
Podívejme se podrobněji na jednotlivé komponenty diagramu a určíme jejich Single Responsibility při hodnocení obrazu.
Mikroslužba „attrai-telegram-bot“
Tato mikroslužba encapsuluje veškeré interakce s Telegram API. Můžeme vymezit dva hlavní scénáře – práci s uživatelským obrazem a práci s výsledkem pipeline hodnocení. Prozkoumáme oba scénáře v obecném smyslu.
Při přijímání uživatelské zprávy s obrazem:
- Probíhá filtrování, které se skládá z následujících kontrol:
- Existence optimální velikosti obrazu
- Počtu obrazů uživatele, které již čekají ve frontě
- Pokud obraz úspěšně projde předběžným filtrem, je uložen do docker volume.
- Do fronty „to_estimate“ se produkuje úkol, ve kterém, mimo jiné, figurují cesta k obrazu uloženému v našem volume.
- Pokud výše uvedené kroky proběhnou úspěšně – uživateli bude zaslána zpráva s přibližnou dobou zpracování obrazu, která se vypočítává na základě počtu úkolů ve frontě. V případě chyby bude uživatel jasně informován – zasláním zprávy s informacemi o tom, co mohlo zklamat.
Tato mikroslužba funguje také jako celery worker, který naslouchá frontě „after_estimate“, určené pro úkoly, které prošly pipeline hodnocení.
Při přijímání nového úkolu z „after_estimate“:
- Pokud byl obraz úspěšně zpracován – odešleme výsledek uživateli, pokud ne – informujeme o chybě.
- Odstraníme obraz, který je výsledkem pipeline hodnocení.
Mikroslužba hodnocení „attrai-estimator“
Tato mikroslužba je celery worker a encapsuluje všechno, co souvisí s pipeline hodnocení obrazu. Algoritmus zde funguje pouze jeden – prozkoumejme jej.
Při přijímání nového úkolu z „to_estimate“:
- Procházíme obrázek hodnoticím pipeline:
- Nahráváme obrázek do paměti
- Přizpůsobujeme obrázek na požadovanou velikost
- Vyhledáváme všechny tváře (MTCNN)
- Hodnotíme všechny tváře (zabalíme tváře nalezené v předchozím kroku do dávky a provedeme inferenci pomocí ResNet34)
- Renderujeme konečný obrázek
- Kreslíme bounding boxy
- Kreslíme hodnocení
- Odstraňujeme uživatelský (původní) obrázek
- Ukládáme výstup z hodnoticího pipeline
- Vkládáme úlohu do fronty 'after_estimate', kterou sleduje dříve zmíněná mikroservis 'attrai-telegram-bot'
Graylog (+ mongoDB + Elasticsearch)
— je to řešení pro centralizované řízení logů. V tomto projektu byl používán k jeho primárnímu účelu.
Volba padla právě na něj, a ne na všem obvyklý stack, kvůli pohodlí práce s ním z Pythonu. Všechno, co potřebujete udělat pro logování do Graylog, je přidat GELFTCPHandler z balíčku k ostatním root logger handlerům naší python mikroservisu.
Já, jako člověk, který dříve pracoval pouze s ELK stackem, jsem celkově měl pozitivní zkušenost během práce s Graylog. Jediná věc, která mě zklamala – převaha funkcí Kibany nad webovým rozhraním Graylog.
RabbitMQ
— je to zprostředkovatel zpráv založený na protokolu AMQP.
V tomto projektu byl používán jako zprostředkovatel pro Celery a fungoval v durable režimu.
Redis
— je to NoSQL databáze, která pracuje se strukturami dat typu 'klíč — hodnota'
Někdy je potřeba používat v různých python mikroservisech společné objekty, které implementují nějaké datové struktury.
Například v Redis se uchovává hashmapa typu 'telegram_user_id => počet aktivních úloh ve frontě', což umožňuje omezit počet požadavků od jednoho uživatele na určitou hodnotu, čímž se zabrání DoS útokům.
Formalizujeme proces úspěšného zpracování obrázku
- Uživatel odešle obrázek do Telegram bota
- 'attrai-telegram-bot' přijímá zprávu od Telegram API a analyzuje ji
- Úloha s obrázkem se přidává do asynchronní fronty 'to_estimate'
- Uživatel dostává zprávu s plánovaným časem hodnocení
- 'attrai-estimator' bere úlohu z fronty 'to_estimate', prochází ji hodnoticím pipeline a produkuje úlohu do fronty 'after_estimate'
- 'attrai-telegram-bot', který sleduje frontu 'after_estimate', posílá výsledek uživateli
DevOps
A konečně, po přehledu architektury, se můžeme přesunout k neméně zajímavé části — DevOps
Docker Swarm
— systém pro clustering, jehož funkce jsou integrovány přímo v Docker Engine a jsou dostupné ihned po instalaci.
Pomocí „roje“ můžeme rozdělit všechny uzly našeho clusteru na 2 typy – worker a manager. Na strojích prvního typu se nasazují skupiny kontejnerů (stacky), stroje druhého typu zajišťují škálování, vyvažování a . Managery jsou obvykle také workery.
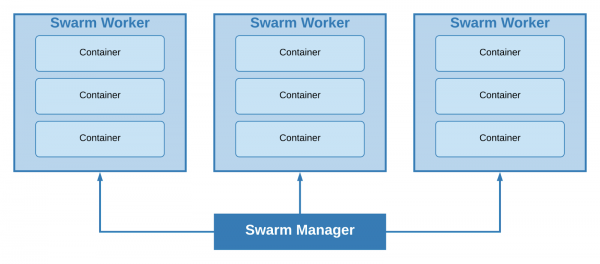
Cluster s jedním leader managerem a třemi workery
Minimální možná velikost clusteru je 1 uzel, který bude sloužit zároveň jako leader manager a worker. Vzhledem k velikosti projektu a minimálním požadavkům na odolnost vůči chybám byla přijata rozhodnutí použít právě tento přístup.
Předbíhaje události, mohu říct, že od první produkční dodávky, která proběhla v polovině června, nebyly žádné problémy spojené s touto organizací clusteru (ale to neznamená, že taková organizace je jakýmkoli způsobem přijatelná pro středně velké a velké projekty, na které se vztahují požadavky na odolnost vůči chybám).
Docker Stack
V režimu „roje“ za nasazení stacků (sady docker služeb) zodpovídá
Podporuje docker-compose konfigurace a umožňuje použít další parametry pro nasazení.
Například pomocí těchto parametrů byly omezeny zdroje na každou instanci mikroslužby hodnocení (vyčlenili jsme N jader na N instancí, v samotné mikroslužbě omezujeme počet jader, která používá PyTorch, na jedno)
attrai_estimator:
  image: 'erqups/attrai_estimator:1.2'
  deploy:
    replicas: 4
    resources:
      limits:
        cpus: '4'
    restart_policy:
      condition: on-failure
      …
Je důležité poznamenat, že Redis, RabbitMQ a Graylog jsou stateful služby a jejich škálování není tak jednoduché jako u „attrai-estimator“
Odpovídám předem na otázku — proč ne Kubernetes?
Zdá se, že použití Kubernetes v projektech malého a středního rozsahu je přítěží, všechny potřebné funkce lze získat od Docker Swarm, který je poměrně uživatelsky přívětivý jako orchestrátor kontejnerů a má také nízký práh vstupu.
Infrastruktura
Všechno to bylo nasazeno na VDS s následujícími specifikacemi:
- CPU: 4 jádra Intel® Xeon® Gold 5120 CPU @ 2.20GHz
- RAM: 8 GB
- SSD: 160 GB
Po lokálním zátěžovém testování se zdálo, že při výrazném nárůstu uživatelů bude této mašinky akorát.
Ale hned po nasazení jsem sdílel odkaz na jednu z nejpopulárnějších v SNG imageboardů (ano, tu známou), po kterém se lidé začali zajímat a během několika hodin služba úspěšně zpracovala desítky tisíc obrázků. Přitom v kritických momentech nebyly zdroje CPU a RAM ani z poloviny využity.
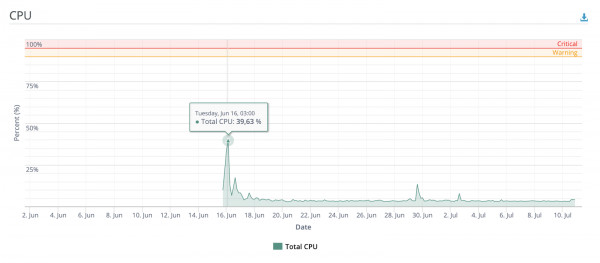
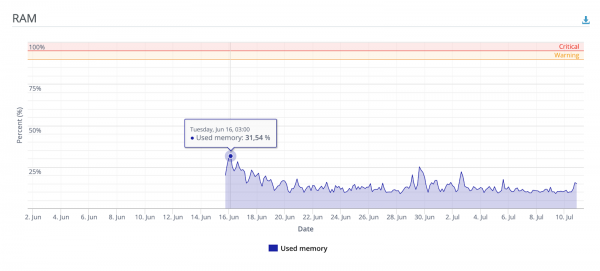
Ještě trochu grafiky
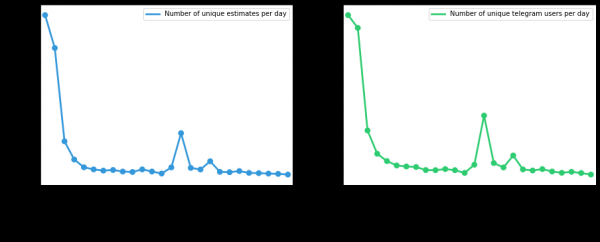
Počet unikátních uživatelů a žádostí o hodnocení od okamžiku nasazení, v závislosti na dni
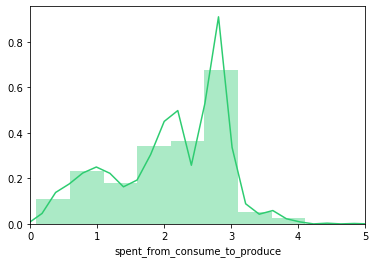
Rozdělení času inferenčního pipeline hodnocení
Závěry
Ve zkratce mohu říci, že architektura a přístup k orchestrace kontejnerů se plně osvědčily – i v nejvíce zatížených momentech nedošlo k poklesům a zpožděním v době zpracování.
Myslím, že projekty malého a středního rozsahu, které ve svém procesu používají reálný čas inferenci neuronových sítí na CPU, mohou úspěšně převzít praktikované popsané v tomto článku.
Dodám, že původně byl článek delší, ale aby se nepřidávalo longread, rozhodl jsem se některé body v tomto článku vynechat – k nim se vrátíme v následujících publikacích.
Na bota si můžete zkusit kliknout na Telegramu – @AttraiBot, fungovat bude minimálně do konce podzimu 2020. Připomínám – žádná uživatelská data nejsou uložena – ani původní obrázky, ani výsledky inferenčního pipeline – vše se po zpracování vymaže.
Zdroj: habr.com
