

Dnes existuje 100500 kurzů Data Science a už je dávno známo, že nejvíce peněz v Data Science se dá vydělat právě na kurzech Data Science (proč kopat, když lze prodávat lopaty?). Hlavní nevýhodou těchto kurzů je, že nemají nic společného se skutečnou prací: nikdo vám nedá čistá, zpracovaná data ve správném formátu. A když skončíte s kurzy a začnete řešit skutečný úkol — vyvstává řada nuancí.
Proto zahajujeme sérii poznámek „Co se může pokazit s Data Science“, založenou na skutečných událostech, které se staly mně, mým přátelům a kolegům. Budeme rozebírat na reálných příkladech typické úkoly v oblasti Data Science: jak to ve skutečnosti probíhá. Dnes začneme s úkolem sběru dat.
A první věc, o kterou se lidé při práci se skutečnými daty zakopávají — je vlastně sběr těchto relevantních dat. Klíčová myšlenka tohoto článku:
Systémově podceňujeme čas, zdroje a úsilí na sběr, čištění a přípravu dat.
A především si probereme, co dělat, aby se tomu zabránilo.
Podle různých odhadů čištění, transformace, zpracování dat, feature engineering atd. zabírá 80–90 % času, zatímco analýza 10–20 %, přičemž většina vzdělávacího materiálu se zaměřuje výhradně na analýzu.
Pojďme si probrat jako typický příklad jednoduchý analytický úkol ve třech variantách a uvidíme, jaké mohou být „zhoršující okolnosti“.
A pro příklad opět zvážíme podobné varianty úkolu sběru dat a srovnání komunit pro:
- Dva subreddity Reddit
- Dvě sekce Habra
- Dvě skupiny na Odnoklassniki
Podmínkový přístup v teorii
Otevřete web a přečtěte si příklady, pokud je to jasné, vyčleňte několik hodin na čtení, několik hodin na kód podle příkladů a ladění. Přidejte několik hodin na sběr. Přidejte několik hodin navíc (vynásobte dvěma a přidejte N hodin).
Klíčový bod: časový odhad je založen na předpokladech a domněnkách o tom, kolik to zabere času.
Začít analýzu času je nutné s odhadem následujících parametrů pro podmínkový úkol, popsaný výše:
- Jaká je velikost dat a kolik je potřeba fyzicky shromáždit (*viz níže*).
- Jaký čas sběru jedné položky a kolik je potřeba čekat, než lze shromáždit druhou.
- Zahrnout kód, který uchovává stav a spouští restart, když (a ne pokud) vše selže.
- Zjistit, zda potřebujeme autorizaci, a zahrnout čas potřebný pro přístup přes API.
- Zahrnout počet chyb jako funkci složitosti dat — vyhodnotit na základě konkrétního úkolu: struktura, kolik transformací, co a jak extrahujeme.
- Zahrnout chyby sítě a problémy s nestandardním chováním projektu.
- Zhodnotit, zda potřebné funkce jsou v dokumentaci, a pokud ne, tak jak a kolik času bude potřeba pro workaround.
Nejdůležitější je, že pro hodnocení času — musíte fakticky investovat čas a úsilí do 'přípravy na boj' — jen tak bude vaše plánování adekvátní. Takže ať vás kdokoli tlačí říct 'kolik času je třeba na sběr dat' — vyžádejte si čas na předběžnou analýzu a obhajte tím, jak moc se čas bude lišit v závislosti na reálných parametrech úkolu.
A nyní ukážeme konkrétní příklady, kde se tyto parametry budou měnit.
Klíčový bod: hodnocení je založeno na analýze klíčových faktorů, které ovlivňují objem a složitost práce.
Hodnocení založené na domněnkách — je to dobrý přístup, když jsou funkční prvky dost malé a není mnoho faktorů, které by mohly zásadně ovlivnit strukturu úkolu. Ale v případě řady úkolů Data Science se takových faktorů stává nesmírně mnoho a tento přístup se stává neadekvátním.
Srovnání komunit Reddit
Začněme s tím nejjednodušším případem (jak se později ukáže). Opravu, pokud budeme upřímní, čelíme prakticky ideálnímu případu, zkontrolujeme náš checklist složitosti:
- Existuje čisté, srozumitelné a dokumentované API.
- Je extrémně jednoduché a hlavně automaticky se generuje token.
- Existuje — s množstvím příkladů.
- Komunita, která se zabývá analýzou a sběrem dat na Redditu (až po YouTube videa vysvětlující, jak používat python wrapper) .
- Potřebné metody pravděpodobně existují v API. Navíc kód vypadá kompaktně a čistě, níže je příklad funkce, která sbírá komentáře k příspěvku.
def get_comments(submission_id):
    reddit = Reddit(check_for_updates=False, user_agent=AGENT)
    submission = reddit.submission(id=submission_id)
    more_comments = submission.comments.replace_more()
    if more_comments:
        skipped_comments = sum(x.count for x in more_comments)
        logger.debug('Skipped %d MoreComments (%d comments)',
                     len(more_comments), skipped_comments)
    return submission.comments.list()
Vzato z výběr užitečných nástrojů pro obalení.
I přes to, že se zde nacházíme v nejlepším scénáři, je stále třeba zvážit několik důležitých faktorů z reálného života:
- Limity API – musíme získávat data po dávkách (čekat mezi požadavky atd.).
- Čas sběru – pro úplnou analýzu a srovnání budeme muset investovat značné množství času jen na to, aby pavouk prošel subreddit.
- Bot musí běžet na serveru – nemůžete ho jen tak spustit na notebooku, sbalit do batohu a jít na jednání. Proto jsem spustil vše na VPS. S promo kódem habrahabr10 můžete ušetřit dalších 10 % nákladů.
- Fyzická nedostupnost některých dat (jsou viditelná pouze adminům nebo se shromažďují příliš obtížně) – to je třeba zohlednit, ne všechna data je možné shromáždit v přiměřeném čase.
- Chyby v práci sítě: práce se sítí je bolest.
- To jsou živá skutečná data – nikdy nejsou čistá.
Samozřejmě je důležité zohlednit uvedené nuance ve vývoji. Konkrétní hodiny/dny závisí na vývojářské zkušenosti nebo zkušenosti s podobnými úkoly, nicméně vidíme, že zde je úkol výhradně inženýrský a nevyžaduje další úsilí pro jeho řešení – vše lze velmi dobře ocenit, naplánovat a realizovat.
Srovnání sekcí Habr
Přecházíme k zajímavějšímu a netradičnímu případu srovnání proudů a/nebo sekcí Habr.
Zkontrolujeme náš checklist složitosti – zde, abychom pochopili každý bod, už bude třeba se trochu poprat s úkolem a experimentovat.
- Nejprve si myslíte, že existuje API, ale není. Ano, Habr má API, ale je dostupné pouze adminům (a možná ani nefunguje).
- Pak začnete jednoduše parsovat HTML – "import requests", co se může pokazit?
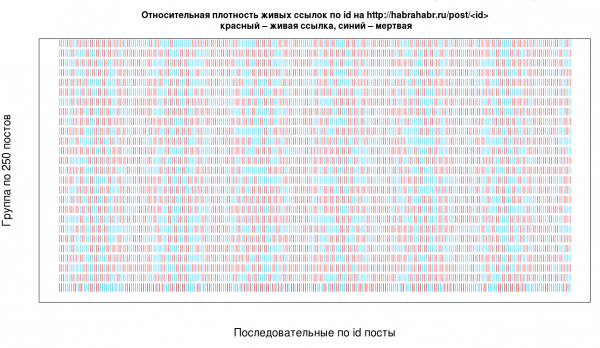
- A jak vlastně parsovat? Nejjednodušší a nejběžnější přístup je iterovat podle ID, ale nezapomeňme, že to není nejefektivnější a budeme muset zpracovávat různé případy – zde je například hustota skutečných ID mezi všemi existujícími.

Vzato z článku. - Surové údaje obalené v HTML přes síť jsou bolestí. Například, chcete shromáždit a uložit hodnocení článku: vytáhli jste score z html a rozhodli se ho uložit jako číslo pro další zpracování.
1) int(score) vyhazuje chybu: protože na Habrue mínus, například v řetězci "–5" — je to krátké pomlčka, a ne znak minus (neočekávané, že?), proto v určitém okamžiku bylo nutné oživit parser s takovým hrozným fixem.
try:
      score_txt = post.find(class_="score").text.replace(u"–","-").replace(u"+","+")
      score = int(score_txt)
      if check_date(date):
        post_score += score
Data, plusy a minusy mohou vůbec chybět (jak vidíme výše v funkci check_date, to se stalo).
2) Neescapované speciální znaky — ty přijdou, je třeba se na to připravit.
3) Struktura se mění v závislosti na typu příspěvku.
4) Staré příspěvky mohou mít **podivnou strukturu**.
- V podstatě bude třeba zpracovávání chyb a co se může nebo nemusí stát zpracovat, a nelze přesně předpovědět, co se pokazí a jaká ještě může být struktura a co kde vypadne — prostě to budete muset zkusit a zohlednit chyby, které vyhazuje parser.
- Pak si uvědomíte, že je třeba parsovat ve více vláknech, jinak parsel v jednom pak zabere 30+ hodin (to je čistě doba provádění již funkčního jednovláknového parseru, který spí a nepodléhá žádným zákazům). V článku, to vedlo v určitém okamžiku k podobnému schématu:
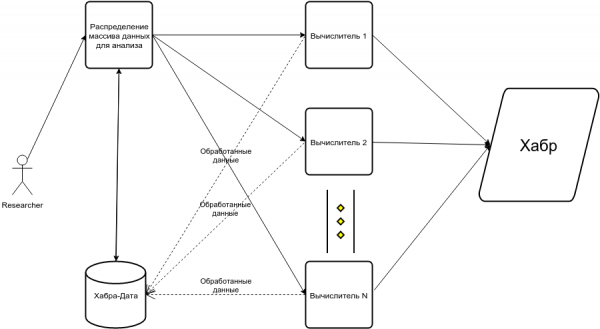
Celkově checklist podle složitosti:
- Práce se sítí a parsováním html s iterací a procházením podle ID.
- Dokumenty mají heterogenní strukturu.
- Mnoho míst, kde kód může snadno spadnout.
- Je nutné psát || kód.
- Chybí potřebná dokumentace, příklady kódu a/nebo komunita.
Podmíněné hodnocení času pro tento úkol bude 3-5krát vyšší, než pro sběr dat z Redditu.
Srovnání skupin Odnoklassniky
Přejdeme k technicky nejzajímavějšímu případu z popsaných. Pro mě byl zajímavý právě tím, že na první pohled vypadá dost triviálně, ale takovým není — jakmile do něj zapíchnete hůlkou.
Začneme s naším checklistem složitosti a poznamenáme, že mnohé z nich se ukážou být mnohem složitější, než vypadají na začátku:
- API existuje, ale téměř úplně postrádá potřebné funkce.
- K některým funkcím je třeba požádat o přístup emailem, což znamená, že udělení přístupu není okamžité.
- Je to hrozně zdokumentováno (začněme tím, že se tu mísí ruské a anglické termíny, a to naprosto nekonzistentně - občas musíte prostě hádat, co od vás kde chtějí) a navíc není vhodné pro získávání dat, například, .
- Vyžaduje dokumentaci se sezením, ale ve skutečnosti jej nepoužívá - a neexistuje žádný způsob, jak pochopit všechny nuance režimů API, kromě toho, že se prostě proklikáváte a doufáte, že něco bude fungovat.
- Chybí příklady a komunita, jediný opěrný bod při shromažďování informací - malý v pythonu (bez velkého množství příkladů použití).
- Nejvíce funkční varianta vypadá na Selenium, protože mnoho potřebných dat je uzamčeno.
1) To znamená, že se provádí autorizace přes fiktivního uživatele (a registraci ručně).2) Nicméně se Selenium nedá zaručit správného a opakovatelného fungování (minimálně v případě s ok.ru určitě).
3) Stránka ok.ru obsahuje chyby JavaScriptu a občas se chová podivně a nekonzistentně.
4) Je třeba se zabývat stránkováním, načítáním prvků atd...
5) Chyby API, které wrapper vrací, je nutné komplikovaně zpracovávat, například takto (kousek experimentálního kódu):
def get_comments(args, context, discussions):
    pause = 1
    if args.extract_comments:
        all_comments = set()
#makes sense to keep track of already processed discussions
        for discussion in tqdm(discussions):
            try:
                comments = get_comments_from_discussion_via_api(context, discussion)
            except odnoklassniki.api.OdnoklassnikiError as e:
                if "NOT_FOUND" in str(e):
                    comments = set()
                else:
                    print(e)
                    bp()
                    pass
            all_comments |= comments
            time.sleep(pause)
        return all_comments
Moje oblíbená chyba byla:
OdnoklassnikiError("Error(code: 'None', description: 'HTTP error', method: 'discussions.getComments', params: …)")6) Nakonec vypadá kombinace Selenium + API jako nejrozumnější varianta.
- Je třeba zachování stavu a restart systému, zpracování mnoha chyb, včetně nekonzistentního chování stránky - a to jsou chyby, které jsou docela obtížné si představit (pokud profesionálně nepíšete parsery, samozřejmě).
Podmínková odhadovaná doba pro tento úkol bude 3-5krát vyšší než pro shromažďování dat z Habr. I když v případě Habr používáme přímý přístup s parsováním HTML, zatímco v případě OK můžeme v kritických místech pracovat s API.
Závěry
Ať se na vás požaduje poskytnout odhad časového rámce „na místě“ (vždyť dnes máme plánování!) pro objemný modul pipeline na zpracování dat, doba provedení se prakticky nikdy nedá adekvátně posoudit bez analýzy parametrů úlohy.
Pokud mluvíme o něco filozofičtěji, strategie hodnocení v agile se poměrně dobře hodí pro inženýrské úkoly, ale s úkoly experimentálními a do určité míry „tvůrčími“ a výzkumnými, tedy méně předvídatelnými, se objevují potíže, jak ukazují příklady, které jsme zde probrali.
Samozřejmě, sběr dat je pouze jasným ilustrativním příkladem — obvykle se tato úloha zdá neuvěřitelně jednoduchá a technicky nenáročná, a právě v detailech se často skrývá ďábel. A na této úloze se ukazuje celá škála možných variant toho, co může selhat, a jak moc se může práce protáhnout.
Pokud se letmo podíváte na charakteristiky úkolu bez dalších experimentů, Reddit a O.K. vypadají podobně: existuje API, python wrapper, ale ve skutečnosti je rozdíl obrovský. Pokud to posoudíme podle těchto parametrů, parsing Habra vypadá složitěji než O.K. — a ve skutečnosti je to přesně naopak, což lze zjistit provedením jednoduchých experimentů zaměřených na analýzu parametrů úlohy.
Podle mých zkušeností je nejúčinnější přístup přibližný odhad času, který budete potřebovat na předběžnou analýzu a jednoduché první experimenty, čtení dokumentace — to vám umožní poskytnout přesný odhad pro celou práci. V termínech populární metodologie agile — prosím, vytvořte mi ticket pro „odhady parametrů úlohy“, na jehož základě mohu poskytnout odhad toho, co je možné splnit v rámci „sprintu“ a udělat přesnější odhady pro jednotlivé úkoly.
Proto se zdá být nejúčinnějším argument, ukázat „netechnickému“ specialistovi, jak moc se bude lišit čas a zdroje v závislosti na parametrech, které je ještě třeba posoudit.
Zdroj: habr.com
