

CAP teorema je základním článkem teorie distribuovaných systémů. Samozřejmě, debaty kolem ní neutichnou: definice nejsou kanonické a důkaz je přísně vzato chybí... Přesto, s pevnou vírou v zdravý selský rozum™, intuitivně chápeme, že teorema je pravdivá.
Jedna věc však není zcela jasná, a to význam písmene „P“. Když se cluster rozdělí, rozhoduje se, zda neodpoví, dokud nebude dosaženo kvóra, nebo zda poskytne dostupná data. V závislosti na výsledku tohoto rozhodnutí je systém klasifikován buď jako CP, nebo jako AP. Cassandra, například, se může chovat oběma způsoby, a to nejen v závislosti na nastavení clusteru, ale i na parametrech každého konkrétního dotazu. Ale co když systém není „P“ a rozdělí se, co se stane?
Odpověď na tuto otázku je poněkud překvapivá: CA cluster se nemůže rozdělit.
Jaký tedy je to cluster, který se nemůže rozdělit?
Nezbytným atributem takového clusteru je společný systém úložiště dat. Ve většině případů to znamená připojení přes SAN, což omezuje použití CA řešení na velké podniky, které si mohou dovolit SAN infrastrukturu. Aby několik servery mohlo pracovat se stejnými daty, je potřebný clusterový souborový systém. Takové souborové systémy jsou v portfoliích HPE (CFS), Veritas (VxCFS) a IBM (GPFS).
Oracle RAC
Možnost Real Application Cluster se poprvé objevila v roce 2001 ve verzi Oracle 9i. V takovém clusteru několik instancí serveru pracuje se stejnou databází.
Oracle může pracovat jak s clusterovým souborovým systémem, tak se svým vlastním řešením – ASM (Automatic Storage Management).
Každá instance vede svůj vlastní protokol. Transakce je provedena a zaznamenána jednou instancí. V případě selhání instance jeden z přeživších uzlů clusteru (instancí) přečte její protokol a obnoví ztracená data – tím se zajišťuje dostupnost.
Všechny instance mají svůj vlastní cache a stejné stránky (bloky) mohou být zároveň v cache několika instancí. Navíc, pokud je nějaká stránka potřebná jednou instancí a je dostupná v cache jiné instance, může ji získat od „soused“ pomocí mechanismu cache fusion, místo aby ji četla z disku.
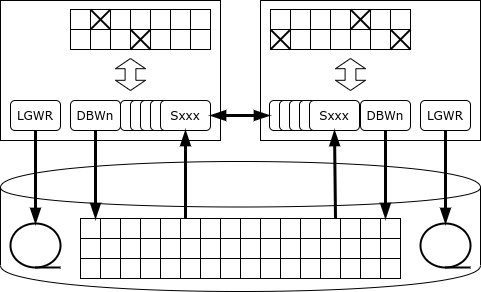
Co se ale stane, pokud jednomu z instancí bude třeba změnit data?
Vlastností Oracle je, že nemá dedikovanou službu zámků: pokud server chce zablokovat řádek, záznam o zámku se umisťuje přímo na stránku paměti, kde se nachází blokovaný řádek. Díky tomuto přístupu je Oracle šampionem v výkonu mezi monolitickými databázemi: služba zámků se nikdy nestává úzkým místem. V clusterové konfiguraci však může taková architektura vést k intenzivnímu síťovému přenosu a vzájemným zámkům.
Jakmile dojde k zablokování záznamu, instance informuje všechny ostatní instance o tom, že stránka, na které se nachází tento záznam, je obsazena v monopolním režimu. Pokud jiné instanci bude třeba změnit záznam na téže stránce, musí čekat, dokud nebudou změny na stránce zapsány, tj. informace o změně nebude zaznamenána do protokolu na disku (přitom transakce může pokračovat). Může se také stát, že stránka bude postupně měněna několika instancemi, a poté, když dojde k zápisu stránky na disk, bude nutné zjistit, u koho se nachází aktuální verze této stránky.
Náhodné aktualizace stejných stránek přes různé uzly RAC vedou k dramatickému poklesu výkonu databáze – až k tomu, že výkon clusteru může být nižší než výkon jediného instance.
Správné využití Oracle RAC spočívá ve fyzickém rozdělení dat (například pomocí mechanismu partitioned tables) a přístupu k každé sadě partitioneů přes dedikovaný uzel. Hlavním účelem RAC se stalo ne horizontální škálování, ale zajištění odolnosti proti výpadkům.
Pokud uzel přestane odpovídat na heartbeat, ten uzel, který to zjistí jako první, spustí proceduru hlasování na disku. Pokud se ani zde ztracený uzel neozve, jeden z uzlů převezme povinnosti obnovení dat:
- „zmrazí“ všechny stránky, které se nacházely v cache ztraceného uzlu;
- přečte protokoly (redo) ztraceného uzlu a znovu aplikuje změny zapsané v těchto protokolech, přičemž zároveň kontroluje, zda nemají jiné uzly novější verze měněných stránek;
- vrací neúplné transakce.
Aby se usnadnilo přepínání mezi uzly, existuje v Oracle pojem služby – virtuální instance. Instance může obsluhovat několik služeb a služba může přesouvat mezi uzly. Instance aplikace, která obsluhuje určitou část databáze (například skupinu klientů), pracuje s jednou službou, a služba, odpovědná za tuto část databáze, se při výpadku uzlu přesouvá na jiný uzel.
IBM Pure Data Systems for Transactions
Klastr řešení pro DBMS se objevilo v portfoliu Modrého Giganta v roce 2009. Ideologicky se jedná o nástupce klastru Parallel Sysplex, postaveného na „běžném“ hardwaru. V roce 2009 byl uveden produkt DB2 pureScale, který je soubor softwaru, a v roce 2012 IBM nabízí softwarově-hardwarový balíček (appliance) nazvaný Pure Data Systems for Transactions. Není třeba jej zaměňovat s Pure Data Systems for Analytics, což je nic jiného než přejmenovaný Netezza.
Architektura pureScale na první pohled připomíná Oracle RAC: stejně jako několik uzlů je připojeno k společnému systému úložiště dat a na každém uzlu běží vlastní instance DBMS se svými oblastmi paměti a transakčními žurnály. Ale na rozdíl od Oracle má DB2 vyhrazenou službu zamykání, prezentovanou sadou procesů db2LLM*. V klastrové konfiguraci je tato služba umístěna na samostatném uzlu, který se v Parallel Sysplex nazývá coupling facility (CF), a v Pure Data – PowerHA.
PowerHA poskytuje následující služby:
- správce zámků;
- globální buffer cache;
- oblast meziprocesní komunikace.
Pro přenos dat mezi PowerHA a uzly DB a zpět se používá vzdálený přístup do paměti, proto musí klastrová interkonektivita podporovat protokol RDMA. PureScale může používat jak Infiniband, tak RDMA over Ethernet.
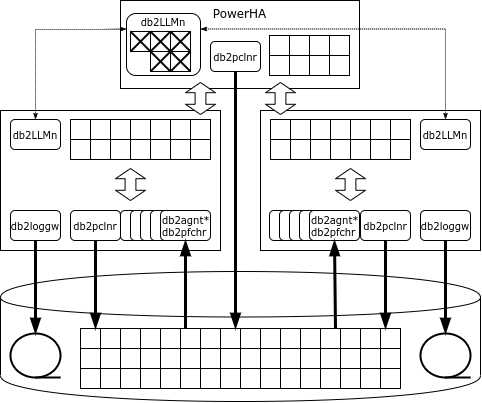
Pokud uzlu potřebuje stránku, a tato stránka není v cache, uzel požaduje stránku v globální cache, a pouze v případě, že ani tam není, ji čte z disku. Na rozdíl od Oracle se požadavek posílá pouze do PowerHA, a ne na sousední uzly.
Pokud instance zamýšlí měnit řádek, zablokuje ho výhradním způsobem a stránku, kde se řádek nachází, ve sdíleném režimu. Všechny blokace jsou zaznamenány v globálním správci blokací. Když transakce skončí, uzel odešle zprávu správci blokací, který zkopíruje změněnou stránku do globální cache, zruší blokace a zneplatní změněnou stránku v cache ostatních uzlů.
Pokud je stránka, ve které se nachází měněný řádek, už blokována, správce blokací přečte změněnou stránku z paměti uzlu, který provedl změny, zruší blokaci, zneplatní změněnou stránku v cache ostatních uzlů a vrátí blokaci stránky užlu, který o ni požádal.
"Špinavé", tedy změněné, stránky mohou být zapisovány na disk jak z běžného uzlu, tak z PowerHA (castout).
Při selhání jednoho z uzlů pureScale je obnova omezena pouze na ty transakce, které v okamžiku selhání ještě nebyly dokončeny: stránky, které byly změněny tímto uzlem v dokončených transakcích, jsou v globální cache na PowerHA. Uzel se restartuje v omezené konfiguraci na jednom ze serverů clusteru, vrátí nezkompletované transakce a uvolní blokace.
PowerHA pracuje na dvou serverech a hlavní uzel synchronně replikovává svůj stav. Při selhání hlavního uzlu PowerHA cluster pokračuje v práci s rezervním uzlem.
Samozřejmě, pokud se přistupuje k sadě dat pouze přes jeden uzel, celkový výkon clusteru bude vyšší. PureScale si dokonce může povšimnout, že určité území dat zpracovává jeden uzel, a pak všechny blokace týkající se této oblasti budou zpracovávány lokálně bez komunikace s PowerHA. Jakmile se však aplikace pokusí přistupovat k těmto datům přes jiný uzel, centralizované zpracování blokací bude obnoveno.
Interní testy IBM na zátěži sestávající z 90% čtení a 10% zápisu, což velmi připomíná reálnou průmyslovou zátěž, ukazují téměř lineární škálování až do 128 uzlů. Podmínky testování se bohužel nezveřejňují.
HPE NonStop SQL
V portfoliu společnosti Hewlett-Packard Enterprise je také vysoce dostupná platforma. Jedná se o platformu NonStop, která byla uvedena na trh v roce 1976 firmou Tandem Computers. V roce 1997 byla firma koupena společností Compaq, která se v roce 2002 spojila se společností Hewlett-Packard.
NonStop se používá pro budování kritických aplikací – například HLR nebo zpracování bankovních karet. Platforma se dodává jako softwarově-hardwarový komplex (appliance), který zahrnuje výpočetní uzly, systém pro ukládání dat a komunikační zařízení. Síť ServerNet (v moderních systémech – Infiniband) slouží jak pro komunikaci mezi uzly, tak pro přístup k systému ukládání dat.
Vraných verzích systému byly použity proprietární procesory, které byly synchronizovány navzájem: všechny operace byly vykonávány synchronně několika procesory, a jakmile došlo k chybě u jednoho z procesorů, byl odpojen, zatímco druhý pokračoval v práci. Později systém přešel na standardní procesory (nejprve MIPS, pak Itanium a nakonec x86) a pro synchronizaci byly použity jiné mechanismy:
- zprávy: každý systémový proces má dvojníka-„stín“, kterému aktivní proces pravidelně posílá zprávy o svém stavu; v případě selhání hlavního procesu začíná stínový proces pracovat od okamžiku určeného poslední zprávou;
- hlasování: systém pro ukládání dat má speciální hardwarovou komponentu, která přijímá několik stejných požadavků a provádí je pouze v případě, že se požadavky shodují; místo fyzické synchronizace procesory pracují asynchronně a výsledky jejich práce se porovnávají pouze v okamžicích vstupu/výstupu.
Od roku 1987 pracuje na platformě NonStop relační DBMS – nejprve SQL/MP a poté SQL/MX.
Celá databáze je rozdělena na části, přičemž za každou část odpovídá vlastní proces Data Access Manager (DAM). Zajišťuje zápis dat, kešování a mechanismus zámků. Zpracování dat provádějí procesy vykonavatelé (Executor Server Process), které běží na těch samých uzlech jako příslušné správce dat. Plánovač SQL/MX rozděluje úkoly mezi vykonavatele a kombinuje výsledky. Při nutnosti provádět koordinované změny se používá protokol dvoufázového potvrzení, zajišťovaný knihovnou TMF (Transaction Management Facility).
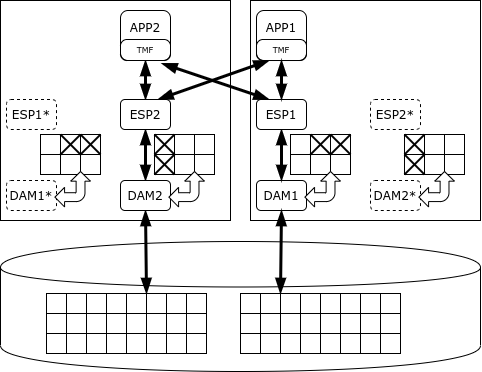
NonStop SQL umí prioritizovat procesy tak, aby dlouhé analytické dotazy nebránily vykonávání transakcí. Jeho hlavním určením je však zpracování krátkých transakcí, nikoli analytika. Vývojář zaručuje dostupnost clusteru NonStop na úrovni pěti devítek, což znamená, že prostoje činí pouze 5 minut ročně.
SAP HANA
První stabilní vydání DBMS HANA (1.0) bylo uvedeno v listopadu 2010 a balík SAP ERP přešel na HANA od května 2013. Platforma je založena na zakoupených technologiích: TREX Search Engine (vyhledávání v sloupcové databázi), DBMS P*TIME a MAX DB.
Samotné slovo "HANA" je akronym, High performance ANalytical Appliance. Tento DBMS je dodáván ve formě kódu, který může běžet na jakýchkoli serverech x86, avšak průmyslové instalace jsou povoleny pouze na certifikovaném hardwaru. Existují řešení od HP, Lenovo, Cisco, Dell, Fujitsu, Hitachi, NEC. Některé konfigurace Lenovo dokonce povolují provoz bez SAN – roli sdíleného úložiště hraje klastr GPFS na místních discích.
Na rozdíl od výše uvedených platforem je HANA DBMS v paměti, tedy primární obraz dat se uchovává v operační paměti, zatímco na disk se zapisují pouze žurnály a periodické snímky – pro obnovu v případě havárie.
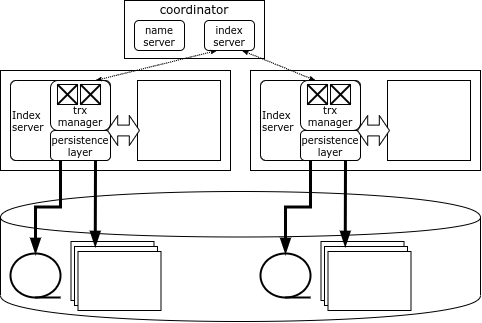
Každý uzel clusteru HANA odpovídá za svou část dat, a mapa dat se uchovává ve specializované komponentě – Name Server, který se nachází na koordinačním uzlu. Data mezi uzly se neduplikuje. Informace o zámcích se také uchovávají na každém uzlu, ale v systému existuje globální detektor vzájemných zámků.
Klient HANA při připojení k clustru načítá jeho topologii a následně se může přímo obracet na libovolný uzel v závislosti na tom, jaká data potřebuje. Pokud transakce zasahuje do dat jediného uzlu, může být provedena tímto uzlem lokálně, ale pokud se mění data několika uzlů, uzel iniciátor se obrací na uzel koordinátor, který otevírá a koordinuje distribuovanou transakci, přičemž ji zafixuje pomocí optimalizovaného protokolu dvoufázového zajištění.
Uzel koordinátor je duplikovaný, takže v případě selhání koordinátora okamžitě nastupuje záložní uzel. Pokud však selže uzel s daty, je jediným způsobem, jak získat přístup k jeho datům, restartovat uzel. Obvykle se v clusterech HANA udržuje záložní server, aby bylo možné co nejrychleji restartovat ztracený uzel.
Zdroj: habr.com
