

Hlavním cílem Patroni je zajistit vysokou dostupnost pro PostgreSQL. Ale Patroni je jen šablona, nikoli hotový nástroj (což je ostatně uvedeno v dokumentaci). Na první pohled, když nastavíte Patroni v testovacím prostředí, můžete vidět, jaký je to skvělý nástroj a jak snadno zvládá naše pokusy o rozpad klastru. Nicméně v praxi v produkčním prostředí se to vždy neděje tak krásně a elegantně jako v testovací laboratoři.
Trochu o sobě. Začínal jsem jako systémový administrátor. Pracoval jsem ve webovém vývoji. Od roku 2014 pracuji ve společnosti Data Egret. Firma se zabývá poradenstvím v oblasti Postgres. A my se specializujeme přímo na Postgres a každý den s ním pracujeme, takže máme různou odbornost spojenou s jeho provozem.
Na konci roku 2018 jsme začali pomalu používat Patroni. Nasbírali jsme určité zkušenosti. Nějak jsme ho diagnostikovali, vyladili, dospěli jsme k vlastním osvědčeným postupům. A v této prezentaci o nich budu vyprávět.
Kromě Postgresu mám rád Linux. Rád v něm kutím a prozkoumávám, rád sestavuji jádra. Zajímám se o virtualizaci, kontejnery, Docker, Kubernetes. Zaujímá mě to, protože se projevují staré administrátorské zvyky. Rád se zabývám monitorováním. A mám rád postgresové věci spojené s administrací, jako je replikace, zálohování. A ve volném čase píšu v Go. Nejsem softwarový inženýr, jen si pro sebe píšu v Go. A dělá mi to radost.
- Myslím, že mnozí z vás ví, že v Postgresu není vysoká dostupnost (HA) out-of-the-box. Abychom dosáhli HA, musíme něco nainstalovat, nastavit, vynaložit úsilí a získat to.
- Existuje několik nástrojů a Patroni je jedním z nich, který velmi dobře řeší HA. Ale když to všechno nastavíme v testovací laboratoři a spustíme, můžeme vidět, že to funguje, můžeme reprodukovat nějaké problémy a podívat se, jak s nimi Patroni zachází. A uvidíme, že všechno skvěle funguje.
- Ale v praxi jsme se setkali s různými problémy. A o těchto problémech budu vyprávět.
- Povím, jak jsme to diagnostikovali, co jsme nastavovali – pomohlo nám to nebo ne.
- Nebudu vyprávět, jak nainstalovat Patroni, protože to lze snadno najít na internetu, můžete se podívat na konfigurační soubory, abyste pochopili, jak to všechno běží a jak se nastavuje. Můžete se seznámit se schématy a architekturami, když najdete informace o tom na internetu.
- Nebudu vyprávět o cizích zkušenostech. Budu mluvit pouze o problémech, se kterými jsme se setkali my sami.
- A nebudu hovořit o problémech, které jsou mimo Patroni a PostgreSQL. Například o problémech souvisejících s vyvažováním, když se náš klastr rozpadl, o tom hovořit nebudu.
A malý disclaimer předtím, než začneme náš příspěvek.
Všechny tyto problémy, se kterými jsme se potýkali, jsme zažili během prvních 6-7-8 měsíců provozu. Časem jsme přišli na své interní osvědčené postupy. A problémy zmizely. Proto byl příspěvek ohlášen před asi půl rokem, když to všechno bylo čerstvé v paměti a já si to dobře pamatoval.
Při přípravě příspěvku jsem již procházel staré postmortemy, zkoumal logy. A některé detaily se mohly zapomenout nebo část některých detailů mohla být během analýzy problémů nedostatečně prozkoumána, takže se může zdát, že problémy nebyly plně probrány, nebo že chybí nějaké informace. A proto se omlouvám za tuto situaci.
Co je Patroni?
- Je to šablona pro vytváření HA. Tak je to napsáno v dokumentaci. A z mého pohledu je to velmi správné upřesnění. Patroni není stříbrná kulka, která vyřeší všechny vaše problémy, tzn. je potřeba vynaložit úsilí, aby to začalo fungovat a přinášelo prospěch.
- Je to agentní služba, která je nainstalována na každé službě s databází a která je jakýmsi init systémem pro váš Postgres. Spouští Postgres, zastavuje ho, restartuje, mění konfiguraci a mění topologii vašeho klastru.
- Aby bylo možné uchovávat stav klastru, jeho aktuální reprezentaci, jak vypadá, je potřeba nějaké úložiště. A z tohoto pohledu Patroni zvolil cestu uchovávání stavu v externím systému. Toto je systém distribuovaného úložiště konfigurace. Mohou to být Etcd, Consul, ZooKeeper nebo kuberneteský Etcd, tedy některá z těchto variant.
- A jednou z vlastností Patroni je to, že autofailover máte z krabice, stačí ho nastavit. Pokud to srovnáme s Repmgr, tam je failover již součástí balení. S Repmgr dostáváme switchover, ale pokud chceme autofailover, musíme ho nastavit dodatečně. Patroni již autofailover z krabice má.
- A existuje mnoho dalších věcí. Například správa konfigurací, zavádění nových replik, zálohování atd. Ale to je mimo téma prezentace, o tom mluvit nebudu.
A malý závěr – hlavní úkol Patroni je dobře a spolehlivě provádět autofailover, aby byl náš cluster funkční a aplikace nezaznamenala změny v topologii clusteru.
Ale když začneme používat Patroni, náš systém se stává trochu složitějším. Pokud jsme měli dříve Postgres, při použití Patroni dostáváme samotný Patroni, dostáváme DCS, kde je uložen stav. A to vše musí nějak fungovat. Takže, co se může pokazit?
Může se pokazit:
- Může se pokazit Postgres. Může to být master nebo replikace, něco z toho může selhat.
- Může se pokazit samotný Patroni.
- Může se pokazit DCS, kde je uložen stav.
- A může se pokazit síť.
Tyto body budu zkoumat v prezentaci.
Budeme zkoumat případy podle jejich složitosti, ne z pohledu toho, že případ zahrnuje mnoho komponent. Ale z pohledu subjektivních pocitů, že tento případ byl pro mě složitý, těžko se rozebíral... a naopak, nějaký případ byl snadný a bylo ho snadné rozebírat.
A první případ je nejjednodušší. Je to případ, kdy jsme vzali cluster databází a na tomto stejném clusteru jsme nasadili naše úložiště DCS. To je nejběžnější chyba. To je chyba architekturálního návrhu, tj. spojení různých komponent na jednom místě.
Takže došlo k failoveru, pojďme se podívat na to, co se stalo.
A zde nás zajímá, kdy došlo k failoveru. Tj. zajímá nás tento okamžik, kdy došlo ke změně stavu clusteru.
Ale failover není vždy okamžitý, tj. nezabere nějakou jednotku času, může se protáhnout. Může trvat delší dobu.
Proto má čas začátku a čas ukončení, tedy se jedná o trvalou událost. Všechny události dělíme na tři intervaly: máme čas před failoverem, během failoveru a po failoveru. Tedy zvažujeme všechny události na této časové ose.
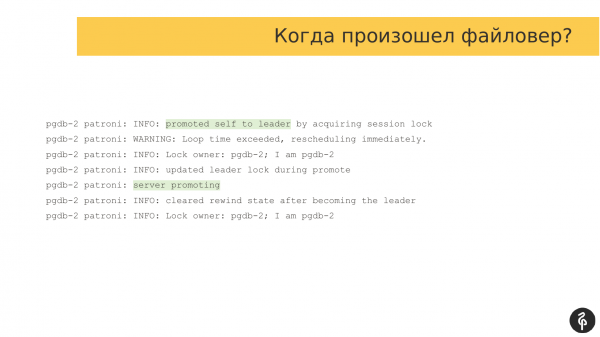
A prvním krokem, když došlo k failoveru, je hledání příčiny, co se stalo, co vedlo k failoveru.
Pokud se podíváme na logy, budou to klasické logy Patroni. V nich nám sděluje, že server se stal mistrem a role mistra přešla na tento uzel. Zde je to zvýrazněno.
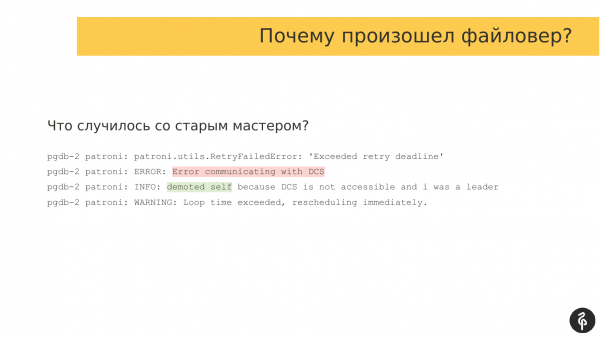
Dále musíme pochopit, proč došlo k failoveru, tedy jaké události vedly k tomu, že se role mistra přestěhovala z jednoho uzlu na druhý. V tomto případě je to jasné. Máme chybu při interakci se systémem úložiště. Mistr si uvědomil, že nemůže pracovat s DCS, tedy došlo k nějakému problému s interakcí. A říká, že už nemůže být mistrem a vzdává se svých pravomocí. Tato řádka „demoted self“ přesně o tom mluví.
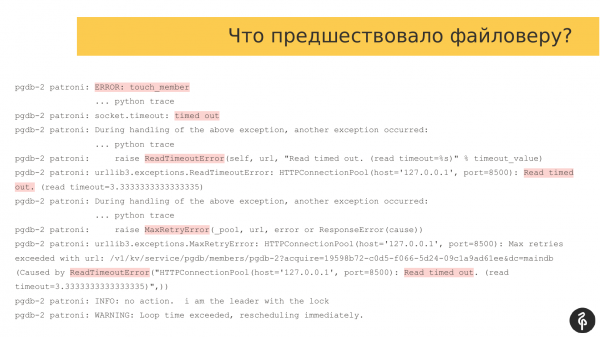
Pokud se podíváme na události, které předcházely failoveru, můžeme tam vidět právě ty příčiny, které způsobily problém pro pokračování práce mistra.
Pokud se podíváme na logy Patroni, uvidíme, že máme spoustu různých chyb, časových limitů, tedy agent Patroni nemůže pracovat s DCS. V tomto případě je to Consul agent, se kterým se komunikuje přes port 8500.
A problém zde spočívá v tom, že Patroni a databáze běží na jednom hostiteli. A na tomto uzlu byly spuštěny také servery Consul. Zatížením serveru jsme vytvořili problémy i pro servery Consul. Nedokázali normálně komunikovat.
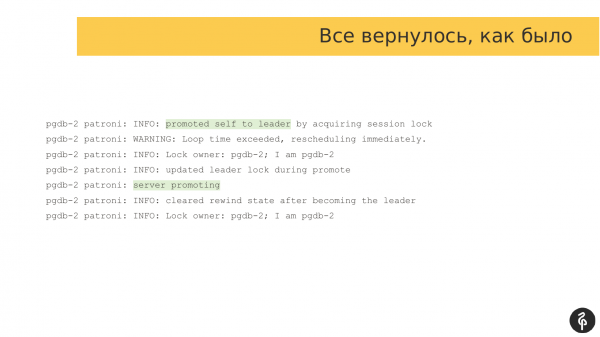
Po nějaké době, když zátěž opadla, mohl náš Patroni opět komunikovat s agenty. Normální provoz byl obnoven. A ten samý server Pgdb-2 se znovu stal mistrem. Tedy došlo k malé změně, kvůli které uzel vzdal své pravomoci mistra, a poté je opět přijal, tedy vše se vrátilo do původního stavu.
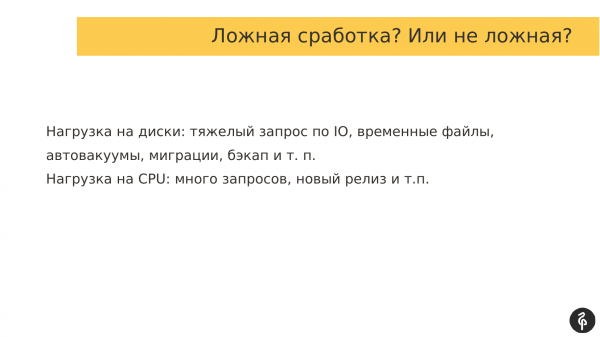
A to lze považovat za falešnou aktivaci, nebo to můžeme vnímat tak, že Patroni udělal vše správně. Tedy pochopil, že nemůže udržovat stav clustera a vzdal se svých pravomocí.
A zde vzniká problém, protože servery Consul jsou na stejném hardware jako databáze. Každá zátěž, ať už zátěž na disky nebo procesory, také ovlivňuje interakci s klastrem Consul.
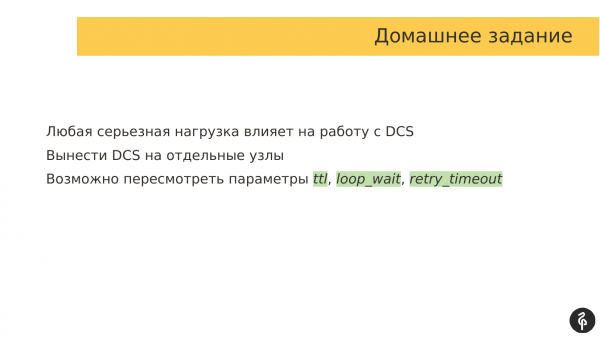
Rozhodli jsme se, že to nemá být součástí jednoho celku, a vyčlenili jsme samostatný klastr pro Consul. Patroni nyní pracoval s odděleným Consulem, tj. byl oddělený klastr Postgres a oddělený klastr Consul. Toto je základní instrukce, jak rozdělovat a udržovat tyto věci, aby nebyly spojeny.
Jako alternativu můžeme upravit parametry ttl, loop_wait, retry_timeout, tedy se pokusit zvýšením těchto parametrů přečkat krátkodobé špičky zátěže. Ale to není úplně vhodná možnost, protože zátěž může být dlouhodobá. Mohli bychom se prostě dostat za limity těchto parametrů, což nemusí nutně pomoci.
První problém, jak jste pochopili, je jednoduchý. Vzali jsme DCS a umístili ho spolu s databází, a tím jsme vytvořili problém.
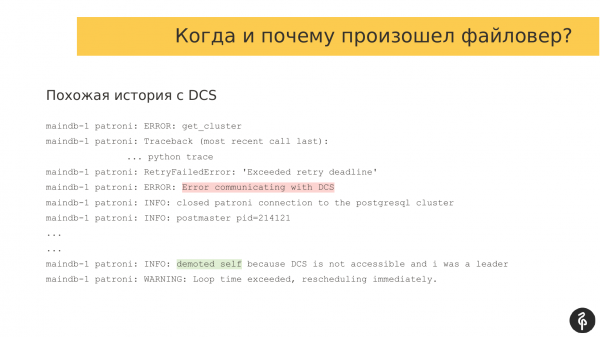
Druhý problém je podobný prvnímu. Je podobný tím, že máme znovu problémy s interakcí se systémem DCS.
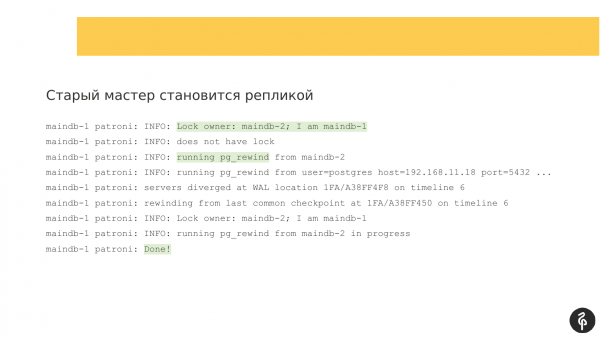
Pokud se podíváme na logy, uvidíme, že znovu dochází k chybě komunikace. Patroni říká, že nemůže komunikovat s DCS, proto aktuální master přechází do režimu repliky.
Starý master se stává replikou, Patroni zde funguje, jak má. Spouští pg_rewind, aby se vrátil k transakčnímu logu a pak se připojil k novému masterovi a vyrovnal se s ním. Patroni zde funguje, jak by měl.
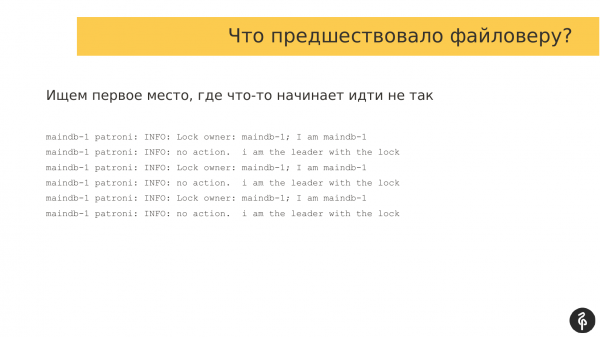
Musíme najít místo, které předcházelo chybě souboru, tedy chyby, které způsobily vznik této situace. Z tohoto pohledu se s logy Patroni pracuje docela snadno. Pravidelně zapisuje stejné zprávy. A pokud rychle projíždíme logy, uvidíme, že se zprávy změnily, což naznačuje, že nějaké problémy začaly. Rychle se vrátíme na toto místo a podíváme se, co se děje.
V normální situaci logy vypadají přibližně takto. Kontroluje se vlastník zámku. A pokud se vlastník například změnil, mohou nastat nějaké události, na které by měl Patroni reagovat. Ale v tomto případě máme vše v pořádku. Hledáme místo, kdy začaly chyby.
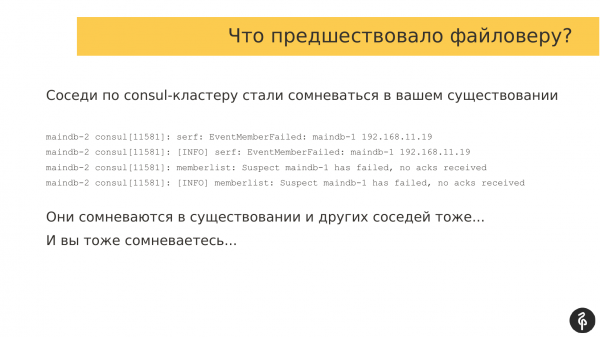
A když se posuneme na místo, kde začaly chyby, vidíme, že došlo k automatickému selhání. A jelikož byly naše chyby spojeny se spoluprací s DCS a v našem případě jsme používali Consul, podíváme se také do logů Consulu, co se tam dělo.
Přibližně srovnáním času selhání a času v logech Consulu vidíme, že naši sousedé z Consul clusteru začali pochybovat o existenci ostatních účastníků Consul clusteru.
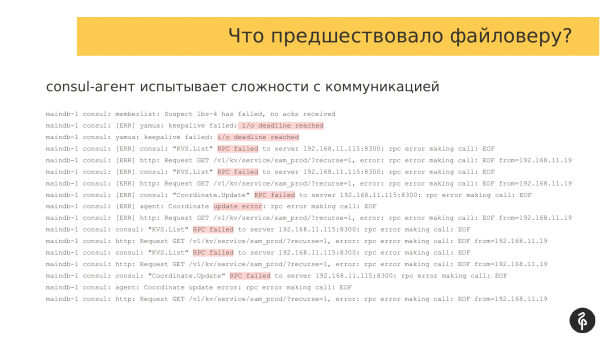
A pokud se podíváme na logy dalších agentů Consulu, pak tam také vidíme, že dochází k nějakému síťovému kolapsu. A všechny účastníky Consul clusteru mají pochybnosti o existenci jeden druhého. A to bylo podnětem k selhání.
Pokud se podíváme, co se dělo před těmito chybami, můžeme vidět, že se objevují různé chyby, například deadline, RPC selhal, tj. zřejmě nějaký problém při vzájemném působení účastníků Consul clusteru.
Nejjednodušší odpověď je opravit síť. Ale pro mě, když stojím na tribuně, je snadné to říct. Ale okolnosti jsou takové, že ne vždy si klient může dovolit opravit síť. Může žít v datovém centru a nemusí mít možnost opravit síť, ovlivnit hardware. A proto jsou potřeba nějaké jiné možnosti.
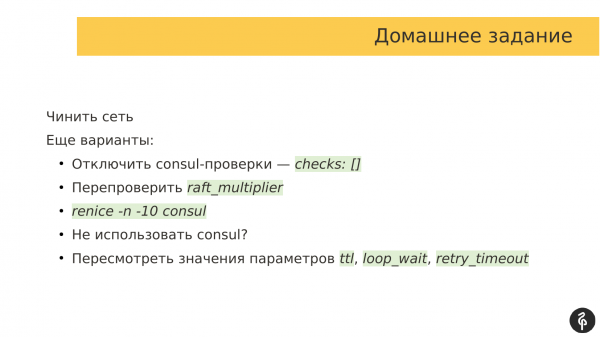
Možnosti existují:
- Nejjednodušší možnost, která je napsaná, myslím, že i v dokumentaci, je vypnout kontrolní mechanismy Consulu, tj. jednoduše předat prázdné pole. Říkáme agentu Consulu, aby nepoužíval žádné kontroly. Díky těmto kontrolám můžeme ignorovat tyto síťové bouře a nevyvolávat selhání.
- Další možností je zkontrolovat raft_multiplier. To je parametr samotného serveru Consul. Ve výchozím nastavení je nastaven na hodnotu 5. Tato hodnota je doporučená podle dokumentace pro staging prostředí. V podstatě to ovlivňuje frekvenci výměny zpráv mezi účastníky sítě Consul. V podstatě tento parametr ovlivňuje rychlost služební komunikace mezi účastníky Consul clusteru. A pro produkci se doporučuje snižovat, aby se uzly častěji vyměňovaly zprávy.
- Jinou možností, kterou jsme začali používat, je zvýšení priority procesů Consul mezi ostatními procesy pro plánovač operačního systému. Existuje takový parametr "nice", který přesně určuje prioritu procesů, jež plánovač OS zohledňuje při plánování. Snížili jsme hodnotu nice pro agenti Consul, tedy jsme zvýšili prioritu, aby operační systém dával procesům Consul více času na práci a na vykonávání svého kódu. V našem případě to vyřešilo náš problém.
- Další možností je nepoužívat Consul. Mám přítele, který je velkým zastáncem Etcd. A pravidelně se s ním hádáme, co je lepší, Etcd nebo Consul. Ale co se týče toho, co je lepší, obvykle se shodujeme v názoru, že Consul má agenta, který musí být spuštěn na každém uzlu s databází. Tedy interakce Patroni s klastrem Consul probíhá přes tohoto agenta. A tento agent se stává úzkým místem. Pokud se s agentem něco stane, Patroni už nemůže pracovat s klastrem Consul. A to je problém. Co se týče Etcd, žádného agenta není. Patroni může přímo pracovat se seznamem Etcd serverů a komunikovat s nimi. V tomto ohledu, pokud ve vaší firmě používáte Etcd, může být Etcd pravděpodobně lepší volbou než Consul. Ale my jsme u našich zákazníků vždy omezeni tím, co si vybral a používá klient. A většinou máme Consul u všech klientů.
- A poslední bod – je přehodnotit hodnoty parametrů. Můžeme tyto parametry zvýšit v naději, že naše krátkodobé síťové problémy budou krátké a nebudou spadat do intervalu těchto parametrů. Tímto způsobem můžeme snížit agresivitu Patroni při provádění automatického převodu, pokud se vyskytnou nějaké síťové problémy.
Myslím, že mnozí, kdo používají Patroni, znají tento příkaz.
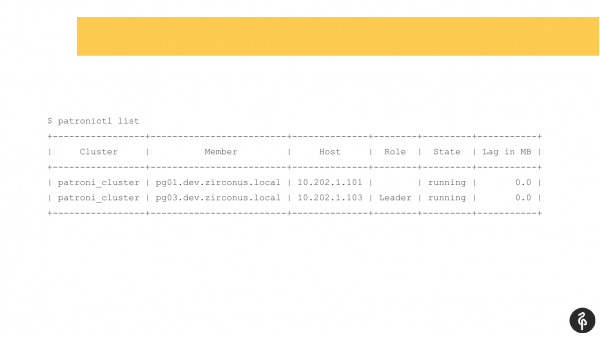
Tento příkaz ukazuje aktuální stav klastru. A na první pohled se může tato situace zdát normální. Máme master, máme repliku, žádná replikace není zpožděná. Ale tato situace je normální jen do té doby, dokud nevíme, že v tomto klastru by měly být tři uzly, nikoli dva.
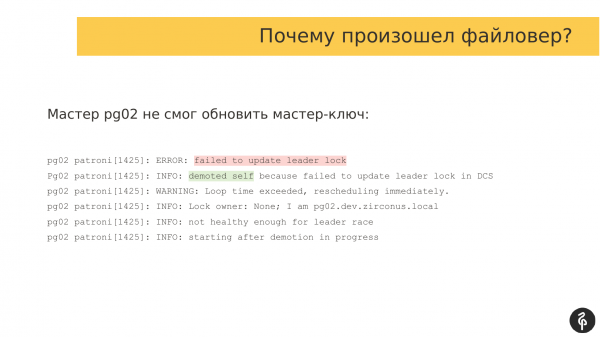
V důsledku toho došlo k automatickému přepnutí souboru. Po tomto přepnutí souboru nám odešla replikace. Musíme zjistit, proč odešla, a vrátit ji zpět, obnovit. A opět se díváme do logů a zkoumáme, proč k automatickému přepnutí souboru došlo.
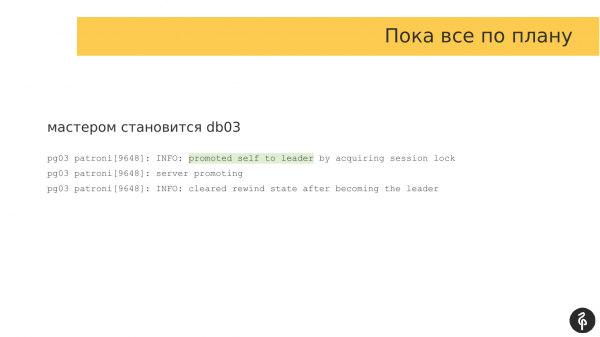
V tomto případě se druhá replikace stala mistrem. Všechno je v pořádku.
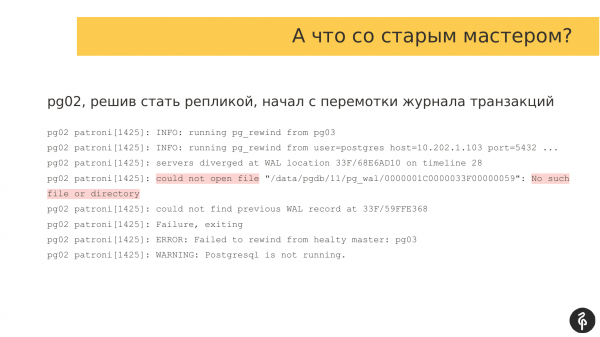
A musíme se podívat na replikaci, která se odpojila a není v clusteru. Otevíráme logy Patroni a sledujeme, že při pokusu o připojení k clusteru došlo k problému ve fázi pg_rewind. Abychom se připojili k clusteru, musíme se vrátit v protokolu transakcí, požádat o potřebný protokol transakcí z mistra a podle něj dohnat mistra.
V tomto případě nemáme protokol transakcí a replikace se nemůže spustit. Důsledkem toho zastavujeme Postgres s chybou. A proto není v clusteru.
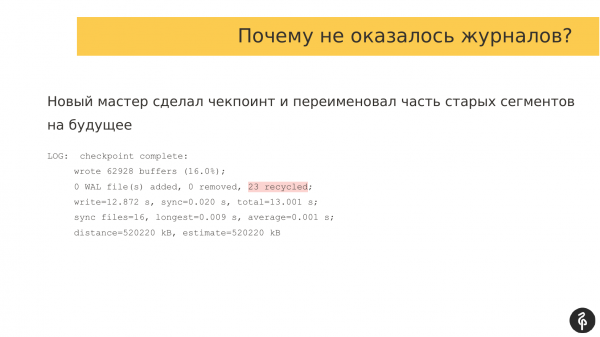
Musíme zjistit, proč není v clusteru a proč chybí logy. Jdeme na nového mistra a zkoumáme, co má v logách. Ukazuje se, že při provádění pg_rewind došlo k checkpointu. A část starých protokolů transakcí byla jednoduše přejmenována. Když se starý mistr pokusil připojit k novému mistrovi a požádat o tyto logy, už byly přejmenovány, jednoduše neexistovaly.
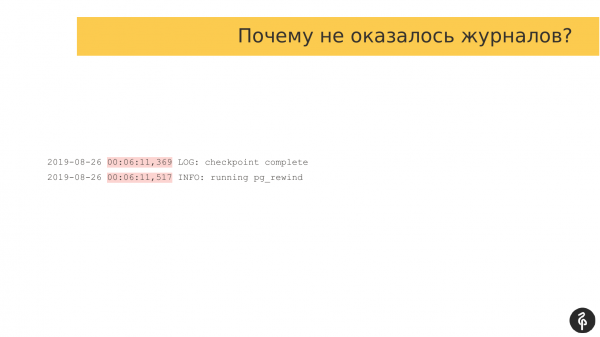
Porovnával jsem časové značky, kdy k těmto událostem došlo. A rozdíl je doslova 150 milisekund, t. j. checkpoint byl dokončen za 369 milisekund, WAL segmenty byly přejmenovány. A doslova po 517 milisekundách, po 150 milisekundách, se spustil rewind na staré replikaci. T. j. stačilo nám 150 milisekund, aby se replikace nemohla připojit a fungovat.
Jaké jsou možnosti?
Zpočátku jsme používali replikace sloty. Zdálo se nám, že je to dobré. I když jsme v první fázi provozu sloty vypnuli. Měli jsme pocit, že pokud budou sloty hromadit mnoho WAL segmentů, můžeme poškodit mistra. Spadne. Chvíli jsme se bez slotů trápili. A pochopili jsme, že sloty potřebujeme, vrátili jsme sloty zpět.
Ale tady je problém, že když se master přejde na replikaci, odstraní sloty a spolu se sloty odstraní WAL segmenty. Abychom předešli této situaci, rozhodli jsme se zvýšit parametr wal_keep_segments. Ten je ve výchozím stavu nastaven na 8 segmentů. My jsme ho zvýšili na 1 000 a podívali se, kolik máme volného místa. A na wal_keep_segments jsme darovali 16 gigabajtů. Tedy při přepínání máme vždy na všech uzlech rezervu 16 gigabajtů transakčních logů.
A navíc – to je také aktuální pro dlouhotrvající údržbové úkoly. Řekněme, že potřebujeme aktualizovat jednu z replik. A chceme ji vypnout. Musíme aktualizovat software, možná operační systém, něco dalšího. A když vypneme replikaci, pro tuto replikaci se také odstraní slot. A pokud použijeme malý wal_keep_segments, při dlouhé absenci repliky se transakční logy přehrají. Spustíme replikaci, ta si vyžádá ty transakční logy, kde skončila, ale na masteru může žádné být. A replikace se také nebude moct připojit. Proto udržujeme velkou rezervu logů.
Máme produkční databázi. Tam už běží projekty.
Došlo k failoveru. Podívali jsme se a všechno je v pořádku, repliky jsou na svém místě, žádný lag replikace. Chyb také není, vše je v pořádku.
Produktový tým říká, že zdánlivě by měly být nějaké údaje, ale vidíme je v jednom zdroji, zatímco v databázi je nevidíme. A musíme pochopit, co se s nimi stalo.
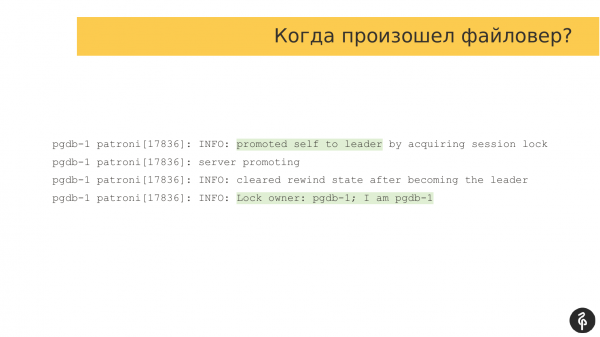
Je jasné, že pg_rewind je smazal. To jsme pochopili hned, ale šli jsme se podívat, co se dělo.
V logách vždy můžeme najít, kdy k failoveru došlo, kdo se stal mistrem a můžeme určit, kdo byl starý master a kdy se chtěl stát replikou, tedy potřebujeme tyto logy, abychom zjistili objem transakčních logů, které byly ztraceny.
Náš starý master se restartoval. A v autostartu byl zapsán Patroni. Patroni se spustil. Následně spustil Postgres. Přesněji před spuštěním Postgresu a před tím, než ho udělal replikou, spustil Patroni proces pg_rewind. Odpovídajícím způsobem smazal část transakčních logů, stáhl nové a připojil se. Tady Patroni skvěle fungoval, jak má. Náš cluster se obnovil. Měli jsme 3 uzly, po failoveru 3 uzly – vše skvělé.
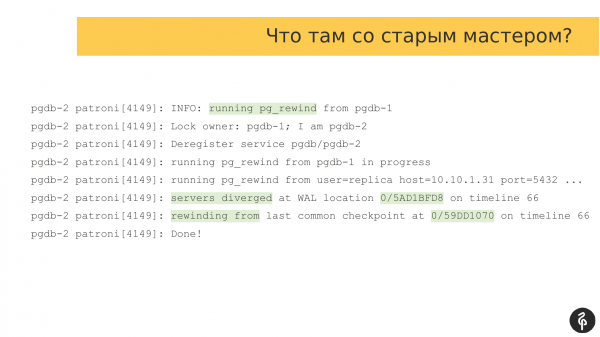
Ztratili jsme část dat. A potřebujeme zjistit, kolik jsme ztratili. Hledáme právě ten okamžik, kdy došlo k rewindu. To můžeme najít podle takovýchto záznamů v logu. Rewind se spustil, něco udělal a dokončil se.
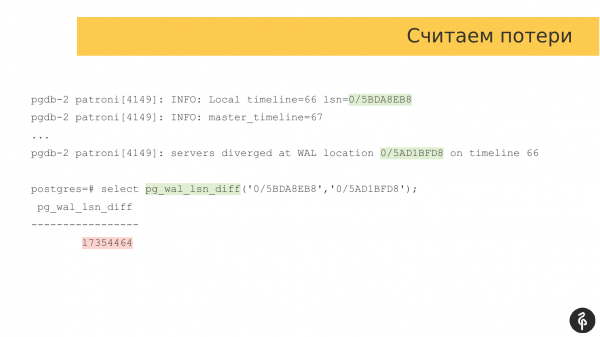
Musíme najít pozici v transakčním logu, na které se zastavil starý master. V tomto případě – je to tato značka. A potřebujeme druhou značku, tedy vzdálenost, o kterou se starý master liší od nového.
Bereme běžný pg_wal_lsn_diff a porovnáváme tyto dvě značky. A v tomto případě dostaneme 17 megabajtů. To, zda je to mnoho nebo málo, si každý rozhoduje sám. Protože pro někoho 17 megabajtů – to je málo, pro někoho je to mnoho a nepřijatelné. Tady už si každý individuálně určuje podle potřeb svého podnikání.
Ale co jsme zjistili pro sebe?
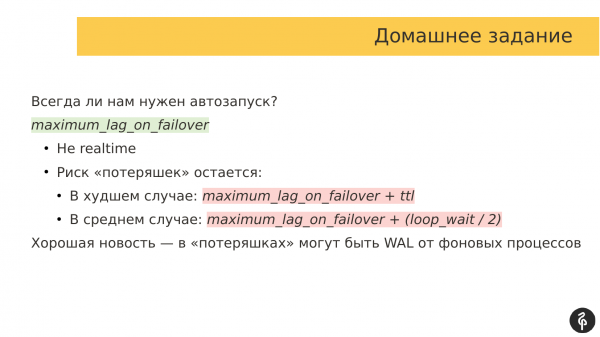
Za prvé, musíme si rozhodnout – potřebujeme vždy automatické spuštění Patroni po restartu systému? Častěji se stává, že musíme jít na starý master, podívat se, jak daleko se vzdálil. Možná prozkoumat segmenty transakčního logu, podívat se, co tam je. A pochopit – můžeme tato data ztratit, nebo potřebujeme spustit starý master v standalone režimu, abychom tato data získali.
A teprve poté bychom měli přijmout rozhodnutí, že tato data můžeme zahodit, nebo je můžeme obnovit, připojit tento uzel jako repliku do našeho clusteru.
Kromě toho existuje parametr „maximum_lag_on_failover“. Pokud se nemýlím, tento parametr má ve výchozím nastavení hodnotu 1 megabajt.
Jak to funguje? Pokud naše replika zpožďuje o 1 megabajt dat kvůli zpoždění replikace, tato replika se neúčastní voleb. A pokud dojde k failoveru, Patroni kontroluje, které repliky se zpožďují. Pokud se zpožďují o velké množství transakčních logů, nemohou se stát masterem. To je velmi dobrá ochranná funkce, která zabraňuje ztrátě velkého množství dat.
Ale zde je problém v tom, že zpoždění replikace v clusteru Patroni a DCS se aktualizuje s určitou periodou. Podle mě je to ve výchozím nastavení 30 sekund pro ttl.
Může nastat situace, kdy zpoždění replikace pro repliky v DCS je jediné, ale ve skutečnosti může být úplně jiné zpoždění nebo dokonce nemusí být žádné, tj. tento proces neprobíhá v reálném čase. A nikdy neodráží skutečný obraz. Není vhodné na něm stavět složitou logiku.
A riziko ztráty dat vždy zůstává. V nejhorším případě jedna formule, v průměrném případě jiná formule. Když plánujeme implementaci Patroni a odhadujeme, kolik dat můžeme ztratit, musíme počítat s těmito formulami a přibližně mít představu o množství ztracených dat.
A mám dobrou zprávu. Když starý master přešel vpřed, může tak učinit díky některým pozadovým procesům. Například pokud byl spuštěn automatický vakuum, zapsal data a uložil je do transakčního logu. Tato data můžeme bez problémů ignorovat a ztratit. Na tom není nic špatného.
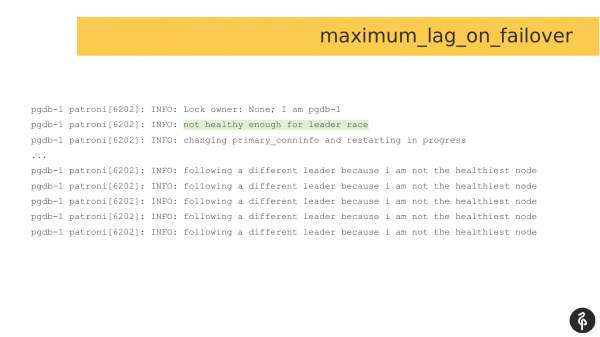
A takto vypadají logy, pokud je nastavena maximum_lag_on_failover a došlo k failoveru, kdy je třeba vybrat nového mastera. Replika se sama hodnotí jako neschopná účastnit se voleb. A odmítá účast v závodu o lídra. Čeká, až bude vybrán nový master, ke kterému se pak připojí. To je dodatečné opatření proti ztrátě dat.
Zde máme od produktového týmu informaci, že jejich produkt má problémy při práci s Postgres. Přitom není možné se připojit k samotnému masterovi, protože není dostupný přes SSH. A automatický failover také neprobíhá.
Tento host byl nuceně restartován. Kvůli restartu došlo k automatickému failoveru, přičemž bylo možné provést i manuální automatický failover, jak nyní chápu. A po restartu jdeme již zkontrolovat, co se dělo s aktuálním masterem.
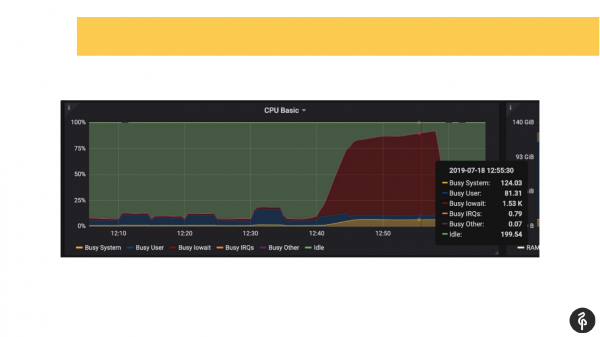
Přitom jsme již předem věděli, že máme problémy s disky, tj. podle monitorování jsme již věděli, kde pátrat a co hledat.
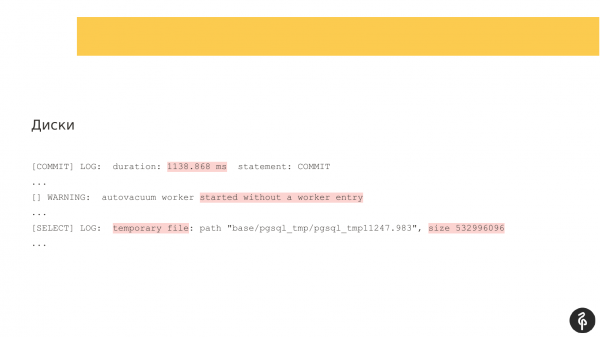
Podívali jsme se do postgresového logu a začali jsme zjišťovat, co se tam děje. Viděli jsme commity, které trvaly jednu, dvě, tři sekundy, což vůbec není normální. Viděli jsme, že náš automatický vakuum se spouští velmi dlouho a zvláštně. A viděli jsme dočasné soubory na disku. Tj. to vše jsou ukazatele problémů s disky.
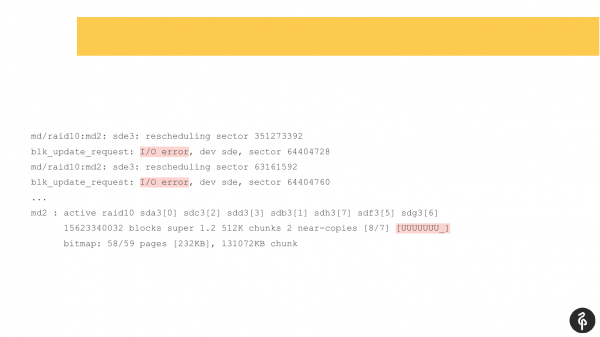
Podívali jsme se do systémového dmesg (do logu jádrových zpráv). A zjistili jsme, že máme problém s jedním z disků. Diskový subsystém představoval softwarový Raid. Podívali jsme se na /proc/mdstat a zjistili, že nám chybí jeden disk. Tj. je to Raid z 8 disků, máme jeden chybějící. Pokud se pozorně podíváte na snímek, můžete v výstupu vidět, že nám tam chybí sde. Podmíněně řečeno, disk vypadl. To spustilo diskové problémy a aplikace také zažívaly problémy při práci s clusterem Postgres.
A v tomto případě by nám Patroni nijak nepomohl, protože Patroni nemá úkol sledovat stav serveru, stav disku. Tyto situace musíme sledovat externím monitoringem. Rychle jsme do externího monitoringu přidali monitoring disků.
A byla taková myšlenka – mohl by nám pomoci fencing, nebo softwarový watchdog? Mysleli jsme, že by nám v tomto případě asi moc nepomohl, protože během problémů Patroni nadále interagoval s clusterem DCS a neviděl žádný problém. Tj. z pohledu DCS a Patroni bylo s clusterem všechno v pořádku, i když ve skutečnosti byly problémy s diskem, byly problémy s dostupností databáze.
Podle mého názoru je to jeden z nejpodivnějších problémů, které jsem dlouho zkoumal, přečetl jsem spoustu logů a nazval jsem ho cluster-simulant.
Problém spočíval v tom, že starý master se nemohl stát normální replikou, tj. Patroni ho spouštěl, Patroni ukazoval, že tento uzel je přítomen jako replikovaná, ale zároveň to nebyla normální replikace. Teď uvidíte, proč. To mi zůstalo z analýzy toho problému.
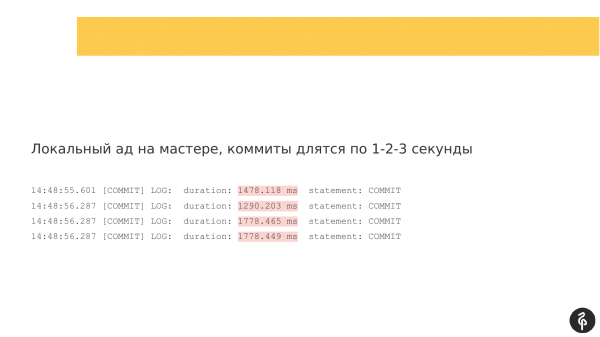
A jak to všechno začalo? Začalo to, jak v předchozím problému, s diskovými zpožděními. Měli jsme commity za sekundu, za dvě.
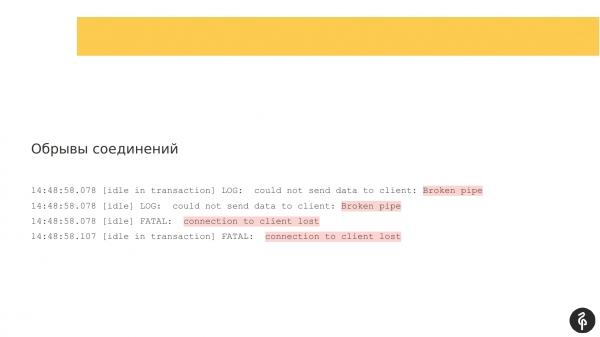
Byly přerušení spojení, tj. klienti se odpojovali.
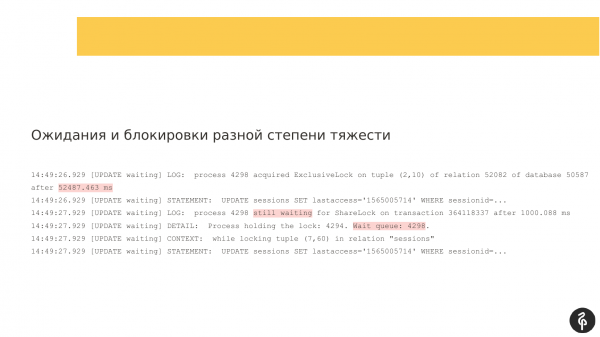
Byly blokace různé závažnosti.
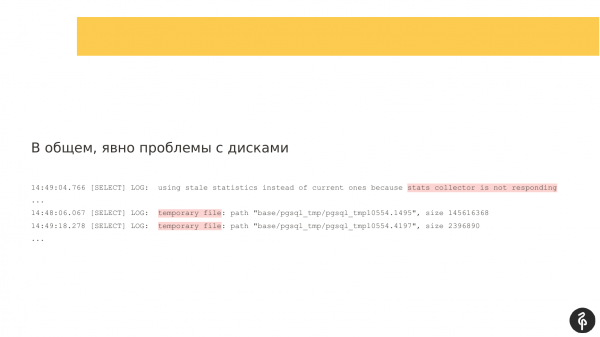
A odpovídajícím způsobem diskový subsystém nebyl příliš rychlý.
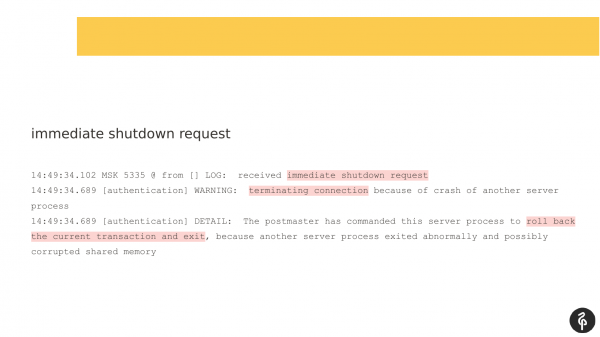
A to nejzáhadnější pro mě – to byl přijatý immediate shutdown request. Postgres má tři režimy vypnutí:
- To je graceful, kdy čekáme, než se všichni klienti odpojí sami.
- Existuje fast, kdy donutíme klienty, aby se odpojili, protože se chystáme na vypnutí.
- A immediate. In this case, immediate doesn't even notify clients that they need to disconnect; it simply shuts down without warning. Meanwhile, all clients receive a message from the operating system, RST (a TCP message indicating that the connection has been interrupted and there is nothing more for the client to catch).
Who sent this signal? Background processes of Postgres don't send such signals to each other, meaning this is kill-9. They don't send such signals to each other; they only react to them, indicating an emergency restart of Postgres. I do not know who sent it.
I checked using the 'last' command and saw one person who also logged into this server with us, but I hesitated to ask. It could have been kill -9. I would have seen kill -9 in the logs because Postgres logs that it received kill -9, but I didn't see this in the logs.
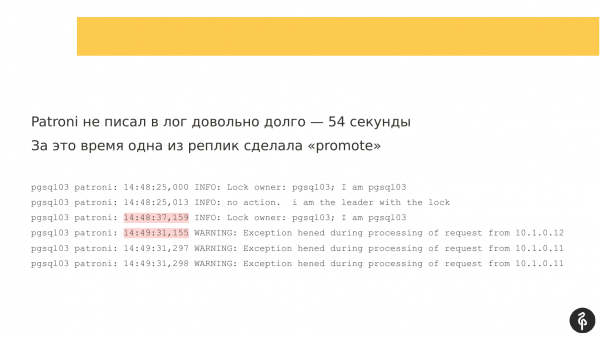
Upon further investigation, I noticed that Patroni hadn't written to the logs for quite a while—54 seconds. When comparing the two timestamps, there were no messages for approximately 54 seconds.
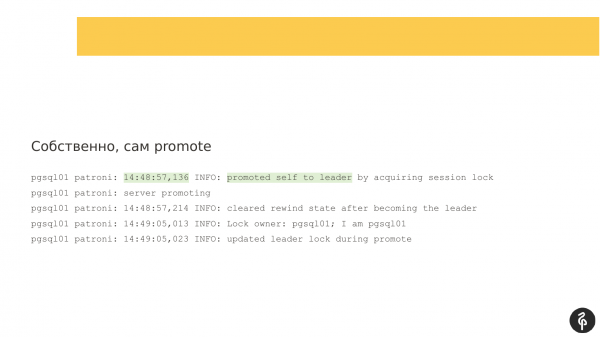
During this time, an auto-failover occurred. Patroni worked excellently again. Our old master was unavailable; something was happening with it. Elections for a new master began. Everything worked well here. Our pgsql01 became the new leader.
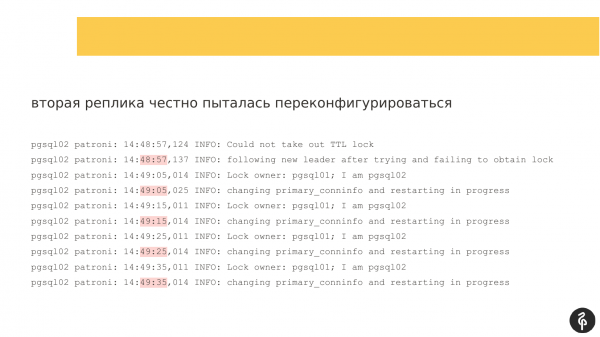
We have a replica that became the master, and there is a second replica. We had issues with the second replica. It was trying to reconfigure itself. As I understand it, it was trying to change recovery.conf, restart Postgres, and connect to the new master. Every 10 seconds, it sent messages that it was trying, but it was unsuccessful.
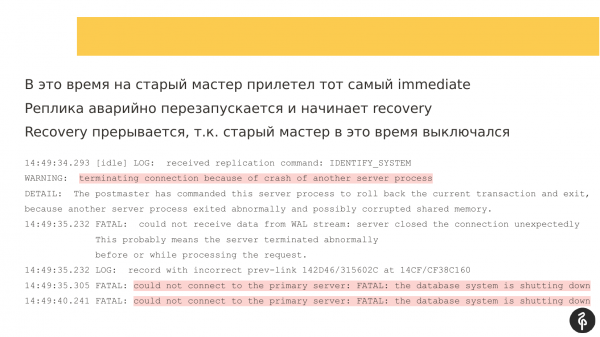
During these attempts, an immediate-shutdown signal reached the old master. The master restarted. Recovery also stopped because the old master went into reboot mode. This means the replica couldn't connect to it because it was shutting down.
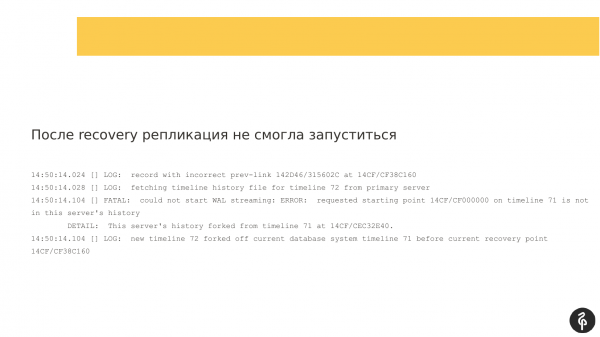
At some point, it managed to start, but replication did not initiate.
I have a single hypothesis that the recovery.conf contained the address of the old master. And when the new master appeared, the second replica continued to try to connect to the old master.
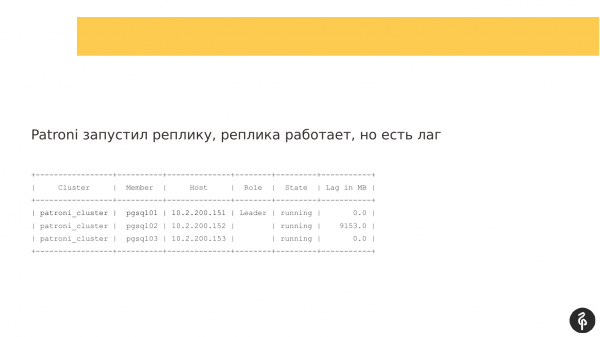
When Patroni started on the second replica, the node started but could not connect for replication. This created a replication lag that looked something like this. That is, all three nodes were in place, but the second node was lagging.
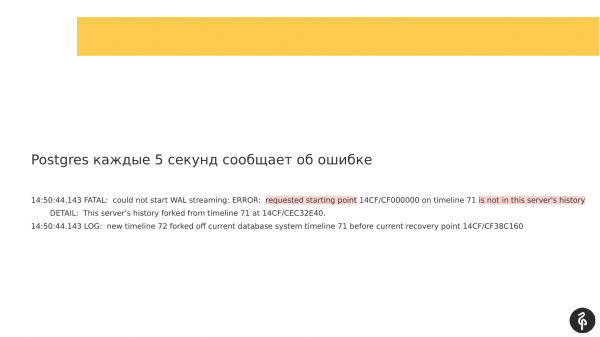
Při pohledu do záznamů, které byly vytvořeny, bylo možno vidět, že replikace nemohla začít, protože transakční logy se lišily. A tyto transakční logy, které nabízí master, uvedené v recovery.conf, jednoduše nevyhovovaly našemu aktuálnímu uzlu.
A tady jsem se dopustil chyby. Měl jsem se podívat, co je v recovery.conf, abych ověřil svou hypotézu, že se připojujeme k nesprávnému masteru. Ale tehdy jsem se s tím teprve seznamoval a nenapadlo mě to, nebo jsem viděl, že replika zaostává a že ji budu muset přenastavit, tzn. odpracoval jsem to tak nějak na rychlo. To byla moje chyba.
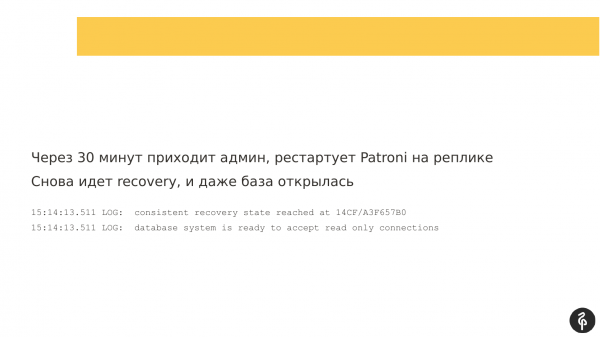
Po třiceti minutách už přišel administrátor, tzn. já jsem restartoval Patroni na replice. Už jsem ji odbyl, myslel jsem, že ji budu muset přenastavit. A pomyslel jsem si – restartuji Patroni, možná se něco povede. Obnovil se recovery. A databáze se dokonce otevřela, byla připravena přijímat spojení.
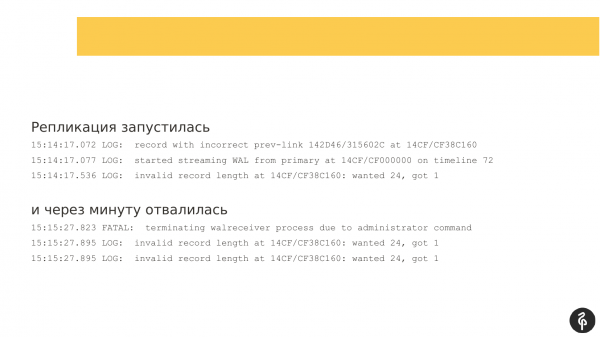
Replikace se rozběhla. Ale po minutě se to zhroutilo s chybou, že jí nevyhovují transakční logy.
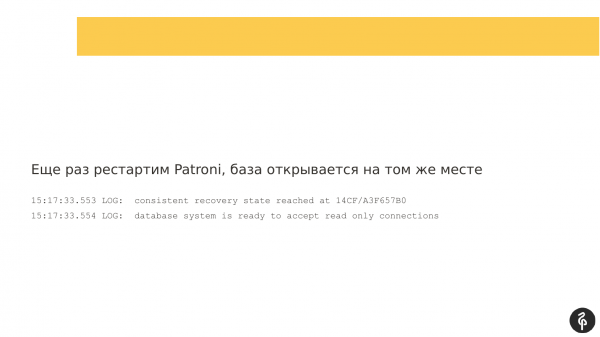
Pomyslel jsem si, že to zkusím restartovat ještě jednou. Znovu jsem restartoval Patroni, a to jsem nerestartoval Postgres, ale právě Patroni, v naději, že kouzelným způsobem spustí databázi.
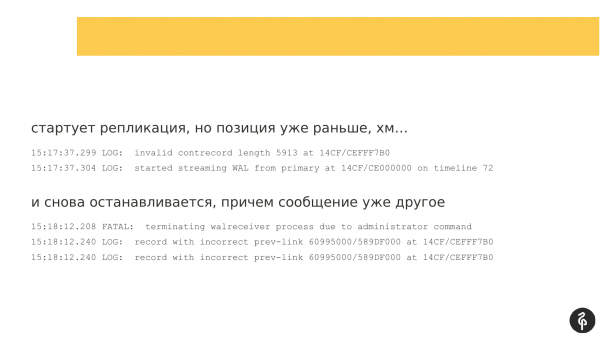
Replikace se znovu rozběhla, ale položky v transakčním logu se lišily, nebyly to ty, které byly při předchozím pokusu o spuštění. Replikace se znovu zastavila. A zpráva byla už trochu jiná. A nebyla pro mě příliš informativní.
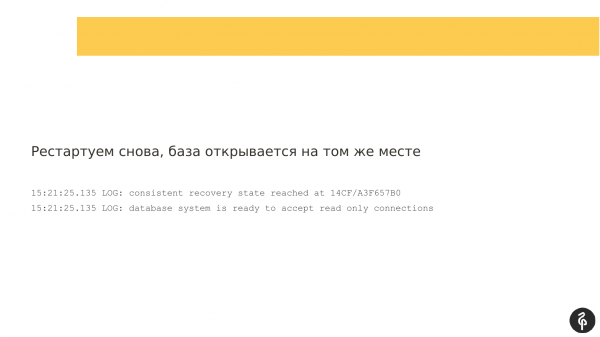
A tu mi blesklo hlavou – co když restartuji Postgres, přičemž na aktuálním masteru udělám checkpoint, abych posunul místo v transakčním logu trochu dopředu, abych spustil recovery z jiného bodu? Navíc tam byly ještě rezervy WAL.
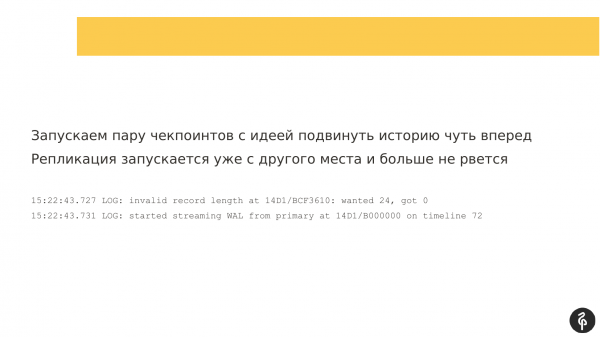
Restartoval jsem Patroni, udělal pár checkpointů na masteru, pár restartovacích bodů na replice, když se otevřela. A to pomohlo. Dlouho jsem přemýšlel, proč to pomohlo a jak to fungovalo. A replika se rozběhla. A replikace už se neodpojila.
Takový problém mi přijde jako jeden z více záhadných, nad kterým stále přemýšlím, co se tam vlastně dělo.
Jaké závěry lze učinit? Patroni může fungovat, jak bylo zamýšleno, a to bez jakýchkoli chyb. Ale to neznamená, že to zaručuje, že všechno funguje správně. Replika může být aktivována, ale může být v polovičním provozním stavu, a aplikace nemůže pracovat s takovou replikou, protože tam budou stará data.
A po failoveru je vždy třeba zkontrolovat, zda je náš cluster v pořádku, tj. že máme potřebný počet replik a žádný zpoždění replikace.
A během zkoumání těchto problémů formulují doporučení. Snažil jsem se je shrnout do dvou slidů. Pravděpodobně by bylo možné všechny příběhy sloučit do dvou slidů a pouze je přednést.
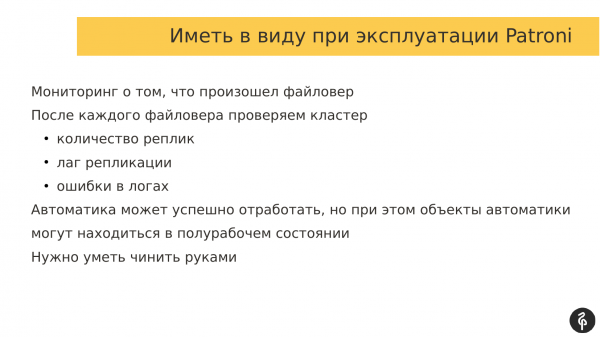
Když používáte Patroni, musíte mít neustálý monitoring. Musíte vždy vědět, kdy došlo k automatickému failoveru, protože pokud nevíte, že došlo k automatickému failoveru, nekontrolujete cluster. A to je špatně.
Po každém failoveru bychom měli ručně zkontrolovat cluster. Musíme se ujistit, že máme vždy aktuální počet replik, že neexistuje zpoždění replikace, v logách nejsou žádné chyby související s tokovou replikací, s Patroni, se systémem DCS.
Automatizace může úspěšně fungovat, Patroni je velmi dobrý nástroj. Může fungovat, ale to neprovede cluster do požadovaného stavu. A pokud se o tom nedozvíme, budeme mít problémy.
A Patroni není stříbrná kulka. Přesto musíme mít představu o tom, jak funguje Postgres, jak funguje replikace a jak Patroni spolupracuje s Postgres a jak je zajištěna interakce mezi uzly. To je nezbytné pro to, abychom mohli sami opravovat vzniklé problémy.
Jak přistupuji k diagnostice? Tak se stalo, že pracujeme s různými klienty a nikdo nemá stack ELK, a tak musíme třídit logy, otevřít 6 konzolí a 2 záložky. V jedné záložce jsou logy Patroni pro každý uzel, ve druhé záložce jsou logy Consul nebo Postgres podle potřeby. Diagnostikovat to je velmi těžké.
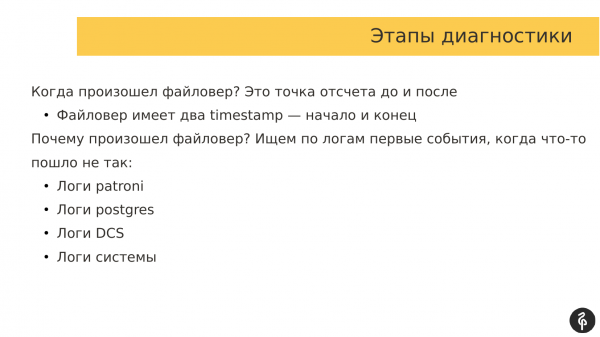
Jaké přístupy jsem vyvinul? Za prvé, vždy sleduji, kdy došlo k failoveru. A pro mě je to jistý vododěl. Sleduji, co se stalo před failoverem, během failoveru a po failoveru. Failover má dvě časové značky: čas začátku a konce.
Dále se dívám v logech na události před failoverem, co mu předcházelo, tj. hledám důvody, proč k failoveru došlo.
A to dává obrázek porozumění, co se dělo a co lze udělat v budoucnu, aby se takové okolnosti neopakovaly (a tím pádem se nestal failover).
A kam se obvykle díváme? Já se dívám:
- Nejprve do logů Patroni.
- Dále se dívám do logů Postgres nebo do logů DCS, v závislosti na tom, co jsem našel v logech Patroni.
- A logy systému také občas poskytují porozumění tomu, co bylo příčinou failoveru.
Jak se dívám na Patroni? Na Patroni se dívám velmi pozitivně. Podle mě je to to nejlepší, co dnes existuje. Znám mnoho dalších produktů. To jsou Stolon, Repmgr, Pg_auto_failover, PAF. Čtyři nástroje. Vyzkoušel jsem všechny. Patroni se mi líbilo nejvíce.
Pokud se mě zeptáte: „Doporučuji Patroni?“. Odpovím, že ano, protože Patroni se mi líbí. A myslím, že jsem se ho naučil dobře používat.
Pokud vás zajímá, jaké další problémy mohou být s Patroni kromě těch, které jsem zmínil, můžete se vždy podívat na stránku na GitHubu. Tam je mnoho různých příběhů a diskutuje se tam o mnoha zajímavých problémech. A nakonec byly odhaleny a vyřešeny nějaké chyby, tj. je to zajímavé čtení.
Jsou tam zajímavé příběhy o tom, jak si lidé střílejí do vlastních nohou. Velmi poučné. Čteš a chápeš, že takto to dělat nesmíš. Udělal jsem si za to čárku.
A chtěl bych moc poděkovat společnosti Zalando za to, že tento projekt rozvíjejí, konkrétně Alexandru Kukuškovi a Alexejovi Kljukinu. Alexej Kljukin je jedním ze spoluautorů, již v Zalando nepracuje, ale to jsou dva lidé, kteří začali pracovat s tímto produktem.
A považuji Patroni za velmi skvělou věc. Jsem spokojený, že existuje, je s ním zajímavé pracovat. A velké díky všem přispěvatelům, kteří píší opravy pro Patroni. Doufám, že Patroni s věkem bude stále vyzrálejší, skvělejší a funkčnější. Již teď je funkční, ale doufám, že se to bude ještě zlepšovat. Proto, pokud plánujete použít Patroni, nebojte se. Je to dobré řešení, které lze implementovat a používat.
Na tom je vše. Pokud máte nějaké otázky, ptejte se.
Otázky
Děkuji za prezentaci! Pokud i po failoveru musíme znovu dávat pozor, proč tedy potřebujeme automatický failover?
Protože je to nová věc. Pracujeme s ní teprve rok. Je lepší se pojistit. Chceme se podívat a ujistit se, že všechno skutečně fungovalo tak, jak mělo. Je to úroveň dospělého nedůvěry – raději znovu zkontrolovat a podívat se.
Například, ráno jsme se podívali, že?
Ne ráno, obvykle se dozvídáme o auto failoveru prakticky okamžitě. Dostáváme upozornění, vidíme, že došlo k auto failoveru. Většinou se hned podíváme. Ale všechny tyto kontroly by měly být přesunuty na úroveň monitorování. Pokud se obrátíme na Patroni přes REST API, existuje historie. Podle historie můžeme sledovat časové značky, kdy došlo k failoveru. Na základě toho lze udělat monitorování. Můžeme sledovat historii, kolik tam bylo událostí. Pokud nám přibylo událostí, došlo k auto failoveru. Můžeme se podívat. Anebo naše automatizace v monitorování zkontrolovala, že všechny repliky jsou na místě, není žádné zpoždění a vše je v pořádku.
Děkuji!
Mockrát děkuji za skvělý příběh! Pokud jsme přesunuli DCS cluster někam daleko od Postgres clusteru, je nutné tento cluster také pravidelně udržovat? Jaké jsou osvědčené postupy, co se týká vypínání některých částí DCS clusteru, co s nimi dělat atd.? Jak v tomto případě funguje celá tato konstrukce? A jak tyto věci dělat?
Pro jednu společnost bylo nutné vytvořit matici problémů, co se stane, pokud některá nebo několik komponent vypadne. Na základě této matice postupně procházejíme všechny komponenty a stavíme scénáře pro případ poruchy těchto komponent. Na každý scénář poruchy lze mít plán pro obnovu. A v případě DCS to jde jako součást standardní infrastruktury. A admin to spravuje, a my už se spoléháme na adminy, kteří to spravují, a na jejich schopnosti to opravit v případě havárie. Pokud DCS vůbec není, nasazujeme ho my, ale přitom se o něj zvlášť nestaráme, protože za infrastrukturu neodpovídáme, ale dáváme doporučení, jak a co monitorovat.
To znamená, rozumím tomu správně, že je třeba vypnout Patroni, vypnout failover, vypnout vše, než něco uděláme s hostiteli?
To závisí na tom, kolik máme uzlů v DCS clusteru. Pokud je uzlů hodně a odstavení nastane jen u jednoho uzlu (repliky), zůstává v clusteru kvórum. A Patroni zůstává funkční. A nic se neaktivuje. Pokud máme nějaké složité operace, které zasahují více uzlů a jejichž absence může rozpadnout kvórum, pak ano, možná má smysl pozastavit Patroni. Má k tomu odpovídající příkaz – patronictl pause, patronictl resume. Jenom pozastavíme a automatické přepnutí (failover) se v tuto dobu nespustí. Provedeme údržbu na DCS clusteru, pak pauzu zrušíme a pokračujeme dál.
Moc děkuji!
Velmi děkuji za prezentaci! Jak se produktový tým staví k tomu, že data mohou být ztracena?
Produktovým týmům je to jedno, ale vůdcové týmů mají obavy.
Jaké jsou tam záruky?
Se zárukami je to velice obtížné. Je zde prezentace od Alexandra Kukuškina „Jak vypočítat RPO a RTO“, tj. čas obnovení a kolik dat můžeme ztratit. Myslím, že je potřeba tyto diapozitivy najít a prostudovat. Podle mých vzpomínek tam jsou konkrétní kroky, jak tyto věci vypočítat. Kolik transakcí můžeme ztratit, kolik dat můžeme ztratit. Jako variantu můžeme použít synchronní replikaci na úrovni Patroni, ale to je dvousečný meč: buď máme spolehlivost dat, nebo ztrácíme na rychlosti. Existuje synchronní replikace, ale ani ta nezaručuje 100% ochranu před ztrátou dat.
Alexei, děkuji za skvělou prezentaci! Máte zkušenosti s používáním Patroni pro ochranu na nulové úrovni? Tj. v kombinaci se synchronním standby? To je první otázka. A druhá otázka. Používali jste různá řešení. My jsme používali Repmgr, ale bez automatizovaného přepnutí a teď plánujeme implementaci automatizovaného přepnutí. Zvažujeme Patroni jako alternativní řešení. Co můžete říct jako výhody právě ve srovnání s Repmgr?
První otázka se týkala synchronních replik. U nás nikdo synchronní replikaci nepoužívá, protože se všichni bojí (Již ji používá několik klientů, problémy s výkonností obecně nezaznamenali — Poznámka přednášejícího). Pro sebe jsme si stanovili pravidlo, že v clusteru synchronní replikace musí být minimálně tři uzly, protože pokud máme dva uzly a pokud dojde k selhání masteru nebo repliky, Patroni převede tento uzel do režimu Standalone, aby aplikace mohla pokračovat v chodu. V tomto případě existují rizika ztráty dat.
Co se týče druhé otázky, použili jsme Repmgr a stále ho používáme u některých klientů z historických důvodů. Co lze říci? V Patroni je auto failover zabudovaný v základu, v Repmgr je auto failover dodatečná funkce, kterou je třeba zapnout. Je nutné spustit Repmgr daemon na každém uzlu a pak můžeme nastavit auto failover.
Repmgr kontroluje, zda jsou uzly Postgres živé. Procesy Repmgr kontrolují přítomnost jeden druhého, což není příliš efektivní přístup, protože mohou nastat složité případy síťové izolace, kdy se velký Repmgr cluster může rozpadnout na několik menších a přesto pokračovat v práci. Dlouho jsem nesledoval Repmgr, možná to opravili… nebo také ne. Přenášení informací o stavu clusteru do DCS, jak to dělá Stolon, Patroni, je nejživotaschopnější varianta.
Alexei, mám otázku, možná naivní. V jednom z prvních příkladů DCS jste přenesli z lokálního stroje na vzdálený uzel. Chápeme, že síť – to je věc, která má své zvláštnosti, žije sama o sobě. A co se stane, pokud se z nějakého důvodu cluster DCS stane nedostupným? Důvody zde nebudu rozebírat, může jich být spousta: od nešikovných síťařů po skutečné problémy.
Neřekl jsem to nahlas, ale cluster DCS by měl být také odolný proti chybám, tj. musí mít lichý počet uzlů, aby se mohla shromáždit kvorum. Co se stane, pokud se cluster DCS stane nedostupným, nebo se nemůže shromáždit kvorum, tj. nějaký síťový split nebo selhání uzlů? V tomto případě přechází cluster Patroni do režimu read only. Cluster Patroni nemůže určit stav clusteru a co by měl dělat. Nemůže se spojit s DCS a uložit tam nový stav clusteru, a proto celý cluster přechází do režimu read only. A čeká na ruční zásah operátora nebo až se DCS obnoví.
Jednoduše řečeno, DCS se pro nás stává službou stejně důležitou jako samotná databáze?
Ano, ano. V mnoha moderních společnostech je Service Discovery nedílnou součástí infrastruktury. Implementuje se dokonce dříve, než se v infrastruktuře objeví databáze. Řekněme, že jsme spustili infrastrukturu, rozvinuli se v datovém centru, a my už máme Service Discovery. Pokud je to Consul, může na něm být postaveno i DNS. Pokud je to Etcd, může to být část z clusteru Kubernetes, ve kterém bude rozvinuto vše ostatní. Mám pocit, že Service Discovery je už nedílnou součástí moderních infrastruktur. A o něm se přemýšlí mnohem dříve, než o databázích.
Děkuji!
Zdroj: habr.com
