

Pozn. přek.: autor tohoto článku (Luc Perkins) — developer advocate v organizaci CNCF, která je domovem pro open source projekty jako Linkerd, SMI (Service Mesh Interface) a Kuma (mimochodem, přemýšleli jste někdy, proč je v tomto seznamu chybí Istio?..). Znovu se snažím přinést do DevOps komunity lepší pochopení módního hype nazvaného „service mesh“ a uvádím 16 charakteristických vlastností, které tato řešení poskytují.
Dnes ― jedno z nejžhavějších témat v oblasti softwarového inženýrství (a právem!). Myslím, že tato technologie je neuvěřitelně perspektivní a sním, že budu svědkem jejího širokého rozšíření (samozřejmě, když to dává smysl). Nicméně, stále je obklopena aurou tajemství pro většinu lidí. Zatímco ti, kdo ji dobře znají, se často setkávají s obtížemi při formulaci jejích výhod a co vlastně představuje (včetně vašeho pokorného sluhy). V článku se pokusím napravit situaci tím, že vyjmenuji různé případy použití „service mesh“*.
* Pozn. red.: zde a dále v článku bude použit právě tento překlad („service mesh“) pro stále novou terminologii service mesh.
Ale nejprve chci udělat několik poznámek:
- Nikdy jsem nepracoval se service meshes a nepoužíval je mimo projekty, které jsem vytvořil pro své vlastní vzdělání. Na druhou stranu, právě já napsal spoustu dokumentace pro interní service mesh společnosti Twitter v roce 2015 (tehdy se to ještě ani neříkalo „service mesh“) a podílel jsem se na vývoji webu a dokumentace pro , takže to něco znamená.
- Můj seznam je orientační a neúplný. Jsou možné případy použití, které mi nejsou známy, a určitě v průběhu času vzniknou nové varianty, jak se technologie vyvíjí a roste její popularita.
- Zároveň ne každá existující implementace service mesh podporuje všechny uvedené případy použití. Proto by měla být má vyjádření jako „service mesh může…“ čtena jako „určité, a možná i všechny populární implementace service mesh mohou…“.
- Pořadí příkladů nemá žádný zvláštní význam.
Krátký seznam:
- objevování služeb;
- šifrování;
- autentizace a autorizace;
- vyvážení zátěže;
- circuit breaking;
- automatické škálování;
- kanárkové nasazení;
- blue-green nasazení;
- kontrola zdraví;
- load shedding;
- zrcadlení provozu;
- izolace;
- omezení frekvence požadavků, opakované pokusy a časové limity;
- telemetrie;
- audit;
- vizualizace.
1. Objevování služeb
TL;DR: Připojujte se k dalším službám v síti pomocí jednoduchých názvů.
Služby by měly být schopny automaticky "nalezeny" navzájem pomocí adekvátních názvů – například, service.api.production, pets/staging nebo cassandra. Cloudové prostředí se vyznačuje svou elastickostí, a za jedním názvem se může skrývat mnoho instancí služby. Je jasné, že v takové situaci není fyzicky možné zakódovat všechny IP adresy.
Kromě toho, když jedna služba najde jinou, musí být schopna zasílat požadavky této službě, aniž by se obávala, že skončí u nefunkční instance. Jinými slovy, service mesh by měl sledovat dostupnost všech instancí služeb a udržovat seznam hostitelů v maximálně aktuálním stavu.
Každá service mesh implementuje mechanizmus objevování služeb po svém. V současnosti je nejběžnějším způsobem delegace externím procesům jako je DNS Kubernetes. V minulosti jsme na Twitteru používali pro tyto účely systém názvů . Kromě toho technologie service mesh umožňuje vznik uživatelských mechanismů pojmenování (i když jsem ještě nenarazil na žádnou implementaci SM s takovou funkcionalitou).
2. Šifrování
TL;DR: Zbavte se nešifrovaného provozu mezi službami a ať je tento proces automatizovaný a škálovatelný.
Je příjemné vědět, že se útočníci nemohou dostat do vaší vnitřní sítě. Síťové brány si s tím skvěle poradí. Ale co se stane, pokud se hacker přece jen dostane dovnitř? Bude moci dělat s vnitřním provozem služby, co chce? Doufejme, že k tomu nedojde. Abychom tomu předešli, měli bychom implementovat síť s nulovým sklonem k důvěře (zero-trust), ve které je veškerý provoz mezi službami šifrován. Většina moderních service mesh dosahuje tohoto cíle pomocí vzájemného (mutual TLS, mTLS). V některých případech mTLS funguje v celých cloudových prostředích a clusterech (myslím si, že i meziplanetární komunikace budou jednou fungovat podobně).
Samozřejmě, pro mTLS service mesh není povinná.Každá služba se může postarat o svůj vlastní TLS, ale to znamená, že bude třeba najít způsob, jak generovat certifikáty, distribuovat je mezi hostitele služby a zahrnout do aplikace kód, který tyto certifikáty načte ze souborů. Nezapomeňte také na aktualizaci těchto certifikátů po určité době. Služební sítě automatizují mTLS pomocí systémů jako je , které zase automatizují proces vydávání a rotace certifikátů.
3. Autentizace a autorizace
TL;DR: Stanovte, kdo je iniciátorem požadavku, a určete, co mu je povoleno dělat ještě před tím, než požadavek dorazí k službě.
Služby často chtějí vědět, kdo kdo provádí požadavek (autentizace), a na základě těchto informací rozhodují, co co danému subjektu je povoleno provádět (autorizace). V tomto případě mohou za zájmenným „kdo“ stát:
- Jiné služby. Tomu se říká „autentizace peer“. Například služba
webchce získat přístup k službědb. Služební sítě obvykle řeší podobné problémy pomocí mTLS: certifikáty zde fungují jako nezbytný identifikátor. - Někteří uživatelé-lidé. Tomu se říká „autentizace požadavku. Například uživatel
haxor69chce koupit novou lampu. Služební sítě poskytují různé mechanismy, jako například .Mnozí z nás to dělali v kódu aplikace. Přijde požadavek, prohlédneme tabulku
users, najdeme uživatele a porovnáme heslo, poté zkontrolujeme sloupecpermissionsatd. V případě service mesh to probíhá ještě před tím, než požadavek dorazí k službě.
Jakmile jsme zjistili, od koho požadavek přišel, musíme určit, co danému subjektu je povoleno dělat. Některé service mesh umožňují definovat základní politiky (o tom, kdo a co může dělat) ve formě YAML souborů nebo v příkazovém řádku, zatímco jiné nabízejí integraci s rámcovými systémy jako je . Konečným cílem je dosáhnout toho, aby vaše služby přijímaly jakékoli požadavky, s důvěrou, že pocházejí z důvěryhodného zdroje a činnost je povolena.
4. Vyvažování zátěže
TL;DR: Rozdělujte zátěž mezi instance služby podle určitého vzoru.
Služba v rámci servisního sektoru se velmi často skládá z mnoha identických instancí. Například dnes služba cache obsahuje 5 kopií, a zítra se jejich počet může zvýšit na 11. Požadavky směřující do cache, by měly být rozděleny podle určitého cíle. Například minimalizovat latenci nebo maximalizovat pravděpodobnost dostat se k funkční instanci. Nejčastěji se používá algoritmus round-robin, ale existuje také mnoho dalších — například metoda vážených (weighted) požadavků (můžete vybrat preferované cíle), ring (ring) hashing (použití konzistentního hashování pro upstream hostitele) nebo metoda s nejmenším počtem požadavků (upřednostňuje instance s nejmenším počtem požadavků).
Klasické vyvažovače mají i další funkce, jako je HTTP caching a ochrana před DDoS, ale ty nejsou příliš relevantní pro traffic typu east-west (t.j. pro traffic běžící v rámci datového centra — pozn. překl.). Samozřejmě, není nutné používat service mesh pro vyvažování zátěže, avšak umožňuje nastavit a řídit politiky vyvažování pro každou službu z centralizované řídicí vrstvy, čímž eliminuje potřebu spouštět a konfigurovat samostatné vyvažovače v síťovém stacku.
5. Přerušení okruhu (circuit breaking)
TL;DR: Zastavte traffic k problémové službě a kontrolujte škody v nejhorších scénářích.
Pokud si z nějakého důvodu služba neporadí s trafficem, service mesh poskytuje několik možností, jak tento problém vyřešit (o dalších bude řeč v odpovídajících sekcích). Circuit breaking je nejtvrdší variantou odpojení služby od trafficu. Nicméně sama o sobě nemá smysl — je nezbytný záložní plán. Může být zajištěn proti tlak () na služby, které provádějí požadavky (nezapomeňte však svou service mesh pro to nakonfigurovat!), nebo například barvení stavové stránky na červenou a přesměrování uživatelů na alternativní verzi stránky s 'padajícím velrybou' ('Twitter is down').
Service mesh umožňuje nejen určovat, kdy dojde k odpojení a co Tímto se pokračuje. V tomto případě "kdy" může zahrnovat jakoukoli kombinaci zadaných parametrů: celkový počet požadavků za určité období, počet paralelních připojení, čekající požadavky, aktivní pokusy o opakování atd.
Pravděpodobně nebudete chtít zneužívat circuit breaking, ale je dobré vědět, že existuje záložní plán pro případ nouze.
6. Automatické škálování
TL;DR: Zvyšujte nebo snižujte počet instancí služby podle zadaných kritérií.
Service mesh není plánovač, a proto ne provádí škálování samostatně. Mohou však poskytovat informace, na jejichž základě plánovače přijímají rozhodnutí. Protože service mesh má přístup ke všemu provozu mezi službami, disponují rozsáhlými informacemi o tom, co se děje: které služby mají problémy, které jsou slabě zatíženy (vyčleněné prostředky jsou plýtvány) atd.
Například Kubernetes škáluje služby na základě využívání CPU a paměti pod. (viz náš referát "“ — pozn. překl.)", ale pokud se rozhodnete provádět škálování na základě jakéhokoli jiného ukazatele (v našem případě spojeného s provozem), budete potřebovat speciální metriky. Návod ukazuje, jak to udělat pomocí , a , ale samotný proces je poměrně složitý. Chtěli bychom, aby service mesh to zjednodušila, umožnila jednoduše zadat podmínky, jako je "zvyšte počet instancí služby auth, pokud počet čekajících požadavků překročí prahovou hodnotu během jedné minuty".
7. Kanárková nasazení
TL;DR: Testujte nové funkce nebo verze služby na podmnožině uživatelů.
Představme si, že vyvíjíte nějaký SaaS produkt a plánujete vydat jeho novou skvělou verzi. Testovali jste ji na stagingu a fungovala skvěle. Přesto vás však sužují určité obavy ohledně jejího chování v reálných podmínkách. Jinými slovy, je třeba novou verzi ověřit na skutečných úkolech, aniž byste riskovali důvěru uživatelů. Kanárkové nasazení je pro to skvělé. Umožňuje představit novou funkci určitému podmnožství uživatelů. Toto podmnožství může zahrnovat nejvěrnější uživatele nebo ty, kteří používají bezplatnou verzi produktu, nebo uživatele, kteří vyjádřili přání být "laboratorními krysami".
Service mesh umožňuje určit kritéria, která definují, kdo a jakou verzi aplikace uvidí, a příslušně směrovat provoz. Pro samotné služby se nic nemění. Verze 1.0 služby předpokládá, že všechny požadavky pocházejí od uživatelů, kteří ji mají vidět, zatímco verze 1.1 má stejnou domněnku o svých uživatelích. A vy mezitím můžete měnit procento provozu mezi starou a novou verzí, přesměrováním rostoucího počtu uživatelů na novou, pokud funguje stabilně a vaši "laboratorní králíci" dávají souhlas.
8. Modro-zelená nasazení
TL;DR: Vypusťte novou skvělou funkci, ale buďte připraveni okamžitě vrátit vše zpět.
Podstata spočívá v tom, že vypustíte nový "modrý" servis, který spustíte paralelně se starým, "zeleným". Pokud vše půjde hladce a nový servis se osvědčí, starý můžete postupně vypnout. (Bohužel, i tento nový "modrý" servis jednou potká osud "zeleného" a zmizí…) Modro-zelená nasazení se liší od kanárkových tím, že nová funkce pokrývá hned všechny uživatele (ne jen část); smyslem zde je mít k dispozici "záložní přístav", pokud by se náhodou něco pokazilo.
Service mesh nabízí velmi pohodlný způsob, jak testovat modrou službu a okamžitě přepnout na funkční zelenou v případě problémů. Nemluvě o tom, že zároveň poskytují spoustu informací (viz bod „Telemetrie“ níže) o výkonu modré, které pomáhají pochopit, zda je připravena na plnohodnotný provoz.
Pozn. přek.: Více o různých strategiích nasazení v Kubernetes (včetně zmíněných canary, blue/green a dalších) si můžete přečíst na .
9. Kontrola zdraví
TL;DR: Sledujte, které instance služeb jsou funkční, a reagujte na ty, které přestanou být.
Kontrola zdraví (health check) pomáhá rozhodnout, zda jsou instance služby připraveny přijímat a zpracovávat provoz. Například v případě HTTP služeb může kontrola zdraví vypadat jako GET žádost na endpoint /health. Odpověď 200 OK bude znamenat, že instance je zdravá, jakákoli jiná znamená, že není připravena přijímat provoz. Service mesh umožňuje specifikovat jak způsob, jakým bude testována funkčnost, tak i frekvenci, s jakou bude tato kontrola prováděna. Tyto informace lze poté použít pro další účely — například pro vyvažování zatížení a circuit breaking.
Tímto způsobem se kontrola zdraví neobjevuje jako samostatný scénář použití, ale obvykle slouží k dosažení jiných cílů. Také, v závislosti na výsledcích health checků, mohou být vyžadovány externí (vzhledem k dalším cílům služebních sítí) akce: například aktualizovat stavovou stránku, vytvářet issue na GitHubu nebo vypisovat ticket v JIRA. A service mesh nabízí pohodlný mechanismus pro automatizaci všech těchto procesů.
10. Přesměrování zátěže (load shedding)
TL;DR: Přesměrovávejte provoz v reakci na dočasný nárůst v používání.
Pokud je nějaká služba přetížena provozem, můžete dočasně přesměrovat část tohoto provozu jinam (tedy „snížit“, „přečerpat“ (shed) to tam). Například do záložní služby nebo datového centra, nebo do stálého Téma. V důsledku toho služba bude nadále zpracovávat část požadavků místo toho, aby selhala a přestala zpracovávat všechny. Vyrovnávání zátěže je preferovanější než přerušení řetězce, ale stále je nežádoucí tímto způsobem zbytečně zneužívat. Umožňuje předejít kaskádovým selháním, díky nimž selhávají downstream služby.
11. Paralelizace/zrcadlení provozu
TL;DR: Odesílejte jeden požadavek na více míst současně.
Někdy je nutné odeslat požadavek (nebo určité podmnožiny požadavků) současně na více služeb. Typickým příkladem je odeslání části produkčního provozu do stagingové služby. Hlavní webový server produkce odesílá požadavek dolní službě products.production a pouze jí. A service mesh inteligentně kopíruje tento požadavek a odesílá ho na products.staging, o čemž webový server ani netuší.
Další související scénář využití service mesh, který lze realizovat na základě paralelizace provozu, je . To zahrnuje odesílání stejných požadavků různým verzím služby a kontrolu toho, zda se všechny verze chovají stejně. Doposud jsem se nesetkal s implementací service mesh s integrovaným systémem regresního testování, jako je , ale samotná myšlenka se zdá být perspektivní.
12. Izolace
TL;DR: Rozdělte svou service mesh na mini-sítě.
Také známé jako segmentace, izolace je umění rozdělení service mesh na logicky oddělené segmenty, které o sobě nic nevědí. Izolace je poněkud podobná vytváření virtuálních privátních sítí. Hlavní rozdíl však spočívá v tom, že můžete i nadále využívat všechny výhody service mesh (jako je objevování služeb), ale s dodatečnou bezpečností. Například, pokud se útočník dostane do služby v jedné z podsítí, nebude schopný vidět, jaké služby běží v jiných podsítích, ani zachytit jejich provoz.
Kromě toho mohou existovat i organizační výhody. Možná budete chtít rozdělit služby na podsítě podle struktury společnosti a zbavit vývojáře kognitivní zátěže způsobené potřebou mít na paměti celou service mesh.
13. Omezení frekvence požadavků, opětovné pokusy a časové limity
TL;DR: Už není třeba zahrnovat do kódu aktuální úkoly spojené s řízením požadavků.
Všechny tyto věci by se daly vnímat jako jednotlivé případy použití, ale rozhodl jsem se je sloučit kvůli jedné společné vlastnosti: přebírají na sebe úkoly řízení životního cyklu požadavků, které obvykle zpracovávají aplikační knihovny. Pokud vyvíjíte webový server na Ruby on Rails (neintegrovaný se service mesh), který provádí požadavky na backendové služby prostřednictvím , aplikace se bude muset sama rozhodnout, co dělat, pokud N požadavků selže. Také bude třeba zjistit, jaký objem provozu tyto služby dokážou zpracovat a 'hardcodovat' tyto parametry pomocí speciální knihovny. Kromě toho se aplikace bude muset rozhodnout, kdy je čas se vzdát a nechat požadavek vypršet (podle timeoutu). A k tomu, aby bylo možné změnit jakýkoli z výše uvedených parametrů, bude nutné webový server zastavit, rekonfigurovat a znovu spustit.
Přenesení těchto úkolů na service mesh znamená nejen to, že vývojáři služeb se o ně nebudou muset starat, ale také to, že je lze vnímat z širšího pohledu. Pokud je použita složitá řetězová struktura služeb, například A -> B -> C -> D -> E, je nutné vzít v úvahu celý životní cyklus požadavku. Pokud je cílem prodloužit time-outy ve službě C, je logické udělat to vše najednou, a ne po částech: aktualizovat kód služby a čekat, až bude pull request přijat a CI systém nasadí aktualizovanou službu.
14. Telemetrie
TL;DR: Sbírejte všechny potřebné (i nepotřebné) informace od služeb.
Telemetrie je obecný termín zahrnující metriky, distribuované trasování a logy. Service mesh nabízí mechanismy pro sběr a zpracování všech tří typů dat. Zde se situace trochu komplikuje, protože počet možných variant je příliš velký. Pro sběr metrik existují a další nástroje, pro sběr logů lze použít , , atd. (například ClickHouse s naším pro K8s – pozn. překl.), pro distribuované trasování existují atd. Každá service mesh může podporovat jedny nástroje a nepodporovat jiné. Bude zajímavé sledovat, zda projekt zajistí nějakou konvergenci.
V tomto případě je výhodou technologie service mesh ta, že sidecar kontejnery mohou v zásadě shromažďovat všechna výše uvedená data ze svých služeb. Jinými slovy, máte k dispozici jednotný systém sběru telemetrie a service mesh může zpracovávat všechny tyto informace různými způsoby. Například:
- sledovat logy z nějaké služby v CLI;
- sledovat objem požadavků z monitorovacího panelu service mesh;
- shromažďovat distribuované stopy a přesměrovávat je do systému jako Jaeger.
Pozor, subjektivní názor: Obecně platí, že telemetrie je ta oblast, do které je silné zasahování service mesh nežádoucí. Sběr základních informací a sledování v reálném čase některých "zlatých metrik" jako je procento úspěšných požadavků a latence je v pořádku, ale doufejme, že se nestaneme svědky vzniku jakýchsi Frankenstein-stacků, které se pokusí nahradit specializované systémy, z nichž některé se již osvědčily a byly dobře prozkoumány.
15. Audit
TL;DR: Ten, kdo zapomíná lekce historie, je odsouzen je opakovat.
Audit je umění sledování důležitých událostí v systému. V případě service mesh to může znamenat sledování toho, kdo prováděl požadavky na konkrétní endpointy určitých služeb nebo kolikrát za poslední měsíc došlo k určité události týkající se bezpečnosti.
Je jasné, že audit je velmi úzce spojen s telemetrií. Rozdíl však spočívá v tom, že telemetrie obvykle souvisí s takovými věcmi, jako je výkon a technická účelnost, zatímco audit může mít vztah k právním a dalším otázkám přesahujícím přísně technickou sféru (například dodržování GDPR – Obecného nařízení o ochraně údajů EU).
16. Vizualizace
TL;DR: Ať žije React.js – nevyčerpatelný zdroj skvostných rozhraní.
Možná existuje vhodnější termín, ale ten neznám. Mám na mysli grafické zobrazení service mesh nebo jejích některých komponent. Tyto vizualizace mohou zahrnovat ukazatele, jako jsou průměrné latence, informace o konfiguraci sidecar kontejnerů, výsledky kontrol zdraví a upozornění.
Práce v prostředí zaměřeném na služby s sebou nese mnohem větší kognitivní zátěž ve srovnání s Jeho Veličenstvem Monolitem. Proto by mělo být kognitivní zatížení snižováno za každou cenu. Banální grafické rozhraní pro service mesh s možností kliknutí na tlačítko a získání požadovaného výsledku může mít rozhodující význam pro nárůst popularity této technologie.
Nebyl zařazen na seznam
Původně jsem měl v úmyslu zahrnout na seznam ještě několik scénářů použití, ale nakonec jsem se rozhodl to neudělat. Zde jsou spolu s důvody mého rozhodnutí:
- Multi-datacentrum. V mém pojetí to není tolik scénář použití, kolik úzká a konkrétní oblast aplikace servisních sítí nebo nějaké sady funkcí jako například detekce služeb.
- Ingress a egress. To je související oblast, ale omezil jsem se (možná uměle) scénářem použití „east-west traffic“. Ingress a egress si zaslouží samostatný článek.
Závěr
Na tomto místě je to zatím vše! Znovu říkám, že tento seznam je velmi podmíněný a pravděpodobně neúplný. Pokud máte pocit, že jsem něco přehlédl, nebo se v něčem mýlil, kontaktujte mě na Twitteru (). Prosím, dodržujte pravidla slušnosti.
P.S. od překladatele
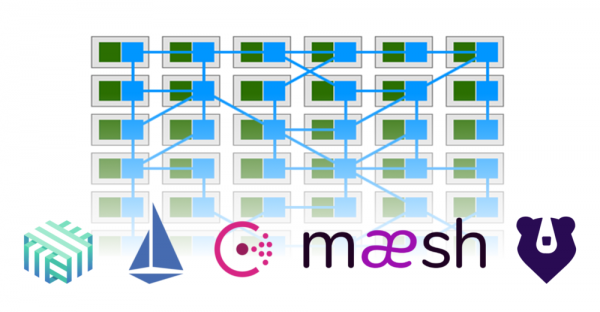
Jako základ pro úvodní ilustraci článku bylo použito obrázku z článku „“ (autor — Gregory MacKinnon). Na něm je znázorněno, jak část funkcionality z aplikací (zelenou barvou) přešla k service mesh, která zajišťuje jejich vzájemné vztahy (modrou barvou).
Přečtěte si také náš blog:
- «»;
- «»;
- «».
Zdroj: habr.com
