

Minuly jsou doby, kdy bylo zbytečné se obávat optimalizace výkonu databází. Čas nečeká. Každý nový podnikatel v oblasti vysokých technologií chce vytvořit další Facebook, přičemž se snaží shromáždit všechna data, která je možné získat. Tato data jsou pro podnikání nezbytná pro kvalitnější trénink modelů, které pomáhají generovat zisk. V takových podmínkách musí programátoři vytvářet API, která umožňují rychlou a spolehlivou práci s obrovskými objemy informací.
Pokud jste již nějakou dobu zaměřeni na návrh serverových částí aplikací nebo databází, pravděpodobně jste psali kód pro provádění dotazů s stránkováním. Například takto:
SELECT * FROM table_name LIMIT 10 OFFSET 40
Je to tak?
Ale pokud jste stránkování prováděli právě takto, musím s politováním konstatovat, že jste to dělali daleko neúčinnějším způsobem.
Chcete mi oponovat? . , a už využívá techniky, o kterých chci dnes hovořit.
Uveďte alespoň jednoho backendového vývojáře, který nikdy nepoužil OFFSET a LIMIT pro provádění dotazů s stránkováním. V MVP (Minimum Viable Product, minimální životaschopný produkt) a v projektech, kde se používají malé objemy dat, je tento přístup zcela aplikovatelný. Funguje, dá se říci, „jednoduše“.
Ale pokud je potřeba od nuly vytvářet spolehlivé a efektivní systémy, je dobré se předem postarat o efektivitu provádění dotazů na databáze používané v takových systémech.
Dnes budeme hovořit o problémech spojených s široce používanými (je škoda, že je to tak) implementacemi mechanismů provádění dotazů se stránkováním a o tom, jak dosáhnout vysokého výkonu při plnění podobných dotazů.
Co je špatně s OFFSET a LIMIT?
Jak již bylo řečeno, OFFSET a LIMIT se skvěle osvědčují v projektech, kde není nutné pracovat s velkými objemy dat.
Problém nastává, pokud se databáze rozroste do takové velikosti, že přestává být schopna se vejít do paměti serveru. Přitom je však během práce s touto databází třeba používat dotazy se stránkováním.
Aby se tento problém projevil, je nutné, aby vznikla situace, ve které SDB provádí neefektivní operaci úplného prohledávání tabulky (Full Table Scan) při vykonávání každého dotazu s rozdělením na stránky (mezi tím mohou probíhat operace vkládání a odstraňování dat a zastaralá data jsou nám přitom nepotřebná!).
Co je to „úplné prohledávání tabulky“ (nebo „sekvenční prohlížení tabulky“, Sequential Scan)? Je to operace, při které SDB sekvenčně čte každou řádku tabulky, tedy — data, která obsahuje, a ověřuje je podle zadané podmínky. Je známo, že tento typ prohledávání tabulek je nejpomalejší. Důvodem je, že během jeho provádění je vykonáno mnoho operací vstupu/výstupu, které zatěžují diskový subsystém serveru. Situaci zhoršují zpoždění spojená s prací s daty uloženými na discích a to, že přenos dat z disku do paměti — je operace náročná na zdroje.
Například máte zápisy o 100000000 uživatelích a provádíte dotaz s konstrukcí OFFSET 50000000. To znamená, že SDB bude muset načíst všechna tato data (až je vůbec nepotřebujeme!), umístit je do paměti a teprve potom vzít, dejme tomu, 20 výsledků, o kterých je zmínka v LIMIT.
Řekněme, že to může vypadat takto: „vybrat řádky od 50000 do 50020 z 100000“. To znamená, že systému pro vykonání dotazu bude nejprve muset načíst 50000 řádků. Vidíte, kolik zbytečné práce bude muset udělat?
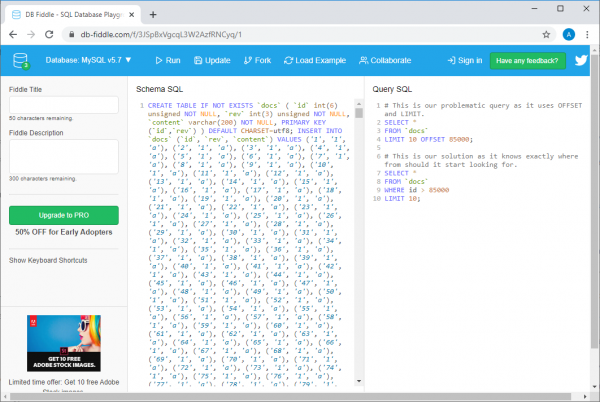
Pokud nevěříte — podívejte se na příklad, který jsem vytvořil pomocí možností .
Příklad na db-fiddle.com
Tam vlevo v poli Schema SQL, je kód, který provádí vložení do databáze 100000 řádků, a vpravo v poli Query SQL, jsou zobrazeny dva dotazy. První, pomalý, vypadá takto:
SELECT *
FROM `docs`
LIMIT 10 OFFSET 85000;
A druhý, který představuje efektivní řešení téhož úkolu, takto:
SELECT *
FROM `docs`
WHERE id > 85000
LIMIT 10;
Pro vykonání těchto dotazů stačí stisknout tlačítko Spustit v horní části stránky. Tímto způsobem porovnáme údaje o čase vykonávání dotazů. Ukazuje se, že vykonání neefektivního dotazu trvá alespoň 30krát déle než vykonání druhého (od spuštění ke spuštění se tento čas liší, například systém může uvést, že vykonání prvního dotazu trvalo 37 ms, zatímco vykonání druhého – 1 ms).
A pokud bude dat ještě více, bude to vypadat ještě hůře (abyste se o tom přesvědčili – podívejte se na můj s 10 miliony řádky).
To, co jsme právě probrali, by vám mělo poskytnout určité porozumění toho, jak se vlastně zpracovávají dotazy na databáze.
Mějte na paměti, že čím vyšší je hodnota OFFSET — tím déle bude dotaz vykonáván.
Co se vyplatí použít místo kombinace OFFSET a LIMIT?
Místo kombinace OFFSET a LIMIT se vyplatí použít konstrukci, založenou na následující schématu:
SELECT * FROM table_name WHERE id > 10 LIMIT 20
Jedná se o provádění dotazu s paginací založenou na kurzoru (Cursor based pagination).
Místo toho, abyste lokálně uchovávali aktuální OFFSET a LIMIT a předávali je s každým dotazem, je třeba uchovávat poslední získaný primární klíč (obvykle je to ID) a LIMIT, výsledné dotazy budou připomínat výše uvedené.
Proč? Je to proto, že pokud explicitně uvedete identifikátor posledního přečteného řádku, informujete svou DBMS o tom, kde má začít hledat potřebná data. A díky použití klíče bude hledání efektivní, systém se nemusí rozptylovat řádky, které leží mimo uvedený rozsah.
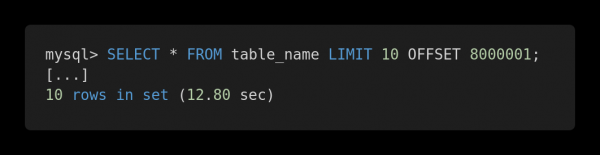
Podívejme se na následující porovnání výkonnosti různých dotazů. Tady je neefektivní dotaz.
Pomalý dotaz
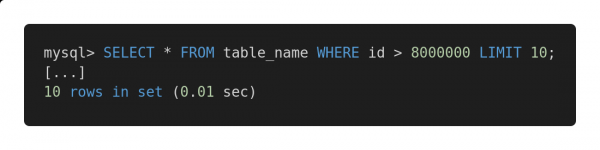
A tady je optimalizovaná verze tohoto dotazu.
Rychlý dotaz
Oba dotazy vracejí přesně stejný objem dat. Ale vykonání prvního trvá 12,80 sekundy, zatímco druhého – 0,01 sekundy. Cítíte ten rozdíl?
Možné problémy
Pro efektivní fungování navržené metody provádění dotazů je důležité, aby v tabulce byl přítomen sloupec (nebo sloupce), obsahující unikátní, sekvenčně uspořádané indexy, jako je celočíselný identifikátor. V některých specifických případech to může určovat úspěch používání takových dotazů pro zrychlení práce s databází.
Samozřejmě, při konstruování dotazů je třeba brát v úvahu zvláštnosti architektury tabulek a vybírat ty mechanismy, které se nejlépe osvědčí na existujících tabulkách. Například, pokud potřebujete pracovat v dotazech s velkými objemy souvisejících dat, může vás zajímat článek.
Pokud čelíme problému absence primárního klíče, například pokud existuje tabulka s vztahem „mnoho k mnoha“, pak tradiční přístup, který zahrnuje použití OFFSET a LIMIT, nám zaručeně vyhovuje. Ale jeho použití může vést k vykonávání potenciálně pomalých dotazů. V takových případech bych doporučil použít primární klíč s automatickým inkrementem, i když je potřebný pouze pro organizaci provádění dotazů s stránkováním.
Pokud vás tato téma zajímá — , a — několik užitečných materiálů.
Závěry
Hlavní závěr, který můžeme učinit, je ten, že vždy, bez ohledu na velikost databází, je potřeba analyzovat rychlost provádění dotazů. V dnešní době je mimořádně důležitá škálovatelnost řešení, a pokud již na začátku práce na nějakém systému dobře navrhneme vše, může to v budoucnu ušetřit vývojářovi spoustu problémů.
Jak analyzujete a optimalizujete dotazy na databáze?
Zdroj: habr.com
