

Jelikož je ClickHouse specializovaný systém, je při jeho používání důležité zohlednit specifika jeho architektury. V této prezentaci Alexej představí příklady typických chyb při používání ClickHouse, které mohou vést k neefektivnímu výkonu. Na příkladech z praxe bude ukázáno, jak může výběr určitého zpracovatelského schématu změnit výkon o řády.
Ahoj všichni! Jmenuji se Alexej a dělám ClickHouse.
Za prvé, okamžitě vás chci potěšit, dnes vám nebudu říkat, co je ClickHouse. Upřímně, už mě to nebaví. Každý rok to říkám. A pravděpodobně už to všichni ví.
Místo toho budu hovořit o tom, jaké jsou možné nástrahy, tedy jak lze ClickHouse používat nesprávně. Ve skutečnosti se není čeho bát, protože vyvíjíme ClickHouse jako systém, který je jednoduchý, pohodlný, a který funguje okamžitě. Instalujete a žádné problémy.
I tak je třeba brát v úvahu, že tento systém je specializovaný a snadno můžete narazit na neobvyklý scénář použití, který tuto systém dostane z komfortní zóny.
Takže, jaké jsou ty nástrahy? Hlavně budu hovořit o zřejmých věcech. Všichni to vidí jako jasné, všichni chápou a mohou se radovat, že jsou tak chytří, a ti, kteří nerozumí, se dozvědí něco nového.
První a velmi jednoduchý příklad, který, bohužel, často nastává, je velké množství insertů s malými batchi, tedy velké množství malých insertů.
Pokud zvažujeme, jak ClickHouse provádí insert, můžete poslat za jeden dotaz klidně i proud dat až na terabajt. To není problém.
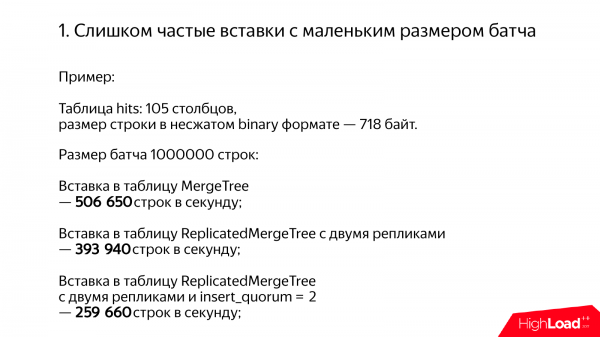
A podívejme se, jaký bude typický výkon. Například máme tabulku s daty z Yandex.Metriky. Hity. 105 různých sloupců. 700 bajtů v nezašifrované podobě. A budeme vkládat hezky po jednom milionu řádků.
Vkládáme do tabulky MergeTree, dostáváme půl milionu řádků za sekundu. Skvělé. Do replikované tabulky – bude to o něco méně, přibližně 400 000 řádků za sekundu.
A pokud zapneme kvórumový insert, dostaneme o něco méně, ale pořád slušný výkon, 250 000 řádků za sekundu. Kvórumový insert – to je nedokumentovaná možnost v ClickHouse*.
* k datu 2020, .
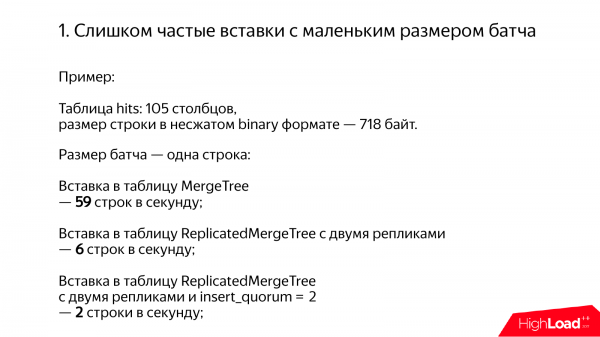
Co se stane, když se to pokazí? Vkládáme řádek po řádku do tabulky MergeTree a dostáváme 59 řádků za sekundu. To je 10 000krát pomalejší. V ReplicatedMergeTree je to 6 řádků za sekundu. A pokud se zapne quorum, dostáváme se na 2 řádky za sekundu. Podle mě je to naprostý průšvih. Jak je vůbec možné takto zpomalit? Dokonce mám na tričku napsáno, že ClickHouse by neměl zpomalovat. Ale občas se to stává.
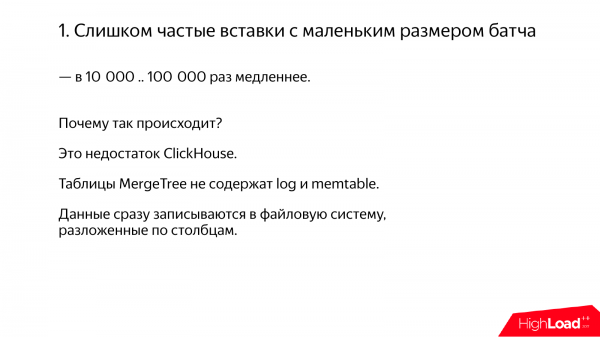
Ve skutečnosti – to je naše selhání. Mohli jsme to zařídit tak, aby všechno fungovalo normálně, ale neudělali jsme to. A neudělali jsme to proto, že pro náš scénář to nebylo nutné. Už jsme měli dávky. Prostě k nám přicházely dávky a žádné problémy. Vkládáme a vše funguje normálně. Ale samozřejmě mohou nastat různé scénáře. Například když máte spoustu serverů, na kterých se generují data. A ta data se vkládají ne tak často, ale přesto dochází k častým vkládáním. A je potřeba tomu nějak zabránit.
Z technického hlediska je podstatou to, že když provádíte insert v ClickHouse, data nedocházejí do žádného memtable. Nemáme ani skutečný log structure MergeTree, ale jen MergeTree, protože nemáme ani log, ani memTable. Data zapisujeme přímo do souborového systému, už rozložená do sloupců. A pokud máte 100 sloupců, budete muset zapsat více než 200 souborů do samostatného adresáře. To je dost objemné.
A vzniká otázka: „Jak to dělat správně?“, pokud nastane situace, že je potřeba nějakým způsobem zapisovat data do ClickHouse.
Metoda 1. To je nejjednodušší způsob. Použít nějakou distribuovanou frontu. Například Kafka. Prostě vytáhnete data z Kafky, dávkujete je jednou za sekundu. A všechno bude v pořádku, zapisujete, všechno funguje.
Nevýhodou je, že Kafka je další objemný distribuovaný systém. Ještě chápu, pokud už máte Kafku ve firmě. To je dobré, to je pohodlné. Ale pokud ji nemáte, je dobré třikrát přemýšlet, než ji přinesete do svého projektu. A proto stojí za to zvážit alternativy.
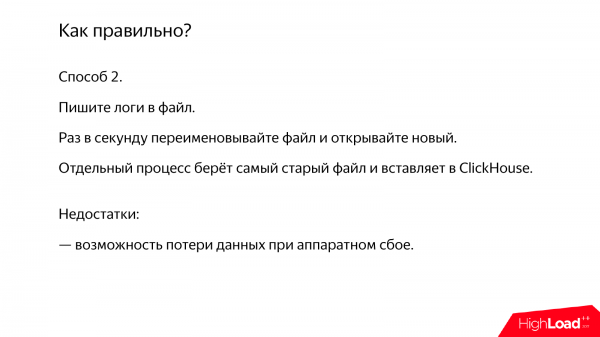
Způsob 2. Tohle je taková oldschoolová alternativa, která je velmi jednoduchá. Máte server, který generuje vaše logy. Ten pak zapisuje vaše logy do souboru. A jednou za sekundu, například, tento soubor přejmenujete a otevřete nový. A samostatný skript, buď podle cronu, nebo nějaký démon, vezme nejstarší soubor a zapíše ho do ClickHouse. Pokud zapisujete logy jednou za sekundu, vše bude skvělé.
Ale nevýhodou tohoto způsobu je, že pokud váš server, na kterém se logy generují, někam zmizí, také zmizí data.
Způsob 3. Existuje ještě jeden zajímavý způsob, který vůbec nevyžaduje dočasné soubory. Například máte nějakou reklamní smyčku nebo jiného zajímavého démona, který generuje data. Můžete hromadit množství dat přímo v paměti, v bufferu. A když uplyne dostatek času, tento buffer odložíte na stranu, vytvoříte nový a v samostatném vlákně, co se již nashromáždilo, vložíte do ClickHouse.
Na druhé straně data také zmizí při kill -9. Pokud váš server spadne, tato data ztratíte. A také je problém, že pokud se vám nepodaří zapsat do databáze, data se vám budou hromadit v paměti. A buď dojde paměť, nebo jednoduše ztratíte data.
Způsob 4. Další zajímavý způsob. Máte nějaký serverový proces. A ten může posílat data do ClickHouse okamžitě, ale dělat to v jednom spojení. Například poslal http-žádost s transfer-encoding: chunked s insertem. A generuje chunk-y již ne příliš zřídka, můžete posílat každý řádek, i když bude mít overhead na rámcování těchto dat.
Ale přesto v tomto případě budou data odeslána do ClickHouse okamžitě. A ClickHouse si je sám bude bufferovat.
Ale také vznikají problémy. Nyní ztratíte data, a to i v případě, že váš proces se zabije, a pokud se proces ClickHouse zabije, protože to bude nedokončený insert. A v ClickHouse jsou inserts atomické do určitého stanoveného prahu v počtu řádků. V zásadě je to zajímavý způsob. Může se také používat.
Způsob 5. Tady je další zajímavý způsob. Je to jakýsi komunitou vyvinutý server pro dávkování dat. Sám jsem se na to nedíval, takže nemohu nic zaručit. Nicméně ani pro samotný ClickHouse nejsou poskytovány žádné záruky. Je to také open source, ale na druhou stranu jste si mohli zvyknout na určitý standard kvality, který se snažíme zajistit. O této funkci však nevím, zkuste se podívat na GitHub, podívejte se na kód. Možná tam napsali něco rozumného.
* k datu 2020 je také třeba vzít v úvahu .
Způsob 6. Dalším způsobem je použití Buffer tabulek. Výhodou tohoto způsobu je, že je velmi jednoduché začít je používat. Vytvoříte Buffer tabulku a vložíte do ní data.
Nevýhodou je, že problém není vyřešen úplně. Pokud při vkládání typu MergeTree musíte seskupovat data po jednom dávce za sekundu, pak při vkládání do buffer tabulky potřebujete seskupit alespoň do několika tisíců za sekundu. Pokud to bude více než 10 000 za sekundu, nebude to i tak dobré. A pokud vkládáte dávkami, pak jste viděli, že tam to může být sto tisíc řádků za sekundu. A to už na dost těžkých datech.
A také buffer tabulky nemají log. A pokud se s vaším serverem něco pokazí, data mohou být ztracena.
A jako bonus nám nedávno v ClickHouse přibyla možnost čerpat data z Kafka. Existuje stroj tabulek – Kafka. Stačí, když vytvoříte. A na to můžete připevnit materializované pohledy. V tomto případě si sám vyjme data z Kafka a vloží je do požadovaných tabulek.
A obzvlášť potěšující na této možnosti je, že ji nedělali my. Je to funkce komunity. A když říkám "funkce komunity", nemám na mysli jakékoli pohrdání. Kód jsme přečetli, provedli jsme kontrolu, mělo by to fungovat normálně.
* k datu 2020 byla k dispozici obdobná podpora pro .
Co může být ještě nepohodlné nebo překvapivé při vkládání dat? Pokud provádíte dotaz insert values a v values uvádíte nějaké vypočítané výrazy. Například now() – to je také vypočítaný výraz. A v tomto případě ClickHouse musí na každém řádku spustit interpretátor těchto výrazů a výkon se výrazně sníží. Je lepší se tomu vyhnout.
* v současné době je problém plně vyřešen, regresní problémy s výkonem při použití výrazů v VALUES již neexistují.
Další příklad, kdy mohou nastat určité problémy, je, když máte na jednom batchi data vztahující se k mnoha partition. Ve výchozím nastavení má ClickHouse partition podle měsíců. A pokud vkládáte batch o milionu řádcích, které pokrývají několik let, bude tam několik desítek partition. A to se rovná tomu, že budou batchi o několik desítek menší velikosti, protože se vždy nejprve dělí podle partition.
* nedávno byla v ClickHouse v experimentálním režimu přidána podpora kompaktního formátu bloků a bloků v paměti s write-ahead log, což téměř úplně vyřešilo problém.
Nyní se podívejme na druhý typ problému – typizace dat.
Typizace dat může být přísná a také může být řetězcová. Řetězcová znamená, že jste prostě vzali a deklarovali, že všechny vaše pole jsou typu string. To je špatně. Takto to dělat není dobré.
Pojďme si ukázat, jak to správně udělat v případech, kdy chcete říct, že nějaké pole máme jako řetězec, a nechť ClickHouse se s tím už sám vypořádá, ale přesto je třeba vynaložit určité úsilí.
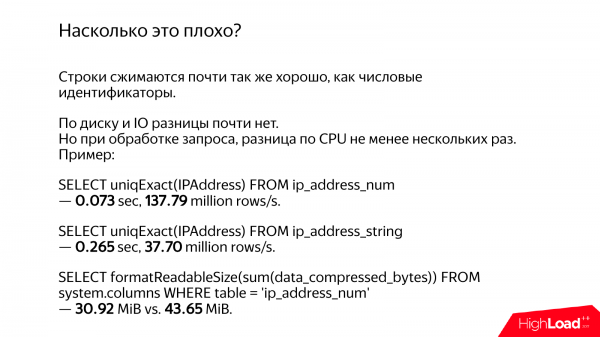
Například máme IP adresu. V jednom případě jsme ji uložili jako řetězec. Například 192.168.1.1. A v jiném případě to bude číslo typu UInt32*. 32 bitů stačí pro IPv4 adresu.
Za prvé, jak se to divně nezdá, data se budou komprimovat přibližně stejným způsobem. Samozřejmě budou rozdíly, ale ne tak velké. Takže z hlediska diskového vstupu a výstupu nejsou žádné zásadní problémy.
Ale je tu značný rozdíl v procesorovém čase a v čase vykonávání dotazu.
Spočítejme počet unikátních IP adres, pokud jsou uchovávány jako čísla. To vychází na 137 milionů řádků za sekundu. Pokud tedy totéž uchováváme jako řetězce, pak je to 37 milionů řádků za sekundu. Nevím, jak k tomu došlo. Tyto dotazy jsem spouštěl sám. Ale je to přibližně čtyřikrát pomalejší.
A pokud spočítáme rozdíl v místě na disku, tak rozdíl také existuje. A je někde okolo jedné čtvrtiny, protože unikátních IP adres je docela hodně. A pokud by zde byly řetězce s malým počtem různých hodnot, pak by se pohodlně komprimovaly do přibližně stejného objemu pomocí slovníku.
A čtyřnásobný rozdíl v čase na silnici se nevyplácí. Možná je vám to jedno, ale když vidím takový rozdíl, je mi smutno.
Podívejme se na různé případy.
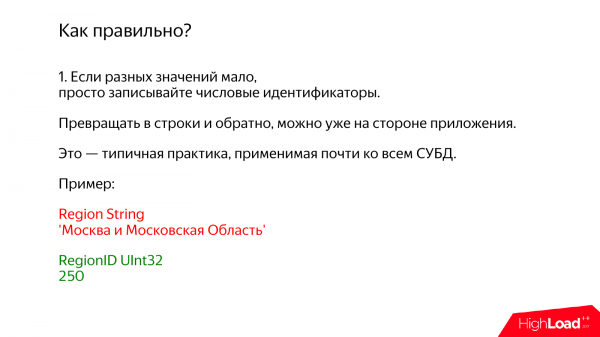
1. Jeden případ, kdy máte málo různých unikátních hodnot. V tomto případě použijeme jednoduchou praktiku, kterou pravděpodobně znáte a můžete ji použít pro jakoukoli DB. Dává to smysl nejen pro ClickHouse. Jednoduše zapisujete do databáze číselné identifikátory. A převádět na řetězce a zpět lze už na straně vaší aplikace.
Například máte region. A snažíte se ho uložit jako řetězec. A bylo by tam napsáno: Moskva a MO. A když vidím, že tam píše „Moskva“, tak to ještě nic, ale když je tam i MO, tak je mi to úplně smutno. To je přece kolik bytů.
Místo toho jednoduše zapisujeme číslo Ulnt32 a 250. Máme 250 v Yandexu, ale u vás to může být jinak. Pro jistotu říkám, že v ClickHouse existuje zabudovaná možnost práce s geodatabází. Jednoduše zapisujete katalog s regiony, včetně hierarchického, t. j. tam bude Moskva, MO a všechno, co potřebujete. A můžete převádět na úrovni dotazu.
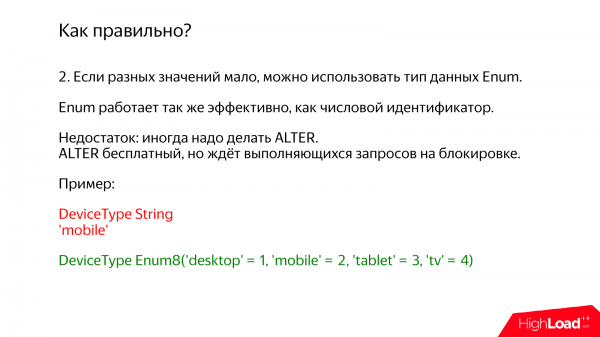
Druhá varianta je přibližně stejná, ale už s podporou uvnitř ClickHouse. To je typ dat Enum. Jednoduše uvnitř Enum zapíšete všechny potřebné hodnoty. Například typ zařízení a tam napíšete: desktop, mobilní, tablet, televizor. Celkem 4 varianty.
Nevýhodou je, že je nutné pravidelně alterovat. Přidali jsme pouze jednu variantu. Děláme alter table. Ve skutečnosti je alter table v ClickHouse zadarmo. Zvlášť je zdarma pro Enum, protože data na disku se nemění. Ale přesto alter zabírá zámek* na tabulku a musí čekat, až se vykonají všechny selects. A teprve poté se alter provede, tedy nějaké nepříjemnosti přece jen existují.
* V novějších verzích ClickHouse je ALTER prováděn zcela neblokujícím způsobem.
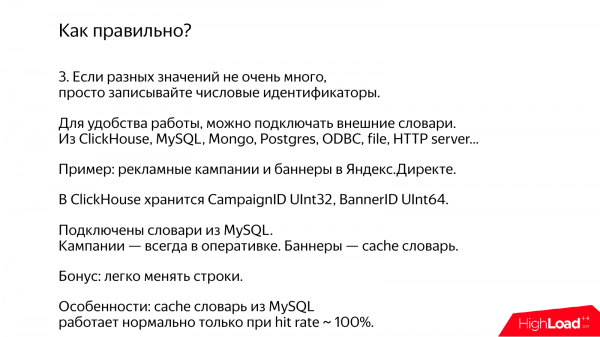
Ještě jedna varianta, která je dost unikátní pro ClickHouse – je připojení externích slovníků. Můžete zapisovat do ClickHouse čísla a vaše katalogy uchovávat v jakémkoli systému, který vám vyhovuje. Například můžete použít: MySQL, Mongo, Postgres. Dokonce si můžete vytvořit vlastní mikroslužbu, která tyto údaje poskytne po http. A na úrovni ClickHouse píšete funkci, která tyto údaje převádí z čísel na řetězce.
To je specializovaný, ale velmi efektivní způsob, jak provést join s externí tabulkou. Existují přitom dvě varianty. V jedné variantě budou tato data plně kešována, budou se nacházet v RAM a občas se aktualizují. V druhé variantě, pokud se tato data nevejdou do RAM, lze je částečně kešovat.
Tady je příklad. Existuje Yandex.Direct. A tam je reklamní kampaň a bannery. Reklamních kampaní je pravděpodobně kolem deseti milionů. A zhruba se vejdou do RAM. Ale bannerů je miliardy a nevejdou se. Používáme kešovací slovník z MySQL.
Jediný problém je, že kešovací slovník bude fungovat správně, pokud hit rate bude blízko 100 %. Pokud bude nižší, při zpracovávání dotazů na každou dávku dat bude třeba skutečně vzít chybějící klíče a získat data z MySQL. O ClickHouse mohu ještě říct, že – ano, nezpomaluje, o jiných systémech mluvit nebudu.
A jako bonus to, že slovníky jsou velmi jednoduchý způsob, jak aktualizovat data v ClickHouse zpětně. T. j. pokud jste měli zprávu o reklamních kampaních, uživatel jednoduše změnil reklamní kampaň a ve všech starých datech, ve všech zprávách se tato data také změnila. Kdybyste psali řádky přímo do tabulky, bylo by nemožné je aktualizovat.
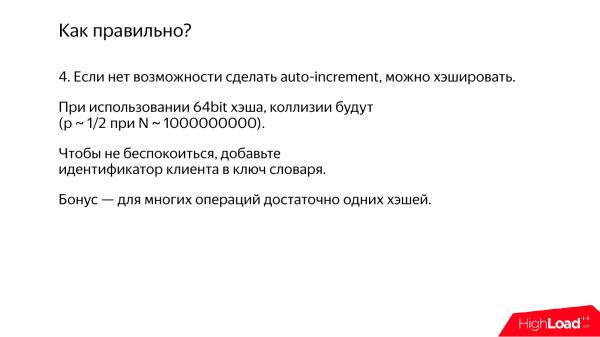
Ještě jeden způsob, když nevíte, odkud vzít identifikátory pro vaše řádky. Můžete je prostě zahashovat. A nejjednodušší varianta je vzít 64bitový hash.
Jediný problém je, že pokud je hash 64bitový, kolize se vám téměř jistě nevyhnou. Protože pokud tam je miliarda řádků, pravděpodobnost se stává znatelnou.
A nebylo by příliš dobré takto hashovat názvy reklamních kampaní. Pokud by se reklamní kampaně různých společností zamíchaly, vzniklo by něco nejasného.
A existuje jednoduchý trik. Pravda, pro vážná data se také příliš nehodí, ale pokud jde o něco méně závažného, stačí přidat do klíče slovníku ještě identifikátor klienta. A pak kolize budete mít, ale pouze v rámci jednoho klienta. Tento způsob se u nás používá pro mapu odkazů v Yandex.Metrice. Máme tam URL, uchováváme hash. A víme, že kolize, samozřejmě, existují. Ale když se stránka zobrazuje, pravděpodobnost, že na jedné stránce bude mít jeden uživatel nějaké URL, které se smíchají a ještě si toho někdo všimne, je zanedbatelná.
Jako bonus - pro mnoho operací stačí pouze hashe a samotné řetězce nemusíte nikde uchovávat.
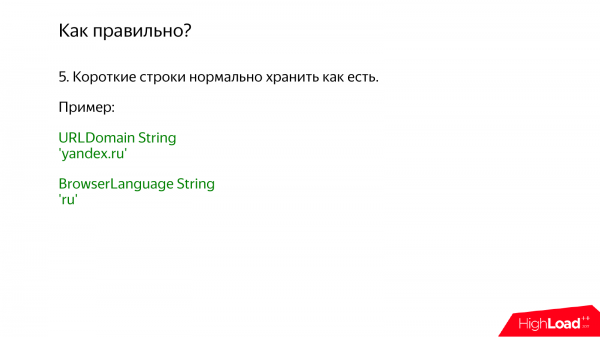
Další příklad, pokud jsou řetězce krátké, například domény webových stránek. Můžete je uchovávat tak, jak jsou. Nebo například jazyk prohlížeče ru - 2 bajty. Omlouvám se za ty bajty, ale nebojte se, 2 bajty nestojí za řeč. Prosím, uchovávejte je tak, jak jsou, nezapomínejte na to.
Další případ je, když existuje naopak mnoho řetězců a v nich je spousta unikátních a množství je potenciálně neomezené. Typický příklad - to jsou vyhledávací fráze nebo URL. Vyhledávací fráze, mezi ostatními kvůli překlepům. Podíváme se, kolik unikátních vyhledávacích frází za den. A ukazuje se, že téměř polovina z všech událostí. V takovém případě byste si mohli myslet, že je třeba data normalizovat, počítat identifikátory, ukládat do samostatné tabulky. Ale to dělat nemusíte. Prostě uchovejte tyto řetězce tak, jak jsou.
Lepší je - nic nevymýšlet, protože pokud byste je uchovávali zvlášť, budete muset provádět join. A ten join - to je v nejlepším případě náhodný přístup na paměť, pokud se ještě vejde do paměti. Pokud se nevejde, budou s tím vůbec problémy.
A pokud jsou data uchovávána in-place, pak se prostě vybírají v potřebném pořadí ze souborového systému a vše je v pořádku.
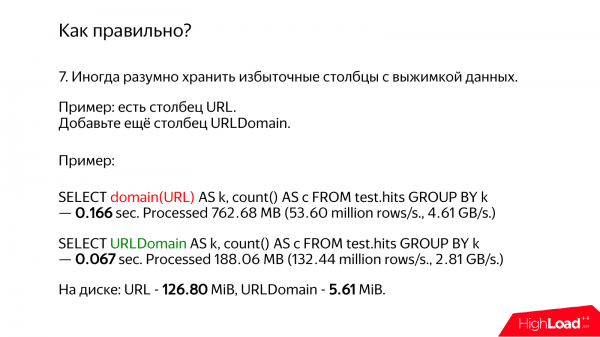
Pokud máte URL nebo nějaký jiný komplikovaný dlouhý řetězec, stojí za to přemýšlet o tom, že byste mohli nějakou sumarizaci spočítat předem a zapsat ji do samostatného sloupce.
Pro URL, například, můžete odděleně uchovávat doménu. A pokud skutečně potřebujete doménu, jednoduše použijte tenhle sloupec, zatímco URL budou ležet, a ani se jich nedotknete.
Pojďme se podívat, jaký je rozdíl. V ClickHouse existuje specializovaná funkce, která vypočítává doménu. Je velmi rychlá, optimalizovali jsme ji. A upřímně, neodpovídá RFC, přesto počítá všechno, co potřebujeme.
V jednom případě budeme pouze získávat URL a vypočítávat doménu. To trvá 166 ms. Pokud vezmeme hotovou doménu, trvá to pouze 67 ms, tedy téměř třikrát rychleji. A rychlejší to není proto, že bychom museli provádět nějaké výpočty, ale proto, že čteme méně dat.
Z nějakého důvodu má jeden dotaz, který je pomalejší, větší rychlost gigabajtů za sekundu. Protože čte více gigabajtů. To jsou zcela zbytečné údaje. Dotaz se zdá rychlejší, ale trvá déle na provedení.
Když se podíváme na objem dat na disku, zjistíme, že URL zabírá 126 MB, zatímco doména jen 5 MB. Je to 25krát méně. Přesto dotaz trvá pouze 4krát rychleji. To je však proto, že data jsou 'čerstvá'. Kdyby byla 'studená', bylo by to pravděpodobně 25krát rychlejší kvůli diskovému I/O.
Mimochodem, pokud posoudíme, jak moc je doména menší než URL, vychází to asi 4x. Přesto na disku data zabírají 25krát méně. Proč? Kvůli kompresi. Jak URL, tak doména se komprimují. Ale často URL obsahuje spoustu zbytečných dat.
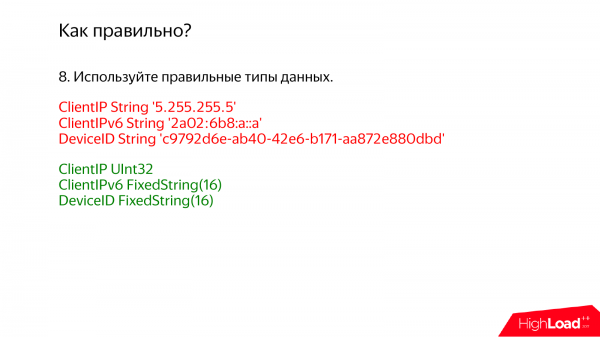
A samozřejmě je důležité používat správné datové typy, které jsou určeny speciálně pro dané hodnoty nebo které vyhovují. Pokud používáte IPv4, uchovávejte UInt32*. Pokud IPv6, pak FixedString(16), protože IPv6 adresa má 128 bitů, tedy uchovávejte ji přímo v binárním formátu.
A co dělat, pokud občas máte IPv4 adresy a občas IPv6? Ano, můžete uchovávat oboje. Jeden sloupec pro IPv4, druhý pro IPv6. Samozřejmě existuje možnost převést IPv4 na IPv6. To také bude fungovat, ale pokud často potřebujete právě IPv4 adresu v dotazech, bylo by dobré ji umístit do samostatného sloupce.
* nyní má ClickHouse samostatné datové typy IPv4 a IPv6, které ukládají data stejně efektivně jako čísla, ale prezentují je stejně pohodlně jako řetězce.
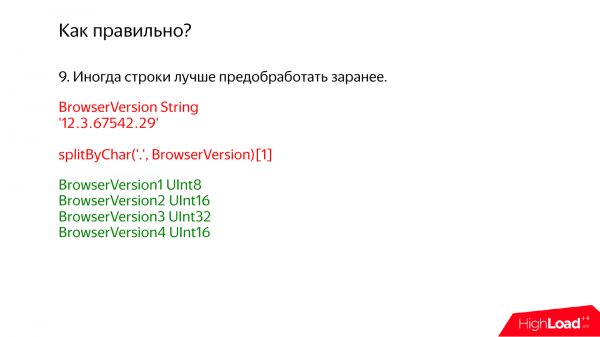
Je důležité poznamenat, že je dobré data předem zpracovat. Například vám přicházejí nějaké surové logy. A možná je lepší je ihned nezavírat do ClickHouse, i když je lákavé nic nedělat a všechno bude fungovat. Nicméně je lepší provést výpočty, které jsou možné.
Například verze prohlížeče. V jedné z vedlejších kanceláří, na kterou se mi nechce ukazovat prstem, se verze prohlížeče uchovává takto, t. j. jako řetězec: 12.3. A pak, aby vytvořili zprávu, tuto řetězec vezmou a rozdělí na pole, a pak na první prvek pole. Samozřejmě, všechno to zpomaluje. Ptám se jich, proč to dělají. Odpověděli mi, že nemají rádi předčasnou optimalizaci. A já nemám rád předčasnou pesimizaci.
V tomto případě by bylo správnější rozdělit na 4 sloupce. Nebojte se toho, protože je to ClickHouse. ClickHouse je sloupcová databáze. A čím více pečlivých malých sloupců máte, tím lépe. Mějte 5 BrowserVersion, vytvořte 5 sloupců. To je normální.
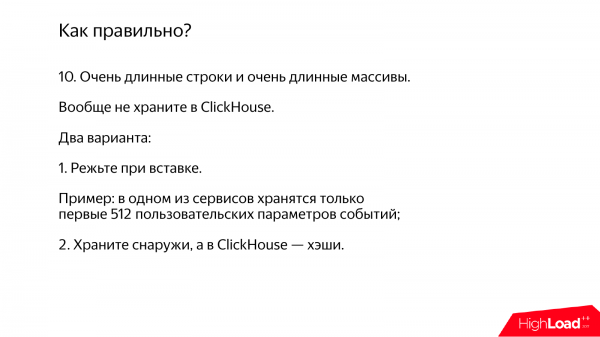
Nyní se podívejme, co dělat, pokud máte mnoho velmi dlouhých řetězců, velmi dlouhých polí. Ty není třeba uchovávat v ClickHouse vůbec. Místo toho můžete uchovávat v ClickHouse pouze nějaký identifikátor. A dlouhé řetězce uložte do nějakého jiného systému.
Například v jednom z našich analytických služeb máme určité parametry událostí. A pokud na události přichází mnoho parametrů, jednoduše uložíme prvních 512. Protože 512 je nám líto.
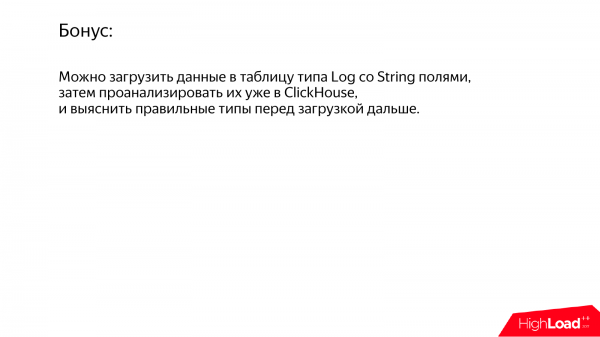
A pokud si nejste jisti svými typy dat, můžete také zapsat data do ClickHouse, ale do dočasné tabulky typu Log, speciální pro dočasná data. Poté můžete analyzovat, jaké máte rozložení hodnot, co tam vůbec je a sestavit správné typy.
* nyní v ClickHouse existuje typ dat který umožňuje efektivně uchovávat řetězce s nižšími náklady na práci.
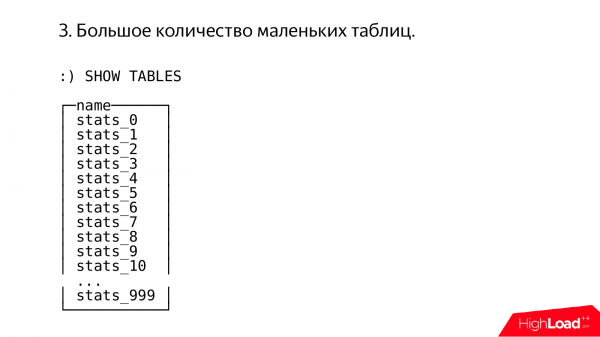
Nyní se podívejme na další zajímavý případ. Někdy lidem všechno nějak podivně funguje. Vstoupím a vidím tohle. A hned se mi vybaví, že to dělal nějaký velmi zkušený, chytrý administrátor, který má velké zkušenosti se konfigurací MySQL verze 3.23.
Zde vidíme tisíc tabulek, z nichž každá obsahuje zbytek po dělení nejasně čeho tisícem.
V zásadě respektuji zkušenosti ostatních a chápu, jaké utrpení může vyžadovat jejich získání.
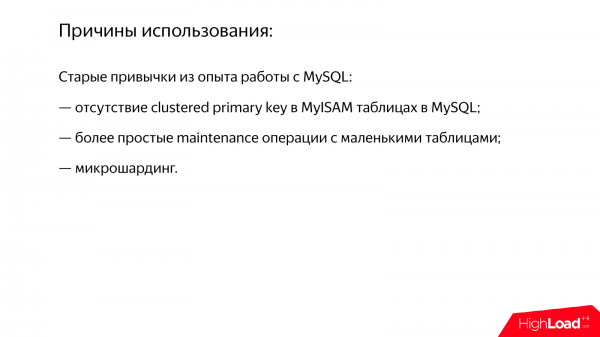
A důvody jsou víceméně jasné. Jsou to staré stereotypy, které se mohly nahromadit při práci s jinými systémy. Například v tabulkách MyISAM neexistuje klastrový primární klíč. A takový způsob rozdělování dat může být zoufalým pokusem získat stejnou funkcionalitu.
Další důvod je ten, že jakékoli operace typu alter nad velkými tabulkami jsou obtížné. Vše bude blokováno. Ačkoli v moderních verzích MySQL už tento problém není tak závažný.
Nebo například mikrosharding, ale o tom později.
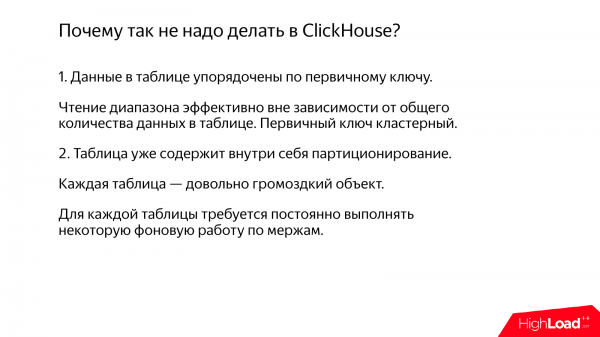
V ClickHouse to tak dělat nemusíte, protože za prvé, primární klíč je klastrový a data jsou uspořádána podle primárního klíče.
A občas se mě ptají: „Jak se mění výkon dotazů na rozsah v ClickHouse podle velikosti tabulky?“. Říkám, že se to nijak nemění. Například pokud máte tabulku s miliardou řádků a čtete rozsah jeden milion řádků. Všechno je v pořádku. Pokud má tabulka trilion řádků a vy čtete jeden milion řádků, bude to skoro to samé.
A za druhé, není potřeba žádné věci jako ruční partitioning. Pokud se podíváte na souborový systém, uvidíte, že tabulka je poměrně složitá záležitost. A uvnitř je něco jako partition. Tedy ClickHouse dělá všechno za vás a nemusíte trpět.
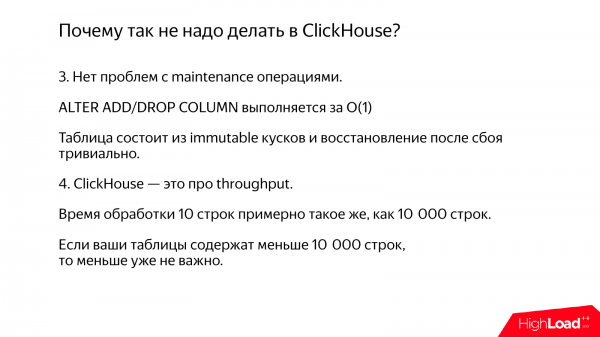
Alter v ClickHouse je zdarma, pokud se jedná o alter add/drop column.
A malé tabulky není dobré dělat, protože pokud máte v tabulce 10 řádků nebo 10 000 řádků, je to úplně irelevantní. ClickHouse je systém, který optimalizuje throughput, ne latency, takže zpracovávat 10 řádků nedává smysl.
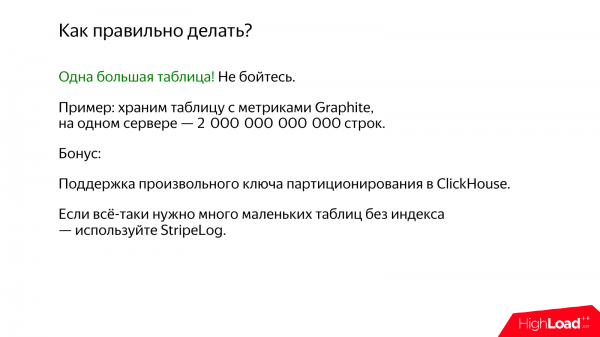
Správné je používat jednu velkou tabulku. Zbavte se starých stereotypů, všechno bude v pořádku.
A jako bonus máme v poslední verzi možnost vytvářet libovolný klíč partitioningu, což umožňuje provádět různé údržbové operace na jednotlivých partition.
Například potřebujete mnoho malých tabulek, například když je potřeba zpracovávat nějaké mezidatové informace, dostanete kusy a musíte na nich provádět transformaci před záznamem do finální tabulky. Pro tento případ existuje skvělý engine tabulky – StripeLog. To je něco jako TinyLog, jen lepší.
* nyní má ClickHouse také .
Další antipattern – to je mikrozacházení. Například, pokud potřebujete shardovat data a máte 5 serverů, ale zítra bude 6 serverů. A přemýšlíte, jak tyto údaje přebalancovat. A místo toho rozdělujete ne na 5 shardů, ale na 1 000 shardů. A pak přiřazujete každý z těchto mikroshardů na samostatný server. A ve výsledku máte na jednom serveru například 200 ClickHouse, tedy jednotlivé instance na různých portech nebo samostatné databáze.
Ale v ClickHouse to není moc dobré. Protože i jedna instance ClickHouse se snaží využít všechny dostupné prostředky serveru pro zpracování jednoho dotazu. Tedy pokud máte nějaký server s například 56 procesorovými jádry. Spustíte dotaz, který trvá jednu sekundu, a ten využije 56 jader. A pokud tam máte 200 ClickHouse na jednom serveru, vznikne 10 000 vláken. Celkově to nějak nebude dobře.
Další důvod je, že rozdělení práce mezi těmito instancemi bude nerovnoměrné. Některé skončí dříve, jiné později. Kdyby se to všechno dělo v jedné instanci, ClickHouse by si s tím poradil lépe a správně rozložil data mezi vlákna.
A ještě jeden důvod je v tom, že budete mít meziprocesorovou komunikaci přes TCP. Data bude nutné serializovat, deserializovat a to je obrovské množství mikroshardů. Zkrátka to bude neefektivní.
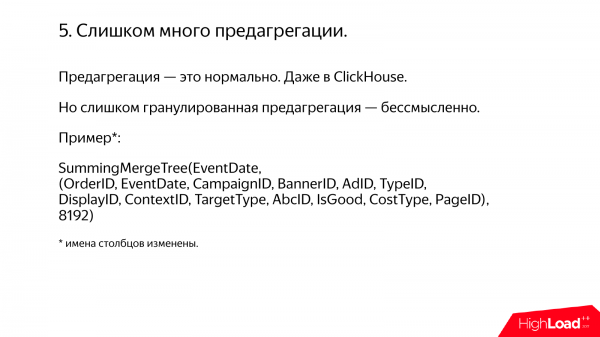
Další antipattern, ačkoliv je těžké to nazvat antipatternem. To je velké množství předagregace.
Obecně, předagregace – to je dobré. Měli jste miliardu řádků, agregovali jste a dostali jste se na 1 000 řádků, a nyní se dotaz vykonává okamžitě. Všechno je skvělé. Tak to lze dělat. A pro to existuje dokonce v ClickHouse speciální typ tabulky AggregatingMergeTree, která provádí inkrementální agregaci při vkládání dat.
Někdy si myslíte, že data budeme agregovat tímto způsobem a ještě tímto způsobem. A v některém sousedním oddělení, o kterém se mi nechce mluvit, používají tabulky SummingMergeTree pro součtování podle primárního klíče, a jako primární klíč používají zhruba 20 různých sloupců. Pro jistotu jsem změnil názvy některých sloupců pro konspiraci, ale zhruba to tak je.
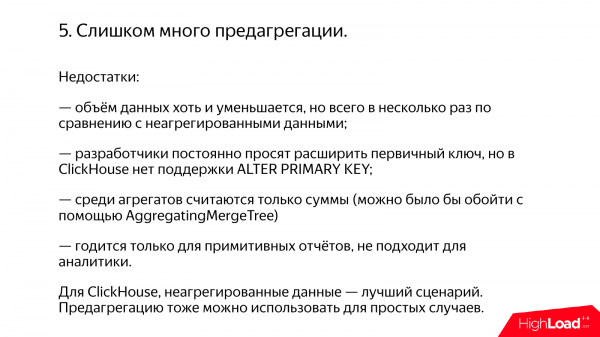
A vznikají takové problémy. Zaprvé, objem dat se vám nezmenší příliš. Například se zmenší třikrát. Třikrát – to by byla dobrá cena, abyste si mohli dovolit neomezené možnosti analytiky, které vznikají, pokud data nejsou agregovaná. Pokud jsou data agregovaná, místo analytiky dostanete jen žalostnou statistiku.
A co je obzvlášť frustrující? To, že lidé ze sousedního oddělení chodí a občas žádají o přidání dalšího sloupce do primárního klíče. Tedy jsme data tímto způsobem agregovali, a teď chceme trochu více. Ale v ClickHouse není možné měnit primární klíč. Proto je potřeba psát nějaké skripty v C++. A já nemám rád skripty, ani když jsou v C++.
A pokud se podíváte, k čemu byl ClickHouse vytvořen, tak neagregovaná data – to je přesně ten scénář, pro který byl vynalezen. Pokud používáte ClickHouse pro neagregovaná data, děláte to správně. Pokud agregujete, je to někdy odpustitelné.
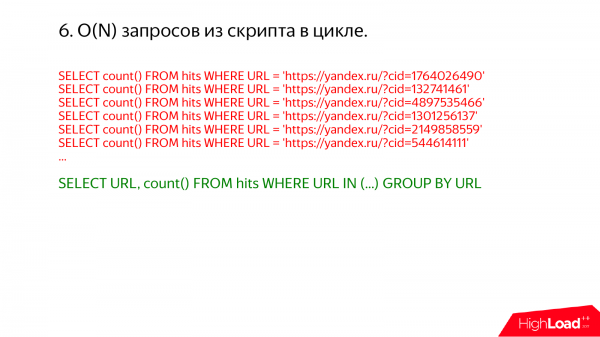
Další zajímavý případ – to jsou dotazy v nekonečné smyčce. Někdy se přihlásím na nějaký produkční server a podívám se na show processlist. A pokaždé zjistím, že se tam děje něco hrozného.
Například něco takového. Hned je jasné, že by to všechno šlo vykonat v jednom dotazu. Stačí napsat url in a seznam.
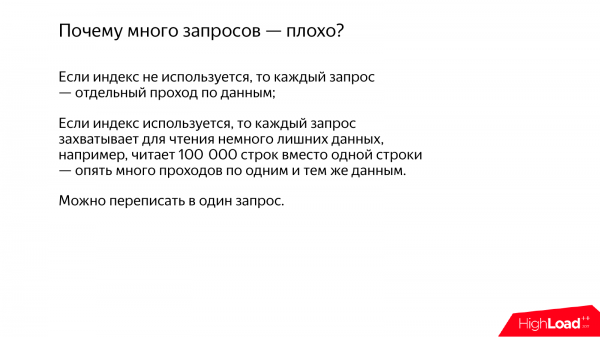
Proč je tolik takových dotazů v nekonečné smyčce špatných? Pokud se index nepoužívá, budete mít hodně průchodů stejnými daty. Ale pokud se index používá, například máte primární klíč podle ru a píšete url = něčemu. A myslíte si, že se bude číst z tabulky konkrétní url, bylo by to v pořádku. Ale skutečně ne. Protože ClickHouse všechno dělá po dávkách.
Když potřebuje přečíst nějaký rozsah dat, přečte o něco více, protože index v ClickHouse je řídký. Tento index neumožňuje najít v tabulce jednu jednotlivou řádku, pouze nějaký rozsah. A data se komprimují po blocích. Abychom přečetli jednu řádku, musíme vzít celý blok a rozbalit ho. A pokud provádíte spoustu dotazů, budete mít mnoho takových překryvů, a spousta práce se bude vykonávat znovu a znovu.
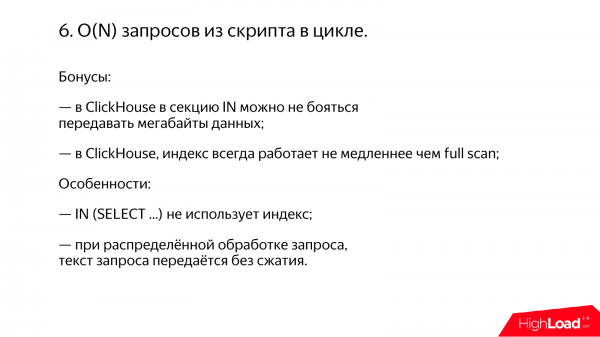
A jako bonus lze poznamenat, že v ClickHouse se není třeba bát předávat i megabyty a dokonce stovky megabytů do sekce IN. Pamatuji si ze své praxe, že pokud v MySQL předáváme spoustu hodnot do sekce IN, například předáváme do ní 100 megabytů nějakých čísel, MySQL spotřebovává 10 gigabajtů paměti a víc se s tím nic neděje, všechno funguje špatně.
A za druhé – je to, že v ClickHouse, pokud vaše dotazy používají index, je to vždy rychlejší než full scan, t. j. pokud je třeba přečíst téměř celou tabulku, bude to probíhat sekvenčně a přečte celou tabulku. Obecně se o to postará sám.
Nicméně existují některé složitosti. Například to, že IN s poddotazem index nevyužívá. Ale to je náš problém a musíme to opravit. Nic zásadního tu není. Budeme opravovat.
A ještě jedna zajímavá věc – pokud máte velmi dlouhý dotaz a probíhá distribuované zpracování dotazů, tento velmi dlouhý dotaz bude odeslán na každý server bez komprese. Například 100 megabytů a 500 serverů. A samozřejmě, že se po síti přenese 50 gigabajtů. Bude to přeneseno a pak se všechno úspěšně provede.
* už používá; všechno je opraveno, jak bylo slíbeno.
A docela častý případ, když dotazy přicházejí z API. Například jste vytvořili nějakou svou službu. A pokud vaši službu někdo potřebuje, otevřeli jste API a už doslova za dva dny vidíte, že se děje něco nejasného. Všechny přetížení a nějaké hrozné dotazy přicházejí, které nikdy neměly být.
A řešení je jediné. Pokud jste otevřeli API, budete ho muset omezit. Například zavést nějaké kvóty. Jiných normálních možností není. Jinak hned napíšou skript a budou problémy.
A v ClickHouse je speciální funkce - počítání kvót. Můžete předat svůj klíč kvóty, což může být například vnitřní identifikátor uživatele. Kvóty se počítají samostatně pro každého z nich.
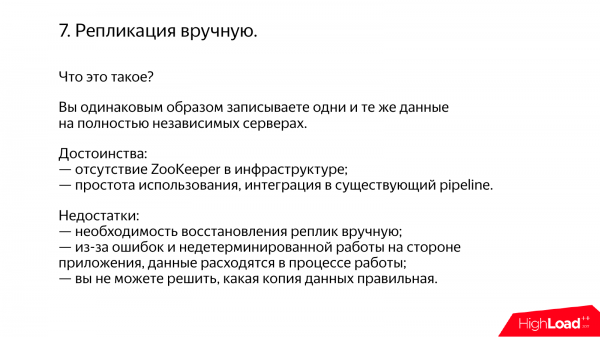
Teď ještě jedna zajímavá věc. To je replikace na ruční pohon.
Znám mnoho případů, kdy lidé, přestože ClickHouse má vestavěnou podporu replikace, replikují ClickHouse ručně.
Jaký je princip? Máte datový zpracovatelský pipeline. A ten pracuje nezávisle, například v různých datových centrech. Stejné údaje zapisujete stejně do ClickHouse. Pravda, praxe ukazuje, že údaje se stejně rozcházejí kvůli nějakým zvláštnostem ve vašem kódu. Doufám, že se to netýká i vás.
A občas budete muset ručně synchronizovat. Například jednou za měsíc administrátoři provádějí rsync.
Ve skutečnosti je mnohem snazší použít vestavěnou replikaci v ClickHouse. Ale mohou být některé kontraindikace, protože k tomu je potřeba používat ZooKeeper. Nic špatného o ZooKeeper neříkám, v podstatě to funguje, ale lidé ho někdy nepoužívají kvůli java-fobii, protože ClickHouse je skvělý systém napsaný v C++, se kterým se dá pracovat a všechno funguje skvěle. A ZooKeeper je na java. A nějak se vám to ani nechce zkoumat, ale pak můžete použít replikaci na ruční pohon.
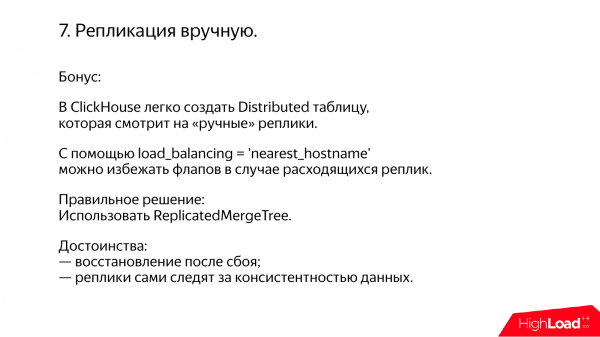
ClickHouse je praktický systém. Zohledňuje vaše potřeby. Pokud máte replikaci na ruční pohon, můžete vytvořit distribuovanou tabulku, která sleduje vaše ruční repliky a sama provádí failover mezi nimi. Existuje dokonce speciální možnost, která umožňuje vyhnout se fluktuacím, i když se vaše repliky systematicky rozcházejí.
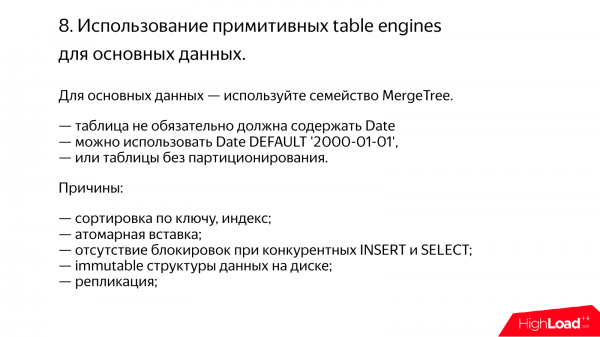
Další mohou vzniknout problémy, pokud používáte primitivní table engines. ClickHouse je jako stavebnice, ve které je spousta různých typů tabulek. Pro všechny vážné případy, jak je uvedeno v dokumentaci, používejte tabulky rodiny MergeTree. Všechny ostatní jsou spíše pro jednotlivé případy nebo pro testy.
V tabulce MergeTree není nutné, abyste měli nějaké datum a čas. Můžete je stejně používat. Pokud datum a čas nejsou, nastavte, že default – 2000 rok. To bude fungovat a nebude to vyžadovat žádné zdroje.
A v nové verzi serveru můžete dokonce určit, že chcete mít vlastní partitioning bez klíče partition. Bude to totéž.
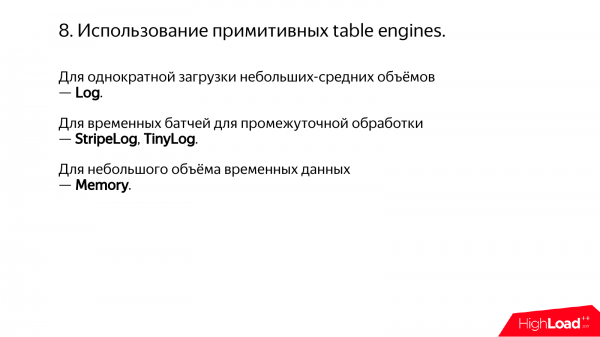
Na druhou stranu lze použít primitivní tabulkové enginy. Například nahrát data jednou a podívat se, otočit a odstranit. Můžete použít Log.
Nebo ukládání malých objemů pro mezispracování – to je StripeLog nebo TinyLog.
Memory můžete použít, pokud máte malý objem dat a jen si chcete něco otočit v paměti.
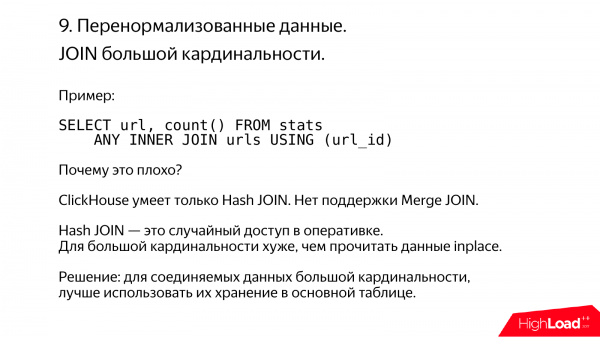
ClickHouse nemá příliš rád denormalizovaná data.
Toto je typický příklad. Je to obrovské množství URL. Zatlačili jste je do sousední tabulky. A pak jste se rozhodli s nimi provádět JOIN, ale to bude obvykle nefungovat, protože ClickHouse podporuje pouze Hash JOIN. Pokud nestačí paměť pro mnoho dat, se kterými se má spojit, JOIN nebude možné provést.
Pokud máte data s vysokou kardinalitou, tak se nestarejte, uchovávejte je v denormalizované podobě, URL přímo inplace v hlavní tabulce.
* a nyní má ClickHouse také merge join, který funguje za podmínek, kdy mezidaty se nevejdou do paměti. Ale to není efektivní a doporučení zůstává v platnosti.
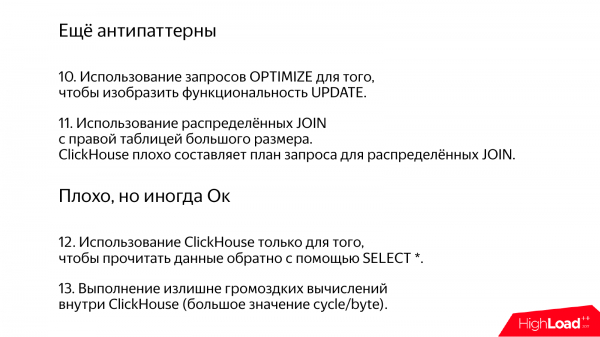
Ještě pár příkladů, ale už váhám, zda jsou antypatternové nebo ne.
V ClickHouse je jeden známý nedostatek. Neumí aktualizace. V jistém smyslu je to dokonce dobré. Pokud máte nějaká důležitá data, například účetnictví, nikdo je nebude moci změnit, protože aktualizace neexistují.
* podpora aktualizace a mazání v dávkovém režimu byla přidána už dávno.
Existují však některé zvláštní způsoby, které umožňují aktualizace jakoby na pozadí. Například tabulky typu ReplaceMergeTree. Provádějí aktualizace během pozadí mergí. Můžete to urychlit pomocí optimize table. Ale nedělejte to příliš často, protože to úplně přepíše partition.
Distribuované JOIN v ClickHouse – to je také špatně zpracováno plánovačem dotazů.
Špatně, ale někdy OK.
Použití ClickHouse pouze pro čtení dat zpět pomocí select.
Nedoporučil bych používat ClickHouse pro složité výpočty. Ale není to úplně tak, protože už od této doporučení ustupujeme. A nedávno jsme přidali možnost aplikovat modely strojového učení v ClickHouse – Catboost. A to mě znepokojuje, protože si říkám: „Jaká hrůza. Kolik taktů na byte to bude?“. Je mi moc líto, že takty jdou na bajty.
Ale nebojte se, nainstalujte ClickHouse, všechno bude v pořádku. Pokud něco, máme komunitu. Mimochodem, ta komunita jste vy. A pokud máte nějaké problémy, můžete se alespoň připojit do našeho chatu, a doufám, že vám pomohou.
Otázky
Děkuji za prezentaci! Kam si mohu stěžovat na pád ClickHouse?
Můžete si stěžovat mě osobně právě teď.
Nedávno jsem začal používat ClickHouse. Okamžitě jsem zkolaboval cli rozhraní.
Měli jste štěstí.
O chvíli později jsem zkolaboval server malým selectem.
Máte talent.
Otevřel jsem bug na GitHubu, ale ignorovali ho.
Podíváme se na to.
Alexej mě podvedl a dostal mě na prezentaci, slíbil, že poví, jak data uvnitř stlačujete.
Velmi jednoduše.
To jsem pochopil už včera. Více konkrétně.
Není tam žádné strašné tajemství. Je to prostě komprese po blocích. Standardně se používá LZ4, lze aktivovat ZSTD*. Bloky jsou od 64 kilobajtů do 1 megabajtu.
* také existuje podpora specializovaných kompresních kodeků, které lze použít v řetězci s jinými algoritmy.
Jsou v blocích prostě syrová data?
Ne úplně syrová. Jsou tam pole. Pokud máte číselný sloupec, čísla jsou uložena za sebou v poli.
Rozumím.
Alexej, příklad, který byl s uniqExact nad IP adresami, tj. to, co říkáte, že uniqExact nad řetězci trvá déle než nad čísly a tak dále. A pokud zkusíme trik a budeme typovat při čtení? Tj. vy jste jakoby řekli, že na disku se to u nás příliš neliší. Pokud budeme číst ze disku řetězce a typovat, zda pak rychleji získáme agregáty, nebo ne? Nebo zde budeme mít jen nepatrný zisk? Myslím, že jste to testovali, ale z nějakého důvodu jste to neuváděli v benchmarku.
Myslím, že to bude pomalejší než bez castu. V tomto případě je třeba extrahovat IP adresu ze řetězce. U nás je samozřejmě v ClickHouse parsing IP adres optimalizovaný také. Udělali jsme, co jsme mohli, ale přece jen máte čísla zapsaná v deseti tisíci formátu. To je velmi nepohodlné. Na druhou stranu funkce uniqExact bude na řetězcích fungovat pomaleji nejen proto, že se jedná o řetězce, ale také proto, že se vybírá jiná specializace algoritmu. Řetězce se zpracovávají jednoduše jinak.
A co kdybychom vzali primitivnější typ dat? Například jsme zapsali user id, které máme v in, zapsali jsme ho jako řetězec a pak jsme to castili, bude to zábavnější, nebo ne?
Mám o tom pochybnosti. Myslím, že to bude ještě smutnější, protože parsování čísel je opravdu vážný problém. Mám pocit, že tento kolega měl dokonce přednášku na téma, jak složité je parsovat čísla v deseti tisíci formátu, ale možná ne.
Alexei, moc děkuji za přednášku! A také děkuji za ClickHouse! Mám otázku ohledně funkcí. Je v plánu funkce pro neúplnou aktualizaci slovníků?
Tedy částečné načtení?
Ano, ano. Typu možnosti nastavit tam pole MySQL, tedy aktualizovat po, aby se načítala pouze tato data, pokud je slovník velmi velký.
Velmi zajímavá funkce. A zdá se mi, že ji někdo navrhnul v našem chatu. Možná jste to byl dokonce vy.
Nemyslím si, že bych to byl já.
Skvělé, nyní máme dva požadavky. A můžeme v klidu začít pracovat. Ale hned vás chci varovat, že tato funkce je poměrně snadná na implementaci. Tedy v ideálním případě stačí napsat do tabulky číslo verze a poté napsat: verze je menší než ta a ta. A to znamená, že to pravděpodobně nabídneme nadšencům. Jste nadšenec?
Ano, ale bohužel ne v C++.
Umí vaši kolegové psát v C++?
Někoho najdu.
Skvělé*.
* možnost byla přidána dva měsíce po přednášce – vyvinul ji autor otázky a zaslal ji .
Děkuji!
Dobrý den! Děkuji za prezentaci! Zmínil jste, že ClickHouse velmi efektivně využívá všechny dostupné zdroje. A přítel z Luxoftu hovořil o svém řešení pro Poštu Ruska. Řekl, že se mu ClickHouse velmi líbil, ale nepoužili ho místo svého hlavního konkurenta právě proto, že žral všechny procesory. A oni ho nedokázali zapojit do své architektury, do svého ZooKeeperu s kontejnery. Je nějaká možnost, jak omezit ClickHouse, aby nespotřebovával vše, co mu je dostupné?
Ano, to lze a velmi jednoduše. Pokud chcete, aby zabíral méně jader, stačí napsat set max_threads = 1. A je to, dotaz bude prováděn na jedno jádro. Přitom lze různým uživatelům nastavit tuto možnost odlišně. Takže žádné problémy. A kolegům z Luxoftu řekněte, že není v pořádku, že tuto možnost nenašli v dokumentaci.
Alexei, dobrý den! Chtěl bych se zeptat na jednu věc. Už nepoprvé slyším, že mnoho lidí začíná používat ClickHouse jako úložiště logů. Na prezentaci jste říkal, aby se to nedělalo, tj. není potřeba uchovávat dlouhé řetězce. Jak na to pohlížíte?
Zaprvé, logy obvykle nejsou dlouhé řetězce. Samozřejmě, občas jsou výjimky. Například nějaká služba napsaná v Javě vyhazuje výjimku, ta se loguje. A tak v nekonečné smyčce, končí místo na pevném disku. Řešení je velmi jednoduché. Pokud jsou řetězce příliš dlouhé, zkraťte je. A co znamená dlouhé? Desítky kilobajtů – to je špatně.
* V nových verzích ClickHouse je zahrnuta "adaptivní granularita indexu", což většinou odstraňuje problém s uchováváním dlouhých řetězců.
A kilobajt – to je normální?
Normální.
Dobrý den! Děkuji za prezentaci! Už jsem se o tom v chatu ptal, ale nepamatuji se, jestli jsem dostal odpověď. Plánuje se nějak rozšířit sekce WITH ve stylu CTE?
Zatím ne. Sekce WITH je u nás poněkud vážná. Je to u nás spíše malá funkce.
Rozumím. Děkuji!
Děkuji za prezentaci! Velmi zajímavé! Velká otázka. Plánuje se možná udělat nějaké zjednodušené modifikace pro odstraňování dat?
Určitě. To je naše první úkol v seznamu. Aktuálně aktivně přemýšlíme, jak vše udělat správně. A je čas začít mačkat klávesnici.
* stiskli jsme klávesy na klávesnici a všechno udělali.
Ovlivní to nějak výkonnost systému, nebo ne? Vložení bude stejně rychlé, jako je tomu nyní?
Možná, že samotné mazaní a aktualizace budou velmi náročné, ale to nijak neovlivní výkonnost výběrů a výkonnost vkládání.
A ještě jeden malý dotaz. Na prezentaci jste mluvili o primárním klíči. Tedy máme parciální rozdělení, které je ve výchozím nastavení měsíční, že? A když zadáme časový rozsah, který se vejde do měsíce, načte se jen tato parciální část, že?
Ano.
Otázka. Pokud nemůžeme vymezit žádný primární klíč, je správné udělat jej právě podle pole 'Datum', aby v pozadí byla menší reorganizace těchto dat, aby byla uspořádána lépe? Pokud nemáte rozsahové dotazy a ani žádný primární klíč nelze vybrat, má smysl vložit datum do primárního klíče?
Ano.
Možná dává smysl vložit do primárního klíče takové pole, podle kterého se budou data lépe komprimovat, pokud budou seřazena podle tohoto pole. Například identifikátor uživatele. Uživatel, například, navštěvuje stejný web. V takovém případě vložte uživatelské ID a čas. A pak se vám data budou lépe komprimovat. Pokud opravdu nemáte nikdy rozsahové dotazy podle dat, tak datum do primárního klíče nemusíte dávat.
Dobře, mnohokrát děkuji!
Zdroj: habr.com
