

10. srpna v Slörmu začal , ve kterém se zaměřujeme na jeho úplné pochopení — od základních abstrakcí až po parametry sítě.
V tomto článku si povíme o historii vzniku Dockeru a jeho základních abstrakcích: Image, Cli, Dockerfile. Přednáška je určena pro začátečníky, takže pravděpodobně nebude zajímavá pro zkušené uživatele. Nebudeme se zde zabývat složitostmi, krvavými detaily ani hlubokým ponořením. Jen ty nejzákladnější informace.
Co je Docker
Podíváme se na definici Dockeru z Wikipedie.
Docker je software pro automatizaci nasazování a správu aplikací v prostředích podporujících kontejnerizaci.
Z této definice není příliš jasné, co to vlastně znamená. Zejména co se myslí „v prostředích podporujících kontejnerizaci“. Abychom to pochopili, vrátíme se do minulosti. Začneme v období, které nazývám „Monolitickou érou“.
Monolitická éra
Monolitická éra je počátek 2000. let, kdy byly všechny aplikace monolitické, s množstvím závislostí. Vývoj trval dlouho. Přitom serverů nebylo příliš mnoho, znali jsme je všechny jménem amonitorovali je. Je tu zajímavé přirovnání:
Domácí zvířata — to jsou naši domácí mazlíčci. V monolitické éře jsme se k našim serverům chovali jako k domácím mazlíkům, hýčkali jsme je a pečovali o ně. Pro lepší správu zdrojů jsme používali virtualizaci: vzali jsme server a rozčlenili ho na několik virtuálních strojů, čímž jsme zajistili izolaci prostředí.
Systémy virtualizace založené na hypervisoru
O systémech virtualizace pravděpodobně slyšel každý: VMware, VirtualBox, Hyper-V, Qemu KVM atd. Zajišťují izolaci aplikací a správu zdrojů, ale mají i své nevýhody. Pro vytvoření virtualizace potřebujeme hypervisor. A hypervisor znamená dodatečný požadavek na zdroje. A také samotný virtuální stroj je obvykle dost robustní — těžký obraz, na kterém je operační systém, Nginx, Apache, možná i MySQL. Obraz je velký, manipulace s virtuálními stroji je obtížná. V důsledku toho může práce s virtuálními stroji být pomalá. Abychom tento problém vyřešili, vytvořili jsme systémy virtualizace na úrovni jádra.
Systémy virtualizace na úrovni jádra
Virtualizaci na úrovni jádra podporují systémy OpenVZ, Systemd-nspawn, LXC. Výrazným příkladem takové virtualizace jsou LXC (Linux Containers).
LXC — systém virtualizace na úrovni operačního systému pro spuštění několika izolovaných instancí operačního systému Linux na jednom uzlu. LXC nepoužívá virtuální stroje, ale vytváří virtuální prostředí s vlastním prostorem procesů a síťovým zásobníkem.
V podstatě LXC vytváří kontejnery. Jaký je rozdíl mezi virtuálními stroji a kontejnery?
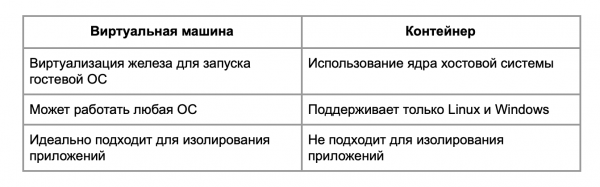
Kontejner není vhodný pro izolaci procesů: v systémech virtualizace na úrovni jádra se nacházejí zranitelnosti, které umožňují dostat se z kontejneru na hostitele. Proto pokud potřebujete něco izolovat, je lepší použít virtuální stroj.
Rozdíly mezi virtualizací a kontejnerizací lze vidět na schématu.
Existují hardwarové hypervizory, hypervizory nad OS a kontejnery.
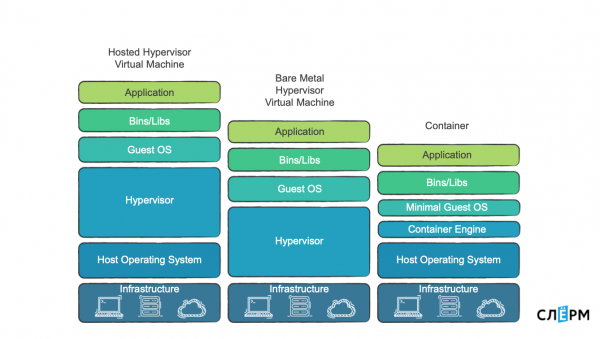
Hardwarové hypervizory jsou skvělý nástroj, pokud opravdu chcete něco izolovat. Protože tam je možnost izolovat na úrovni stránek paměti a procesorů.
Existují hypervizory jako programy a jsou zde kontejnery, o kterých budeme dále hovořit. V systémech kontejnerizace hypervizor není, ale je zde Container Engine, který vytváří kontejnery a spravuje je. Toto je lehčí záležitost, a díky práci s jádrem je overhead menší, nebo dokonce žádný.
Co se používá pro kontejnerizaci na úrovni jádra
Hlavní technologie, které umožňují vytvořit izolovaný kontejner od ostatních procesů, jsou Namespaces a Control Groups.
Namespaces: PID, Networking, Mount a User. Existují i další, ale pro zjednodušení porozumění se zastavíme u těchto.
PID Namespace omezuje procesy. Když například vytvoříme PID Namespace a umístíme do něj proces, stává se z něj proces s PID 1. Obvykle v systémech PID 1 — to je systemd nebo init. Odpovídajícím způsobem, když umístíme proces do nového jmenného prostoru, dostane také PID 1.
Networking Namespace umožňuje omezit/izolovat síť a uvnitř již umístit své rozhraní. Mount — to je omezení pro souborový systém. User — omezení podle uživatelů.
Control Groups: Memory, CPU, IOPS, Network — celkem asi 12 nastavení. Jinak se také nazývají Cgroups („C skupiny“).
Control Groups spravují zdroje pro kontejner. Pomocí Control Groups můžeme říct, že kontejner by neměl spotřebovávat více než určité množství zdrojů.
Aby kontejnerizace fungovala naplno, používají se další technologie: Capabilities, Copy-on-write a další.
Capabilities znamenají, že říkáme procesu, co může nebo nemůže dělat. Na úrovni jádra jde vlastně o bitové mapy s mnoha parametry. Například uživatel root má plné oprávnění a může dělat cokoliv. Server času může měnit systémový čas: má capabilities na Time Capsule a hotovo. Pomocí oprávnění lze flexibilně nastavit omezení pro procesy a tím se zajistit.
Systém Copy-on-write nám umožňuje efektivněji pracovat s obrazy Docker.
V současnosti má Docker problémy s kompatibilitou Cgroups v2, a proto se v článku řeší právě Cgroups v1.
Ale vraťme se k historii.
Když se objevily virtualizační systémy na úrovni jádra, začaly se aktivně používat. Oproti hypervizoru zmizel overhead, ale některé problémy zůstaly:
- velké obrazy: do OpenVZ se cpou operační systémy, knihovny, spousta různých softwarů, a nakonec je obraz stejně docela velký;
- není tu normální standard balení a dodávání, což přináší problém se závislostmi. Často se stává, že dva kusy kódu používají jednu knihovnu, ale v různých verzích. Mezi nimi mohou nastat konflikty.
Abychom tyto problémy vyřešili, přišla další éra.
Éra kontejnerů
S příchodem Éry kontejnerů se změnila filozofie práce s nimi:
- Jeden proces — jeden kontejner.
- Všechny potřebné závislosti procesu dodáváme do jeho kontejneru. To vyžaduje rozkouskovat monolity na mikroslužby.
- Čím menší obraz, tím lepší — méně možných zranitelností, rychlejší nasazení a tak dále.
- Instance se stávají efemérními.
Pamatujete, jak jsem mluvil o pets vs cattle? Dříve byly instance jako domácí mazlíčci, nyní se staly jako skot. Dříve byl monolit — jedna aplikace. Nyní je to 100 mikroslužeb, 100 kontejnerů. Některé kontejnery mohou mít 2-3 repliky. Není pro nás tolik důležité kontrolovat každý kontejner. Důležitější je pro nás dostupnost samotné služby: toho, co dělá tato sada kontejnerů. To mění přístupy k monitorování.
V letech 2014-2015 nastal rozkvět Dockeru — technologie, o které budeme nyní mluvit.
Docker změnil filozofii a standardizoval balení aplikací. S pomocí Dockeru můžeme zabalit aplikaci, poslat ji do repozitáře, stáhnout ji odtud a nasadit.
Do Docker kontejneru zahrnujeme vše potřebné, čímž se vyřeší problém závislostí. Docker zaručuje reprodukovatelnost. Myslím, že se mnozí z nás setkali s nereprodukovatelností: všechno ti funguje, odpushuješ to na produkci a tam to přestane fungovat. S Dockerem tento problém zmizí. Pokud se tvůj Docker kontejner spustí a dělá to, co má, je velká pravděpodobnost, že se spustí i na produkci a udělá totéž.
Odbočka o overheadu
Téma overheadu je neustále sporné. Někteří lidé tvrdí, že Docker nenese dodatečné zatížení, protože využívá jádro Linuxu a všechny jeho procesy potřebné pro kontejnerizaci. Říkají, že pokud říkáte, že Docker je overhead, pak je i jádro Linuxu overhead.
Na druhou stranu, pokud se na to podíváme hlouběji, opravdu existuje několik věcí v Dockeru, které bychom s nadsázkou mohli označit za overhead.
První věc je PID namespace. Když umístíme nějaký proces do namespace, dostane PID 1. Zároveň má tento proces ještě jedno PID, které se nachází na hostitelském namespace, mimo kontejner. Například, spustili jsme v kontejneru Nginx, stal se PID 1 (master proces). Na hostiteli má PID 12623. A těžko říct, jak velké je to overhead.
Druhá věc jsou Cgroups. Pokud vezmeme Cgroups pro paměť, tedy možnost omezit kontejneru paměť. Při jejím zapnutí se aktivují počítadla, memory accounting: jádro musí rozumět, kolik stránek bylo přiděleno a kolik je ještě volných pro tento kontejner. To může být overhead, ale nestudoval jsem přesné výzkumy o tom, jak to ovlivňuje výkon. A sám jsem si nevšiml, že by aplikace spuštěná v Dockeru náhle ztrácela na výkonu.
A ještě jedna poznámka k výkonu. Některé parametry jádra se pasují z hostitele do kontejneru. Zejména některé síťové parametry. Pokud tedy chcete v Dockeru spustit něco vysoce výkonného, například něco, co bude aktivně využívat síť, musíte tyto parametry minimálně upravit. Například nf_conntrack.
O konceptu Dockeru
Docker se skládá z několika komponentů:
- Docker Daemon — to je ten správný Container Engine; spouští kontejnery.
- Docker CII — nástroj pro správu Dockeru.
- Dockerfile — instrukce, jak vytvořit obraz.
- Image — obraz, ze kterého se rozbalí kontejner.
- Kontejner.
- Docker registry — úložiště obrazů.
Schematicky to vypadá přibližně takto:
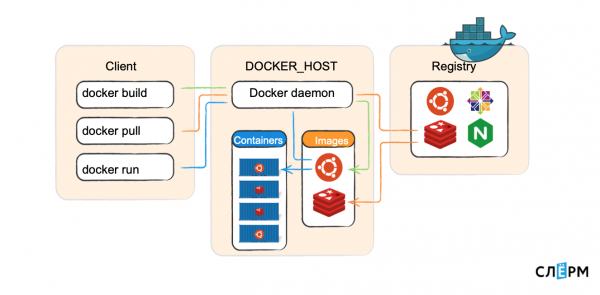
Na Docker_host běží Docker daemon, spouští kontejnery. Existuje Client, který předává příkazy: vytvoř obraz, stáhni obraz, spusť kontejner. Docker daemon jde do registry a vykonává je. Docker klient může komunikovat jak lokálně (přes unixový socket), tak i přes TCP z vzdáleného hostitele.
Projdeme si každý komponent.
Docker daemon (démon) — to je serverová část, funguje na hostitelském stroji: stahuje obrazy a spouští z nich kontejnery, vytváří síť mezi kontejnery, shromažďuje logy. Když říkáme „vytvoř obraz“, toto také provádí démon.
Docker CLI — klientská část Dockeru, konzolový nástroj pro práci s démonem. Opakuji, může fungovat nejen lokálně, ale i přes síť.
Základní příkazy:
docker ps — zobrazit kontejnery, které jsou nyní spuštěny na Docker hostiteli.
docker images — zobrazit obrazy stažené lokálně.
docker search — hledání obrazu v registry.
docker pull — stáhnout obraz z registry na stroj.
docker build <> — vytvořit obraz.
docker run — spustit kontejner.
docker rm — odstranit kontejner.
docker logs — logy kontejneru.
docker start/stop/restart — práce s kontejnerem.
Pokud zvládnete tyto příkazy a budete je umět bez problémů používat, můžete považovat, že máte 70 % zvládnuto na úrovni uživatele Dockeru.
Dockerfile — instrukce pro vytvoření obrazu. Téměř každý příkaz v instrukcích je nová vrstva. Podívejme se na příkladu.
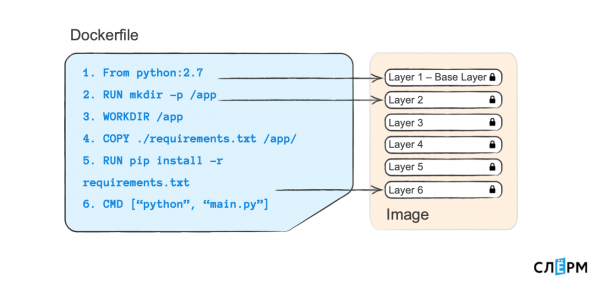
Takto vypadá Dockerfile: vlevo příkazy, vpravo — argumenty. Každý příkaz, který zde je (a vůbec se píše v Dockerfile), vytváří novou vrstvu v Image.
I když se podíváte na levou část, můžete přibližně pochopit, co se děje. Říkáme: „vytvoř nám složku“ — to je jedna vrstva. „Udělaj složku pracovním“ — to je další vrstva, a tak dále. Vrstvený koláč usnadňuje život. Pokud vytvořím další Dockerfile a na posledním řádku něco změním — nespustím "python" "main.py", ale něco jiného, nebo nainstaluji závislosti z jiného souboru — předchozí vrstvy budou znovu použity jako cache.
Obrázek — je to obal kontejneru, ze kterého se spouští kontejnery. Když se na Docker podíváme jako na správce balíčků (jako bychom pracovali s balíčky deb nebo rpm), pak image je v podstatě rpm balíček. Pomocí yum install můžeme nainstalovat aplikaci, odebrat ji, najít v repozitáři, stáhnout. Tady je to podobné: z obrazu se spouští kontejnery, které se ukládají v Docker registry (podobně jako yum, v repozitáři), a každý image má hash SHA-256, název a tag.
Image se sestavuje podle instrukcí z Dockerfile. Každá instrukce z Dockerfile vytváří novou vrstvu. Vrstvy mohou být znovu použity.
Docker registry — je repozitář obrazů Docker. Podobně jako operační systém má Docker veřejný standardní registr — Docker Hub. Je však možné vytvořit si vlastní repozitář, svou Docker registry.
Kontejner — je to, co se spouští z obrazu. Podle instrukcí z Dockerfile jsme sestavili image, a poté ho z tohoto obrazu spouštíme. Tento kontejner je izolován od ostatních kontejnerů, měl by obsahovat vše potřebné k běhu aplikace. Přičemž jeden kontejner = jeden proces. Někdy je třeba udělat dva procesy, ale to trochu odporuje ideologii Docker.
Požadavek „jeden kontejner — jeden proces“ souvisí s PID Namespace. Když se v Namespace spustí proces s PID 1, pokud náhle zemře, celý kontejner také umírá. Pokud jsou však spuštěny dva procesy: jeden žije a druhý zemřel, kontejner bude i tak pokračovat v životě. Ale to je k otázce Nejlepších praktik, o těch budeme mluvit v dalších materiálech.
Podrobněji seznámit se s vlastnostmi a celým programem kurzu lze na odkazu: „».
Autor: Marsel Ibrajev, certifikovaný administrátor Kubernetes, praktikující inženýr ve společnosti Southbridge, řečník a vývojář kurzů Slěrm.
Zdroj: habr.com
