

V tomto článku jsou shromážděny některé obecné šablony, které pomáhají inženýrům pracovat s rozsáhlými službami, na které se obracejí miliony uživatelů.
Podle zkušeností autora to není vyčerpávající seznam, ale opravdu efektivní tipy. Tak začněme.
Přeloženo s podporou .
Základní úroveň
Níže uvedená opatření jsou poměrně snadno realizovatelná, ale přinášejí vysokou návratnost. Pokud jste je dosud nezavedli, budete překvapeni významnými zlepšeními.
Infrastruktura jako kód
První část tipů spočívá v zavedení infrastruktury jako kódu. To znamená, že byste měli mít programový způsob nasazení celé infrastruktury. Zní to složitě, ale ve skutečnosti mluvíme o následujícím kódu:
Nasazení 100 virtuálních strojů
- s Ubuntu
- 2 GB RAM na každém
- budou mít následující kód
- s těmito parametry
Můžete sledovat změny v infrastruktuře a rychle se k nim vracet pomocí systému správy verzí.
Můj moderní já říká, že můžeme použít Kubernetes/Docker, abychom udělali vše výše uvedené, a má pravdu.
Kromě toho lze automatizaci zajistit pomocí Chef, Puppet nebo Terraform.
Kontinuální integrace a doručování
Pro vytvoření škálovatelné služby je důležité mít proces sestavení a testování pro každý pull request. I když je test nejjednodušší, alespoň zajišťuje, že kód, který nasazujete, se kompiluje.
Každýkrát v této fázi odpovídáte na otázku: Bude se moje sestavení kompilovat a projde testy, je platné? Může se to zdát jako nízká laťka, ale vyřeší to mnoho problémů.
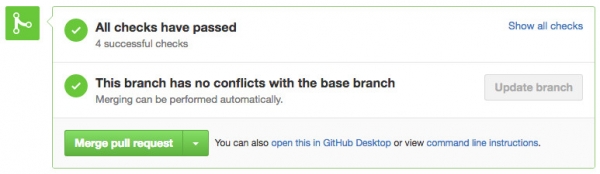
Není nic krásnějšího než vidět tyto zaškrtávací políčka
Pro tuto technologii můžete zvážit Github, CircleCI nebo Jenkins.
Vyvažovače zatížení
Takže chceme spustit vyvažovač zatížení, abychom přesměrovávali provoz a zajistili rovnoměrné zatížení na všech uzlech, nebo provoz služby v případě selhání:
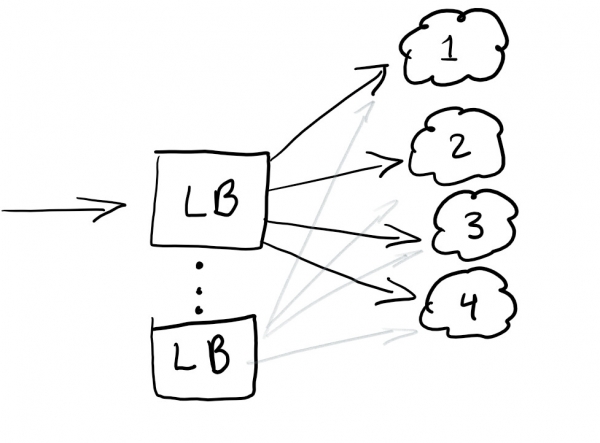
Vyvažovač zatížení obvykle dobře pomáhá distribuovat provoz. Nejlepší praxí je nadbytečné vyvážení, abyste neměli jediný bod selhání.
Obvykle jsou vyvažovače zatížení konfigurovány v tom cloudu, který používáte.
RayID, correlative ID nebo UUID pro požadavky
Setkali jste se někdy s chybou v aplikaci s podobným oznámením: „Něco se pokazilo. Uložte si toto ID a pošlete ho na naši zákaznickou podporu“?
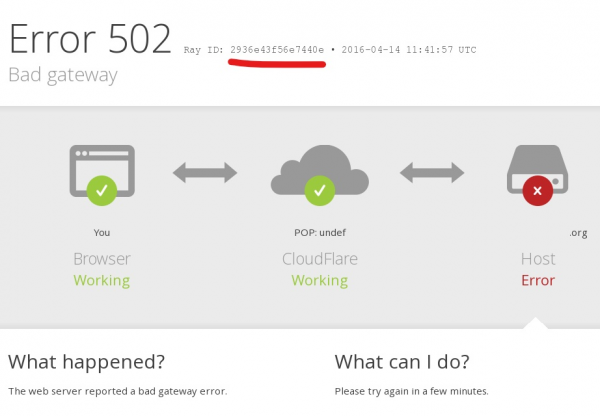
Jedinečný identifikátor, correlation ID, RayID nebo jakákoliv z variant – je to jedinečný identifikátor, který umožňuje sledovat požadavek během jeho životního cyklu. To umožňuje sledovat celou cestu požadavku v logech.
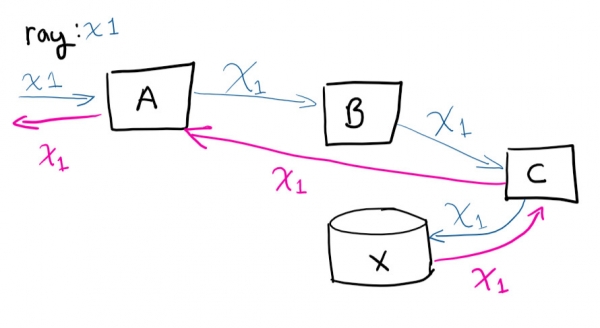
Uživatel provede požadavek na systém A, pak A naváže spojení s B, B se spojí s C, uloží do X a poté se požadavek vrátí zpět do A.
Kdybyste se vzdáleně připojili k virtuálním strojům a snažili se sledovat cestu požadavku (a manuálně přiřazovat, které výzvy probíhají), tak byste se z toho zbláznili. Mít jedinečný identifikátor výrazně usnadňuje život. To je jedna z nejjednodušších věcí, které můžete udělat, abyste ušetřili čas s rostoucím servisním zatížením.
Průměrná úroveň
Zde jsou rady složitější než předchozí, ale správné nástroje usnadňují úkol a zajišťují návratnost investic i pro malé a střední firmy.
Centralizované vedení logů
Gratuluji! Nasadili jste 100 virtuálních strojů. Druhý den ředitel přichází a stěžuje si na chybu, kterou obdržel během testování služby. Uvádí příslušný identifikátor, o kterém jsme mluvili výše, ale budete muset procházet logy 100 strojů, abyste našli ten, který selhal. A tu je třeba najít do zítřejší prezentace.
Ačkoli to zní jako zábavné dobrodružství, je lepší zajistit, aby bylo možné hledat v logech z jednoho místa. Řešil jsem úkol centralizace logů pomocí zabudované funkčnosti ELK stacku: podporuje sběr logů s možností vyhledávání. To opravdu pomůže vyřešit problém s hledáním konkrétního logu. Jako bonus můžete vytvářet grafy a podobné zábavné věci.
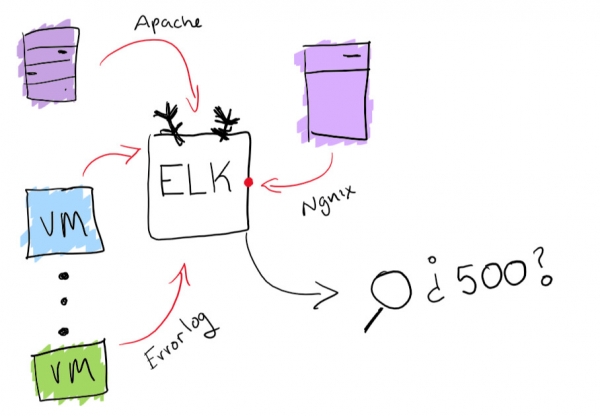
Funkčnost ELK stacku
Monitoring agents
Nyní, když je vaše služba uvedena do provozu, je třeba se ujistit, že funguje bez problémů. Nejlepší způsob, jak to udělat, je spustit několik agentů,, kteří běží současně a kontrolují, že to funguje a že se provádějí základní operace.
V této fázi ověřujete, že spuštěná sestava se dobře cítí a funguje normálně.
Pro malé a střední projekty doporučuji Postman pro monitorování a dokumentaci API. Ale celkově je důležité mít způsob, jak zjistit, kdy došlo k selhání, a obdržet včasné upozornění.
Automatické škálování podle zatížení
Je to velmi jednoduché. Pokud máte virtuální stroj, který obsluhuje dotazy, a blíží se k tomu, že 80 % paměti je obsazeno, můžete buď zvýšit jeho zdroje, nebo přidat do cloudu více virtuálních strojů. Automatické provádění těchto operací je skvělé pro pružnou změnu výkonu podle zatížení. Ale vždy byste měli být opatrní, kolik peněz utrácíte, a nastavit rozumné limity.
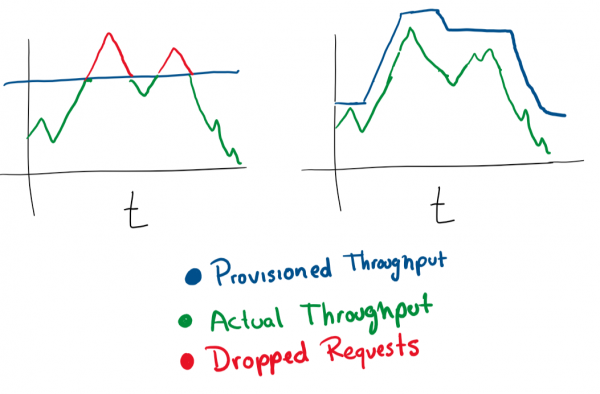
Ve většině cloudových služeb můžete nastavit automatické škálování pomocí většího počtu serverů nebo výkonnějších serverů.
Systém experimentů
Dobrou metodou pro bezpečné nasazení aktualizací je schopnost testovat něco pro 1 % uživatelů během jedné hodiny. Samozřejmě jste viděli takové mechanismy v akci. Například Facebook ukazuje části publika jinou barvu nebo mění velikost písma, aby zjistil, jak uživatelé vnímají změny. Tomu se říká A/B testování.
I uvedení nové funkcionality lze spustit jako experiment a následně určit, jak ji uvádět. Také máte možnost "vzít zpět" nebo změnit konfiguraci za chodu, pokud funkce způsobuje degradaci vašeho servisu.
Pokročilá úroveň
Zde jsou rady, které se poměrně obtížně realizují. Pravděpodobně budete potřebovat trochu více zdrojů, takže malé nebo střední společnosti by s tím měly obtíže.
Modro-zelené nasazení
To, co nazývám "erlangovým" způsobem nasazení. Erlang se stal široce používaným, když v oblasti telefonních společností přišly na scénu. Pro směrování telefonních hovorů byly použity softwarové přepínače. Hlavním úkolem softwaru těchto přepínačů bylo neztratit hovory během aktualizace systému. Erlang má skvělý způsob nahrávání nového modulu bez pádu předchozího.
Tento krok závisí na dostupnosti vyvažovače zátěže. Představme si, že máte verzi N vašeho softwaru a poté chcete nasadit verzi N+1.
Vy mohli byste prostě zastavit službu a nasadit následující verzi v čase, který považujete za pohodlný pro své uživatele, a získat nějaký čas na výpadek. Ale předpokládejme, že máte opravdu přísné podmínky SLA. SLA 99,99 % znamená, že můžete být offline pouze po dobu 52 minut ročně.
Pokud opravdu chcete dosáhnout takových ukazatelů, potřebujete dvě nasazení současně:
- to, které je právě teď (N);
- následující verzi (N+1).
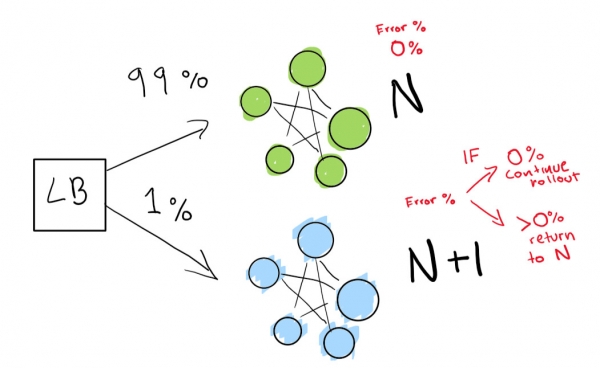
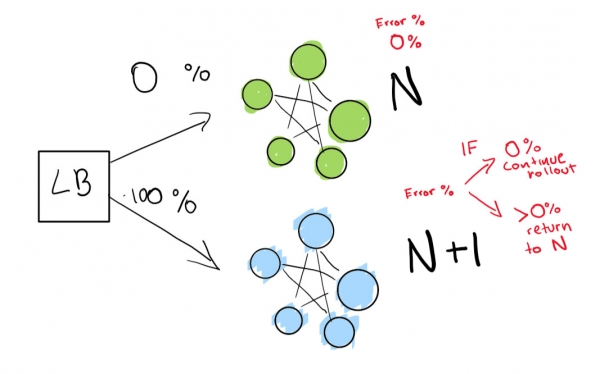
Řeknete vyvažovači zátěže, aby přesměroval procento provozu na novou verzi (N+1), zatímco aktivně sledujete regresi.
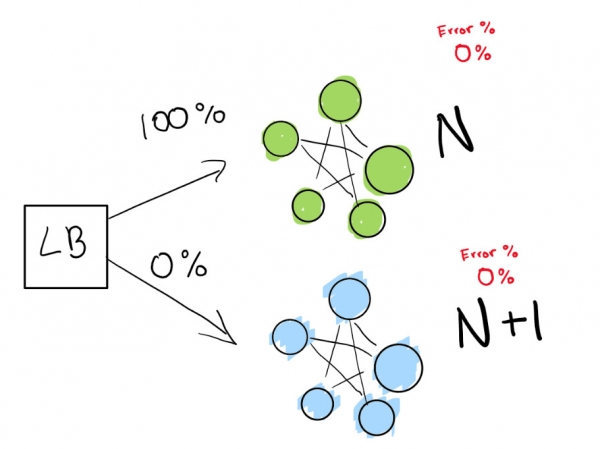
Tady máme zelené nasazení N, které normálně funguje. Snažíme se přejít na následující verzi tohoto nasazení.
Nejprve pošleme skutečně malý test, abychom zjistili, zda naše nasazení N+1 funguje s malým množstvím provozu:
Nakonec máme sadu automatických kontrol, které spouštíme, dokud naše nasazení nebude dokončeno. Pokud jste velmi, velmi opatrní, můžete také zachovat své nasazení N navždy pro rychlé vrácení zpět v případě špatné regression:
Pokud chcete přejít na ještě pokročilejší úroveň, nechte vše v modro-zeleném nasazení provádět automaticky.
Detekce anomálií a automatické zmírňování následků
S ohledem na to, že máte centralizované vedení záznamů a dobrou sběr logů, můžete si již stanovit vyšší cíle. Například proaktivně předpovídat selhání. Na monitorech a v záznamech se sledují funkce a vytvářejí různé grafy – a můžete předpovědět, co se pokazí:
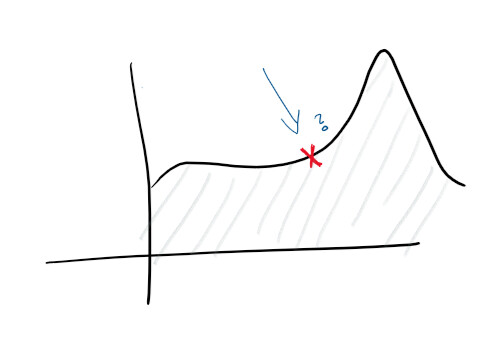
S detekcí anomálií začínáte zkoumat některé náznaky, které služba poskytuje. Například vzestup zatížení CPU může naznačovat, že pevný disk selhává, a vzestup počtu požadavků znamená, že je třeba škálovat. Takové statistické údaje umožňují učinit službu proaktivní.
Získáním takových analytických dat můžete škálovat v jakémkoli měřítku, proaktivně a reaktivně měnit vlastnosti strojů, databází, připojení a dalších zdrojů.
A to je vše!
Tento seznam priorit vás zbaví mnoha problémů, pokud přecházíte na cloudovou službu.
Autor původního článku vyzývá čtenáře, aby zanechali své komentáře a provedli úpravy. Článek je šířen jako open source, pull requesty autor .
Co dalšího si přečíst na toto téma:
Zdroj: habr.com
