

Vývoj úložiště je dlouhý a vážný proces.
Mnoho v životě projektu závisí na tom, jak dobře je promyšlená objektová modela a struktura databáze na začátku.
Obvyklým přístupem byly a zůstávají různé varianty kombinace schématu "hvězda" s třetí normální formou. Obvykle podle principu: původní data — 3NF, datové sklady — hvězda. Tento přístup, který obstál testem času a je podložen velkým množstvím studií, je prvním (a někdy i jediným), co přijde na mysl zkušenému DWH specialistovi, když přemýšlí o tom, jak by mělo analytické úložiště vypadat.
Na druhé straně se podnikání jako celek a požadavky zákazníka zvlášť rychle mění, zatímco data rostou jak "do hloubky", tak "do šíře". A tady se projevuje hlavní nedostatek hvězdy — omezená flexibilita.
A pokud ve vašem klidném a útulném životě DWH vývojáře náhle:
- vznikla úloha "udělat rychle něco, a pak se podíváme";
- se objevil rychle se rozvíjející projekt, s připojením nových zdrojů a přepracováním obchodní modelu alespoň jednou za týden;
- se objevil zákazník, který si nedokáže představit, jak by měl systém vypadat a jaké funkce by měl vykonávat, ale je otevřen experimentům a postupnému upřesňování požadovaného výsledku s postupným přiblížením se k němu;
- se objevil projektový manažer s radostnou zprávou: "A nyní máme agilní metodiku!".
Nebo pokud vás zkrátka zajímá, jak jinak lze vytvářet úložiště — vítejte pod kat!
Co znamená "flexibilita"
Nejprve si ujasněme, jaké vlastnosti by měla mít systém, aby mohl být nazván "flexibilním".
Je třeba poznamenat, že popisované vlastnosti by měly platit konkrétně pro systému, a ne pro proces jeho vývoje. Proto pokud jste chtěli číst o Agile jako metodologii vývoje, raději si přečtěte jiné články. Například zde, na Habr, je spousta zajímavého materiálu (například a , tak i ).
To není znamená, že proces vývoje a struktura DWH jsou vůbec nesouvisející. Obecně by mělo být při vývoji podle Agile flexibilní datové úložiště podstatně snazší. Nicméně v praxi se častěji setkáváme s variantami vývoje podle klasického DWH podle Kimballa a DataVault — podle vodopádu, než s šťastnými shodami flexibility v jejích dvou podobách na jednom projektu.
Jaké funkce by tedy mělo mít flexibilní datové úložiště? Zde lze vyzdvihnout tři body:
- Brzké dodání a rychlé úpravy — to znamená, že v ideálním případě by měl být první obchodní výsledek (například první funkční zprávy) dosažen co nejdříve, tedy ještě před tím, než je systém zcela navržen a implementován. Každá následující úprava by také měla zabrat co nejméně času.
- Iterativní úpravy — to znamená, že každá následující úprava by v ideálním případě neměla zasahovat do již fungujícího funkčnosti. Tento aspekt se často stává největším noční můrou na velkých projektech — dříve či později začínají jednotlivé objekty mít tolik vazeb, že je snazší zcela zopakovat logiku v kopii vedle, než přidat pole do stávající tabulky. A pokud vás překvapuje, že analýza vlivu úpravy na stávající objekty může trvat déle než samotná úprava — pravděpodobně jste ještě nepracovali s velkými DWH v bankovnictví nebo telekomunikacích.
- Nepřetržitá adaptace na měnící se obchodní požadavky — celková objektová struktura by měla být navržena nejen s ohledem na možné rozšíření, ale s výhledem na to, že směr tohoto dalšího rozšíření si ani nedokážete představit v okamžiku návrhu.
A ano, splnění všech těchto požadavků v jednom systému je možné (samozřejmě za určitých okolností a s několika výhradami).
Níže se podívám na dvě nejoblíbenější metodologie flexibilního designu pro DWH — Anchor model a Data Vault. Mezi skvělými metodami, jako je například EAV, 6NF (v čisté podobě) a všechno, co se týče NoSQL řešení, zůstává mimo pozornost – ne proto, že by nějakým způsobem byly horší, a ani ne proto, že by v tomto případě článek hrozil, že se změní na objem průměrné disertace. Všechny tyto řešení spadají do trochu jiné třídy – buď do metod, které můžete aplikovat ve specifických případech, nezávisle na celkové architektuře vašeho projektu (jako EAV), nebo do globálně jiných paradigmat ukládání informací (jako například grafové databáze a jiné varianty NoSQL).
Problémy "klasického" přístupu a jejich řešení v flexibilních metodologiích
Když mluvím o "klasickém" přístupu, myslím tím starou dobrou hvězdu (bez ohledu na konkrétní implementaci podkladových vrstev, ať mi odpustí přívrženci Kimballa, Inmona a CDM).
1. Tvrdá kardinalita vazeb
Do takového modelu je zakotveno jasné rozdělení dat na dimenze (Dimension) a fakty (Fact). A to dává smysl – analýza dat se ve většině případů soustředí právě na analýzu určitých číselných ukazatelů (faktů) v určitých řezech (dimenzích).
Přitom jsou vztahy mezi objekty zakotveny jako vazby mezi tabulkami podle cizího klíče. To vypadá docela přirozeně, ale okamžitě vede k prvnímu omezení flexibility – tvrdému určení kardinality vazeb.
To znamená, že na fázi návrhu tabulek musíte přesně určit, zda každá dvojice spojených objektů může mít vztah mnoha k mnohým, nebo jen 1 k mnohým, a v "jakém směru". Od toho přímo závisí, v které tabulce bude primární klíč a v které – cizí. Změna tohoto vztahu při obdržení nových požadavků pravděpodobně povede k přepracování databáze.
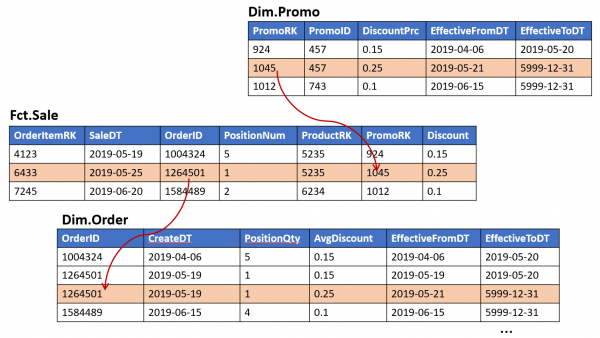
Například, při návrhu objektu "pokladní doklad" jste na základě upřímných záruk oddělení prodeje zakotvili možnost působení jedné promo akce na několik dokladových položek (ale ne naopak):
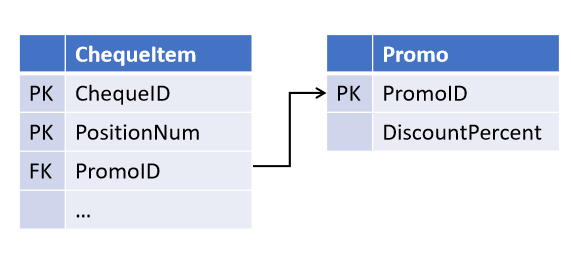
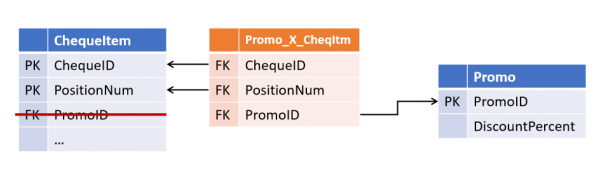
A po nějaké době kolegové zavedli novou marketingovou strategii, ve které může na jednu a tutéž položku působit několik promo akcí současně. A nyní musíte upravit tabulky, čímž vytvoříte spojení jako samostatný objekt.
(Všechny odvozené objekty, ve kterých dochází k připojení konta na promo, nyní také potřebují úpravy).
Vazby v Data Vault a Anchor Model
Vyhnout se takové situaci se ukázalo jako docela jednoduché: není třeba věřit obchodnímu oddělení, to stačí všechny vazby původně uchovávat v samostatných tabulkách a zpracovávat jako mnoho-k-mnoha.
Takový přístup navrhl Dan Linstedt jako součást paradigmatu Data Vault a byl plně podporován Lars Rönnbäck v Yakovou Modelou.
Nakonec dostáváme první charakteristickou vlastnost flexibilních metodologií:
Vazby mezi objekty nejsou uchovávány v atributech nadřazených entit, ale představují samostatný typ objektů.
V Data Vault takové vazebné tabulky se nazývají Link, a v Yakovou Modelou — Tie. Na první pohled se velmi podobají, i když se jejich názvy neomezují jen na to (o čemž bude řeč níže). V obou architekturách mohou vazebné tabulky spojit libovolný počet entit (není nutné 2).
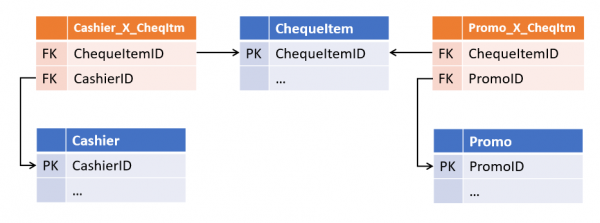
Tento na první pohled nadbytek poskytuje zásadní flexibilitu při úpravách. Taková struktura se stává tolerantní nejen vůči změnám kardinálností existujících vazeb, ale i k přidávání nových — pokud nyní bude mít pozice na účtence také odkaz na pokladníka, který ji vytvořil, vznik takové vazby se stane jednoduše nadstavbou nad existujícími tabulkami bez vlivu na jakékoli existující objekty a procesy.
2. Duplicitní data
Druhý problém, který flexibilní architektury řeší, je méně zřejmý a především typický pro měření typu SCD2 (pomalu se měnící měření druhého typu), i když nejen pro ně.
V klasickém skladu měření obvykle představuje tabulku, která obsahuje surrogate klíč (jako PK) a také sadu obchodních klíčů a atributů v samostatných sloupcích.
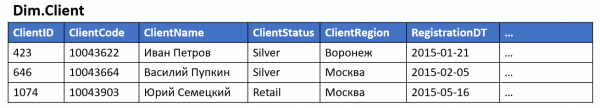
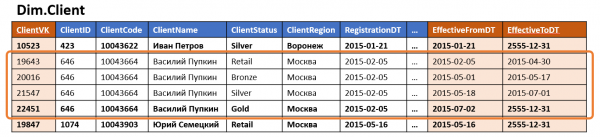
Pokud měření podporuje verzování, jsou k standardní sadě polí přidány hranice doby platnosti verze a v jednom řádku v zdroji se objevuje několik verzí ve skladu (po jedné na každou změnu verzovacích atributů).
Pokud obsahuje měření alespoň jeden často se měnící verzovaný atribut, bude počet verzí tohoto měření značný (i když ostatní atributy nejsou verzované nebo se nikdy nemění), a pokud je těchto atributů více, může počet verzí geometricky vzrůst s jejich počtem. Takové měření může zabírat značný prostor na disku, přičemž většina uložených dat jsou pouze duplicitní hodnoty neměnných atributů z jiných řádků.
Přitom se velmi často používá i denormalizace — část atributů je záměrně ukládána jako hodnota, nikoli jako odkaz na slovník nebo jiné měření. Tento přístup urychluje přístup k datům a snižuje počet spojení při dotazování na měření.
Obvykle to vede k tomu, že stejné informace jsou uloženy současně na několika místech. Například informace o regionu bydliště a příslušnosti kategorie klienta mohou být současně uloženy v měřeních „Klient“ a v faktech „Nákup“, „Doprava“ a „Obrázky do call centra“, stejně jako v tabulce spojení „Klient — Klientský manažer“.
Obecně platí, že výše popsané se vztahuje i na běžná (ne verzovaná) měření, ale ve verzovaných mohou mít jiný rozsah: vznik nové verze objektu (zejména zpětně) nevede pouze k aktualizaci všech souvisejících tabulek, ale k kaskádovému vzniku nových verzí souvisejících objektů — když Tabulka 1 je použita při vytváření Tabulky 2, a Tabulka 2 — při vytváření Tabulky 3 atd. I když žádný atribut Tabulky 1 se nepodílí na vytváření Tabulky 3 (a účastní se jiné atributy Tabulky 2, získané z jiných zdrojů), verzová aktualizace této konstrukce povede minimálně k dodatečným nákladům a maximálně k zbytečným verzím v Tabulce 3, která je tu vlastně „nevinná“, a dále po řetězci.
3. Nelineární složitost úprav
Přitom každá nová vitrina, která je budována na základě jiné, zvyšuje počet míst, kde se mohou data „rozcházet“ při provádění změn v ETL. To na oplátku vede k nárůstu složitosti (a trvání) každé další úpravy.
Pokud se výše uvedené týká systémů s málo upravovanými ETL procesy, je možné žít v takové paradigmě – stačí pečlivě sledovat, aby nové úpravy byly správně zařazeny do všech souvisejících objektů. Pokud však k úpravám dochází často, významně roste pravděpodobnost, že se náhodou "propustí" několik vazeb.
Pokud navíc zohledníme, že "verzovaný" ETL je podstatně složitější než "neverzovaný", stává se obtížným vyhnout se chybám při časté úpravě tohoto systému.
Ukládání objektů a atributů v Data Vault a Anchor Modelu
Přístup, který autoři flexibilních architektur navrhují, lze formulovat takto:
Je nutné oddělit to, co se mění, od toho, co zůstává neměnné. To znamená ukládat klíče odděleně od atributů.
Přitom bychom neměli zaměňovat neverzovaný atribut s neměnným: první neuchovává historii svých změn, ale může se měnit (například při opravě chybného zadání nebo při získání nových dat), druhý – nikdy se nemění.
Názory na to, co lze považovat za neměnné v Data Vault a Anchor modelu, se liší.
Z pohledu architektury Data Vault, za neměnné lze považovat celou sadu klíčů – přirozené (IČO organizace, kód zboží v systému zdroje atd.) a surrogate. Přitom ostatní atributy lze rozdělit do skupin podle zdroje a/nebo četnosti změn a pro každou skupinu vést samostatnou tabulku s nezávislým souborem verzí.
V paradigmatu Anchor Model je neměnný považován pouze surrogate klíč entit. Vše ostatní (včetně přirozených klíčů) je jednoduše zvláštní případ jeho atributů. Přitom všechny atributy jsou ve výchozím nastavení nezávislé na sobě, proto pro každý atribut by měla být vytvořena samostatná tabulka.
V Data Vault tabulky, obsahující klíče entit, se nazývají Huby (Hub). Huby vždy obsahují pevnou sadu polí:
- Přirozené klíče entity
- Surrogate klíč
- Odkaz na zdroj
- Čas přidání záznamu
Záznamy v Hubech se nikdy nezmění a nemají verze. Vzhledem k tomu, že jsou externě huby velmi podobné tabulkám typu ID-map, které se používají v některých systémech pro generování surrogate, doporučuje se u Data Vault používat jako surrogate nikoliv celočíselnou sekvenci, ale hash z množiny obchodních klíčů. Tento přístup usnadňuje načítání vazeb a atributů ze zdrojů (není třeba se spojovat do hubu pro získání surrogate, stačí pouze spočítat hash ze přirozeného klíče), ale může způsobit další problémy (například související s kolizemi, velikostí písmen a neviditelnými symboly v řetězcích klíčů atd.), proto není obecně přijímaný.
Všechny ostatní atributy entit se ukládají do speciálních tabulek, nazývaných Satelity (Satellit). Jeden hub může mít několik satelitů, které uchovávají různé soubory atributů.
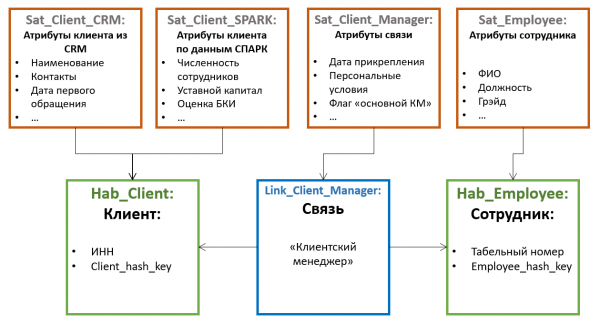
Rozdělení atributů mezi satelity probíhá na principu společné změny — v jednom satelitu mohou být uloženy nevydávané atributy (například datum narození a SNILS pro fyzické osoby), v jiném — zřídka měněné verze (například příjmení a číslo pasu), ve třetím — často měněné (například dodací adresa, kategorie, datum poslední objednávky atd.). Verze se přitom sledují na úrovni jednotlivých satelitů, nikoli entity jako celku, proto je účelné rozdělovat atributy tak, aby průnik verzí uvnitř jednoho satelitu byl minimální (což snižuje celkový počet uložených verzí).
Také, pro optimalizaci procesu načítání dat, se do samostatných satelitů často vyčleňují atributy získané z různých zdrojů.
Satelity jsou spojeny s hubem pomocí cizího klíče (což odpovídá kardinalitě 1-k-mnoha). To znamená, že vícenásobné hodnoty atributů (například několik kontaktů telefonních čísel u jednoho klienta) jsou podporovány touto architekturou „ve defaultu“.
V Model zakotvení (Anchor Model) tabulky, které uchovávají klíče, se nazývají Zakotvení (Anchor). A uchovávají:
- Pouze surrogate klíče
- Odkaz na zdroj
- Čas přidání záznamu
Přirozené klíče z pohledu Modelu zakotvení se považují za běžné atributy. Tato varianta se může zdát složitější na pochopení, ale poskytuje mnohem větší prostor pro identifikaci objektu.
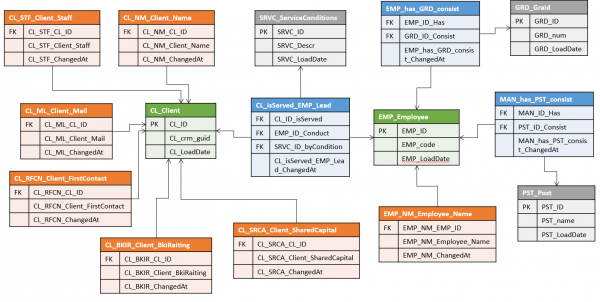
Například pokud jsou údaje o jedné a téže entitě získávány z různých systémů, z nichž každý používá svůj vlastní přirozený klíč. V Data Vault to může vést k poměrně složitým konstrukcím, které zahrnují několik hubů (po jednom na zdroj + spojující master-verzi), zatímco v Jádrovém modelu každý přirozený klíč zdroje se dostává do svého atributu a může být používán při nahrávání nezávisle na všech ostatních.
Ale zde se skrývá i jeden záludný moment: pokud se v jedné entitě spojují atributy z různých systémů, pravděpodobně existují určité pravidla "slučování", podle kterých musí systém rozumět tomu, že záznamy z různých zdrojů odpovídají jednomu objektu entity.
V Data Vault Tato pravidla pravděpodobně stanoví formování "surrogátního hubu" master-entity a nijak neovlivní Huby, které uchovávají přirozené klíče zdrojů a jejich původní atributy. Pokud se v určitém okamžiku pravidla slučování změní (nebo přijdou aktualizace atributů, podle kterých se provádí), stačí přetvořit surrogátní huby.
V Jádrový model by taková entita pravděpodobně měla být uložena v jediném jádru. To znamená, že všechny atributy, bez ohledu na to, z jakého zdroje byly získány, budou přiřazeny k jednomu a tomu samému surrogate. Rozdělit chybně slité záznamy a obecně sledovat aktuálnost slučování v takovém systému může být podstatně obtížnější, zejména pokud jsou pravidla dostatečně složitá a často se mění, a jeden a tentýž atribut může být získán z různých zdrojů (i když je přesně možné, protože každá verze atributu uchovává odkaz na svůj zdroj).
V každém případě, pokud je ve vaší systému předpokládána realizace funkčnosti deduplikačního, slučování záznamů a dalších prvků MDM, je důležité se obzvlášť pečlivě seznámit s aspekty uchovávání přirozených klíčů v flexibilních metodologiích. Pravděpodobně složitější konstrukce Data Vault se najednou ukáže jako bezpečnější z pohledu chyb slučování.
Jádrový model ve skutečnosti také zahrnuje další typ objektu nazývaný Uzlem (Knot) v podstatě jde o speciální degenerovaný typ jádra, který může obsahovat pouze jeden atribut. Uzly se předpokládají k použití pro uchovávání plochých slovníků (například pohlaví, rodinný stav, kategorie zákaznického servisu atd.). Na rozdíl od Kotvy, Uzly nemají žádné související tabulky atributů, a jejich jediný atribut (název) se vždy ukládá do jedné tabulky s klíčem. Uzly se spojují s Kotvami prostřednictvím vztahových tabulek (Tie), stejně jako kotvy mezi sebou.
Není jednoznačný názor na používání Uzlů. Například , který aktivně prosazuje používání Kotvové modelu v Rusku, se domnívá (ne bezdůvodně), že pro žádný slovník nelze přesně tvrdit, že bude vždy statický a jednovrstevný, proto pro všechny objekty je lepší ihned použít plnohodnotnou Kotvu.
Další důležité rozlišení mezi Data Vault a Kotvovým modelem spočívá v přítomnosti atributů u vztahů:
V Data Vault Vztahy jsou taktéž plnohodnotnými objekty jako Haby a mohou mít vlastní atributy. V Jádrový model Vztahy se používají pouze ke spojení Kotvy a vlastní atributy mít nemohou. Toto rozlišení dává podstatně odlišné přístupy k modelování faktů, o čemž bude řeč dále.
Uložení faktů
Do této doby jsme hovořili převážně o modelování rozměrů. S fakty to je o něco méně jednoznačné.
V Data Vault typický objekt pro uložení faktů — Vztah (Link), v Satelitech kterého se shromažďují reálné ukazatele.
Tento přístup vypadá intuitivně srozumitelně. Poskytuje snadný přístup k analyzovaným ukazatelům a celkově se podobá tradiční tabulce faktů (pouze ukazatele nejsou uloženy v samotné tabulce, ale v "sousední"). Ale existují i skryté úskalí: jedna z typických úprav modelu — rozšíření klíče faktu — vyžaduje přidání nového cizího klíče do Link. A to zase "narušuje" modularitu a potenciálně vyžaduje úpravy jiných objektů.
V Jádrový model Vztah nemůže mít vlastní atributy, proto takový přístup neprojde — všechny atributy a ukazatele musí mít vazbu na jeden konkrétní kotvu. Z toho vyplývá jednoduchý závěr — pro každý fakt je také potřeba svůj vlastní kotvu.. Pro část toho, co jsme zvyklí považovat za fakta, to může vypadat přirozeně — například fakt nákupu se krásně ztotožňuje s objektem „objednávka“ nebo „účtenka“, návštěva webu — se sezením, atd. Ale objevují se i fakta, pro která není tak snadné najít přirozený „objekt, nosič“ — například zbytkové zboží na skladech na začátku každého dne.
Odpovídajícím způsobem se při rozšiřování klíče faktu v Anchor modelu nevyskytují problémy s modularitou (stačí jednoduše přidat novou vazbu k odpovídajícímu kotvě), ale navrhování modelu pro zobrazení faktů je méně jednoznačné a mohou se objevovat „umělé“ kotvy, které nevhodně reprezentují objektový model podnikání.
Jak se dosahuje flexibility
Výsledná konstrukce v obou případech obsahuje významně více tabulek, než tradiční měření. Ale může zabírat významně méně diskového prostoru při stejném souboru verzi atributů jako tradiční měření. Žádná magie tu samozřejmě není — vše tkví v normalizaci. Rozdělením atributů do Satelitů (ve Data Vault) nebo do samostatných tabulek (Anchor Model) snižujeme (nebo úplně vylučujeme) duplicitní hodnoty některých atributů při změně jiných.
Pro Data Vault zisk bude záviset na rozložení atributů do Satelitů, a pro Jádrový model — prakticky přímo úměrný průměrnému počtu verzí na objekt měření.
Nicméně zisk z obsazení prostoru — důležitá, ale ne hlavní výhoda odděleného ukládání atributů. Spolu s odděleným uložením vazeb dělá tento přístup úložiště modulární konstrukcí. To znamená, že přidání jak jednotlivých atributů, tak celých nových subjektových oblastí v takovém modelu vypadá jako nadzvednutí nad existujícím souborem objektů bez jejich změny. A to je přesně to, co dělá popsané metodiky flexibilními.
Taktéž to připomíná přechod od kusové výroby k sériové — pokud v tradičním přístupu každá tabulka modelu je jedinečná a vyžaduje zvláštní pozornost, pak v flexibilních metodikách — to už je soubor standardních „dílů“. Na jedné straně se počet tabulek zvyšuje, procesy načítání a výběru dat se musí zdát složitější. Na druhé straně se stávají standardizovanými. A to znamená, že mohou být automatizovány a spravovány metadatami. Otázka „jak budeme ukládat?“, na kterou mohla odpověď zabrat podstatnou část práce na projektování úprav, nyní prostě nestojí (stejně jako otázka o vlivu změny modelu na pracovní procesy).
To neznamená, že analytici v takovém systému vůbec nejsou potřeba — někdo stále musí zpracovat sadu objektů s atributy a zjistit odkud a jak to vše načítat. Ale objem práce, stejně jako pravděpodobnost a cena chyby se podstatně snižují. Jak v analýze, tak při vývoji ETL, který se v podstatné části může scvrknout na editaci metadat.
Temná stránka
Vše výše popsané dělá oba přístupy skutečně flexibilní, technologické a vhodné pro iterativní úpravy. Samozřejmě existuje i „barel dehtu“, o kterém, myslím, už tušíte.
Dekonstrukce dat, ležící v základě modulárnosti flexibilních architektur, vede ke zvýšení počtu tabulek a tím pádem nákladů na spojení při výběru. K tomu, abyste jednoduše získali všechny atributy měření, v klasickém datovém skladu stačí jeden SELECT, zatímco flexibilní architektura bude vyžadovat celou řadu JOINů. A pokud pro reporty je možné všechny tyto JOINy napsat předem, analytici, zvyklí psát SQL ručně, budou trpět dvakrát.
Existuje několik faktů, které usnadňují takovou situaci:
Při práci s velkými měřeními se téměř nikdy nepoužívají současně všechny jeho atributy. To znamená, že může být méně JOINů, než se na první pohled zdá z modelu. V Data Vault lze také zohlednit předpokládanou frekvenci společného používání při rozdělování atributů do satelitů. Přitom samotné Huby nebo Kotvy jsou potřebné především pro generování a mapování surrogate na etapě načítání a zřídka se používají v dotazech (to se obzvlášť týká Kotvy).
Všechny JOINy — podle klíče. Kromě toho, kompaktnější způsob ukládání dat snižuje režijní náklady na skenování tabulek tam, kde je to potřeba (například při filtrování podle hodnoty atributu). To může vést k tomu, že výběr z normalizované databáze s mnoha JOINy bude dokonce rychlejší než skenování jedné těžké dimenze s velkým počtem verzí na řádek.
Například v článku je podrobný srovnávací test výkonu Anchor Modelu s výběrem z jedné tabulky.
Mnoho závisí na enginu. Mnoho moderních platforem má interní mechanismy optimalizace JOINů. Například MS SQL a Oracle umějí "přeskočit" JOINy na tabulky, pokud jejich data nejsou nikde využívána, kromě jiných JOINů a neovlivňují finální výběr (eliminace tabulky/JOINu), zatímco MPP Vertica podle , se ukázala jako skvělý engine pro Anchor Model s ohledem na určitou manuální optimalizaci plánu dotazu. Na druhou stranu, uchovávat Anchor Model například na Click House, který má omezenou podporu JOINu, se zatím nejeví jako nejlepší nápad.
Kromě toho, pro obě architektury existují speciální techniky, které usnadňují přístup k datům (jak z pohledu výkonu dotazů, tak pro koncové uživatele). Například, Point-In-Time tabulky v Data Vault nebo speciální tabulkové funkce v Anchor Modelu.
Celkem
Hlavní podstata diskutovaných flexibilních architektur spočívá v modularitě jejich "konstrukce".
Jedná se o vlastnost, která umožňuje:
- Po určitém počátečním nastavení, spojeném s nasazením metadat a psaním základních ETL algoritmů, rychle poskytnout zákazníkovi první výsledek ve formě několika reportů, obsahujících data pouze několika zdrojových objektů. Není nutné plně promýšlet (ani na vysoké úrovni) celou objektovou model pro to.
- Datový model může začít fungovat (a přinášet užitek) s pouhými 2-3 objekty a poté postupně narůstat (co se týče Anchor Modelu, Nikolaj hezky přirovnání k houbovému myceliu).
- Většina úprav, včetně rozšíření předmětu a přidání nových zdrojů se nedotýká stávajícího funkcionality a neohrožuje rozbití něčeho, co již funguje..
- Díky dekompozici na standardní prvky vypadají ETL procesy v těchto systémech jednotně, jejich psaní se dá algoritmizovat a v konečném důsledku automatizovat.
Cena této flexibility spočívá v výkonu. To neznamená, že dosažení přijatelných výkonových metrik na takových modelech je nemožné. Často vám může stačit pouze více úsilí a pozornosti k detailům pro dosažení požadovaných metrik.
Aplikace
Typy entit Data Vault
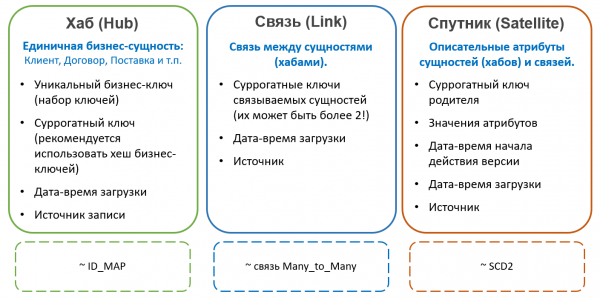
Více o Data Vault:
Typy entit Anchor Model
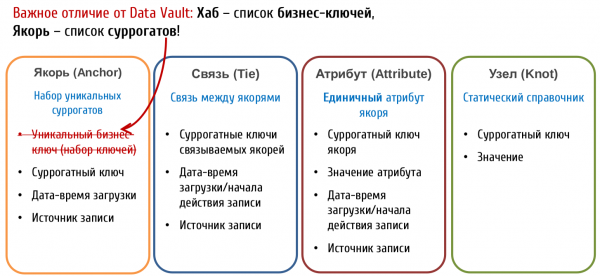
Více o Anchor Model:
Shrnutí s běžnými rysy a rozdíly uvedených přístupů:
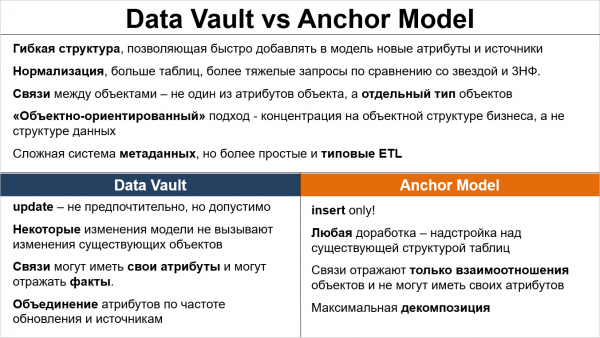
Zdroj: habr.com
