

– O, žádný úkryt nepřežije zásah meteoritu. Ale i vy, jako každý, máte rezervu, takže si nemusíte dělat starosti.
Stanislav Lem, „Hvězdné deníky Ijona Tichého“
Zálohování znamená uchování kopie dat někde mimo hlavní místo jejich ukládání.
Hlavním účelem zálohování je obnovení dat po jejich ztrátě. V této souvislosti se často říká, že pokud máte replikaci databáze, data můžete vždy obnovit z ní, a zálohování je tedy zbytečné. Ve skutečnosti zálohování umožňuje vyřešit alespoň tři úkoly, které nelze vyřešit pomocí repliky, a replikaci bez zálohy nelze ani inicializovat.
Za prvé, záloha umožňuje obnovit data po logické chybě. Například účetní smazal skupinu účetních dokladů nebo správce databáze zničil tabulkový prostor. Obě operace jsou z pohledu databáze naprosto legální, a proces replikace je přenese do replikované databáze.
Za druhé, moderní SŘBD jsou velmi spolehlivé programové komplexy, avšak občas k poškození vnitřních struktur databáze dochází, což vede ke ztrátě přístupu k datům. Což je obzvlášť nepříjemné, protože k takovému porušení dochází obvykle při vysoké zátěži nebo během instalace nějaké aktualizace. Ale jak vysoká zátěž, tak pravidelné aktualizace naznačují, že databáze rozhodně není testovací a data, která obsahuje, jsou cenná.
Nakonec třetí úkol, jehož řešení vyžaduje existenci zálohy, je klonování databáze, například pro testovací účely.
Zálohování databází stojí na jednom ze dvou principů:
- Výběr dat s následným uložením v libovolném formátu;
- Snímek stavu souborů databáze a uchování protokolů.
Podívejme se na tyto principy a nástroje, které je realizují, podrobněji.
Export dat
V sadě nástrojů přiložených k jakékoliv SŘBD jsou vždy dostupné nástroje pro export a import dat. Data se ukládají buď v textovém formátu, nebo ve specifickém binárním formátu pro konkrétní SŘBD. V následující tabulce jsou uvedeny takové nástroje:
Binární formát
Textový formát
Oracle
DataPump Export/DataPump Import
Export/Import
SQL*Plus/SQL*Loader
PostgreSQL
pg_dump, pg_dumpall/pg_restore
pg_dump, pg_dumpall/psql
Microsoft SQL Server
bcp
bcp
DB2
unload/load
unload/load
MySQL
mysqldump, mysqlpump/mysql, mysqlimport
MongoDB
mongodump/mongorestore
mongoexport/mongoimport
Cassandra
nodetool snapshot/sstableloader
cqlsh
Textový formát je dobrý v tom, že jej lze upravovat nebo dokonce vytvářet pomocí externích programů, zatímco binární formát je dobrý, protože umožňuje rychlejší export a import dat díky úspoře zdrojů při převodu formátů.
Přes jednoduchost a zjevnost myšlenky exportu dat se tento způsob pro zálohování vytížených průmyslových databází používá zřídka. Zde jsou důvody, proč export není vhodný pro plnohodnotné zálohování:
- proces exportu vytváří značné zatížení na systému zdroje;
- export trvá dlouho – k okamžiku dokončení exportu již nebude aktuální;
- uskutečnit konzistentní export celé databáze za vysoké zátěže je prakticky nemožné, protože DBMS musí uchovat snímek svého stavu v okamžiku zahájení exportu. Čím více transakcí se uskutečnilo od začátku exportu, tím větší objem snímku (neaktuálních kopií dat v PostgreSQL, undo prostoru v Oracle, tempdb v Microsoft SQL Server apod.);
- export uchovává logickou strukturu dat, ale neuchovává jejich fyzickou strukturu – parametry fyzického uložení tabulek, indexy atd.
Nicméně export má také výhody:
- vysoká selektivita: lze exportovat určité tabulky, jednotlivé sloupce a dokonce i jednotlivé řádky;
- exportovaná data lze načíst do databáze jiné verze, a pokud byl export proveden ve formátu textu, tak i do jiné databáze.
Tímto způsobem se export v zásadě používá především pro úkoly jako zálohování malých tabulek (například slovníků) nebo distribuci datových sad s dalším uvedením aplikace.
Nejrozšířenějším způsobem zálohování databází je však kopírování souborů databáze.
„Studené“ ukládání souborů DB
Zřejmá myšlenka – zastavit databázi a zkopírovat všechny její soubory. Tato záloha se nazývá „studená“. Metoda je krajně spolehlivá a jednoduchá, ale má dva zjevné nedostatky:
- Z „studené“ zálohy je možné obnovit pouze stav databáze, který existoval v okamžiku zastavení; transakce provedené po restartu databáze se do „studené“ zálohy nedostanou.
- Není každá databáze vybavena časovým oknem, kdy ji lze zastavit.
Pokud vám vyhovuje „studené“ zálohování, měli byste mít na paměti, že
- „studená“ kopie by někdy měla zahrnovat i žurnály. Metody určování žurnálů, které by měly být zahrnuty do „studené“ kopie, se liší pro každou SŘBD. Například v Oracle je nutné zkopírovat takzvané online redo, tedy pevný počet žurnálových souborů ve speciálním adresáři, a to i tehdy, když je databáze správně zastavena. V PostgreSQL je potřeba uchovat všechny žurnály počínaje tím, který obsahuje poslední kontrolní bod, jehož informace jsou obsaženy v řídícím souboru.
- Adresář databáze může obsahovat poměrně velké soubory dočasných tabulkových prostorů, které není nutné zahrnout do zálohy. Mimochodem, toto pozornění platí i pro „horké“ zálohování.
„Horké“ zálohování souborů
Většina záloh moderních databází je prováděna kopírováním souborů databáze bez zastavení databáze. Zde se objevuje několik problémů:
- V okamžiku zahájení kopírování se obsah databáze nemusí shodovat s obsahem souborů, protože část informací je v mezipaměti a ještě nebyla zapsána na disk.
- Během kopírování se obsah databáze může měnit. Pokud jsou používány měnitelné datové struktury, mění se obsah souborů, a pokud jsou používány neměnitelné struktury, mění se souborová sada: nové soubory se objevují, zatímco staré jsou odstraňovány.
- Protože zápis dat do databáze a čtení souborů DB nejsou nijak synchronizovány, může program zálohování přečíst nesprávnou stránku, ve které polovina bude z staré verze stránky a druhá polovina – z nové.
Aby záloha byla konzistentní, existuje pro každou SŘBD příkaz, který oznamuje, že byl zahájen proces zálohování. Syntakticky se tento příkaz může lišit:
- v Oracle je to samostatný příkaz ALTER DATABASE/TABLESPACE BEGIN BACKUP;
- v PostgreSQL – funkce pg_start_backup();
- Příprava na zálohování v Microsoft SQL Server a DB2 probíhá implicitně během provádění příkazu BACKUP DATABASE;
- V MySQL Enterprise, Cassandra a MongoDB se příprava implicitně provádí externím nástrojem – mysqlbackup, OpsCenter a Ops Manager v tomto pořadí.
Navzdory syntaktickým rozdílům vypadá proces přípravy na zálohování stejně.
Takto vypadá příprava na zálohování v systémech s měnitelnou diskovou strukturou, tedy ve všech tradičních diskových relačních systémech:
- Zaznamená se okamžik začátku zálohování; záloha bude obsahovat záznamy databáze od tohoto okamžiku.
- Provede se kontrolní bod, což znamená, že všechny změny, které se staly na datech před zaznamenaným okamžikem, se uloží na disk. To zaručuje, že záznamy před začátkem zálohování nebudou potřeba při obnovení.
- Aktivuje se speciální režim zaznamenávání: pokud je stránka dat poprvé změněna po načtení z disku, namísto toho, aby se změna stránky zaznamenala do protokolu, se zaznamená celá stránka. Během přípravného procesu se všechny stránky zapíší na disk, a proto při prvním změně bude blok vždy zaznamenán v protokolu jako celek. Pokud však bude stránka během zálohování opět zapsána na disk, pak její další změna povede také k zaznamenání celé kopie stránky v protokolu. To zaručuje, že pokud dojde k poškození stránky při kopírování datového souboru, použití protokolu ji znovu opraví.
- Zablokuje se změna hlaviček datových souborů, tedy té části, jejíž změny nejsou zaznamenány v protokolech. To zaručuje, že hlavička bude kopírována správně a poté budou k datovému souboru správně aplikovány protokoly.
Jakmile jsou všechny výše uvedené postupy dokončeny, je možné kopírovat datové soubory pomocí prostředků operačního systému – cp, rsync a dalších. Aktivace režimu zálohování snižuje výkon databáze: za prvé, zvyšuje se objem žurnálů, a za druhé, pokud dojde k chybě v režimu zálohování, obnova bude časově náročnější, protože se neaktualizují hlavičky datových souborů. Čím rychleji se zálohování dokončí, tím lépe pro databázi, proto je zde vhodné využít nástroje jako je snímek (snapshot) souborového systému nebo roztržení zrcadla (BCV) v diskovém poli. Některé SŘBD (Oracle, PostgreSQL) umožňují administrátorovi sám vybrat způsob kopírování, jiné (Microsoft SQL Server) nabízejí rozhraní pro integraci vlastních zálohovacích utilit s mechanismy souborových systémů nebo SÓŘ.
Po dokončení zálohování je třeba vrátit databázi zpět do běžného stavu. V Oracle se to provádí příkazem ALTER DATABASE/TABLESPACE END BACKUP, v PostgreSQL – voláním funkce pg_stop_backup(), a v jiných databázích – vnitřními podprogramy příslušných příkazů nebo externích služeb.
Takto vypadá časová diagram procesu zálohování:
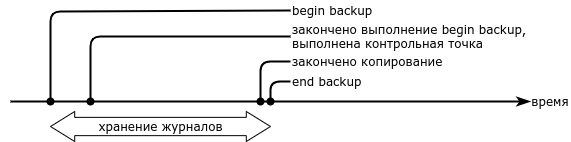
- Příprava na zálohování (begin backup) zabírá čas, někdy značný. I když se používají zrcadlové svazky nebo souborové systémy s možností vytváření snímků, proces zálohování nebude okamžitý.
- Spolu s datovými soubory je nutné uchovat žurnály počínaje okamžikem zahájení přípravy na zálohování a konče okamžikem návratu databáze do normálního stavu.
- Obnovit se z této zálohy lze v momentě, kdy se databáze vrátí do normálního stavu. Obnova k dřívějšímu okamžiku není možná.
Se zařízeními databází, které používají neměnné datové struktury (snímky paměti, LSM-stromy), je situace jednodušší. Příprava na zálohování se skládá z následujících kroků:
- Data z paměti se zapisují na disk.
- Je zaznamenán seznam souborů zahrnutých do zálohy. Do té doby, dokud proces zálohování neskončí, je databázi zakázáno mazat tyto soubory, i když se stanou nepotřebnými.
Na signál o ukončení zálohování může databáze s neměnnými strukturami opět mazat nepotřebné soubory.
Obnovení na bod
Záloha umožňuje obnovit stav databáze k okamžiku, kdy byla dokončena příkaz k návratu z režimu zálohování. Avšak havárie, po níž bude třeba obnovit, může nastat kdykoli. Úkol obnovit stav DB k libovolnému okamžiku se nazývá „obnovení na bod“ (point-in-time recovery).
Aby byla tato možnost zajištěna, měly by se uchovávat protokoly DB od okamžiku ukončení zálohování, a během obnovy pokračovat v aplikaci protokolů na obnovenou kopii. Poté, co byla DB obnovena ze zálohy k okamžiku ukončení kopírování, je stav databáze (soubory a mezipaměť stránek) zaručeně správný, proto není potřeba žádný speciální režim protokolování. Aplikací protokolů do požadovaného okamžiku lze získat stav databáze k libovolnému bodu v čase.
Pokud je rychlost obnovení zálohy omezena pouze šířkou pásma disku, pak je rychlost aplikace protokolů obvykle omezena výkonem procesoru. Pokud dochází ke změnám v primární databázi paralelně, pak při obnově jsou všechny změny prováděny sekvenčně – v pořadí čtení z protokolu. Tímto způsobem čas obnovení lineárně závisí na tom, jak daleko je bod obnovení od bodu ukončení zálohování. Z tohoto důvodu je potřeba docela často provádět úplné zálohy – minimálně jednou týdně pro databáze s nízkou transakční zátěží a až po každodenní zálohy pro vysoce zatížené databáze.
Inkrementální zálohování
Aby se urychlilo obnovení na bod, bylo by dobré mít možnost provádět zálohování co nejčastěji, ale zároveň nezabírat zbytečné místo na discích a nezatěžovat databázi úkoly zálohování.
Řešení problému – inkrementální zálohování, tedy kopírování pouze těch stránek dat, které se změnily od posledního zálohování.
Inkrementální zálohování dává smysl pouze pro databáze, které používají měnitelné datové struktury.
Inkrement může být počítán jak od úplné zálohy (kumulativní záloha), tak od jakékoli předchozí zálohy (diferenciální záloha).
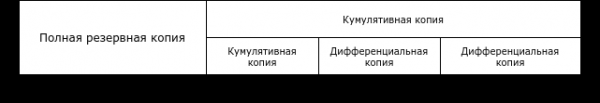
Bohužel neexistuje jednotná terminologie, a různí výrobci používají různé termíny:
Diferenciální
Kumulativní
Oracle
Diferenciální
Kumulativní
PostgresPro
Inkrementální
—
Microsoft SQL Server
—
Diferenciální
IBM DB2
Delta
Inkrementální
Při existenci inkrementálních kopií vypadá proces obnovení k určitému bodu následovně:
- obnoví se poslední úplná záloha, která byla provedena před okamžikem obnovení;
- na plnou kopii se obnoví inkrementální kopie;
- aplikují se protokoly od bodu začátku zálohování do bodu obnovení.
Přítomnost kumulativní kopie urychluje proces obnovení. Například pro obnovení stavu databáze k bodu mezi T3 a T4 je třeba obnovit dvě inkrementální kopie, ale pro obnovení k bodu po T4 – pouze jednu.
Je zřejmé, že objem jedné kumulativní kopie je menší než objem několika diferenciálních kopií, protože některé stránky byly změněny několikrát a každá inkrementální kopie obsahuje svou verzi stránky.
Existují tři způsoby, jak vytvořit inkrementální kopii:
- vytvoření úplné kopie a výpočet rozdílu s předchozí úplnou kopií;
- analýza protokolů, vytvoření seznamu změněných stránek a zálohování stránek zahrnutých v seznamu;
- dotaz na změněné stránky v databázi.
První způsob šetří diskový prostor, ale neřeší úkol snížení zátěže na databázi. Dále, pokud máme úplnou zálohu, pak není smysluplné ji měnit na inkrementální, protože obnova úplné kopie je rychlejší než obnova předchozí úplné kopie a inkrementu. Úkol úspory diskového prostoru při tomto přístupu je lepší přenést na specializované komponenty s vestavěnými mechanismy deduplikace. Mohou to být jak specializované úložiště (EMC DataDomain, HPE StorageWorks VLS, celá řada NetApp), tak softwarové produkty (ZFS, Veritas NetBackup PureFile, Windows Server Data Deduplication).
Druhý a třetí způsob se liší mechanismem určení seznamu změněných stránek. Analýza protokolů je časově náročnější a navíc je nutné znát strukturu protokolových souborů. Nejjednodušší je se zeptat samotné databáze, které stránky se změnily, ale k tomu musí jádro DBMS mít funkčnost sledování změněných bloků (block change tracking).
Poprvé byla funkčnost inkrementálního zálohování implementována v softwaru Oracle Recovery Manager (RMAN), který se objevil v releasu Oracle 8i. Oracle okamžitě zrealizoval sledování změněných bloků, proto není potřeba provádět analýzu protokolů.
PostgreSQL nesleduje změněné bloky, a proto nástroj pg_probackup, vyvinutý ruskou společností Postgres Professional, určuje změněné stránky analýzou protokolu. Společnost však dodává i DBMS PostgresPro, která zahrnuje rozšíření ptrack, sledující změny stránek. Při použití pg_probackup s DBMS PostgresPro nástroj dotazuje změněné stránky přímo u databáze – přesně tak, jak to dělá RMAN.
Microsoft SQL Server, stejně jako Oracle, sleduje změněné stránky, ale příkaz BACKUP umožňuje vytvářet pouze úplné a kumulativní zálohy.
V DB2 existuje možnost sledování změněných stránek, ale je ve výchozím nastavení vypnuta. Po jejím zapnutí DB2 umožní vytvářet úplné, diferencované a kumulativní zálohy.
Důležité rozdíly mezi nástroji popsanými v této části (kromě pg_probackup) a souborovými zálohovacími nástroji spočívají v tom, že dotazují databázi na obrázky stránek, místo aby samostatně čtly data z disku. Nevýhodou tohoto přístupu je mírné dodatečné zatížení databáze. Nicméně tato nevýhoda je více než kompenzována tím, že přečtená stránka je vždy správná, a proto není třeba dočasně zapínat speciální režim protokolování během zálohování.
Ještě jednou upozorňujeme, že existence inkrementálních kopií nezrušuje požadavky na uchování protokolů pro obnovení k libovolnému bodu v čase. Proto jsou v průmyslových databázích protokoly neustále přepisovány na externí médium a zálohy, úplné a/nebo inkrementální, jsou vytvářeny podle plánu.
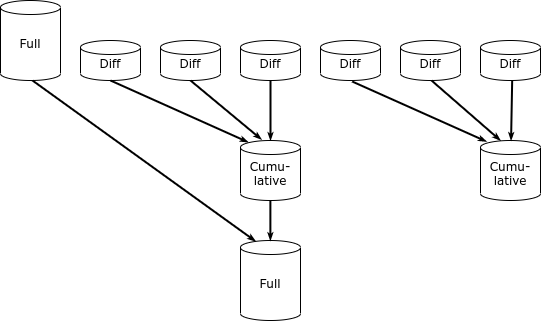
Nejlepší realizací myšlenky inkrementálního zálohování je software-hardware systém (v terminologii Oracle – engineered system) Zero Data Loss Recovery Appliance – specializované řešení Oracle pro zálohování vlastní databáze. Systém představuje klastr servery s velkým objemem disků, na které je nainstalována modifikovaná verze softwaru Recovery Manager, a může pracovat jak s jinými software-hardware systémy Oracle (Database Appliance, Exadata, SPARC Supercluster), tak s databázemi Oracle na tradiční infrastruktuře. Na rozdíl od „běžného“ RMAN, v ZDLRA je realizována koncepce „věčného inkrementu“ (incremental forever). Systém jednou vytváří plnou kopii databáze a poté provádí pouze inkrementální kopie. Další moduly RMAN umožňují spojovat kopie a vytvářet nové plné kopie z inkrementálních.
Ku cti ruských vývojářů je třeba zmínit, že i pg_probackup umí spojovat inkrementální kopie.
Na rozdíl od mnoha podobných otázek má otázka „jaká metoda zálohování je nejlepší“ jednoznačnou odpověď – nejlépe je nativní nástroj pro použitý SGBD, který zajišťuje možnost inkrementálního zálohování.
Pro správce databáze jsou mnohem důležitější otázky výběru strategie zálohování a integrace nástrojů zálohování databází do firemní infrastruktury. Tyto otázky však překračují rámec tohoto článku.
Zdroj: habr.com
