

Poslední zhruba půlrok jsem se věnoval vytváření systému na boj proti podvodům (fraudulent activity, fraud, atd.) bez jakékoli počáteční infrastruktury pro to. Dnešní nápady, které jsme našli a implementovali do našeho systému, nám pomáhají odhalovat množství podvodných činů a analyzovat je. V tomto článku bych chtěl hovořit o principech, kterými jsme se řídili, a o tom, co jsme udělali pro dosažení současného stavu našeho systému, aniž bychom se ponořili do technických detailů.
Principy našeho systému
Když slyšíte takové termíny jako „automatic“ a „fraud“, pravděpodobně začínáte přemýšlet o strojovém učení, Apache Spark, Hadoop, Python, Airflow a dalších technologiích ekosystému Apache Foundation a oblasti Data Science. Myslím, že existuje jeden aspekt používání těchto nástrojů, který obvykle není zmiňován: vyžadují určité předpoklady ve vaší firemní infrastruktuře, než je začnete používat. Jinými slovy, potřebujete podnikovou datovou platformu, která zahrnuje datové jezero a úložiště. Ale co když takovou platformu nemáte a přesto potřebujete tuto praxi rozvíjet? Následující principy, o kterých budu hovořit níže, nám pomohly dosáhnout bodu, kdy se můžeme soustředit na zlepšování našich nápadů, namísto jejich hledání. Přesto to není „plateau“ projektu. Z pohledu technologie a produktu je ještě mnoho věcí, které je třeba udělat.
Princip 1: Hodnota pro podnikání na prvním místě
Na vrcholu všech našich snah jsme postavili „hodnotu pro podnikání“. Celkově jakýkoli systém automatizované analýzy spadá do skupiny složitých systémů s vysokou úrovní automatizace a technické náročnosti. Vytvoření dokončeného řešení zabere spoustu času, pokud je vytvoříte od nuly. Rozhodli jsme se postavit na první místo hodnotu pro podnikání a na druhé technologickou úplnost. V reálném životě to znamená, že nepřijímáme špičkové technologie jako dogma. Volíme technologii, která pro nás v tuto chvíli nejlépe funguje. Časem se může ukázat, že budeme muset některé moduly znovu implementovat. Tento kompromis jsme přijali.
Princip 2: Augmentovaná inteligence (augmented intelligence)
Sázím se, že většina lidí, kteří nejsou hluboce zapojeni do vývoje strojového učení, si může myslet, že cílem je nahradit lidi. Ve skutečnosti jsou řešení strojového učení daleko od dokonalosti a náhrada je možná pouze v určitých oblastech. Tuto myšlenku jsme od samého začátku zavrhli z několika důvodů: nevyvážená data o podvodné činnosti a nemožnost poskytnout vyčerpávající seznam funkcí pro modely strojového učení. Na rozdíl od toho jsme zvolili variantu rozšířeného inteligence. To je alternativní koncept umělé inteligence, který se soustředí na podpůrnou roli AI, zdůrazňující skutečnost, že kognitivní technologie mají za cíl zlepšit lidskou inteligenci, nikoli ji nahradit. [1]
Vzhledem k tomu byla vývoj plného řešení strojového učení od samého začátku by vyžadoval obrovské úsilí, které by zpozdilo vytvoření hodnoty pro naše podnikání. Rozhodli jsme se vybudovat systém s iterativně rostoucím aspektem strojového učení pod vedením našich odborníků v oblasti. Složitá část vývoje takového systému spočívá v tom, že musí poskytovat našim analytikům případy nejen z hlediska toho, zda jde o podvodnou činnost, nebo ne. Obecně platí, že jakákoli anomálie v chování zákazníků je podezřelý případ, který musí specialisté vyšetřit a na nějakou způsob reagovat. Pouze nějaká část těchto zaznamenaných případů může být skutečně zařazena do kategorie podvodů.
Princip 3: platforma rozsáhlých analytických dat
Nejkomplexnější část našeho systému je průběžná kontrola pracovních toků systému. Analytici a vývojáři by měli mít snadný přístup k datovým sadám za minulé období se všemi metrikami, které byly použity pro analýzu. Kromě toho by datová platforma měla poskytovat jednoduchý způsob, jak doplnit stávající sadu ukazatelů o nové. Procesy, které vytváříme, nejen softwarové procesy, by měly umožnit snadné přepočítání předchozích období, přidávání nových metrik a změnu datových prognóz. Toho bychom mohli dosáhnout shromažďováním všech dat generovaných naším výrobním systémem. V takovém případě by se data postupně stala překážkou. Museli bychom uchovávat rostoucí objem dat, která nepoužíváme, a chránit je. V takovém scénáři by časem byla data stále méně relevantní, avšak stále by vyžadovala naši pozornost pro správu. Pro nás nemělo smysl akumulovat data (data hoarding), a tedy jsme se rozhodli zvolit jiný přístup. Rozhodli jsme se uspořádat úložiště dat v reálném čase kolem cílových entit, které chceme klasifikovat, a uchovávat pouze ta data, která umožňují ověřit nejnovější a aktuální období. Komplexnost těchto snah spočívá v tom, že náš systém je heterogenní, se několika úložišti dat a softwarovými moduly, které vyžadují pečlivé plánování pro souvislou činnost.
Konstructivní koncepty našeho systému
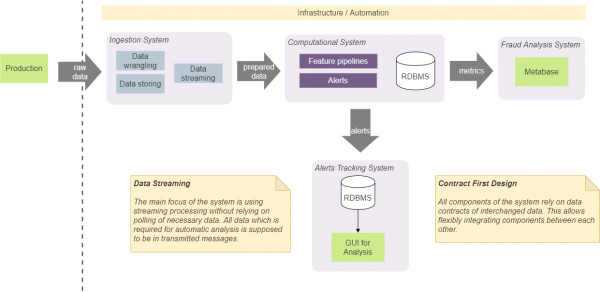
Máme čtyři hlavní komponenty v našem systému: systém příjmu (ingestion system), výpočetní (computational), analýzu (BI analysis) a systém sledování (tracking system). Tyto komponenty slouží specifickým izolačním cílům a udržujeme je izolované podle vybraných přístupů ve vývoji.
Design na základě smluv
Především jsme se dohodli, že komponenty by měly spoléhat pouze na určité struktury dat (smlouvy), které jsou mezi nimi předávány. To umožňuje snadnou integraci mezi nimi a nenutí konkrétní složení (a pořadí) komponentů. Například v některých případech nám to umožňuje přímo integrovat přijímací systém se systémem sledování upozornění. V takovém případě to bude provedeno v souladu se dohodnutou smlouvou o upozornění. To znamená, že oba komponenty budou integrovány pomocí smlouvy, kterou může použít jakákoli jiná komponenta. Nebudeme přidávat další smlouvu o přidání upozornění do systému sledování ze systému vstupu. Takový přístup vyžaduje použití předem definovaného minimálního počtu smluv a zjednodušuje systém a komunikaci. V podstatě používáme přístup, který se nazývá „Contract First Design“, a aplikujeme ho na smlouvy o streamovaní dat. [2]
Streamování všude
Ukládání a správa stavu v systému nevyhnutelně povedou k jeho složitější realizaci. Obecně platí, že stav by měl být přístupný z jakéhokoli komponentu, měl by být konzistentní a poskytovat nejaktuálnější hodnotu pro všechny komponenty a měl by být spolehlivý s správnými hodnotami. Kromě toho volání na trvalé úložiště pro získání posledního stavu zvyšuje počet operací vstupu a výstupu a složitost algoritmů používaných v našich reálných časových operacích. Z tohoto důvodu jsme se rozhodli odstranit uchování stavu, pokud je to možné, z našeho systému. Tento přístup vyžaduje zahrnout všechna potřebná data do předávaného bloku dat (zpráva). Například pokud potřebujeme spočítat celkový počet některých pozorování (počet operací nebo případů s určitými charakteristikami), spočítáme to v paměti a vygenerujeme tok těchto hodnot. Závislé moduly budou používat rozdělení (partition) a dávkování (batch) k rozdělení toku podle entit a manipulaci s posledními hodnotami. Tento přístup odstranil potřebu mít trvalé diskové úložiště pro taková data. Náš systém používá Kafka jako zprostředkovatele zpráv, a může být použit jako databáze s KSQL. [3] Avšak jeho použití by silně svázalo naše řešení s Kafkou, a rozhodli jsme se jej nepoužívat. Zvolený přístup nám umožňuje nahradit Kafku jiným zprostředkovatelem zpráv bez závažných vnitřních změn systému.
Tato koncepce neznamená, že nepoužíváme disková úložiště a databáze. Pro ověřování a analýzu výkonu systému potřebujeme uchovávat na disku významnou část dat, která představují různé ukazatele a stavy. Důležitým bodem je, že algoritmy v reálném čase nezávisí na takových datech. Většinou používáme uložená data pro autonomní analýzu, ladění a sledování konkrétních případů a výsledků, které systém poskytuje.
Problémy našeho systému
Existují určité problémy, které jsme vyřešili do určité míry, ale vyžadují promyšlenější řešení. Chtěl bych je zde zmínit, protože každý bod by si zasloužil samostatný článek.
- Stále musíme určit procesy a politiky, které přispívají k akumulaci významných a aktuálních dat pro naši automatickou analýzu, objevování a zkoumání dat.
- Zavedení výsledků analýzy člověkem do procesu automatického nastavení systému pro jeho aktualizaci na základě nejnovějších dat. To zahrnuje nejen aktualizaci našeho modelu, ale také aktualizaci procesů a zlepšení porozumění našim datům.
- Nalezení rovnováhy mezi deterministickým přístupem IF-ELSE a ML. Někdo řekl: „ML je nástroj pro zoufalé“. To znamená, že chcete použít ML, když už nerozumíte, jak optimalizovat a zlepšovat své algoritmy. Na druhou stranu deterministický přístup neumožňuje objevování anomálií, které nebyly předvídány.
- Potřebujeme jednoduchý způsob, jak ověřit naše hypotézy nebo korelace mezi metrikami v datech.
- Systém by měl mít několik úrovní skutečně pozitivních (true positive) výsledků. Případy podvodu jsou jen částí všech případů, které lze považovat za pozitivní pro systém. Například analytici chtějí dostávat všechny podezřelé případy k prověření, a jen malá část z nich je podvod. Systém by měl efektivně poskytovat analytikům všechny případy, bez ohledu na to, zda se jedná o skutečný podvod nebo pouze podezřelé chování.
- Datová platforma by měla umožnit získávat datové soubory za minulé období s výpočty, které byly provedeny a spočítány na místě.
- Jednoduché a automatické nasazení libovolné z komponentů systému alespoň ve třech různých prostředích: výrobním, experimentálním (beta) a pro vývojáře.
- A nakonec, ale ne méně důležité. Musíme vytvořit rozsáhlou platformu pro testování výkonu, na které budeme moci analyzovat naše modely. [4]
Odkazy
Zdroj: habr.com
