

Mnozí, kdo již využívají — našeho vizualizačního servisu plánů PostgreSQL, si možná nejsou vědomi jedné z jeho úžasných schopností — převádět složitě čitelný kus serverového logu…
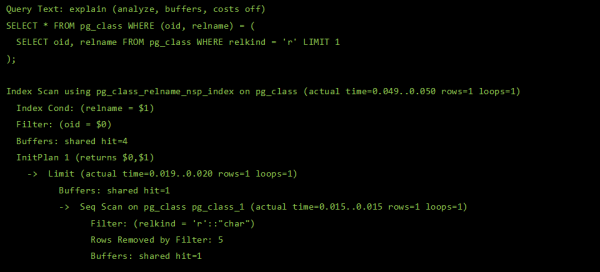
… na krásně zformulovaný dotaz s kontextovými nápovědami k odpovídajícím uzlům plánu:
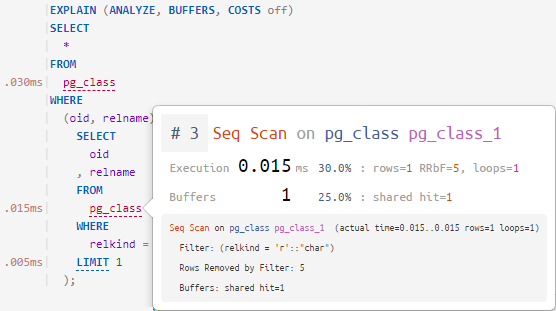
V této dešifrování druhé části své vám ukážu, jak se nám to podařilo.
S přepisem první části, která se věnovala typickým problémům s výkonností dotazů a jejich řešením, se můžete seznámit v článku .
Nejprve se zaměříme na barevné zvýraznění — a barevně zvýrazníme již ne plán, ten jsme už nazdobili, je krásný a srozumitelný, ale dotaz.
Přišlo nám, že takto neformátovaný „plátno“ vytažený z logu dotazu vypadá velmi ošklivě a proto — je nepohodlný.
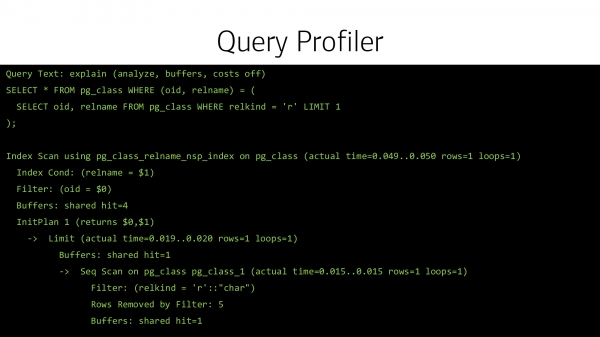
Ze jména, když vývojáři v kódu „lepí“ tělo dotazu (to je samozřejmě antipattern, ale stává se) do jedné řádky. Hrůza!
Pojďme to nakreslit nějak krásněji.
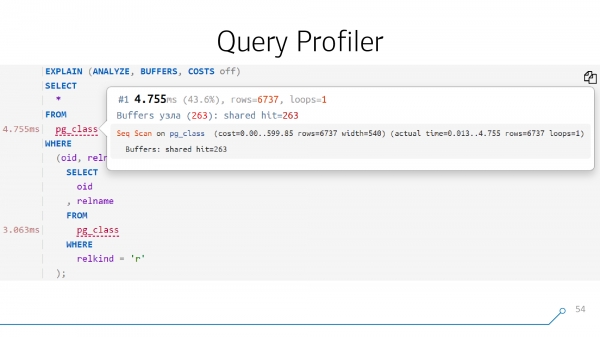
A pokud to budeme moci nakreslit pěkně, tj. rozdělit a znovu sestavit tělo dotazu, pak budeme moci ke každému objektu tohoto dotazu „připojit“ nápovědu — co se dělo v odpovídajícím bodě plánu.
Syntaxe stromu dotazu
Abychom to udělali, musíme dotaz nejprve rozebrat.
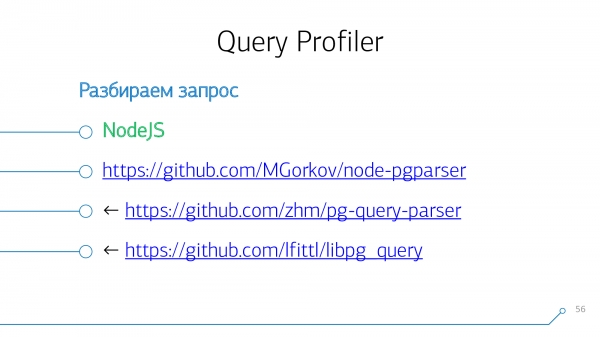
Protože máme , vytvořili jsme k tomu modul, který můžete . Ve skutečnosti jde o rozšířené „bindingy“ k vnitřnostem samotného PostgreSQL parseru. Tedy jednoduše binárně zkompilovaná gramatika a k ní byly provedeny bindingy z pohledu NodeJS. Za základ jsme vzali cizí moduly — tady žádné velké tajemství není.
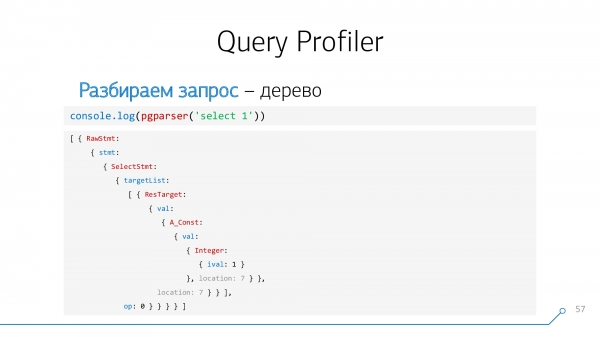
Podáváme tělo dotazu na vstup naší funkce — na výstupu dostáváme rozebrané syntaktické strom v podobě JSON objektu.
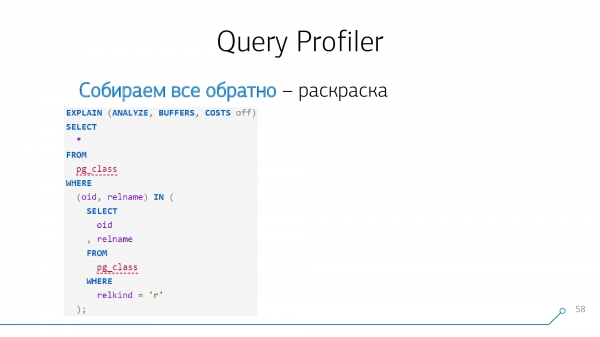
Nyní lze touto strukturou projít zpět a sestavit dotaz s těmi odsazeními, barevným zvýrazněním a formátováním, které nám vyhovuje. Ne, to není nastavitelné, ale nám se zdá, že právě tak bude pohodlné.
Přiřazení uzlů dotazu a plánu
Nyní se podíváme, jak můžeme spojit plán, který jsme rozebrali v prvním kroku, a dotaz, který jsme rozebrali ve druhém.
Pojďme si vzít jednoduchý příklad — máme dotaz, který vytváří CTE a dvakrát z ní čte. Generuje takový plán.
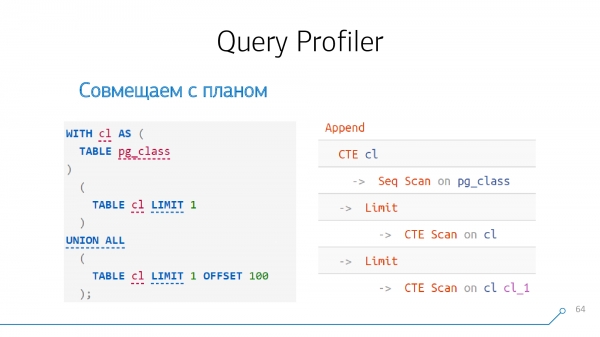
CTE
Pokud se na něj podíváte pozorně, co do 12. verze (nebo počínaje ní s klíčovým slovem MATERIALIZED) vytvoření .
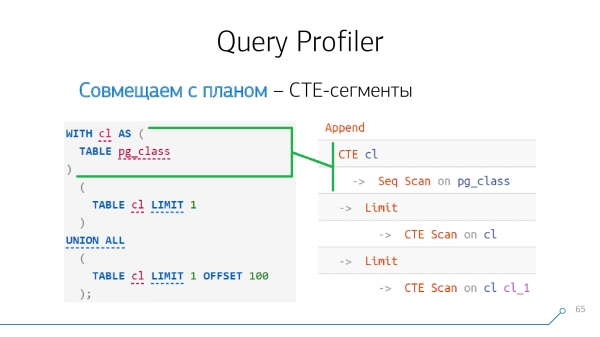
A tedy pokud někde v dotazu vidíme generaci CTE a někde v plánu uzel CTE, tak tyto uzly jednoznačně mezi sebou "vyhodnocují", můžeme je okamžitě sloučit.
Úkol "se hvězdičkou": CTE mohou být vnořené.
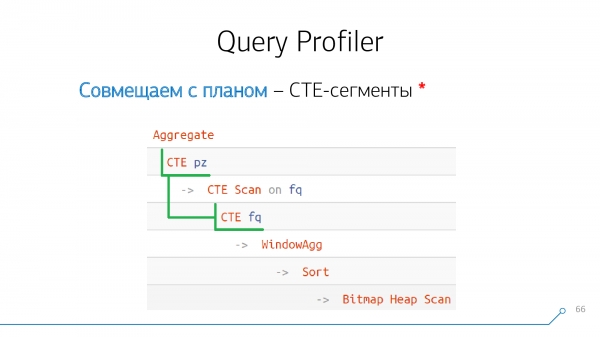
Mohou být velmi špatně vnořené, a dokonce i se stejným názvem. Například můžete uvnitř CTE A udělat CTE X, a na stejné úrovni uvnitř CTE B udělat znovu CTE X:
WITH A AS (
  WITH X AS (...)
  SELECT ...
)
, B AS (
  WITH X AS (...)
  SELECT ...
)
...
Při porovnávání to musíte chápat. Chápat to "očima" — i při pohledu na plán, i při pohledu na tělo dotazu — je velmi těžké. Pokud máte generaci CTE složitou, vnořenou, dotazy jsou velké — pak je to dokonce nevědomé.
UNION
Pokud máme v dotazu klíčové slovo UNION [ALL] (operátor pro spojení dvou výběrů), pak mu v plánu odpovídá buď uzel Přidat, nebo nějaký Rekurzivní unie.
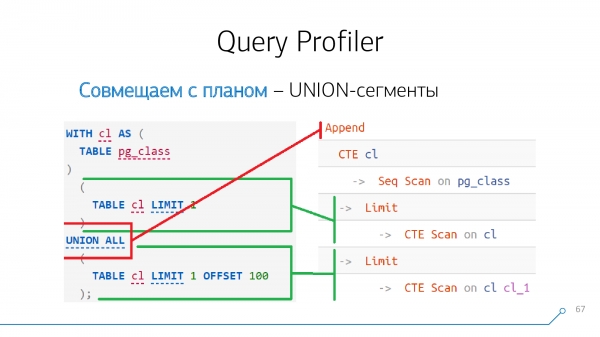
To, co "shora" nad UNION — to je první potomek našeho uzlu, co "spodní" — druhý. Pokud přes UNION máme "přilepeno" několik bloků najednou, pak Přidat-uzel bude i tak pouze jeden, ale dětí bude mnohem více — podle pořadí, jak jdou, příslušně:
  (...) -- #1
UNION ALL
  (...) -- #2
UNION ALL
  (...) -- #3
Append
-> ... #1
-> ... #2
-> ... #3
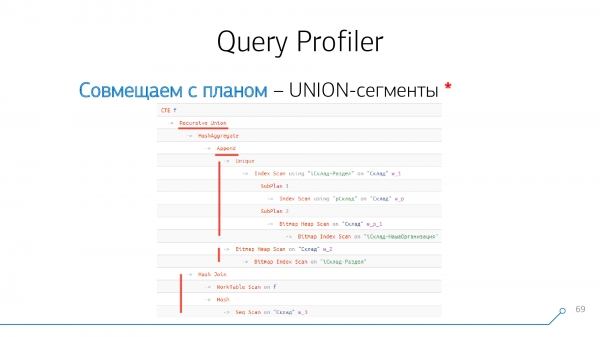
Úkol "se hvězdičkou": uvnitř generace rekurzivního výběru (WITH RECURSIVE) může být také více než jedno UNION. Ale vždy je rekurzivní pouze poslední blok po posledním UNION. Všechno, co je nahoře — to je jeden, ale jiný UNION:
WITH RECURSIVE T AS(
  (...) -- #1
UNION ALL
  (...) -- #2, zde končí generace počátečního stavu rekurze
UNION ALL
  (...) -- #3, pouze tento blok je rekurzivní a může obsahovat odkaz na T
)
...
Takové příklady je třeba umět "rozstříhat". Tady v tomto příkladu vidíme, že UNION-segmentů v našem dotazu bylo 3 kusy. Odpovídajícímu jednomu UNION odpovídá Přidat-uzlu, a druhému — Rekurzivní unie.
Čtení-zápis dat
Vše, rozložili jsme, nyní víme, který kousek dotazu odpovídá jakému kousku plánu. A v těchto kouscích můžeme snadno a přirozeně najít ty objekty, které "se čtou".
Z pohledu dotazu nevíme — zda je to tabulka nebo CTE, ale označují se stejným uzlem. Rozsahová proměnná. A v plánu „čte se“ — to je také dost omezená sada uzlů:
Sekvenční sken na [tbl]Bitmapové hromadné prohledání na [tbl]Index [Only] Scan [Backward] using [idx] on [tbl]CTE skenování na [cte]Vložit/Aktualizovat/Delete na [tbl]
Strukturu plánu a dotazu známe, shodu bloků známe, jména objektů známe — provádíme jednoznačné přiřazení.
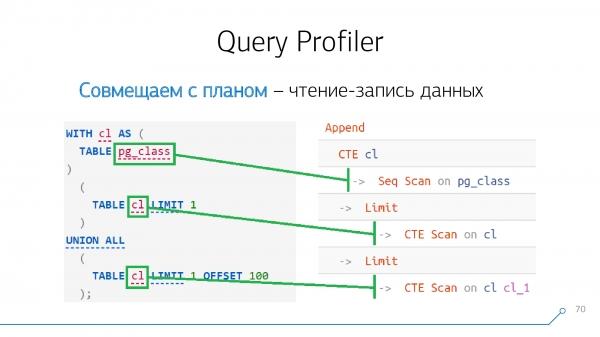
Opět úkol „se hvězdičkou“. Bereme dotaz, vykonáváme, nemáme žádné aliasy — prostě jsme dvakrát přečetli ze stejné CTE.
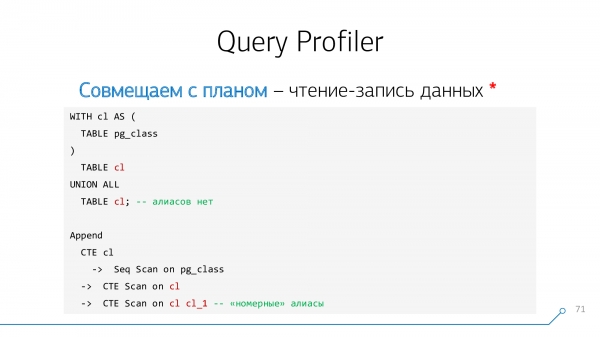
Podíváme se do plánu — co to je za problém? Proč nám vylezl alias? Neobjednali jsme si ho. Odkud se vzal takový „číslicový“?
PostgreSQL si ho přidává samo. Je třeba jen chápat, že takový alias pro naše účely přiřazení k plánu nemá žádný smysl, byl sem prostě přidán. Nebudeme si ho všímat.
Druhý úkol „se hvězdičkou“: pokud čteme ze sekcionované tabulky, dostaneme uzel Přidat nebo Sloučit připojení, který bude obsahovat velké množství „dětí“, přičemž každé z nich bude nějaké Scan‘em z tabulky-sekce: Sekvenční sken, Bitmapové hromadné prohledání nebo Index Scan. Ale v každém případě tyto „děti“ nebudou složitými dotazy — takové uzly je možné odlišit od Přidat při UNION.
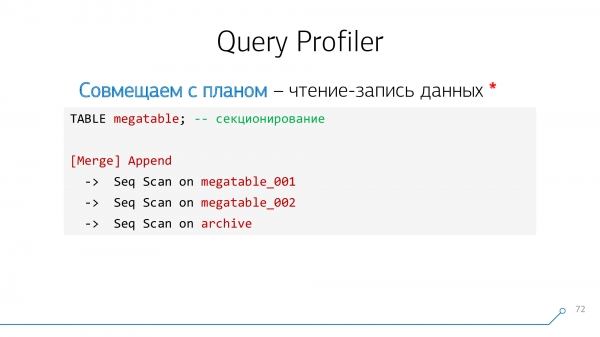
Takové uzly také chápeme, shromažďujeme „do jedné hromady“ a říkáme: "všechno, co jsi četl z megatable — tohle je tady a dolů po stromě".
„Jednoduché“ uzly pro získání dat
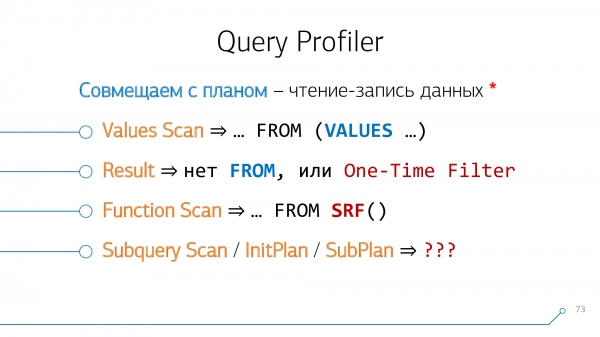
Skener hodnot v plánu odpovídají VALUES v dotazu.
Výsledek — je to dotaz bez FROM jakoby SELECT 1. Nebo když máte záměrně nepravdivý výraz v není spolehlivý:-bloku (pak vzniká atribut One-Time Filter):
EXPLAIN ANALYZE
SELECT * FROM pg_class WHERE FALSE; -- nebo 0 = 1
Výsledek (náklady=0.00..0.00 řádky=0 šířka=230) (skutečný čas=0.000..0.000 řádky=0 smyčky=1)
One-Time Filter: false
Skenování funkce „mapují“ se na stejně pojmenované SRF.
Ale s vnořenými dotazy je to složitější — bohužel se ne vždy přetvářejí na Začátek plánu/SubPlán. Někdy se přetvářejí na ... Join nebo ... Anti Join, zejména když píšete něco jako WHERE NOT EXISTS .... A tam spojení ne vždy funguje — v textu plánu odpovídajících uzlům plánových operatorů není.
Opět úkol „se hvězdičkou“: několik VALUES v dotazu. V tomto případě a v plánu obdržíte několik uzlů Skener hodnot.
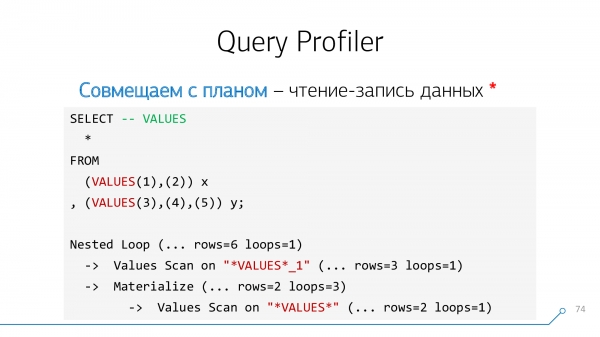
Rozlišit je jeden od druhého pomohou „číslicové“ přípony — přidávají se přesně v pořadí nacházení odpovídajících VALUES-bloků podle toku dotazu shora dolů.
Zpracování dat
Zdá se, že jsme rozebrali všechno v našem dotazu — zbývá pouze Limit.
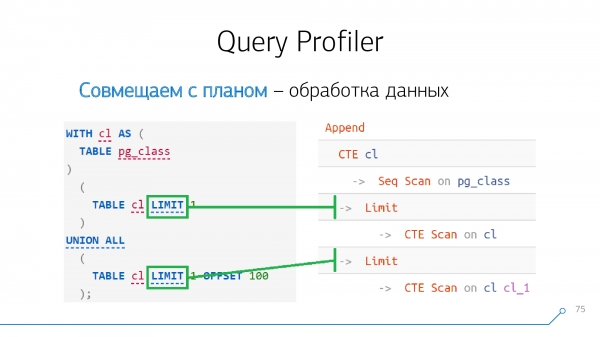
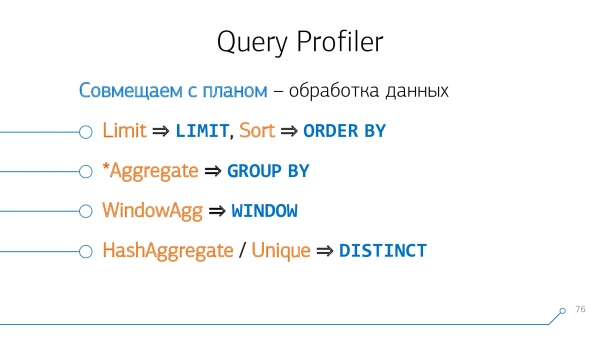
Ale tady je to jednoduché — takové uzly jako Limit, Třídit, Agregovat, WindowAgg, Unique „mapují“ se jeden na jednoho na odpovídající operátory v dotazu, pokud tam jsou. Tady žádné „hvězdičky“ a složitosti nejsou.
JOIN
Složitosti vznikají, když se chceme spojit JOIN mezi sebou. To není vždy možné, ale lze to.
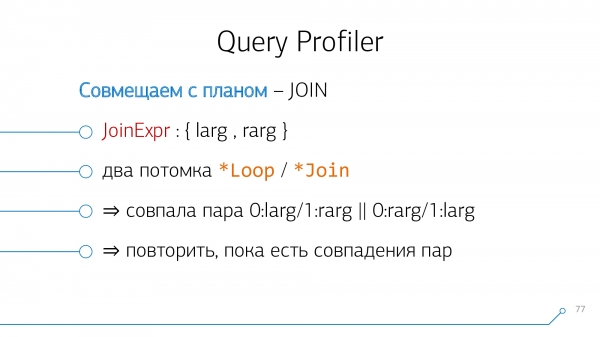
Z hlediska parseru dotazu máme uzel JoinExpr, který má přesně dva potomky — levého a pravého. To je, respektive, to, co je „nad“ vaším JOIN a to, co je „pod“ ním v dotazu napsáno.
A z pohledu plánu to jsou dva potomci nějakého * Smyčka/* Připojit-uzlu. Zanořená smyčka, Hash Anti Join,… — něco takového.
Využijeme jednoduchou logiku: pokud máme tabulky A a B, které se „joinují“ mezi sebou v plánu, mohly by být v dotazu umístěny buď A-JOIN-B, nebo B-JOIN-A. Zkusíme to tak zkombinovat, zkusíme to naopak, a tak dále, dokud tyto páry neskončí.
Vezmeme naše syntaktické strom, vezmeme náš plán, podíváme se na ně… nevypadá to podobně!
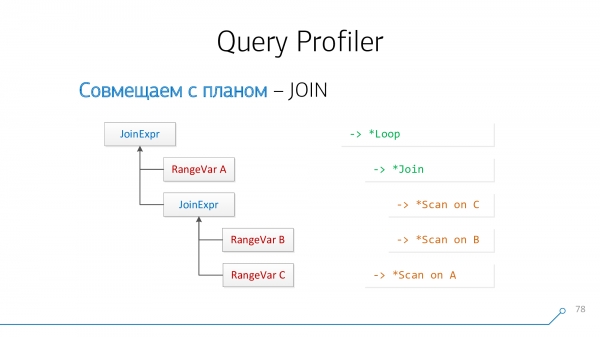
Přepracujeme to do podoby grafů — oh, už to vypadá jako něco!
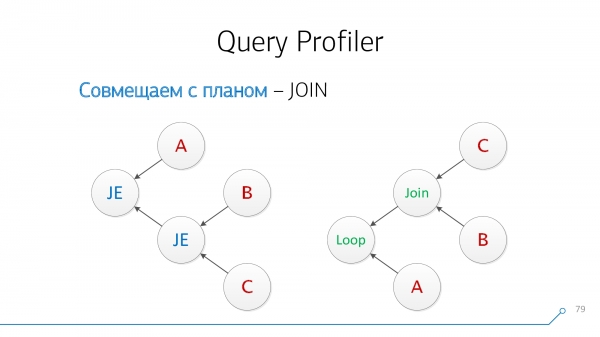
Všimneme si, že máme uzly, které mají zároveň děti B a C — nezáleží nám na pořadí. Zkombinujeme je a otočíme obrázek uzlu.
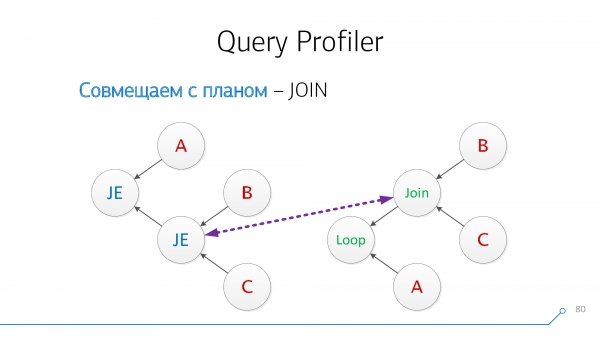
Podíváme se znovu. Teď máme uzly s dětmi A a dvojicí (B + C) — zkombinujeme i je.
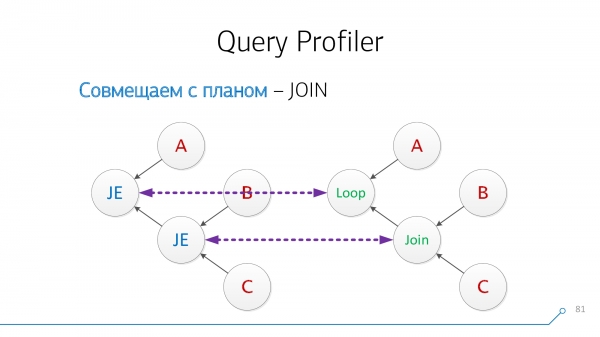
Skvěle! Ukazuje se, že tato dvě JOIN z dotazu s uzly plánu jsme úspěšně zkombinovali.
Bohužel, tato úloha není vždy řešitelná.
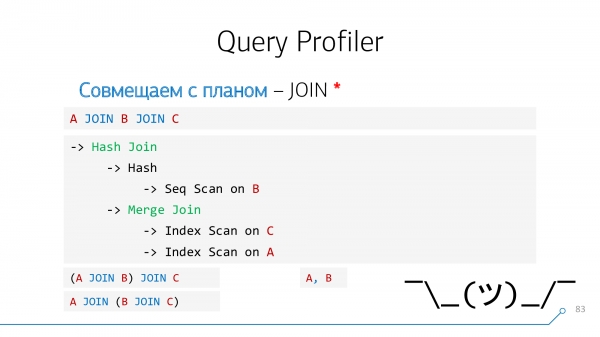
Například, pokud je v dotazu A JOIN B JOIN C, zatímco v plánu se nejprve spojily „okrajové“ uzly A a C. A v dotazu není takový operátor, nemáme co zvýraznit, není k čemu připojit nápovědu. Totéž platí pro „čárku“, když píšete A, B.
Ale ve většině případů se skoro všechny uzly daří „rozvázat“ a získat takové profily vlevo podle času — doslova, jako v Google Chrome, když analyzujete kód na JavaScriptu. Vidíte, kolik času každá řádka a každý operátor „prováděli“.
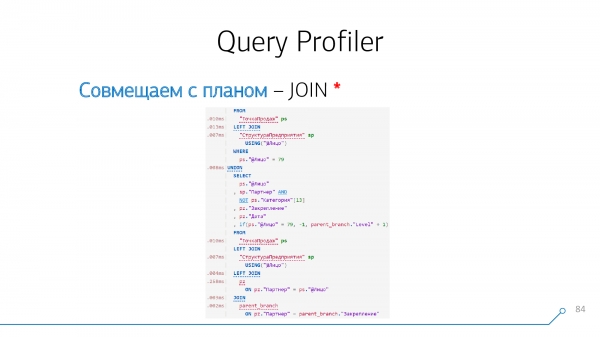
A abyste toho všeho mohli snadněji používat, vytvořili jsme úložiště , kde můžete uložit a následně najít své plány spolu s asociovanými dotazy nebo sdílet odkaz s někým jiným.
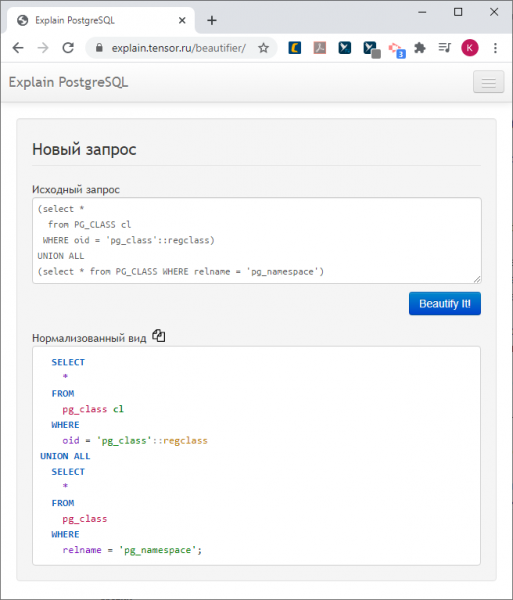
Pokud potřebujete jednoduše převést nečitelný dotaz do přijatelnější podoby, použijte .
Zdroj: habr.com
