

Mnozí jsou obeznámeni s databázovým systémem PostgreSQL, který se osvědčil na menších instalacích. Nicméně trend přechodu na Open Source je stále výraznější, a to i ve vztahu k velkým firmám a podnikových požadavkům. V tomto článku se podíváme na to, jak integrovat Postgres do podnikového prostředí, a podělíme se o zkušenosti se vytvořením systému zálohování (ZK) pro tuto databázi na příkladu zálohovacího systému Commvault.
PostgreSQL již prokázala svou spolehlivost — databázový systém skvěle funguje, používají ho moderní digitální podniky jako Alibaba a TripAdvisor, a absence licenčních poplatků ji činí lákavou alternativou k takovým gigantům jako MS SQL nebo Oracle DB. Jakmile však začneme přemýšlet o PostgreSQL v kontextu podniků, okamžitě narážíme na přísné požadavky: "Co třeba odolnost konfigurace? Odolnost proti katastrofám? Kde je komplexní monitorování? Jaké je automatizované zálohování? Jaké je použití páskových knihoven jak přímo, tak jako sekundární úložiště?"
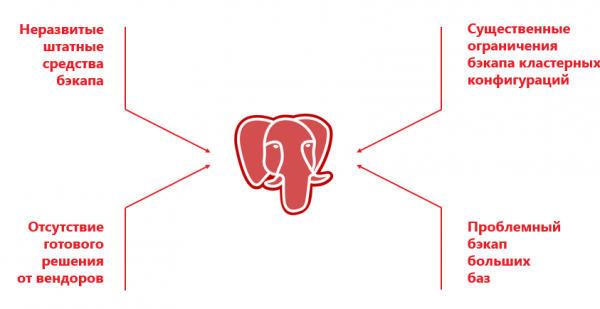
Na jedné straně PostgreSQL nemá vestavěné nástroje pro zálohování jako "dospělé" databáze typu RMAN u Oracle DB nebo SAP Database Backup. Na druhé straně, dodavatelé korporátních zálohovacích systémů (Veeam, Veritas, Commvault) i když podporují PostgreSQL, ve skutečnosti pracují pouze s určitou (obvykle standalone) konfigurací a s různými omezeními.
Systémy zálohování navržené speciálně pro PostgreSQL, jako jsou Barman, Wal-g, pg_probackup, jsou velmi populární v malých instalacích databáze PostgreSQL nebo tam, kde nejsou potřeba těžké zálohy dalších prvků IT prostředí. Například, kromě PostgreSQL může být v infrastruktuře fyzický a virtuální OpenShift, Oracle, MariaDB, Cassandra atd. Vše by mělo být zálohováno společným nástrojem. Použití samostatného řešení pouze pro PostgreSQL je nešťastná myšlenka: data budou někde kopírována na disk a pak je třeba je přesunout na pásku. Toto zdvojení zálohování zvyšuje dobu zálohování a, co je ještě důležitější, dobu obnovy. servery, OpenShift, Oracle, MariaDB, Cassandra atd. Je dobré zálohovat to všechno společným nástrojem. Instalace samostatného řešení pouze pro PostgreSQL je špatný nápad: data se nejprve zkopírují na disk a poté je potřeba je převést na pásku. Takové duplicitní zálohování zvyšuje dobu zálohování a také, což je mnohem kritičtější, – obnovování.
V enterprise řešení se zálohování instalace provádí s určitým počtem uzlů vyhrazeného clusteru. Například, Commvault dokáže pracovat pouze s dvouuzlovým clusterem, ve kterém jsou Primary a Secondary pevně přiřazeny k určitým uzlům. A smysl zálohovat existuje pouze s Primary, protože zálohování z Secondary má svá omezení. Kvůli vlastnostem DBMS se dump na Secondary nevytváří, a proto zbývá pouze možnost souborové zálohy.
Aby se snížila rizika výpadku, při vytváření odolného systému vzniká „živá“ clusterová konfigurace, a Primary může postupně migrovat mezi různými servery. Například software Patroni sám spouští Primary na náhodně vybraném uzlu clusteru. SŘK nemá způsob, jak to sledovat „z krabice“, a pokud se mění konfigurace, procesy se rozbíjejí. To znamená, že zavedení externího řízení brání SŘK efektivně fungovat, protože řídicí server jednoduše nechápe, odkud a jaká data je třeba kopírovat.
Další problém – implementace zálohy v Postgres. Ta je možná přes dump, a na malých databázích to funguje. Ale u velkých DB dump trvá dlouho, vyžaduje mnoho zdrojů a může způsobit selhání instance DB.
Souborová záloha situaci vyřeší, ale na velkých databázích probíhá pomalu, protože pracuje v jednovláknovém režimu. Kromě toho mají dodavatelé celou řadu dalších omezení. Není možné simultánně používat souborovou a dumpovou zálohu, ani nepodporují deduplikaci. Problémů je mnoho, a často je jednodušší vybrat místo Postgres drahou, ale osvědčenou DB.
Není kam ustoupit! Za námi je Moskva a vývojáři!
Nedávno se naše týmu ocitla před nelehkým úkolem: v projektu budování AIS OSAGo 2.0, kde jsme prováděli IT infrastrukturu, si vývojáři pro nový systém vybrali PostgreSQL.
Velkým vývojářům softwaru je mnohem snazší používat „módní“ open-source řešení. V rámci Facebooku je dost specialistů, kteří podporují práci tohoto DBMS. A v případě RSA všechny úkoly „druhého dne“ spočívaly na našich bedrech. Požadovalo se od nás zajistit odolnost, vytvořit cluster a samozřejmě nastavit zálohování. Logika postupů byla následující:
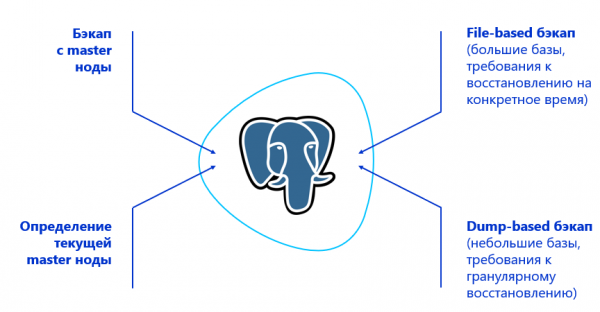
- Naučit SRK provádět zálohu z primárního uzlu clusteru. K tomu musí SRK najít tento uzel — to znamená, že je zapotřebí integrace s nějakým řešením pro správu clusteru PostgreSQL. V případě RSA bylo k tomu použito softwarové vybavení Patroni.
- Určit typ zálohy na základě objemu dat a požadavků na obnovení. Například, když je potřeba obnovovat stránky granulárně, použít dump, a pokud jsou databáze velké a granulární obnova není požadována — pracovat na úrovni souborů.
- Přidat k řešení možnost blokové zálohy, aby bylo možné vytvářet zálohu v multithreadovém režimu.
Naším cílem bylo původně vytvořit efektivní a jednoduchý systém bez monstrózní vazby na další komponenty. Čím méně berliček, tím menší zatížení pro personál a nižší riziko selhání SRK. Přístupy, které používaly Veeam a RMAN, jsme okamžitě vyloučili, protože soubor dvou řešení už naznačuje nspolehlivost systému.
Trochu magie pro enterprise
Takže jsme potřebovali zajistit spolehlivé zálohování pro 10 clusterů po 3 uzlech každý, přičemž v rezervním datovém centru se nachází identická infrastruktura. Datová centra v rámci PostgreSQL fungují na principu active-passive. Celkový objem databází činil 50 TB. S tím si poradí jakýkoli SRK na úrovni podniku. Ale nuance spočívá v tom, že původně v Postgresu neexistuje podpora pro plnou a hloubkovou kompatibilitu se systémy zálohování. Proto jsme museli hledat řešení, které od začátku disponuje maximem funkcionality v kombinaci s PostgreSQL a dále systém upravit.
Uspořádali jsme 3 interní "hackatony" — zhodnotili jsme více než padesát nápadů, testovali je, prováděli změny v souvislosti s našimi hypotézami a opět testovali. Po analýze dostupných možností jsme vybrali Commvault. Tento produkt již "z krabice" mohl pracovat s nejjednoduššími clusterovými instalacemi PostgreSQL, a jeho otevřená architektura vzbuzovala naději (která se naplnila) na úspěšnou úpravu a integraci. Také Commvault umí provádět zálohu logů PostgreSQL. Například Veritas NetBackup v oblasti PostgreSQL umí provádět pouze plné zálohy.
Podrobnosti o architektuře. Řídící servery Commvault byly nainstalovány v každém ze dvou datových center v konfiguraci CommServ HA. Systém je zrcadlový, spravován prostřednictvím jednoho rozhraní a z hlediska HA splňuje všechna kritéria pro podnikové použití.
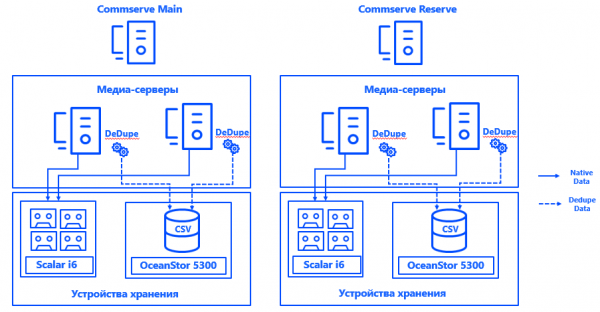
Také v každém datovém centru jsme spustili dva fyzické mediální servery, k nimž jsme přes SAN pomocí Fibre Channel připojili diskové pole a páskové knihovny, které byly speciálně určeny pro zálohování. Rozšířené deduplikační databáze zajišťovaly odolnost mediálních serverů, a připojení každého serveru k každému CSV poskytovalo možnost nepřetržité činnosti i při selhání kteréhokoliv komponentu. Architektura systému umožňuje pokračovat v zálohování, i když dojde k výpadku jednoho z datových center.
Patroni určuje Primary uzel pro každý klastr. Tím může být jakýkoliv volný uzel v datovém centru — ale pouze v hlavním. V záložním jsou všechny uzly Secondary.
Aby Commvault rozuměl, který uzel klastra je Primary, integrovali jsme systém (děkujeme otevřené architektuře řešení) s Postgres. Za tímto účelem byl vytvořen skript, který informuje o aktuální poloze Primary uzlu správce. serveru Commvault.
Celkově proces vypadá takto:
Patroni vybírá Primary → Keepalived zvedá IP klastr a spouští skript → agent Commvault na vybraném uzlu klastra dostává upozornění, že je to Primary → Commvault automaticky přenastaví zálohu pro pseudozákazníka.
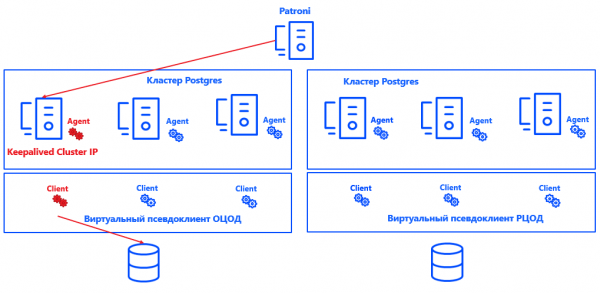
Výhodou tohoto přístupu je, že řešení neovlivňuje ani konzistenci, ani správnost protokolů, ani obnovení instance Postgres. Je také snadno škálovatelné, protože nyní není potřeba fixovat Primary a Secondary uzly pro Commvault. Stačí, že systém rozumí, kde je Primary, a počet uzlů může být zvýšen prakticky na libovolnou hodnotu.
Řešení si nenárokuje dokonalost a má své nuance. Commvault umí zálohovat pouze instanci jako celek, a ne jednotlivé databáze. Proto byl pro každou databázi vytvořen samostatný instance. Skuteční zákazníci jsou spojeni do virtuálních pseudozákazníků. Každý pseudozákazník Commvault představuje UNIX klastr. Do něj se přidávají ty uzly klastra, na kterých je nainstalován agent Commvault pro Postgres. V důsledku toho jsou všechny virtuální uzly pseudozákazníka zálohovány jako jedna instance.
Uvnitř každého pseudoklienta je uvedena aktivní uzel clustera. Právě ten určuje naše integrační řešení pro Commvault. Princip jeho fungování je poměrně jednoduchý: pokud na uzlu vzrůstá clusterový IP, skript nastavuje v binárním souboru agenta Commvault parametr „aktivní uzel“ — ve skutečnosti skript umístí „1“ na potřebné místo v paměti. Agent předává tyto údaje na CommServe a Commvault provádí zálohu z potřebného uzlu. Kromě toho na úrovni skriptu probíhá kontrola správnosti konfigurace, což pomáhá předejít chybám při spuštění zálohování.
Velké databáze jsou přitom zálohovány blokově ve více vláknech, což splňuje požadavky RPO a zálohovacího okna. Zátěž na systém je minimální: plné kopie probíhají ne tak často, v ostatních dnech se shromažďují pouze logy, přičemž v obdobích nízké zátěže.
Mimochodem jsme použili samostatné politiky pro zálohování archivních žurnálů PostgreSQL — ty jsou uchovávány podle jiných pravidel, kopírovány podle jiného harmonogramu a pro ně není aktivována deduplikace, protože tyto žurnály nesou unikátní data.
Aby byla zajištěna konzistence celé IT infrastruktury, jsou na každém uzlu clustera nainstalováni samostatní souboroví klienti Commvault. Vylučují z záloh soubory Postgres a jsou určeni pouze pro zálohu operačního systému a aplikačních programů. Pro tuto část dat je také stanovena vlastní politika a vlastní doba uchovávání.
Nyní SRK neovlivňuje produktivní služby, ale pokud se situace změní, v Commvaultu bude možné aktivovat systém omezení zátěže.
Vhodné? Vhodné!
Takže jsme získali nejen funkční, ale také plně automatizované zálohování pro clusterovou instalaci PostgreSQL, které splňuje všechny požadavky na enterprise.
Parametry RPO a RTO na 1 hodinu a 2 hodiny jsou pokryty s rezervou, a to znamená, že systém je bude splňovat i při významném nárůstu objemů uložených dat. Navzdory mnoha pochybnostem se PostgreSQL a enterprise prostředí ukázaly jako zcela kompatibilní. A nyní víme ze své zkušenosti, že zálohování pro podobné DBMS je možné v nejrůznějších konfiguracích.
Samozřejmě, na této cestě jsme si museli pořídit sedm párů železných bot, překonat řadu obtíží, šlápnout na několik hřebíků a napravit množství chyb. Ale nyní je přístup již vyzkoušen a může být použit pro nasazení Open Source místo proprietárních DBMS v náročných podmínkách podniku.
Zkoušeli jste pracovat s PostgreSQL v korporátním prostředí?
Autoři:
Oleg Lavrenov, inženýr projektování systémů pro ukládání dat 'Infosystemy Jet'
Dmitrij Jerykin, inženýr projektování výpočetních komplexů 'Infosystemy Jet'
Zdroj: habr.com
