

VictoriaMetrics — rychlá a škálovatelná databáze pro uchovávání a zpracování dat ve formě časových řad (záznam vytváří čas a sadu odpovídajících hodnot, například získaných prostřednictvím periodického dotazování stavu senzorů nebo shromažďování metrik).
Jmenuji se Kolobaev Pavel. DevOps, SRE, LeroyMerlin, všechno jako kód – to všechno se nás týká: mě a ostatních zaměstnanců LeroyMerlin.
Existuje cloud založený na OpenStacku. Tam je malý odkaz na technický radar.
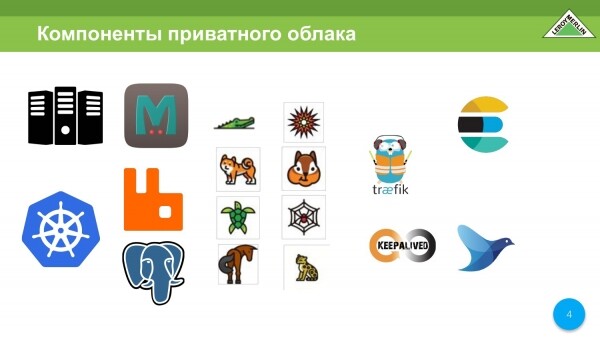
Bylo postaveno na základě hardware Kubernetes, a také na všech souvisejících službách s OpenStackem a logováním.
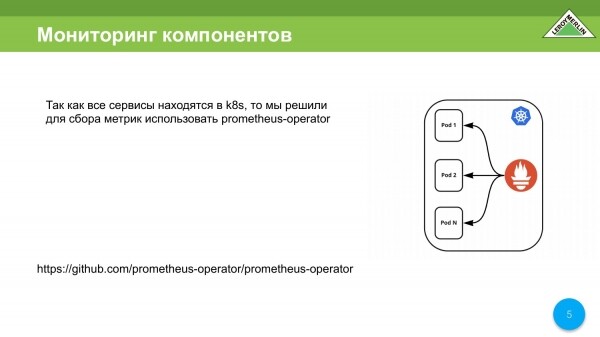
Schema, kterou jsme měli při vývoji, byla taková. Když jsme to všechno vyvíjeli, měli jsme operátora Prometheus, který uchovával data uvnitř samotného clustera K8s. Automaticky nalezl to, co bylo potřeba scrapovat, a uložil si to pod nohy, tak říkajíc.
Všechna data budeme muset vyvést mimo cluster Kubernetes, protože pokud se něco stane, musíme chápat, co a kde.
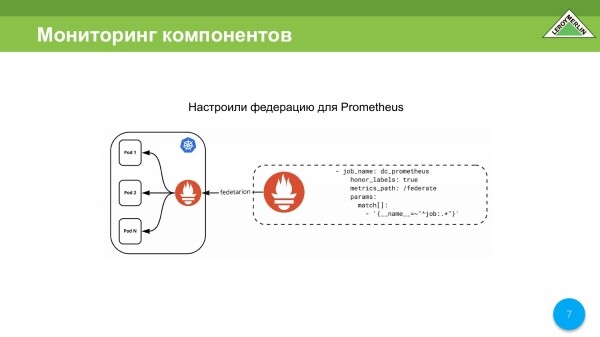
První řešení – používáme federation, když máme externí Prometheus a procházejí do clusteru Kubernetes prostřednictvím mechanismu federation.
Ale vznikají zde drobné problémy. V našem případě problémy začaly, když jsme měli 250 000 metrik, a když jich bylo 400 000, uvědomili jsme si, že takto pracovat nemůžeme. Zvětšili jsme scrape_timeout na 25 sekund.
Proč jsme to museli udělat? Prometheus začíná počítat čas timeoutu od začátku odběru. A nezáleží na tom, že data stále tečou. Pokud se během daného časového úseku data nesloučila a relace nebude uzavřena přes http, pak se považuje, že relace je neúspěšná a data se nedostanou do samotného Prometheus.
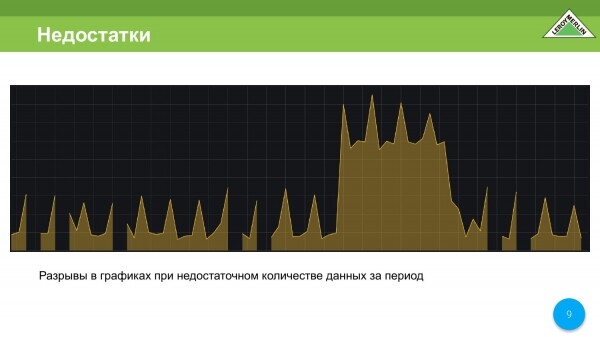
Všem známé grafy, které dostáváme, když část dat chybí. Grafy jsou trhané a to nás neuspokojuje.
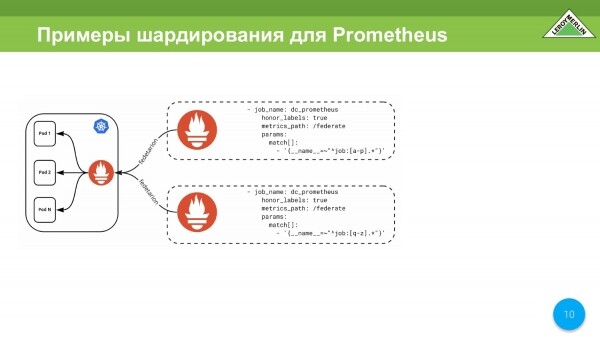
Další možnost – to je shardování na základě dvou různých Prometheus skrze stejný mechanismus federation.
Například je jednoduše vzít a shardovat je podle jména. To lze také použít, ale rozhodli jsme se posunout dál.
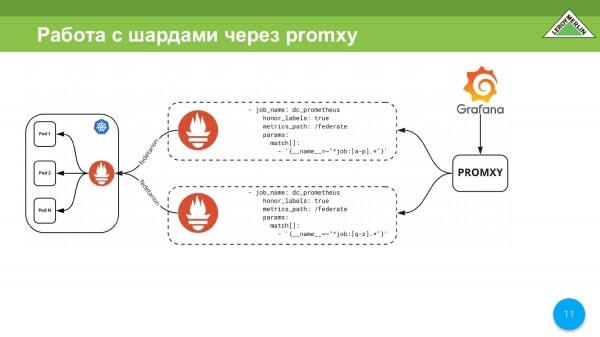
Nyní budeme muset tyto shards nějak zpracovat. Můžeme vzít promxy, který zajde do oblasti shardu a zmultiplikuje data. Pracuje s dvěma shardy jako s jediným vstupním bodem. To lze realizovat prostřednictvím promxy, ale zatím je to příliš složité.
První možnost – chceme se vzdát mechanismu federation, protože je velmi pomalý.
Vývojáři Promethea jasně říkají: „Lidi, používejte jiné TimescaleDB, protože nebudeme dlouhodobě podporovat uchovávání metrik.“ To není jejich úkol. 
Na papír si zapisujeme, že potřebujeme export ven, abychom nemuseli uchovávat všechno na jednom místě.
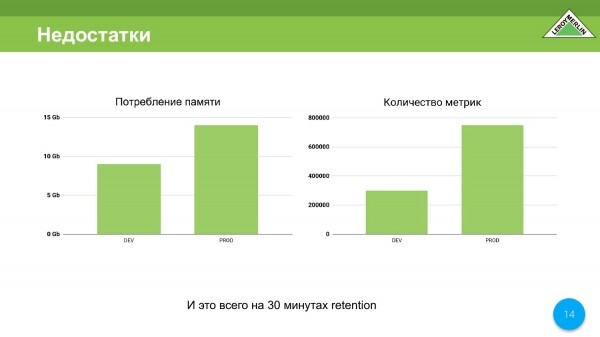
Druhým nedostatkem je spotřeba paměti. Ano, chápu, že mnozí řeknou, že v roce 2020 pár gigabajtů paměti nestojí moc, ale i tak.
Aktuálně máme dev a prod prostředí. V dev to je asi 9 gigabajtů na 350 000 metrik. V prod je to něco přes 14 gigabajtů na 780 000 metrik. Přitom retention time máme pouhých 30 minut. To je špatně. A teď vysvětlím proč.
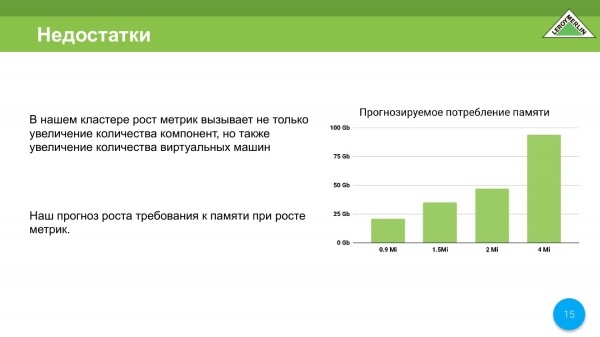
Provádíme výpočty, tj. při jednom a půl milionu metrik, což už je velmi blízko, získáme na úrovni projektování 35-37 gigabajtů paměti. Ale už při 4 milionech metrik potřebujeme asi 90 gigabajtů paměti. Tato čísla byla vypočítána podle vzorce, který poskytují vývojáři Promethea. Zjistili jsme korelaci a došli jsme k tomu, že nechceme platit pár milionů za server jen na monitorování.
Nejenže se zvýší počet strojů, ale monitorujeme také samotné virtuální stroje. Takže čím více virtuálních strojů, tím více různých metrik atd. Naše klastry se budou specificky rozrůstat v rámci metrik.
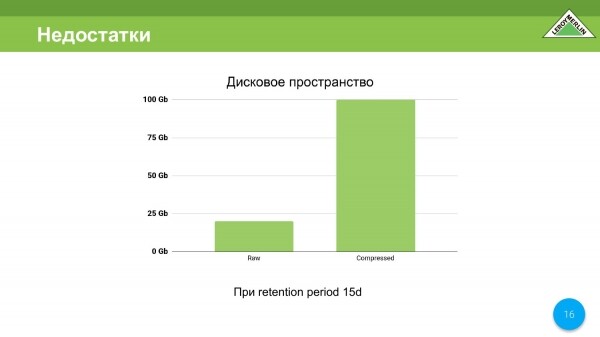
Co se diskového prostoru týče, není to tak špatné, ale chtěli bychom to zlepšit. Za 15 dní jsme získali celkem 120 gigabajtů, z nichž 100 je komprimovaných dat a 20 nekomprimovaných, ale vždy chceme méně.
Odpovídajícím způsobem zapisujeme ještě jeden bod – je to vysoká spotřeba zdrojů, které bychom chtěli šetřit, protože nechceme, aby náš monitorovací klastr zabíral více zdrojů než náš klastr, který spravuje OpenStack.
Existuje ještě jeden nedostatek Promethea, který jsme si uvědomili, a to je alespoň nějaké omezení paměti. S Prometheem je to mnohem horší, protože nemá žádné takové možnosti. Používat omezení v Dockeru také není řešení. Pokud náhodou spadne RAF a máte tam 20-30 gigabajtů, bude trvat docela dlouho, než se znovu zvedne.
To je další důvod, proč nám Prometheus nevyhovuje, t. j. nemožnost omezit spotřebu paměti.
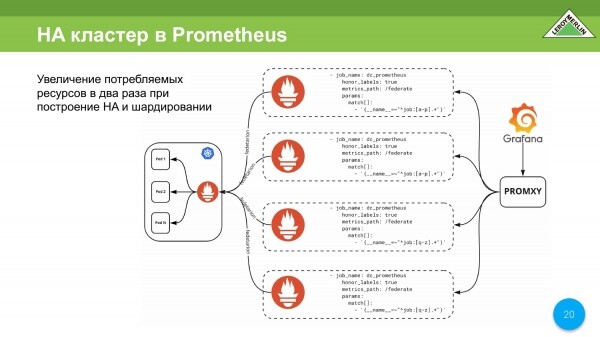
Můžeme přejít na tento model. Tento model potřebujeme pro organizaci HA clusteru. Chceme, aby naše metriky byly vždy a všude dostupné, i při výpadku serveru, který tyto metriky uchovává. A tím pádem budeme muset postavit tuto strukturu.
Tento model říká, že budeme mít duplikaci shardů a tím pádem i duplikaci nákladů na spotřebovávané zdroje. Lze ji téměř horizontálně škálovat, ale i přesto budou náklady na zdroje ohromné.
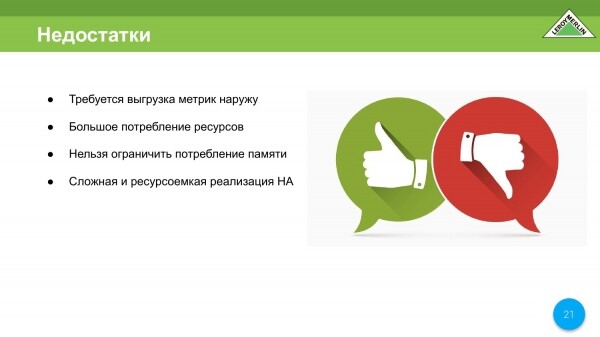
Nevýhody v pořadí, jak jsme si je zapsali:
- Je potřeba exportovat metriky ven.
- Velká spotřeba zdrojů.
- Nelze omezit spotřebu paměti.
- Složitá a náročná implementace HA.
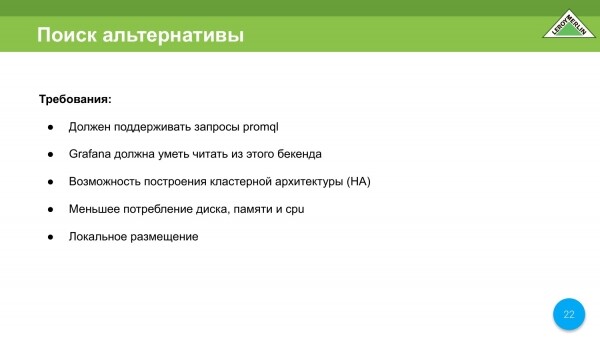
Rozhodli jsme se, že se od Promethea distancujeme jako od úložiště.
Určili jsme si také další požadavky, které potřebujeme. To zahrnuje:
- Podporu promql, protože již bylo napsáno mnoho věcí pro Prometheus: dotazy, upozornění.
- A máme zde také Grafanu, která je rovněž napsána pod Prometheus jako backend. Nechceme přepisovat panely.
- Chceme postavit adekvátní HA architekturu.
- Chceme snížit spotřebu všech zdrojů.
- Je tu ještě malý detail. Nemůžeme použít různé cloudové systémy pro sběr metrik. Nevíme, co se nám dostane do těchto metrik zatím. A protože se tam může dostat cokoliv, musíme se omezit na lokální umístění.
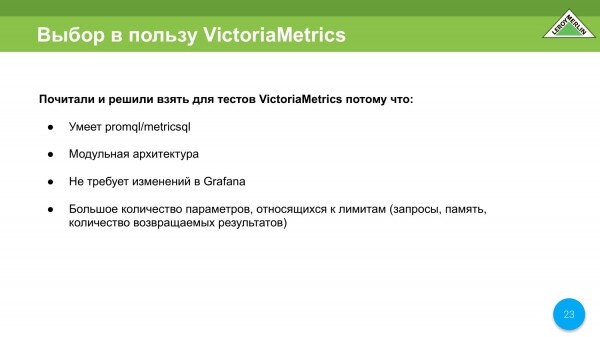
Výběr nebyl velký. Shromáždili jsme vše, s čím máme zkušenosti. Podívali jsme se na stránku Prometheus v sekci integrace, přečetli jsme spoustu článků a zjistili, co je k dispozici. A pro sebe jsme vybrali VictoriaMetrics jako náhradu za Prometheus.
Proč? Protože:
- Podporuje promql.
- Má modulární architekturu.
- Nevyžaduje změny v Grafaně.
- A co je nejdůležitější – možná budeme poskytovat úložiště metrik uvnitř naší společnosti jako službu, a proto se v předstihu díváme na omezení různých typů, aby uživatelé mohli v nějaké omezené podobě používat všechny zdroje clusteru, protože existuje šance, že bude multitenantní.
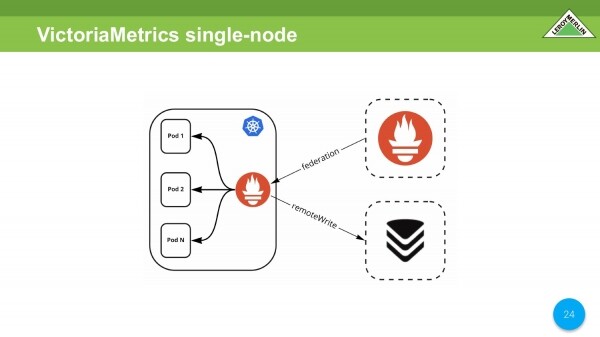
Děláme první srovnání. Bereme stejný Prometheus uvnitř clusteru, ke kterému přistupuje externí Prometheus. Přidáváme přes remoteWrite VictoriaMetrics.
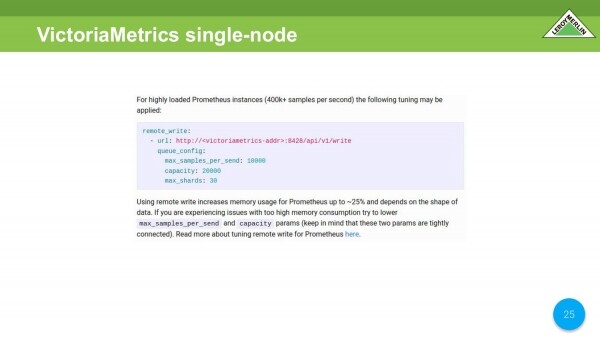
Hned na začátku uvedu, že jsme zde zaznamenali mírné zvýšení spotřeby CPU ze strany VictoriaMetrics. Na wiki VictoriaMetrics je uvedeno, které parametry jsou nejvhodnější. Otestovali jsme je. Velmi dobře snížily spotřebu právě CPU.
V našem případě se spotřeba paměti Prometheus, který běží v clusteru Kubernetes, zvýšila jen mírně.
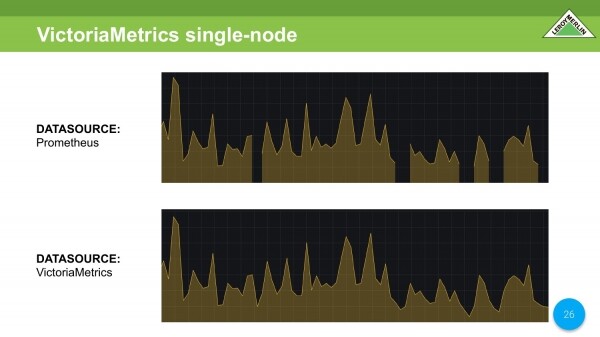
Srovnáváme dva datové zdroje stejných dat. V Prometheus vidíme všechny ty samé chybějící údaje. Ve VictoriaMetrics je vše v pořádku.
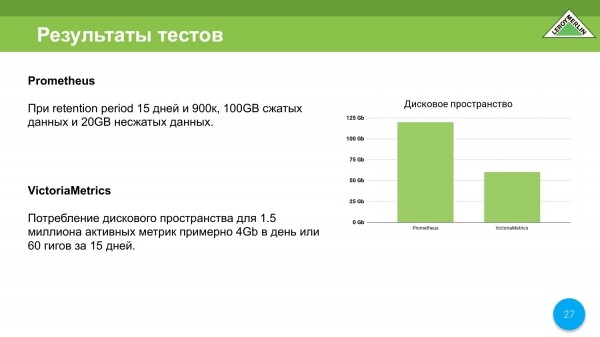
Výsledky testů s diskovým prostorem. V Prometheus jsme získali celkem 120 gigabajtů. Ve VictoriaMetrics získáváme již 4 gigabajty denně. Mají zde poněkud odlišný mechanismus, než na který jsme zvyklí z Prometheus. Tedy data se zde dost dobře komprimují za den, za půl hodiny. Jsou již dobře komprimována za den, za půl hodiny, i když se pak ještě data míchají. Nakonec jsme ušetřili na diskovém prostoru.
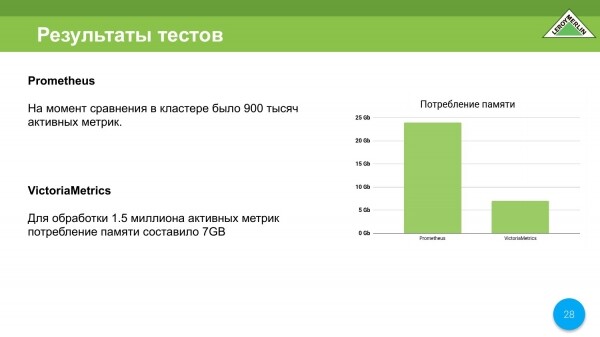
Další úspora je na spotřebě paměťových zdrojů. Naše Prometheus byla v době testů nasazena na virtuálním stroji – 8 jader, 24 gigabajtů. Prometheus využívá téměř všechny dostupné prostředky. Zkolabovala kvůli OOM Killeru. Přitom do ní proudilo pouze 900 000 aktivních metrik. To je přibližně 25 000-27 000 metrik za sekundu.
VictoriaMetrics byla spuštěna na dvoujádrové virtuální mašině s 8 gigabajty RAM. Dokázali jsme donutit VictoriaMetrics, aby fungovala dobře, když jsme nastavili některé parametry na té 8-gigabajtové mašině. Nakonec jsme se vešli do 7 gigabajtů. Přitom jsme dosáhli rychlosti dodávání obsahu, tj. metrik, dokonce vyšší než u Prometheus.
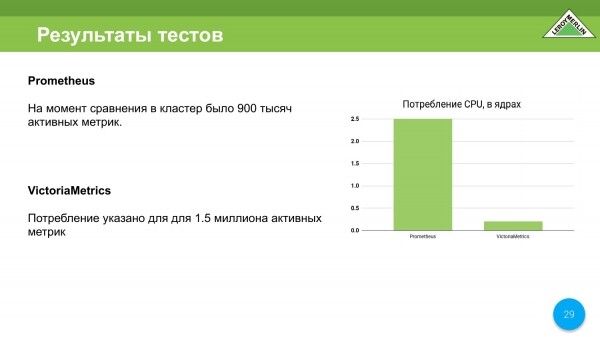
Co se týče CPU, situace se výrazně zlepšila ve srovnání s Prometheus. Zde Prometheus spotřebovává 2,5 jádra, zatímco VictoriaMetrics pouze 0,25 jádra. Na začátku – 0,5 jádra. Při slučování to obvykle dosahuje jednoho jádra, ale to se stává extrémně vzácně.
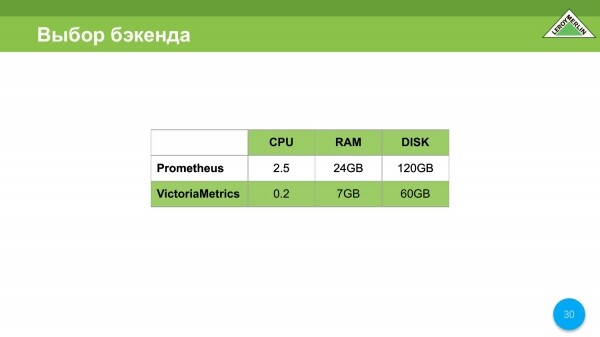
V našem případě jsme se rozhodli pro VictoriaMetrics z dobře známých důvodů; chtěli jsme šetřit a skutečně jsme ušetřili.
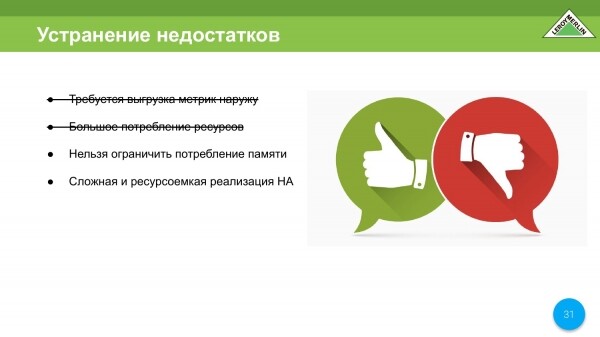
Okamžitě vylučujeme dva body – export metrik a vysokou spotřebu zdrojů. Zůstává nám rozhodnout o dvou bodech, které jsme si ještě ponechali.
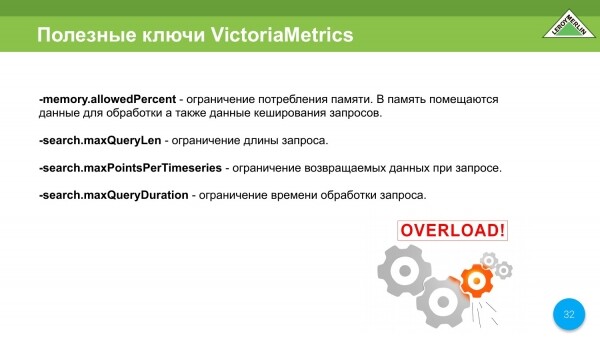
Tady hned dodám, že VictoriaMetrics vidíme jako úložiště metrik. Ale protože pravděpodobně budeme poskytovat VictoriaMetrics jako úložiště pro celý Leroy, potřebujeme omezit ty, kteří budou tento cluster používat, aby nám ho nezdevastovali.
Existuje skvělá funkce, která umožňuje omezit čas, objem dat a dobu vykonávání.
A také je zde skvělá možnost, která umožňuje omezit spotřebu paměti, čímž můžeme nalézt ten správný balanc, který nám umožní dosáhnout normální rychlosti práce a přiměřené spotřeby zdrojů.
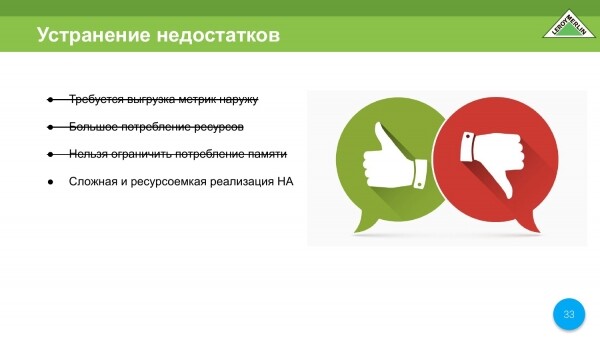
Další nevýhodou je to, že nemůžeme omezit spotřebu paměti.
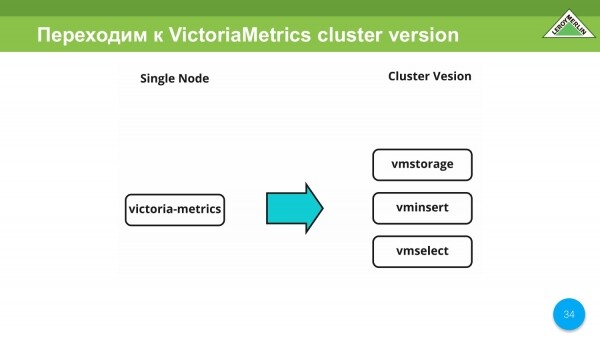
V prvních iteracích jsme testovali VictoriaMetrics Single Node. Nyní přecházíme na verzi VictoriaMetrics Cluster.
Zde máme volné ruce co se týče rozdělení různých služeb ve VictoriaMetrics v závislosti na tom, na čem poběží a jaké zdroje budou spotřebovávat. Je to velmi flexibilní a pohodlné řešení, které jsme sami používali.
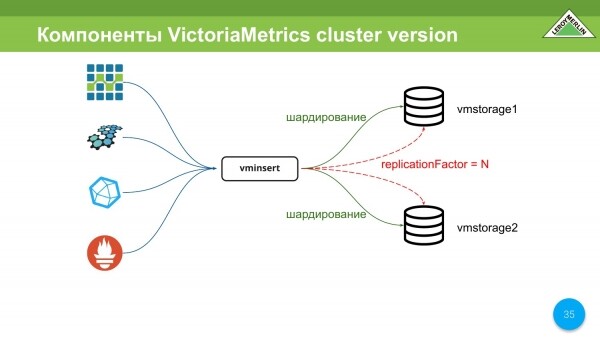
Hlavními komponenty verze VictoriaMetrics Cluster jsou vmstorage. Může jich být N množství, v našem případě zatím dva.
A je tu také vminsert. To je proxy server, který nám umožňuje: provádět shardování mezi všemi úložišti, o kterých jsme mu řekli, a také umožňuje mít replikaci, tj. bude mít jak shardování, tak replikaci.
Vminsert podporuje protokoly OpenTSDB, Graphite, InfluxDB a remoteWrite od Prometheuse.
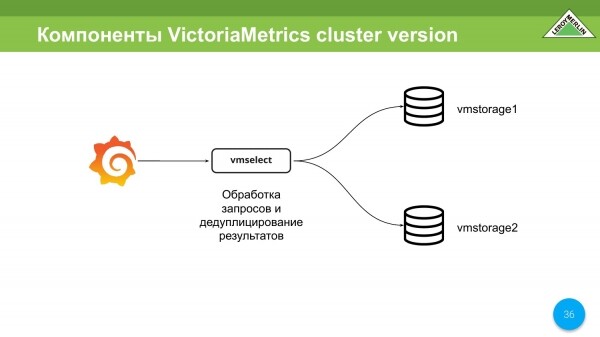
Je tu také vmselect. Jeho hlavním úkolem je vyžádat si data z vmstorage, deduplikovat je a předat je klientovi.
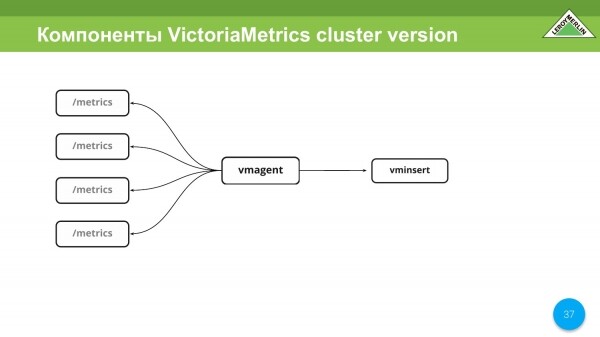
Existuje skvělá věc jako vmagent. Opravdu se nám líbí. Umožňuje konfigurovat stejně jako Prometheus a zároveň dělá všechno přesně tak jako Prometheus. Tj. sbírá metriky z různých entit a služeb a odesílá je do vminsert. Dále už záleží na vás.
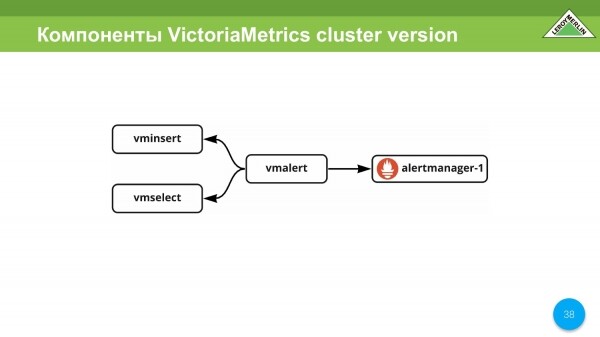
Další skvělou službou je vmalert, který má jako backend VictoriaMetrics a získává z vminsert a odesílá do vmselect zpracovaná data. Zpracovává samotné alerty a také pravidla. V případě alertů získáváme alert přes alertmanager.
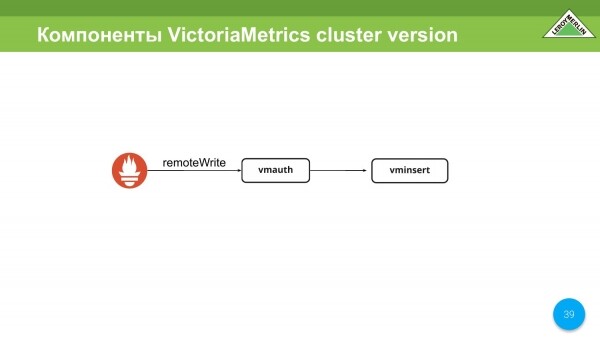
Existuje komponent wmauth. Možná ho budeme používat, a možná ne (ještě jsme se s tím nerozhodli), jako systém autorizace při multitenancy verzích klastrů. Podporuje remoteWrite pro Prometheus a může autorizovat na základě url, přesněji jeho druhé části, kam vám je umožněno nebo zakázáno psát.
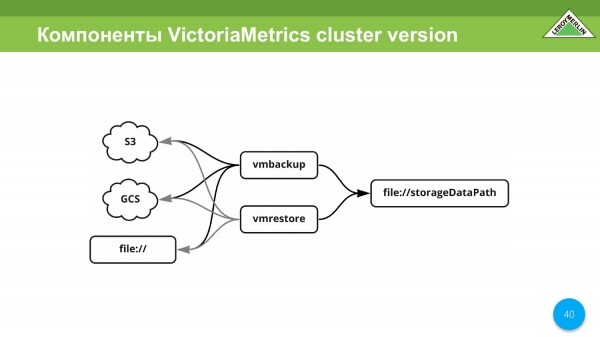
Je tu také vmbackup a vmrestore. To je v podstatě obnova a zálohování všech dat. Podporuje S3, GCS a soubor.
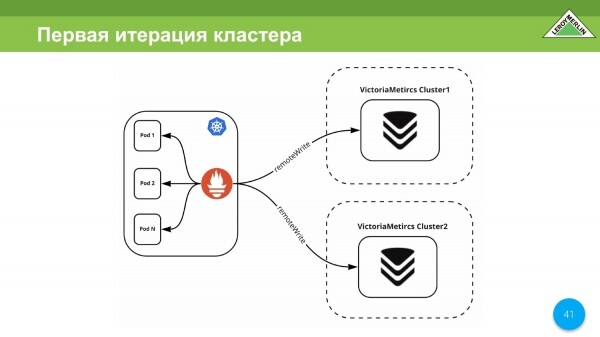
První iterace našeho clusteru byla provedena během karantény. Tehdy nebyla žádná replikace, takže naše iterace sestávala ze dvou různých a nezávislých clusterů, do kterých jsme pomocí remoteWrite přijímali data.
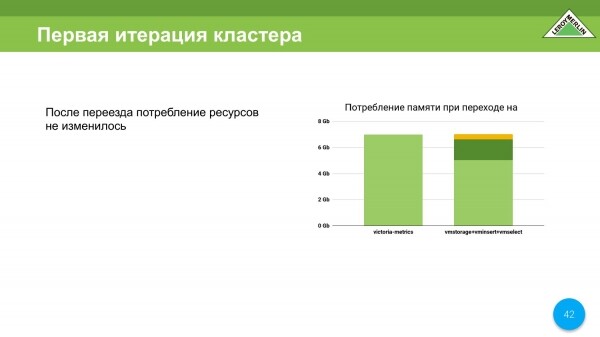
Zde bych chtěl uvést, že když jsme přecházeli z VictoriaMetrics Single Node na VictoriaMetrics Cluster Version, zůstali jsme na stejné spotřebě zdrojů, tedy hlavně paměti. Takto se přibližně rozdělila naše data, tedy spotřeba zdrojů.
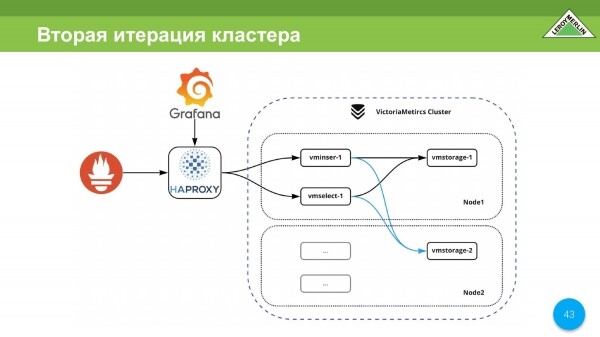
Zde byla již přidána replikace. Všechny tyto prvky jsme spojili do jednoho relativně velkého clusteru. Všechna data jsou jak shardována, tak replikována.
Celý cluster má N bodů přístupu, tedy Prometheus může přidávat data prostřednictvím HAPROXY. Tady máme tento bod přístupu. A přes tento bod přístupu lze vstupovat pomocí Grafany.
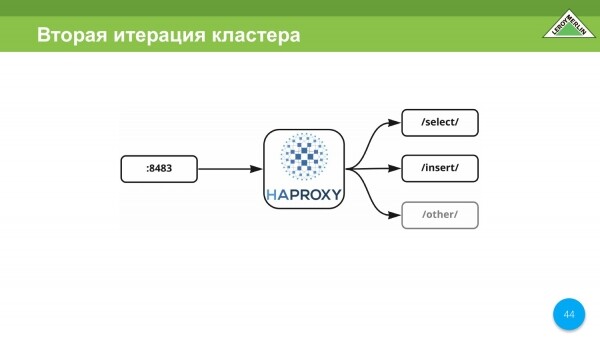
V našem případě je HAPROXY jediný port, který zprostředkovává select, insert a další služby uvnitř tohoto clusteru. Nebylo možné vytvořit jednu adresu, museli jsme udělat několik bodů přístupu, protože samotné virtuální stroje, na kterých běží cluster VictoriaMetrics, se nacházejí v různých zónách jednoho poskytovatele cloudových služeb, tedy ne uvnitř našeho cloudu, ale venku.
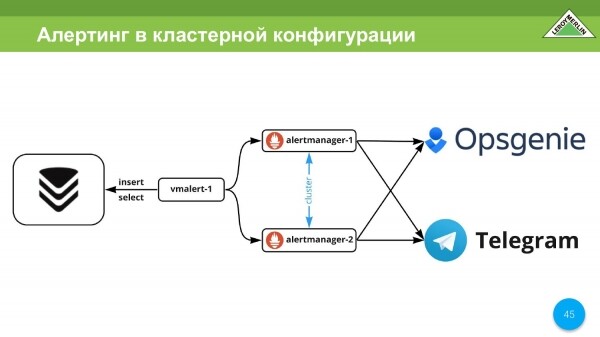
Máme alerting. Používáme ho. Používáme alertmanager od Promethea. Jako kanál pro doručování alertů používáme Opsgenie a Telegram. Na Telegramu se shromažďují notifikace od dev, možná něco od prod, ale většinou něco takového statistického, potřebného inženýrům. Opsgenie představuje kritické oznámení. To jsou telefonáty, správa incidentů.
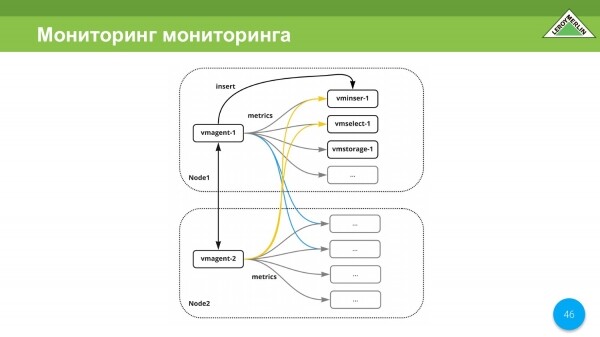
Věčný dotaz: „Kdo monitoruje monitoring?“. V našem případě monitoring monitoruje sám monitoring, protože používáme vmagent na každém uzlu. A protože jsou naše uzly rozloženy po různých datových centrech jednoho poskytovatele, máme pro každé datové centrum vlastní kanál, jsou nezávislé a i když dojde k rozdělení mozku, přesto získáme alerty. Ano, bude jich víc, ale lépe dostat více alertů než žádné.
Končíme náš seznam realizací HA.
A dále bych chtěl zmínit zkušenost s komunitou VictoriaMetrics. Ta byla velmi pozitivní. Kluci jsou ochotní. Snaží se pochopit každý případ, který je předložen.
Vytvářel jsem problémy na GitHubu. Ty byly velmi rychle vyřešeny. Jsou ještě nějaké problémy, které nejsou úplně uzavřeny, ale už podle kódu vidím, že se na tom pracuje.
Hlavní problém během iterací pro mě byl, že když jsem vypnul uzel, prvních 30 sekund mi vminsert nemohl pochopit, že backend není k dispozici. Toto už je nyní vyřešeno. A doslova za sekundu nebo dvě jsou data získávána ze všech zbývajících uzlů a dotaz přestává čekat na chybějící uzel.
V nějakém okamžiku jsme měli z VictoriaMetrics přání, aby to byl VictoriaMetrics operator. Čekali jsme na něj. Nyní aktivně budujeme obal nad VictoriaMetrics operator, abychom vzali všechna pravidla pro předpočítávání atd. Prometheus, protože dost aktivně používáme pravidla, která přicházejí spolu s operatorhem Prometheus.
Existují návrhy na zlepšení klastrové implementace. Vysvětlil jsem je výše.
A také bych velmi rád viděl downsampling. V našem případě je downsampling potřebný výhradně pro sledování trendů. Jinými slovy, jedna metrika během dne mi stačí. Tyto trendy potřebujeme na rok, na tři, na pět, na deset let. A jedno hodnotu metriky je naprosto dostatečné.
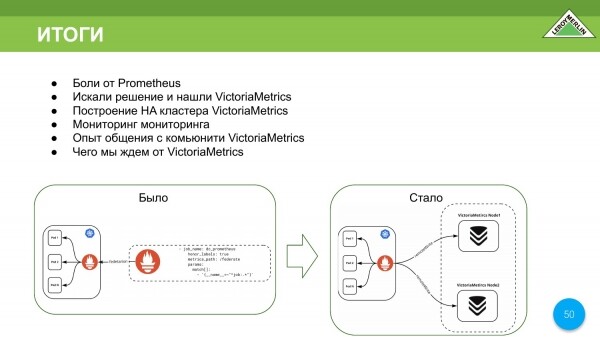
- Poznali jsme bolest, stejně jako někteří naši kolegové, při používání Prometheus.
- Vybrali jsme si VictoriaMetrics.
- Dostatečně dobře se škáluje jak vertikálně, tak horizontálně.
- Můžeme rozdělit různé komponenty na různé množství uzlů v clusterech, omezit je podle velikosti paměti, přidávat paměť atd.
Budeme u nás používat VictoriaMetrics, protože se nám velmi líbí. Tohle byla původní situace a jak to nyní vypadá.
Dva qr kódy na chat VictoriaMetrics, mé kontakty, tech radar LeroyMerlin.
Zdroj: habr.com
