

Ahoj!
Jmenuji se Michail, jsem zástupcem ředitele IT v společnosti „Sportmaster“. Chci se podělit o příběh o tom, jak jsme se vyrovnali s obtížemi, které nastaly během pandemie.
V prvních dnech nových skutečností zastavil obvyklý formát offline obchodu „Sportmasteru“ a zatížení našeho online kanálu, zejména v oblasti doručování k zákazníkům, se zvýšilo desetinásobně. Během několika týdnů jsme transformovali obrovský offline byznys na online a přizpůsobili službu potřebám našich zákazníků.
Celkově se to, co bylo v podstatě naší vedlejší činností, stalo hlavním byznysem. Důležitost každé internetové objednávky se zvýšila extrémně. Bylo třeba zachovat každý rubl, který zákazník přinesl do společnosti.
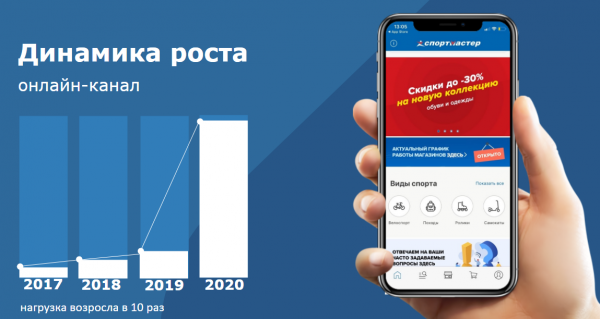
Abychom mohli rychle reagovat na požadavky zákazníků, otevřeli jsme další kontaktní centrum v hlavní kanceláři společnosti a nyní můžeme přijímat přibližně 285 tisíc hovorů týdně. Zároveň jsme převiedli 270 obchodů do nového formátu bezkontaktní a bezpečné práce, což umožnilo zákazníkům dostávat objednávky a zaměstnancům udržet si pracovní místa.
Během transformace jsme narazili na dvě hlavní problémy. Za prvé, výrazně vzrostlo zatížení našich online zdrojů (jak jsme se s tím vypořádali, poví vám Sergej). Za druhé, tok vzácných operací (před COVID) mnohonásobně vzrostl, což na oplátku vyžadovalo velký objem rychlé automatizace. Abychom tento problém vyřešili, museli jsme rychle přesunout zdroje z oblastí, které byly dříve hlavní. Jak jsme se s tím vyrovnali, poví vám Elena.
Provoz online služeb
Kolesnikov Sergej, odpovídá za provoz internetového obchodu a mikroslužeb
Od chvíle, kdy naše kamenné obchody začaly být uzavřeny pro návštěvníky, jsme začali zaznamenávat růst takových metrik, jako je počet uživatelů, počet objednávek provedených v naší aplikaci, počet požadavků na aplikace.
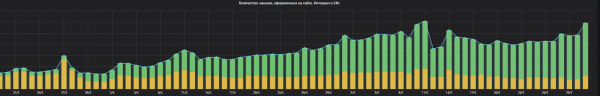 Počet objednávek od 18. do 31. března
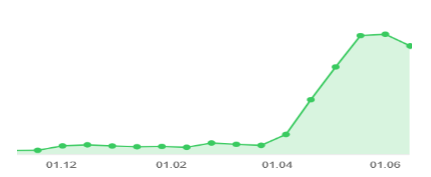 Počet požadavků na mikroslužby online plateb
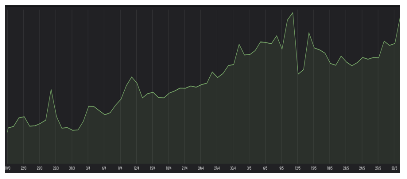 Počet objednávek zadaných na webu
Na prvním grafu vidíme, že nárůst činil přibližně 14krát, na druhém — 4krát. Nejvýznamnější při tom považujeme metriku doby odezvy našich aplikací.
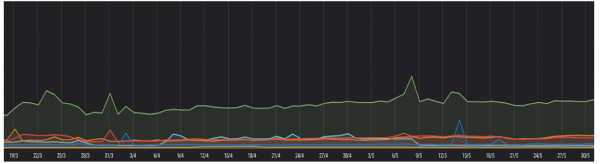
Na tomto grafu vidíme odpovědi front a aplikací, a my jsme si určili, že jsme nezaznamenali žádný konkrétní růst.
Toto je především způsobeno tím, že jsme začali přípravné práce na konci roku 2019. Nyní jsou naše služby rezervovány, zajištěna redundance na úrovni fyzických serverů, virtualizačních systémů, Dockeru a služeb v nich. Naše serverové zdroje nyní zvládají několikanásobnou zátěž.
Hlavním nástrojem, který nám v této záležitosti pomohl, byl náš monitorovací systém. Je pravda, že ještě nedávno jsme neměli jednotný systém, který by shromažďoval metriky na všech vrstvách, od fyzického hardware po obchodní metriky.
Formálně monitorování v společnosti existovalo, ale obvykle bylo rozptýlené a bylo v odpovědnosti konkrétních oddělení. Ve skutečnosti, když došlo k nějakému incidentu, často jsme neměli jednotné pochopení, co se přesně stalo, nebyla zde žádná informace, a to často vedlo k bezcílnému hledání a lokalizaci problému pro jeho následné odstranění.
V určitém okamžiku jsme si uvědomili, že to takto už dál nemůžeme snášet — potřebujeme jednotný systém, abychom viděli celý obraz. Hlavní technologie, které používáme, jsou Zabbix jako centrum alertingu a ukládání metrik, Prometheus pro shromažďování a ukládání metrik aplikací, Stack ELK pro logování a ukládání dat celého monitorovacího systému, a Grafana pro vizualizaci, Swagger, Docker a další užitečné a známé nástroje.
Používáme nejen dostupné technologie na trhu, ale také vyvíjíme některé věci sami. Například vytváříme služby pro integraci systémů mezi sebou, tedy jakési API pro shromažďování metrik. Pracujeme také na našich vlastních monitorovacích systémech — na úrovni obchodních metrik používáme UI testy. Dále máme bota v Telegramu pro upozorňování týmů.
A také se snažíme zpřístupnit monitorovací systém týmům, aby si mohly samostatně ukládat své metriky a pracovat s nimi, včetně nastavení alertingu u některých úzkých metrik, které mají omezené použití.
V rámci celého systému usilujeme o proaktivitu a maximálně rychlou lokalizaci incidentů. Navíc se počet našich mikroslužeb a systémů v poslední době významně zvýšil, a tím i počet integrací. V rámci optimalizace procesu diagnostiky incidentů na úrovni integrace vyvíjíme systém, který umožňuje provádět mezi systémové kontroly a vyhodnocovat výsledky, což nám pomáhá identifikovat hlavní problémy spojené s importy a vzájemným interakcím systémů.
Samozřejmě máme ještě prostor pro růst a rozvoj v oblasti provozu systémů, a na tom aktivně pracujeme. Více informací o našem monitorovacím systému si můžete přečíst .
Technické zkoušky
Sergej Orlov, vede kompetenční centrum pro webový a mobilní vývoj
Od začátku uzavření fyzických obchodů jsme čelili různým zkouškám z hlediska vývoje. V první řadě skokovému nárůstu zátěže. Je jasné, že pokud se nepodniknou odpovídající kroky, při vysoké zátěži může systém s nepříjemným prasknutím přestat fungovat, nebo úplně ztratit svou výkonnost.
Druhý aspekt, méně zřejmý, spočívá v tom, že systém s vysokou zátěží je nutné velmi rychle měnit a přizpůsobovat se změnám obchodních procesů. Někdy i několikrát za den. V mnoha firmách platí pravidlo, že při velkých marketingových aktivitách by se do systému nemělo provádět žádné změny. Opravdu žádné, ať funguje, když funguje.
A my jsme v podstatě měli nekonečný černý pátek, během kterého bylo nutné systém měnit. A jakákoliv chyba, problém nebo selhání v systému by firmu stály velké peníze.
Abyste věděli, podařilo se nám tyto zkoušky zvládnout, všechny systémy udržely zátěž, snadno se škálovaly a nedošlo k žádným globálním technickým selháním.
Existují čtyři základní pilíře, na kterých stojí schopnost systému zvládat vysoké nárazové zatížení. Prvním z nich je monitoring, o kterém jste četli výše. Bez dobře nastaveného monitorovacího systému je téměř nemožné určit slabá místa systému. Dobrý monitorovací systém je jako pohodlný domácí oděv, měl by být komfortní a přizpůsobený vašim potřebám.
Druhým aspektem je testování. K tomuto bodu přistupujeme velmi vážně: píšeme a provádíme klasické jednotkové, integrační, zátěžové testy a mnohé další pro každý systém. Také vytváříme testovací strategii a snažíme se dosáhnout úrovně testování, kdy už nám ruční kontroly nebudou potřeba.
Třetí pilíř představuje CI/CD Pipeline. Procesy buildování, testování a nasazování aplikace by měly být co nejvíce automatizovány, bez ručního zásahu. Téma CI/CD Pipeline je poměrně hluboké, a tak se k němu dotknu jen okrajově. Je třeba zmínit, že máme checklist CI/CD Pipeline, podle kterého každá produktová tým prochází pomocí center kompetence.
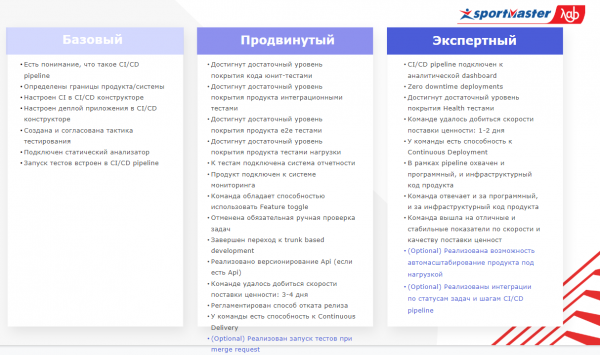 A tady je checklist
Tímto se dosahuje mnoha cílů. Jde o verzionování API, a feature toggle, aby se předešlo problémům s releasováním, a také o dosažení takové úrovně pokrytí různými testy, kdy by testování bylo plně automatizované, nasazení bezproblémové a další.
Čtvrtým pilířem jsou architektonické principy a technická řešení. O architektuře lze mluvit dlouho a obsáhle, ale chtěl bych zdůraznit pár principů, na které bych se chtěl zaměřit.
Za prvé, je nutné vybírat specializované nástroje pro konkrétní úkoly. Ano, zní to samozřejmě a je jasné, že hřebíky je třeba zatloukat kladivem a rozebírat náramkové hodinky speciálními šroubováky. Ale v naší době se mnohé nástroje snaží o univerzalizaci, aby pokryly maximální segment uživatelů: databáze, cache, frameworky a další. Například, pokud vezmeme databázi MongoDB, funguje s vícedokumentovými transakcemi, zatímco databáze Oracle pracuje s jsony. A zdálo by se, že vše lze použít na vše. Ale pokud obhajujeme výkon, musíme jasně porozumět silným a slabým stránkám každého nástroje a používat ty, které potřebujeme pro naši třídu úkolů.
Za druhé, při návrhu systémů by každé zvýšení složitosti mělo být odůvodněné. Musíme si to stále připomínat, princip nízké vazby je všem známý. Myslím, že by měl být aplikován jak na úrovni konkrétního služby, tak na úrovni celého systému a na úrovni architektonické krajiny. Důležitá je také schopnost horizontálního škálování každé komponenty systému při zatížení. Pokud tuto schopnost máme, škálování nebude žádný problém.
Pokud jde o technická řešení, požádali jsme produktové týmy, aby připravily čerstvou sadu doporučení, nápadů a řešení, která realizovaly v průběhu přípravy na další vlnu zatížení.
Cache
Je třeba věnovat obzvláštní pozornost výběru lokálních a distribuovaných cache. Někdy dává smysl používat obojí v rámci jednoho systému. Například máme systémy, kde část dat je v podstatě výstavním cache, což znamená, že zdroj aktualizací se nachází za samotným systémem a systémy tato data nemění. Pro tento přístup používáme lokální Caffeine Cache.
A existují data, která systém aktivně mění v průběhu provozu, a zde již používáme distribuovaný cache s Hazelcastem. Tento přístup nám umožňuje využívat výhody distribuovaného cache tam, kde jsou skutečně potřeba, a minimalizovat náklady na službu při cirkulaci dat clusteru Hazelcast tam, kde se tomu můžeme vyhnout. O cache jsme již hodně psali. a .
Změna serializátoru na Kryo v Hazelcast nám přinesla slušný nárůst. A přechod z ReplicatedMap na IMap + Near Cache v Hazelcast nám umožnil minimalizovat pohyb dat v rámci clustera.
Malý tip: při hromadné invalidaci cache se někdy osvědčuje taktika ohřevu druhé cache s následným přepnutím na ni. Na první pohled by se mohlo zdát, že při tomto přístupu bychom měli mít dvojité využití paměti, avšak v praxi se v těch systémech, kde bylo toto praktikováno, spotřeba paměti snižovala.
Reaktivní stack
Používáme reaktivní stack v již poměrně velkém počtu systémů. V našem případě je to Webflux nebo Kotlin s korutinami. Reaktivní stack je obzvlášť efektivní tam, kde očekáváme pomalé operace vstupu a výstupu. Například při volání pomalých služeb, práci se souborovým systémem nebo systémy ukládání.
Nejdůležitějším principem je vyhýbat se blokujícím voláním. Pod kapotou reaktivních frameworků běží omezený počet živých servisních vláken. Pokud nebezpečně umožníme přímé blokující volání, jako je volání JDBC ovladače, systém se jednoduše zastaví.
Snažte se převádět chyby na vlastní runtime výjimky. Skutečný tok vykonávání programu se přenáší k reaktivním frameworkům, provádění kódu se stává neliniárním. Proto je velmi obtížné diagnostikovat problémy pomocí stack trace. Řešením je tedy vytváření srozumitelných objektivních runtime výjimek na každou chybu.
Elasticsearch
Při použití Elasticsearch nevybírejte nepoužívaná data. Toto je v podstatě velmi jednoduchý tip, ale často se na něj zapomíná. Pokud potřebujete vybrat více než 10 tisíc záznamů najednou, je třeba použít Scroll. V analogii to trochu připomíná kurzor v relační databázi.
Nepoužívejte postfilter bez nutnosti. Při velkých datech v hlavním výběru tato operace výrazně zatěžuje databázi.
Používejte hromadné operace tam, kde je to aplikovatelné.
API
Při návrhu API zohledněte požadavky na minimalizaci přenášených dat. To je obzvlášť důležité při spojení s frontendem: právě na tomto rozhraní opouštíme kanály našich datových center a pracujeme už na kanálu spojujícím nás s klientem. Pokud na něm nastanou jakékoli problémy, příliš vysoký provoz způsobí negativní uživatelskou zkušenost.
A nakonec, nevylévejte všechny údaje, přistupujte k smlouvě mezi spotřebiteli a dodavateli jasně.
Organizační transformace
Elena Jeroškina, zástupkyně ředitele pro IT
V okamžiku, kdy došlo ke karanténě a vznikla potřeba rychle zvyšovat tempo rozvoje online a zavádět omnichannel služby, jsme již byli v procesu organizační transformace.
Část naší struktury byla převedena na práci podle principů a praktik produktového přístupu. Vytvořily se týmy, které nyní odpovídají za fungování a rozvoj každého produktu. Zaměstnanci v těchto týmech jsou zapojeni na 100 % a organizují svou práci podle scrumu nebo kanbanu, v závislosti na tom, co je pro ně preferovanější, nastavují dodací proces, zavádějí technické praktiky, praktiky zajištění kvality a mnohé další.
Nešťastnou náhodou byla většina těchto produktových týmů u nás právě v oblasti online a omnichannel služeb. To nám umožnilo v nejkratší době (opravdu, doslova za dva dny) přejít do režimu domácí práce bez ztráty efektivity. Nastavený proces umožnil rychlou adaptaci na nové podmínky práce a udržení dostatečně vysokého tempa dodávky nové funkčnosti.
Kromě toho jsme potřebovali posílit ty týmy, které se nacházely na frontě online byznysu. V tu chvíli bylo jasné, že to můžeme udělat pouze na úkor interních zdrojů. A přibližně 50 lidí během dvou týdnů změnilo oblast, ve které dosud pracovali, a zapojili se do práce na novém produktu.
K tomu nebylo zapotřebí žádných speciálních manažerských úsilí, protože vedle organizace vlastního procesu, technického zdokonalování produktu, a praxe zajištění kvality, učíme naše týmy sebeorganizaci — řídit vlastní výrobní proces bez zapojení administrativních zdrojů.
Vedení zdrojů jsme mohli soustředit tam, kde to bylo v danou chvíli nezbytné — na koordinaci s byznysem: Co je nyní pro naše klienty důležité, jaké funkce je třeba realizovat jako první, co je potřeba udělat pro zvýšení naší kapacity v dodávkách a zpracování objednávek. To všechno, spolu s jasným rolovým modelem, umožnilo v tomto období zatížit naše výrobní toky vytváření hodnoty tím, co je skutečně důležité a potřebné.
Je jasné, že při práci na dálku a vysokém tempu změn, kdy od účasti každého závisí obchodní ukazatele, nelze spoléhat pouze na vnitřní pocity typu "Jde nám to dobře? No, celkem to jde." Potřebujeme objektivní metriky výrobního procesu. Ty máme k dispozici, jsou dostupné každému, kdo se zajímá o metriky produktových týmů. Především samotnému týmu, byznysu, spolupracovníkům a vedení.
Jednou za dva týdny se s každým týmem koná status, během něhož se během 10 minut analyzují metriky, odhalují úzká místa výrobního procesu a vytváří se společné řešení: co lze udělat pro odstranění těchto úzkých míst. Zde si také lze rovnou požádat o pomoc vedení, pokud se nějaký zjištěný problém nachází mimo rámec vlivu týmů, nebo o expertní radu kolegů, kteří se s podobným problémem již mohli setkat.
Přesto chápeme, že pro nás je třeba se mnohému ještě naučit a implementovat to do každodenní práce, abychom dosáhli výrazného zrychlení (což je cíl, který si klademe). Právě teď pokračujeme ve škálování produktového přístupu na další týmy a nové produkty. K tomu jsme se museli naučit nový formát online školy metodologů.
Metodologové, lidé, kteří pomáhají týmům budovat procesy, zlepšovat komunikaci a zvyšovat efektivitu práce, jsou v podstatě agenty změny. Právě teď absolventi našeho prvního ročníku pracují s týmy a pomáhají jim k úspěchu.
Myslím, že aktuální situace nám otevírá příležitosti a perspektivy, které si možná ještě plně neuvědomujeme. Ale zkušenosti a praxe, které získáváme právě teď, potvrzují, že jsme si vybrali správnou cestu rozvoje, a v budoucnu nepropásneme tyto nové příležitosti a budeme schopni efektivně reagovat na výzvy, které před "Sportmasterem" budou.
Závěry
Během této náročné doby jsme formulovali hlavní principy, na kterých stojí vývoj softwaru, které si myslím, že budou relevantní pro každou společnost, která se tím zabývá.
Lidé. To je to, na čem to celé spočívá. Zaměstnanci by měli mít radost z práce, rozumět cílům společnosti a cílům produktů, na kterých pracují. A samozřejmě by se měli profesionálně rozvíjet.
Technologie. Je nutné, aby společnost zralým způsobem přistupovala k práci se svým technologickým stackem a zvyšovala kompetence tam, kde je to skutečně potřebné. Zní to velmi jednoduše a samozřejmě. A velmi často se to ignoruje.
Procesy. Je důležité správně nastavit práci produktových týmů a center kompetencí, navázat interakci s byznysem, abychom s ním mohli pracovat jako s partnerem.
Takže, přibližně tak jsme přežili. Hlavní teze současnosti se opět potvrdila, zvučně mě praštila přes čelo.
I když jsi obrovský offline business s mnoha obchody a spoustou měst, rozvíjej svůj online. To není jen další kanál prodeje nebo krásná aplikace, přes kterou si také můžeš něco koupit (a navíc protože konkurence má také krásnou). To není rezerva pro případ nouze, která pomůže přečkat bouři.
Je to naprostá nutnost. Na kterou by měly být připraveny nejen vaše technické kapacity a infrastruktura, ale i lidé a procesy. Vždyť je možné rychle dokoupit paměť, místo, nasadit nové instance a tak dále za pár hodin. Ale lidi a procesy je třeba na to připravovat dopředu.
Zdroj: habr.com
