

Stále častěji dostáváme od klientů takové dotazy: „Chceme něco jako Amazon RDS, ale levnější“; „Chceme něco jako RDS, ale všude, v jakékoli infrastruktuře.“ Abychom realizovali takové spravované řešení na Kubernetes, podívali jsme se na aktuální stav nejpopulárnějších operátorů pro PostgreSQL (Stolon, operátoři od Crunchy Data a Zalando) a učinili jsme svůj výběr.
Tento článek je založen na našich zkušenostech a to jak z teoretického hlediska (přehled řešení), tak z praktického pohledu (co bylo zvoleno a co z toho vzešlo). Ale nejdříve si pojďme vyjasnit, jaké požadavky jsou kladeny na potenciální náhradu RDS...
Co vlastně RDS je
Když lidé mluví o RDS, podle našich zkušeností mají na mysli spravovanou službu DBMS, která:
- snadno se nastavuje;
- má možnost pracovat se snapshoty a obnovovat je z nich (preferovaně s podporou );
- umožňuje vytvářet topologie master-slave;
- má bohatý seznam rozšíření;
- poskytuje audit a správu uživatelů/přístupů.
Obecně řečeno, přístupy k realizaci stanoveného úkolu mohou být velmi různé, nicméně cesta s podmínkovým Ansible nám není blízká. (K podobnému závěru dospěli i kolegové z 2GIS v důsledku vytvořit „nástroj pro rychlé nasazení vysoce dostupného clustera na základě Postgres“.)
Právě operátoři jsou běžně používaný přístup pro řešení podobných úkolů v ekosystému Kubernetes. Podrobněji o nich v souvislosti s databázemi spuštěnými uvnitř Kubernetes již hovořil technický ředitel „Flanta“, , v .
NB: Pro rychlé vytvoření jednoduchých operátorů doporučujeme věnovat pozornost naší Open Source utilitě . Její využití umožňuje to bez znalosti Go, ale spíše běžnými způsoby pro administrátory: v Bash, Pythonu atd.
Pro PostgreSQL existuje několik populárních K8s operátorů:
- Stolon;
- Crunchy Data PostgreSQL Operator;
- Zalando Postgres Operator.
Podívejme se na ně podrobněji.
Výběr operátora
Kromě těch důležitých funkcí, které již byly zmíněny výše, jsme – jako inženýři pro provoz infrastruktury na Kubernetes – rovněž očekávali od operátorů následující:
- nasazení z Gitu a s ;
- podpora pod anti-affinity;
- nástavba node affinity nebo node selector;
- nástavba tolerations;
- možnosti ladění;
- srozumitelné technologie a dokonce i příkazy.
Aniž bych se podrobně zabýval každým bodem (ptejte se v komentářích, pokud zůstanou otázky po přečtení celého článku), všimnu si celkově, že tyto parametry jsou potřebné pro jemnější popis specializace uzlů clusteru, abychom je mohli objednávat pro konkrétní aplikace. Tímto způsobem můžeme dosáhnout optimální rovnováhy mezi výkonem a náklady.
Nyní k samotným operátorům PostgreSQL.
1. Stolon
od italské společnosti Sorint.lab v byl považován za jakýsi etalon mezi operátory pro DB. Je to poměrně starý projekt: jeho první veřejné vydání se uskutečnilo již v listopadu 2015(!), a repozitář na GitHubu se může pyšnit téměř 3000 hvězdami a více než 40 přispěvateli.
A skutečně, Stolon je skvělým příkladem promyšlené architektury:
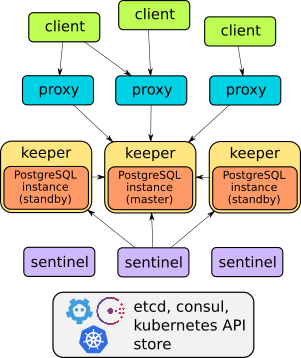
S tímto operátorem se podrobněji můžete seznámit ve zprávě nebo . Obecně lze říci, že umí vše popsané: failover, proxy pro transparentní přístup klientů, zálohy… Přičemž proxy poskytují přístup přes jeden serverový endpoint — na rozdíl od dvou dalších řešení, která budou dále probrána (mají po dvou službách pro přístup k databázi).
Nicméně Stolon , takže jej nelze nasadit tak, aby bylo možné rychle a snadno — "jako horké koláče" — vytvářet instance DB v Kubernetes. Správa se provádí pomocí nástroje stolonctl, nasazení — pomocí Helm chartu, a uživatelské definice se nastavují v ConfigMap.
Na jedné straně to vypadá, že operátor není skutečně operátor (vždyť nevyužívá CRD). Na druhé straně je to flexibilní systém, který umožňuje přizpůsobení zdrojů v K8s tak, jak vám to vyhovuje.
Shrnuto, osobně nám nepřišlo optimální mít samostatný chart pro každou DB. Proto jsme začali hledat alternativy.
2. Crunchy Data PostgreSQL Operator
, mladého amerického startupu, vypadal jako logická alternativa. Jeho veřejná historie začíná prvním vydáním v březnu 2017, od té doby repozitář na GitHubu získal něco méně než 1300 hvězd a více než 50 přispěvatelů. Poslední vydání z září bylo testováno na spolupráci s Kubernetes 1.15–1.18, OpenShift 3.11+ a 4.4+, GKE a VMware Enterprise PKS 1.3+.
Architektura Crunchy Data PostgreSQL Operator také splňuje uvedené požadavky:
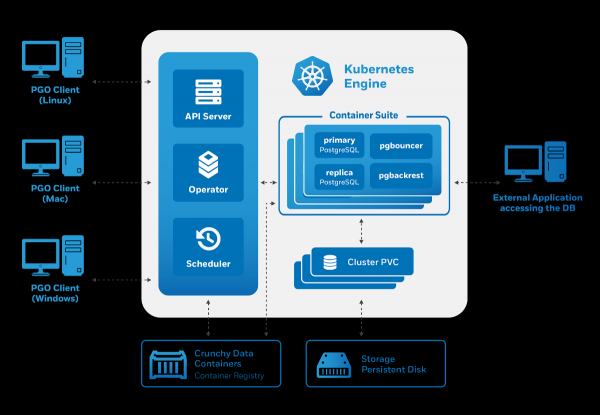
Správa probíhá prostřednictvím utility pgo, nicméně ta zase generuje Custom Resources pro Kubernetes. Proto nás jako potenciální uživatele operátor potěšil:
- existuje správa přes CRD;
- pohodlná správa uživatelů (také přes CRD);
- integrace s dalšími komponentami — specializovaná kolekce kontejnerových obrazů pro PostgreSQL a utilit pro práci s ní (včetně pgBackRest, pgAudit, rozšíření z contrib atd.).
Nicméně pokusy začít používat operátor od Crunchy Data odhalily několik problémů:
- Nebyla možnost tolerancí — byl zajištěn pouze nodeSelector.
- Vytvářené pod-y byly součástí Deploymentu, přestože jsme nasazovali stateful aplikaci. Na rozdíl od StatefulSetů, Deploymenty neumí vytvářet disky.
Poslední nedostatek vede k zábavným okamžikům: na testovací prostředí se podařilo spustit 3 repliky s jedním diskem lokální úložiště, což vedlo k tomu, že operátor hlásil, že 3 repliky fungují (ačkoliv to tak nebylo).
Další zvláštností tohoto operátora je jeho hotová integrace s různými podpůrnými systémy. Například je snadné nainstalovat pgAdmin a pgBounce, a v zvažují se přednastavené Grafana a Prometheus. V nedávném se zvlášť zmiňuje vylepšená integrace s projektem , díky níž operátor nabízí názornou vizualizaci metrik podle PgSQL „z krabice“.
Nicméně podivná volba generovaných Kubernetes zdrojů nás přivedla k nutnosti hledat jiné řešení.
3. Zalando Postgres Operator
Produkty Zalando známe již dlouho: máme zkušenosti s používáním Zalenium a samozřejmě jsme vyzkoušeli — jejich populární HA řešení pro PostgreSQL. O přístupu firmy k vytvoření vyprávěl jeden z jeho autorů — Alexej Kljukin — ve vysílání , a ten se nám zalíbil.
Je to nejmladší řešení z těch, která se zde zmiňují: první vydání se konalo v srpnu 2018. Nicméně, i přes malé množství formálních vydání, projekt prošel dlouhou cestu, již překonal na popularitě řešení od Crunchy Data s více než 1300 hvězdami na GitHubu a maximálním počtem přispěvatelů (70+).
"Pod kapotou" tohoto operátora se používají řešení, která odolala zkoušce času:
- Patroni a pro správu,
- — pro zálohy,
- — jako pool připojení.
Takto je reprezentována architektura operátora od Zalando:
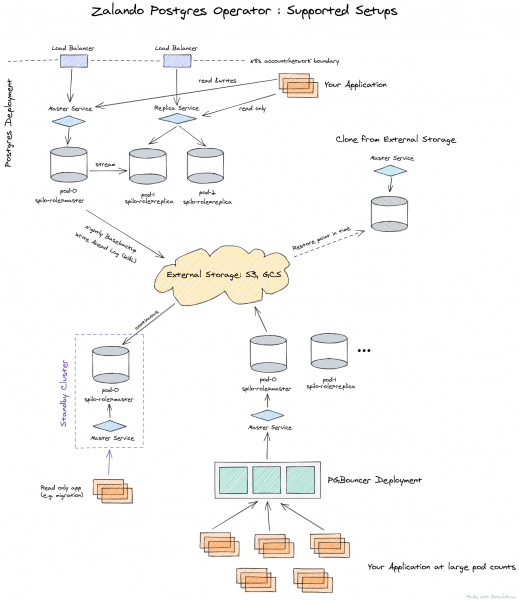
Operátor je plně spravován prostřednictvím Custom Resources, automaticky vytváří StatefulSet z kontejnerů, které lze poté přizpůsobit přidáním různých sidecarů do podu. To je značná výhoda ve srovnání s operátorem od Crunchy Data.
Jelikož jsme se rozhodli pro řešení od Zalando mezi třemi zvažovanými variantami, následující popis jeho možností bude uveden níže, hned společně s praktickým použitím.
Praktická část s Postgres Operátorem od Zalando
Nasazení operátora probíhá velmi jednoduše: stačí stáhnout aktuální verzi z GitHubu a aplikovat YAML soubory z adresáře . Alternativně lze také využít .
Po nainstalování je dobré se postarat o nastavení . To se provádí prostřednictvím ConfigMap postgres-operator ve jmenném prostoru, kam jste operátor nainstalovali. Jakmile jsou úložiště nastavena, lze nasadit první cluster PostgreSQL.
Například naše standardní nasazení vypadá takto:
apiVersion: acid.zalan.do/v1
kind: postgresql
metadata:
 name: staging-db
spec:
 numberOfInstances: 3
 patroni:
   synchronous_mode: true
 postgresql:
   version: "12"
 resources:
   limits:
     cpu: 100m
     memory: 1Gi
   requests:
     cpu: 100m
     memory: 1Gi
 sidecars:
 - env:
   - name: DATA_SOURCE_URI
     value: 127.0.0.1:5432
   - name: DATA_SOURCE_PASS
     valueFrom:
       secretKeyRef:
         key: password
         name: postgres.staging-db.credentials
   - name: DATA_SOURCE_USER
     value: postgres
   image: wrouesnel/postgres_exporter
   name: prometheus-exporter
   resources:
     limits:
       cpu: 500m
       memory: 100Mi
     requests:
       cpu: 100m
       memory: 100Mi
 teamId: staging
 volume:
   size: 2Gi
Tento manifest nasazuje cluster ze 3 instancí se sidecarem ve formě , ze kterého sledujeme metriky aplikace. Jak vidíte, vše je velmi jednoduché a lze vytvořit doslova neomezené množství clusterů.
Je dobré věnovat pozornost také webovému rozhraní pro správu — . To se dodává spolu s operátorem a umožňuje vytvářet a mazat clustery, stejně jako pracovat se zálohami, které operátor vytváří.
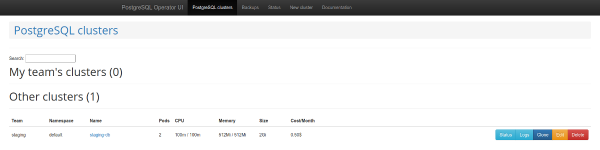
Seznam clusterů PostgreSQL
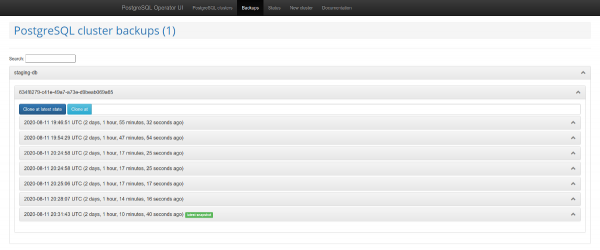
Správa záloh
Další zajímavou funkcí je podpora . Tento mechanismus automaticky vytváří role v PostgreSQL, na základě získaného seznamu jmen uživatelů. Poté API umožňuje vrátit seznam uživatelů, pro které jsou automaticky vytvářeny role.
Problémy a jejich řešení
Použití operátora však brzy odhalilo několik závažných nedostatků:
- nedostatek podpory pro nodeSelector;
- nemožnost zakázat zálohy;
- při použití funkce pro vytváření databází se nezobrazují výchozí oprávnění;
- Občas chybí dokumentace nebo je v zastaralém stavu.
Naštěstí mnoho z nich lze vyřešit. Začneme od konce — problémů s dokumentací.
Pravděpodobně se setkáte s tím, že není vždy jasné, jak nastavit zálohu a jak připojit zálohovací bucket k Operator UI. O tom se v dokumentaci zmiňuje jen okrajově, skutečný popis je v :
- je třeba vytvořit tajný klíč;
- předat jej operátorovi v parametru
pod_environment_secret_namev CRD se konfigurací operátora nebo v ConfigMap (záleží na tom, jak jste se rozhodli operátor nainstalovat).
Jak se však ukázalo, v současné době to není možné. Právě proto jsme shromáždili s některými dodatečnými externími vylepšeními. Podrobnosti o ní — viz níže.
Pokud předáváte operátorovi parametry pro zálohu, konkrétně — wal_s3_bucket a přístupové klíče do AWS S3, pak bude zálohovat všechno: nejen databáze v produkci, ale také ve stagingu. To nám nevyhovovalo.
V popisu parametrů k Spilo, které je základním Docker wrapperem pro PgSQL při použití operátora, se ukázalo: lze předat parametr WAL_S3_BUCKET prázdným, čímž se zálohy deaktivují. Navíc, k naší velké radosti, se našel i , který jsme okamžitě přijali do našeho forku. Teď stačí jednoduše přidat enableWALArchiving: false do zdroje clusteru PostgreSQL.
Ano, byla možnost udělat to jinak, spustit 2 operátory: jeden pro staging (bez záloh), a druhý — pro produkci. Ale tak jsme se mohli obejít s jedním.
Dobře, naučili jsme se předávat databázím přístup pro S3 a zálohy začaly končit ve skladišti. Jak aktivovat stránky záloh v Operator UI?
V Operator UI je třeba přidat 3 proměnné:
-
SPILO_S3_BACKUP_BUCKET -
AWS_ACCESS_KEY_ID -
AWS_SECRET_ACCESS_KEY
Poté se správa záloh stane dostupnou, což v našem případě zjednoduší práci se stagingem, umožní posílat tam výřezy z produkce bez dalších skriptů.
Jako další výhodu se zmiňovalo použití Teams API a široké možnosti pro vytváření databází a rolí pomocí operátora. Nicméně vytvářené role neměly výchozí oprávnění. Uživatel s právy na čtení tak nemohl číst nové tabulky.
Proč tomu tak je? I když v kódu jsou potřebné UDĚLOVAT, nejsou vždy používány. Existují 2 metody: syncPreparedDatabases a syncDatabases. V syncPreparedDatabases — navzdory tomu, že v sekci preparedDatabases je podmínka defaultRoles a defaultUsers pro vytváření rolí, — výchozí práva se neuplatňují. Pracujeme na přípravě opravy, aby se tato práva automaticky aplikovala.
A poslední bod v současných úpravách — , který přidává Node Affinity do vytvářeného StatefulSet. Naši klienti často preferují snižovat náklady používáním spot instancí, na které rozhodně není dobré umisťovat databázové služby. Tento problém by šlo řešit i pomocí tolerancí, ale existence Node Affinity zajišťuje větší důvěru.
Co se podařilo?
Na základě řešení výše uvedených problémů jsme forkli Postgres Operator od Zalando do , kde je sbírán se velmi užitečnými opravami. A pro větší pohodlí jsme také .
Seznam PR přijatých do forku:
- ;
- ;
- ;
- .
Bylo by skvělé, kdyby komunita podpořila tyto PR, aby se dostaly do upstreamu s příští verzí operátora (1.6).
Bonus! Příběh úspěchu s migrací produkce
Pokud používáte Patroni, můžete migrovat živou produkci na operátora s minimálním prostojem.
Spilo umožňuje vytváření standby clusterů přes S3 úložiště s , kdy je binární log PgSQL nejprve uložen do S3 a poté stažen replikou. Ale co dělat, pokud máte ne používáte Wal-E ve staré infrastruktuře? Řešení tohoto problému už na habru.
Na pomoc přichází logická replikace PostgreSQL. Nicméně se nebudeme zabývat detaily vytváření publikací a předplatných, protože… náš plán selhal.
Skutečností je, že v databázi bylo několik zatížených tabulek s miliony řádků, které byly zároveň neustále doplňovány a odstraňovány. s copy_data, kdy nová replikace kopíruje veškerý obsah z primárního zdroje, si jednoduše nestačila za primárním zdrojem. Kopírování obsahu trvalo týden, ale primární zdroj nedohnala. Nakonec pomohlo se problémem pohnout kolegům z Avito: lze přenést data pomocí pg_dumpPopíši naši (mírně upravenou) variantu tohoto algoritmu.
Myšlenka spočívá v tom, že lze vytvořit vypnutou subscripci, která je vázaná na konkrétní replikační slot, a poté opravit číslo transakce. K dispozici byly repliky pro provoz v produkci. To je důležité, protože replika pomůže vytvořit konzistentní dump a pokračovat v příjmu změn z hlavního serveru.
V následujících příkazech, popisujících proces migrace, budou použity následující označení pro hostitele:
- master — zdrojový server;
- replica1 — streamová replika na starém produkčním serveru;
- replica2 — nová logická replika.
Plán migrace
1. Vytvoříme na hlavním serveru subscripci pro všechny tabulky ve schématu public databáze dbname:
psql -h master -d dbname -c "CREATE PUBLICATION dbname FOR ALL TABLES;"
2. Vytvoříme replikační slot na hlavním serveru:
psql -h master -c "select pg_create_logical_replication_slot('repl', 'pgoutput');"
3. Zastavíme replikaci na staré replice:
psql -h replica1 -c "select pg_wal_replay_pause();"
4. Získáme číslo transakce z hlavního serveru:
psql -h master -c "select replay_lsn from pg_stat_replication where client_addr = 'replica1';"
5. Vytvoříme dump ze staré repliky. Budeme to dělat ve více vláknech, což pomůže urychlit proces:
pg_dump -h replica1 --no-publications --no-subscriptions -O -C -F d -j 8 -f dump/ dbname
6. Nahrajeme dump na nový server:
pg_restore -h replica2 -F d -j 8 -d dbname dump/
7. Po načtení dumpu můžeme spustit replikaci na streamové replice:
psql -h replica1 -c "select pg_wal_replay_resume();"
7. Vytvoříme subscripci na nové logické replice:
psql -h replica2 -c "create subscription oldprod connection 'host=replica1 port=5432 user=postgres password=secret dbname=dbname' publication dbname with (enabled = false, create_slot = false, copy_data = false, slot_name='repl');"
8. Získáme oid subscripce:
psql -h replica2 -d dbname -c "select oid, * from pg_subscription;"
9. Předpokládejme, že bylo získáno oid=1000. Aplikujeme číslo transakce na subscripci:
psql -h replica2 -d dbname -c "select pg_replication_origin_advance('pg_1000', 'AA/AAAAAAAA');"
10. Spustíme replikaci:
psql -h replica2 -d dbname -c "alter subscription oldprod enable;"
11. Zkontrolujeme stav subscripce, replikace by měla fungovat:
psql -h replica2 -d dbname -c "select * from pg_replication_origin_status;"
psql -h master -d dbname -c "select slot_name, restart_lsn, confirmed_flush_lsn from pg_replication_slots;"
12. Po spuštění replikace a synchronizaci databází můžeme provést přepnutí.
13. Po zastavení replikace je třeba opravit sekvence. To je dobře popsáno .
Díky tomuto plánu bylo přepnutí provedeno s minimálními zpožděními.
Závěr
Kubernetes operátoři umožňují zjednodušit různé úkony tím, že je zredukují na vytváření K8s zdrojů. Nicméně, poté co dosáhnete skvělé automatizace s jejich pomocí, nezapomínejte, že může přinést i řadu nečekaných nuancí, proto přistupujte k výběru operátorů s rozmyslem.
Po zvážení tří nejpopulárnějších Kubernetes operátorů pro PostgreSQL jsme se rozhodli pro projekt od Zalando. A museli jsme překonat určité obtíže, ale výsledek nás skutečně potěšil, takže plánujeme tento zkušenost rozšířit i na několik dalších instalací PgSQL. Pokud máte zkušenosti s podobnými řešeními — rádi uvidíme podrobnosti v komentářích!
P.S.
Přečtěte si také náš blog:
- «»;
- «»;
- «».
Zdroj: habr.com
