

Před třemi lety Viktor Tarnavský a Alexej Milovidov z Yandexu na pódiu HighLoad++ , jaký je ClickHouse dobrý, a jak nebuzeruje. Na sousedním pódiu byl Alexander Zaitsev s o přechodu na ClickHouse jinou analytickou DBMS a s závěrem, že ClickHouse, samozřejmě, je dobrý, ale ne moc pohodlný. Když v roce 2016 firma LifeStreet, ve které tehdy pracoval Alexander, přenášela vícepetabajtový analytický systém na ClickHouse, byla to vzrušující "cesta ze žlutého cihlového" plná neznámých nebezpečí — ClickHouse tenkrát to připomínalo minové pole.
O tři roky později ClickHouse se stal mnohem lepším — za tu dobu Alexander založil firmu Altinity, která nejen pomáhá přecházet na ClickHouse desítkách projektů, ale také zdokonaluje samotný produkt společně s kolegy z Yandexu. Teď ClickHouse to už není bezstarostná procházka, ale už ani minové pole.
Alexander se systémům distribuovaným věnuje od roku 2003, vyvíjel velké projekty na MySQL, Oracle a Vertica. Na proběhlé HighLoad++ 2019 Alexander, jeden z pionýrů používání ClickHouse, vyprávěl, co si teď tato DBMS představuje. Poznáme hlavní rysy ClickHouse: čím se liší od jiných systémů a v jakých případech je efektivnější ji používat. Na příkladech prozkoumáme novější a osvědčené praktiky ze stavby systémů na ClickHouse.
Retrospektiva: co bylo před 3 lety
Před třemi lety jsme převáděli firmu LifeStreet na ClickHouse z jiné analytické databáze, a migrace analytiky reklamní sítě vypadala takto:
- Červen 2016. V OpenSource vznikl ClickHouse a zahájili jsme náš projekt;
- Srpen. Proof Of Concept: velká reklamní síť, infrastruktura a 200-300 terabajtů dat;
- Říjen. První produkční data;
- Prosinec. Plná produktová zátěž — 10-50 miliard událostí denně.
- Červen 2017. Úspěšný přechod uživatelů na ClickHouse, 2,5 petabajty dat na clusteru ze 60 serverů.
Během migrace rostlo porozumění, že ClickHouse — to je dobrý systém, se kterým je radost pracovat, ale je to interní projekt společnosti Yandex. Proto jsou zde nuance: Yandex se nejdříve zaměří na vlastní interní zákazníky a teprve poté — na komunitu a potřeby externích uživatelů, a ClickHouse tehdy nedosahoval úrovně enterprise v mnoha funkčních oblastech. Proto v březnu 2017 jsme založili firmu Altinity, abychom to udělali. ClickHouse ještě rychlejší a pohodlnější nejen pro Yandex, ale také pro ostatní uživatele. A nyní jsme:
- Vzděláváme a pomáháme vytvářet řešení na ClickHouse tak, aby zákazníci nenaráželi na problémy a aby řešení nakonec fungovalo;
- Zajišťujeme podporu 24/7 ClickHouse- instalací;
- Vyvíjíme vlastní ekosystémové projekty;
- Aktivně přispíváme k ClickHouse, reagujeme na požadavky uživatelů, kteří chtějí vidět určité funkce.
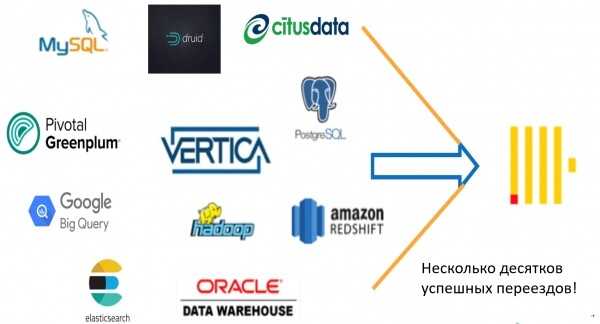
A samozřejmě, pomáháme s přechodem na ClickHouse s MySQL, Vertica, Oracle, Greenplum, Redshift a další systémy. Účastnili jsme se různých přechodů a všechny byly úspěšné.
Proč vůbec přecházet na ClickHouse
Nespomaluje! To je hlavní důvod. ClickHouse — velmi rychlá databáze pro různé scénáře:
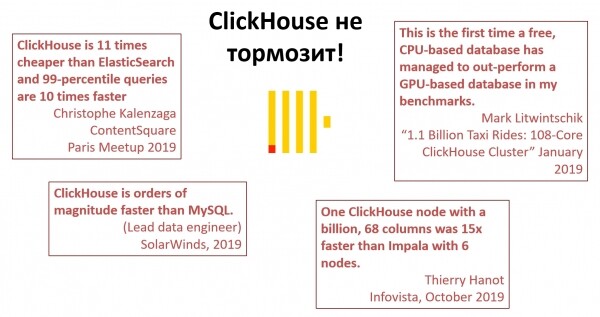
Náhodné citace lidí, kteří dlouho pracují s ClickHouse.
Škálovatelnost. Na nějaké jiné DB můžeš dosáhnout slušné výkonu na jednom hardwaru, ale ClickHouse můžeš škálovat nejen vertikálně, ale i horizontálně, jednoduše přidáním serverů. Všechno nefunguje tak hladce, jak bychom chtěli, ale funguje. Můžeš rozšiřovat systém spolu s růstem podnikání. Je důležité, že nejsme omezeni současným řešením a vždy existuje potenciál pro rozvoj.
Přenositelnost. Není vázána na něco jednoho. Například, s Amazon Redshift se těžko někam přestěhuje. A ClickHouse si můžeš nainstalovat na svůj notebook, server, nasadit do cloudu, přejít na Kubernetes — nejsou žádná omezení ohledně používání infrastruktury. To je výhodné pro všechny a je to velká výhoda, kterou nemohou nabídnout mnohé jiné podobné DB.
Flexibilita. ClickHouse se nezastavuje u něčeho jednoho, například u Yandex.Metriky, ale vyvíjí se a je využívána ve stále větším počtu různých projektů a odvětví. Můžeš ji rozšiřovat přidáváním nových funkcí pro řešení nových úloh. Například se považuje za nevhodné ukládat logy do DB, proto na to vymysleli Elasticsearch. Ale díky flexibilitě ClickHouse, v ní také můžeš ukládat logy a často je to dokonce lepší než v Elasticsearch — v ClickHouse to vyžaduje 10krát méně hardwaru.
Zdarma Open Source. Není třeba platit za nic. Není třeba se domlouvat na povolení nainstalovat systém na svůj notebook nebo server. Žádné skryté platby. Přitom žádná jiná technologie Open Source databází nemůže konkurovat rychlostí s ClickHouse. MySQL, MariaDB, Greenplum — všechny jsou mnohem pomalejší.
Komunita, podpora a zábava. U ClickHouse skvělé společenství: setkání, chaty a Alexej Milovidov, který nás všechny nabíjí svou energií a optimismem.
Přechod na ClickHouse
Abychom přešli na ClickHouse něco jiného, potřebujeme jen tři věci:
- Rozumět omezením ClickHouse a pro co není vhodný.
- Využít výhody technologie a její největší silné stránky.
- Experimentovat. I když rozumíme tomu, jak funguje ClickHouse, nemusíme vždy předvídat, kdy bude rychlejší, kdy pomalejší, kdy lepší a kdy horší. Takže to zkuste.
Problém s přechodem
Existuje jen jedno „ale“: pokud přecházíte na ClickHouse z něčeho jiného, obvykle něco nejde podle plánu. Jsme zvyklí na určité praktiky a věci, které fungují v naší oblíbené databázi. Například každý, kdo pracuje s SQL databázemi, považuje tento soubor funkcí za povinný:
- transakce;
- omezení;
- konzistence;
- indexy;
- UPDATE/DELETE;;
- NULL hodnoty;;
- milisekundy;
- automatické převody typů;
- vícenásobné spojení;
- libovolné partitioning;
- nástroje pro správu clusteru.
Sada je povinná, ale před třemi lety v ClickHouse nebyla ani jedna z těchto funkcí! Nyní z nerealizovaných funkcí zbývají méně než polovina: transakce, omezení, konzistence, milisekundy a převody typů.
A hlavně — to, že v ClickHouse některé standardní praktiky a přístupy nefungují nebo nefungují tak, jak jsme zvyklí. Všechno, co se objevuje v ClickHouse, odpovídá „ClickHouse way“, tj. funkce se liší od jiných databází. Například:
- Indexy nevybírají, ale přeskočí.
- UPDATE/DELETE; nejsou synchronní, ale asynchronní.
- Vícenásobné spojení existují, ale plánovač dotazů ne. Jak se pak vykonávají, není vůbec jasné lidem ze světa databází.
Scénáře ClickHouse
V roce 1960 americký matematik maďarského původu Wigner E. P. napsal článek „Nepochopitelná účinnost matematiky v přírodních vědách“ ("The unreasonable effectiveness of mathematics in the natural sciences") o tom, že okolní svět je podivně dobře popsán matematickými zákony. Matematika je abstraktní věda, a fyzikální zákony vyjádřené v matematické podobě nejsou triviální, a Wigner E. P. zdůraznil, že je to velmi podivné.
Z mého pohledu, ClickHouse — je to stejná podivnost. Parafrázováno Wignerem, lze říci toto: ohromující nepochopitelná účinnost ClickHouse v nejrůznějších analytických aplikacích!
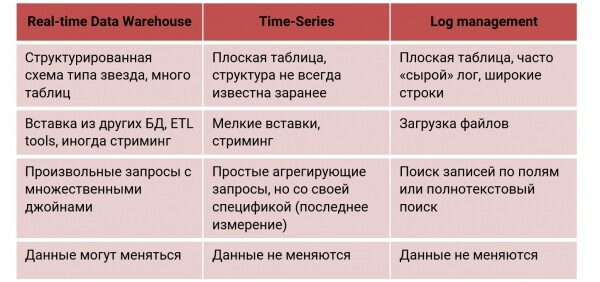
Například vezměme Real-Time Data Warehouse, do kterého se data načítají prakticky nepřetržitě. Chceme od něj přijímat požadavky s jednosekundovým zpožděním. Prosím — využijme ClickHouse, protože pro tento scénář byl také navržen. ClickHouse přesně tak se používá nejen na webu, ale také v marketingové a finanční analytice, AdTech, stejně jako v Fraud detection. V Real-time Data Warehouse se používá složitá strukturovaná schéma typu „hvězda“ nebo „sněhová vločka“, množství tabulek s JOIN (někdy vícero), a data se obvykle ukládají a mění v nějakých systémech.
Vezměme si jiný scénář — Time Series: monitorování zařízení, sítí, statistika využití, internet věcí. Zde se setkáváme s časově seřazenými dost jednoduchými událostmi. ClickHouse pro tento účel nebyl původně navržen, ale ukázal se dobře, a proto jej používají velké společnosti ClickHouse jako úložiště monitorovacích informací. Abychom zjistili, zda je ClickHouse pro time-series, provedli jsme benchmark na základě přístupu a výsledků InfluxDB a TimescaleDB — specializovaných time-series databází. , že ClickHouse, i bez optimalizace pro takové úkoly, vítězí a na cizím poli:
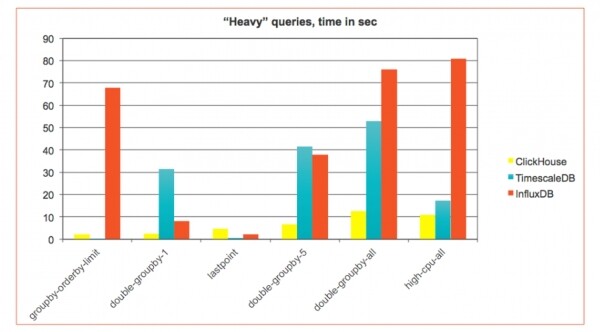
V time-series běžně se používá úzká tabulka — několik malých sloupců. Z monitorování může přicházet velmi mnoho dat, — miliony záznamů za sekundu, — a obvykle přicházejí malými vkládáními (real-time streamingem). Proto je potřeba jiný scénář vkládání, a samotné požadavky — se svojí určitou specifikací.
Log Management. Shromažďování logů do DB — to je obvykle špatně, ale v ClickHouse to lze provádět s určitými poznámkami, jak bylo uvedeno výše. Mnoho společností používá ClickHouse přesně pro to. V tomto případě se používá plochá široká tabulka, kde uchováváme logy celé (například ve formě JSON), nebo je nařezáváme na části. Data se obvykle načítají ve velkých dávkách (souborech), a hledáme podle nějakého pole.
Pro každou z těchto funkcí se obvykle používají specializované DB. ClickHouse jeden může dělat vše dobře, že je překonává v výkonu. Teď se podívejme na time-series scénář, a jak správně „připravit“ ClickHouse pro tento scénář.
Time-Series
V současnosti je to hlavní scénář, pro který ClickHouse se považuje za standardní řešení. Time-series — je soubor časově uspořádaných událostí, které reprezentují změny nějakého procesu v čase. Například to může být srdeční frekvence za den nebo počet procesů v systému. Všechno, co poskytuje časové tiky s nějakými měřeními – to je time-series:
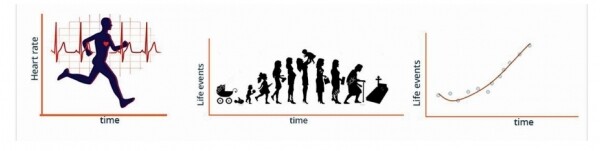
Nejvíce takovýchto událostí přichází z monitoringu. Může to být nejen monitoring webu, ale i skutečných zařízení: automobily, průmyslové systémy, IoT, výroby nebo autonomní taxi, do kufru kterých Yandex už teď pokládá ClickHouse-server.
Například existují společnosti, které sbírají data z lodí. Každých několik sekund senzory z kontejnerové lodi posílají stovky různých měření. Inženýři je zkoumají, staví modely a snaží se pochopit, jak efektivně je loď využívána, protože kontejnerová loď by neměla stát ani vteřinu. Každá prodleva je ztrátou peněz, proto je důležité předpovědět trasu tak, aby zastávky byly minimální.
Nyní je pozorován růst specializovaných databází, které měří time-series. Na webu DB-Engines jakým způsobem se různě databáze řadí, a lze je prohlížet podle typů:
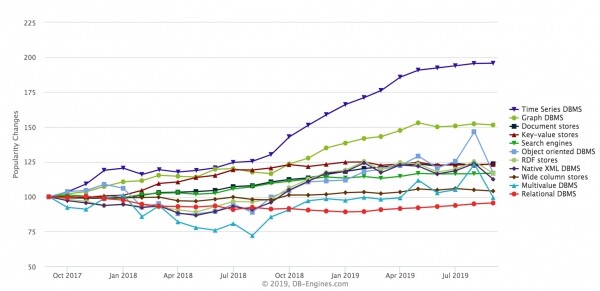
Nejrychleji rostoucí typ — časové řady.Rostou také grafové databáze, ale časové řady.časové řady rostou rychleji v posledních několika letech. Typickými zástupci databází této rodiny jsou InfluxDB, Prometheus, KDB, TimescaleDB (postavená na PostgreSQL), řešení od Amazon. ClickHouse se tu také může použít, a používá se. Uvedu několik veřejných příkladů.
Jedním z pionýrů je společnost CloudFlare (CDN-poskytovatel). Monitorují své CDN přes ClickHouse (. Vytvořte A-záznam blog a určete pro něj nějakou fiktivní IP (to je oficiální-požadavky, HTTP-požadavky) s ohromnou zátěží — 6 milionů událostí za sekundu. Všechno jde přes Kafka, odesílá se do ClickHouse, který poskytuje možnost v reálném čase vidět dashboardy událostí v systému.
Comcast — jeden z lídrů telekomunikací v USA: internet, digitální televize, telefonie. Vytvořili podobný systém řízení CDN v rámci Open Source projektem Apache Traffic Control pro práci se svými obrovskými daty. ClickHouse se používá jako backend pro analytiku.
Percona integrovala ClickHouse do svého PMM, aby uchovávala monitoring různých MySQL.
Specifické požadavky
Na časové databáze existují své specifické požadavky.
- Rychlé vložení z mnoha agentů.Musíme velmi rychle vložit data z mnoha toků. ClickHouse to dělá dobře, protože má všechny vkládání neblokující. Jakékoliv vložit — to je nový soubor na disku, a malé úryvky lze vyrovnávat různými způsoby. V ClickHouse lepší je vkládat data ve velkých balících, nikoli po jedné řádce.
- Flexibilní schéma. V time-series obyčejně neznáme strukturu dat do konce. Lze vytvořit monitorovací systém pro konkrétní aplikaci, ale pak je obtížné jej použít pro jinou aplikaci. K tomu je zapotřebí flexibilnější schéma. ClickHouse, což to umožňuje, i když se jedná o přísně typizovanou databázi.
- Efektivní ukládání a „zapomínání“ dat. Obvykle v time-series obrovském objemu dat, takže je třeba je ukládat co nejefektivněji. Například u InfluxDB dobrá komprese — to je jeho hlavní charakteristika. Kromě ukládání je také potřeba umět „zapomínat“ stará data a dělat nějaký downsampling — automatický výpočet agregátů.
- Rychlé dotazy na agregovaná data. Někdy je zajímavé podívat se na posledních 5 minut s přesností na milisekundy, ale u měsíčních dat minute nebo sekundová granularita nemusí být potřebná — stačí obecná statistika. Podpora tohoto typu je nezbytná, jinak se dotaz za 3 měsíce provede velmi dlouho i v ClickHouse.
- Dotazy typu „last point, as of». To jsou typické pro time-series dotazy: díváme se na poslední měření nebo stav systému v daném okamžiku t. Pro DB to nejsou příliš příjemné dotazy, ale musí se také umět vykonat.
- „Sestavování“ časových řad. Time-series — to je časová řada. Pokud existují dvě časové řady, často je třeba je spojovat a korelovat. Ne ve všech DB je to pohodlné provádět, zejména u nevyrovnaných časových řad: zde — jedny časové značky, tam — jiné. Lze počítat průměry, ale co když tam stejně bude mezera, takže není jasné.
Podívejme se, jak jsou tyto požadavky splněny v ClickHouse.
Schéma
V ClickHouse schéma pro time-series může být provedeno různými způsoby, v závislosti na míře pravidelnosti dat. Lze vytvořit systém na pravidelných datech, kdy vše metriky známe předem. Například to udělal CloudFlare s monitorováním CDN — to je dobře optimalizovaný systém. Můžeme vytvořit obecnější systém, který monitoruje celou infrastrukturu, různé služby. V případě nepravidelných dat nevíme předem, co monitorujeme — a pravděpodobně je to nejagresivnější běžný případ.
Pravidelná data. Sloupce. Schéma je jednoduché – sloupce s požadovanými typy:
VYTVÁŘEJTE TABULKU cpu (
  created_date Date DEFAULT today(),
  created_at DateTime DEFAULT now(),
  time String,
  tags_id UInt32,
  /* join to dim_tag */
  usage_user Float64,
  usage_system Float64,
  usage_idle Float64,
  usage_nice Float64,
  usage_iowait Float64,
  usage_irq Float64,
  usage_softirq Float64,
  usage_steal Float64,
  usage_guest Float64,
  usage_guest_nice Float64
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
To je běžná tabulka, která monitoruje nějakou aktivitu zatížení systému (uživatel, systém, nečinnost, nice). Je to jednoduché a pohodlné, ale ne flexibilní. Pokud chceme flexibilnější schéma, můžeme použít pole.
Neregulární data. Pole:
VYTVOŘTE TABULKU cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  )
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);

VYBERTE max(metrics.value[indexOf(metrics.name,'usage_user')]) Z ...
Struktura Vnořené — to jsou dvě pole: metrics.name a metrics.value. Zde je možné uchovávat taková libovolná monitorovací data, jako pole názvů a pole měření při každé události. Pro další optimalizaci místo jedné takové struktury lze vytvořit několik. Například jednu — pro float-hodnotu, druhou — pro int-hodnotu, protože int chceme uchovávat efektivněji.
Ale k takové struktuře je obtížnější přistupovat. Bude nutné použít speciální konstrukci, pomocí speciálních funkcí vyhledávat hodnoty nejprve podle indexu a poté pole:
VYBERTE max(metrics.value[indexOf(metrics.name,'usage_user')]) Z ...Ale to funguje stále dost rychle. Další způsob ukládání neregulárních dat – po řádcích.
Neregulární data. Řádky. V tomto tradičním způsobu bez polí jsou uchovávána hned názvy a hodnoty. Pokud z jednoho zařízení přichází hned 5 000 měření — generuje se 5 000 řádků v databázi:
VYTVOŘTE TABULKU cpu_rlc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metric_name LowCardinality(String),
  metric_value Float64
) ENGINE = MergeTree(created_date, (metric_name, tags_id, created_at), 8192);


VYBERTE
    maxIf(metric_value, metric_name = 'usage_user'),
    ...
Z cpu_r
KDE metric_name IN ('usage_user', ...)
ClickHouse s tím si poradí — má speciální rozšíření ClickHouse SQL. Například, maxIf — speciální funkce, která počítá maximum podle metriky při splnění nějaké podmínky. Můžete v jednom dotazu napsat několik takových výrazů a okamžitě spočítat hodnotu pro několik metrik.
Srovnejme tři přístupy:
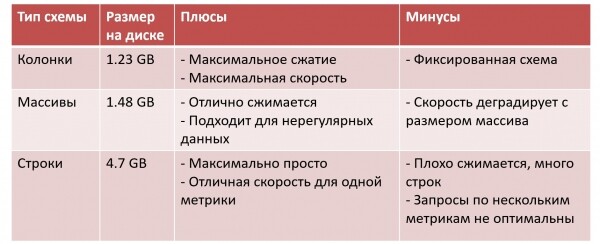
Zde jsem přidal „Velikost dat na disku“ pro konkrétní testovací datovou sadu. V případě sloupců máme nejmenší velikost dat: maximální kompresi, maximální rychlost dotazů, ale platíme tím, že musíme vše okamžitě zafixovat.
V případě polí je to o něco horší. Data se stále dobře komprimují a je možné uchovávat nepravidelnou schému. Ale ClickHouse — sloupcová databáze, a když začneme uchovávat všechno v poli, přechází na řádkovou a platíme za flexibilitu efektivitou. Na jakoukoli operaci je nutné přečíst celé pole do paměti, poté najít potřebný prvek — a pokud pole roste, rychlost se zhoršuje.
V jedné ze společností, která používá takový přístup (například, ), jsou pole rozdělována na kousky po 128 prvcích. Data několika tisíc metrik s objemem 200 TB dat/den nejsou uchovávána v jednom poli, ale ve 10 nebo 30 polích se speciální logikou pro ukládání.
Nejjednodušší přístup — se řetězci. Ale data se špatně komprimují, velikost tabulky je velká, a když dotazy probíhají přes několik metrik, ClickHouse pracuje neoptimálně.
Hybridní schéma
Předpokládejme, že jsme zvolili schéma s polem. Ale pokud víme, že většina našich dashboardů zobrazuje pouze metriky user a system, můžeme navíc na úrovni tabulky materializovat tyto metriky do sloupců následujícím způsobem:
CREATE TABLE cpu_alc (
  created_date Date,
  created_at DateTime,
  time String,
  tags_id UInt32,
  metrics Nested(
    name LowCardinality(String),
    value Float64
  ),
  usage_user Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_user')],
  usage_system Float64
             MATERIALIZED metrics.value[indexOf(metrics.name,'usage_system')]
) ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Při vkládání ClickHouse je automaticky spočítá. Takto lze kombinovat příjemné s užitečným: schéma je flexibilní a obecné, ale nejčastěji používané sloupce jsme získali. Upozorňuji, že to nevyžadovalo měnit vkládání a ETL, který stále vkládá do tabulky pole. Prostě jsme provedli ALTER TABLE, přidali pár sloupců a vytvořili hybridní a rychlejší schéma, které lze okamžitě začít používat.
Codecs a komprese
Pro time-series je důležité, jak dobře balíte data, protože pole informací může být velmi velké. V ClickHouse existuje sada nástrojů pro dosažení kompresního efektu 1:10, 1:20, a někdy i více. To znamená, že nekomprimovaná data o objemu 1 TB na disku zabírají 50-100 GB. Menší velikost je výhodná, data lze rychleji číst a zpracovávat.
Pro dosažení vysoké úrovně komprese, ClickHouse podporuje následující kodeky:
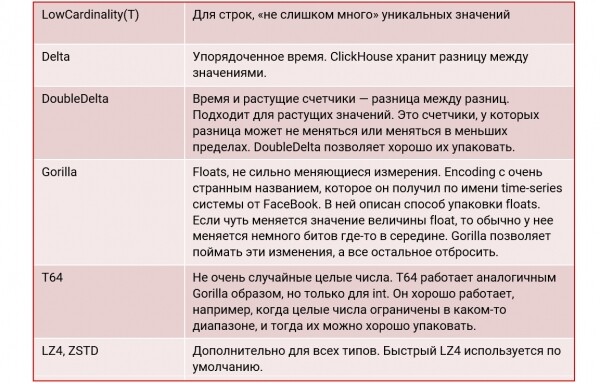
Příklad tabulky:
CREATE TABLE benchmark.cpu_codecs_lz4 (
    created_date Date DEFAULT today(),
    created_at DateTime DEFAULT now() Codec(DoubleDelta, LZ4),
    tags_id UInt32,
    usage_user Float64 Codec(Gorilla, LZ4),
    usage_system Float64 Codec(Gorilla, LZ4),
    usage_idle Float64 Codec(Gorilla, LZ4),
    usage_nice Float64 Codec(Gorilla, LZ4),
    usage_iowait Float64 Codec(Gorilla, LZ4),
    usage_irq Float64 Codec(Gorilla, LZ4),
    usage_softirq Float64 Codec(Gorilla, LZ4),
    usage_steal Float64 Codec(Gorilla, LZ4),
    usage_guest Float64 Codec(Gorilla, LZ4),
    usage_guest_nice Float64 Codec(Gorilla, LZ4),
    additional_tags String DEFAULT ''
)
ENGINE = MergeTree(created_date, (tags_id, created_at), 8192);
Zde definujeme kodek DoubleDelta v jednom případě, v druhém — Gorilla, a rozhodně přidáváme další LZ4 kompresi. V důsledku toho se velikost dat na disku výrazně snižuje:
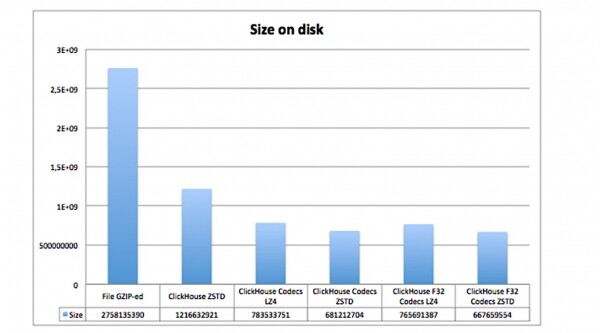
Zde je ukázáno, kolik místa zabírají stejná data, ale při použití různých kodeků a kompresí:
- v GZIPovaném souboru na disku;
- v ClickHouse bez kodeků, ale se ZSTD kompresí;
- v ClickHouse s kodeky a kompresí LZ4 a ZSTD.
Je zřejmé, že tabulky s kodeky zabírají mnohem méně místa.
Velikost má význam
Naprosto důležité je správný typ dat:
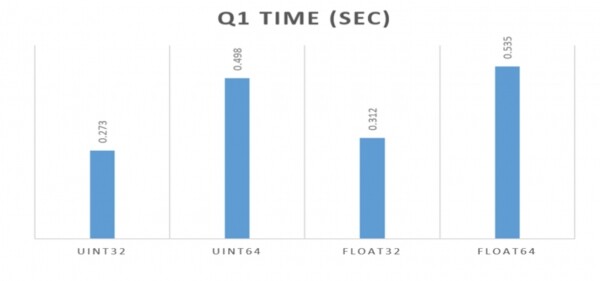
Ve všech příkladech výše jsem použil Float64. Ale kdybychom zvolili Float32, bylo by to dokonce lepší. To dobře ukázali kluci z Perkony v článku na výše uvedeném odkazu. Je důležité používat maximálně kompaktní typ, který je vhodný pro daný úkol: i v menší míře pro velikost na disku, spíš pro rychlost dotazů. ClickHouse je na to velmi citlivý.
Pokud můžete použít int32 místo int64, očekávejte téměř dvojnásobné zvýšení výkonu. Data zabírají méně paměti a veškerá „aritmetika“ funguje mnohem rychleji. ClickHouse uvnitř sebe — velmi přísně typizovaný systém, maximálně využívá všechny možnosti, které moderní systémy nabízejí.
Agregace a Materialized Views
Agregace a materializované pohledy umožňují vytvářet agregáty pro různé případy použití:
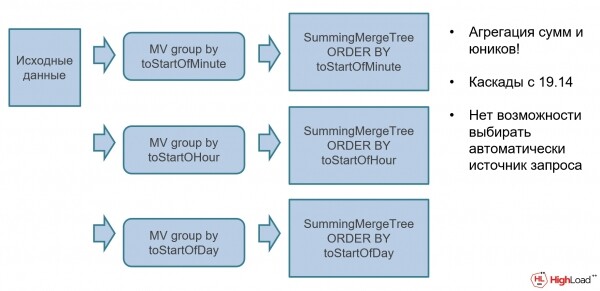
Například můžete mít neagregovaná původní data, na která lze aplikovat různá materializovaná zobrazení s automatickým souhrnováním prostřednictvím speciálního enginu. SummingMergeTree (SMT). SMT — je to speciální agregující datová struktura, která automaticky počítá agregáty. Do databáze se vkládají surová data, ta se automaticky agregují a ihned je lze používat pro dashboardy.
TTL — „zapomínáme“ na stará data
Jak „zapomínat“ na data, která již nejsou potřebná? ClickHouse umí to. Při vytváření tabulek lze určit TTL výrazy: například, že minutová data uchováváme jeden den, denní — 30 dní, a týdenní nebo měsíční nikdy nesmazáváme:
CREATE TABLE aggr_by_minute
…
TTL time + interval 1 day

CREATE TABLE aggr_by_day
…
TTL time + interval 30 day

CREATE TABLE aggr_by_week
…

/* no TTL */
Multi-tier — dělíme data podle disků
Rozvinutím této myšlenky lze uchovávat data v ClickHouse různých místech. Předpokládejme, že chceme uchovávat horká data za poslední týden na velmi rychlém lokálním SSD, a historická data skladujeme na jiném místě. V ClickHouse to je nyní možné:
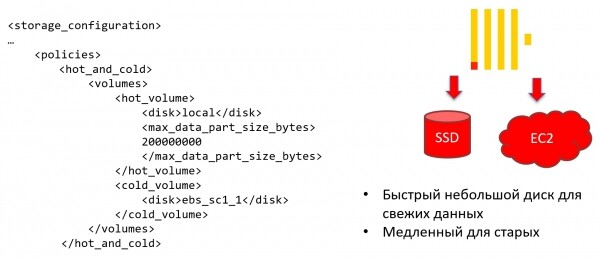
Lze konfigurovat politiku uchovávání (storage policy) tak, že ClickHouse se automaticky přesune do jiného úložiště při splnění určitých podmínek.
Ale to ještě není všechno. Na úrovni konkrétní tabulky lze definovat pravidla, kdy přesně data přecházejí do studeného úložiště. Například 7 dní data leží na velmi rychlém disku a vše, co je starší, se přesune na pomalejší. To je výhodné, protože umožňuje udržovat systém na maximálním výkonu, přičemž kontroluje náklady a neztrácí prostředky na studená data:
CREATE TABLE
...
TTL date + INTERVAL 7 DAY TO VOLUME 'cold_volume',
    date + INTERVAL 180 DAY DELETE
Unikátní možnosti ClickHouse
Téměř ve všem v ClickHouse existují takové „šťavnatosti“, ale ty se vyrovnávají exkluzivitou — tím, co není v jiných DB. Například, zde jsou některé z unikátních funkcí ClickHouse:
- Pole. V ClickHouse velmi dobrá podpora pro pole, stejně jako možnost provádět na nich složité výpočty.
- Agregující datové struktury. To je jedna z „killer feature“ ClickHouse. Přestože kluci z Yandexu říkají, že nechceme agregovat data, všichni agregují v ClickHouse, protože je to rychlé a pohodlné.
- Materializované pohledy. Společně s agregujícími datovými strukturami umožňují materializované pohledy pohodlnou real-time agregaci.
- ClickHouse SQL. Toto je rozšíření jazyka SQL s některými dodatečnými a exkluzivními funkcemi, které jsou pouze v ClickHouse. Dříve to bylo jakoby z jedné strany rozšíření, a z druhé strany – nedostatek. Nyní jsme téměř všechny nedostatky ve srovnání s SQL 92 odstranili, teď je to jen rozšíření.
- Lambda–výrazy. Existují snad ještě v nějaké jiné databázi?
- ML-podpora. To je v různých DB, v některých lépe, v některých hůře.
- Otevřený kód. Můžeme rozšiřovat ClickHouse spolu. Nyní je v ClickHouse přibližně 500 přispěvatelů, a toto číslo neustále roste.
Chytré dotazy
V ClickHouse existuje mnoho různých způsobů, jak udělat to samé. Například lze třemi různými způsoby vrátit poslední hodnotu z tabulky pro CPU (existuje ještě čtvrtý, ale ten je ještě exotičtější).
První ukazuje, jak pohodlné je to dělat v ClickHouse dotazech, když chcete zkontrolovat, zda n-tice se nachází v poddotazu. To je to, co mi osobně v jiných DB velmi chybělo. Pokud chci něco porovnat s poddotazem, tak v jiných DB mohu porovnávat pouze se skalárem, a pro více sloupců musím psát JOIN. V ClickHouse lze použít n-tici:
SELECT *
  FROM cpu
 WHERE (tags_id, created_at) IN
    (SELECT tags_id, max(created_at)
        FROM cpu
        GROUP BY tags_id)
Druhý způsob dělá totéž, ale používá agregační funkci argMax:
SELECT
    argMax(usage_user), created_at),
    argMax(usage_system), created_at),
...
 FROM cpu
V ClickHouse existuje několik desítek agregačních funkcí, a pokud použijete kombinátory, podle zákonů kombinatoriky jich bude přibližně tisíc. ArgMax – jedna z funkcí, která počítá maximální hodnotu: dotaz vrací hodnotu usage_user, při které je dosaženo maximální hodnoty created_at:
SELECT now() as created_at,
       cpu.*
  FROM (SELECT DISTINCT tags_id from cpu) base
  ASOF LEFT JOIN cpu USING (tags_id, created_at)
ASOF JOIN – „připojení“ řad s různými časovými údaji. To je unikátní funkce pro databáze, která existuje ještě pouze v kdb+. Pokud existují dva časové řady s různými časy, ASOF JOIN umožňuje je posunout a spojit v jednom dotazu. Pro každou hodnotu v jednom časovém řadu se najde nejbližší hodnota v druhém, a ty se vrátí na jednom řádku:
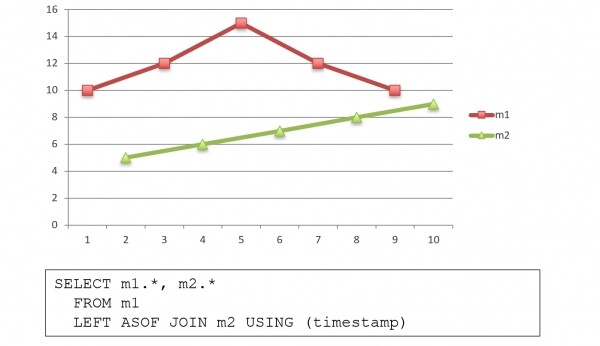
Analytické funkce
Ve standardu SQL-2003 to lze psát takto:
SELECT origin,
       timestamp,
       timestamp -LAG(timestamp, 1) OVER (PARTITION BY origin ORDER BY timestamp) AS duration,
       timestamp -MIN(timestamp) OVER (PARTITION BY origin ORDER BY timestamp) AS startseq_duration,
       ROW_NUMBER() OVER (PARTITION BY origin ORDER BY timestamp) AS sequence,
       COUNT() OVER (PARTITION BY origin ORDER BY timestamp) AS nb
  FROM mytable
ORDER BY origin, timestamp;
V ClickHouse tohle nelze — nepodporuje standard SQL-2003 a pravděpodobně to nikdy dělat nebude. Místo toho je ClickHouse obvyklé psát takto:
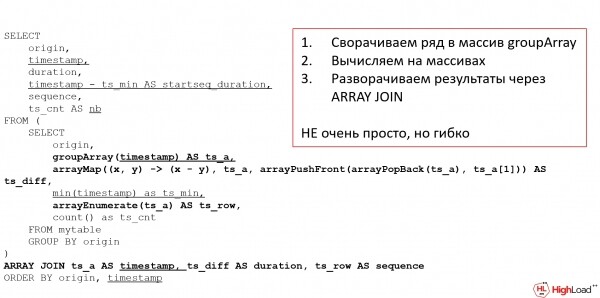
Sliboval jsem lambdy – tady jsou!
To je ekvivalent analytického dotazu ve standardu SQL-2003: počítá rozdíl mezi dvěma timestamp, duration, pořadové číslo — to vše, co obvykle považujeme za analytické funkce. V ClickHouse je považujeme za pole: nejprve shromáždíme data do pole, poté provedeme vše, co chceme, a pak je znovu rozbalíme. Není to moc pohodlné, vyžaduje to lásku k funkcionálnímu programování, ale je to velmi flexibilní.
Speciální funkce
Kromě toho v ClickHouse existuje mnoho specializovaných funkcí. Například, jak určit, kolik sezení probíhá současně? Typický úkol pro monitoring – zjistit maximální zatížení jedním dotazem. V ClickHouse existuje speciální funkce pro tento účel:
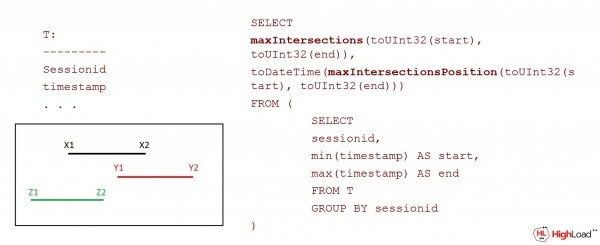
Vlastně, pro mnohé úkoly má ClickHouse speciální funkce:
- runningDifference, runningAccumulate, neighbor;
- sumMap(key, value);
- timeSeriesGroupSum(uid, timestamp, value);
- timeSeriesGroupRateSum(uid, timestamp, value);
- skewPop, skewSamp, kurtPop, kurtSamp;
- WITH FILL / WITH TIES;
- simpleLinearRegression, stochasticLinearRegression.
To není úplný seznam funkcí, jich je celkem 500-600. Tip: všechny funkce v ClickHouse jsou v systémové tabulce (ne všechny jsou zdokumentovány, ale všechny jsou zajímavé):
select * from system.functions order by nameClickHouse sama o sobě uchovává mnoho informací o sobě, včetně log tables, query_log, log sledování, log operací s bloky dat (part_log), log metrik a systémový log, který obvykle zapisuje na disk. Log metriky – to je time-series v ClickHouse ve skutečnosti ClickHouse: DB sama pro sebe může hrát roli time-series databází, tím „požírá“ sama sebe.
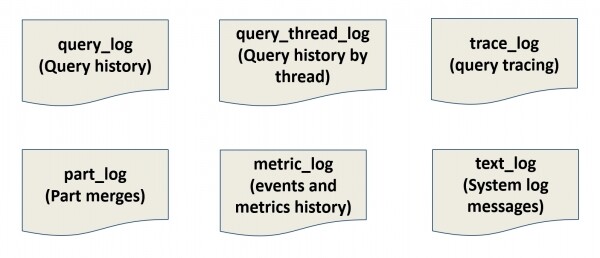
To je také unikátní věc — když jsme dobře udělali práci pro time-series, proč nemůžeme uchovávat vše, co potřebujeme, sami v sobě? Nepotřebujeme Prometheus, uchováváme vše v sobě. Připojili jsme Grafana a sami sebe monitorujeme. Pokud ale ClickHouse spadne, nevidíme, proč — proto se to obvykle nedělá.
Velký cluster nebo mnoho malých ClickHouse
Co je lepší — jeden velký cluster nebo mnoho malých ClickHouse? Tradiční přístup k DWH — to je velký cluster, ve kterém se vyčleňují schémata pro každou aplikaci. Přišli jsme za správcem databáze — dejte nám schéma, a dostali jsme ho:
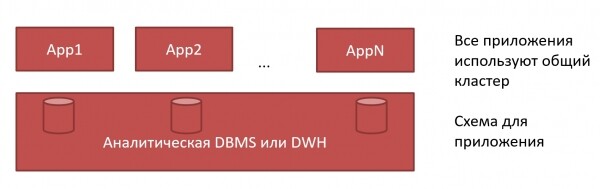
V ClickHouse můžeme to udělat jinak. Můžeme každé aplikaci dát její vlastní ClickHouse:
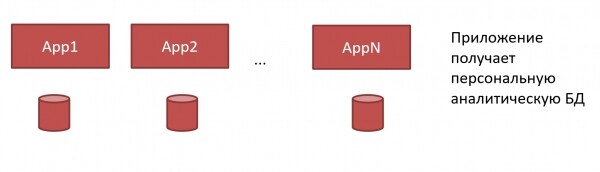
Už nepotřebujeme velký monstrózní DWH a neochotné administrátory. Můžeme každé aplikaci poskytnout její vlastní ClickHouse, a vývojář to může udělat sám, protože ClickHouse se velmi snadno instaluje a nevyžaduje složité administrace:
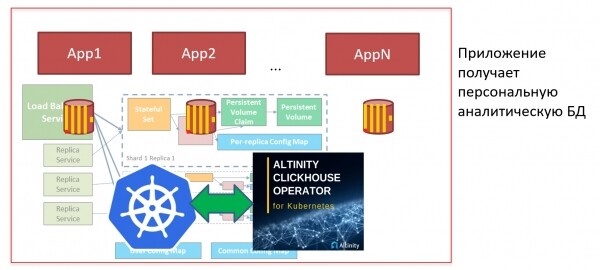
Ale pokud máme mnoho ClickHouse, a musíme to často instalovat, chceme tento proces automatizovat. K tomu můžeme například použít Kubernetes a ClickHouse-operátor. V Kubernetes ClickHouse můžeme nainstalovat „jedním kliknutím”: mohu stisknout tlačítko, spustit manifest a databáze je hotová. Můžeme okamžitě vytvořit schéma, začít do něj nahrávat metriky, a za 5 minut mám již připravený dashboard Grafana. Je to tak jednoduché!
Jaký je výsledek?
Takže, ClickHouse — to je:
- Rychle. To je všem známo.
- Jednoduše. Trochu sporné, ale já si myslím, že co se těžce učí, to se v boji snadno používá. Pokud pochopíte, jak ClickHouse funguje, dál je to velmi snadné.
- Univerzálně. Je vhodný pro různé scénáře: DWH, Time Series, Log Storage. Ale to není OLTP databáze, takže se nesnažte dělat krátké vkládání a čtení.
- Zajímavé. Pravděpodobně ten, kdo pracuje s ClickHouse, zažil mnoho zajímavých okamžiků ve dobrém i zlém smyslu. Například vyšel nový release, všechno přestalo fungovat. Nebo když jste se tři dny trápili s úkolem, ale po otázce v Telegram-chatu se úkol vyřešil za dvě minuty. Nebo jako na konferenci na přednášce Alexe Milovidova, screenshot z ClickHouse rozbil stream HighLoad++. Takové věci se dějí neustále a dělají náš život s ClickHouse živým a zajímavým!
Prezentaci si můžete prohlédnout .
Dlouho očekávané setkání vývojářů vysoce zatížených systémů na se uskuteční 9. a 10. listopadu ve Skolkově. Nakonec to bude offline konference (i když se všemi bezpečnostními opatřeními), protože energii HighLoad++ nelze zabalení do online.
Na konferenci představujeme a ukazujeme vám případy maximálních možností technologií: HighLoad++ byl, je a bude jediným místem, kde se během dvou dnů můžete dozvědět, jak fungují Facebook, Yandex, Vkontakte, Google a Amazon.
Od roku 2007 se naše setkání konají bez přerušení a tento rok se setkáme poprvé ve 14. ročníku. Během této doby konference vzrostla desetinásobně, v loňském roce klíčová událost v oboru přilákala 3339 účastníků, 165 řečníků a zároveň probíhalo 16 programových bloků.
V loňském roce pro vás bylo k dispozici 20 autobusů, 5280 litrů čaje a kávy, 1650 litrů ovocných nápojů a 10200 lahví vody. A navíc 2640 kilogramů jídla, 16000 talířů a 25000 pohárků. Mimochodem, za peníze získané z recyklovaného papíru jsme zasadili 100 sazenic dubů 🙂Vstupenky lze zakoupit , získat novinky o konferenci — , a promluvit si — na všech sociálních sítích: , , a .
Zdroj: habr.com
