

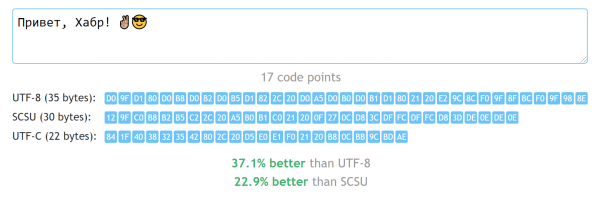
Pokud jste vývojář a máte za úkol vybrat kódování, téměř vždy bude správným řešením Unicode. Konkrétní způsob reprezentace závisí na kontextu, ale často je zde také univerzální odpověď — UTF-8. Je dobré tím, že umožňuje používat všechny znaky Unicode, aniž by to stálo příliš mnoho bajtů ve většině případů. Pravda, pro jazyky používající nejen latinku, "ne příliš mnoho" znamená minimálně dva bajty na znak. Lze to udělat lépe, aniž bychom se vraceli k prehistorickým kódováním, která nás omezují na pouhých 256 dostupných znaků?
Níže nabízím, abyste se seznámili s mým pokusem odpovědět na tuto otázku a realizovat poměrně jednoduchý algoritmus, který umožňuje ukládat řádky ve většině světových jazyků, aniž bychom přidávali tu nadbytečnost, která je v UTF-8.
Disklaimer. Hned udělám několik důležitých poznámek: popisované řešení není navrhováno jako univerzální náhrada za UTF-8, hodí se pouze pro úzký seznam případů (o nich níže) a rozhodně by se nemělo používat pro interakci se třetími API (které o něm ani nevědí). Nejčastěji pro kompaktní ukládání velkých objemů textových dat vyhovují algoritmy obecné komprese (například deflate). Kromě toho jsem již v procesu vytváření svého řešení našel existující standard v samotném Unicode, který řeší stejný problém — je o něco složitější (a často horší), ale přesto je přijatým standardem, nikoli zkolabovaným na koleně. O něm také budu hovořit.
O Unicode a UTF-8
Nejdříve — několik slov o tom, co vůbec je Unicode a UTF-8.
Jak víme, dříve měly popularitu 8bitové kódování. S nimi to bylo jednoduché: 256 znaků lze číslovat čísly od 0 do 255, a čísla od 0 do 255 jsou očividně reprezentovatelná v jednom bajtu. Pokud se vrátíme ke samým počátkům, kódování ASCII je omezeno na 7 bitů, a proto je nejvyšší bit v jeho bajtové reprezentaci roven nule, a většina 8bitových kódování je s ním kompatibilní (liší se pouze v "horní" části, kde je nejvyšší bit jedna).
Čím se tedy od těchto kódování liší Unicode a proč je s ním spojeno hned několik konkrétních reprezentací — UTF-8, UTF-16 (BE a LE), UTF-32? Probereme to postupně.
Základní standard Unicode popisuje pouze vztah mezi znaky (a v některých případech — jednotlivými komponenty znaků) a jejich čísly. A možných čísel v tomto standardu je velmi mnoho — od 0x00 do 0x10FFFF (1 114 112 kusů). Kdybychom chtěli umístit číslo v tomto rozsahu do proměnné, ani 1, ani 2 bajty by nám nestačily. A protože naše procesory nejsou příliš uzpůsobeny pro práci s tříbajtovými čísly, byli bychom nuceni použít celých 4 bajty na jeden znak! Tím je UTF-32, ale právě kvůli této "rozmařilosti" tento formát není populární.
Naštěstí jsou znaky v rámci Unicode uspořádány ne náhodně. Všechno jejich množství je rozděleno do 17 „plošin“, z nichž každá obsahuje 65536 (0x10000) «kódových bodů“. Pojem „kódový bod“ zde — to je jednoduše číslo znaku, které mu bylo přiřazeno Unicode. Ale, jak bylo řečeno výše, v Unicode jsou číslovány nejen jednotlivé znaky, ale také jejich komponenty a služební označení (a někdy číslo vůbec nic neodpovídá — možná dočasně, ale pro nás to není tak důležité), proto je správnější vždy mluvit právě o počtu samotných čísel, a ne znaků. Nicméně dále pro stručnost často budu používat slovo „znak“, kdy myslím termín „kódový bod“.
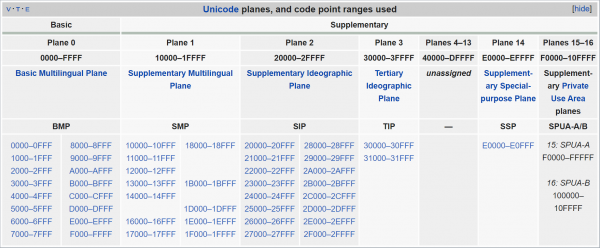
Plošiny Unicode. Jak je vidět, většina (plošiny 4 až 13) stále není využita.
Co je nejpozoruhodnější — celá hlavní „dužina“ leží v nulové plošině, ta se nazývá "Basic Multilingual Plane". Pokud řetězec obsahuje text v jedním z moderních jazyků (včetně čínštiny), mimo tuto plošinu se nedostanete. Ale omezovat zbytek Unicode také nelze — například emoji se většinou nacházejí na konci další plošiny, "Supplementary Multilingual Plane" (ta se rozprostírá od 0x10000 do 0x1FFFF). Proto UTF-16 postupuje takto: všechny znaky, které spadají do Basic Multilingual Plane, jsou kódovány „tak jak jsou“, odpovídajícím dvoubajtovým číslem. Nicméně část čísel v tomto rozsahu vůbec neoznačuje konkrétní znaky, ale naznačuje, že po tomto páru bajtů je potřeba zvážit ještě jeden — zkombinováním hodnot těchto čtyř bajtů dohromady dostaneme číslo, které pokrývá celý povolený rozsah Unicode. Tento způsob reprezentace se nazývá „surrogátní páry“ — možná jste o nich slyšeli.
UTF-16 tak vyžaduje dva nebo (ve velmi vzácných případech) čtyři bajty na jednu „kódovou bod“. To je lepší než neustále používat čtyři bajty, ale latinka (a jiné ASCII znaky) při tomto kódování spotřebovává polovinu místa na nuly. UTF-8 má tento problém napravit: ASCII v něm zůstává na jednom bajtu; kódy od 0x80 do 0x7FF — dvou bajtů; od 0x800 do 0xFFFF — tří, a od 0x10000 do 0x10FFFF — čtyř. Na jedné straně se latince daří dobře: vrací se kompatibilita s ASCII, a také rozdělení je více rovnoměrně „rozloženo“ od 1 do 4 bajtů. Ale abecedy, které nejsou latinské, bohužel nevyhrávají ve srovnání s UTF-16, a mnohé nyní vyžadují dokonce tři bajty místo dvou — rozsah pokrytý dvoubajtovým zápisem se zúžil 32krát, od 0xFFFF do 0x7FF, a již se tam nevejde ani čínský, ani například gruzínský. Cyrilici a ještě pěti abecedám — hurá — se podařilo, 2 bajty na znak.
Proč to tak je? Pojďme se podívat, jak UTF-8 představuje kódy znaků:
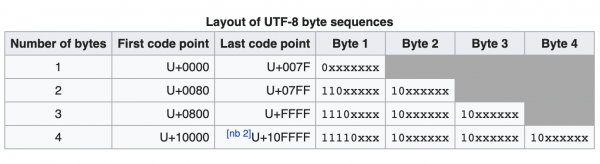
Přímo pro reprezentaci čísel se zde používají bity označené symbolem x. Je vidět, že v dvoubajtovém zápisu je takových bitů pouze 11 (ze 16). Vedoucí bity zde mají pouze služební funkci. V případě čtyřbajtového zápisu je dokonce pro číslo kódového bodu vyhrazeno 21 bitů ze 32 — zdálo by se, že by stačily i tři bajty (které dávají celkem 24 bitů), ale služební markery zabírají příliš mnoho.
Je to špatně? Opravitelně, ne příliš. Na jedné straně — pokud nám opravdu záleží na zabraném prostoru, máme algoritmy komprese, které snadno odstraní veškerou zbytečnou entropii a nadbytečnost. Na druhé — cílem Unicode bylo poskytnout co nejuniverzálnější kódování. Například řádek zakódovaný v UTF-8 můžeme svěřit kódu, který dříve pracoval pouze s ASCII, a nemusíme se bát, že tam uvidí znak z ASCII rozsahu, který tam ve skutečnosti není (vždyť v UTF-8 jsou všechny bajty začínající nulovým bitem právě ASCII). A pokud bychom se náhle chtěli zbavit malého ocásku velkého řetězce, aniž bychom ho dekódovali od začátku (nebo obnovili část informací po poškozené části) — není těžké najít to posunutí, kde začíná nějaký znak (stačí přeskočit bajty, které mají bitový prefix 10).
Proč tedy vymýšlet něco nového?
Souběžně se občas vyskytují situace, kdy algoritmy komprese jako deflate nejsou špatně použitelné, ale je třeba dosáhnout kompaktního uložení řetězců. Osobně jsem se s takovým úkolem setkal při úvahách o konstrukci pro velký slovník zahrnující slova v libovolných jazycích. Na jedné straně – každé slovo je velmi krátké, takže jeho komprese bude neefektivní. Na druhé straně – implementace stromu, kterou jsem zvažoval, byla navržena tak, že každý byte uloženého řetězce generoval samostatný uzel stromu, takže minimalizace jejich počtu byla velmi užitečná. V mé knihovně (stejně jako v , na kterém je založena) se podobný problém řeší jednoduše – řetězce uložené v -slovníku se zde uchovávají v . Jak však snadno pochopíte, to funguje pouze pro omezenou abecedu – řetězec v čínštině už do takového slovníku nelze vložit.
Zvlášť bych chtěl zdůraznit ještě jedno nepříjemné úskalí, které se objevuje při použití UTF-8 v takové datové struktuře. Na obrázku výše je vidět, že při zápisu symbolu ve formě dvou bytů nejsou bity, které se vztahují k jeho číslu, za sebou, ale jsou přerušeny dvojicí bitů 10 uprostřed: 110xxxxx 10xxxxxx. V důsledku toho, když v kódu symbolu přeplníme mladších 6 bitů druhého bytu (tj. dochází k přechodu 10111111 → 10000000), změní se i první byte. Tak se písmeno „п“ označuje byty 0xD0 0xBF, a to následné „р“ – už 0xD1 0x80. V prefixovém stromu to vede k rozdělení rodičovského uzlu na dva – jeden pro prefix 0xD0, a druhý pro 0xD1 (i když by celá cyrilika mohla být kódována pouze druhým bytem).
Co se mi podařilo
Když jsem se s tímto úkolem setkal, rozhodl jsem se procvičit si hru s bity a zároveň se blíže seznámit se strukturou Unicode jako takové. Výsledkem byl kódovací formát UTF-C („C“ znamená kompaktní), který spotřebovává maximálně 3 byty na jeden kódový bod, a velmi často umožňuje ušetřit pouze jeden další byte na celý kódovaný řetězec. To má za následek, že v mnoha ne-ASCII abecedách je toto kódování o 30-60% kompaktnější než UTF-8.
Připravil jsem příklady implementace algoritmů kódování a dekódování ve formě , můžete je volně používat ve svém kódu. Ale přesto zdůrazňuji, že v určitém smyslu zůstává tento formát „kola“, a nedoporučuji ho používat bez povědomí o tom, proč ho potřebujete. Je to přece více experiment než vážné „vylepšení UTF-8“. Nicméně je kód napsán pečlivě, stručně, s velkým množstvím komentářů a pokrytím testy.
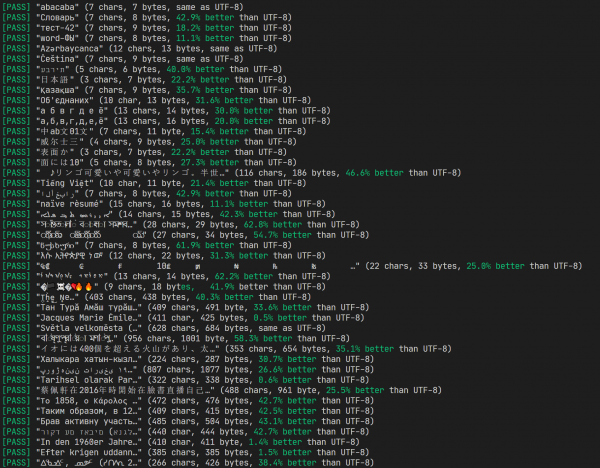
Výsledek testů a srovnání s UTF-8
Také jsem vytvořil , kde si můžete vyzkoušet fungování algoritmu, a dále vám podrobněji popíšu jeho principy a proces vývoje.
Odstraňujeme nadbytečné bity
Jako základ jsem vzal samozřejmě UTF-8. První a nejzřejmější věcí, kterou můžete změnit, je snížit počet ovládacích bitů v každém bajtu. Například, první bajt v UTF-8 vždy začíná buď 0, nebo s 11 — a prefix 10 je pouze u následujících bajtů. Nahradíme prefix 11 na 1, a u následujících bajtů úplně odstraníme prefixy. Co se stane?
0xxxxxxx — 1 bajt
10xxxxxx xxxxxxxx — 2 bajty
110xxxxx xxxxxxxx xxxxxxxx — 3 bajty
Stop, kde je čtyřbajtová zápis? Ta se stala zbytečnou — při zápisu třemi bajty máme nyní k dispozici 21 bitů a to stačí na všechna čísla až 0x10FFFF.
Čím jsme tu obětovali? Nejdůležitější je zjištění hranic symbolů z libovolného místa v bufferu. Nemůžeme se prostě vybrat náhodný bajt a od něj najít začátek dalšího symbolu. To je omezení našeho formátu, ale v praxi se tou potřebou setkáváme zřídka. Obvykle můžeme proběhnout buffer od začátku (zejména když jde o krátké řetězce).
Situace s pokrytím jazyků 2 bajty se také zlepšila: nyní dvoubajtový formát poskytuje rozsah 14 bitů, což odpovídá kódům až 0x3FFF. Číňané to mají těžké (jejich znaky leží převážně v rozmezí od 0x4E00 do 0x9FFF), ale Gruzínci a mnoho dalších národů mají nyní více radosti — jejich jazyky se vejdou do 2 bytů na symbol.
Zavádíme stav kódovače
Nyní si promyslíme vlastnosti samotných řetězců. Ve slovníku se většinou nacházejí slova napsaná symboly jedné abecedy, a to platí i pro mnoho dalších textů. Bylo by dobré jednou zadat tuto abecedu a poté uvádět pouze číslo písmene uvnitř ní. Podívejme se, jestli nám uspořádání symbolů v tabulce Unicode pomůže.
Jak bylo uvedeno výše, Unicode je rozdělen na plochy po 65536 kódů každý. Ale to není příliš užitečné dělení (jak již bylo řečeno, většinou se nacházíme v nulové rovině). Zajímavější je dělení na bloky. Tyto rozsahy již nemají pevnou délku a nesou větší smysl — obvykle každý sdružuje znaky jednoho abecedy.
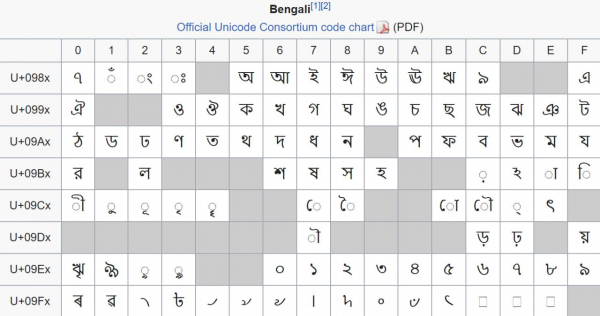
Blok obsahující znaky bengálské abecedy. Bohužel, z historických důvodů, je to příklad ne příliš hustého balení — 96 znaků je chaoticky rozptýleno po 128 kódových bodech bloku.
Začátky bloků a jejich velikosti jsou vždy násobky 16 — je to uděláno prostě pro pohodlí. Kromě toho mnoho bloků začíná a končí na hodnotách, které jsou násobky 128 nebo dokonce 256 — například, hlavní cyrilice zabírá 256 bytů od 0x0400 do 0x04FF. To je docela pohodlné: pokud jednou uložíme prefix 0x04, pak jakýkoliv cyrilský znak lze zapsat jedním bytem. Pravda, tak ztratíme možnost vrátit se k ASCII (a k jakýmkoliv jiným znakům vůbec). Proto to děláme takto:
- Dva byty
10yyyyyy yxxxxxxxnejenže označují znak s číslemyyyyyy yxxxxxxx, ale také mění aktuální abecedu nayyyyyy y0000000tj. zapamatujeme si všechny bity, kromě nejnižších 7 bit); - Jeden byt
0xxxxxxxto je znak aktuální abecedy. Jeho je potřeba jednoduše sečíst s tím posunem, který jsme si zapamatovali v kroku 1. Dokud jsme abecedu nezměnili, posun je roven nule, takže jsme zachovali kompatibilitu s ASCII.
Analogicky pro kódy, které vyžadují 3 byty:
- Tři byty
110yyyyy yxxxxxxx xxxxxxxxoznačují znak s číslemyyyyyy yxxxxxxx xxxxxxxx, mění aktuální abecedu nayyyyyy y0000000 00000000zapamatovali jsme si všechno kromě nejnižších 15 bit), a nastavují příznak, že jsme nyní v dlouhém režimu (při změně abecedy zpět na dvoubajtový tento příznak resetujeme); - Dva byty
0xxxxxxx xxxxxxxxv dlouhém režimu to je znak aktuální abecedy. Analogicky, sečítáme ho s posunem z kroku 1. Celý rozdíl je jen v tom, že nyní čteme po dvou bytech (protože jsme přešli do takového režimu).
Zní to dobře: nyní, dokud potřebujeme kódovat znaky z jednoho a téhož 7-bitového rozsahu Unicode, utrácíme 1 přebytečný byt na začátku a jen po jednom bytu na každý znak.
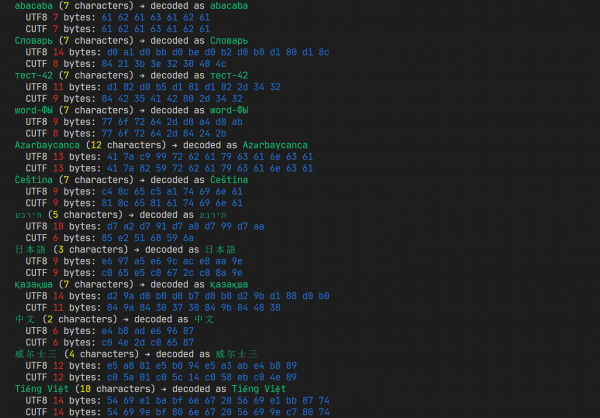
Práce jedné z raných verzí. Již často obchází UTF-8, ale stále je co zlepšovat.
Co se stalo hůře? Především, máme stav, a to konkrétně posun aktuální abecedy a příznak dlouhého režimu. To nás navíc omezuje: nyní mohou být stejné znaky zakódovány odlišně v různých kontextech. Hledání podřetězců, například, bude muset brát toto v úvahu místo pouhého porovnávání bytů. Za druhé, jakmile jsme změnili abecedu, došlo k problémům s kódováním ASCII znaků (a to zahrnuje nejen latinskou abecedu, ale i základní interpunkci, včetně mezer) — ty vyžadují změnu abecedy do 0, tedy opět zbytečný byte (a poté ještě jeden, abychom se vrátili k naší hlavní).
Jedna abeceda je dobrá, dvě jsou lepší.
Zkusíme trochu změnit naše bitové prefixy tím, že k třem výše zmíněným přidáme ještě jeden:
0xxxxxxx — 1 byte v běžném režimu, 2 v dlouhém.
11xxxxxx — 1 bajt
100xxxxx xxxxxxxx — 2 bajty
101xxxxx xxxxxxxx xxxxxxxx — 3 bajty
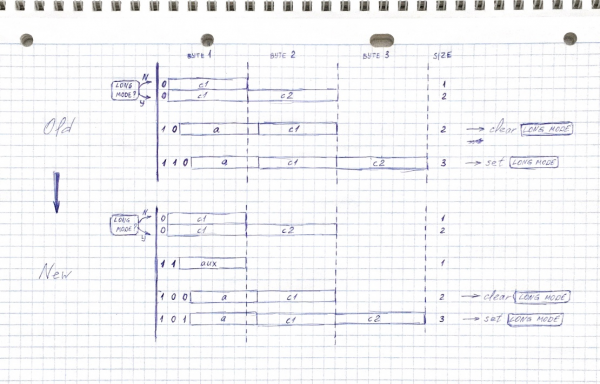
Nyní v dvoubajtovém zápisu k dispozici o jeden bit méně — kódové body se vejdou až do 0x1FFF, a ne 0x3FFF. I když je to stále výrazně víc než u dvoubajtových kódů UTF-8, většina běžných jazyků se stále vejde, nejvýraznější ztráta — vypadla a , Japonci jsou smutní.
Co to je za nový kód 11xxxxxx? Это небольшой «загашник» размером в 64 символа, он дополняет наш основной алфавит, поэтому я назвал его вспомогательным (auxiliary) abecedou. Když přepneme současnou abecedu, kus staré abecedy se stane pomocnou. Například, přešli jsme z ASCII na cyrilici — v „záloze“ je nyní 64 znaků, které obsahují latinku, čísla, mezeru a čárku (nejčastější prvky v ne-ASCII textech). Přepnuli jsme se zpět na ASCII — a pomocnou abecedou se stane hlavní část cyrilice.
Díky přístupu k dvěma abecedám můžeme zpracovat velké množství textů s minimálními náklady na přepínání abeced (interpunkce většinou povede k návratu do ASCII, ale poté mnohé ne-ASCII znaky již vyjmeme z doplňkové abecedy, bez opětovného přepínání).
Bonus: označením doplňkové abecedy prefixem 11xxxxxx a výběrem jejího počátečního posunutí rovného 0xC0, dostaneme částečnou kompatibilitu s CP1252. Jinými slovy, mnohé (ale ne všechny) západoevropské texty zakódované v CP1252 budou vypadat stejně i v UTF-C.
Zde však vzniká problém: jak získat pomocnou abecedu z hlavní? Můžeme nechat stejné posunutí, ale — bohužel — zde už struktura Unicode hraje proti nám. Velmi často se hlavní část abecedy nenachází na začátku bloku (například ruské velké písmeno „A“ má kód 0x0410, zatímco Kyrilická blok začíná na 0x0400). Takto, vezmeme-li do „úložiště“ prvních 64 znaků, můžeme potenciálně ztratit přístup k zadní části abecedy.
Abych tento problém vyřešil, ručně jsem procházel některé bloky odpovídající různým jazykům a uvedl jsem pro ně posunutí pomocného abecedy uvnitř hlavního. Latinku jsem, z výjimky, zcela přeuspořádal obdobně jako base64.
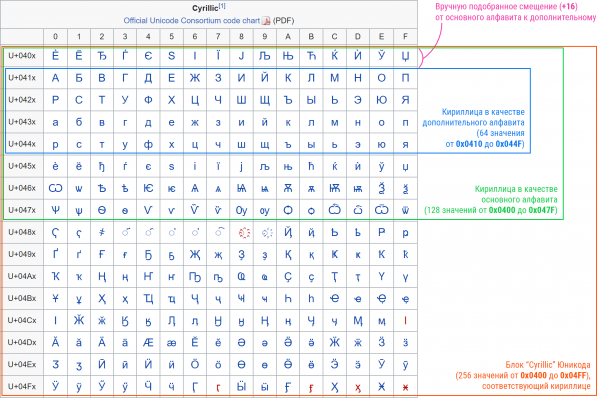
Finální úpravy
Pojďme na závěr popřemýšlet, kde ještě můžeme něco vylepšit.
Všimněme si, že formát 101xxxxx xxxxxxxx xxxxxxxx umožňuje kódovat čísla až do 0x1FFFFF, ale Unicode končí dříve, na 0x10FFFF. Jinými slovy, poslední kódový bod bude vyjádřen jako 10110000 11111111 11111111. Tedy můžeme říci, že pokud první bajt má podobu 1011xxxx (kde xxxx více než 0), pak znamená něco jiného. Například bychom mohli přidat ještě 15 znaků, trvale dostupných pro kódování jedním bajtem, ale rozhodl jsem se jednat jinak.
Podívejme se na ty bloky Unicode, které v současnosti vyžadují tři bajty. Většinou, jak již bylo zmíněno, jsou to čínské znaky – ale s nimi se těžko něco dělá, je jich 21 tisíc. Ale také sem spadá hiragana a katakana – a těch už není tolik, méně než dvě stovky. A pokud jsme vzpomněli na Japonce – tam leží také emoji (ve skutečnosti jsou rozptýlená po celém Unicode, ale hlavní bloky jsou v rozsahu 0x1F300 – 0x1FBFF). Pokud si uvědomíme, že nyní existují emoji, které se skládají z několika kódových bodů (například emoji se skládá z 7 kódů!), pak je opravdu škoda strávit tři bajty na každé (7×3 = 21 bajtů za jeden znak, to je šílenství).
Proto vybíráme několik vybraných rozsahů odpovídajících emoji, hiraganě a katakaně, přenumerováváme je do jednoho nepřetržitého seznamu a kódujeme jako dva bajty místo tří:
1011xxxx xxxxxxxx
Skvělé: výše zmíněné emoji , složené ze 7 kódových bodů, v UTF-8 zabírá 25 bajtů, ale my jsme ho vešli do 14 přesně dva bajty na každý kódový bod). Mimochodem, Habr odmítl jej zpracovat (jak ve starém, tak v novém editoru), takže jsem musel vložit jeho obrázkem.
Zkusíme opravit ještě jeden problém. Jak víme, hlavní abeceda je vlastně vyšších 6 bitů, které máme v paměti, a přilepíme kód k každému dalšímu dekódovanému znaku. Co se týče čínských znaků, které jsou v bloku 0x4E00 – 0x9FFF, to je buď bit 0, nebo 1. To není příliš pohodlné: budeme muset neustále přepínat abecedu mezi těmito dvěma hodnotami (tj. utrácet tři bajty). Ale všimněte si, že v dlouhém režimu můžeme z kódu odečíst počet znaků, které kódujeme pomocí krátkého režimu (po všech výše uvedených kličkách je to 10240) — pak se rozsah znaků posune k 0x2600 – 0x77FF, a v tomto případě budou v celém tomto rozsahu nejvyšší 4 bity (z 21) rovny 0. Takto budou sekvence znaků používat dva bajty na znak (což je optimální pro tak velký rozsah), aniž by docházelo k přepínání abecedy.
Alternativní řešení: SCSU, BOCU-1
Znalci Unicode, již po přečtení názvu článku, pravděpodobně, spěchají připomenout, že přímo mezi standardy Unicode existuje (SCSU), který popisuje způsob kódování velmi podobný tomu, který je popsán v článku.
Musím upřímně přiznat: o jeho existenci jsem se dozvěděl až poté, co jsem se hluboce ponořil do psaní svého řešení. Kdybych o něm věděl od začátku, pravděpodobně bych se pokusil napsat jeho implementaci místo vymýšlení vlastního přístupu.
Co je zajímavé, SCSU používá myšlenky, které jsou velmi podobné těm, které jsem vyvinul nezávisle (namísto pojmu „abecedy“ se používají „okna“, a těch je k dispozici více než u mě). Současně má tento formát také nevýhody: je trochu blíže k algoritmům komprese než kódování. Konkrétně standard poskytuje řadu způsobů reprezentace, ale neříká, jak vybrat z nich optimální — encoder musí aplikovat nějaké heuristiky. Takže SCSU-encoder, který poskytuje dobrou kompresi, bude složitější a objemnější než můj algoritmus.
Pro srovnání jsem přenesl relativně jednoduchou implementaci SCSU na JavaScript — objem kódu se ukázal jako srovnatelný s mým UTF-C, ale v některých případech vykázal výsledky o desítky procent horší (někdy může dokonce překonat, ale ne o moc). Například texty v hebrejštině a řečtině UTF-C zakódoval až o 60 % lépe než SCSU (pravděpodobně díky jejich kompaktním abecedám).
Dále dodávám, že kromě SCSU existuje také jiný způsob kompaktního zobrazení Unicode — , ale jeho cílem je zajistit kompatibilitu s MIME (což jsem nepotřeboval) a používá poněkud jiný přístup k kódování. Jeho efektivitu jsem nehodnotil, ale mám pocit, že nebude vyšší než SCSU.
Možné vylepšení
Již zmíněný algoritmus není univerzální kvůli designu (zde se mé cíle pravděpodobně nejvíce rozcházejí s cíli konsorcia Unicode). Již jsem zmínil, že byl vyvíjen převážně pro jeden úkol (ukládání víc jazykového slovníku v prefixovém stromu) a některé jeho rysy se nemusí hodit pro jiné úkoly. Ale to, že není standardem, může být i výhodou — můžete jej snadno přizpůsobit svým potřebám.
Například lze očividně odstranit přítomnost stavu, udělat kódování stateless — prostě neaktualizovat proměnné odpisy, výpadek a is21Bit v enkodéru a dekodéru. V takovém případě nebude možné efektivně komprimovat sekvence znaků jednoho abecedy, ale zaručí se, že stejný znak bude vždy kódován stejnými bajty, bez ohledu na kontext.
Kromě toho lze kódovač zaměřit na konkrétní jazyk, změnit výchozí stav — například při zaměření na ruské texty nastavit na začátku enkodéru a dekodéru offs = 0x0400 a auxOffs = 0. To dává smysl zejména v režimu stateless. Celkově to bude podobné použití starého osmitbitového kódování, jen to nezbavuje možnosti vkládat znaky z celého Unicode podle potřeby.
Další nevýhoda, kterou jsem již zmínil — v objemovém textu kódovaném v UTF-C neexistuje rychlý způsob, jak najít hranici znaku blízkého k libovolnému bajtu. Pokud od kódovaného bufferu odříznete posledních, řekněme, 100 bajtů, riskujete získání odpadu, se kterým nic neuděláte. Kódování není určeno pro ukládání víc než několika gigabajtových logů, ale to lze obecně opravit. Bajt 0xBF by nikdy neměl být prvním bajtem (ale může být druhým nebo třetím). Proto lze při kódování vkládat sekvenci 0xBF 0xBF 0xBF každých, dejme tomu, 10 Kb — pak při potřebě nalezení hranice stačí proscanovat vybraný úsek, dokud nenajdete podobný marker. Po posledním 0xBF zaručeně bude začátek znaku. (Při dekódování tuto sekvenci tří bytů, samozřejmě, je třeba ignorovat.)
Shrnutí
Pokud jste dočetli až sem — blahopřeji! Doufám, že jste, stejně jako já, získali nové znalosti (nebo si osvěžili vzpomínky) o fungování Unicode.
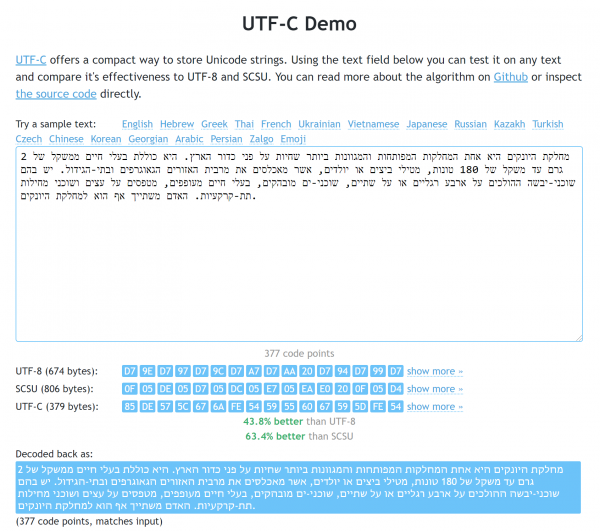
Demonstrační stránka. Na příkladu hebrejštiny jsou vidět výhody jak před UTF-8, tak před SCSU.
Není nutné považovat výše uvedené úvahy za zásah do standardů. Nicméně jsem celkově spokojen s výsledky své práce, a proto se s nimi rád : například, JS knihovna v minifikované podobě váží pouhých 1710 bytů (a nemá žádné závislosti, samozřejmě). Jak jsem zmínil výše, s jejím fungováním se můžete seznámit na (tam je také soubor textů, na kterých ji můžete porovnat s UTF-8 a SCSU).
Nakonec ještě jednou upozorním na případy, ve kterých používat UTF-C No.:
- Pokud jsou vaše řetězce dostatečně dlouhé (od 100-200 znaků). V takovém případě byste měli uvažovat o využití kompresních algoritmů jako je deflate.
- Pokud potřebujete ASCII transparentnost, tedy vám záleží na tom, aby v zakódovaných sekvencích nevznikaly ASCII kódy, které nebyly v původním řetězci. Tento požadavek se dá předejít, pokud při interakci s externími API (například při práci s databází) budete předávat výsledek kódování jako abstraktní sadu bytů, a ne jako řetězce. Jinak riskujete nečekané zranitelnosti.
- Pokud chcete mít možnost rychle najít hranice znaků podle libovolného posunu (například při poškození části řetězce). To lze udělat, ale pouze skenováním řetězce od začátku (nebo použitím úpravy popsané v předchozí části).
- Pokud potřebujete rychle provádět operace na obsahu řetězců (třídit je, hledat v nich podřetězce, konkatenovat). Pro to je potřeba řetězce nejprve dekódovat, takže UTF-C bude v těchto případech pomalejší než UTF-8 (ale rychlejší než kompresní algoritmy). Protože stejný řetězec je vždy kódován stejným způsobem, přesné srovnání dekódování není nutné, lze je provádět po bytech.
Update: uživateli vyvěsil graf, který zdůrazňuje hranici použitelnosti UTF-C. Na něm lze vidět, že UTF-C je efektivnější než algoritmus pro všeobecné použití (varianty LZW), dokud je balený řetězec kratší ~140 znaků (pravda, poznamenám, že srovnání bylo provedeno na jednom textu; pro jiné jazyky se výsledky mohou lišit).
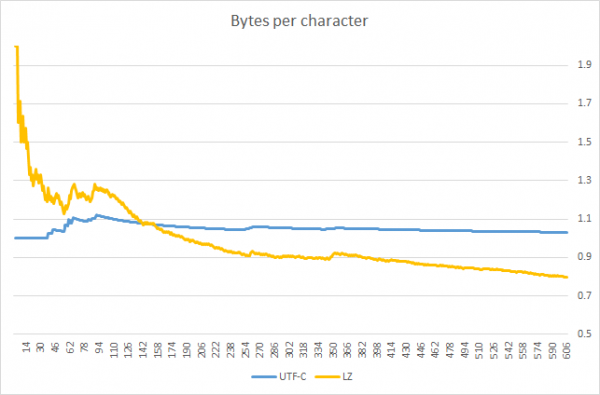
Zdroj: habr.com
