

Vysoký výkon je jednou z klíčových požadavků při práci s velkými daty. V oblasti správy datových toků ve Sberbank se zabýváme zpracováním prakticky všech transakcí do našeho cloudového úložiště na bázi Hadoop, a proto pracujeme s opravdu velkými objemy informací. Přirozeně, neustále hledáme způsoby, jak zlepšit výkon, a nyní bychom chtěli sdílet, jak se nám podařilo upravit RegionServer HBase a HDFS klienta, což vedlo ke značnému zvýšení rychlosti operací čtení.
Než se však pustíme do samotných úprav, je dobré zmínit omezení, kterým se v zásadě nelze vyhnout, pokud pracujete s HDD.
Proč jsou HDD a rychlé náhodné čtení neslučitelné
Jak je známo, HBase a mnoho dalších databází ukládá data po blocích o velikosti několika desítek kilobajtů. Obyčejně je to kolem 64 KB. Představme si nyní, že potřebujeme získat pouze 100 bajtů a žádáme HBase, aby nám poskytla tato data na základě nějakého klíče. Vzhledem k tomu, že velikost bloku v HFiles je 64 KB, bude požadováno 640krát více (mimochodem!) než je potřeba.
Dále, protože požadavek půjde přes HDFS a jeho mechanismus cachování metadat ShortCircuitCache (který umožňuje přímý přístup k souborům), dochází k načítání již 1 MB z disku. To však lze regulovat parametrem dfs.client.read.shortcircuit.buffer.size a v mnoha případech dává smysl tuto hodnotu snížit, například na 126 KB.
Představme si, že to uděláme, ale navíc, když začneme číst data přes java API, pomocí funkcí jako FileChannel.read, a žádáme operační systém o přečtení určitého objemu dat, načítá "pro jistotu" dvojnásobek, t.j. 256 KB v našem případě. To se děje, protože v Javě neexistuje jednoduchá možnost nastavit příznak FADV_RANDOM, který by takovému chování zabránil.
Nakonec, abychom získali naše 100 bajtů, je v pozadí načítáno 2600krát více. Mohlo by se zdát, že řešení je zřejmé, pojďme snížit velikost bloku na kilobajt, nastavíme zmíněný příznak a dosáhneme velkého zrychlení. Problém však je, že snížením velikosti bloku na polovinu rovněž snižujeme množství načítaných bajtů za jednotku času také na polovinu.
Nějaké výhody z nastavení flagu FADV_RANDOM lze získat, ale pouze při vysoké vícevláknovosti a při velikosti bloku od 128 kB, což je maximálně pár desítek procent:
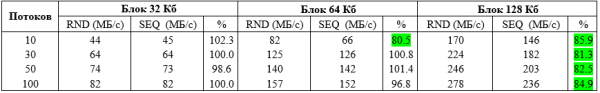
Testy byly prováděny na 100 souborech, každém o velikosti 1 GB, uložených na 10 discích HDD.
Pojďme spočítat, na co se s takovou rychlostí vlastně můžeme spolehnout:
Předpokládejme, že čteme z 10 disků rychlostí 280 MB/s, tedy 3 miliony krát po 100 bytech. Ale jak si pamatujeme, potřebná data se vyskytují 2600krát méně než přečtená. Takže 3 miliony dělíme 2600 a dostáváme 1100 záznamů za sekundu.
Zklamání, že? Taková je povaha náhodného přístupu k datům na HDD — bez ohledu na velikost bloku. To je fyzický limit náhodného přístupu a většího za těchto podmínek žádná databáze nevytáhne.
Jak tedy databáze dosahují mnohem vyšší rychlosti? Abychom na tuto otázku odpověděli, podívejme se, co se děje na následujícím obrázku:
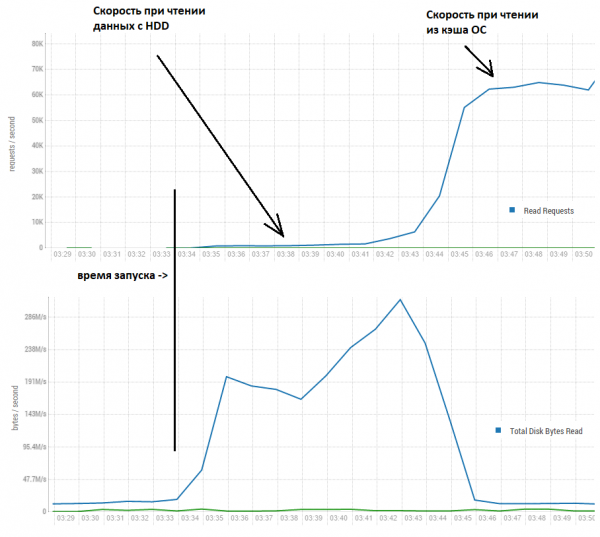
Vidíme, že prvních pár minut je rychlost skutečně kolem tisíce záznamů za sekundu. Nicméně později, díky tomu, že se čte mnohem více, než bylo požadováno, data se usazují v buff/cache operačního systému (linux) a rychlost roste na více slušných 60 tisíc za sekundu.
Tímto způsobem se budeme dále zabývat urychlením přístupu pouze k těm datům, která jsou v cache OS nebo se nacházejí v porovnatelně rychlých úložištích jako SSD/NVMe.
V našem případě budeme provádět testy na sestavě ze 4 serverů, z nichž každý je vybaven následujícím:
CPU: Xeon E5-2680 v4 @ 2.40GHz 64 threadů.
Paměť: 730 GB.
java version: 1.8.0_111
A zde je vlastně klíčový bod — objem dat v tabulkách, která je třeba číst. Věc je taková, že pokud čtete data z tabulky, která se celá vejde do cache HBase, tak k čtení z buff/cache operačního systému ani nedojde. Protože HBase standardně vyhrazuje 40 % paměti pro strukturu, která se nazývá BlockCache. V podstatě je to ConcurrentHashMap, kde je klíč jméno souboru + offset bloku a value jsou vlastně data podle tohoto posunu.
Tímto způsobem, když čtení probíhá pouze z této struktury, my , jako by to bylo milion požadavků za sekundu. Ale představme si, že nemůžeme věnovat stovky gigabajtů paměti pouze pro potřeby databáze, protože na těchto serverech běží mnoho dalších užitečných věcí.
Například v našem případě objem BlockCache na jednom RS je přibližně 12 GB. Nasadili jsme dva RS na jednu uzel, tj. pro BlockCache je vyhrazeno 96 GB na všech uzlech. A dat je při tom mnohonásobně více, například ať už to jsou 4 tabulky po 130 regionech, ve kterých jsou soubory o velikosti 800 MB, komprimované pomocí FAST_DIFF, tj. celkem 410 GB (to jsou čistá data, tj. bez ohledu na faktory replikace).
Takže BlockCache představuje pouze asi 23% z celkového objemu dat a to je mnohem blíž skutečným podmínkám, které se nazývají Big Data. A tady začíná to nejzajímavější - je jasné, že čím méně zásahů do cache, tím horší výkon. V případě zásahu bude třeba provést spoustu práce - tj. se dostat až na volání systémových funkcí. Nicméně tomu se nedá vyhnout, a proto se podívejme na zcela jiný aspekt - co se děje s daty uvnitř cache?
Zjednodušíme situaci a předpokládejme, že máme cache, do které se vejde pouze 1 objekt. Tady je příklad toho, co se stane, když se pokusíme pracovat s objemem dat třikrát větším než cache, budeme muset:
1. Umístit blok 1 do cache
2. Odstranit blok 1 z cache
3. Umístit blok 2 do cache
4. Odstranit blok 2 z cache
5. Umístit blok 3 do cache
Bylo dokončeno 5 akcí! Nicméně tuto situaci nelze nazvat normální, v podstatě nutíme HBase vykonávat spoustu naprosto zbytečné práce. Neustále čte data z cache OS, umisťuje je do BlockCache, aby je téměř ihned vyhodil, protože dorazila nová várka dat. Animace na začátku příspěvku ukazuje podstatu problému - Garbage Collector přetéká, atmosféra se otepluje, malá Greta v dalekém a horkém Švédsku se trápí. A my počítačoví technici velmi neradi vidíme, když děti smutní, proto začínáme přemýšlet, co s tím můžeme udělat.
A co kdybychom do cache umisťovali ne všechny bloky, ale pouze určitý procento z nich, aby se cache nepřetékala? Pojďme na začátek jednoduše přidat několik řádků kódu na začátek funkce pro umístění dat do BlockCache:
  public void cacheBlock(BlockCacheKey cacheKey, Cacheable buf, boolean inMemory) {
    if (cacheDataBlockPercent != 100 && buf.getBlockType().isData()) {
      if (cacheKey.getOffset() % 100 >= cacheDataBlockPercent) {
        return;
      }
    }
...
Smysl je následující: offset je pozice bloku v souboru a poslední čísla jsou náhodně a rovnoměrně rozložena od 00 do 99. Proto budeme přeskočit pouze ty, které spadají do požadovaného rozsahu.
Například nastavíme cacheDataBlockPercent = 20 a podíváme se, co se stane:
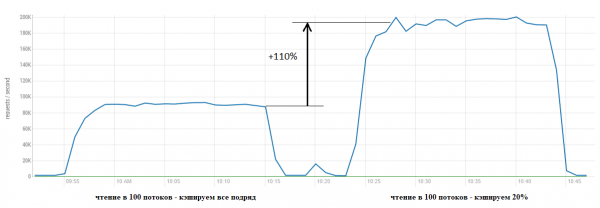
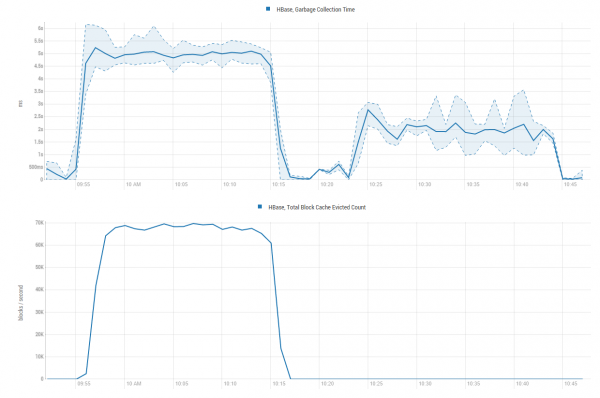
Výsledek je zřejmý. Na grafech níže je jasné, čím se to urychlení stalo — šetříme spoustu prostředků GC, protože se nezabýváme Sisyfovou prací umísťování dat do cache jen proto, abychom je pak ihned vyhodili marťanským psům pod ocas:
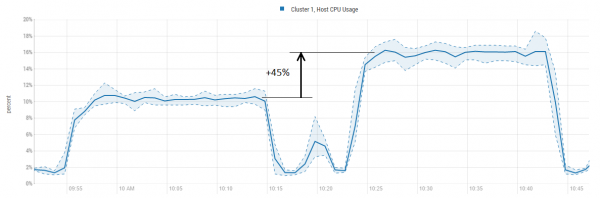
Využití CPU při tom roste, ale mnohem méně než výkon:
Ještě je třeba poznamenat, že bloky, které se ukládají v BlockCache, mohou být různé. Většina, zhruba 95 %, jsou vlastně data. A zbytek, to jsou metadata, jako například Bloom filtry nebo LEAF_INDEX a . Těchto dat je málo, ale jsou velmi užitečné, protože než se HBase obrátí přímo na data, obrací se na metadata, aby pochopila, zda je třeba hledat dál a pokud ano, tak kde přesně se nachází zajímavý blok.
Proto v kódu vidíme podmínku kontrolu buf.getBlockType().isData() a díky tomuto metadatům budeme vždy vkládat do cache.
Nyní zvyšte zatížení a zároveň trochu vylepšeme funkci. V prvním testu jsme provedli procento ořezání = 20 a BlockCache byl mírně nedostatečně zatížen. Nyní nastavíme 23 % a budeme přidávat 100 vláken každých 5 minut, abychom viděli, в jakém okamžiku dochází k nasycení:
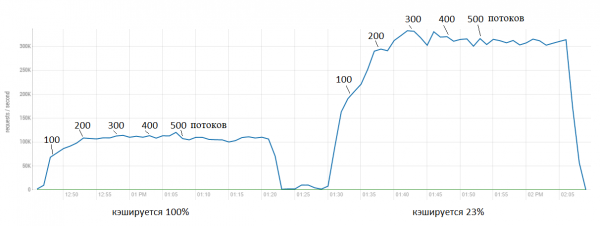
Vidíme, že původní verze téměř okamžitě narazí na strop kolem 100 tisíc požadavků za sekundu. Zatímco oprava dává zrychlení až na 300 tisíc. Při tom je jasné, že další urychlení už není tak "bezplatné", využití CPU také roste.
Nicméně to není příliš elegantní řešení, protože předem nevíme, jaké procento bloků je třeba kešovat, závisí to na profilu zátěže. Proto byl implementován mechanismus automatického přizpůsobení tohoto parametru v závislosti na četnosti čtecích operací.
K řízení toho bylo přidáno tři parametry:
hbase.lru.cache.heavy.eviction.count.limit — určuje, kolikrát by měl proces vyřazení dat z cache proběhnout, než začneme používat optimalizaci (tj. přeskočit bloky). Ve výchozím nastavení je nastaven na MAX_INT = 2147483647, což v podstatě znamená, že funkce nikdy nezačne fungovat při této hodnotě. Protože proces vyřazení probíhá každých 5 — 10 sekund (to závisí na zátěži) a 2147483647 * 10 / 60 / 60 / 24 / 365 = 680 let. Můžeme však tento parametr nastavit na 0 a tímto způsobem spustit funkci ihned po startu.
Nicméně v tomto parametru je i užitečná část. Pokud máme zátěž, která se neustále střídá mezi krátkodobým čtením (dejme tomu ve dne) a dlouhodobým (v noci), můžeme zabezpečit, aby se funkce aktivovala pouze v době, kdy probíhají dlouhodobé operace čtení.
Například víme, že krátkodobá čtení obvykle trvají asi 1 minutu. Není nutné začínat vyhazovat bloky, cache nebude mít čas na zastarání a tudíž můžeme nastavit tento parametr například na 10. To povede k tomu, že optimalizace začne fungovat pouze tehdy, když začne delší aktivní čtení, tj. po 100 sekundách. Tímto způsobem, pokud provádíme krátkodobé čtení, všechny bloky se dostanou do cache a budou dostupné (s výjimkou těch, které budou vyřazeny standardním algoritmem). A když provádíme dlouhodobá čtení, funkce se aktivuje a dosáhneme mnohem vyšší výkonnosti.
hbase.lru.cache.heavy.eviction.mb.size.limit — určuje, kolik megabajtů bychom chtěli umístit do cache (a přirozeně vyřazovat) za 10 sekund. Funkce se pokusí dosáhnout této hodnoty a udržovat ji. Smysl spočívá v tom, že pokud dáváme do cache gigabajty, musíme vyřazovat gigabajty, což, jak jsme viděli výše, je velmi nákladné. Nicméně není dobré nastavovat hodnotu příliš nízko, protože to povede k předčasnému ukončení režimu přeskočení bloků. Pro výkonné servery (okolo 20-40 fyzických jader) je optimální nastavit asi 300-400 MB. Pro střední třídu (~10 jader) 200-300 MB. Pro slabé systémy (2-5 jader) může být v pořádku 50-100 MB (na těchto nebylo testováno).
Podívejme se, jak to funguje: dejme tomu, že jsme nastavili hbase.lru.cache.heavy.eviction.mb.size.limit = 500, probíhá nějaké zatížení (čtení) a pak každých ~10 sekund vypočítáme, kolik bajtů bylo vyřazeno podle vzorce:
Overhead = Součet osvobozených bajtů (MB) * 100 / Limit (MB) — 100;
Pokud bylo ve skutečnosti vyřazeno 2000 MB, pak je Overhead roven:
2000 * 100 / 500 — 100 = 300%
Algoritmy se snaží udržovat maximálně několik desítek procent, takže tato funkce sníží procento cachovaných bloků, čímž realizuje mechanismus automatického ladění.
Pokud však zatížení kleslo, dejme tomu, že bylo vyřazeno pouze 200 MB a Overhead se stal negativním (takzvaný overshooting):
200 * 100 / 500 — 100 = -60%
Pak funkce naopak zvýší procento cachovaných bloků, dokud Overhead nezíská pozitivní hodnotu.
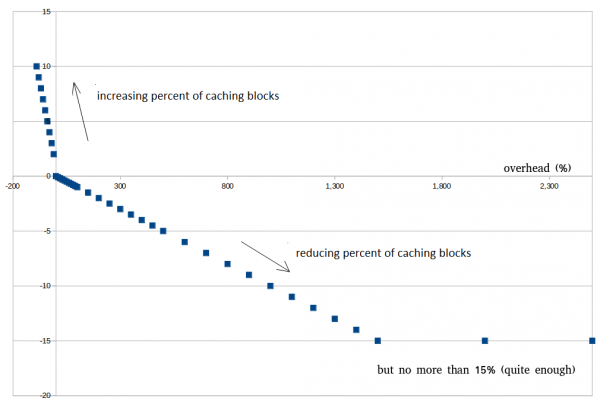
Níže bude příklad, jak to vypadá na reálných datech. Není třeba se snažit dosáhnout 0%, to je nemožné. Velmi dobře je, když je to kolem 30 — 100%, pomáhá to vyhnout se předčasnému ukončení optimalizačního režimu při krátkodobých výkyvech.
hbase.lru.cache.heavy.eviction.overhead.coefficient — nastavuje, jak rychle bychom chtěli získat výsledek. Pokud pevně víme, že naše čtení jsou převážně dlouhá a nechceme čekat, můžeme tento koeficient zvýšit a dosáhnout vysokého výkonu rychleji.
Například jsme nastavili tento koeficient = 0.01. To znamená, že Overhead (viz výše) bude vynásoben touto hodnotou na získaný výsledek a procento cachovaných bloků bude sníženo. Dejme tomu, že Overhead = 300%, a koeficient = 0.01, pak procento cachovaných bloků klesne o 3%.
Podobná logika "Backpressure" — je realizována i pro negativní hodnoty Overhead (overshooting). Protože vždy mohou nastat krátkodobé výkyvy objemu čtení-vyřazení, tento mechanismus zabraňuje předčasnému ukončení optimalizačního režimu. Backpressure má obrácenou logiku: čím silnější je overshooting, tím více bloků se cachuje.
Kód implementace
        LruBlockCache cache = this.cache.get();
        if (cache == null) {
          break;
        }
        freedSumMb += cache.evict() / 1024 / 1024;
        /*
        * Někdy čteme více dat, než se vejde do BlockCache
        * a to je příčinou vysoké míry evikcí.
        * To na oplátku vede k intenzivní činnosti Garbage Collector.
        * Takže spousta bloků je vložena do BlockCache, ale nikdy čtena,
        * a spotřebovává hodně CPU prostředků.
        * Zde analyzujeme, kolik bytů bylo uvolněno, a rozhodneme se,
        * zda je čas snížit množství ukládaných bloků.
        * Pomůže to zabránit vkládání příliš mnoha bloků do BlockCache,
        * když evict() pracuje velmi aktivně a ušetří CPU pro jiné úkoly.
        * Další podrobnosti: https://issues.apache.org/jira/browse/HBASE-23887
        */

        // Především musíme kontrolovat, kolik času
        // uplynulo od posledního spuštění evict()
        // Toto by mělo být téměř stejný čas (+/- 10s)
        // protože každý čas dostáváme srovnatelné objemy uvolněných bytů.
        // 10s, protože toto je výchozí doba pro spuštění evict() (viz výše this.wait)
        long stopTime = System.currentTimeMillis();
        if ((stopTime - startTime) > 1000 * 10 - 1) {
          // Zde musíme spočítat, jakou situaci máme.
          // Máme limit "hbase.lru.cache.heavy.eviction.bytes.size.limit"
          // a můžeme vypočítat přetížení na něj.
          // Tyto informace použijeme k rozhodnutí,
          // jak změnit procento ukládaných bloků.
          freedDataOverheadPercent =
            (int) (freedSumMb * 100 / cache.heavyEvictionMbSizeLimit) - 100;
          if (freedSumMb > cache.heavyEvictionMbSizeLimit) {
            // Nyní jsme ve situaci, kdy jsme nad limitem
            // Ale možná to ignorujeme, protože to brzy skončí
            heavyEvictionCount++;
            if (heavyEvictionCount > cache.heavyEvictionCountLimit) {
              // Děje se to už dlouho a musíme snížit množství ukládaných
              // bloků nyní. Spočítáme zde, kolik bloků chceme přeskočit.
              // Závisí to na:
              // 1. Přetížení - pokud je přetížení vysoké, mohli bychom být agresivnější
              // ve snižování množství ukládaných bloků.
              // 2. Jak rychle chceme dosáhnout výsledku. Pokud víme, že naše
              // intenzivní čtení trvá dlouho, nechceme čekat a můžeme
              // zvýšit koeficient a dosáhnout dobrého výkonu docela brzy.
              // Ale pokud si nejsme jisti, můžeme to dělat pomalu a to by mohlo zabránit
              // předčasnému výstupu z tohoto módu. Takže, když je koeficient
              // vyšší, můžeme dosáhnout lepšího výkonu, když je intenzivní čtení stabilní.
              // Ale když se čtení mění, můžeme se tomu přizpůsobit a nastavit
              // koeficient na nižší hodnotu.
              int change =
                (int) (freedDataOverheadPercent * cache.heavyEvictionOverheadCoefficient);
              // Ale praxe ukazuje, že snížení o 15% je docela dost.
              // Nejsme chamtiví (to by mohlo vést k předčasnému výstupu).
              change = Math.min(15, change);
              change = Math.max(0, change); // Myslím, že to se nikdy nestane, ale pro jistotu zkontrolujeme
              // Takže toto je klíčový bod, zde snižujeme % ukládaných bloků
              cache.cacheDataBlockPercent -= change;
              // Pokud jdeme dolů příliš hluboko, musíme se zde zastavit, 1% by každopádně mělo být.
              cache.cacheDataBlockPercent = Math.max(1, cache.cacheDataBlockPercent);
            }
          } else {
            // No, máme přestřelení.
            // Možná je to jen krátkodobá fluktuace, a můžeme zůstat v tomto módu.
            // Pomůže to zabránit předčasnému výstupu během krátkodobé fluktuace.
            // Pokud je přestřelení menší než 90%, pokusíme se zvýšit procento
            // ukládaných bloků a doufat, že to bude stačit.
            if (freedSumMb >= cache.heavyEvictionMbSizeLimit * 0.1) {
              // Jednoduchá logika: více přestřelování - více ukládaných bloků (zpětný tlak)
              int change = (int) (-freedDataOverheadPercent * 0.1 + 1);
              cache.cacheDataBlockPercent += change;
              // Ale nemůže to být více než 100%, takže to zkontrolujeme.
              cache.cacheDataBlockPercent = Math.min(100, cache.cacheDataBlockPercent);
            } else {
              // Vypadá to, že intenzivní čtení je u konce.
              // Jen vystoupíme z tohoto módu.
              heavyEvictionCount = 0;
              cache.cacheDataBlockPercent = 100;
            }
          }
          LOG.info("BlockCache evicted (MB): {}, overhead (%): {}, " +
            "heavy eviction counter: {}, " +
            "current caching DataBlock (%): {}",
            freedSumMb, freedDataOverheadPercent,
            heavyEvictionCount, cache.cacheDataBlockPercent);

          freedSumMb = 0;
          startTime = stopTime;
       }
Podívejme se nyní na vše pomocí reálného příkladu. Máme následující testovací scénář:
- Začínáme provádět skenování (25 vláken, dávka = 100)
- Po 5 minutách přidáváme multi-gets (25 vláken, dávka = 100)
- Po 5 minutách vypínáme multi-gets (zůstává opět jen skenování)
Děláme dva průchody, nejprve hbase.lru.cache.heavy.eviction.count.limit = 10000 (což v podstatě vypíná funkci), a poté nastavíme limit = 0 (zapíná).
V níže uvedených logech vidíme, jak se funkce zapíná, resetuje Overshooting na 14-71%. Občas se zatížení snižuje, což aktivuje Backpressure a HBase znovu ukládá více bloků do cache.
Log RegionServer
odstraněno (MB): 0, poměr 0.0, nárůst (%): -100, počítadlo těžkých evikcí: 0, aktuální ukládání DataBlock (%): 100
odstraněno (MB): 0, poměr 0.0, nárůst (%): -100, počítadlo těžkých evikcí: 0, aktuální ukládání DataBlock (%): 100
odstraněno (MB): 2170, poměr 1.09, nárůst (%): 985, počítadlo těžkých evikcí: 1, aktuální ukládání DataBlock (%): 91 < start
odstraněno (MB): 3763, poměr 1.08, nárůst (%): 1781, počítadlo těžkých evikcí: 2, aktuální ukládání DataBlock (%): 76
odstraněno (MB): 3306, poměr 1.07, nárůst (%): 1553, počítadlo těžkých evikcí: 3, aktuální ukládání DataBlock (%): 61
odstraněno (MB): 2508, poměr 1.06, nárůst (%): 1154, počítadlo těžkých evikcí: 4, aktuální ukládání DataBlock (%): 50
odstraněno (MB): 1824, poměr 1.04, nárůst (%): 812, počítadlo těžkých evikcí: 5, aktuální ukládání DataBlock (%): 42
odstraněno (MB): 1482, poměr 1.03, nárůst (%): 641, počítadlo těžkých evikcí: 6, aktuální ukládání DataBlock (%): 36
odstraněno (MB): 1140, poměr 1.01, nárůst (%): 470, počítadlo těžkých evikcí: 7, aktuální ukládání DataBlock (%): 32
odstraněno (MB): 913, poměr 1.0, nárůst (%): 356, počítadlo těžkých evikcí: 8, aktuální ukládání DataBlock (%): 29
odstraněno (MB): 912, poměr 0.89, nárůst (%): 356, počítadlo těžkých evikcí: 9, aktuální ukládání DataBlock (%): 26
odstraněno (MB): 684, poměr 0.76, nárůst (%): 242, počítadlo těžkých evikcí: 10, aktuální ukládání DataBlock (%): 24
odstraněno (MB): 684, poměr 0.61, nárůst (%): 242, počítadlo těžkých evikcí: 11, aktuální ukládání DataBlock (%): 22
odstraněno (MB): 456, poměr 0.51, nárůst (%): 128, počítadlo těžkých evikcí: 12, aktuální ukládání DataBlock (%): 21
odstraněno (MB): 456, poměr 0.42, nárůst (%): 128, počítadlo těžkých evikcí: 13, aktuální ukládání DataBlock (%): 20
odstraněno (MB): 456, poměr 0.33, nárůst (%): 128, počítadlo těžkých evikcí: 14, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 342, poměr 0.33, nárůst (%): 71, počítadlo těžkých evikcí: 15, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 342, poměr 0.32, nárůst (%): 71, počítadlo těžkých evikcí: 16, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 342, poměr 0.31, nárůst (%): 71, počítadlo těžkých evikcí: 17, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.3, nárůst (%): 14, počítadlo těžkých evikcí: 18, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.29, nárůst (%): 14, počítadlo těžkých evikcí: 19, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.27, nárůst (%): 14, počítadlo těžkých evikcí: 20, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.25, nárůst (%): 14, počítadlo těžkých evikcí: 21, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.24, nárůst (%): 14, počítadlo těžkých evikcí: 22, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.22, nárůst (%): 14, počítadlo těžkých evikcí: 23, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.21, nárůst (%): 14, počítadlo těžkých evikcí: 24, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.2, nárůst (%): 14, počítadlo těžkých evikcí: 25, aktuální ukládání DataBlock (%): 19
odstraněno (MB): 228, poměr 0.17, nárůst (%): 14, počítadlo těžkých evikcí: 26, aktuální ukládání DataBlock (%): 19
vyhnáno (MB): 456, poměr 0.17, režie (%): 128, těžký vyhazovací čítač: 27, aktuální caching DataBlock (%): 18 < přidané získání (ale tabulka stejná)
vyhnáno (MB): 456, poměr 0.15, režie (%): 128, těžký vyhazovací čítač: 28, aktuální caching DataBlock (%): 17
vyhnáno (MB): 342, poměr 0.13, režie (%): 71, těžký vyhazovací čítač: 29, aktuální caching DataBlock (%): 17
vyhnáno (MB): 342, poměr 0.11, režie (%): 71, těžký vyhazovací čítač: 30, aktuální caching DataBlock (%): 17
vyhnáno (MB): 342, poměr 0.09, režie (%): 71, těžký vyhazovací čítač: 31, aktuální caching DataBlock (%): 17
vyhnáno (MB): 228, poměr 0.08, režie (%): 14, těžký vyhazovací čítač: 32, aktuální caching DataBlock (%): 17
vyhnáno (MB): 228, poměr 0.07, režie (%): 14, těžký vyhazovací čítač: 33, aktuální caching DataBlock (%): 17
vyhnáno (MB): 228, poměr 0.06, režie (%): 14, těžký vyhazovací čítač: 34, aktuální caching DataBlock (%): 17
vyhnáno (MB): 228, poměr 0.05, režie (%): 14, těžký vyhazovací čítač: 35, aktuální caching DataBlock (%): 17
vyhnáno (MB): 228, poměr 0.05, režie (%): 14, těžký vyhazovací čítač: 36, aktuální caching DataBlock (%): 17
vyhnáno (MB): 228, poměr 0.04, režie (%): 14, těžký vyhazovací čítač: 37, aktuální caching DataBlock (%): 17
vyhnáno (MB): 109, poměr 0.04, režie (%): -46, těžký vyhazovací čítač: 37, aktuální caching DataBlock (%): 22 < tlak na opětovné získání
vyhnáno (MB): 798, poměr 0.24, režie (%): 299, těžký vyhazovací čítač: 38, aktuální caching DataBlock (%): 20
vyhnáno (MB): 798, poměr 0.29, režie (%): 299, těžký vyhazovací čítač: 39, aktuální caching DataBlock (%): 18
vyhnáno (MB): 570, poměr 0.27, režie (%): 185, těžký vyhazovací čítač: 40, aktuální caching DataBlock (%): 17
vyhnáno (MB): 456, poměr 0.22, režie (%): 128, těžký vyhazovací čítač: 41, aktuální caching DataBlock (%): 16
vyhnáno (MB): 342, poměr 0.16, režie (%): 71, těžký vyhazovací čítač: 42, aktuální caching DataBlock (%): 16
vyhnáno (MB): 342, poměr 0.11, režie (%): 71, těžký vyhazovací čítač: 43, aktuální caching DataBlock (%): 16
vyhnáno (MB): 228, poměr 0.09, režie (%): 14, těžký vyhazovací čítač: 44, aktuální caching DataBlock (%): 16
vyhnáno (MB): 228, poměr 0.07, režie (%): 14, těžký vyhazovací čítač: 45, aktuální caching DataBlock (%): 16
vyhnáno (MB): 228, poměr 0.05, režie (%): 14, těžký vyhazovací čítač: 46, aktuální caching DataBlock (%): 16
vyhnáno (MB): 222, poměr 0.04, režie (%): 11, těžký vyhazovací čítač: 47, aktuální caching DataBlock (%): 16
vyhnáno (MB): 104, poměr 0.03, režie (%): -48, těžký vyhazovací čítač: 47, aktuální caching DataBlock (%): 21 < přerušit získání
vyhnáno (MB): 684, poměr 0.2, režie (%): 242, těžký vyhazovací čítač: 48, aktuální caching DataBlock (%): 19
vyhnáno (MB): 570, poměr 0.23, režie (%): 185, těžký vyhazovací čítač: 49, aktuální caching DataBlock (%): 18
vyhnáno (MB): 342, poměr 0.22, režie (%): 71, těžký vyhazovací čítač: 50, aktuální caching DataBlock (%): 18
vyhnáno (MB): 228, poměr 0.21, režie (%): 14, těžký vyhazovací čítač: 51, aktuální caching DataBlock (%): 18
vyhnáno (MB): 228, poměr 0.2, režie (%): 14, těžký vyhazovací čítač: 52, aktuální caching DataBlock (%): 18
vyhnáno (MB): 228, poměr 0.18, režie (%): 14, těžký vyhazovací čítač: 53, aktuální caching DataBlock (%): 18
vyhnáno (MB): 228, poměr 0.16, režie (%): 14, těžký vyhazovací čítač: 54, aktuální caching DataBlock (%): 18
vyhnáno (MB): 228, poměr 0.14, režie (%): 14, těžký vyhazovací čítač: 55, aktuální caching DataBlock (%): 18
vyhnáno (MB): 112, poměr 0.14, režie (%): -44, těžký vyhazovací čítač: 55, aktuální caching DataBlock (%): 23 < tlak na opětovné získání
vyhnáno (MB): 456, poměr 0.26, režie (%): 128, těžký vyhazovací čítač: 56, aktuální caching DataBlock (%): 22
vyhnáno (MB): 342, poměr 0.31, režie (%): 71, těžký vyhazovací čítač: 57, aktuální caching DataBlock (%): 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 58, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 59, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 60, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 61, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 62, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 63, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.32, režie (%): 71, těžký počet vysídlení: 64, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 65, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 66, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.32, režie (%): 71, těžký počet vysídlení: 67, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 68, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.32, režie (%): 71, těžký počet vysídlení: 69, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.32, režie (%): 71, těžký počet vysídlení: 70, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 71, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 72, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 73, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 74, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 75, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 342, poměr 0.33, režie (%): 71, těžký počet vysídlení: 76, aktuální procento cachovaných DataBlocků: 22
vysídleno (MB): 21, poměr 0.33, režie (%): -90, těžký počet vysídlení: 76, aktuální procento cachovaných DataBlocků: 32
odstraněno (MB): 0, poměr 0.0, nárůst (%): -100, počítadlo těžkých evikcí: 0, aktuální ukládání DataBlock (%): 100
odstraněno (MB): 0, poměr 0.0, nárůst (%): -100, počítadlo těžkých evikcí: 0, aktuální ukládání DataBlock (%): 100
Snímky byly potřebné k zobrazení tohoto procesu jako grafického znázornění poměru mezi dvěma částmi cache — single (kam přicházejí bloky, které dosud nikdo nepožadoval) a multi (zde jsou uložena data, která byla alespoň jednou „požadována“):
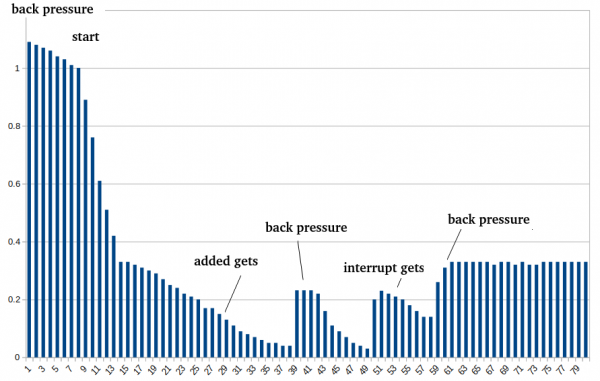
A nakonec, jak vypadá práce parametrů ve formě grafu. Pro srovnání byla cache na začátku zcela vypnuta, poté byl spuštěn HBase s cachováním a zpožděním začátku optimalizace o 5 minut (30 cyklů vysídlení).
Úplný kód lze nalézt v Pull Request na github.
Nicméně 300 tisíc čtení za sekundu není vše, co lze na tomto hardwaru v těchto podmínkách dosáhnout. Věc je taková, že když je potřeba přistupovat k datům přes HDFS, využívá se mechanismus ShortCircuitCache (dále SSC), který umožňuje přistupovat k datům přímo a vyhnout se síťovým interakcím.
Profilování ukázalo, že tento mechanismus i když přináší významné výhody, v určitém okamžiku se také stává úzkým hrdlem, protože téměř všechny těžké operace probíhají uvnitř zámku, což vede k blokacím většinu času.
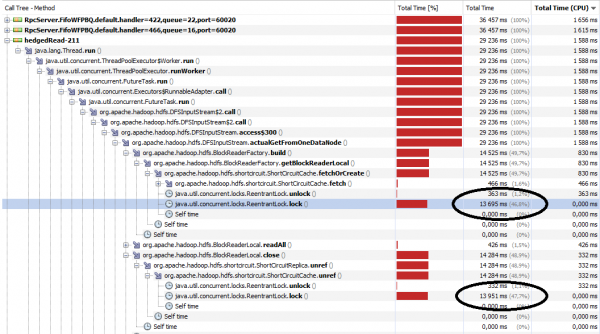
Uvědomili jsme si, že problém lze obejít, pokud vytvoříme pole nezávislých SSC:
private final ShortCircuitCache[] shortCircuitCache;
...
shortCircuitCache = new ShortCircuitCache[this.clientShortCircuitNum];
for (int i = 0; i < this.clientShortCircuitNum; i++)
  this.shortCircuitCache[i] = new ShortCircuitCache(…);
A dále s nimi pracovat, s výjimkou překrývání také podle poslední cifry offsetu:
public ShortCircuitCache getShortCircuitCache(long idx) {
    return shortCircuitCache[(int) (idx % clientShortCircuitNum)];
}
Nyní můžeme přejít k testům. K tomu budeme číst soubory z HDFS jednoduchou vícvláknovou aplikací. Nastavujeme parametry:
conf.set("dfs.client.read.shortcircuit", "true");
conf.set("dfs.client.read.shortcircuit.buffer.size", "65536"); // defaultně = 1 MB a to výrazně zpomaluje čtení, proto je lepší přizpůsobit k reálným potřebám
conf.set("dfs.client.short.circuit.num", num); // od 1 do 10
A jednoduše čteme soubory:
FSDataInputStream in = fileSystem.open(path);
for (int i = 0; i  900000000)
        position = 0L;
    int res = in.read(position, byteBuffer, 0, 65536);
}
Tento kód se provádí ve více vláknech a budeme zvyšovat počet současně čtených souborů (od 10 do 200 — horizontální osa) a počet cache (od 1 do 10 — grafy). Vertikální osa ukazuje zrychlení, které zvyšuje SSC ve srovnání s případem, kdy je cache pouze jedna.
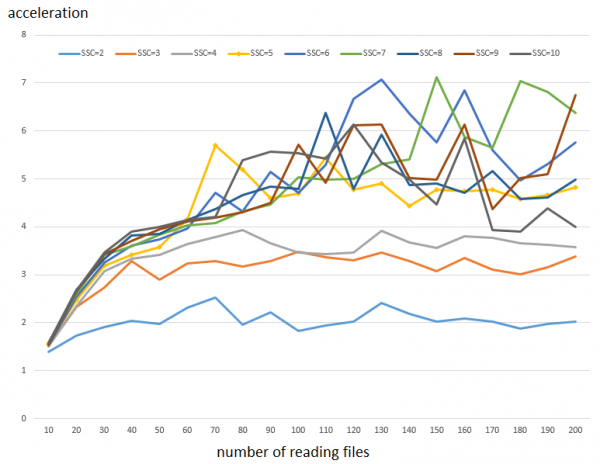
Jak číst graf: doba provádění 100 tisíc čtení v blocích po 64 KB s jednou cache vyžaduje 78 sekund. Zatímco s 5 cache to trvá 16 sekund. Tedy je zde zrychlení ~5krát. Jak je vidět z grafu, při malém počtu paralelních čtení je efekt méně nápadný, to začíná hrát významnou roli při více než 50 čteních. Také je znatelné, že zvyšování počtu SSC od 6 a výše poskytuje podstatně menší zisk výkonu.
Poznámka 1: jelikož výsledky testování jsou poměrně volatilní (viz níže), byly provedeny 3 spuštění a získané hodnoty byly zprůměrovány.
Poznámka 2: Zisk výkonu z nastavení pro náhodný přístup je stejný, i když přístup samotný je o něco pomalejší.
Je však třeba upřesnit, že na rozdíl od případu s HBase toto zrychlení není vždy zdarma. Zde spíše "odemkneme" schopnosti CPU vykonávat práci, místo abychom se zasekávali na zámcích.
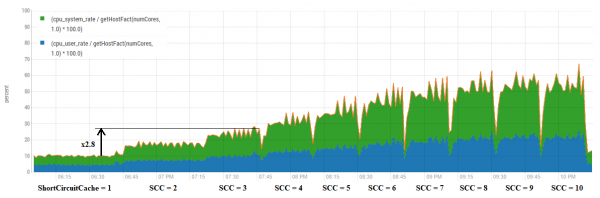
Můžeme pozorovat, že celkově zvýšení počtu cache přináší přibližně proporcionální nárůst využití CPU. Nicméně existuje několik výhodnějších kombinací.
Například se podívejme blíže na nastavení SSC = 3. Nárůst výkonu v rozmezí činí přibližně 3,3x. Níže jsou výsledky všech tří jednotlivých běhů.
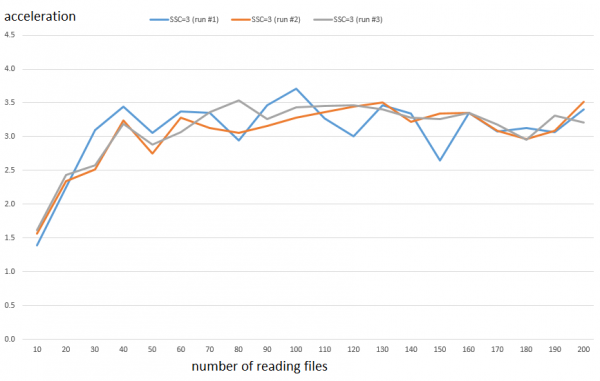
Zatímco spotřeba CPU roste přibližně 2,8x. Rozdíl není příliš velký, ale malé Gretě to už přináší radost a možná se objeví čas na návštěvu školy a hodin.
Tím pádem to bude mít pozitivní efekt pro jakýkoliv nástroj využívající hromadný přístup k HDFS (např. Spark atd.), za předpokladu, že aplikační kód je lehký (tj. problém je na straně klienta HDFS) a jsou k dispozici volné kapacity CPU. Pro ověření otestujme, jaký efekt přinese společné použití optimalizace BlockCache a ladění SSC pro čtení z HBase.
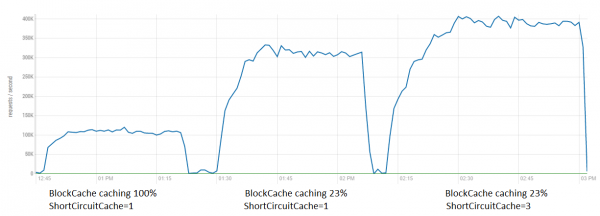
Zde je vidět, že v takových podmínkách efekt není tak velký jako v rafinovaných testech (čtení bez jakékoliv zpracování), nicméně vytáhnout navíc 80K je zde zcela možné. Společně obě optimalizace přinášejí zrychlení až 4x.
Také byla na tuto optimalizaci vytvořena PR , která byla sloučena a tato funkce bude dostupná v následujících verzích.
A nakonec bylo zajímavé porovnat výkon čtení podobné wide-column databáze Cassandra a HBase.
K tomu byly spuštěny instance standardního zátěžového testovacího nástroje YCSB z dvou hostitelů (celkem 800 vláken). Na serverové straně byly po 4 instance RegionServer a Cassandra na 4 hostitelích (ne na těch, kde běží klienti, aby se předešlo jejich vlivu). Čtení probíhalo z tabulek o velikosti:
HBase — 300 GB na HDFS (100 GB čistých dat)
Cassandra — 250 GB (faktor replikace = 3)
Tj. objem byl přibližně stejný (v HBase o něco větší).
Parametry HBase:
dfs.client.short.circuit.num = 5 (optimalizace klienta HDFS)
hbase.lru.cache.heavy.eviction.count.limit = 30 — to znamená, že patch začne fungovat po 30 evikcí (~5 minut)
hbase.lru.cache.heavy.eviction.mb.size.limit = 300 — cílový objem kešování a evikcí
Logy YCSB byly zpracovány a shrnuty do grafů Excel:
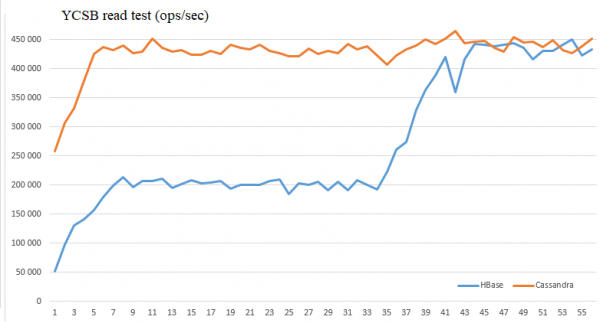
Jak vidno, data optimalizace umožňují srovnat výkon těchto databází za těchto podmínek a dosáhnout 450 tisíc čtení za sekundu.
Doufáme, že tyto informace mohou být někomu užitečné v průběhu vzrušujícího boje o výkon.
Zdroj: habr.com
