

Ve své práci se často setkávám s novými technickými řešeními/progra{
Co je Debezium a co je to CDC?
je představitel kategorie softwaru CDC (), a pokud budeme přesní, je to sada konektorů pro různé SGBD, kompatibilní s frameworkem Apache Kafka Connect.
To je který používá licenci Apache License v2.0 a je sponzorován společností Red Hat. Vývoj probíhá od roku 2016 a v současné době nabízí oficiální podporu pro následující SGBD: MySQL, PostgreSQL, MongoDB, SQL Server. Existují také konektory pro Cassandra a Oracle, ale v současnosti jsou ve stavu 'raného přístupu' a nové verze nezaručují zpětnou kompatibilitu.
Pokud srovnáme CDC s tradičním přístupem (kdy aplikace čte data přímo ze SGBD), hlavními výhodami jsou implementace streamování změn dat na úrovni řádků s nízkou latencí, vysokou spolehlivostí a dostupností. Poslední dva body jsou dosaženy díky použití Kafka clustera jako úložiště CDC událostí.
Dalšími výhodami je fakt, že pro ukládání událostí se používá jednotný model, takže koncová aplikace se nebude muset starat o nuance provozu různých SGBD.
Nakonec, díky použití message brokeru se otevírá prostor pro horizontální škálování aplikací, které sledují změny v datech. Přitom je vliv na zdroj dat minimalizován, protože získávání dat probíhá ne přímo ze SGBD, ale z Kafka clusteru.
O architektuře Debezium
Použití Debezium se shrnuje do takto jednoduchého schématu:
SGBD (jako zdroj dat) → konektor v Kafka Connect → Apache Kafka → konzument
Jako ilustraci uvedu schéma z webové stránky projektu:
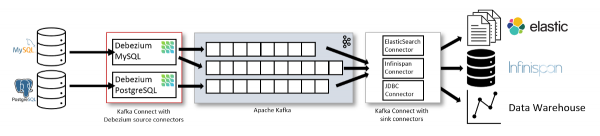
Toto schéma se mi ale příliš nelíbí, protože to vytváří dojem, že je možné použít pouze sink konektor.
Ve skutečnosti je situace jiná: naplnění vaší Data Lake (poslední článek v uvedeném schématu) — to není jediný způsob využití Debezium. Události odeslané do Apache Kafka mohou být používány vašimi aplikacemi pro řešení různých situací. Například:
- odstranění zastaralých dat z cache;
- odesílání oznámení;
- aktualizace vyhledávacích indexů;
- něco jako auditní logy;
- …
Pokud máte aplikaci na Java a není potřeba/možnost používat cluster Kafka, existuje také možnost práce přes . Zřejmou výhodou je, že se můžete obejít bez další infrastruktury (ve formě konektoru a Kafka). Toto řešení je však od verze 1.1 prohlášeno za zastaralé (deprecated) a již se nedoporučuje používat (v budoucích verzích může být jeho podpora odstraněna).
V tomto článku se budeme zabývat doporučovanou architekturou od vývojářů, která zajišťuje odolnost proti chybám a možnost škálování.
Konfigurace konektoru
Abychom mohli začít sledovat změny toho nejcennějšího — dat — budeme potřebovat:
- zdroj dat, kterým může být MySQL od verze 5.7, PostgreSQL 9.6+, MongoDB 3.2+ ();
- cluster Apache Kafka;
- instanci Kafka Connect (verze 1.x, 2.x);
- konfigurovaný konektor Debezium.
Práce na prvních dvou bodech, tj. proces instalace DB a Apache Kafka, přesahují rámec článku. Avšak pro ty, kteří chtějí rozvinout vše v sandboxu, je v oficiálním repozitáři s příklady k dispozici hotový .
My se podrobněji zastavíme u dvou posledních bodů.
0. Kafka Connect
Zde a dále v článku jsou všechny příklady konfigurace posuzovány v kontextu Docker obrazu, který distributoři Debezium poskytují. Obsahuje všechny potřebné soubory pluginů (konektory) a předpokládá konfiguraci Kafka Connect pomocí proměnných prostředí.
Pokud se předpokládá využití Kafka Connect od Confluent, bude nutné samostatně přidat pluginy potřebných konektorů do adresáře uvedeného v plugin.path nebo stanoveného prostřednictvím proměnné prostředí CLASSPATH. Nastavení pracovníka Kafka Connect a konektorů jsou definována prostřednictvím konfiguračních souborů, které jsou předávány jako argumenty příkazu pro spuštění pracovníka. Podrobněji viz .
Celý proces nastavení Debezium s konektorem se uskutečňuje ve dvou fázích. Podíváme se na každou z nich:
1. Nastavení frameworku Kafka Connect
Pro streamování dat do clustru Apache Kafka ve frameworku Kafka Connect se definují specifické parametry, jako například:
- parametry připojení k clustru,
- název topiků, ve kterých bude uchovávána samotná konfigurace konektoru,
- název skupiny, ve které je konektor spuštěn (v případě použití distribuovaného režimu).
Oficiální Docker obraz projektu podporuje konfiguraci pomocí proměnných prostředí – to je to, co využijeme. Takže si stáhneme obraz:
docker pull debezium/connectMinimální soubor proměnných prostředí potřebných pro spuštění konektoru vypadá následovně:
-
BOOTSTRAP_SERVERS=kafka-1:9092,kafka-2:9092,kafka-3:9092— počáteční seznam serverů clustru Kafka pro získání celého seznamu členů clustru; -
OFFSET_STORAGE_TOPIC=connector-offsets— topik pro uchovávání pozic, na kterých se konektor aktuálně nachází; -
CONNECT_STATUS_STORAGE_TOPIC=connector-status— topik pro uchovávání stavu konektoru a jeho úkolů; -
CONFIG_STORAGE_TOPIC=connector-config— topik pro uchovávání dat konfigurace konektoru a jeho úkolů; -
GROUP_ID=1— identifikátor skupiny pracovníků, na kterých může úkol konektoru běžet; nutný při použití distribuovaného (distributed) režimu.
Spouštíme kontejner s těmito proměnnými:
docker run
  -e BOOTSTRAP_SERVERS='kafka-1:9092,kafka-2:9092,kafka-3:9092'
  -e GROUP_ID=1
  -e CONFIG_STORAGE_TOPIC=my_connect_configs
  -e OFFSET_STORAGE_TOPIC=my_connect_offsets
  -e STATUS_STORAGE_TOPIC=my_connect_statuses  debezium/connect:1.2
Poznámka o Avro
Ve výchozím nastavení Debezium zapisuje data ve formátu JSON, což je přijatelná volba pro testovací prostředí a menší objemy dat, ale může se stát problémem ve vysoce zatížených databázích. Alternativou k JSON konvertoru je serializace zpráv pomocí binárního formátu, což umožňuje snížit zátěž na subsystém I/O v Apache Kafka.
Pro použití Avro je třeba nasadit oddělený (pro uchovávání schémat). Proměnné pro konvertor budou vypadat následovně:
name: CONNECT_VALUE_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: CONNECT_KEY_CONVERTER_SCHEMA_REGISTRY_URL
value: http://kafka-registry-01:8081/
name: VALUE_CONVERTER
value: io.confluent.connect.avro.AvroConverter
Detaily k použití Avro a nastavení registry přesahují rámec tohoto článku – dále pro názornost budeme používat JSON.
2. Nastavení samotného konektoru
Nyní se můžeme přímo věnovat konfiguraci samotného konektoru, který bude číst data ze zdroje.
Podíváme se na příklad konektorů pro dvě databázové SŘBD: PostgreSQL a MongoDB, — s nimiž mám zkušenosti a kde existují rozdíly (ačkoliv malé, v některých případech mohou být podstatné!).
Konfigurace je popsána v notaci JSON a je nahrávána do Kafka Connect pomocí POST požadavku.
2.1. PostgreSQL
Příklad konfigurace konektoru pro PostgreSQL:
{
  "name": "pg-connector",
  "config": {
    "connector.class": "io.debezium.connector.postgresql.PostgresConnector",
    "plugin.name": "pgoutput",
    "database.hostname": "127.0.0.1",
    "database.port": "5432",
    "database.user": "debezium",
    "database.password": "definitelynotpassword",
    "database.dbname" : "dbname",
    "database.server.name": "pg-dev",
    "table.include.list": "public.(.*)",
    "heartbeat.interval.ms": "5000",
    "slot.name": "dbname_debezium",
    "publication.name": "dbname_publication",
    "transforms": "AddPrefix",
    "transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
    "transforms.AddPrefix.regex": "pg-dev.public.(.*)",
    "transforms.AddPrefix.replacement": "data.cdc.dbname"
  }
}
Princip fungování konektoru po takovém nastavení je poměrně jednoduchý:
- Při prvním spuštění se připojí k databázi uvedené v konfiguraci a spouští se v režimu počáteční snímek, posílající do Kafka počáteční sadu dat získanou pomocí podmínkového
SELECT * FROM table_name. - Jakmile je inicializace dokončena, konektor přechází do režimu čtení změn z WAL souborů PostgreSQL.
O používaných možnostech:
-
name— název konektoru, pro který se používá konfigurace popsaná níže; toto jméno se následně používá pro práci s konektorem (tj. pro zobrazení stavu / restartování / aktualizaci konfigurace) přes REST API Kafka Connect; -
connector.class— třída konektoru SŘBD, která bude používána konfigurovaným konektorem; -
plugin.name— název pluginu pro logické dekódování dat z WAL souborů. K dispozici jsou možnostiwal2json,decoderbuffsapgoutput. První dvě vyžadují instalaci odpovídajících rozšíření ve SŘBD, zatímcopgoutputpro PostgreSQL verzi 10 a vyšší nevyžaduje žádné dodatečné úpravy; -
database.*— možnosti pro připojení k databázi, kdedatabase.server.name— název instance PostgreSQL používaný k vytváření názvu topiku v klastru Kafka; -
table.include.list— seznam tabulek, ve kterých chceme sledovat změny; zadává se ve formátuschéma.název_tabky; nelze používat spolu stable.exclude.list; -
heartbeat.interval.ms— interval (v milisekundách), se kterým konektor odesílá heartbeat zprávy do speciálního tématu; -
heartbeat.action.query— dotaz, který se provede při odeslání každé heartbeat zprávy (možnost byla přidána od verze 1.1); -
slot.name— název replikace slotu, který bude použit konektorem; publication.name— název v PostgreSQL, který používá konektor. V případě, že neexistuje, se Debezium pokusí ji vytvořit. Pokud uživatel, pod kterým se připojuje, nemá dostatečná práva k této akci, konektor skončí s chybou;-
transformsurčuje, jak přesně změnit název cílového tématu:-
transforms.AddPrefix.typeurčuje, že použijeme regulární výrazy; -
transforms.AddPrefix.regex— maska, podle které se přepisuje název cílového tématu; -
transforms.AddPrefix.replacement— to, na co se přepisuje.
-
Více informací o heartbeat a transforms
Ve výchozím nastavení konektor odesílá data do Kafky při každé potvrzené transakci a její LSN (číslo pořadí protokolu) zapisuje do interního tématu offset. Ale co se stane, pokud je konektor nastaven na čtení nejen celé databáze, ale pouze části jejích tabulek (ve kterých se data neaktualizují často)?
- Konektor bude číst WAL soubory a v nich nezjistí potvrzení transakcí v těch tabulkách, které sleduje.
- Proto nebude aktualizovat svou aktuální pozici ani v tématu, ani v replikaci slotu.
- To povede k „udržování“ WAL souborů na disku a možnému vyčerpání veškerého diskového prostoru.
A zde přicházejí na pomoc možnosti heartbeat.interval.ms a heartbeat.action.query. Použití těchto možností ve dvojici umožňuje při každém odeslání heartbeat zprávy provést dotaz na změnu dat v samostatné tabulce. Tím se neustále aktualizuje LSN, na kterém se konektor momentálně nachází (v replikaci slotu). To umožňuje DBMS odstranit WAL soubory, které jsou již nepotřebné. Více informací o fungování možností naleznete v .
Další možnost, která si zaslouží větší pozornost, je transforms. Ačkoli jde spíše o pohodlí a estetično…
Ve výchozím nastavení Debezium vytváří témata podle následující politiky pojmenování: serverName.schemaName.tableName. To nemusí vždy být pohodlné. Možnostmi transforms Můžete pomocí regulárních výrazů určit seznam tabulek, jejichž události je třeba směrovat do tématu se specifickým názvem.
V naší konfiguraci díky Na závěr popisu konfigurace konektoru pro PostgreSQL stojí za to zmínit následující specifika/omezení jeho fungování: Takže nyní nahrajeme naši konfiguraci do konektoru: Zkontrolujeme, že nahrávání proběhlo úspěšně a konektor se spustil: Skvěle: je nastaven a připraven k práci. Nyní se tvářme jako consumer a připojme se k Kafka, poté přidáme a změníme záznam v tabulce: V našem tématu se to zobrazí následujícím způsobem: Velmi dlouhý JSON s našimi změnami V obou případech záznamy sestávají z klíče (PK) záznamu, který byl změněn, a samotné podstaty změn: jaký záznam byl předtím a jaký je nyní. Tento konektor používá standardní mechanismus replikace MongoDB a čte informace z oplog primárního uzlu databáze. Podobně jako v již popsaném konektoru pro PgSQL, i zde se při prvním spuštění vytvoří primární snímek dat, poté se konektor přepne do režimu čtení oplog. Příklad konfigurace: Jak můžete vidět, zde nejsou žádné nové možnosti ve srovnání s předchozím příkladem, ale zkrátilo se jen množství možnosti týkající se připojení k DB a jejich prefixů. Nastavení Otázka odolnosti proti výpadkům a vysoké dostupnosti je v dnešní době zvlášť důležitá — zejména když hovoříme o datech a transakcích, a sledování změn dat v tomto ohledu nehraje vedlejší roli. Pojďme se podívat, co se může pokazit a co se bude dít s Debezium v každém z těchto případů. Existují tři varianty selhání: Existují však výjimky. Pokud byl konektor delší dobu v odpojeném stavu (nebo se nemohl spojit s instancí MongoDB), a oplog byl v té době rotován, po obnovení připojení konektor klidně pokračuje ve čtení dat od první dostupné pozice, což způsobí, že část dat se objeví v Kafka ne . Debezium — moje první zkušenost s CDC systémy a celkově velmi pozitivní. Projekt mě zaujal podporou hlavních DBMS, jednoduchostí konfigurace, podporou clusteringu a aktivní komunitou. Zainteresovaným praktikům doporučuji se seznámit s příručkami pro a . Ve srovnání s JDBC konektorem pro Kafka Connect je hlavní výhodou Debezium, že změny se čtou ze žurnálů DBMS, což umožňuje získávat data s minimálním zpožděním. JDBC konektor (dodávaný s Kafka Connect) provádí dotazy na sledovanou tabulku v pevných intervalech a (z tohoto důvodu) negeneruje zprávy při odstraňování dat (jak mohou být dotazována data, která neexistují?). Pro řešení podobných úloh se můžete podívat na následující řešení (kromě Debezium): Přečtěte si také náš blog: Zdroj: habr.comtransforms se děje následující: všechny CDC události z monitorované databáze se dostanou do tématu s názvem data.cdc.dbname. V opačném případě (bez těchto nastavení) by Debezium podle defaultu vytvářel samostatné téma pro každou tabulku typu: pg-dev.public..
Omezení konektoru
Aplikace konfigurace
curl -i -X POST -H "Accept:application/json"
-H "Content-Type:application/json" http://localhost:8083/connectors/
-d @pg-con.json$ curl -i http://localhost:8083/connectors/pg-connector/status
HTTP/1.1 200 OK
Date: Thu, 17 Sep 2020 20:19:40 GMT
Content-Type: application/json
Content-Length: 175
Server: Jetty(9.4.20.v20190813)
{"name":"pg-connector","connector":{"state":"RUNNING","worker_id":"172.24.0.5:8083"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"172.24.0.5:8083"}],"type":"source"}$ kafka/bin/kafka-console-consumer.sh
--bootstrap-server kafka:9092
--from-beginning
--property print.key=true
--topic data.cdc.dbname
postgres=# insert into customers (id, first_name, last_name, email) values (1005, 'foo', 'bar', 'foo@bar.com');
INSERT 0 1
postgres=# update customers set first_name = 'egg' where id = 1005;
UPDATE 1{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":null,
"after":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600374991648,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":602,
"lsn":34088472,
"xmin":null
},
"op":"c",
"ts_ms":1600374991762,
"transaction":null
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
}
],
"optional":false,
"name":"data.cdc.dbname.Key"
},
"payload":{
"id":1005
}
}{
"schema":{
"type":"struct",
"fields":[
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"before"
},
{
"type":"struct",
"fields":[
{
"type":"int32",
"optional":false,
"field":"id"
},
{
"type":"string",
"optional":false,
"field":"first_name"
},
{
"type":"string",
"optional":false,
"field":"last_name"
},
{
"type":"string",
"optional":false,
"field":"email"
}
],
"optional":true,
"name":"data.cdc.dbname.Value",
"field":"after"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"version"
},
{
"type":"string",
"optional":false,
"field":"connector"
},
{
"type":"string",
"optional":false,
"field":"name"
},
{
"type":"int64",
"optional":false,
"field":"ts_ms"
},
{
"type":"string",
"optional":true,
"name":"io.debezium.data.Enum",
"version":1,
"parameters":{
"allowed":"true,last,false"
},
"default":"false",
"field":"snapshot"
},
{
"type":"string",
"optional":false,
"field":"db"
},
{
"type":"string",
"optional":false,
"field":"schema"
},
{
"type":"string",
"optional":false,
"field":"table"
},
{
"type":"int64",
"optional":true,
"field":"txId"
},
{
"type":"int64",
"optional":true,
"field":"lsn"
},
{
"type":"int64",
"optional":true,
"field":"xmin"
}
],
"optional":false,
"name":"io.debezium.connector.postgresql.Source",
"field":"source"
},
{
"type":"string",
"optional":false,
"field":"op"
},
{
"type":"int64",
"optional":true,
"field":"ts_ms"
},
{
"type":"struct",
"fields":[
{
"type":"string",
"optional":false,
"field":"id"
},
{
"type":"int64",
"optional":false,
"field":"total_order"
},
{
"type":"int64",
"optional":false,
"field":"data_collection_order"
}
],
"optional":true,
"field":"transaction"
}
],
"optional":false,
"name":"data.cdc.dbname.Envelope"
},
"payload":{
"before":{
"id":1005,
"first_name":"foo",
"last_name":"bar",
"email":"foo@bar.com"
},
"after":{
"id":1005,
"first_name":"egg",
"last_name":"bar",
"email":"foo@bar.com"
},
"source":{
"version":"1.2.3.Final",
"connector":"postgresql",
"name":"dbserver1",
"ts_ms":1600375609365,
"snapshot":"false",
"db":"postgres",
"schema":"public",
"table":"customers",
"txId":603,
"lsn":34089688,
"xmin":null
},
"op":"u",
"ts_ms":1600375609778,
"transaction":null
}
}
INSERT: hodnota před (before) je rovna null, a po ní je řetězec, který byl vložen. AKTUALIZACE: v payload.before se zobrazuje předchozí stav řetězce, a v payload.after — nové s podstatou změn.2.2 MongoDB
{
"name": "mp-k8s-mongo-connector",
"config": {
"connector.class": "io.debezium.connector.mongodb.MongoDbConnector",
"tasks.max": "1",
"mongodb.hosts": "MainRepSet/mongo:27017",
"mongodb.name": "mongo",
"mongodb.user": "debezium",
"mongodb.password": "dbname",
"database.whitelist": "db_1,db_2",
"transforms": "AddPrefix",
"transforms.AddPrefix.type": "org.apache.kafka.connect.transforms.RegexRouter",
"transforms.AddPrefix.regex": "mongo.([a-zA-Z_0-9]*).([a-zA-Z_0-9]*)",
"transforms.AddPrefix.replacement": "data.cdc.mongo_$1"
}
}transforms tentokrát dělají následující: mění název cílového topiku podle vzoru <server_name>.<db_name>.<collection_name> v data.cdc.mongo_<db_name>.Odolnost proti výpadkům
Závěr
P.S.
