

Jak backendový vývojář zjistí, že SQL dotaz bude na „produ“ fungovat dobře? Ve velkých nebo rychle rostoucích firmách je přístup k „produ“ daleko ne pro všechny. A i s přístupem není možné bezbolestně zkontrolovat všechny dotazy, a vytvoření kopie databáze často trvá hodiny. Abychom tyto problémy vyřešili, vytvořili jsme umělého DBA – Joea. Již úspěšně implementován v několika firmách a pomáhá nejednomu desítku vývojářů.
Video:
Ahoj všichni! Jmenuji se Anatolij Stansler. Pracuji ve firmě . Zaměřujeme se na to, abychom urychlili proces vývoje tím, že odbouráváme zpoždění spojená s prací s Postgres, vývojářům, DBA a QA.
Máme skvělé klienty a dnes bude část prezentace věnována případům, se kterými jsme se v práci s nimi setkali. Povědím vám, jak jsme jim pomohli vyřešit dost závažné problémy.
Když vyvíjíme a děláme složité zátěžové migrace, klademe si otázku: „Vyjde tato migrace?“ Používáme review, využíváme znalosti zkušenějších kolegů, odborníků na DBA. A ti mohou říct – vyjde nebo nevyjde.
Ale možná by bylo lepší, kdybychom to mohli otestovat sami na plnohodnotných kopiích. A dnes se právě budeme bavit o tom, jaké jsou teď přístupy k testování, jak to lze dělat lépe a s jakými nástroji. A také se podíváme na výhody a nevýhody těchto přístupů a co zde můžeme opravit.
Kdo někdy prováděl indexy nebo nějaké změny přímo na prod? Docela dost. A u koho to vedlo k tomu, že došlo ke ztrátě dat nebo k výpadkům? Potom znáte tuto bolest. Díky bohu, zálohy existují.
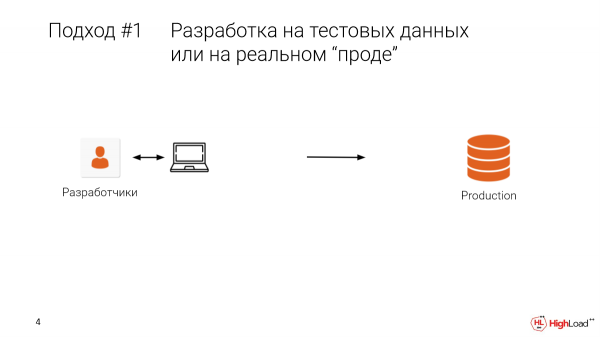
První přístup – to je testování na produ. Nebo když se vývojář posadí s lokálního stroje, má testovací data, je zde nějaký omezený vzorek. A my nasazujeme na prod, a dostáváme takovou situaci.
To bolí, to je drahé. Možná, že to takto lépe nedělat.
Ale jak to udělat lépe?
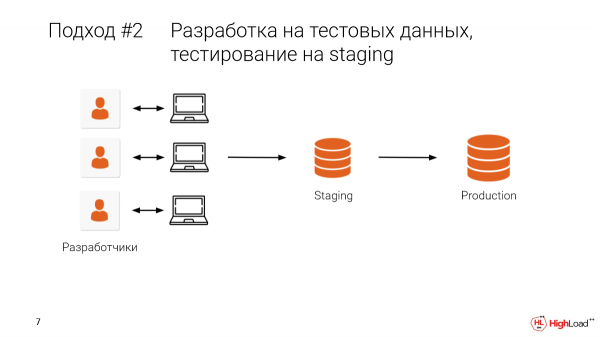
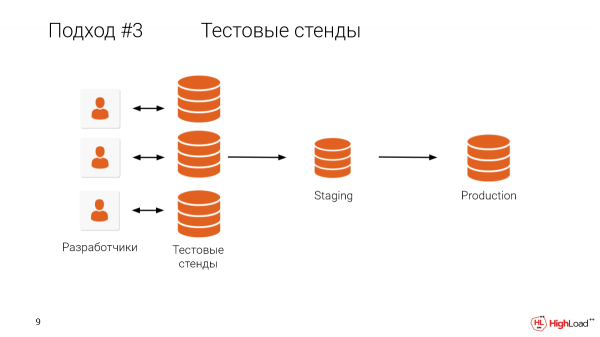
Pojďme vzít staging a vyčlenit tam nějakou část produ. Nebo v lepším případě vezmeme skutečný prod, všechna data. A po lokálním vývoji budeme navíc ověřovat ještě na stagingu.
To nám umožní odstranit nějakou část chyb, t. j. zabránit jim na produ.
Jaké jsou problémy?
- Problém je v tom, že tento staging sdílíme s kolegy. A velmi často se stává, že uděláte nějakou změnu, bum – a žádná data nejsou, práce vyjde vniveč. Staging byl mnoha terabajtový. A musíte dlouho čekat, než se znovu rozběhne. A rozhodujeme se to dokončit zítra. Všechno, máme zastavený vývoj.
- A samozřejmě tam u nás pracuje spousta kolegů, spousta týmů. A je nutné to dohadovat ručně. A to je nepohodlné.
A je třeba říct, že máme jen jednu šanci, jeden pokus, pokud chceme provést nějaké změny v databázi, sáhnout na data, změnit strukturu. A pokud něco nevyjde, pokud dojde k chybě při migraci, tak se rychle již nevrátíme zpět.
Je to lepší než předchozí přístup, ale stále existuje velká pravděpodobnost, že nějaká chyba se dostane do produkce.
Co nám brání dát každému vývojáři testovací prostředí, plnou kopii? Myslím, že je jasné, co brání.
Kdo má databázi větší než terabajt? Víc než polovina sálu.
A je jasné, že udržovat stroje pro každého vývojáře, když je tak velká produkce, je velmi drahé, navíc ještě i časově náročné.
Máme klienty, kteří si uvědomili, jak důležité je testovat všechny změny na plných kopiích, ale jejich databáze je menší než terabajt, a prostředky na to, aby měli testovací prostředí pro každého vývojáře, nejsou. Proto si musí stahovat dumpy lokálně na svůj stroj a testovat tímto způsobem. To zabere spoustu času.
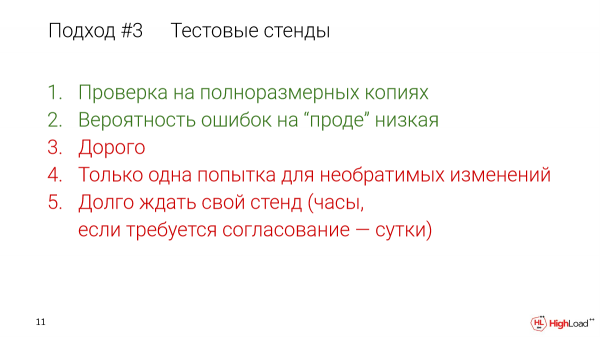
I kdybyste to dělali uvnitř infrastruktury, stáhnout jeden terabajt dat za hodinu – to už je velmi dobré. Ale používají logické dumpy, stahují lokálně z cloudu. Pro ně je rychlost kolem 200 gigabajtů za hodinu. A ještě potřebují čas, aby se z logického dumpu rozběhli, nasadili indexy atd.
Ale tento přístup používají, protože to umožňuje udržovat prod spolehlivým.
Co můžeme udělat zde? Pojďme to udělat tak, aby testovací prostředí byla levná a dáme každému vývojáři jeho vlastní testovací prostředí.
A to je možné.
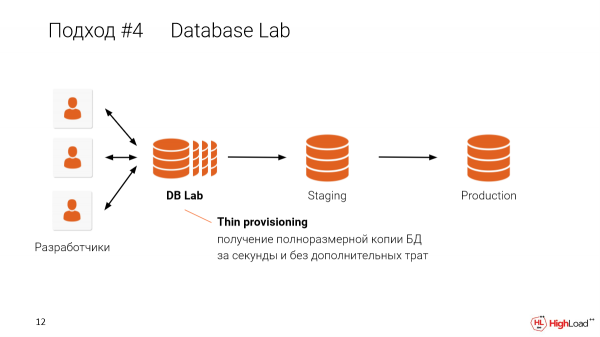
A v tomto přístupu, když vytváříme tenké klony pro každého vývojáře, můžeme to sdílet na jednom stroji. Například, pokud máte čtyřterabytovou databázi a chcete ji poskytnout 10 vývojářům, nemusíte mít 10 x čtyřterabytových databází. Stačí vám jeden stroj, abyste dělali tenké izolované kopie pro každého vývojáře, využívající jeden stroj. Jak to funguje, povím později.
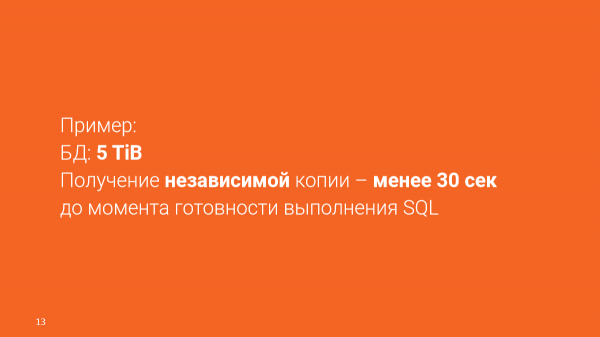
Skutečný příklad:
DB – 4,5 terabytu.
Můžeme získat nezávislé kopie za 30 sekund.
Nemusíte čekat na testovací prostředí a záviset na tom, jak velké je. Můžete to získat během sekund. Bude to plně izolované prostředí, které sdílí data mezi sebou.
To je skvělé. Zde mluvíme o kouzlu a paralelním vesmíru.
V našem případě to funguje díky systému OpenZFS.
OpenZFS je copy-on-write souborový systém, který již z krabice podporuje snapshoty a klony. Je spolehlivý a škálovatelný. Je velmi snadné jej spravovat. Doslova ho můžete nasadit ve dvou příkazech.
Existují i jiné možnosti:
LVM,
SAN (například Pure Storage).
Database Lab, o kterém mluvím, je modulární. Lze ho implementovat při použití těchto variant. Ale zatím jsme se soustředili na OpenZFS, protože konkrétně s LVM byly problémy.
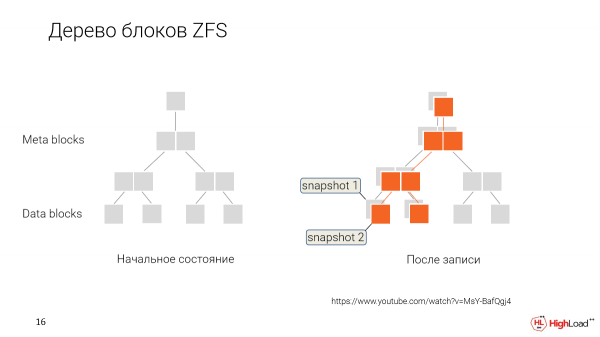
Jak to funguje? Místo toho, abychom každý čas znovu přepisovali data, když je měníme, ukládáme je, tím, že označíme, že tyto nové údaje patří k novému časovému bodu, novému snapshotu.
A pokud se později chceme vrátit zpět nebo chceme udělat nový klon z nějaké starší verze, prostě řekneme: "Dobře, dejte nám tyto bloky dat, které jsou takto označeny."
A tento uživatel bude pracovat s tímto souborem dat. Bude je postupně měnit a vytvářet své snapshoty.
A dojde k větvení. Každý vývojář v našem případě bude mít možnost mít svůj vlastní klon, který editují, a ty údaje, které jsou společné, budou sdíleny mezi všemi.
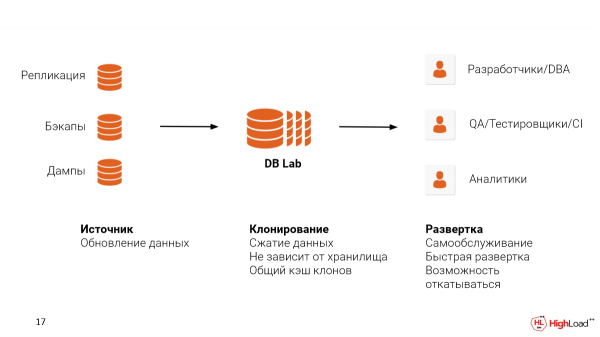
Abychom mohli nasadit takový systém, musíme vyřešit dva problémy:
První je zdroj dat, odkud je budete brát. Můžete nastavit replikaci s produkcí. Můžete použít už nastavené zálohy, doufám, že máte. WAL-E, WAL-G nebo Barman. A i když používáte nějaké cloudové řešení, jako RDS nebo Cloud SQL, můžete používat logické dumpy. Ale stále vám doporučujeme používat zálohy, protože při takovém přístupu si zachováte také fyzickou strukturu souborů, což vám umožní být blíže k metrikám, které byste viděli na produkci, abyste odhalili problémy, které existují.
Druhý je místo, kde chcete hostit Database Lab. Může to být cloud, může to být on-premise. Je důležité říci, že ZFS podporuje kompresi dat. A to dělá poměrně dobře.
Představte si, že každý takový klon, v závislosti na operacích, které s databází provádíme, bude mít nějaký dev běžící. Pro tento dev bude také potřeba místo. Ale díky tomu, že jsme vzali databázi o velikosti 4,5 terabajtu, ZFS ji zmenší na 3,5 terabajtu. V závislosti na nastavení to lze variabilně měnit. A pro dev nám ještě zbude místo.
Takový systém lze využít pro různé případy.
Toto jsou vývojáři, DBA pro kontrolu dotazů, pro optimalizaci.
Můžeme to použít v QA testování pro ověření konkrétní migrace před tím, než ji nasadíme do produkce. A také můžeme vytvářet speciální prostředí pro QA s reálnými daty, kde mohou otestovat nové funkce. A to bude trvat sekundy místo toho, abychom čekali hodiny, nebo možná i dny v některých jiných případech, kde se nevyužívají tenké kopie.
A je tu ještě jeden případ. Pokud ve firmě není nastavena analytická systém, můžeme vyčlenit tenký klon produktové databáze a předat ho pro dlouhé dotazy nebo pro speciální indexy, které mohou být v analytice použity.
S takovým přístupem:
Nízká pravděpodobnost chyb na "produkcí", protože jsme všechny změny otestovali na plnohodnotných datech.
Vytváříme kulturu testování, protože nyní není potřeba hodiny čekat na vlastní stand.
A nejsou překážky, není čekání mezi testováními. Můžete skutečně jít a ověřit. A bude to lepší, protože zrychlíme vývoj.
Bude méně refaktoringu. Méně chyb se dostane do produkce. Méně jich pak refaktorujeme.
Můžeme provádět nevratné změny. To v standardních přístupech chybí.
- Je to výhodné, protože sdílíme zdroje testovacích prostředí.
To je dobré, ale co ještě bychom mohli urychlit?
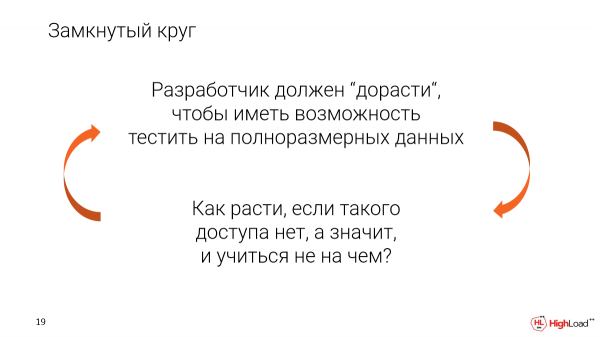
Díky tomuto systému můžeme významně snížit vstupní práh pro takové testování.
Existuje uzavřený kruh, kdy vývojář, aby získal přístup k reálným plnohodnotným datům, musí stát se expertem. Musí mu být důvěřováno s takovým přístupem.
Ale jak růst, pokud to není? A co když máš přístup pouze k velmi malému setu testovacích dat? Pak není možné získat skutečnou zkušenost.
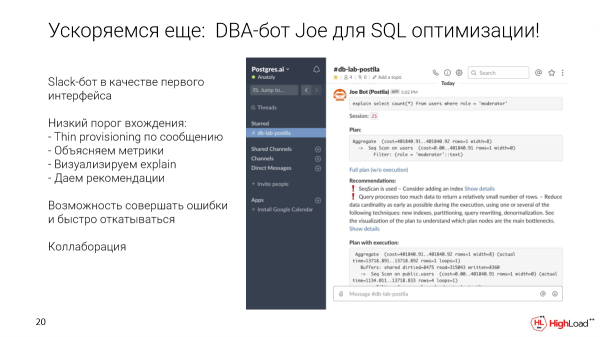
Jak se dostat z tohoto kruhu? Jako první rozhraní, které je pohodlné pro vývojáře jakékoli úrovně, jsme zvolili Slack bota. Ale může to být jakékoli jiné rozhraní.
Co to umožňuje? Můžete vzít konkrétní dotaz a poslat ho do speciálního kanálu pro databázi. Automaticky během sekund rozvineme tenký klon. Spustíme tento dotaz. Shromáždíme metriky a doporučení. Ukážeme vizualizaci. A dále tento klon zůstane, aby bylo možné tento dotaz nějak optimalizovat, přidat indexy atd.
A také nám Slack dává možnosti pro spolupráci přímo ze zásobníku. Protože to je prostě kanál, můžeme tam přímo v threadu pro tento dotaz začít diskutovat, oslovit své kolegy, DBA, kteří jsou uvnitř firmy.
Ale existují samozřejmě i problémy. Protože je to reálný svět a používáme server, na kterém hostíme najednou více klonů, musíme omezit množství paměti a výkonu CPU, které jsou klonům k dispozici.
Ale abychom tyto testy byly věrohodné, je třeba nějak tuto problematiku vyřešit.
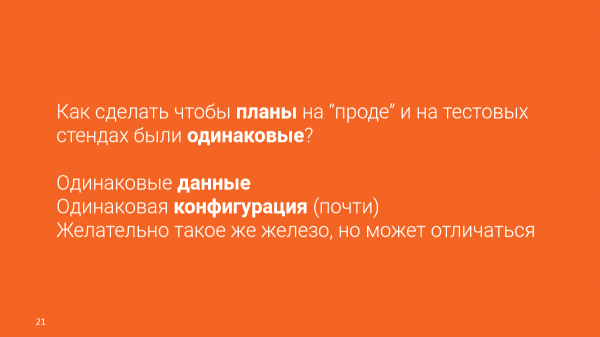
Je jasné, že důležitým faktorem jsou shodná data. Ale ta už máme. A chceme dosáhnout shodné konfigurace. A můžeme tak prakticky obdobnou konfiguraci poskytnout.
Bylo by skvělé mít stejný hardware jako na produkci, ale může se lišit.
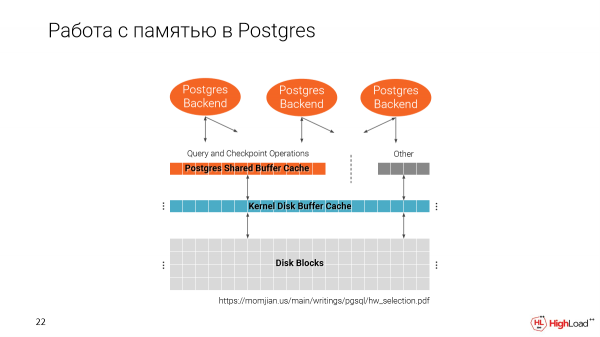
Pojďme si připomenout, jak PostgreSQL pracuje s pamětí. Máme dva cache. Jeden od souborového systému a jeden vlastní PostgreSQL, tedy Shared Buffer Cache.
Je důležité poznamenat, že Shared Buffer Cache je alokováno při startu Postgres v závislosti na velikosti, kterou nastavíte v konfiguraci.
A druhý cache používá veškerý dostupný prostor.
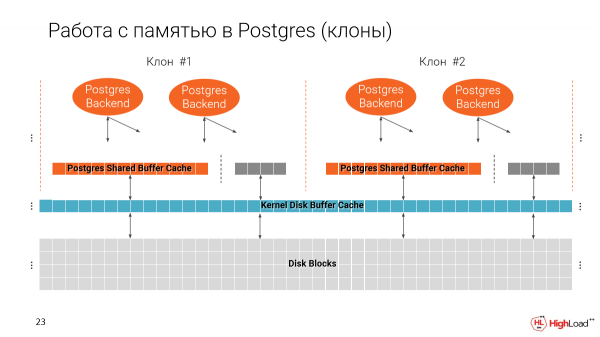
A když děláme několik klonů na jednom stroji, postupně zaplňujeme paměť. A ideálně by Shared Buffer Cache mělo být 25 % z celkového objemu paměti dostupné na stroji.
A tak vychází, že pokud tento parametr nezměníme, můžeme na jednom stroji spustit pouze 4 instance, tedy 4 takové tenké klony. A to je samozřejmě špatně, protože bychom je chtěli mít mnohem více.
Na druhou stranu, Buffer Cache se používá pro vykonávání dotazů, pro indexy, tedy plán závisí na tom, jaké velikosti máme cache. A pokud tento parametr jednoduše snížíme, plány se mohou výrazně změnit.
Například, pokud máme na prod velké cache, Postgres bude přednostně používat index. A pokud ne, pak dojde k SeqScan. A jaký by měl smysl, kdyby se naše plány neshodovaly?
Ale zde se dostáváme k řešení, že plán v Postgres ve skutečnosti nezávisí na konkrétní velikosti zadané v Shared Buffer, ale závisí na effective_cache_size.
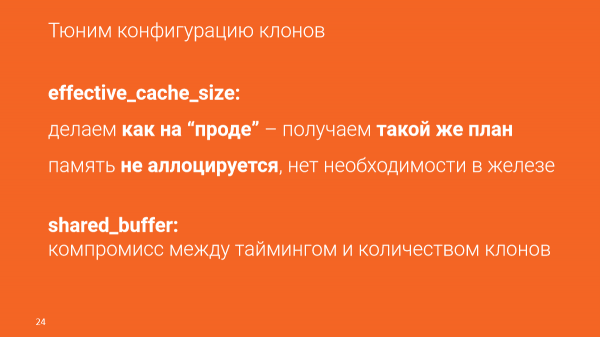
Effective_cache_size je předpokládaný objem cache, který máme k dispozici, tedy součet Buffer Cache a cache souborového systému. To je nastaveno v konfiguraci. A tato paměť není alokována.
A díky tomuto parametru můžeme jakoby oklamat Postgres tím, že mu řekneme, že máme k dispozici spoustu dat, i když tato data nemáme. Takže plány budou plně odpovídat produkci.
Ale to může ovlivnit časování. A optimalizujeme dotazy podle časování, ale je důležité, že časování závisí na mnoha faktorech:
Závisí na tom zatížení, které momentálně existuje na produ.
Závisí na charakteristikách samotného stroje.
A to je nepřímý parametr, ale ve skutečnosti můžeme optimalizovat právě podle množství dat, které tento dotaz přečte, abychom získali výsledek.
A pokud chceme, aby časování bylo co nejblíže tomu, co uvidíme v produkci, musíme vzít co nejpodobnější hardware a možná dokonce víc, aby se všechny klony vešly. Ale to je kompromis, tzn. dostanete stejné plány, uvidíte, kolik dat konkrétní dotaz přečte, a budete moci učinit závěr – zda je dotaz dobrý (nebo migrace), nebo špatný, a je třeba ho ještě optimalizovat.
Pojďme si podrobněji rozebrat, jak probíhá optimalizace s Joem.
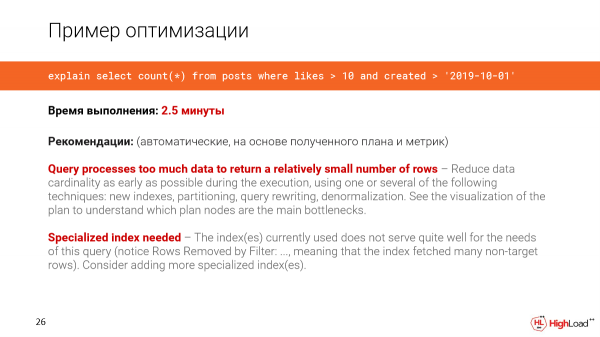
Vezmeme si dotaz z reálného systému. V tomto případě databáze má 1 terabajt. A chceme spočítat počet nových příspěvků, které měly více než 10 lajků.
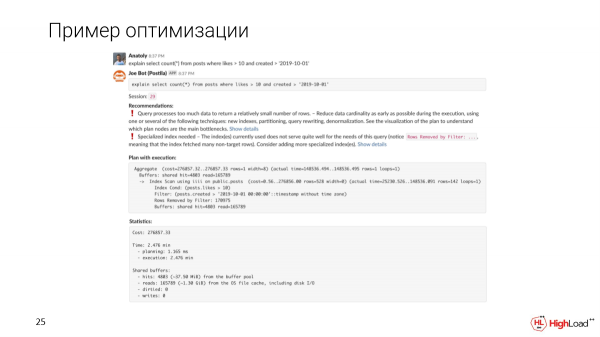
Napíšeme zprávu do kanálu, pro nás se rozběhne klon. A uvidíme, že takový dotaz se zpracuje za 2,5 minuty. To je první, co si všimneme.
Joe ukáže automatická doporučení na základě plánu a metrik.
Uvidíme, že dotaz zpracovává příliš mnoho dat, aby získal relativně malé množství řádků. A potřebujeme nějaký specializovaný index, protože jsme si všimli, že v dotazu je příliš mnoho filtrovaných řádků.
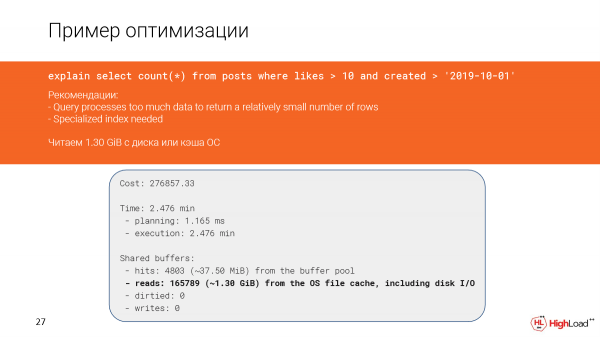
Pojďme se podívat podrobněji, co se stalo. Opravdu vidíme, že jsme přečetli téměř 1,5 gigabytu dat z filesového cache nebo dokonce z disku. A to není dobré, protože jsme získali pouze 142 řádků.
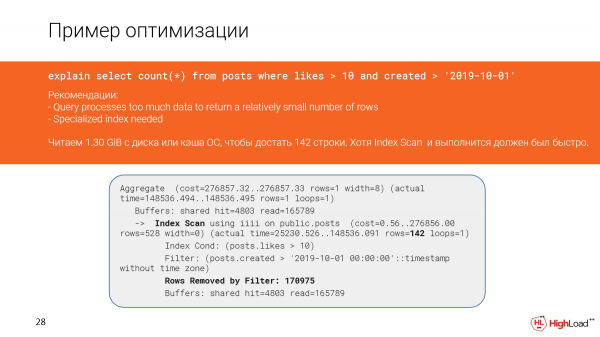
A zdálo by se, že zde máme index scan a mělo to rychle fungovat, ale protože jsme filtrovali příliš mnoho řádků (museli jsme je počítat), dotaz se zpracoval pomalu.
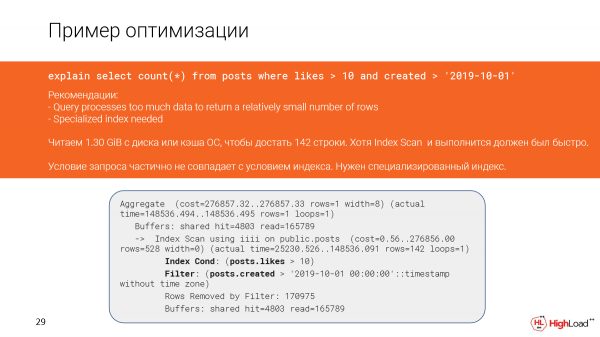
A k tomu došlo v plánu, protože částečně nesouhlasí podmínky v dotazu a podmínky v indexu.
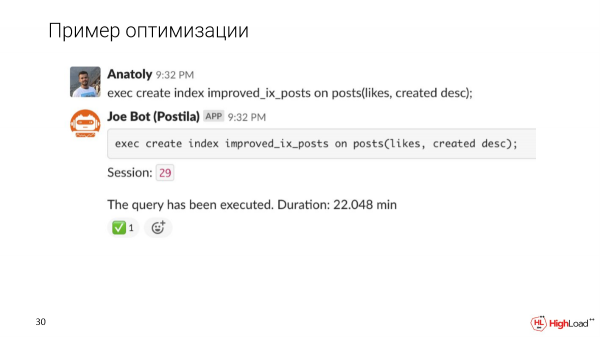
Pojďme se pokusit vytvořit index přesněji a podívejme se, jak se změní výkon dotazu po tomto.
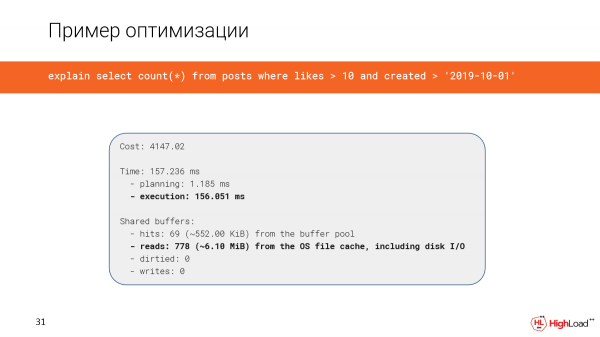
Vytvoření indexu trvalo dost dlouho, ale nyní kontrolujeme dotaz a vidíme, že čas místo 2,5 minuty se snížil na pouhých 156 milisekund, což je docela dobré. A čteme pouze 6 megabajtů dat.
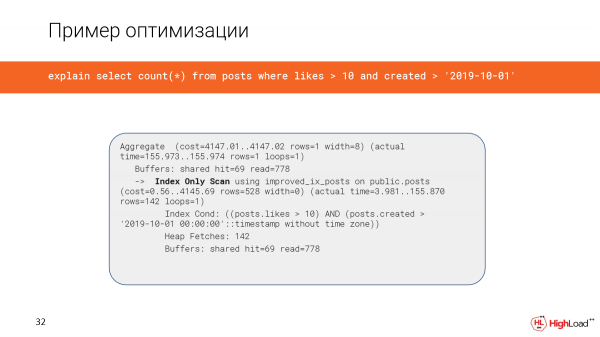
A nyní používáme index only scan.
Další důležitou záležitostí je, že chceme plán představit nějakým srozumitelnějším způsobem. U nás jsme implementovali vizualizaci pomocí Flame Graphs.
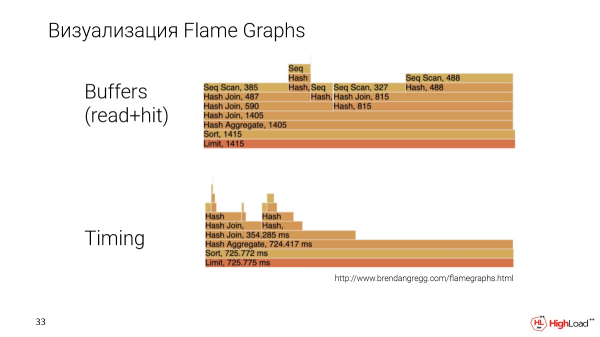
To je jiný dotaz, bohatší. A Flame Graphs vytváříme na základě dvou parametrů: množství dat, které konkrétní uzel v plánu přečetl, a časování, tzn. čas vykonání uzlu.
Zde můžeme porovnávat konkrétně uzly mezi sebou. Bude jasné, který z nich zabírá více nebo méně místa, což bývá obvykle složité realizovat jinými způsoby vizualizace.
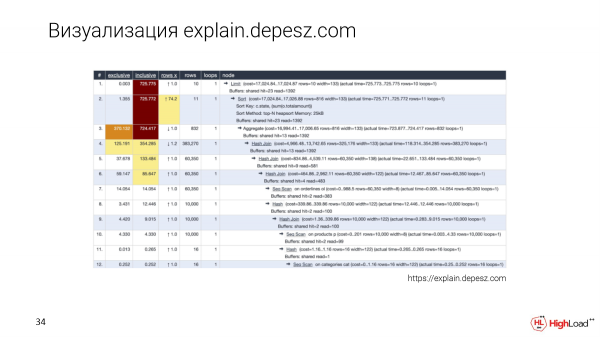
Samozřejmě, všichni znají explain.depesz.com. Dobrou funkcí této vizualizace je, že uchováváme textový plán a také vytrháváme některé hlavní parametry do tabulky, abychom je mohli seřadit.
A vývojáři, kteří se do této problematiky ještě hlouběji nepouštěli, také využívají explain.depesz.com, protože je pro ně jednodušší pochopit, které metriky jsou důležité, a které nikoli.
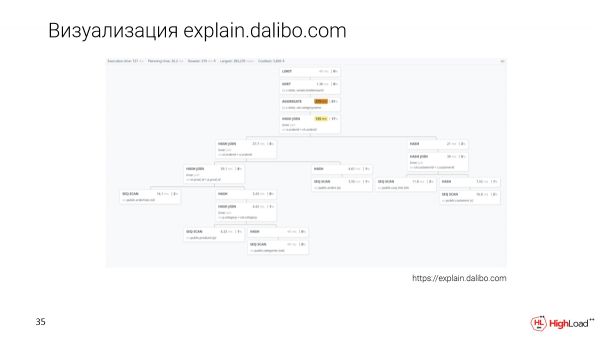
Existuje nový přístup k vizualizaci – explain.dalibo.com. Dělají stromovou vizualizaci, ale zde je velmi těžké porovnávat uzly mezi sebou. Dobře lze pochopit strukturu, ale pokud bude velký dotaz, bude nutné scrollovat tam a zpět, ale také je to možnost.
Kolaborace
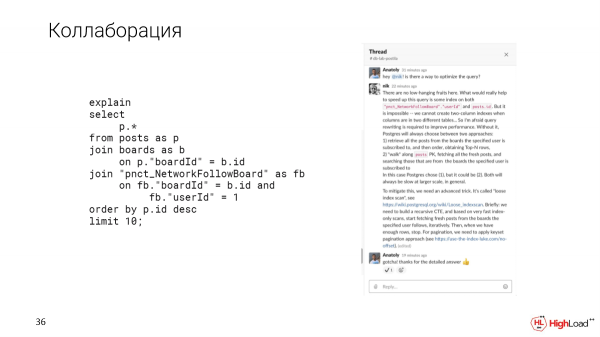
A jak jsem již řekl, Slack nám umožňuje kolaboraci. Například, pokud jsme narazili na složitý dotaz, který není jasné, jak optimalizovat, můžeme tento problém upřesnit v threadu ve Slacku se svými kolegy.
Myslíme si, že je důležité testovat na plných datech. K tomu jsme vytvořili nástroj Update Database Lab, který je dostupný jako open source. Můžete také používat bota Joe. Můžete si ho vzít hned teď a implementovat u sebe. Všechny návody jsou tam dostupné.
Je také důležité poznamenat, že samotné řešení není ničím revolučním, protože existuje Delphix, ale to je enterprise řešení. Je to zcela uzavřené a velmi drahé. My se specializujeme na Postgres. Tohle všechno jsou produkty open source. Připojte se k nám!
Tímto končím. Děkuji!
Otázky
Dobrý den! Děkuji za prezentaci! Velmi zajímavé, zejména pro mě, protože jsem podobný problém řešil před nějakým časem. A proto mám celou řadu otázek. Doufám, že se mi podaří alespoň část z nich položit.
Zajímalo by mě, jak počítáte místo pro toto prostředí? Technologie předpokládá, že za určitých okolností mohou vaše klony vyrůst na maximální velikost. Zjednodušeně řečeno, pokud máte deseterabajtovou databázi a 10 klonů, je snadné modelovat situaci, kdy každý klon bude mít 10 unikátních dat. Jak počítáte toto místo, tedy tu deltu, o které jste mluvili, ve které budou tyto klony žít?
Dobrá otázka. Tady je důležité sledovat konkrétní klony. A pokud nějaký klon udělá příliš velkou změnu a začne růst, můžeme nejprve uživatele varovat, nebo okamžitě tento klon zastavit, abychom se vyhnuli fail-situaci.
Ano, mám na to doplňující otázku. Tedy, jak zajišťujete životní cyklus těchto modulů? U nás je to problém a celá samostatná kapitola. Jak se to děje?
Každý klon má nějakou dobu TTL. V zásadě máme pevně stanovené TTL.
Jaké, pokud to není tajné?
1 hodina, tedy idle – 1 hodina. Pokud se nepoužívá, tak ho zrušíme. Ale tady žádné překvapení není, protože klon můžeme spustit během sekund. A pokud ho budeme potřebovat znovu, tak – prosím.
Zajímá mě také volba technologií, protože my například paralelně používáme několik metod z různých důvodů. Proč právě ZFS? Proč jste nepoužili LVM? Zmínili jste, že s LVM byly problémy. Jaké to byly problémy? Podle mě je nejoptimálnějším řešením možnost s SAN z hlediska výkonu.
Jaký je hlavní problém se ZFS? V tom, že musíte běžet na jednom hostiteli, tedy všechny instance budou žít v rámci jednoho operačního systému. A v případě SAN můžete připojovat různá zařízení. A úzkým hrdlem jsou pouze ty bloky, které jsou na SAN. A otázka výběru technologií je velmi zajímavá. Proč ne LVM?
O LVM můžeme konkrétně diskutovat na meetupu. Co se týče SAN, to je jednoduše drahé. Systém ZFS můžeme implementovat kdekoli. Můžete si ji rozběhnout na svém stroji. Můžete si jednoduše stáhnout repozitář a nasadit ji. ZFS se instaluje prakticky všude, pokud mluvíme o Linuxu. Tedy dostáváme velmi flexibilní řešení. A ZFS sám o sobě nabízí mnoho možností. Můžete nahrávat tolik dat, kolik chcete, připojit velké množství disků, jsou tu snapshoty. A jak jsem už zmínil, je to snadné na administraci. Tedy se zdá být velmi příjemné na používání. Je to osvědčené, má dlouhou historii. Má velmi velkou komunitu, která roste. ZFS je velmi spolehlivé řešení.
Nikolaj Samokhvalov: Mohu to ještě okomentovat? Jmenuji se Nikolaj, spolupracuji s Anatolijem. Souhlasím, že SAN je skvělý. A někteří naši klienti mají Pure Storage a podobně.
Anatolij správně poznamenal, že se zaměřujeme na modularitu. A v budoucnu bychom mohli realizovat jediné rozhraní – vytvořte snapshot, vytvořte klon, zničte klon. To vše je snadné. A úložné systémy jsou skvělé, pokud jsou k dispozici.
Ale ZFS je dostupné pro každého. Už je dost Delphix, mají 300 zákazníků. Z toho v Fortune 100 – 50 zákazníků, tj. zaměřují se na NASA atd. Je načase, aby tuto technologii měli všichni. A proto máme open source Core. Máme část rozhraní, která není open source. To je platforma, kterou předvedeme. Ale chceme, aby to bylo dostupné každému. Chceme udělat revoluci, aby všichni testovači přestali hádat na noteboocích. Musíme psát SELECT a okamžitě vidět, že je pomalý. Už není čas čekat, až o tom DBA poví. To je hlavní cíl. A myslím, že k tomu všichni dojdeme. A tohle děláme, aby to měli všichni. Proto ZFS, protože bude dostupné všude. Děkujeme komunitě za řešení problémů a za to, že tam je open source licence atd.
Dobrý den! Děkuji za prezentaci! Jmenuji se Maxim. Řešili jsme stejné problémy. U nás jsme to vyřešili. Jak rozdělujete zdroje mezi těmito klony? Každý klon může v každém okamžiku řešit své vlastní úkoly: jeden testuje něco jiného, druhý něco jiného, někdo buduje index, jiný má těžkou job. Pokud jde o CPU, to se ještě dá rozdělit, ale jak to děláte s IO?
A druhá otázka o odlišnosti prostředí. Představme si, že tady mám ZFS a všechno je skvělé, ale u klienta na production není ZFS, ale například ext4. Jak v tomto případě?
Otázky jsou velmi dobré. Trochu jsem zmínil tento problém s tím, že rozdělujeme zdroje. A řešení spočívá v následujícím. Představte si, že testujete na stagingu. Může se stát, že někdo dává jednu zátěž a někdo jiný druhou. A nakonec vidíte nejasné metriky. Stejný problém se může stát s produkcí. Když chcete ověřit nějaký dotaz a vidíte, že s ním je nějaký problém – je pomalý, tak ve skutečnosti problém nebyl v dotazu, ale v tom, že byla nějaká paralelní zátěž.
A proto je důležité zaměřit se na to, jaký bude plán, jakými kroky se v plánu vydáme a kolik dat pro to shromáždíme. To, že máme disky například zatížené něčím, ovlivní konkrétně časování. Ale podle množství dat můžeme posoudit, jak náročný je tento dotaz. Není tak důležité, že zároveň bude i nějaké provádění.
Mám dvě otázky. Tohle je opravdu skvělá věc. Byly nějaké případy, kdy byly na produkci data kriticky důležitá, například čísla kreditních karet? Je už něco hotového, nebo je to samostatný úkol? A druhá otázka – existuje něco takového pro MySQL?
Co se týče dat. Budeme provádět obfuscaci, i když to nyní neděláme. Ale pokud nasazujete konkrétně Joe, pokud nedáte přístup vývojářům, tak k datům přístup není. Proč? Protože Joe nezobrazuje data. Zobrazuje pouze metriky, plány a všechno. To bylo uděláno záměrně, protože je to jedno z požadavků našeho klienta. Chtěli mít možnost optimalizovat, ale zároveň nedávat přístup každému.
Pokud jde o MySQL. Tento systém lze použít pro cokoliv, co uchovává stav na disku. A protože se zabýváme Postgres, nyní především vytváříme plnou automatizaci pro Postgres. Chceme automatizovat získávání dat z zálohy. Správně konfigurujeme Postgres. Víme, jak zajistit, aby plány odpovídaly atd.
Ale vzhledem k tomu, že je systém rozšiřitelný, bude ho možné použít také pro MySQL. A takové příklady existují. Podobná věc existuje u Yandexu, ale nikde ji nezveřejňují. Používají ji uvnitř Yandex.Metriky. A tam je to právě o MySQL. Ale technologie jsou stejné, ZFS.
Děkuji za přednášku! Mám také pár otázek. Zmínil jste, že klonování lze použít pro analytiku, například k vytváření dodatečných indexů. Můžete trochu podrobněji vysvětlit, jak to funguje?
A druhou otázku položím hned ohledně shodnosti stanic, shodnosti plánů. Plán závisí také na statistikách shromážděných Postgres. Jak tuto problematiku řešíte?
V analýze konkrétních případů nejsou žádné informace, protože jsme je dosud nepoužívali, ale tato možnost existuje. Pokud hovoříme o indexech, představte si, že se spouští dotaz na tabulku s stovkami milionů záznamů a na sloupec, který obvykle není v produkci indexován. A my chceme něco spočítat. Pokud se tento dotaz provede na produkci, existuje možnost, že dojde k výpadku, protože dotaz tam bude zpracovávat minutu.
Dobře, udělejme tenký klon, který se nebojíme zastavit na několik minut. A pro to, aby bylo pohodlnější provádět analýzu, přidáme indexy na ty sloupce, o které máme zájem.
Bude se index každýkrát vytvářet?
Můžeme udělat to, že se dotknete dat, uděláme snapshoty, pak se z tohoto snapshotu budeme obnovovat a spouštět nové dotazy. T. j. lze to udělat tak, že se podaří spouštět nové klony již s nastavenými indexy.
Pokud jde o otázku ohledně statistiky, pokud se obnovujeme z zálohy, pokud děláme replikaci, tak naše statistika bude přesně stejná. Protože máme naprosto celou fyzickou strukturu dat, t. j. přeneseme i data s veškerými metrikami statistiky.
Tady je jiný problém. Pokud používáte cloudové řešení, pak jsou dostupné pouze logické zálohy, protože Google, Amazon nedávají možnost vzít fyzickou kopii. To bude problém.
Děkuji za prezentaci. Zde zazněly dvě dobré otázky ohledně MySQL a rozdělení zdrojů. Ale vlastně to všechno směřuje k tomu, že se jedná o téma nikoli konkrétních databázových systémů, ale obecně souborového systému. A tedy otázky rozdělení zdrojů by měly být také řešeny odtud, nejen na konci, že to je Postgres, ale v souborovém systému, v serveru, v instance.
Můj dotaz je o něčem jiném. Je blíže vícestupňovosti databáze, kde je několik vrstev. Například jsme nastavili aktualizaci desetiterabytového obrazu, probíhá nám replikace. A my konkrétně používáme toto řešení pro databáze. Probíhá replikace a aktualizace dat. Zde paralelně pracuje 100 zaměstnanců, kteří neustále spouštějí tyto různé snapshoty. Co dělat? Jak zajistit, aby nedošlo ke konfliktu, že spustili jedno a pak se souborový systém změnil, a tyto snapshoty se všechny pokazily?
Neodjedou, protože tak ZFS funguje. Můžeme udržovat odděleně v jednom vlákně změny souborového systému, které přicházejí díky replikaci. A držet klony na starých verzích dat, které používají vývojáři. A to nám funguje, s tím je vše v pořádku.
Takže aktualizace proběhne jako další vrstva, a všechny nové snímky budou vycházet z této vrstvy, že?
Z předchozích vrstev, které byly z předchozích replikací.
Předchozí vrstvy odpadnou, ale budou odkazovat na starou vrstvu, a nové obrazy budou brát z poslední vrstvy, která byla získána v aktualizaci?
Obecně řečeno, ano.
Takže jako důsledek budeme mít spoustu vrstev. A v průběhu času je budeme muset zhušťovat?
Ano, přesně tak. Existuje nějaké okno. Udržujeme týdenní snímky. To záleží na tom, jaký máte zdroj. Pokud máte možnost uchovávat mnoho dat, můžete uchovávat snímky po dlouhou dobu. Ty se samy neodstraní. Nebude žádná corrupt data. Pokud snímky zestárnou, jak se nám zdá, tj. to záleží na politice firmy, můžeme je prostě smazat a uvolnit místo.
Dobrý den, děkuji za prezentaci! K otázce Joea: Říkali jste, že zakázník nechtěl dát přístup všem k datům. Přísně vzato, pokud má člověk výsledek Explain Analyze, může data nahlédnout.
Ano, přesně tak. Například můžeme napsat: „SELECT FROM WHERE email = někdo“. Tj. neuvidíme samotná data, ale nějaké nepřímé znaky můžeme vidět. To je třeba si uvědomit. Ale na druhou stranu je to všechno viditelné. Máme audit logů, máme kontrolu od ostatních kolegů, kteří také vidí, čím se vývojáři zabývají. A pokud se někdo pokusí něco takového udělat, přijde za ním bezpečnostní služba a vyřeší to.
Dobrý den! Děkuji za prezentaci! Mám krátkou otázku. Pokud se ve firmě nepoužívá Slack, existuje k němu nějaké propojení, nebo můžeme pro vývojáře nasadit instance, abychom připojili testovací aplikaci k databázím?
V současnosti máme propojení se Slackem, tedy neexistuje žádný jiný messenger, ale rádi bychom podpořili i další messengery. Co můžete udělat? Můžete si rozjet DB Lab bez Joe, používat REST API nebo naši platformu a vytvářet klony a připojovat se pomocí PSQL. Ale to lze udělat pouze pokud jste ochotni poskytnout svým vývojářům přístup k datům, protože zde už žádná obrazovka nebude.
Tu vrstvu nepotřebuji, ale potřebuji tuto schopnost.
Pak ano, to se dá udělat.
Zdroj: habr.com
