

Pozn. přek.: autoři tohoto článku — inženýři z malé české společnosti pipetail. Podařilo se jim sestavit skvělý seznam [ místy banálních, ale stále ] velmi aktuálních problémů a mylných představ spojených s provozem clusterů Kubernetes.
Během let používání Kubernetes jsme měli možnost pracovat s mnoha clustery (jak spravovanými, tak i nespravovanými — na GCP, AWS a Azure). Postupem času jsme si začali všímat, že některé chyby se neustále opakují. Na tom však není nic hanebného: většinu z nich jsme udělali sami!
V článku jsou shrnuty nejčastější chyby a je zmíněno, jak je opravit.
1. Zdroje: požadavky a limity
Tento bod si rozhodně zaslouží největší pozornost a první místo v seznamu.
Požadavek na CPU obvykle buď není vůbec nastaven, nebo má velmi nízkou hodnotu (abychom umístili co nejvíce podů na každý uzel). Takže uzly se dostanou do přetížení. Při vysokém zatížení jsou procesorové zdroje uzlu plně využity a konkrétní pracovní zátěž dostává pouze to, co si "požádala" prostřednictvím CPU throttlingu. To vede ke zvýšení latence v aplikaci, timeoutům a dalším nepříjemným následkům. (Více o tom čtěte v našem dalším nedávném překladu: „“ — pozn. překl.)
BestEffort (extrémně ne doporučeno):
resources: {}Extrémně nízký požadavek na CPU (extrémně ne doporučeno):
   resources:
      Requests:
        cpu: "1m"
Na druhou stranu, pokud existují limity CPU, může to vést k neodůvodněnému vynechávání taktů pody, i když procesor uzlu není plně zatížen. Opět to může vést k zvýšení latence. Pokračují spory o parametru CPU CFS quota v jádře Linuxu a CPU throttlingu v závislosti na nastavených limitech, stejně jako o vypnutí CFS quota… Bohužel, limity CPU mohou způsobit více problémů, než dokážou vyřešit. Více o tom se můžete dozvědět na odkazu níže.
Zbytečné alokování (overcommiting) paměti může vést k větším problémům. Dosahování limitu CPU má za následek vynechávání taktů, zatímco dosažení limitu paměti vede k „usmrcení“ podu. Viděli jste někdy OOMkill? Да, речь идет именно о нем.
Chcete minimalizovat pravděpodobnost této události? Nezapojujte nadměrné množství paměti a využijte Garantovanou QoS (Quality of Service) tím, že nastavíte memory request na limit (jak je uvedeno v příkladu níže). Více informací najdete v (hlavní inženýr Zalando).
Burstable (vyšší pravděpodobnost, že dojde k OOMkilled):
   resources:
      requests:
        memory: "128Mi"
        cpu: "500m"
      limits:
        memory: "256Mi"
cpu: 2Guaranteed:
   resources:
      requests:
        memory: "128Mi"
        cpu: 2
      limits:
        memory: "128Mi"
        cpu: 2
Co může potenciálně pomoci při nastavení zdrojů?
Pomocí metrics-server můžete vidět aktuální využití CPU a paměti pody (a kontejnery uvnitř jich). Pravděpodobně je už používáte. Stačí provést následující příkazy:
kubectl top pods
kubectl top pods --containers
kubectl top nodes
Ukazují však pouze aktuální využití. Můžete získat přibližný obrázek o velikostních řádech, ale nakonec budete potřebovat historii změny metrik v čase (aby bylo možné odpovědět na otázky, jako: „Jaké bylo maximální zatížení CPU?“, „Jaké bylo zatížení včera ráno?“ — atd.). K tomu můžete použít Prometheus, DataDog a další nástroje. Tyto nástroje jednoduše získávají metriky z metrics-server a ukládají je, přičemž uživatel je může dotazovat a vytvářet příslušné grafy.
umožňuje automatizovat tento proces. Sleduje historii využití CPU a paměti a nastavuje nové požadavky a limity na základě těchto informací.
Efektivní využití výpočetních zdrojů je náročný úkol. Je to jako neustále hrát Tetris. Pokud za výpočetní zdroje platíte příliš mnoho při nízkém průměrném využití (řekněme ~10 %), doporučujeme se podívat na produkty založené na AWS Fargate nebo Virtual Kubelet. Ty jsou postaveny na modelu účtování serverless/pay-per-usage, což může v těchto podmínkách vyjít levněji.
2. Liveness a readiness probes
Ve výchozím nastavení nejsou v Kubernetes kontroly stavu liveness a readiness povoleny. A někdy se na jejich povolení zapomíná...
Ale jak jinak můžete vyvolat restart služby v případě nezhojitelné chyby? A jak se load balancer dozví, že je pod připraven přebírat provoz? Nebo že je schopen zpracovat více provozu?
Tyto kontroly se často vzájemně pletou:
- Liveness — kontrola „živosti“, která restartuje pod při neúspěšném ukončení;
- Readiness — kontrola připravenosti, která při neúspěchu odpojí pod od služby Kubernetes (to lze ověřit pomocí
kubectl get endpoints) a na něj nepřichází žádný provoz, dokud další kontrola neskončí úspěšně.
Obě tyto kontroly SE PROVÁDĚJÍ PO CELÝ ŽIVOTNÍ CYKLUS POD’u. To je velmi důležité.
Je rozšířeným omylem, že readiness testy se spouštějí pouze na začátku, aby vyvážec mohl zjistit, že pod je připraven (Ready) a může začít zpracovávat provoz. Nicméně to je pouze jedna z možností jejich použití.
Další možností je zjistit, že provoz na pod je příliš velký a přetěžuje jej (nebo pod provádí výpočetně náročné úkoly). V tomto případě readiness kontrola pomáhá snížit zátěž na pod a „ochladit“ jej. Úspěšné dokončení readiness kontroly v budoucnu umožňuje opět zvýšit zátěž na pod. V tomto případě (při neúspěchu readiness testu) by selhání liveness kontroly bylo velmi kontraproduktivní. Proč restartovat pod, který je zdravý a pracuje naplno?
Proto v některých případech je lepší zcela se vyhnout kontrolám, než je zapnout s nesprávně nastavenými parametry. Jak bylo zmíněno výše, pokud liveness kontrola kopíruje readiness kontrolu, pak jste ve velkých potížích. Možná byste měli nastavit , a nechat stranou.
Oba typy kontrol by neměly selhávat při pádu společných závislostí, jinak to povede k kaskádovému (lavinovému) selhání všech podů. Jinými slovy, .
3. LoadBalancer pro každou HTTP službu
Pravděpodobně máte ve svém clusteru HTTP služby, které byste chtěli přenést do vnějšího světa.
Pokud otevřete službu jako type: LoadBalancer, její kontroler (v závislosti na poskytovateli služeb) poskytne a zaregistruje vnější LoadBalancer (není nutně fungující na L7, spíše na L4), což může ovlivnit náklady (vnější statická adresa IPv4, výpočetní kapacity, účtování za sekundu) kvůli nutnosti vytvořit velké množství těchto zdrojů.
V tomto případě je daleko logičtější použít jeden vnější vyvažovač zátěže, když otevřete služby jako type: NodePort. Nebo, co je ještě lepší, nasadit něco jako nginx-ingress-controller (nebo traefik), který bude jedinečný NodePort endpointem spojeným s externím vyvažovačem zátěže a bude směrovat provoz v klastru pomocí ingress-zdrojů Kubernetes.
Další vnitřní (mikro)služby, které spolu komunikují, mohou "spolupracovat" pomocí typů služeb ClusterIP a vestavěného mechanismu objevování služeb přes DNS. Pouze nepoužívejte jejich veřejné DNS/IP, protože to může ovlivnit latenci a vést k nárůstu nákladů na cloudové služby.
4. Automatické škálování klastru bez ohledu na jeho specifika
Při přidávání uzlů do klastru a jejich odstraňování se nelze spoléhat na některé základní metriky, jako je využití CPU na těchto uzlech. Plánování podu by mělo brát v úvahu celou řadu omezení, jako je affinity podů/uzlů, tainty a tolerace, požadavky na zdroje, QoS atd. Použití externího autoscaleru, který tyto nuance nezohledňuje, může vést k problémům.
Představte si, že určitý pod musí být naplánován, ale všechny dostupné zdroje CPU jsou požadovány/vyčerpány a pod zůstane ve stavu Pending. Externí autoscaler vidí průměrné aktuální zatížení CPU (a ne požadované) a neinitíuje rozšíření (scale-out) — nepřidá další uzel. Výsledkem bude, že tento pod nebude naplánován.
V tomto ohledu je zpětné škálování (scale-in) — odstranění uzlu z klastru — vždy těžší implementovat. Představte si, že máte stateful pod (s připojeným trvalým úložištěm). Persistent-volumy obvykle patří k určité dostupnostní zóně a nereplikuje se v regionu. Pokud tedy externí autoscaler odstraní uzel s tímto pod, plánovač nebude moci naplánovat tento pod na jiný uzel, protože to lze provést pouze v té dostupnostní zóně, kde se nachází trvalé úložiště. Pod zůstane viset ve stavu Pending.
V komunitě Kubernetes je velmi populární . Pracuje v klastru, podporuje API od hlavních poskytovatelů cloudových služeb, bere v úvahu všechna omezení a umí škálovat v uvedených případech. Také je schopen provádět scale-in s dodržením všech nastavených omezení, čímž šetří peníze (které by jinak byly utraceny za nevyužité zdroje).
5. Ignorování možností IAM/RBAC
Vyhněte se používání IAM uživatelů s trvalými tajnými klíči pro stroje a aplikace. Organizujte dočasný přístup pomocí rolí a účtů služeb (service accounts).
Často se setkáváme s tím, že přístupové klíče (a tajné klíče) jsou 'hardcodovány' v konfiguraci aplikace a že se zanedbává rotace tajných klíčů i přes existující přístup k Cloud IAM. Používejte IAM role a účty služeb místo uživatelů, kde je to vhodné.
Zapomeňte na kube2iam a přejděte rovnou k IAM rolím pro účty služeb (jak je popsáno v Štěpán Vraný):
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    eks.amazonaws.com/role-arn: arn:aws:iam::123456789012:role/my-app-role
  name: my-serviceaccount
  namespace: default
Jedna anotace. Není to tak složité, že?
Navíc, nepřiřazujte účtům služeb a profilům instancí oprávnění admin a cluster-admin, pokud je to nepotřebují. To se realizuje trochu složitěji, zejména v RBAC K8s, ale určitě to stojí za to.
6. Nespoléhejte na automatickou anti-affinity pro pod
Představte si, že máte tři repliky nějakého deploymentu na jednom uzlu. Uzlík selže a spolu s ním všechny repliky. Nepříjemná situace, že? Ale proč byly všechny repliky na jednom uzlu? Neměl by Kubernetes zajišťovat vysokou dostupnost (HA)?!
Bohužel, plánovač Kubernetes sám od sebe nedodržuje pravidla pro oddělené existence (anti-affinity) pro pod. Musí se explicitně uvést:
// опущено для краткости
      labels:
        app: zk
// опущено для краткости
      affinity:
        podAntiAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            - labelSelector:
                matchExpressions:
                  - key: "app"
                    operator: In
                    values:
                    - zk
              topologyKey: "kubernetes.io/hostname"
A je to. Nyní budou pod plánovány na různé uzly (toto podmínka se kontroluje pouze během plánování, nikoli během jejich činnosti — odtud to requiredDuringSchedulingIgnoredDuringExecution).
Zde se bavíme o podAntiAffinity na různých uzlech: topologyKey: "kubernetes.io/hostname", — a ne o různých zónách dostupnosti. Aby se zajistila plná HA, budete muset jít hlouběji do této problematiky.
7. Ignorování PodDisruptionBudgetů
Představte si, že máte produkční zátěž v Kubernetes clusteru. Periodicky je třeba uzly a samotný cluster aktualizovat (nebo je vyřadit z provozu). PodDisruptionBudget (PDB) je něco jako záruka mezi správci clusteru a uživateli.
PDB pomáhá vyhnout se přerušení provozu služeb způsobeným nedostatkem uzlů:
apiVersion: policy/v1beta1
kind: PodDisruptionBudget
metadata:
  name: zk-pdb
spec:
  minAvailable: 2
  selector:
    matchLabels:
      app: zookeeper
V tomto příkladu jako uživatel clusteru oznamujete administrátorům: „Hej, mám službu zookeeper a bez ohledu na to, co děláte, chtěl bych, aby byly vždy k dispozici alespoň 2 repliky této služby.“
Více informací si můžete přečíst .
8. Více uživatelů nebo prostředí v běžném clusteru
Prostory názvů Kubernetes (namespaces) nenabízejí silnou izolaci.
Je rozšířeným mylným představou, že pokud nasadíte ne-prod zatížení do jednoho prostoru názvů a prod zatížení do druhého, nebudou na sebe vzájemně působit.… Ačkoli je možné dosáhnout určité úrovně izolace pomocí požadavků/omezení prostředků, nastavením kvót a určením priorityClassů. Nějakou "fyzickou" izolaci v datovém plánu zajišťují affinities, tolerations, taint (nebo nodeselectors), avšak takové rozdělení je poměrně složité implementovat.
Ti, kdo potřebují kombinovat oba typy pracovních zátěží v jednom clusteru, se budou muset smířit se složitostí. Pokud však taková potřeba není a můžete si dovolit pořídit další cluster (řekněme v veřejném cloudu), je lepší to udělat. To umožní dosáhnout mnohem vyšší úrovně izolace.
9. externalTrafficPolicy: Cluster
Velmi často pozorujeme, že veškerý provoz do clusteru přichází přes službu typu NodePort, pro kterou je ve výchozím nastavení nastavena politika externalTrafficPolicy: Cluster. To znamená, že NodePort je otevřen na každém uzlu v clusterech a můžete použít libovolný z nich pro interakci s požadovanou službou (sadou podů).
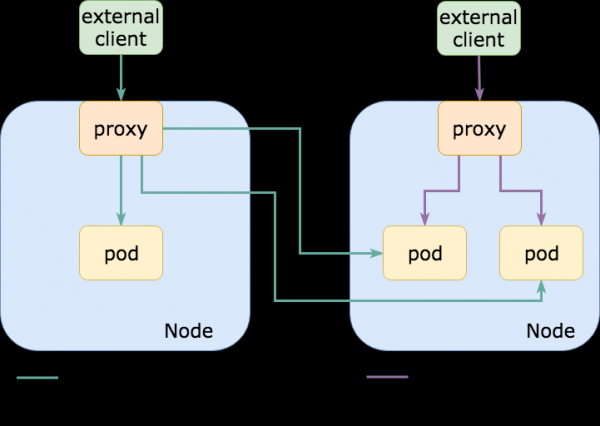
Přitom skutečné pody spojené s výše zmíněnou službou NodePort obvykle existují pouze na určitém podmnožině těchto uzlů.Jinými slovy, pokud se připojím k uzlu, na kterém není požadovaný pod, převede provoz na jiný uzel, přidáním transitního úseku (hop) a zvyšuje zpoždění (pokud jsou uzly v různých zónách dostupnosti/datových centrech, zpoždění může být docela vysoké; odborně také porostou náklady na egress provoz).
Na druhou stranu, pokud je pro nějakou službu Kubernetes nastavena politika externalTrafficPolicy: Local, pak se NodePort otevře pouze na těch uzlech, kde jsou skutečně spuštěny požadované pody. Při použití externího vyvažovače zátěže, který kontroluje stav (healthchecking) endpointů (jak to dělá AWS ELB), bude posílat provoz pouze na požadované uzly., což pozitivně ovlivní latenci, výpočetní nároky a účty za egress (a zdravý rozum, samozřejmě, také to naznačuje).
Je velmi pravděpodobné, že již používáte něco jako traefik nebo nginx-ingress-controller jako koncovou NodePort adresu (nebo LoadBalancer, který také používá NodePort) pro směrování HTTP ingress provozu, a nastavení této možnosti může výrazně snížit latenci pro takovéto požadavky.
V se můžete podrobněji dozvědět o externalTrafficPolicy, jejích výhodách a nevýhodách.
10. Nepřivazujte se k clusterům a nezapomínejte na control plane
Dříve se servery obvykle pojmenovávaly vlastními názvy: , HAL9000 a Colossus… Dnes je nahradily náhodně generované identifikátory. Přesto zůstala zvyklost, a nyní vlastní názvy připadly clustertům.
Typický příběh (založený na skutečných událostech): všechno začalo jako důkaz konceptu, takže cluster měl hrdé jméno testing… Uplynuly roky a stále je používán v production, a všichni se ho bojí dotknout.
Není žádná sranda v tom, že se clustery mění na domácí mazlíčky, proto doporučujeme je pravidelně odstraňovat, přičemž si procvičujete obnovení po haváriích (s tím vám pomůže — pozn. překl.). Kromě toho by nebylo na škodu zabývat se i řídicím vrstvou (control plane). Bát se ho dotknout — není příliš dobré znamení. Etcd mrtvý? Kluci, jste skutečně ve vážných problémech!
Na druhou stranu se s ním příliš nezapletete. Časem může řídicí vrstva zpomalit.Pravděpodobně je to způsobeno velkým množstvím vytvářených objektů bez jejich rotace (běžná situace při používání Helm s výchozími nastaveními, což způsobuje, že se jeho stav v configmapách / tajnostech neaktualizuje — jako výsledek se v řídicí vrstvě hromadí tisíce objektů) nebo stálým editováním objektů kube-api (pro automatické škálování, pro CI / CD, pro monitoring, logy událostí, kontroléry atd.).
Kromě toho doporučujeme zkontrolovat SLA / SLO smlouvy se správcem Kubernetes a věnovat pozornost zárukám. Dodavatel může zaručit dostupnost řídicí vrstvy (nebo jejích subkomponent), ale ne p99-latenci požadavků, které mu posíláte. Jinými slovy, můžete zavést kubectl get nodes, a odpověď získáte až za 10 minut, a to nebude porušením podmínek smlouvy o poskytování služeb.
11. Bonus: použití tagu latest
A tohle už je klasika. V poslední době se s podobnou technikou setkáváme méně často, protože mnozí, poučeni hořkou zkušeností, přestali používat tag :latest a začali verzovat (pin) verze. Hurá!
ECR ; doporučujeme se seznámit s touto pozoruhodnou vlastností.
Shrnutí
Nečekejte, že všechno bude fungovat mávnutím kouzelného proutku: Kubernetes není zázračný lék. Špatná aplikace (a možná se ještě zhorší). Nedbalost povede k nadměrné složitosti, pomalému a napjatému chodu řídicího vrstvy. Navíc riskujete, že zůstanete bez strategie pro zotavení po havárii. Nepředpokládejte, že Kubernetes "out of the box" převezme zajištění izolace a vysoké dostupnosti. Věnujte nějaký čas tomu, abyste svou aplikaci opravdu udělali cloud native.
S neúspěšným zkušenostmi různých týmů se můžete seznámit v od Henninga Jacobse.
Ti, kteří chtějí doplnit seznam chyb uvedený v tomto článku, se mohou spojit s námi na Twitteru (, ).
P.S. od překladatele
Přečtěte si také náš blog:
- «»;
- «»;
- «» (přehled a video přednášky);
- «».
Zdroj: habr.com
