

To je mýtus, který je v oblasti serverového hardwaru poměrně rozšířený. V praxi však hyperkonvergentní řešení (když je vše v jednom) jsou potřebná z mnoha důvodů. Historicky bylo první architektury vyvinuto společnostmi Amazon a Google pro své služby. Tehdy byla myšlenka vytvořit výpočetní farmu z identických uzlů, z nichž každý měl své vlastní disky. Vše bylo spojeno nějakým systémovým softwarem (hypervizorem) a následně rozdělena na virtuální stroje. Hlavním cílem je minimální úsilí na údržbu jednoho uzlu a minimální problémy při škálování: jednoduše se dokoupilo další tisícovku takových serverů a připojilo se vedle. V praxi se jedná o ojedinělé případy, a mnohem častěji se hovoří o menším počtu uzlů a trochu jiné architektuře.
Ale výhoda zůstává stejná – neuvěřitelná jednoduchost škálování a správy. Nevýhodou jsou různé úkoly, které různě spotřebovávají zdroje, a někde bude místních disků hodně, jinde málo RAM, a tak dále, což znamená, že při různých typech úkolů bude klesat využití zdrojů.
Ukázalo se, že platíte o 10-15 % více za pohodlí v nastavení. To vyvolalo mýtus, který je uveden v nadpisu. Dlouho jsme hledali, kde by technologie mohla být optimálně aplikována, a našli jsme to. Skutečnost je taková, že Cisco nemělo své vlastní úložiště, ale chtěli kompletní serverový trh. A vytvořili Cisco Hyperflex – řešení s místními úložišti na uzlech.
A z toho náhle vzniklo velmi dobré řešení pro záložní datová centra (Disaster Recovery). Proč a jak – nyní vám povím. A ukážu testy clusteru.
Kde je to potřeba
Hyperkonvergence – to je:
- Přenos disků do výpočetních uzlů.
- Plnohodnotná integrace subsystému ukládání dat se subsystémem virtualizace.
- Přenos/integrace s síťovým subsystémem.
Takové propojení umožňuje implementaci mnoha funkcí úložiště na úrovni virtualizace a to vše z jednoho ovládacího okna.
V naší společnosti jsou velmi žádané projekty na návrh záložních datových center, a často se volí právě hyperkonvergentní řešení díky množství možností replikace (až po metroklaster) z krabice.
V případě záložních datových center se obvykle jedná o vzdálený objekt na místě na druhé straně města nebo dokonce v jiném městě. To umožňuje obnovit kritické systémy v případě částečného nebo úplného selhání hlavního datového centra. Data se neustále replikují z produkčního prostředí, a tato replikace může probíhat na úrovni aplikace nebo na úrovni blokového zařízení (úložiště).
Proto teď popíšu strukturu systému a testy, a poté - několik scénářů reálného použití s údaji o úsporách.
Testy
Naše instance se skládá ze čtyř serverů, přičemž každý z nich má 10 SSD disků o velikosti 960 GB. Existuje vyhrazený disk pro kešování zápisových operací a ukládání servisní virtuální mašiny. Samo řešení je čtvrtá verze. První byla očividně nedodělaná (soudě podle recenzí), druhá byla také nedokonalá, třetí byla již dost stabilní, a tuto lze nazvat verzí po skončení beta testování pro širší veřejnost. Během testování jsem nezjistil žádné problémy, vše funguje jako hodinky.
Změny ve verzi 4Bylo opraveno množství chyb.
Původně platforma mohla pracovat pouze s hypervizorem VMware ESXi a podporovala omezený počet uzlů. Také proces nasazení často nekončil úspěšně, musel se restartovat některé kroky, byly problémy s aktualizací ze starších verzí, data v GUI se nezobrazovala vždy správně (i když teď nejsem nadšený z grafického zobrazení výkonu), někdy se objevovaly problémy na pomezí s virtualizací.
Nyní jsou všechny dětské nemoci opraveny, HyperFlex ovládá jak ESXi, tak Hyper-V, navíc je možné:
- Vytvoření rozšířeného clustru.
- Vytvoření clustru pro kanceláře bez použití Fabric Interconnect, od dvou do čtyř uzlů (kupujeme pouze servery).
- Možnost práce s externími úložišti.
- Podpora kontejnerů a Kubernetes.
- Vytvoření zón dostupnosti.
- Integrace s VMware SRM, pokud integrovaná funkčnost nevyhovuje.
Architektura se výrazně neliší od řešení hlavních konkurentů, kolo jsme nevynalezli. Všechno to funguje na virtualizační platformě VMware nebo Hyper-V. Hardwarově je to umístěno na serverech vlastní konstrukce Cisco UCS. Jsou ti, kdo nenávidí tuto platformu kvůli relativní složitosti počátečního nastavení, množství tlačítek, netradičnímu systému šablon a závislostí, ale jsou i ti, kdo pochopili Zen, vcítili se do myšlenky a nechtějí už pracovat s jinými servery.
Budeme se zabývat právě řešením pro VMware, protože bylo původně vytvořeno pro něj a má větší funkčnost; Hyper-V byl vylepšen průběžně, aby nezůstal pozadu za konkurencí a splnil očekávání trhu.
Existuje cluster serverů naplněných disky. Jsou disky určené pro ukládání dat (SSD nebo HDD — podle vašeho vkusu a potřeb), a jeden SSD disk pro cachování. Při zápisu dat na datastore dochází k ukládání dat na cache vrstvě (vyhrazený SSD disk a RAM servisní VM). Paralelně je blok dat zasílán na uzly v clusteru (počet uzlů závisí na faktoru replikace clusteru). Po potvrzení od všech uzlů o úspěšném zápisu je potvrzení zápisu odesláno hypervizoru a dále — do VM. Uložená data se na pozadí deduplikuje, komprimují a zapisují na úložné disky. Při tom se na úložné disky vždy zapisuje velký blok a postupně, což snižuje zátěž na úložné disky.
Deduplicace a komprese jsou neustále zapnuty a nelze je vypnout. Čtení dat probíhá přímo z úložných disků nebo z cache RAM. Pokud je použita hybridní konfigurace, pak se čtení také cache na SSD disku.
Data nejsou vázána na aktuální umístění virtuálního stroje a distribuují se mezi uzly rovnoměrně. Takový přístup umožňuje rovnoměrně zatížit všechny disky a síťové rozhraní. Samozřejmě, že zde je zřejmý nedostatek: nemůžeme co nejvíc snížit zpoždění čtení, protože není zaručeno, že data jsou lokální. Ale považuji to za zanedbatelnou oběť ve srovnání s dosaženými výhodami. O to víc, že latence v síti dosáhla takových hodnot, že prakticky neovlivňuje celkový výsledek.
Za celou logiku práce diskového subsystému odpovídá speciální servisní VM Cisco HyperFlex Data Platform controller, která se vytváří na každé uzlu úložiště. V naší konfiguraci byla servisní VM přidělena osm vCPU a 72 GB RAM, což není zrovna málo. Připomínám, že samotný host má k dispozici 28 fyzických jader a 512 GB RAM.
Servisní VM má přístup k fyzickým diskům přímo pomocí průchodu SAS-řadiče do VM. Komunikace s hypervizorem probíhá prostřednictvím speciálního modulu IOVisor, který zachycuje operace vstupu a výstupu, a pomocí agenta, který umožňuje předávat příkazy do API hypervizoru. Agent zajišťuje práci s HyperFlex snapshoty a klony.
V hypervizoru se diskové zdroje montují jako NFS- nebo SMB-sdílení (závisí na typu hypervizoru, hádejte, který je kde). A pod kapotou je to distribuovaný souborový systém, který umožňuje přidání funkcí dospělých plnohodnotných úložišť: tenké přidělování objemů, kompresi a deduplikaci, snapshoty podle technologie Redirect-on-Write, synchronní/asynchronní replikaci.
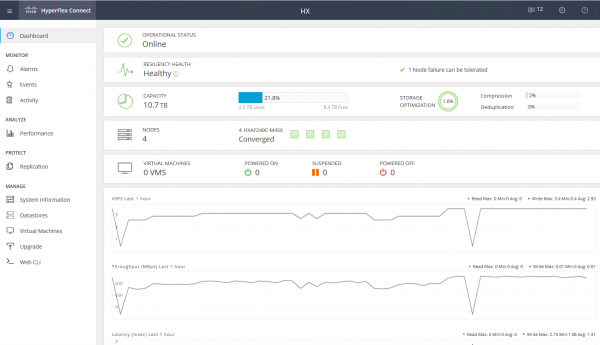
Servisní VM poskytuje přístup k webovému rozhraní správy subsystému HyperFlex. Existuje integrace s vCenter a většina každodenních úkolů může být provedena z něj, ale datastory je například pohodlnější rozdělit z odděleného webového rozhraní, pokud jste již přešli na rychlé HTML5 rozhraní, nebo použít plnohodnotného Flash klienta s kompletní integrací. V servisním webovém rozhraní lze sledovat výkonnost a podrobný stav systému.
Existuje také jiný typ uzlů v klastru — výpočetní uzly. To mohou být rackové nebo blade servery bez vestavěných disků. Na těchto serverech lze spouštět VM, jejichž data jsou uložena na serverech s disky. Z pohledu přístupu k datům není rozdíl mezi typy uzlů, protože architektura předpokládá abstrakci od fyzického umístění dat. Maximální poměr výpočetních uzlů a uzlů úložiště je 2:1.
Použití výpočetních uzlů zvyšuje flexibilitu při škálování zdrojů klastru: nemusíme nutně dokupovat uzly s disky, pokud máme potřebu pouze po CPU/RAM. Kromě toho můžeme přidat blade koš a získat úsporu na umístění serverů v racku.
Výsledkem je, že máme hyperkonvergentní platformu s následujícími funkcemi:
- Až 64 uzlů v clusteru (až 32 uzlů pro ukládání).
- Minimální počet uzlů v clusteru — tři (dva pro Edge cluster).
- Mekanismus redundance dat: zrcadlení s replikací 2 a 3.
- Metro cluster.
- Asynchronní replikace VM na jiný HyperFlex cluster.
- Orchestrace přepínání VM do vzdáleného datového centra.
- Nativní snapshoty pomocí technologie Redirect-on-Write.
- Až 1 PB užitečného prostoru při replikaci 3 a bez zohlednění deduplikace. Replikace 2 se nezohledňuje, protože to není varianta pro seriózní prodej.
Další obrovská výhoda — jednoduchost správy a nasazení. Všechny složitosti nastavení serverů UCS přebírá specializovaná VM, kterou připravili inženýři Cisco.
Konfigurace testovacího stojanu:
- 2 x Cisco UCS Fabric Interconnect 6248UP jako řídící cluster a síťové komponenty (48 portů pracujících v režimu Ethernet 10G/FC 16G).
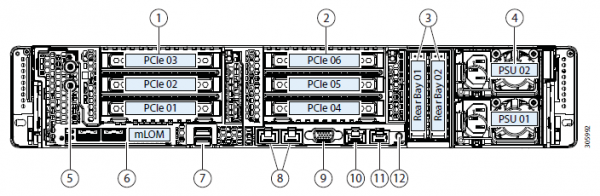
- Čtyři servery Cisco UCS HXAF240 M4.
Specifikace serverů:
CPU
2 x Intel ® Xeon ® E5-2690 v4
RAM
16 x 32GB DDR4-2400-MHz RDIMM/PC4-19200/dual rank/x4/1.2v
Síť
UCSC-MLOM-CSC-02 (VIC 1227). 2 porty 10G Ethernet
Storage HBA
Cisco 12G Modular SAS Pass through Controller
Úložné disky
1 x SSD Intel S3520 120 GB, 1 x SSD Samsung MZ-IES800D, 10 x SSD Samsung PM863a 960 GB
Více konfiguracíKromě vybraného hardwaru jsou v současnosti k dispozici následující možnosti:
- HXAF240c M5.
- Jedno nebo dvě CPU začínající od Intel Silver 4110 až po Intel Platinum I8260Y. K dispozici je druhá generace.
- 24 slotů pro paměť, moduly od 16 GB RDIMM 2600 do 128 GB LRDIMM 2933.
- Od 6 do 23 disků pro data, jeden cache disk, jeden systémový a jeden bootovací disk.
Kapacitní disky
- HX-SD960G61X-EV 960GB 2.5 palcový Enterprise Value 6G SATA SSD (1X endurance) SAS 960 GB.
- HX-SD38T61X-EV 3.8TB 2.5 palcový Enterprise Value 6G SATA SSD (1X endurance) SAS 3.8 TB.
- Cache disky
- HX-NVMEXPB-I375 375GB 2.5 palcový Intel Optane Drive, Extreme Perf & Endurance.
- HX-NVMEHW-H1600* 1.6TB 2.5 palcový Ent. Perf. NVMe SSD (3X endurance) NVMe 1.6 TB.
- HX-SD400G12TX-EP 400GB 2.5 palcový Ent. Perf. 12G SAS SSD (10X endurance) SAS 400 GB.
- HX-SD800GBENK9** 800GB 2.5 palcový Ent. Perf. 12G SAS SED SSD (10X endurance) SAS 800 GB.
- HX-SD16T123X-EP 1.6TB 2.5 palcový Enterprise performance 12G SAS SSD (3X endurance).
Systémové / Log disky
- HX-SD240GM1X-EV 240GB 2.5 palcový Enterprise Value 6G SATA SSD (vyžaduje upgrade).
Boot disky
- HX-M2-240GB 240GB SATA M.2 SSD SATA 240 GB.
Připojení k síti pomocí portů Ethernet 40G, 25G nebo 10G.
Jako FI mohou být HX-FI-6332 (40G), HX-FI-6332-16UP (40G), HX-FI-6454 (40G/100G).
Samotný test
Pro testování diskového subsystému jsem použil HCIBench 2.2.1. Je to bezplatná utilita umožňující automatizaci vytváření zátěže z několika virtuálních strojů. Samotná zátěž je generována běžným fio.
Náš cluster se skládá ze čtyř uzlů, faktor replikace 3, všechny disky Flash.
Pro testování jsem vytvořil čtyři datová úložiště a osm virtuálních strojů. Pro záznamové testy se předpokládá varianta, kdy se vyrovnávací disk nepřeplňuje.
Výsledky testů jsou následující:
100 % Čtení 100 % Náhodně
0 % Čtení 100 % Náhodně
Blok / hloubka fronty
128
256
512
1024
2048
128
256
512
1024
2048
4K
0,59 ms 213804 IOPS
0,84 ms 303540 IOPS
1,36 ms 374348 IOPS
2,47 ms 414116 IOPS
4,86 ms 420180 IOPS
2,22 ms 57408 IOPS
3,09 ms 82744 IOPS
5,02 ms 101824 IOPS
8,75 ms 116912 IOPS
17,2 ms 118592 IOPS
8K
0,67 ms 188416 IOPS
0,93 ms 273280 IOPS
1,7 ms 299932 IOPS
2,72 ms 376484 IOPS
5,47 ms 373176 IOPS
3,1 ms 41148 IOPS
4,7 ms 54396 IOPS
7,09 ms 72192 IOPS
12,77 ms 80132 IOPS
16K
0,77 ms 164116 IOPS
1,12 ms 228328 IOPS
1,9 ms 268140 IOPS
3,96 ms 258480 IOPS
3,8 ms 33640 IOPS
6,97 ms 36696 IOPS
11,35 ms 45060 IOPS
32K
1,07 ms 119292 IOPS
1,79 ms 142888 IOPS
3,56 ms 143760 IOPS
7,17 ms 17810 IOPS
11,96 ms 21396 IOPS
64K
1,84 ms 69440 IOPS
3,6 ms 71008 IOPS
7,26 ms 70404 IOPS
11,37 ms 11248 IOPS
Tučně jsou označeny hodnoty, po kterých již nedochází k růstu výkonu, občas je dokonce viditelná degradace. Je to způsobeno tím, že jsme limitováni výkonem sítě / řadičů / disků.
- Sekvenční čtení 4432 MB/s.
- Sekvenční zápis 804 MB/s.
- Pokud selže jeden řadič (selhání virtuálního stroje nebo hostitele), výkon klesá na polovinu.
- Při selhání disku úložiště dochází k poklesu o 1/3. Obnova disku spotřebovává 5 % zdrojů každého řadiče.
U malého bloku narážíme na výkon řadiče (virtuální stroj), jeho CPU je zatížen na 100 %, při zvyšování bloku narážíme na propustnost portů. 10 Gbit/s nestačí k úplnému využití potenciálu AllFlash systému. Bohužel, testování na 40 Gbit/s není možné kvůli parametrům poskytnutého demo standu.
Podle mých dojmů z testů a zkoumání architektury, díky algoritmu, který rozmisťuje data mezi všemi hostiteli, získáváme škálovatelný a předvídatelný výkon, ale to je také omezení při čtení, protože z lokálních disků by bylo možné vytáhnout více. Zde by mohla pomoci výkonnější síť, například FI dostupné na 40 Gbit/s.
Také jeden disk pro vyrovnávací paměť a deduplikaci může být omezením, v tomto standu skutečně můžeme zapisovat na čtyři SSD disky. Bylo by skvělé mít možnost zvyšovat počet vyrovnávacích disků a vidět rozdíl.
Skutečné použití
Pro zajištění záložního datového centra lze použít dva přístupy (umístění zálohy na vzdáleném místě nezvažujeme):
- Aktivně-pasivní. Všechny aplikace jsou umístěny v hlavním datovém centru. Replikace je synchronní nebo asynchronní. V případě výpadku hlavního datového centra musíme aktivovat záložní. To lze provést ručně/scripts/aplikacemi orchestraci. Zde dostaneme RPO porovnatelný s frekvencí replikace, a RTO závisí na reakci a schopnostech administrátora a kvalitě zpracování/debugování plánu přepnutí.
- Aktivně-aktivní. V tomto případě je přítomna pouze synchronní replikace, dostupnost datových center je určena většinou/rozhodčím umístěným striktně na třetí lokalitě. RPO = 0, a RTO může dosáhnout 0 (pokud aplikace umožňuje) nebo se rovná času potřebnému k překonání výpadku uzlu v klastru virtualizace. Na úrovni virtualizace se vytváří rozšířený (Metro) klastr, který vyžaduje aktivně-aktivní SDD.
Obvykle vidíme, že zákazníci již mají realizovanou architekturu s klasickou SDD v hlavním datovém centru, proto navrhujeme další pro replikaci. Jak jsem již zmínil, Cisco HyperFlex nabízí asynchronní replikaci a vytváření rozšířeného klastru virtualizace. Přitom nepotřebujeme specializovanou SDD střední úrovně a výše s drahými funkcemi replikace a aktivně-aktivního přístupu k datům na dvou SDD.
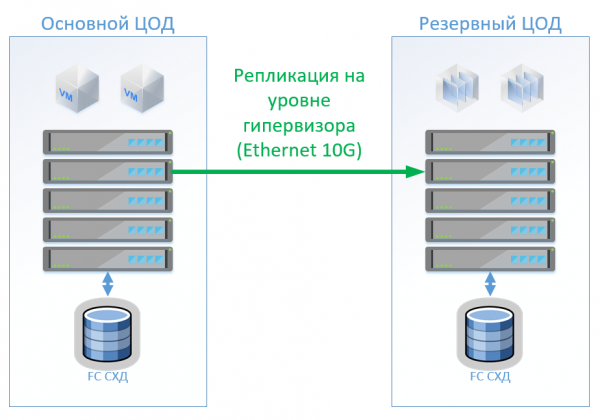
Scénář 1: Máme hlavní a záložní datová centra, platforma virtualizace na VMware vSphere. Všechny produkční systémy jsou umístěny v hlavním datovém centru, a replikace virtuálních strojů se provádí na úrovni hypervizoru, což umožní, že VM nemusí být zapnuté v záložním datovém centru. Databáze a speciální aplikace replikujeme vestavěnými prostředky a držíme VM zapnuté. V případě výpadku hlavního datového centra spouštíme systémy v záložním datovém centru. Předpokládáme, že máme kolem 100 virtuálních strojů. Dokud funguje hlavní datové centrum, v záložním datovém centru lze spouštět testovací prostředí a další systémy, které lze vypnout v případě přepnutí hlavního datového centra. Také je možná varianta, kdy máme dvoucestnou replikaci. Z hlediska hardwaru se nic nezmění.
V případě klasické architektury umístíme do každého datového centra hybridní úložiště s přístupem přes FibreChannel, tieringem, deduplikací a kompresí (ale ne online), 8 serverů na každou lokalitu, po 2 přepínače FibreChannel a Ethernet 10G. Pro replikaci a správu přepínání v klasické architektuře můžeme použít nástroje VMware (Replication + SRM) nebo jiné nástroje, které budou o něco levnější a občas i pohodlnější.
Na obrázku je znázorněn diagram.
V případě použití Cisco HyperFlex vzniká následující architektura:
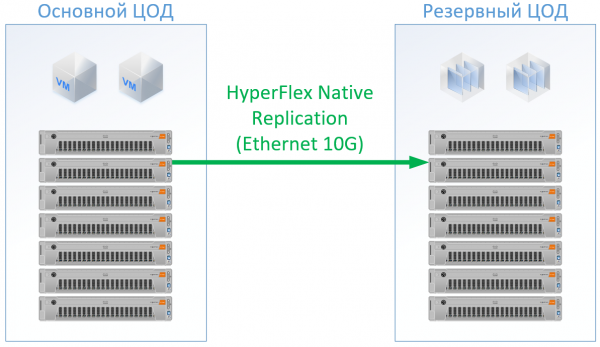
Pro HyperFlex jsem použil servery s velkými zdroji CPU/RAM, protože část zdrojů půjde na VM kontroleru HyperFlex, po CPU a paměti jsem dokonce trochu přezalžil v konfiguraci HyperFlex, abych nevyhovoval Cisco a zajistil zdroje pro ostatní VM. Zato se můžeme vzdát přepínačů FibreChannel a nebudeme potřebovat Ethernetové porty pro každý server, místní traffic se přepíná uvnitř FI.
Nakonec vznikla následující konfigurace pro každé datové centrum:
Servery
8 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA)
8 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6150, 3,2 GB SSD, 10 x 6 TB NL-SAS)
Úložiště dat
Hybridní úložiště s FC Front-End (20TB SSD, 130 TB NL-SAS)
—
LAN
2 x Ethernet switch 10G 12 ports
—
SAN
2 x FC switch 32/16Gb 24 ports
2 x Cisco UCS FI 6332
Licence
VMware Ent Plus
Replikace a/nebo orchestrace přepínání VM
VMware Ent Plus
Pro HyperFlex jsem nezakládal licence pro replikační software, protože to máme dostupné z krabice.
Pro klasickou architekturu jsem vybral dodavatele, který si vybudoval pověst kvalitního a cenově dostupného výrobce. Pro obě varianty jsem použil standardní slevu pro dané řešení, na výstupu jsem dostal reálné ceny.
Řešení na Cisco HyperFlex vyšlo o 13 % levněji.
Scénář 2: vytvoření dvou aktivních datových center. V tomto scénáři projektujeme rozšířený klastr na VMware.
Klasická architektura se skládá ze serverů virtualizace, SAN (protokol FC) a dvou úložišť, která umí číst a zapisovat na tom, které jsou mezi nimi rozprostřeny. Na každém úložišti navrhujeme užitečnou kapacitu pro lokalitu.
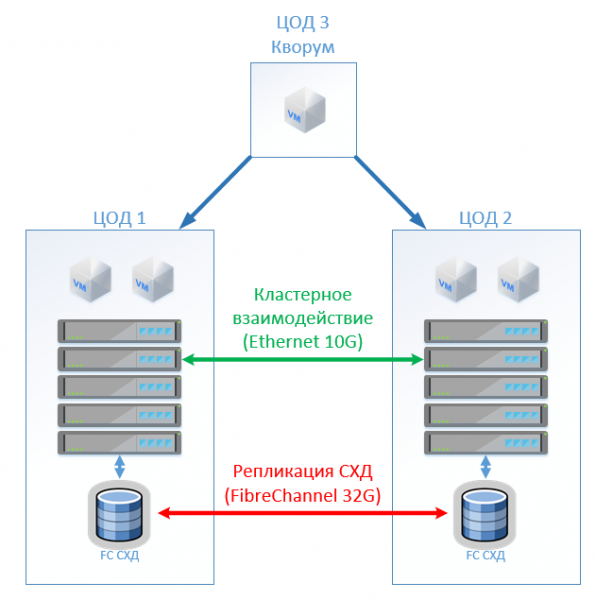
U HyperFlex jednoduše vytvoříme Stretch Cluster se stejným počtem uzlů na obou lokalitách. V tomto případě se používá faktor replikace 2+2.
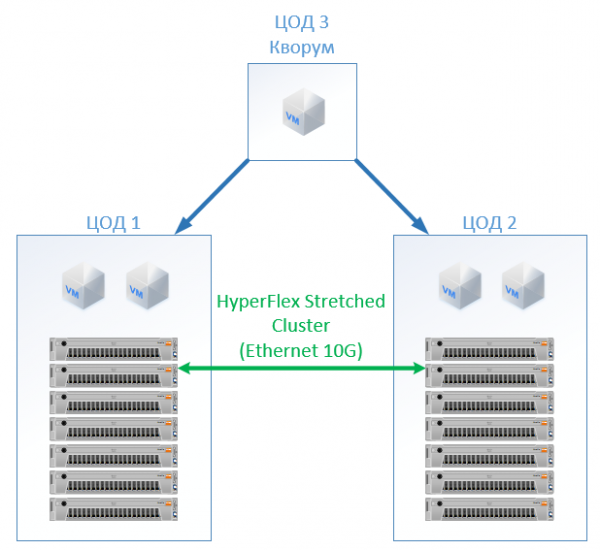
Vznikla následující konfigurace:
Klasická architektura
HyperFlex
Servery
16 x 1U Server (384 GB RAM, 2 x Intel Gold 6132, FC HBA, 2 x 10G NIC)
16 x HX240C-M5L (512 GB RAM, 2 x Intel Gold 6132, 1,6 TB NVMe, 12 x 3,8 TB SSD, VIC 1387)
Úložiště dat
2 x AllFlash úložiště (150 TB SSD)
—
LAN
4 x Ethernet switch 10G 24 ports
—
SAN
4 x FC switch 32/16Gb 24 ports
4 x Cisco UCS FI 6332
Licence
VMware Ent Plus
VMware Ent Plus
Ve všech výpočtech jsem nezohledňoval síťovou infrastrukturu, náklady na datová centra atd.: budou stejné pro klasickou architekturu i pro řešení na HyperFlex.
Co se ceny týče, HyperFlex byl o 5 % dražší. Je třeba poznamenat, že u zdrojů CPU/RAM jsem pro Cisco zaznamenal nesoulad, protože jsem v konfiguraci rovnoměrně vyplnil kanály řadičů paměti. Cena je o něco vyšší, ale ne o mnoho, což jasně naznačuje, že hyperkonvergence nemusí být "hračka pro bohaté" a může konkurovat standardnímu přístupu k budování datových center. Může to být také zajímavé pro ty, kteří již mají servery Cisco UCS a odpovídající infrastrukturu.
Mezi výhody získáme absenci nákladů na správu SAN a SSSD, online kompresi a deduplikaci, jednotný kontaktní bod pro podporu (virtualizace, servery, což je také SSSD), úsporu místa (ale ne ve všech scénářích), zjednodušení provozu.
Pokud jde o podporu, získáváte ji od jednoho dodavatele - Cisco. Pokud soudím podle zkušeností s servery Cisco UCS, líbí se mi, na HyperFlex jsem se nemusel obracet, všechno fungovalo. Inženýři rychle odpovídají a mohou řešit nejen běžné problémy, ale i složité hraniční případy. Někdy se na ně obracím s otázkami: "Lze to udělat takto, připojit toto?" nebo "Tady jsem něco nakonfiguroval a nechce to fungovat. Pomozte!" - trpělivě najdou potřebného průvodce a ukážou na správné kroky, neodpoví: "Řešíme pouze hardwarové problémy."
Odkazy
- Můj email je StGeneralov@croc.ru
Zdroj: habr.com
