

Ahoj, Habr! V tomto článku chci vyprávět o jednom skvělém nástroji pro vývoj batch procesů zpracování dat, například v infrastruktuře firemního DWH nebo vašeho DataLake. Řeč bude o Apache Airflow (dále jen Airflow). Je nespravedlivě opomíjen na Habru, a v hlavní části se vás pokusím přesvědčit, že na Airflow se rozhodně vyplatí podívat při výběru plánovače pro vaše ETL/ELT procesy.
Dříve jsem psal sérii článků na téma DWH, když jsem pracoval v Tinkoff Bank. Nyní jsem součástí týmu Mail.Ru Group a zabývám se rozvojem platformy pro analýzu dat v herním odvětví. Vlastně, jakmile se objeví novinky a zajímavá řešení, budeme s týmem vyprávět o naší platformě pro analytiku dat.
Prolog
Tak pojďme začít. Co je to Airflow? Je to knihovna (nebo ) pro vývoj, plánování a monitorování pracovních procesů. Hlavní charakteristikou Airflow je, že pro popis (vývoj) procesů se používá kód v Pythonu. Z toho vyplývá řada výhod pro organizaci vašeho projektu a vývoj: vlastně váš (například) ETL projekt je jen Python projekt a můžete ho uspořádat tak, jak vám to vyhovuje, s ohledem na specifika infrastruktury, velikost týmu a další požadavky. Nástroje jsou jednoduché. Používejte například PyCharm + Git. To je skvělé a velmi pohodlné!
Nyní se podívejme na hlavní entity Airflow. Pochopením jejich podstaty a účelu optimálně uspořádáte architekturu procesů. Snad nejdůležitější entitou je Directed Acyclic Graph (dále DAG).
DAG
DAG je určité významové spojení vašich úloh, které chcete provést ve striktně stanovené posloupnosti podle určeného harmonogramu. Airflow poskytuje uživatelsky přívětivé webové rozhraní pro práci s DAGy a dalšími entitami:
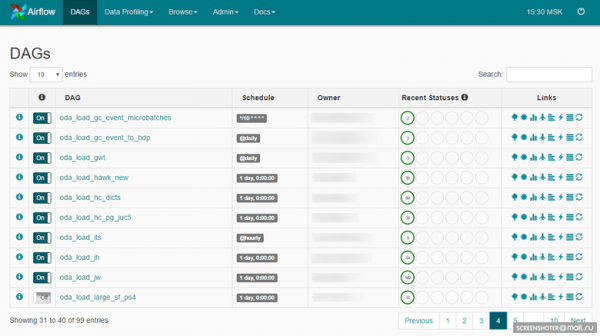
DAG může vypadat takto:
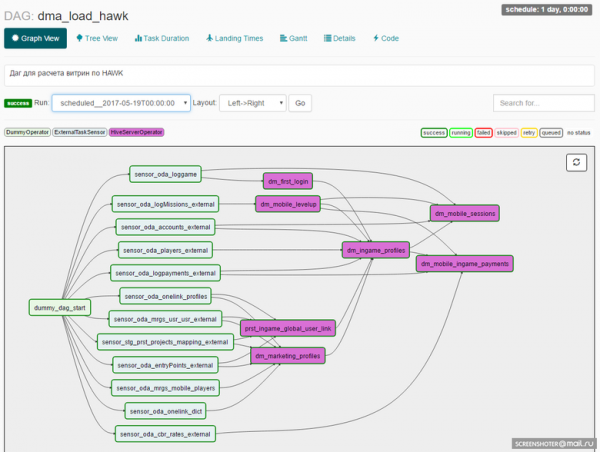
Vývojář, při navrhování DAG, zakládá sadu operátorů, na kterých budou postaveny úkoly uvnitř DAGu. Zde se dostáváme k další důležité entity: Airflow Operator.
Operátoři
Operátor je entita, na jejímž základě se vytvářejí instance úloh, kde se popisuje, co se stane během provádění instance úlohy. už obsahují sadu operátorů, připravených k použití. Příklady:
- BashOperator — operátor pro spuštění bash příkazu.
- PythonOperator — operátor pro volání Python kódu.
- EmailOperator — operátor pro odesílání e-mailu.
- HTTPOperator — operátor pro práci s http požadavky.
- SqlOperator — operátor pro vykonávání SQL kódu.
- Sensor — operátor čekající na událost (nastání požadovaného času, objevení požadovaného souboru, řádku v databázi, odpovědi z API — atd.).
Existují specifičtější operátory: DockerOperator, HiveOperator, S3FileTransferOperator, PrestoToMysqlOperator, SlackOperator.
Můžete také vyvíjet operátory přizpůsobené vašim potřebám a používat je v projektu. Například jsme vytvořili MongoDBToHiveViaHdfsTransfer, operátor pro export dokumentů z MongoDB do Hive, a několik operátorů pro práci s : CHLoadFromHiveOperator a CHTableLoaderOperator. V podstatě, jakmile se v projektu objeví znovu používaný kód, založený na základních operátorech, měli byste zvážit jeho sbalení do nového operátora. To usnadní další vývoj a obohatíte svou knihovnu operátorů v projektu.
Poté je nutné vykonat všechny tyto úlohy a nyní se budeme zabývat plánovačem.
Plánovač
Plánovač úloh v Airflow je postaven na . Celery je Python knihovna, která umožňuje organizovat frontu plus asynchronní a distribuované vykonávání úloh. Z pohledu Airflow jsou všechny úlohy rozděleny do poolů. Pooly jsou vytvářeny manuálně. Jejich cílem je obvykle omezit zátěž při práci se zdrojem nebo typizovat úlohy v DWH. S pooly lze spravovat prostřednictvím webového rozhraní:
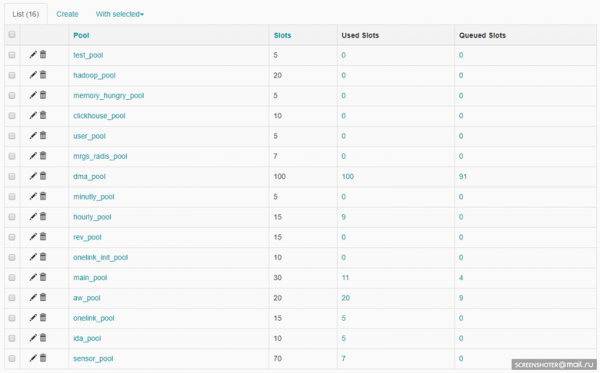
Každý pool má omezení počtu slotů. Při vytváření DAGu mu je přiřazen pool:
ALERT_MAILS =  Variable.get("gv_mail_admin_dwh")
DAG_NAME = 'dma_load'
OWNER = 'Vasya Pupkin'
DEPENDS_ON_PAST = True
EMAIL_ON_FAILURE = True
EMAIL_ON_RETRY = True
RETRIES = int(Variable.get('gv_dag_retries'))
POOL = 'dma_pool'
PRIORITY_WEIGHT = 10

start_dt = datetime.today() - timedelta(1)
start_dt = datetime(start_dt.year, start_dt.month, start_dt.day)

default_args = {
    'owner': OWNER,
    'depends_on_past': DEPENDS_ON_PAST,
    'start_date': start_dt,
    'email': ALERT_MAILS,
    'email_on_failure': EMAIL_ON_FAILURE,
    'email_on_retry': EMAIL_ON_RETRY,
    'retries': RETRIES,
    'pool': POOL,
    'priority_weight': PRIORITY_WEIGHT
}
dag = DAG(DAG_NAME, default_args=default_args)
dag.doc_md = __doc__
Pool zadaný na úrovni DAGu lze přepsat na úrovni úlohy.
Za plánování všech úloh v Airflow odpovídá samostatný proces — Scheduler. Scheduler se vlastně zabývá celou mechanikou zadávání úloh k provedení. Úloha, než se dostane k provedení, prochází několika fázemi:
- Ve DAGu jsou prioritující úkoly, nový úkol lze zařadit do fronty.
- Fronta se třídí podle priority úkolů (prioritou lze také řídit) a pokud je v poolu volné místo, úkol lze převzít do práce.
- Pokud je k dispozici volný worker celery, úkol je mu přidělen; začíná práce, kterou jste naprogramovali v úkolu, použitím příslušného operátoru.
Je to dost jednoduché.
Scheduler pracuje na mnoha všech DAGs a všech úkolech uvnitř DAGů.
Aby Scheduler začal pracovat s DAGem, je nutné nastavit harmonogram DAGu:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='@hourly')Existuje sada připravených presetů: @once, @hourly, @daily, @weekly, @monthly, @yearly.
Lze také použít cron výrazy:
dag = DAG(DAG_NAME, default_args=default_args, schedule_interval='*/10 * * * *')Datum vykonání
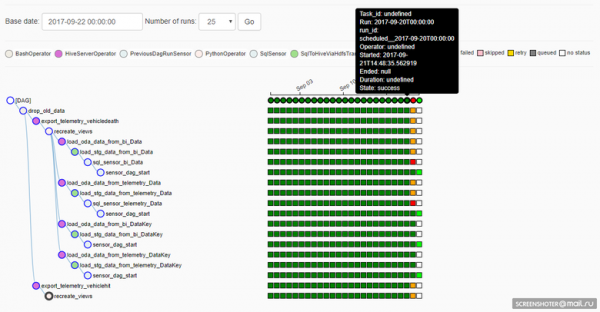
Abychom pochopili, jak Airflow funguje, je důležité chápat, co je to Datum vykonání pro DAG. V Airflow má DAG dimenzi Datum vykonání, tj. podle harmonogramu práce DAGu se vytvářejí instance úkolů pro každé Datum vykonání. A pro každé Datum vykonání lze úkoly znovu vykonat — nebo například může DAG pracovat současně na několika Datumech vykonání. To je jasně zobrazeno zde:
Bohužel (možná i k vaší smůle: záleží na situaci), pokud je upravena implementace úkolu v DAGu, pak provádění v předchozích Datumech vykonání proběhne již s ohledem na úpravy. To je dobře, pokud je třeba přepočítat data v minulých obdobích novým algoritmem, ale špatně, protože se ztrácí reprodukovatelnost výsledku (samozřejmě nikdo nebrání vrátit se z Gitu k potřebné verzi zdrojáku a jednorázově spočítat to, co je potřeba, tak, jak je potřeba).
Generování úkolů
Implementace DAGu je kód v Pythonu, takže máme velmi pohodlný způsob, jak zkrátit objem kódu při práci například s shardovanými zdroji. Představte si, že máte jako zdroje tři shardy MySQL, musíte se podívat do každého z nich a získat nějaká data. A to nezávisle a paralelně. Kód v Pythonu v DAGu může vypadat takto:
connection_list = lv.get('connection_list')

export_profiles_sql = '''
SELECT
  id,
  user_id,
  nickname,
  gender,
  {{params.shard_id}} as shard_id
FROM profiles
'''

for conn_id in connection_list:
    export_profiles = SqlToHiveViaHdfsTransfer(
        task_id='export_profiles_from_' + conn_id,
        sql=export_profiles_sql,
        hive_table='stg.profiles',
        overwrite=False,
        tmpdir='/data/tmp',
        conn_id=conn_id,
        params={'shard_id': conn_id[-1:], },
        compress=None,
        dag=dag
    )
    export_profiles.set_upstream(exec_truncate_stg)
    export_profiles.set_downstream(load_profiles)
DAG se ukazuje jako následující:
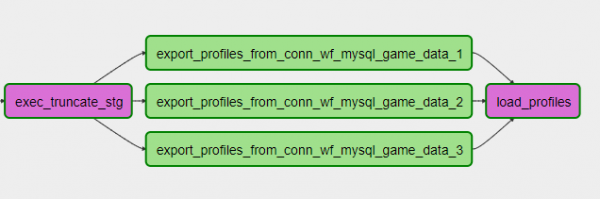
Lze přidat nebo odebrat shard jednoduše úpravou nastavení a aktualizací DAG. Pohodlné!
Lze použít i složitější generaci kódu, například pracovat se zdroji jako s databázemi nebo popsat tabulkovou strukturu, algoritmus práce s tabulkou a s ohledem na zvláštnosti infrastruktury DWH generovat proces načítání N tabulek do vašeho úložiště. Nebo například pracovat s API, které nepodporuje práci s parametrem ve formě seznamu, můžete vygenerovat podle tohoto seznamu N úloh v DAGu, omezit paralelismus požadavků v API pomocí poolu a získat z API potřebná data. Flexibilní!
Repozitář
V Airflow je vlastní backendový repozitář, databáze (může být MySQL nebo Postgres, my máme Postgres), kde se ukládají stavy úloh, DAGů, nastavení připojení, globální proměnné atd. Je dobré zmínit, že repozitář v Airflow je velmi jednoduchý (asi 20 tabulek) a pohodlný, pokud chcete vytvořit nějaký vlastní proces nad ním. Vzpomínám si na 100500 tabulek v repozitáři Informatica, které bylo třeba dlouho studovat, než jsem pochopil, jak sestavit dotaz.
Monitoring
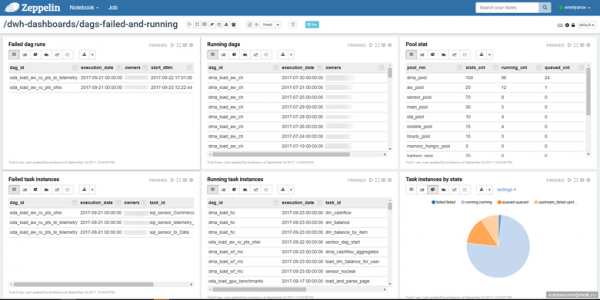
Zvažujíc jednoduchost repozitáře, můžete si sami vytvořit pohodlný proces monitorování úloh. Používáme zápisník v Zeppelinu, kde sledujeme stav úloh:
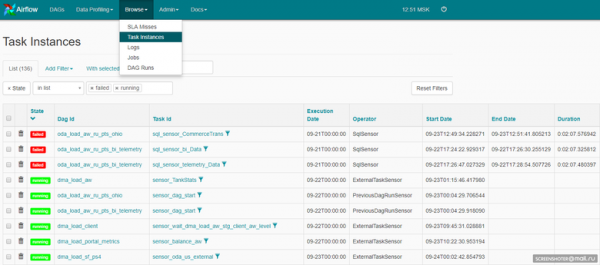
Může to být i webové rozhraní samotného Airflow:
Kód Airflow je otevřený, proto jsme k němu přidali alerting v Telegramu. Každý běžící instance úlohy, pokud dojde k chybě, spamuje do skupiny v Telegramu, kde je celá vývojová a podpůrná tým.
Dostáváme přes Telegram okamžité reakce (pokud jsou potřeba), přes Zeppelin - celkový přehled úloh v Airflow.
Celkem
Airflow je především open source a není třeba čekat od něj zázraky. Buďte připraveni investovat čas a úsilí do vybudování funkčního řešení. Cíl je dosažitelný, věřte mi, stojí to za to. Rychlost vývoje, flexibilita, jednoduchost přidávání nových procesů - bude se vám to líbit. Samozřejmě je třeba věnovat velkou pozornost organizaci projektu, stabilitě samotného Airflow: zázraky se nedějí.
Nyní máme Airflow, který každý den zpracovává přibližně 6,5 tisíce úloh. Jsou dost odlišné povahy. Existují úkoly pro načítání dat do hlavního DWH z mnoha různých a velmi specifických zdrojů, existují úkoly pro výpočty pohledů uvnitř hlavního DWH, existují úkoly pro publikaci dat v rychlém DWH, existuje spousta různých úkolů — a Airflow si s nimi poradí den za dnem. Pokud se podíváme na čísla, tak to je 2,3 tisíce ELT úkolů různé složitosti uvnitř DWH (Hadoop), přibližně 2,5 stovky databází zdrojů, to je tým z čtyř ETL vývojářů, kteří se dělí na ETL zpracování dat v DWH a ELT zpracování dat uvnitř DWH a samozřejmě také jednoho administrátora, který se stará o infrastrukturu služby.
Plány do budoucna
Počet procesů nevyhnutelně roste, a hlavní, co budeme dělat v oblasti infrastruktury Airflow, — je škálování. Chceme postavit cluster Airflow, vyčlenit pár uzlů pro worker‘y Celery a vytvořit duplikující se hlavu s procesy plánování úloh a úložištěm.
Epilog
To samozřejmě není vše, co bych chtěl říct o Airflow, ale hlavní body jsem se snažil osvětlit. Chutě přicházejí s jídlem, zkuste to — a budete spokojeni 🙂
Zdroj: habr.com
