

Před zahájením kurzu připravili jsme pro vás překlad dalšího užitečného materiálu.
Huffmanovo kódování je algoritmus pro kompresi dat, který formuloval základní myšlenku komprese souborů. V tomto článku budeme hovořit o kódování pevné a proměnné délky, unikátně dekódovatelných kódech, prefixních pravidlech a budování Huffmanova stromu.
Víme, že každý znak je uložen jako sekvence 0 a 1 a zabírá 8 bitů. To se nazývá kódování pevné délky, protože každý znak používá stejné pevné množství bitů pro uložení.
Představme si, že máme text. Jak můžeme snížit množství místa potřebného k uložení jednoho znaku?
Základní myšlenka spočívá v kódování proměnné délky. Můžeme využít toho, že některé znaky v textu se objevují častěji než jiné (), abychom vyvinuli algoritmus, který bude představovat stejnou sekvenci znaků menším počtem bitů. Při kódování proměnné délky přidělujeme znakům proměnlivé množství bitů v závislosti na četnosti jejich výskytu v daném textu. Výsledkem může být, že některé znaky zaberou pouze 1 bit, zatímco jiné 2 bity, 3 nebo více. Problém s kódováním proměnné délky spočívá pouze v následném dekódování sekvence.
Jak, pokud známe sekvenci bitů, ji jednoznačně dekódovat?
Zvažme řetězec "aabacdab".Obsahuje 8 znaků, a při kódování pevné délky pro jeho uložení bude potřeba 64 bitů. Všimněme si, že četnost znaků "a", "b", "c" a "d" je 4, 2, 1, 1, v tomto pořadí. Zkusme to vyjádřit "aabacdab". menším množstvím bitů, přičemž vezmeme v úvahu, že "a" se objevuje častěji než "b", a "b" se objevuje častěji než "c". a "d"Začneme tím, že kódujeme "a" pomocí jednoho bitu, kterým je 0, "b" přiřadíme dvoubitský kód 11 a pomocí tří bitů 100 a 011 kódujeme "c". a "d".
Nakonec získáme:
a
0
b
11
s
100
– perioda anténní mřížky (vzdálenost mezi sousedními prvky),
011
Tímto způsobem řetězec "aabacdab". zakódujeme jako 00110100011011 (0|0|11|0|100|011|0|11), využívajíc kódy uvedené výše. Hlavní problém však bude v dekódování. Když se pokusíme dekódovat řetězec 00110100011011, dostaneme nejednoznačný výsledek, protože ho lze reprezentovat jako:
0|011|0|100|011|0|11    adacdab
0|0|11|0|100|0|11|011   aabacabd
0|011|0|100|0|11|0|11   adacabab
…
atd.
Aby se předešlo této nejednoznačnosti, musíme zajistit, že naše kódování vyhovuje pojmu prefixní pravidlo, které v konečném důsledku znamená, že kódy mohou být dekódovány pouze jedním unikátním způsobem. Prefixní pravidlo zajišťuje, že žádný kód nebude prefixem jiného. Kódem rozumíme bity, které se používají k reprezentaci konkrétního symbolu. V uvedeném příkladu 0 – je prefix 011, což porušuje prefixní pravidlo. Pokud tedy naše kódy splňují prefixní pravidlo, můžeme provést jednoznačné dekódování (a naopak).
Pojďme se podívat na výše uvedený příklad. Tentokrát přiřadíme symbolům "a", "b", "c" a "d" kódy, které splňují prefixní pravidlo.
a
0
b
10
s
110
– perioda anténní mřížky (vzdálenost mezi sousedními prvky),
111
Při použití takového kódování bude řetězec "aabacdab". zakódován jako 00100100011010 (0|0|10|0|100|011|0|10). A nyní 00100100011010 budeme schopni jednoznačně dekódovat a vrátit se k našemu původnímu řetězci. "aabacdab"..
Huffmanovo kódování
Nyní, když jsme si objasnili kódování proměnné délky a prefixní pravidlo, pojďme mluvit o Huffmanově kódování.
Metoda se zakládá na vytváření binárních stromů. V něm může být uzel buď konečný, nebo vnitřní. Původně jsou všechny uzly považovány za listy (konečné), které představují samotný symbol a jeho váhu (tj. frekvenci výskytu). Vnitřní uzly obsahují váhu symbolu a odkazují na dva uzly-dedičů. Podle obecné dohody bit „0“ představuje pokračování po levé větvi, zatímco „1“ — po pravé. V plném stromě N je listů a N-1 vnitřních uzlů. Doporučuje se, aby se při stavbě Huffmanova stromu ignorovaly nevyužívané symboly, aby bylo možné získat kódy optimální délky.
Budeme používat prioritu fronty při stavbě Huffmanova stromu, kde uzlu s nejnižší frekvencí bude přidělen nejvyšší priorita. Níže jsou popsány kroky výstavby:
- Vytvořte uzel-list pro každý symbol a přidejte je do priority fronty.
- Dokud je ve frontě více než jeden list, proveďte následující:
- Odstraňte dva uzly s nejvyšší prioritou (s nejnižší frekvencí) z fronty;
- Vytvořte nový vnitřní uzel, kde budou tyto dva uzly potomky, a frekvence výskytu bude rovna součtu frekvencí těchto dvou uzlů.
- Přidejte nový uzel do priority fronty.
- Poslední zbývající uzel bude kořenový, na tomto se stavba stromu ukončí.
Představme si, že máme nějaký text, který se skládá pouze z znaků „a“, „b“, „c“, „d“ a „e“, a jejich frekvence výskytu jsou 15, 7, 6, 6 a 5. Níže jsou ilustrace, které odrážejí kroky algoritmu.
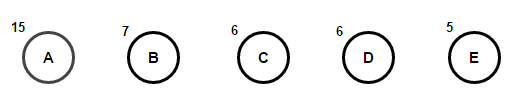
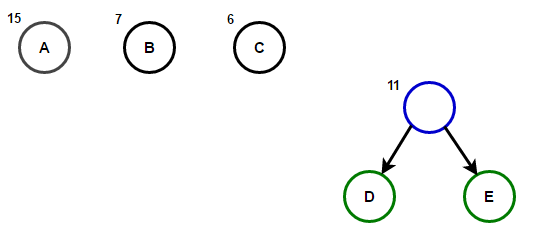
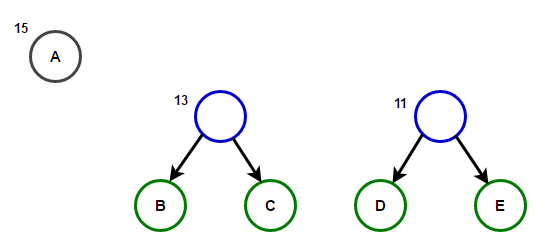
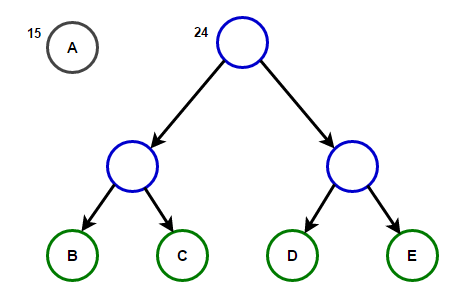
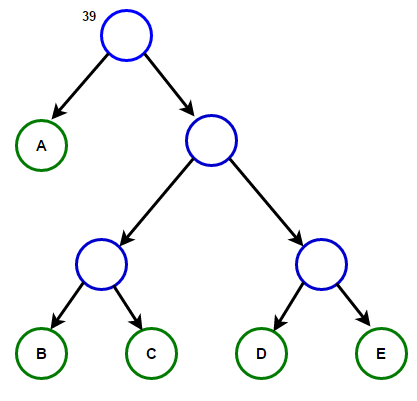
Cesta od kořene k jakémukoli koncovému uzlu bude uchovávat optimální prefixový kód (také známý jako Huffmanův kód), odpovídající znaku spojenému s tímto koncovým uzlem.
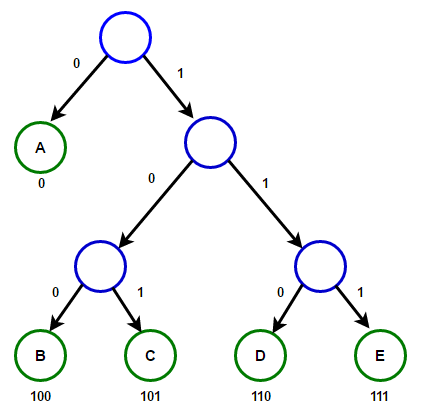
Huffmanovo strom
Níže najdete implementaci Huffmanova kompresního algoritmu v jazycích C++ a Java:
#include <iostream>
#include <string>
#include <queue>
#include <unordered_map>
using namespace std;

// A Tree node
struct Node
{
	char ch;
	int freq;
	Node *left, *right;
};

// Function to allocate a new tree node
Node* getNode(char ch, int freq, Node* left, Node* right)
{
	Node* node = new Node();

	node->ch = ch;
	node->freq = freq;
	node->left = left;
	node->right = right;

	return node;
}

// Comparison object to be used to order the heap
struct comp
{
	bool operator()(Node* l, Node* r)
	{
		// highest priority item has lowest frequency
		return l->freq > r->freq;
	}
};

// traverse the Huffman Tree and store Huffman Codes
// in a map.
void encode(Node* root, string str,
			unordered_map<char, string> &huffmanCode)
{
	if (root == nullptr)
		return;

	// found a leaf node
	if (!root->left && !root->right) {
		huffmanCode[root->ch] = str;
	}

	encode(root->left, str + "0", huffmanCode);
	encode(root->right, str + "1", huffmanCode);
}

// traverse the Huffman Tree and decode the encoded string
void decode(Node* root, int &index, string str)
{
	if (root == nullptr) {
		return;
	}

	// found a leaf node
	if (!root->left && !root->right)
	{
		cout << root->ch;
		return;
	}

	index++;

	if (str[index] =='0')
		decode(root->left, index, str);
	else
		decode(root->right, index, str);
}

// Builds Huffman Tree and decode given input text
void buildHuffmanTree(string text)
{
	// count frequency of appearance of each character
	// and store it in a map
	unordered_map<char, int> freq;
	for (char ch: text) {
		freq[ch]++;
	}

	// Create a priority queue to store live nodes of
	// Huffman tree;
	priority_queue<Node*, vector<Node*>, comp> pq;

	// Create a leaf node for each character and add it
	// to the priority queue.
	for (auto pair: freq) {
		pq.push(getNode(pair.first, pair.second, nullptr, nullptr));
	}

	// do till there is more than one node in the queue
	while (pq.size() != 1)
	{
		// Remove the two nodes of highest priority
		// (lowest frequency) from the queue
		Node *left = pq.top(); pq.pop();
		Node *right = pq.top();	pq.pop();

		// Create a new internal node with these two nodes
		// as children and with frequency equal to the sum
		// of the two nodes' frequencies. Add the new node
		// to the priority queue.
		int sum = left->freq + right->freq;
		pq.push(getNode(' ', sum, left, right));
	}

	// root stores pointer to root of Huffman Tree
	Node* root = pq.top();

	// traverse the Huffman Tree and store Huffman Codes
	// in a map. Also prints them
	unordered_map<char, string> huffmanCode;
	encode(root, "", huffmanCode);

	cout << "Huffman Codes are :n" << 'n';
	for (auto pair: huffmanCode) {
		cout << pair.first << " " << pair.second << 'n';
	}

	cout << "nOriginal string was :n" << text << 'n';

	// print encoded string
	string str = "";
	for (char ch: text) {
		str += huffmanCode[ch];
	}

	cout << "nEncoded string is :n" << str << 'n';

	// traverse the Huffman Tree again and this time
	// decode the encoded string
	int index = -1;
	cout << "nDecoded string is: n";
	while (index < (int)str.size() - 2) {
		decode(root, index, str);
	}
}

// Huffman coding algorithm
int main()
{
	string text = "Huffman coding is a data compression algorithm.";

	buildHuffmanTree(text);

	return 0;
}
import java.util.HashMap;
import java.util.Map;
import java.util.PriorityQueue;
// Uzlový bod stromu
class Node
{
char ch;
int freq;
Node left = null, right = null;
Node(char ch, int freq)
{
this.ch = ch;
this.freq = freq;
}
public Node(char ch, int freq, Node left, Node right) {
this.ch = ch;
this.freq = freq;
this.left = left;
this.right = right;
}
};
class Huffman
{
// procházet Huffmanův strom a ukládat Huffmanovy kódy
// do mapy.
public static void encode(Node root, String str,
Map huffmanCode)
{
if (root == null)
return;
// nalezeno listové uzel
if (root.left == null && root.right == null) {
huffmanCode.put(root.ch, str);
}
encode(root.left, str + "0", huffmanCode);
encode(root.right, str + "1", huffmanCode);
}
// procházet Huffmanův strom a dekódovat zakódovaný řetězec
public static int decode(Node root, int index, StringBuilder sb)
{
if (root == null)
return index;
// nalezeno listové uzel
if (root.left == null && root.right == null)
{
System.out.print(root.ch);
return index;
}
index++;
if (sb.charAt(index) == '0')
index = decode(root.left, index, sb);
else
index = decode(root.right, index, sb);
return index;
}
// Vybuduje Huffmanův strom a huffmanCode a dekóduje daný vstupní text
public static void buildHuffmanTree(String text)
{
// počítat frekvenci výskytu každého znaku
// a uložit ji do mapy
Map freq = new HashMap();
for (int i = 0 ; i < text.length(); i++) {
if (!freq.containsKey(text.charAt(i))) {
freq.put(text.charAt(i), 0);
}
freq.put(text.charAt(i), freq.get(text.charAt(i)) + 1);
}
// Vytvořit prioritní frontu pro ukládání živých uzlů Huffmanova stromu
// Pozor, že položka s nejvyšší prioritou má nejnižší frekvenci
PriorityQueue pq = new PriorityQueue(
(l, r) -> l.freq - r.freq);
// Vytvořit listový uzel pro každý znak a přidat ho
// do prioritní fronty.
for (Map.Entry entry : freq.entrySet()) {
pq.add(new Node(entry.getKey(), entry.getValue()));
}
// pokračovat dokud je ve frontě více než jeden uzel
while (pq.size() != 1)
{
// Odebrat dva uzly s nejvyšší prioritou
// (nejnižší frekvenci) z fronty
Node left = pq.poll();
Node right = pq.poll();
// Vytvořit nový vnitřní uzel s těmito dvěma uzly jako děti
// a s frekvencí rovnou součtu dvou uzlů
// frekvence. Přidat nový uzel do prioritní fronty.
int sum = left.freq + right.freq;
pq.add(new Node(' ', sum, left, right));
}
// root obsahuje ukazatel na kořen Huffmanova stromu
Node root = pq.peek();
// procházet Huffmanův strom a ukládat Huffmanovy kódy do mapy
Map huffmanCode = new HashMap();
encode(root, "", huffmanCode);
// tisknout Huffmanovy kódy
System.out.println("Huffmanovy kódy jsou :\n");
for (Map.Entry entry : huffmanCode.entrySet()) {
System.out.println(entry.getKey() + " " + entry.getValue());
}
System.out.println("\nOriginální řetězec byl :\n" + text);
// tisknout zakódovaný řetězec
StringBuilder sb = new StringBuilder();
for (int i = 0 ; i < text.length(); i++) {
sb.append(huffmanCode.get(text.charAt(i)));
}
System.out.println("\nZakódovaný řetězec je :\n" + sb);
// procházet znovu Huffmanův strom a tentokrát
// dekódovat zakódovaný řetězec
int index = -1;
System.out.println("\nDekódovaný řetězec je: \n");
while (index < sb.length() - 2) {
index = decode(root, index, sb);
}
}
public static void main(String[] args)
{
String text = "Huffmanovo kódování je algoritmus pro kompresi dat.";
buildHuffmanTree(text);
}
}Poznámka: Paměť používaná vstupním řetězcem činí 47 * 8 = 376 bitů, zatímco kódovaný řetězec zabírá pouze 194 bitů, což znamená, že data jsou komprimována přibližně o 48 %. V programu v C++ výše používáme třídu string pro uchování kódovaného řetězce, aby byl program čitelný.
Protože efektivní datové struktury prioritních front vyžadují pro vložení O(log(N)) času a v úplném binárním stromu s N listy je přítomno 2N-1 uzlů a Huffmanovo strom je úplný binární strom, pak algoritmus pracuje za O(Nlog(N)) času, kde N – je počet symbolů.
Zdroje:
Zdroj: habr.com
