

Obvykle se pro sledování a analýzu fungování Nginx používají komerční produkty nebo hotové open-source alternativy, jako je Prometheus + Grafana. To je dobrá volba pro monitorování nebo analýzu v reálném čase, ale není příliš pohodlná pro historickou analýzu. Na jakémkoli populárním webu objem dat z logů nginx rychle roste a pro analýzu velkého objemu dat je rozumné použít něco specializovanějšího.
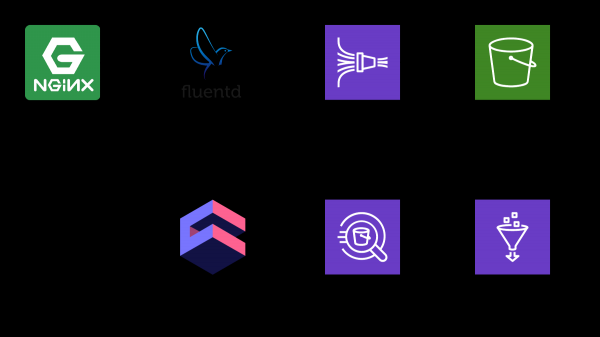
V tomto článku vám ukážu, jak lze použít k analýze logů, s příkladem Nginx, a ukážu, jak z těchto dat sestavit analytický dashboard pomocí open-source frameworku cube.js. Zde je celková architektura řešení:
TL:DR;
.
Pro sběr informací používáme , pro zpracování — a , pro ukládání — . S pomocí této kombinace lze ukládat nejen logy nginx, ale i další události a logy jiných služeb. Některé části můžete nahradit podobnými pro váš stack, například můžete zapisovat logy do Kinesis přímo z nginx, bez fluentd, nebo použít logstash pro tento účel.
Sbíráme logy Nginx
Ve výchozím nastavení logy Nginx vypadají takto:
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-up HTTP/2.0" 200 9168 "https://example.com/sign-in" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
4/9/2019 12:58:17 PM1.1.1.1 - - [09/Apr/2019:09:58:17 +0000] "GET /sign-in HTTP/2.0" 200 9168 "https://example.com/sign-up" "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_14_4) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/73.0.3683.86 Safari/537.36" "-"
Lze je zpracovat, ale mnohem snazší je upravit konfiguraci Nginx tak, aby vydával logy ve formátu JSON:
log_format json_combined escape=json '{ "created_at": "$msec", '
            '"remote_addr": "$remote_addr", '
            '"remote_user": "$remote_user", '
            '"request": "$request", '
            '"status": $status, '
            '"bytes_sent": $bytes_sent, '
            '"request_length": $request_length, '
            '"request_time": $request_time, '
            '"http_referrer": "$http_referer", '
            '"http_x_forwarded_for": "$http_x_forwarded_for", '
            '"http_user_agent": "$http_user_agent" }';

access_log  /var/log/nginx/access.log  json_combined;
S3 pro ukládání
Pro uchovávání logů budeme používat S3. To umožňuje ukládat a analyzovat logy na jednom místě, protože Athena může pracovat s daty v S3 přímo. Dále v článku vám ukážu, jak správně skladovat a zpracovávat logy, ale nejprve potřebujeme čistý bucket v S3, ve kterém nebude uložen žádný jiný obsah. Stojí za to předem zvážit, v jakém regionu bucket vytvoříte, protože Athena není dostupná ve všech regionech.
Vytváříme schéma v konzoli Athena
Vytvoříme tabulku v Athena pro logy. Je potřeba jak pro zápis, tak pro čtení, pokud plánujete použít Kinesis Firehose. Otevřete konzoli Athena a vytvořte tabulku:
SQL pro vytvoření tabulky
CREATE EXTERNAL TABLE `kinesis_logs_nginx`(
  `created_at` double,
  `remote_addr` string,
  `remote_user` string,
  `request` string,
  `status` int,
  `bytes_sent` int,
  `request_length` int,
  `request_time` double,
  `http_referrer` string,
  `http_x_forwarded_for` string,
  `http_user_agent` string)
ROW FORMAT SERDE
  'org.apache.hadoop.hive.ql.io.orc.OrcSerde'
STORED AS INPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcInputFormat'
OUTPUTFORMAT
  'org.apache.hadoop.hive.ql.io.orc.OrcOutputFormat'
LOCATION
  's3://'
TBLPROPERTIES ('has_encrypted_data'='false');
Vytváříme Kinesis Firehose Stream
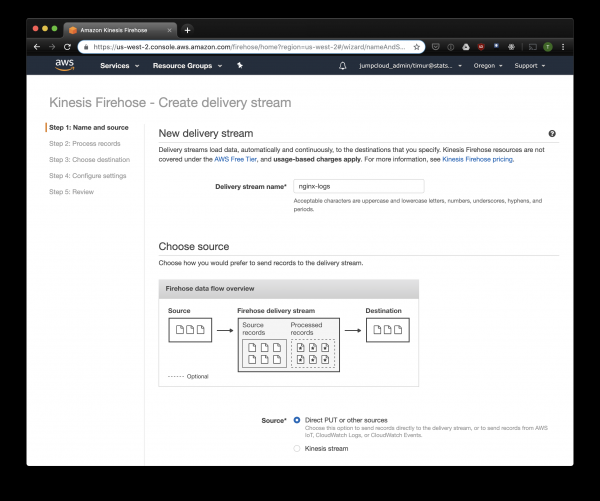
Kinesis Firehose zapíše data získaná z Nginx do S3 ve vybraném formátu, rozdělená podle adresářů ve formátu RRRR/MM/DD/HH. To se hodí při čtení dat. Samozřejmě lze zapisovat přímo do S3 z fluentd, ale v takovém případě bude nutné zapisovat ve formátu JSON, což je neefektivní kvůli velké velikosti souborů. Kromě toho, při použití PrestoDB nebo Athena je JSON nejpomalejší formát dat. Takže otevřete konzoli Kinesis Firehose, klikněte na „Create delivery stream“, vyberte „direct PUT“ v poli „delivery“:
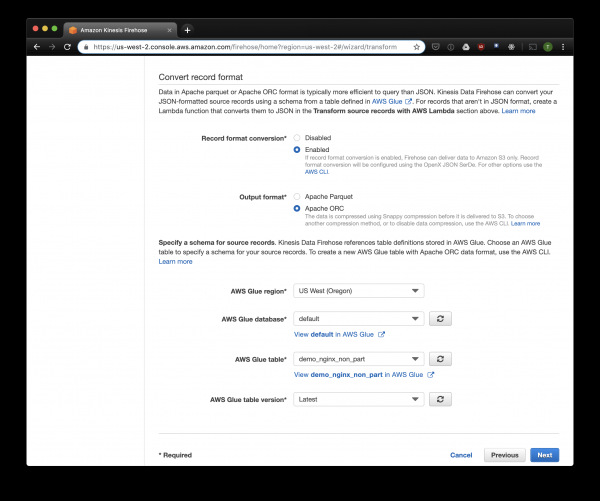
Na další kartě vyberte „Record format conversion“ — „Enabled“ a vyberte „Apache ORC“ jako formát pro zápis. Podle výzkumů některých , je to optimální formát pro PrestoDB a Athena. Jako schéma uveďte tabulku, kterou jsme vytvořili výše. Všimněte si, že S3 location v Kinesis lze uvést jakýkoli, z tabulky se používá pouze schéma. Pokud však uvedete jinou S3 location, nebudete moci tyto záznamy z této tabulky přečíst.
Vyberte S3 pro ukládání a bucket, který jsme vytvořili dříve. Aws Glue Crawler, o kterém budu hovořit později, neumí pracovat s prefixy v S3 bucketu, takže je důležité nechat ho prázdný.
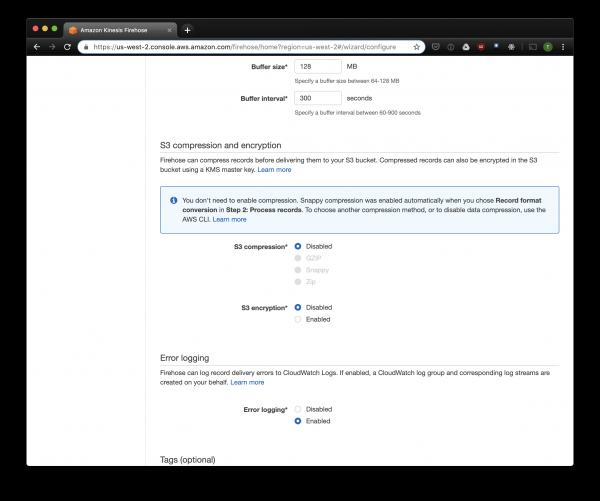
Ostatní možnosti lze měnit v závislosti na vaší zátěži, obvykle používám výchozí. Všimněte si, že komprese S3 není k dispozici, ale ORC používá vlastní kompresi ve výchozím nastavení.
Fluentd
Teď, když máme nastaveno ukládání a příjem logů, je třeba nastavit odesílání. Budeme používat , protože mám rád Ruby, ale můžete použít Logstash nebo odesílat logy přímo do Kinesis. Server Fluentd lze spustit několika způsoby, řeknu o dockeru, protože je to jednoduché a pohodlné.
Nejprve potřebujeme konfigurační soubor fluent.conf. Vytvořte ho a přidejte source:
forward
port 24224
bind 0.0.0.0
Nyní lze spustit server Fluentd. Pokud potřebujete pokročilejší konfiguraci, na najdete podrobný návod, včetně toho, jak vytvořit vlastní obraz.
$ docker run
  -d
  -p 24224:24224
  -p 24224:24224/udp
  -v /data:/fluentd/log
  -v :/fluentd/etc fluentd
  -c /fluentd/etc/fluent.conf
  fluent/fluentd:stable
Tato konfigurace používá cestu /fluentd/log pro kešování logů před odesláním. Lze se obejít bez toho, ale při restartu můžete ztratit všechny kešované údaje, které jste pracně nashromáždili. Port lze také použít jakýkoli, 24224 – to je výchozí port pro Fluentd.
Nyní, když máme spuštěný Fluentd, můžeme posílat logy Nginx. Obvykle spouštíme Nginx v Docker kontejnerech a v tom případě má Docker nativního logovacího ovladače pro Fluentd:
$ docker run
--log-driver=fluentd
--log-opt fluentd-address=
--log-opt tag="{{.Name}}"
-v /some/content:/usr/share/nginx/html:ro
-d
nginx
Pokud Nginx spouštíte jinak, můžete použít logy, ve Fluentd je k dispozici .
Přidáme do konfigurace Fluent zpracování logů, jak bylo nastaveno výše:
@type parser
  key_name log
  emit_invalid_record_to_error false

    @type json
A odeslání logů do Kinesis, pomocí :
@type kinesis_firehose
    region region
    delivery_stream_name
    aws_key_id
    aws_sec_key
Athena
Pokud jste vše správně nastavili, měli byste za chvíli (výchozí nastavení Kinesis zaznamenává přijatá data každých 10 minut) vidět logy v S3. V nabídce "monitoring" Kinesis Firehose můžete vidět, kolik dat bylo zapsáno do S3, stejně jako chyby. Nezapomeňte udělit přístup k zápisu do S3 bucketu pro Kinesis roli. Pokud Kinesis něco nedokáže analyzovat, uloží chyby do stejného bucketu.
Nyní lze data prohlížet v Athéně. Pojďme najít nedávné dotazy, na které jsme dali chyby:
SELECT * FROM "db_name"."table_name" WHERE status > 499 ORDER BY created_at DESC LIMIT 10;Skenování všech záznamů pro každý dotaz
Nyní jsou naše logy zpracovány a uloženy v S3 ve formátu ORC, komprimovány a připraveny k analýze. Kinesis Firehose dokonce rozdělil logy podle adresářů na každou hodinu. Nicméně, dokud tabulka není particionována, Athena bude pro každý dotaz načítat data za celé období, kromě několika výjimek. To je velký problém z dvou důvodů:
- Objem dat neustále roste, což zpomaluje dotazy;
- Účet za Athénu se vystavuje na základě objemu prosklených dat, s minimem 10 MB za každý dotaz.
Pro opravu toho používáme AWS Glue Crawler, který prohledá data v S3 a zapíše informace o partiích do Glue Metastore. To nám umožní používat partie jako filtr při dotazech v Athena, která pak prohledá pouze adresáře uvedené v dotazu.
Nastavujeme Amazon Glue Crawler
Amazon Glue Crawler skenuje všechna data v S3 bucketu a vytváří tabulky s partiemi. Vytvořte Glue Crawler z konzole AWS Glue a přidejte bucket, ve kterém uchováváte data. Jednoho crawlera můžete použít pro několik bucketů, v takovém případě vytvoří tabulky ve zvolené databázi se jmény odpovídajícími názvům bucketů. Pokud plánujete tato data používat pravidelně, nezapomeňte nastavit plán spuštění crawlera podle svých potřeb. Používáme jednoho crawlera pro všechny tabulky, který se spouští každou hodinu.
Tabulky s partiemi
Po prvním spuštění crawlera by měly být v databázi, kterou jste uvedli v nastaveních, dostupné tabulky pro každý prozkoumaný bucket. Otevřete konzoli Athena a najděte tabulku s logy Nginx. Zkusme něco přečíst:
SELECT * FROM "default"."part_demo_kinesis_bucket"
WHERE(
  partition_0 = '2019' AND
  partition_1 = '04' AND
  partition_2 = '08' AND
  partition_3 = '06'
  );
Tento dotaz vybere všechny záznamy, které byly získány od 6 do 7 ráno 8. dubna 2019. Ale jak je to efektivnější než prosté čtení z ne-partionované tabulky? Zjistíme to a vybereme ty samé záznamy podle časového razítka:
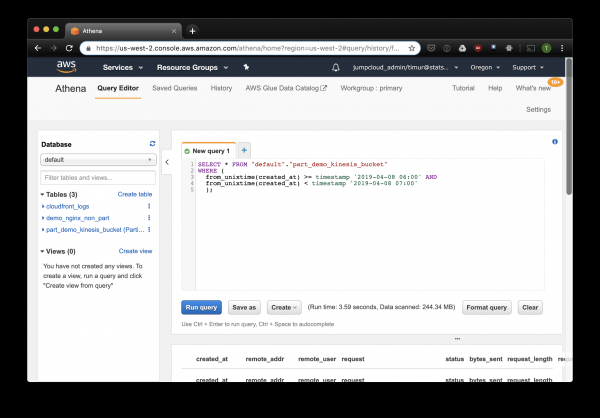
3.59 sekundy a 244.34 megabajtů dat na datasetu, ve kterém jsou pouze týdenní logy. Zkusme filtr přes partie:
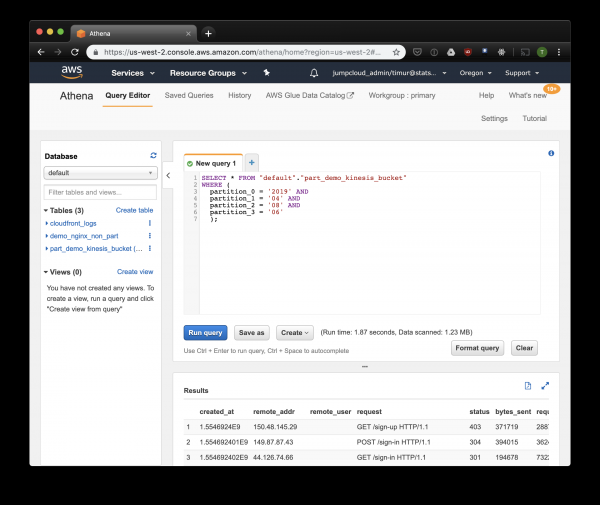
Trochu rychlejší, ale to nejdůležitější — pouze 1.23 megabajty dat! Bylo by to mnohem levnější, kdyby nebylo minimálních 10 megabajtů za dotaz v ceníku. Ale stále mnohem lepší, a na větších datasetech bude rozdíl mnohem impozantnější.
Собираем дэшборд с помощью Cube.js
Pro sestavení dashboardu používáme analytický rámec Cube.js. Má poměrně mnoho funkcí, ale nás zajímají dvě: schopnost automaticky používat filtry podle partií a pre-aggregaci dat. Používá schéma dat, , napsané v Javascriptu, aby vygenerovalo SQL a provedlo dotaz na databázi. Od nás se vyžaduje pouze uvést, jak použít filtr podle partií v datovém schématu.
Vytvoříme novou aplikaci Cube.js. Protože již používáme AWS stack, je logické použít Lambda pro nasazení. Můžete použít express šablonu pro generaci, pokud plánujete hostovat Cube.js backend na Heroku nebo Docker. V dokumentaci jsou popsány další .
$ npm install -g cubejs-cli
$ cubejs create nginx-log-analytics -t serverless -d athena
Pro nastavení přístupu k databázi v cube.js se používají proměnné prostředí. Generátor vytvoří soubor .env, ve kterém můžete zadat své klíče pro .
Nyní budeme potřebovat , ve které určíme, jak jsou naše logy uloženy. Také zde můžeme zadat, jak počítat metriky pro dashboardy.
V adresáři schema, vytvořte soubor Logs.js. Zde je příklad datového modelu pro nginx:
Kód modelu
const partitionFilter = (from, to) => `
    date(from_iso8601_timestamp(${from})) = date_parse(partition_0 || partition_1 || partition_2, '%Y%m%d')
    `

cube(`Logs`, {
  sql: `
  select * from part_demo_kinesis_bucket
  WHERE ${FILTER_PARAMS.Logs.createdAt.filter(partitionFilter)}
  `,

  measures: {
    count: {
      type: `count`,
    },

    errorCount: {
      type: `count`,
      filters: [
        { sql: `${CUBE.isError} = 'Yes'` }
      ]
    },

    errorRate: {
      type: `number`,
      sql: `100.0 * ${errorCount} / ${count}`,
      format: `percent`
    }
  },

  dimensions: {
    status: {
      sql: `status`,
      type: `number`
    },

    isError: {
      type: `string`,
      case: {
        when: [{
          sql: `${CUBE}.status >= 400`, label: `Yes`
        }],
        else: { label: `No` }
      }
    },

    createdAt: {
      sql: `from_unixtime(created_at)`,
      type: `time`
    }
  }
});
Zde používáme proměnnou , abychom vygenerovali SQL dotaz s filtrem podle partií.
Také nastavujeme metriky a parametry, které chceme zobrazit na dashboardu, a určujeme před-aggregace. Cube.js vytvoří další tabulky s před-aggregovanými daty a automaticky aktualizuje data s každým příchozím požadavkem. To umožňuje nejen urychlit dotazy, ale také snížit náklady na používání služby Athena.
Přidáme tyto informace do souboru schématu dat:
preAggregations: {
  main: {
    type: `rollup`,
    measureReferences: [count, errorCount],
    dimensionReferences: [isError, status],
    timeDimensionReference: createdAt,
    granularity: `day`,
    partitionGranularity: `month`,
    refreshKey: {
      sql: FILTER_PARAMS.Logs.createdAt.filter((from, to) =>
        `select
           CASE WHEN from_iso8601_timestamp(${to}) + interval '3' day > now()
           THEN date_trunc('hour', now()) END`
      )
    }
  }
}
V tomto modelu určujeme, že je třeba před-aggregovat data pro všechny používané metriky a použít dělení podle měsíců. může výrazně urychlit sběr a aktualizaci dat.
Teď můžeme sestavit dashboard!
Backend Cube.js poskytuje a sadu klientských knihoven pro populární frontendové frameworky. Použijeme React verzi klienta pro sestavení dashboardu. Cube.js poskytuje pouze data, takže budeme potřebovat knihovnu pro vizualizace — mě líbí , ale můžete použít jakoukoli jinou.
Server Cube.js přijímá požadavek ve , ve kterém jsou uvedeny potřebné metriky. Například, abychom spočítali, kolik chyb vrátil Nginx po dnech, musíme poslat takový požadavek:
{
  "measures": ["Logs.errorCount"],
  "timeDimensions": [
    {
      "dimension": "Logs.createdAt",
      "dateRange": ["2019-01-01", "2019-01-07"],
      "granularity": "day"
    }
  ]
}
Nainstalujeme Cube.js klienta a React komponenty přes NPM:
$ npm i --save @cubejs-client/core @cubejs-client/reactImportujeme komponenty cubejs a QueryRenderer, abychom načetli data, a sestavíme dashboard:
Kód dashboardu
import React from 'react';
import { LineChart, Line, XAxis, YAxis } from 'recharts';
import cubejs from '@cubejs-client/core';
import { QueryRenderer } from '@cubejs-client/react';

const cubejsApi = cubejs(
  'YOUR-CUBEJS-API-TOKEN',
  { apiUrl: 'http://localhost:4000/cubejs-api/v1' },
);

export default () => {
  return (
     {
        if (!resultSet) {
          return 'Načítání...';
        }

        return (


        );
      }}
    />
  )
}
Zdroje dashboardu jsou k dispozici na .
Zdroj: habr.com
