

Pokud spravujete virtuální infrastrukturu na bázi VMware vSphere (nebo jakéhokoli jiného technologického stacku), pravděpodobně často slýcháte od uživatelů stížnosti: „Virtuální stroj běží pomalu!“. V této sérii článků si podrobně probereme metriky výkonnosti a povíme si, co a proč „zpomalují“ a jak tomu předejít.
Budu zvažovat následující aspekty výkonnosti virtuálních strojů:
- CPU,
- RAM,
- DISK,
- Síť.
Začnu s CPU.
K analýze výkonnosti budeme potřebovat:
- vCenter Performance Counters – výkonové ukazatele, jejichž grafy si můžete prohlédnout přes vSphere Client. Informace o těchto ukazatelích jsou dostupné v jakékoli verzi klienta ("tlustý" klient na C#, webový klient na Flex a webový klient na HTML5). V těchto článcích budeme používat screenshoty z C# klienta, pouze proto, že vypadají lépe v miniaturní podobě :)
- ESXTOP – nástroj, který lze spustit z příkazového řádku ESXi. Pomocí něj můžete získat hodnoty výkonových ukazatelů v reálném čase nebo exportovat tyto hodnoty za určité období do .csv souboru pro další analýzu. Později se o tomto nástroji zmíním podrobněji a přidám několik užitečných odkazů na dokumentaci a články na toto téma.
Trochu teorie
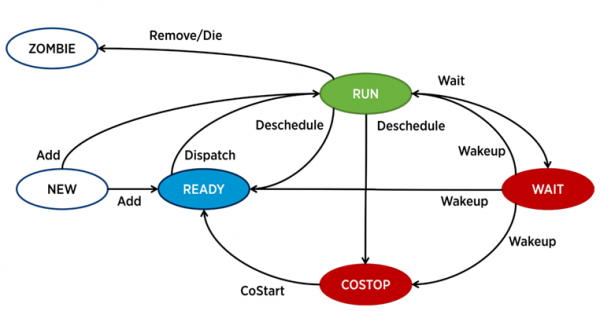
V ESXi zodpovídá za práci každého vCPU (jádra virtuálního stroje) samostatný proces – world v terminologii VMware. Existují také servisní procesy, ale z hlediska analýzy výkonu VM jsou méně zajímavé.
Proces v ESXi může být v jednom ze čtyř stavů:
- Spustit – proces vykonává nějakou užitečnou práci.
- Čekání – proces nevykonává žádnou práci (idle) nebo čeká na vstup/výstup.
- Costop – stav, který vzniká v vícejádrových virtuálních strojích. Vzniká, když plánovač CPU hypervizoru (ESXi CPU Scheduler) nedokáže naplánovat současné spuštění na fyzických jádrech serveru všech aktivních jader virtuálního stroje. Ve fyzickém světě fungují všechna jádra procesoru paralelně, hostitelský operační systém uvnitř VM se spoléhá na podobné chování, a proto musíte hypervizoru zpomalit jádra VM, která mají možnost dokončit cyklus rychleji. V moderních verzích ESXi používá plánovač CPU mechanismus zvaný relaxed co-scheduling: hypervizor považuje rozdíl mezi nejrychlejším a nejpomalejším jádrem virtuálního stroje (skew). Pokud tento rozdíl překročí určitou hranici, „rychlé“ jádro přechází do stavu costop. Pokud jádra VM tráví mnoho času v tomto stavu, může to způsobit problémy s výkonem.
- Ready – proces přechází do tohoto stavu, když hypervizor nemá možnost alokovat prostředky pro jeho vykonání. Vysoké hodnoty ready mohou způsobit problémy s výkonem VM.
Hlavní ukazatele výkonu CPU virtuálního stroje
Využití CPU, %. Ukazuje procento využití CPU za zadané období.
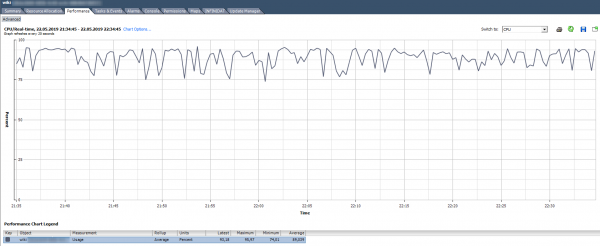
Jak analyzovat? Pokud VM stabilně využívá CPU na 90 % nebo jsou nárazy až na 100 %, máme problém. Problémy se mohou projevovat nejen v „pomalé“ práci aplikace uvnitř VM, ale i v nedostupnosti VM přes síť. Pokud monitorovací systém ukazuje, že VM se občas odpojuje, věnujte pozornost vrcholům v grafu využití CPU.
Existuje standardní Alarm, který ukazuje zatížení CPU virtuálního stroje:
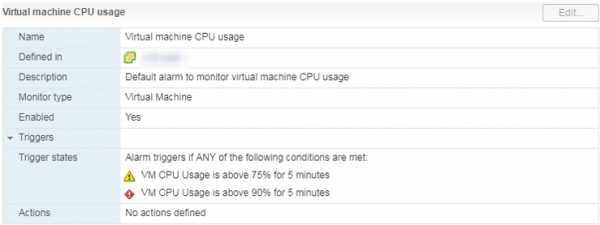
Co dělat? Pokud má VM neustále vysoké využití CPU, je možné uvažovat o zvýšení počtu vCPU (bohužel to není vždy účinné) nebo přesunout VM na server s výkonnějšími procesory.
Využití CPU v Mhz
V grafech na vCenter lze vidět využití v % pouze celého virtuálního stroje, grafy pro jednotlivá jádra nejsou (v Esxtopu jsou hodnoty % podle jader). Pro každé jádro lze vidět využití v MHz.
Jak analyzovat? Někdy může aplikace být neoptimalizována pro vícejádrovou architekturu: používá na 100 % pouze jedno jádro, zatímco ostatní zůstávají bez zátěže. Například při výchozích nastaveních zálohy MS SQL spouští proces pouze na jednom jádře. Výsledkem je, že zálohování zpomaluje ne kvůli pomalé rychlosti disků (na co si uživatel stěžoval), ale kvůli tomu, že procesor nezvládá. Problém byl vyřešen změnou parametrů: zálohování začalo běžet paralelně v několika souborech (a tím pádem v několika procesech).
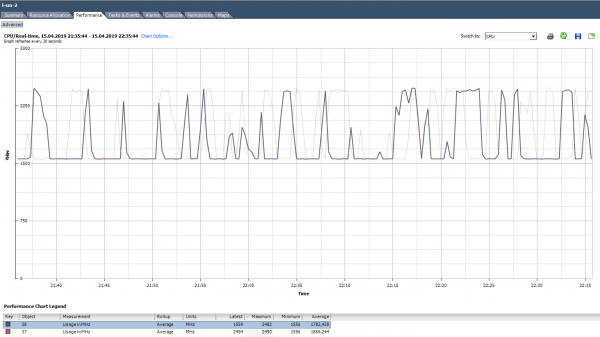
Příklad nevyváženého zatížení jader.
Může také nastat situace (jak je znázorněno na grafu výše), kdy jsou jádra zatížena nevyváženě a některá z nich mají špičky na 100 %. Stejně jako při zatížení pouze jednoho jádra alarm na CPU Usage neobstojí (je na celé VM), ale problémy s výkonem se projeví.
Co dělat? Pokud software ve virtuální mašině zatěžuje jádra nevyváženě (používá pouze jedno jádro nebo část jader), není smysl zvyšovat jejich počet. V takovém případě je lepší přesunout VM na server s výkonnějšími procesory.
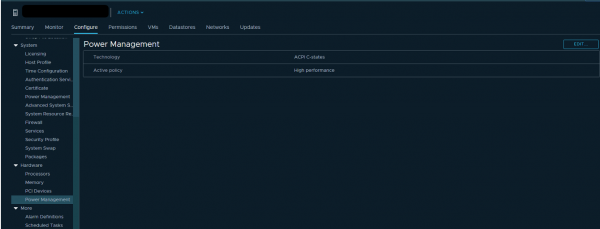
Můžete také zkusit zkontrolovat nastavení spotřeby energie v BIOSu serveru. Mnoho administrátorů zapíná v BIOSu režim Vysoký výkon a tímto způsobem vypínají technologie úspory energie C-states a P-states. V moderních procesorech Intel se používá technologie Turbo Boost, která zvyšuje frekvenci jednotlivých jader procesoru na úkor jiných jader. Ale funguje jen při zapnutých technologiích úspory energie. Pokud je vypneme, procesor nemůže snížit spotřebu energie jader, která nejsou zatížena.
VMware doporučuje nevypínat technologie úspory energie na serverech, ale vybírat režimy, které maximálně předávají kontrolu nad spotřebou energie hypervisoru. Při tom by se v nastaveních spotřeby energie hypervisoru měl vybrat režim Vysoký výkon.
Pokud máte ve své infrastruktuře samostatné VM (nebo jádra VM), které vyžadují zvýšenou frekvenci CPU, správné nastavení spotřeby energie může výrazně zlepšit jejich výkon.
CPU Ready (Připravenost)
Pokud je jádro VM (vCPU) ve stavu Ready, neprovádí užitečnou práci. Tento stav nastává, když hypervizor nenachází dostupné fyzické jádro, na které by mohl přiřadit proces vCPU virtuální stroje.
Jak analyzovat? Obvykle, pokud jsou jádra virtuálního stroje ve stavu Ready více než 10% času, zaznamenáte problémy s výkonem. Jinými slovy, více než 10% času VM čeká na dostupnost fyzických zdrojů.
Ve vCenter lze sledovat 2 ukazatele související s CPU Ready:
- Readiness,
- Ready.
Hodnoty obou ukazatelů lze sledovat jak pro celý VM, tak pro jednotlivá jádra.
Readiness ukazuje hodnotu ihned v procentech, ale pouze v reálném čase (data za poslední hodinu, interval měření 20 sekund). Tento ukazatel je lepší používat pouze pro identifikaci problémů „na místě“.
Hodnoty ukazatele Ready lze také sledovat v historickém kontextu. To je užitečné pro určení vzorců a pro hlubší analýzu problému. Například, pokud má virtuální stroj problémy s výkonem v určitou dobu, lze spojit intervaly zvýšené hodnoty CPU Ready s celkovým zatížením serveru, na kterém daný VM běží, a přijmout opatření ke snížení zatížení (pokud si DRS neporadilo).
Ready na rozdíl od Readiness není zobrazen v procentech, ale v milisekundách. Je to ukazatel typu Sumarizace, což znamená, že ukazuje, jak dlouho v průběhu měření bylo jádro VM ve stavu Ready. Tento údaj lze převést na procenta pomocí jednoduchého vzorce:
(součet CPU ready hodnoty / (výchozí interval aktualizace grafu v sekundách * 1000)) * 100 = CPU ready %
Například pro VM na níže uvedeném grafu dosáhne maximální hodnota Ready pro celý virtuální stroj následujícího:

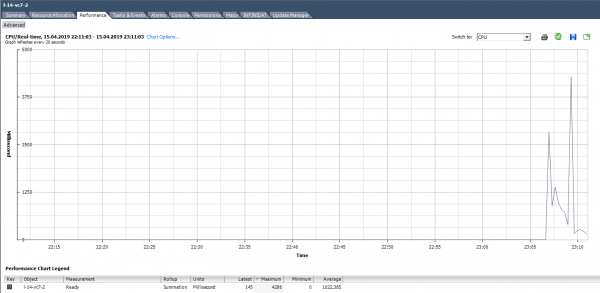
Při výpočtu hodnoty Ready v procentech je třeba věnovat pozornost dvěma bodům:
- Celkové hodnoty Ready pro VM jsou součtem Ready pro jádra.
- Interval měření. Pro reálný čas – to je 20 sekund, a například na denních grafech – to je 300 sekund.
Při aktivním řešení problémů lze tyto jednoduché body snadno opomenout a ztratit cenný čas na řešení neexistujících problémů.
Vypočítáme Ready na základě údajů z grafu níže. (324474/(20*1000))*100 = 1622% na celou VM. Pokud se podíváme na jádra, výsledek už není tak dramatický: 1622/64 = 25% na jádro. V tomto případě je celkem snadné odhalit podvod: hodnota Ready není realistická. Pokud však hovoříme o 10–20% na celou VM s několika jádry, může být hodnota na každém jádru v normálních mezích.
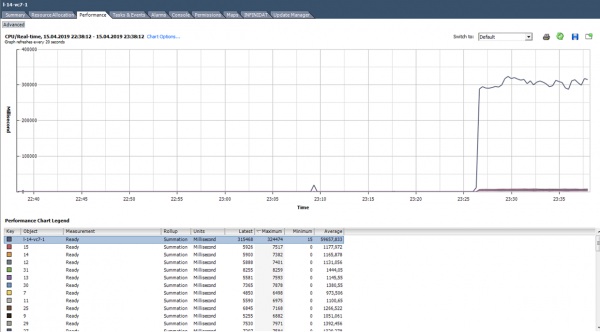
Co dělat? Vysoká hodnota Ready naznačuje, že serveru chybí procesorové zdroje pro správnou činnost virtuálních strojů. V takové situaci nezbývá než snížit překlep na procesoru (vCPU:pCPU). Toho lze dosáhnout zmenšením parametrů stávajících VM nebo migrací části VM na jiné servery.
Co-stop
Jak analyzovat? Tento čítač má také typ Sumace a přepočítává se na procenta podobně jako Ready:
(CPU co-stop summation value / (výchozí časový interval aktualizace grafu v sekundách * 1000)) * 100 = % CPU co-stop
Je třeba také věnovat pozornost počtu jader na VM a intervalu měření.
Ve stavu co-stop jádro nevykonává užitečnou práci. Při správném výběru velikosti VM a normálním zatížení serveru by měl čítač co-stop být blízký nule.
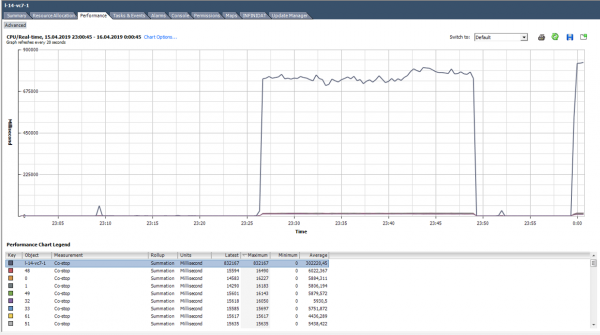
V tomto případě je zatížení zjevně nenormální :)
Co dělat? Pokud na jednom hypervizoru běží více VM s velkým počtem jader a dochází k překlepům na CPU, může se čítač co-stop zvýšit, což povede k problémům s výkonem těchto VM.
Také se co-stop zvýší, pokud se pro aktivní jádra jedné VM používají vlákna na jednom fyzickém jádru serveru se zapnutým hyper-threadingem. Taková situace může nastat, pokud má VM více jader, než je fyzicky dostupné na serveru, kde běží, nebo pokud je pro VM zapnuta volba "preferHT". O této volbě si můžete přečíst .
Aby se předešlo problémům s výkonem VM kvůli vysokému co-stop, vybírejte velikost VM v souladu s doporučeními výrobce softwaru, který na této VM běží, a podle možností fyzického serveru, na kterém VM pracuje.
Nedávejte jádra na zásobu, to může způsobit problémy s výkonem nejen samotné VM, ale i jejích sousedů na serveru.
Další užitečné metriky CPU
Spustit – kolik času (ms) v průběhu měřeného období vCPU strávil ve stavu RUN, tedy skutečně vykonával užitečnou práci.
Idle – jak dlouho (ms) byl vCPU během měření v klidovém stavu. Vysoké hodnoty Idle nejsou problém, jen prostě vCPU neměl "co dělat".
Čekání – jak dlouho (ms) byl vCPU během měření ve stavu Wait. Jelikož do tohoto počítadla se zahrnuje IDLE, vysoké hodnoty Wait také neznamenají, že by byl problém. Ale pokud je při vysokém Wait IDLE nízké, znamená to, že VM čekala na dokončení vstupně/výstupních operací, což může naznačovat problém s výkonem pevného disku nebo nějakých virtuálních zařízení VM.
Maximální omezení – jak dlouho (ms) byl vCPU během měření ve stavu Ready kvůli nastavenému limitu na zdroje. Pokud je výkon nečekaně nízký, je užitečné zkontrolovat hodnotu tohoto počítadla a limit na CPU v nastavení VM. Může se stát, že VM má nastaveny limity, o kterých nevíte. Například se to děje, když byla VM zduplikována z šablony, na které byl nastaven limit na CPU.
Swap wait – jak dlouho vCPU čekal na operace s VMkernel Swap během měření. Pokud jsou hodnoty tohoto počítadla nad nulou, pak má VM určitě problémy s výkonem. O SWAPu si povíme více v článku o počitadlech paměti.
ESXTOP
Pokud jsou počitadla výkonu ve vCenter dobrá pro analýzu historických dat, pak je lepší provádět operační analýzu problému v ESXTOP. Zde jsou všechny hodnoty prezentovány hotově (není potřeba nic převádět) a minimální měřící období je 2 sekundy.
Obrazovka ESXTOP pro CPU se vyvolává klávesou „c“ a vypadá následovně:

Pro pohodlí můžete nechat pouze procesy virtuálních strojů stisknutím Shift-V.
Chcete-li zobrazit metriky pro jednotlivé jádra VM, stiskněte „e“ a zadejte GID zájmové VM (30919 na snímku níže):
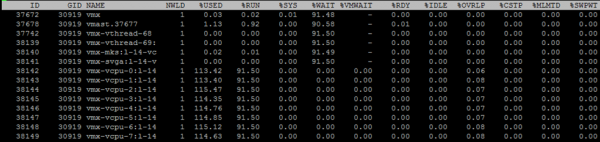
Stručně projdu sloupci, které jsou výchozí. Další sloupce lze přidat stisknutím „f“.
NWLD (Počet světů) – počet procesů ve skupině. Chcete-li rozbalit skupinu a zobrazit metriky pro každý proces (například pro každé jádro vícejádrové VM), stiskněte “e”. Pokud je ve skupině více než jeden proces, pak jsou hodnoty metrik pro skupinu rovny součtu metrik pro jednotlivé procesy.
%USED – kolik cyklů CPU serveru používá proces nebo skupina procesů.
%RUN – kolik času byl proces ve stavu RUN, tj. vykonával užitečnou práci během sledovaného období. Liší se od %USED tím, že nezohledňuje hyper-threading, frekvenční škálování a čas strávený na systémových úlohách (%SYS).
%SYS – čas strávený na systémových úlohách, například: zpracování přerušení, vstup/výstup, práce se sítí atd. Hodnota může být vysoká, pokud má VM velký vstup/výstup.
%OVRLP – kolik času fyzické jádro, na kterém běží VM proces, strávilo na úlohách jiných procesů.
Tato měření jsou mezi sebou propojena následujícím způsobem:
%USED = %RUN + %SYS — %OVRLP.
Obvykle je metrika %USED informativnější.
%WAIT – kolik času byl proces ve stavu Wait během sledovaného období. Zahrnuje IDLE.
%IDLE – kolik času byl proces ve stavu IDLE během sledovaného období.
%SWPWT – kolik času v průběhu sledovaného období vCPU čekal na operaci VMkernel Swap.
%VMWAIT – kolik času byl vCPU ve stavu čekání na událost (obvykle vstup/výstup) během sledovaného období. V vCenter není ekvivalentní čítač. Vysoké hodnoty naznačují problémy s vstupem/výstupem na VM.
%WAIT = %VMWAIT + %IDLE + %SWPWT.
Pokud VM nepoužívá VMkernel Swap, je při analýze problémů s výkonem rozumné se zaměřit na %VMWAIT, protože tato metrika nezohledňuje čas, kdy VM nic nedělala (%IDLE).
%RDY – kolik času byl proces ve stavu Ready během sledovaného období.
%CSTP – kolik času byl proces ve stavu costop během sledovaného období.
%MLMTD – kolik času byl vCPU ve stavu Ready kvůli nastavenému limitu na zdroje během sledovaného období.
%WAIT + %RDY + %CSTP + %RUN = 100% – jádro VM je vždy v nějakém z těchto čtyř stavů.
CPU na hypervizoru
V vCenter jsou také čítače výkonnosti CPU pro hypervizor, ale nepředstavují nic zajímavého – jsou to prostě součty čítačů ze všech VM na serveru.
Nejlépe je sledovat stav CPU na serveru na záložce Shrnutí:
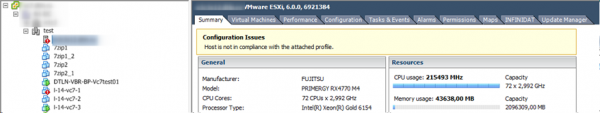
Pro server, stejně jako pro virtuální stroj, existuje standardní Alarm:
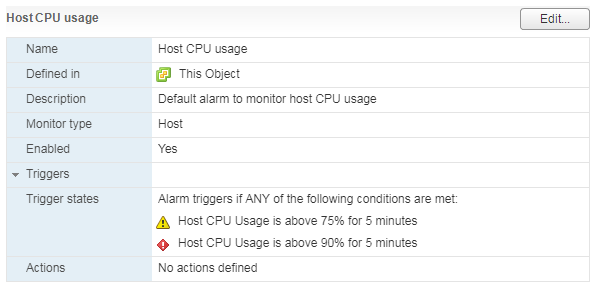
Při vysoké zátěži CPU serveru začínají VM, které na něm běží, mít problémy s výkonem.
V ESXTOP jsou data o zatížení CPU serveru zobrazena v horní části obrazovky. Kromě standardního zatížení CPU, které je málo informativní pro hypervizory, existují ještě tři metriky:
CORE UTIL(%) – zatížení jádra fyzického serveru. Tento měřič ukazuje, kolik času během měřícího období jádro vykonávalo práci.
PCPU UTIL(%) – pokud je aktivován hyper-threading, na každé fyzické jádro připadnou dva vlákna (PCPU). Tato metrika ukazuje, kolik času každé vlákno vykonávalo práci.
PCPU USED(%) – totéž jako PCPU UTIL(%), ale bere v úvahu frequency scaling (buď snížení frekvence jádra za účelem úspory energie, nebo zvýšení frekvence jádra pomocí technologie Turbo Boost) a hyper-threading.
PCPU_USED% = PCPU_UTIL% * efektivní frekvence jádra / nominální frekvence jádra.
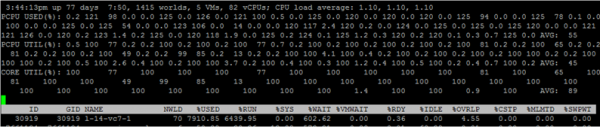
Na tomto snímku obrazovky je pro některá jádra hodnoty USED vyšší než 100%, protože frekvence jádra je vyšší než nominální kvůli práci Turbo Boost.
Pár slov o tom, jak se zohledňuje hyper-threading. Pokud procesy běží 100% času na obou vláknech fyzického jádra serveru, přičemž jádro pracuje na nominální frekvenci, pak:
- CORE UTIL pro jádro bude 100%,
- PCPU UTIL pro obě vlákna bude 100%,
- PCPU USED pro obě vlákna bude 50%.
Pokud obě vlákna nepracovala 100% času během měřeného období, pak se v těch obdobích, kdy vlákna pracovaly současně, PCPU USED pro jádra dělí na polovinu.
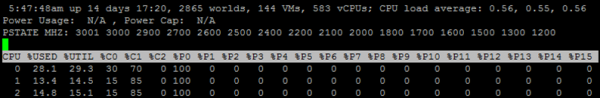
V ESXTOP je také obrazovka s parametry spotřeby energie CPU serveru. Zde můžete zjistit, zda server využívá technologie úspory energie: C-states a P-states. Otevře se klávesou „p“:
Standardní problémy s výkonem CPU
Nakonec si projdu typické příčiny problémů s výkonem CPU VM a dám krátké rady, jak je řešit:
Nedostatek taktovací frekvence jádra. Pokud není možné převést VM na výkonnější jádra, můžete zkusit změnit nastavení správy energie, aby Turbo Boost fungoval efektivněji.
Nesprávné velikování VM (příliš mnoho/málo jader). Pokud je jader málo, bude vysoké zatížení CPU VM. Pokud hodně, narazíte na vysoký co-stop.
Velká přeplatba za CPU na serveru. Pokud má VM vysoký Ready, snižte přeplatbu za CPU.
Nesprávná NUMA topologie na velkých VM. Topologie NUMA, kterou vidí VM (vNUMA), by měla odpovídat topologii NUMA serveru (pNUMA). O diagnostice a možných řešeních tohoto problému se píše například v knize . Pokud se nechcete příliš zabývat a nemáte licenční omezení na OS nainstalovaném na VM, vytvořte na VM více virtuálních soketů s jedním jádrem. Mnoho neztratíte 🙂
To je vše ohledně CPU. Ptejte se. V další části vám povím o operační paměti.
Užitečné odkazy
Zdroj: habr.com
