

Dnes se podíváme na metriky diskového subsystému v vSphere. Problém se skladováním je nejčastější příčinou pomalého provozu virtuálního stroje. Zatímco u CPU a RAM troubleshooting končí na úrovni hypervizoru, u problémů s diskem může být nutné se zabývat sítí a úložišti dat.
Téma budu rozebírat na příkladu blokového přístupu k úložišti, i když při files accessible jsou ukazatele přibližně stejné.
Trochu teorie
Když se mluví o výkonu diskového subsystému virtuálních strojů, obvykle se zaměřujeme na tři vzájemně související parametry:
- počet operací vstupu/výstupu (Input/Output Operations Per Second, IOPS);
- průchodnost (Throughput);
- prodlevu operací vstupu/výstupu (Latency).
Počet IOPS je obvykle důležitý pro náročnosti náhodného charakteru (random): přístup k blokům na disku, které jsou umístěny na různých místech. Příkladem takového zatížení mohou být databáze, obchodní aplikace (ERP, CRM) atd.
Šířka pásma je důležitý pro zatížení sekvenčního charakteru: přístup k blokům umístěným za sebou. Například takové zatížení mohou generovat souborové servery (ale ne vždy) a systémy videonahrávání.
Průchodnost souvisí s počtem operací vstupu/výstupu následujícím způsobem:
Throughput = IOPS * Velikost bloku, kde Velikost bloku je velikost bloku.
Velikost bloku je poměrně důležitá charakteristika. Moderní verze ESXi propouštějí bloky o velikosti až 32 767 KB. Pokud je blok ještě větší, je rozdělen na více. Ne všechna úložiště mohou efektivně pracovat s tak velkými bloky, proto v pokročilých nastaveních ESXi existuje parametr DiskMaxIOSize. Pomocí něj je možné snížit maximální velikost bloku, který hypervizor propouští (více ). Doporučuji se před změnou tohoto parametru poradit s výrobcem úložiště nebo alespoň otestovat změny na laboratorním stánku.
Velká velikost bloku může negativně ovlivnit výkon úložiště. I když je počet IOPS a throughput relativně malý, při velké velikosti bloku mohou být pozorovány vysoké prodlevy. Proto si na tento parametr dejte pozor.
Latence – nejzajímavější parametr výkonu. Prodleva operací vstupu/výstupu pro virtuální stroj se skládá z:
- prodlevy uvnitř hypervizoru (KAVG, Average Kernel MilliSec/Read);
- zpoždění, které poskytuje síť pro přenos dat a úložiště (DAVG, průměrné zpoždění řidiče v milisekundách/příkaz).
Celkové zpoždění, které je viditelné v hostitelském operačním systému (GAVG, průměrné zpoždění hosta v milisekundách/příkaz), je součtem KAVG a DAVG.
GAVG a DAVG se měří, zatímco KAVG se vypočítává: GAVG–DAVG.
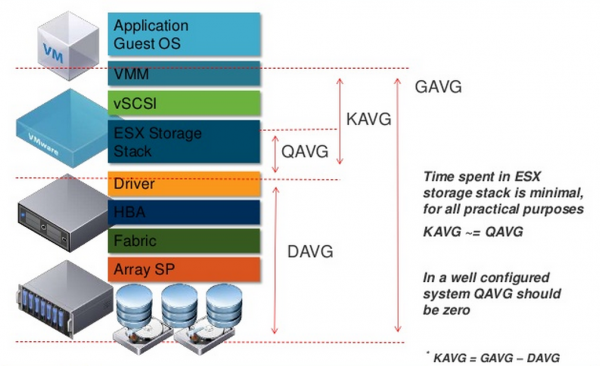
Pojďme se podrobněji zaměřit na KAVG. Při normálním chodu by KAVG měl směřovat k nule nebo alespoň být značně menší než DAVG. Jediný známý případ, kdy je KAVG očekávaně vysoké, jsou omezení IOPS na disku VM. V tomto případě bude KAVG růst při pokusu o překročení limitu.
Nejvýznamnější složkou KAVG je QAVG – čas strávený ve frontě na zpracování uvnitř hypervizora. Ostatní složky KAVG jsou zanedbatelné.
Fronta v ovladači diskového adaptéru a fronty k lunám mají pevnou velikost. Pro vysoce zatížené prostředí může být užitečné tuto velikost zvýšit. je popsáno, jak zvýšit fronty v ovladači adaptéru (současně se zvýší fronta k lunám). Toto nastavení funguje, když s lunou pracuje pouze jeden VM, což se stává zřídka. Pokud má lunu více VM, je také nutné zvýšit parametr Disk.SchedNumReqOutstanding (pokyn ). Zvýšením fronty snižujete QAVG a KAVG odpovídajícím způsobem.
Ale znovu, nejprve se seznamte s dokumentací od dodavatele HBA a otestujte změny na laboratorním prostředí.
Na velikost fronty k luně může mít vliv aktivace mechanismu SIOC (Storage I/O Control). Ten zajišťuje rovnoměrný přístup k luně ze strany všech serverů v clusterech tím, že dynamicky mění frontu k luně na serverech. To znamená, že pokud na nějakém z hostitelů běží VM, která vyžaduje nepřiměřeně mnoho výkonu (noisy neighbor VM), SIOC zkracuje délku fronty k luně na tomto hostiteli (DQLEN). Podrobněji .
S KAVG jsme se zabývali, nyní něco o DAVG. Tady je to jednoduché: DAVG je zpoždění, které zavádí vnější prostředí (síť pro přenos dat a úložiště). V každém moderním, ale i v méně moderním úložišti jsou své výkonnostní počítadla. Pro analýzu problémů s DAVG má smysl se na ně podívat. Pokud je z pohledu ESXi a úložiště vše v pořádku, zkontrolujte síť pro přenos dat.
Aby se předešlo problémům s výkonem, vyberte správnou politiku výběru cesty (PSP) pro váš úložný systém. V podstatě všechny moderní úložné systémy podporují politiku Round-Robin PSP (s ALUA, asymetrickým přístupem k logickým jednotkám, nebo bez něj). Tato politika umožňuje využít všechny dostupné cesty k úložnému systému. V případě ALUA se používají pouze cesty k řadiči, který vlastní LUN. Ne pro všechny úložné systémy na ESXi existují výchozí pravidla, která nastavují politiku Round-Robin. Pokud pro váš úložný systém pravidlo neexistuje, použijte plugin od výrobce úložného systému, který vytvoří odpovídající pravidlo na všech hostitelích clusteru, nebo vytvořte pravidlo sami. Další podrobnosti .
Také někteří výrobci úložných systémů doporučují změnit počet IOPS na cestě ze standardní hodnoty 1000 na 1. V naší praxi to umožnilo „vytáhnout“ z úložného systému více výkonu a výrazně zkrátit čas potřebný na failover v případě selhání nebo aktualizace řadičů. Ověřte si doporučení dodavatele, a pokud nejsou žádná omezení, zkuste tuto hodnotu změnit. Další podrobnosti .
Hlavní statistiky výkonu diskového subsystému virtuálního stroje
Statistiky výkonu diskového subsystému v vCenter jsou shromážděny v sekcích Datastore, Disk, Virtuální disk:
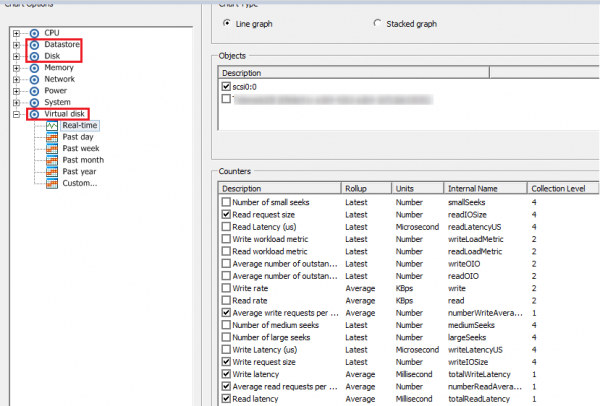
V sekci Datastore se nacházejí metriky pro disková úložiště vSphere (datastory), na kterých leží disky VM. Zde najdete standardní metriky pro:
- IOPS (průměrné čtení/zápis požadavků za sekundu),
- propustnost (čtecí/zapisovací rychlost),
- zpoždění (čtení/zápis/nejvyšší zpoždění).
Z názvů statistik je vlastně vše jasné. Ještě jednou bych chtěl upozornit, že zde statistika není za konkrétní VM (nebo disk VM), ale celková pro celé datastore. Podle mého názoru je tato statistika pohodlnější sledovat v ESXTOP, alespoň s ohledem na to, že minimální měřicí období tam je 2 sekundy.
V sekci Disk se nacházejí metriky pro bloková zařízení, která používají VM. Existují zde statistiky typu summation (počet vstupních/výstupních operací za měřicí období) a několik statistik týkajících se blokového přístupu (Příkazy zrušené, Resetování sběrnice). Tuto informaci, podle mého názoru, je také pohodlnější sledovat v ESXTOP.
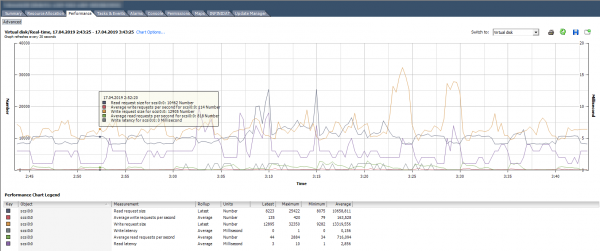
Sekce Virtuální disk – je nejzajímavější z hlediska vyhledávání problémů s výkonem diskového subsystému VM. Zde si můžete prohlédnout výkon každého virtuálního disku. Tyto informace jsou nezbytné k pochopení, zda má konkrétní virtuální stroj problém. Kromě standardních ukazatelů počtu operací I/O, objemu čtení/zápisu a zpoždění obsahuje tato sekce užitečné ukazatele, které ukazují velikost bloku: velikost Read/Write request.
Na obrázku níže je graf výkonu disku VM, na kterém můžete vidět počet IOPS, zpoždění a velikost bloku.
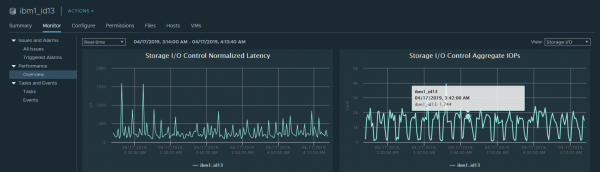
Také metriky výkonu lze zobrazit v celém datastoru, pokud je zapnuto SIOC. Zde jsou základní informace o průměrné latenci a IOPS. Standardně je možné tyto informace zobrazit pouze v reálném čase.
ESXTOP
V ESXTOP je několik obrazovek, na kterých jsou zobrazeny informace o diskovém subsystému hostitele jako celku, jednotlivých virtuálních strojích a jejich discích.
Začněme informacemi o virtuálních strojích. Obrazovka „Disk VM“ se vyvolává klávesou „v“:
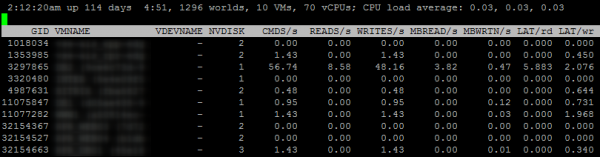
NVDISK – to je počet disků VM. Chcete-li si prohlédnout informace o každém disku, stiskněte „e“ a zadejte GID zajímavého VM.
Hodnoty ostatních parametrů na této obrazovce jsou jasné z jejich názvů.
Další užitečná obrazovka při hledání problémů – Disk adapter. Je vyvolána klávesou „d“ (na obrázku níže byly vybrány pole A, B, C, D, E, G):
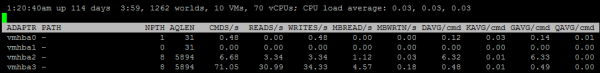
NPTH – počet cest k lunám, které jsou viditelné z tohoto adaptéru. Abychom získali informace o každé cestě na adaptéru, stiskněte „e“ a zadejte název adaptéru:
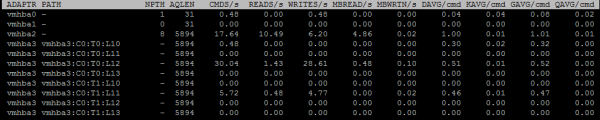
AQLEN – maximální velikost fronty na adaptéru.
Na této obrazovce jsou také zobrazeny ukazatele zpoždění, o kterých jsem hovořil výše: KAVG/cmd, GAVG/cmd, DAVG/cmd, QAVG/cmd.
Na obrazovce Disk device, která se vyvolává klávesou „u“, jsou zobrazeny informace o jednotlivých blokových zařízeních – lunách (na obrázku níže byla vybrána pole A, B, F, G, I). Zde můžete vidět stav fronty k lunám.

DQLEN – velikost fronty pro blokové zařízení.
ACTV – počet příkazů I/O v jádře ESXi.
QUED – počet příkazů I/O ve frontě.
%USD – ACTV / DQLEN × 100%.
LOAD – (ACTV + QUED) / DQLEN.
Pokud je %USD vysoké, stojí za to zvážit možnost zvýšení fronty. Čím více příkazů je ve frontě, tím vyšší je QAVG a, odpovídajícím způsobem, KAVG.
Na obrazovce Disk device lze také zjistit, zda na úložišti VAAI (vStorage API for Array Integration) funguje. K tomu je třeba vybrat pole A a O.
Mechanismus VAAI umožňuje přesunout část práce z hypervizoru přímo na úložiště, například nulování, kopírování bloků nebo zámky.

Jak je vidět na obrázku výše, na tomto úložišti VAAI funguje: aktivně se používají primitivy Zero a ATS.
Tipy na optimalizaci práce s diskovým subsystémem na ESXi
- Věnujte pozornost velikosti bloku.
- Nastavte optimální velikost fronty na HBA.
- Nezapomeňte zapnout SIOC na datastorech.
- Vyberte PSP podle doporučení výrobce úložiště.
- Ujistěte se, že VAAI funguje.
Užitečné články na téma:
Zdroj: habr.com
