

Databáze časových řad (TSDB, time series database) v Prometheu 2 je skvělým příkladem inženýrského řešení, které nabízí výrazná zlepšení oproti úložišti v2 v Prometheu 1 z hlediska rychlosti shromažďování dat a vykonávání dotazů, účinnosti využití zdrojů. Prometheus 2 jsme implementovali do Percona Monitoring and Management (PMM) a měl jsem příležitost podívat se na výkon TSDB v Prometheu 2. V tomto článku se podělím o výsledky těchto pozorování.
Průměrná zátěž Promethea
Pro ty, kteří jsou zvyklí pracovat s obvyklými databázemi, je obvyklá zátěž Promethea celkem zajímavá. Rychlost shromažďování dat se snaží dosáhnout stabilní hodnoty: obvykle služby, které monitorujete, odesílají přibližně stejné množství metrik a infrastruktura se mění relativně pomalu.
Dotazy na informace mohou přicházet z různých zdrojů. Některé z nich, například upozornění, se také snaží dosáhnout stabilní a předvídatelné hodnoty. Jiné, jako jsou uživatelské dotazy, mohou způsobit špičky, i když to není charakteristické pro většinu zátěže.
Zátěžový test
Během testování jsem se soustředil na schopnost shromažďovat data. Nasadil jsem Prometheus 2.3.2, zkompilovaný pomocí Go 1.10.1 (jako součást PMM 1.14) na službě Linode s využitím tohoto skriptu: . Pro maximálně realistické generování zátěže jsem pomocí tohoto spustil několik MySQL uzlů s reálnou zátěží (Sysbench TPC-C Test), z nichž každý emuloval 10 uzlů Linux/MySQL.
Všechny následující testy byly provedeny na serveru Linode s osmi virtuálními jádry a 32 GB paměti, na kterém běželo 20 simulačních zátěží monitorující dvě stě instancí MySQL. Nebo, v termínech Promethea, 800 cílů (targets), 440 shromáždění (scrapes) za sekundu, 380 tisíc záznamů (samples) za sekundu a 1,7 milionu aktivních časových řad.
Design
Obvyklý přístup tradičních databází, včetně toho, který používal Prometheus 1.x, spočívá v . Pokud není dostatečná na to, aby zvládla zátěž, setkáte se s velkými zpožděními a některé dotazy nebudou splněny. Využití paměti v Prometheu 2 se konfiguruje pomocí klíče storage.tsdb.min-block-duration, který určuje, jak dlouho budou záznamy uchovávány v paměti před zápisem na disk (výchozí hodnota je 2 hodiny). Potřebné množství paměti bude záviset na počtu časových řad, štítcích (labels) a intenzitě sběru dat (scrapes) v kombinaci s čistým příchozím tokem. Co se týče diskového prostoru, Prometheus se snaží používat 3 bajty na záznam (sample). Na druhé straně jsou požadavky na paměť mnohem vyšší.
I když existuje možnost nakonfigurovat velikost bloku, nedoporučuje se nastavovat ji ručně, a proto stojíte před nutností poskytnout Prometheovi tolik paměti, kolik požaduje pro vaši zátěž.
Pokud nebude dostatek paměti na podporu příchozího toku metrik, Prometheus se zhroutí s out of memory nebo se k němu dostane OOM killer.
Přidání swapu pro oddálení okamžiku pádu, když Prometheovi dojde paměť, příliš nepomáhá, protože použití této funkce vyvolává explozivní spotřebu paměti. Myslím, že je to kvůli Go, jeho garbage collector a tomu, jak pracuje se swapem.
Dalším zajímavým přístupem vypadá nastavití zápisu head bloku na disk v určitém časovém okamžiku, místo aby se počítalo od startu procesu.
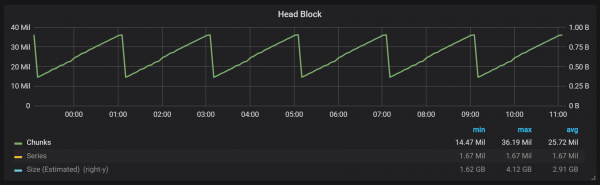
Jak můžete vidět z grafu, zápisy na disk probíhají každé dvě hodiny. Pokud změníte parametr min-block-duration na jednu hodinu, tyto zápisy budou probíhat každou hodinu, počínaje za půl hodiny.
Pokud chcete použít tento a další grafy ve vaší instalaci Prometheus, můžete použít tento . Byl navržen pro PMM, ale s drobnými úpravami se hodí pro jakoukoli instalaci Prometheus.
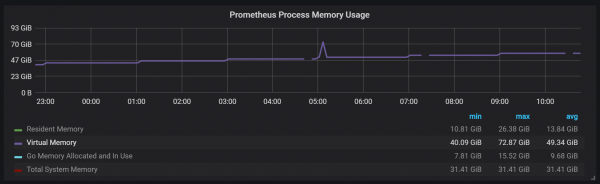
Máme aktivní blok nazývaný head block, který je uchováván v paměti; bloky s staršími daty jsou dostupné prostřednictvím mmap(). To eliminuje potřebu konfigurovat cache zvlášť, ale také to znamená, že musíte nechat dostatek místa pro cache operačního systému, pokud chcete provádět dotazy na data starší než ta, která pojme head block.
A to také znamená, že spotřeba virtuální paměti Prometheus bude vypadat docela vysoká, o čemž není třeba se obávat.
Další zajímavý prvek designu – použití WAL (write ahead log). Jak je vidět v dokumentaci k úložišti, Prometheus používá WAL, aby se vyhnul ztrátám při selhání. Konkrétní mechanismy záruky životnosti dat jsou, bohužel, nedostatečně zdokumentovány. Verze Prometheus 2.3.2 zapisuje WAL na disk každých 10 sekund a tento parametr není uživatelsky konfigurovatelný.
Kompakce
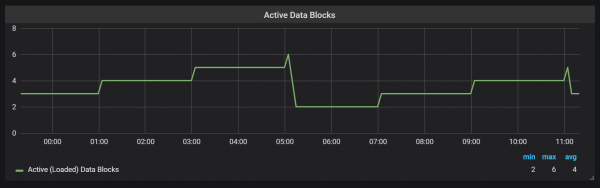
Prometheus TSDB je navržena podle vzoru LSM-úložiště (Log Structured Merge): head block je pravidelně zapisován na disk, zatímco mechanismus kompakce spojuje několik bloků, aby se zabránilo skenování příliš mnoha bloků při dotazech. Zde je vidět počet bloků, které jsem sledoval na testovém systému po jednom dni zátěže.
Pokud se chcete dozvědět více o úložišti, můžete prozkoumat soubor meta.json, který obsahuje informace oexistujících blocích a o tom, jak se objevily.
{
       "ulid": "01CPZDPD1D9R019JS87TPV5MPE",
       "minTime": 1536472800000,
       "maxTime": 1536494400000,
       "stats": {
               "numSamples": 8292128378,
               "numSeries": 1673622,
               "numChunks": 69528220
       },
       "compaction": {
               "level": 2,
               "sources": [
                       "01CPYRY9MS465Y5ETM3SXFBV7X",
                       "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                       "01CPZ6NR4Q3PDP3E57HEH760XS"
               ],
               "parents": [
                       {
                               "ulid": "01CPYRY9MS465Y5ETM3SXFBV7X",
                               "minTime": 1536472800000,
                               "maxTime": 1536480000000
                       },
                       {
                               "ulid": "01CPYZT0WRJ1JB1P0DP80VY5KJ",
                               "minTime": 1536480000000,
                               "maxTime": 1536487200000
                       },
                       {
                               "ulid": "01CPZ6NR4Q3PDP3E57HEH760XS",
                               "minTime": 1536487200000,
                               "maxTime": 1536494400000
                       }
               ]
       },
       "version": 1
}
Kompakce v Prometheovi jsou vázány na čas zápisu head blocku na disk. V tuto chvíli může probíhat několik takových operací.
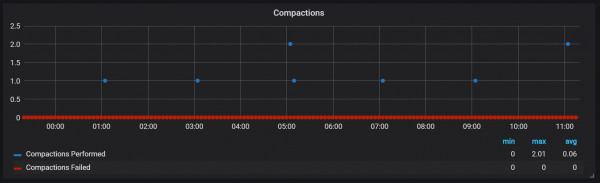
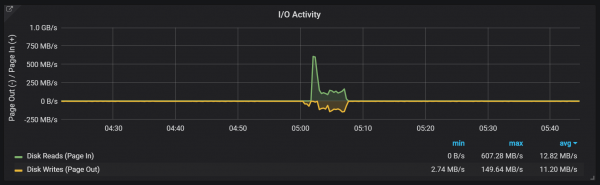
Zdá se, že komprese nejsou nijak omezeny a mohou způsobovat velké skoky v diskovém I/O během provádění.
Skoky zatížení CPU
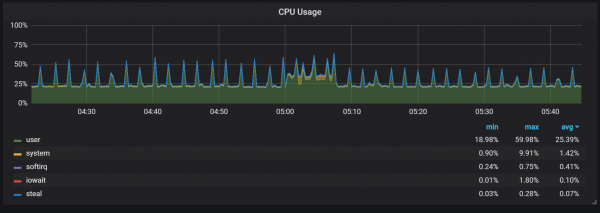
Samozřejmě, to má poměrně negativní vliv na rychlost systému a představuje to vážnou výzvu pro úložiště LSM: jak provádět komprese, aby se udržela vysoká rychlost dotazů a současně nebyl způsoben příliš velký overhead?
Použití paměti během komprese také vypadá docela zajímavě.
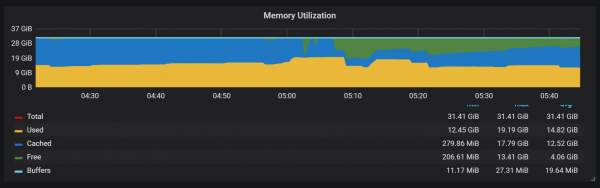
Vidíme, jak po kompresi většina paměti mění stav z Cached na Free: to znamená, že potenciálně cenné informace byly odstraněny. Zajímavé je, zda se zde používá fadvice() nebo jiná technika minimalizace, nebo zda to bylo způsobeno uvolněním cache od bloků zničených během komprese?
Obnovení po havárii
Obnovení po selhání trvá nějaký čas a to je opodstatněné. Pro příchozí tok milionu záznamů za sekundu jsem musel čekat přibližně 25 minut, zatímco docházelo k obnově s ohledem na SSD disk.
level=info ts=2018-09-13T13:38:14.09650965Z caller=main.go:222 msg="Spouštím Prometheus" version="(version=2.3.2, branch=v2.3.2, revision=71af5e29e815795e9dd14742ee7725682fa14b7b)"
level=info ts=2018-09-13T13:38:14.096599879Z caller=main.go:223 build_context="(go=go1.10.1, user=Jenkins, date=20180725-08:58:13OURCE)"
level=info ts=2018-09-13T13:38:14.096624109Z caller=main.go:224 host_details="(Linux 4.15.0-32-generic #35-Ubuntu SMP Fri Aug 10 17:58:07 UTC 2018 x86_64 1bee9e9b78cf (none))"
level=info ts=2018-09-13T13:38:14.096641396Z caller=main.go:225 fd_limits="(soft=1048576, hard=1048576)"
level=info ts=2018-09-13T13:38:14.097715256Z caller=web.go:415 component=web msg="Začínám naslouchat přípojkám" address=:9090
level=info ts=2018-09-13T13:38:14.097400393Z caller=main.go:533 msg="Spouštím TSDB ..."
level=info ts=2018-09-13T13:38:14.098718401Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536530400000 maxt=1536537600000 ulid=01CQ0FW3ME8Q5W2AN5F9CB7R0R
level=info ts=2018-09-13T13:38:14.100315658Z caller=web.go:467 component=web msg="prefix routeru" prefix=\prometheus
level=info ts=2018-09-13T13:38:14.101793727Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536732000000 maxt=1536753600000 ulid=01CQ78486TNX5QZTBF049PQHSM
level=info ts=2018-09-13T13:38:14.102267346Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536537600000 maxt=1536732000000 ulid=01CQ78DE7HSQK0C0F5AZ46YGF0
level=info ts=2018-09-13T13:38:14.102660295Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536775200000 maxt=1536782400000 ulid=01CQ7SAT4RM21Y0PT5GNSS146Q
level=info ts=2018-09-13T13:38:14.103075885Z caller=repair.go:39 component=tsdb msg="nalezen zdravý blok" mint=1536753600000 maxt=1536775200000 ulid=01CQ7SV8WJ3C2W5S3RTAHC2GHB
level=error ts=2018-09-13T14:05:18.208469169Z caller=wal.go:275 component=tsdb msg="Zjištěna chyba WAL; truncating" err="neočekávaná kontrolní součet CRC32 d0465484, očekávaná 0" file=\opt\prometheus\data\.prom2-data\wal\007357 pos=15504363
level=info ts=2018-09-13T14:05:19.471459777Z caller=main.go:543 msg="TSDB spuštěn"
level=info ts=2018-09-13T14:05:19.471604598Z caller=main.go:603 msg="Načítám konfigurační soubor" filename=\etc\prometheus.yml
level=info ts=2018-09-13T14:05:19.499156711Z caller=main.go:629 msg="Dokončeno načítáni konfiguračního souboru" filename=\etc\prometheus.yml
level=info ts=2018-09-13T14:05:19.499228186Z caller=main.go:502 msg="Server je připraven přijímat webové požadavky."
Hlavní problém s procesem obnovení je vysoká spotřeba paměti. I když server může v normální situaci stabilně pracovat se stejným množstvím paměti, po selhání nemusí být schopen se znovu spustit kvůli OOM. Jediným řešením, které jsem našel, je vypnout sběr dat, spustit server, umožnit mu se zotavit a poté jej restartovat se zapnutým sběrem.
Rozehřívání
Další chování, které je třeba mít na paměti během rozehřívání, je poměr nízkého výkonu a vysoké spotřeby zdrojů těsně po spuštění. Při některých, ale ne všech spuštěních jsem zaznamenal vážnou zátěž CPU a paměti.
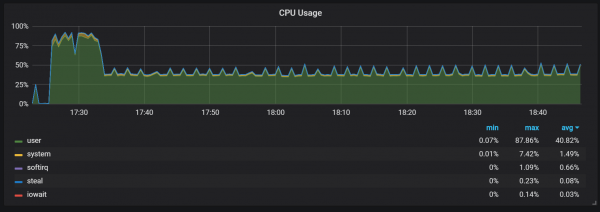
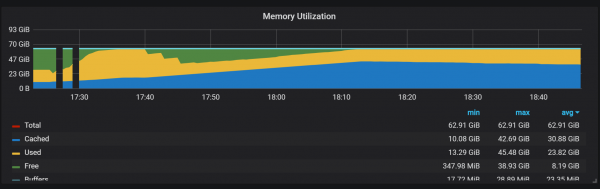
Výkyvy v užívání paměti ukazují na to, že Prometheus není schopen od začátku nakonfigurovat všechny sběry, a nějaké informace zůstávají ztraceny.
Nedokázal jsem zjistit přesné příčiny vysokého zatížení CPU a paměti. Podezřívám, že to souvisí s vytvářením nových časových řad v head bloku s vysokou frekvencí.
Skoky zatížení CPU
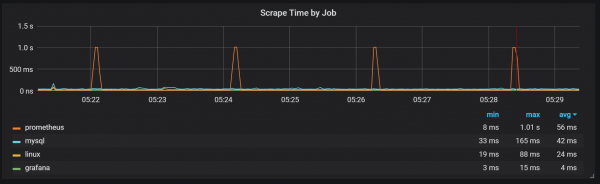
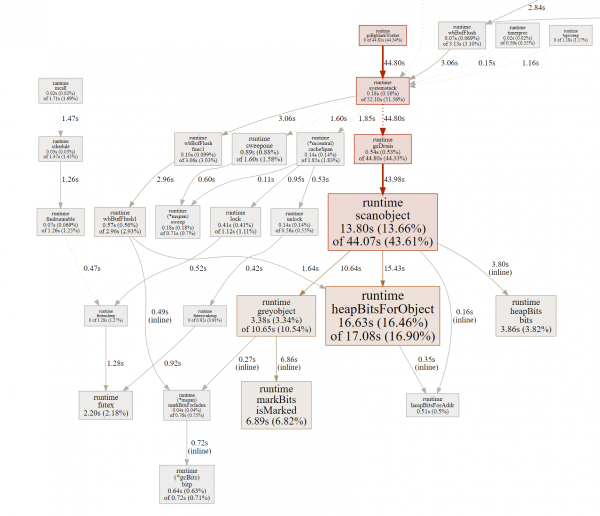
Kromě kompresí, které vytvářejí poměrně vysoké zatížení I/O, jsem si všiml vážných skoků v zatížení CPU každé dvě minuty. Vzestupy trvají déle při vysokém příchozím toku a zdá se, že je způsobuje garbage collector Go, alespoň jádra jsou plně zatížena.
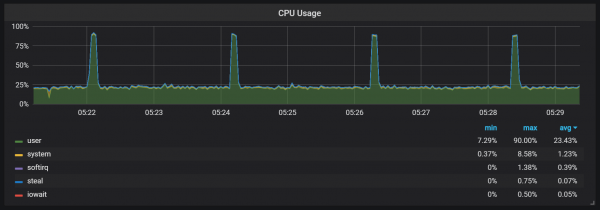
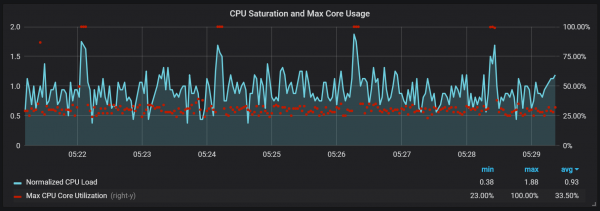
Tyto skoky nejsou vůbec nevýznamné. Když k nim dojde, interní vstupní bod a metriky Prometheus se stanou nedostupnými, což způsobuje ztráty dat v těchto obdobích.
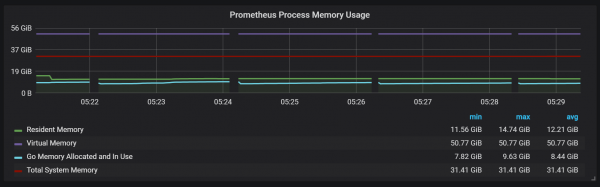
Je také možné si všimnout, že exportér Prometheus se na jednu sekundu zablokuje.
Můžeme si všimnout korelace s úklidem odpadu (GC).
Závěr
TSDB v Prometheus 2 funguje rychle a dokáže zvládat miliony časových řad, zatímco provádí tisíce zápisů za sekundu s poměrně skromným hardwarem. Využití CPU a diskového I/O je také působivé. Můj příklad vykazoval až 200 000 metrik za sekundu na jedno použité jádro.
Při plánování rozšíření je třeba mít na paměti dostatečné objemy paměti, a ta by měla být fyzická. Objem paměti, kterou jsem pozoroval, byl přibližně 5 GB na 100 000 zápisů za sekundu příchozího toku, což dalo celkem s cache operačního systému přibližně 8 GB obsazené paměti.
Samozřejmě je stále spousta práce na zkrocení skoků CPU a diskového I/O, a to není překvapivé, vezmeme-li v úvahu, jak mladá je TSDB Prometheus 2 ve srovnání s InnoDB, TokuDB, RocksDB, WiredTiger, ale všechny měly podobné problémy na začátku životního cyklu.
Zdroj: habr.com
