

Ahoj, já jsem Dmitrij Logvinenko — datový inženýr v analytickém oddělení skupiny společností „Vezët“.
Rád vám představím úžasný nástroj pro vývoj ETL procesů — Apache Airflow. Ale Airflow je tak univerzální a mnohostranný, že byste se na něj měli podívat i v případě, že se nezabýváte datovými toky, ale občas potřebujete spouštět nějaké procesy a sledovat jejich výkon.
A ano, budu nejen vyprávět, ale také ukazovat: v programu je hodně kódu, screenshotů a doporučení.
Co obvykle vidíte, když googlíte slovo Airflow / Wikimedia Commons
Obsah
Úvod
Apache Airflow — je přesně jako Django:
- napsaný v Pythonu,
- má skvělé administrační rozhraní,
- neomezeně rozšiřitelný,
— jen lepší a vytvořený pro zcela jiné cíle, totiž (jak je napsáno před castingem):
- spuštění a monitorování úkolů na neomezeném počtu strojů (kolik vám dovolí Celery/Kubernetes a vaše svědomí)
- s dynamickou generací workflow z velmi snadno psatelného a čitelného Python kódu
- a se schopností spojovat jakékoli databáze a API pomocí jak připravených komponentů, tak vlastních pluginů (což se dělá neuvěřitelně snadno).
Apache Airflow používáme takto:
- shromažďujeme data z různých zdrojů (mnoho instancí SQL Server a PostgreSQL, různé API s metrikami aplikací, dokonce 1C) do DWH a ODS (u nás to jsou Vertica a Clickhouse).
- jako pokročilý
cron., který spouští procesy konsolidace dat na ODS a také sleduje jejich údržbu.
Do nedávné doby naše potřeby pokrýval jeden malý server se 32 jádry a 50 GB operační paměti. V Airflow přitom funguje:
- více než 200 DAGů (vlastně workflows, do kterých jsme naplnili úkoly),
- v každém průměrně 70 úkolů,
- tento proces (také průměrně) se spouští každou hodinu.
A o tom, jak jsme se rozšiřovali, napíšu níže, ale teď pojďme definovat über-úkol, který budeme řešit:
Existují tři počáteční SQL Servery, z nichž každý obsahuje 50 databází — instance jednoho projektu, mají tedy téměř identickou strukturu (kromě některých detailů, muahaha), a znamená to, že každá obsahuje tabulku Orders (naštěstí tabulku s tímto názvem lze vložit do jakéhokoli byznysu). Schraňujeme data a přidáváme pomocná pole (server zdroje, databáze zdroje, identifikátor ETL úlohy) a naivně je uložíme, řekněme, do Vertica.
Začínáme!
Hlavní, praktická (a trochu teoretická) část
Proč to potřebujeme (a vy)
Když byly stromy veliké a já jsem byl obyčejný SQL-čekatel v jednom ruském maloobchodě, prováděli jsme ETL procesy alias datové toky pomocí dvou dostupných nástrojů:
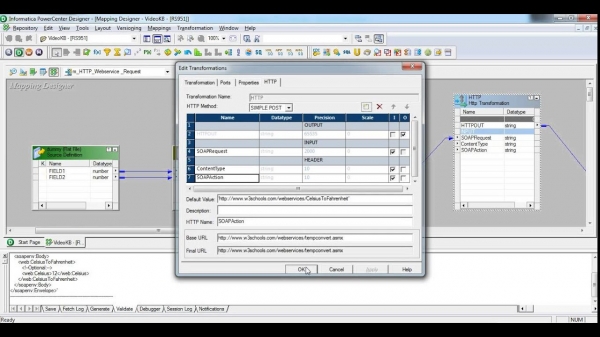
- Informatica Power Center — velmi robustní systém, nesmírně výkonný, se svým vlastním hardwarem a verzováním. Použil jsem snad 1 % jejích schopností. Proč? No, zaprvé, ten rozhraní vypadalo jako z nultých let a psychicky nás tlačilo. Zadruhé, tento nástroj je určen pro velmi složité procesy, urputné opětovné využívání komponent a další důležité podnikové vychytávky. O její ceně, která je jako křídlo Airbusu A380/rok, raději pomlčíme.
Pozor, screenshot může způsobit mírné utrpení lidem mladším 30 let.

- SQL Server Integration Server — tohle jsme používali v našich projektových tocích. Vždyť skutečně: SQL Server už používáme, a nevyužít jeho ETL nástroje by bylo trochu nerozumné. Všechno je v něm hezky provedeno: rozhraní je pěkné, zprávy o výkonu... Ale ne kvůli tomu máme rádi softwarové produkty, oh ne, ne kvůli tomu. Můžeme verzovat jeho
dtsx(což je XML s uzly, které se při uložení mísí), ale k čemu to je? A vytvořit balíček úloh, který přenese sto tabulek z jednoho serveru na druhý? Totéž udělat pro dvacet kousků, vám odpadne ukazováček, který kliká na myš. Ale vypadá určitě současněji:
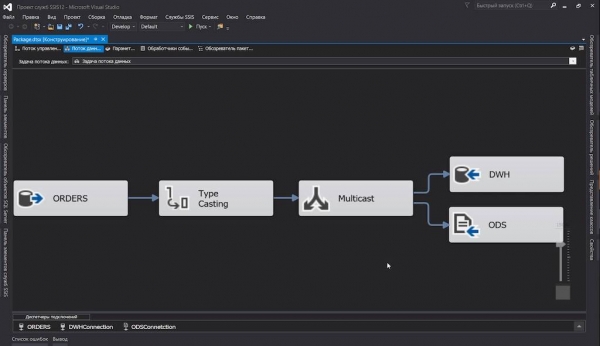
Bezpochyby jsme hledali východiska. Skoro se to dostalo až k vlastnímu generátoru SSIS balíčků…
… a pak mě našla nová práce. A v ní mě zastihl Apache Airflow.
Když jsem zjistil, že popisy ETL procesů jsou jen jednoduchý Python kód, skoro jsem začal tančit radostí. Takto se datové toky dostaly pod verzování a dify, a shromažďování tabulek se stejnou strukturou z stovky databází do jednoho cíle se stalo záležitostí Python kódu na jednom a půl až dvou 13” obrazovkách.
Sestavujeme klastr
Pojďme se vyhnout dětským hrám a nemluvme o naprosto zřejmých věcech, jako je instalace Airflow, vámi zvolené DB, Celery a dalších věcech popsaných v dokumentaci.
Abychom mohli hned začít s experimenty, připravil jsem nástin docker-compose.yml v němž:
- Zvedneme tedy Airflow: Scheduler, Webserver. Tam bude fungovat Flower pro monitorování Celery úloh (protože už byl zařazen do
apache/airflow:1.10.10-python3.7, a my proti tomu nemáme nic); - PostgreSQL, do kterého bude Airflow zapisovat své provozní informace (údaje plánovače, statistika provádění atd.), a Celery bude zaznamenávat dokončené úlohy;
- Redis, který bude plnit roli brokeru úloh pro Celery;
- Celery worker, který se postará o samotnou realizaci úloh.
- Do složky
./dagsbudeme ukládat naše soubory s popisem DAGů. Ty budou zachycovány za běhu, takže není potřeba restartovat celý stack po každém drobném zásahu.
Někde je kód uveden v příkladech neúplně (aby text nebyl přeplněný), a někde je během procesu modifikován. Celé funkční příklady kódu lze vidět v repozitáři. .
docker-compose.yml
verze: '3.4'

x-airflow-config: &airflow-config
  AIRFLOW__CORE__DAGS_FOLDER: /dags
  AIRFLOW__CORE__EXECUTOR: CeleryExecutor
  AIRFLOW__CORE__FERNET_KEY: MJNz36Q8222VOQhBOmBROFrmeSxNOgTCMaVp2_HOtE0=
  AIRFLOW__CORE__HOSTNAME_CALLABLE: airflow.utils.net:get_host_ip_address
  AIRFLOW__CORE__SQL_ALCHEMY_CONN: postgres+psycopg2://airflow:airflow@airflow-db:5432/airflow

  AIRFLOW__CORE__PARALLELISM: 128
  AIRFLOW__CORE__DAG_CONCURRENCY: 16
  AIRFLOW__CORE__MAX_ACTIVE_RUNS_PER_DAG: 4
  AIRFLOW__CORE__LOAD_EXAMPLES: 'False'
  AIRFLOW__CORE__LOAD_DEFAULT_CONNECTIONS: 'False'

  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_RETRY: 'False'
  AIRFLOW__EMAIL__DEFAULT_EMAIL_ON_FAILURE: 'False'

  AIRFLOW__CELERY__BROKER_URL: redis://broker:6379/0
  AIRFLOW__CELERY__RESULT_BACKEND: db+postgresql://airflow:airflow@airflow-db/airflow

x-airflow-base: &airflow-base
  image: apache/airflow:1.10.10-python3.7
  entrypoint: /bin/bash
  restart: always
  volumes:
    - ./dags:/dags
    - ./requirements.txt:/requirements.txt

services:
  # Redis jako broker pro Celery
  broker:
    image: redis:6.0.5-alpine

  # Databáze pro metadat Airflow
  airflow-db:
    image: postgres:10.13-alpine

    environment:
      - POSTGRES_USER=airflow
      - POSTGRES_PASSWORD=airflow
      - POSTGRES_DB=airflow

    volumes:
      - ./db:/var/lib/postgresql/data

  # Hlavní kontejner s Airflow Webserverem, Plánovačem, Celery Flower
  airflow:
    <<: *airflow-base

    environment:
      <<: *airflow-config

      AIRFLOW__SCHEDULER__DAG_DIR_LIST_INTERVAL: 30
      AIRFLOW__SCHEDULER__CATCHUP_BY_DEFAULT: 'False'
      AIRFLOW__SCHEDULER__MAX_THREADS: 8

      AIRFLOW__WEBSERVER__LOG_FETCH_TIMEOUT_SEC: 10

    depends_on:
      - airflow-db
      - broker

    command: >
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint initdb &&
          (/entrypoint webserver &) &&
          (/entrypoint flower &) &&
           /entrypoint scheduler"

    ports:
      # Celery Flower
      - 5555:5555
      # Airflow Webserver
      - 8080:8080

  # Pracovníků Celery, kteří budou škálováni používáním `--scale=n`
  worker:
    <<: *airflow-base

    environment:
      <<: *airflow-config

    command: >
      -c " sleep 10 &&
           pip install --user -r /requirements.txt &&
           /entrypoint worker"

    depends_on:
      - airflow
      - airflow-db
      - broker
Poznámky:
- Při sestavování composeru jsem se do značné míry opíral o známý obraz – určitě se na něj podívejte. Možná už nic jiného v životě nepotřebujete.
- Všechna nastavení Airflow jsou dostupná nejen přes
airflow.cfg, ale také přes proměnné prostředí (chvála vývojářům), což jsem zřejmě zneužil. - Samozřejmě, není to připraveno pro produkci: záměrně jsem nenastavoval heartbeaty na kontejnery, nezabýval jsem se bezpečností. Ale udělal jsem minimum, které je vhodné pro naše experimenty.
- Všimněte si, že:
- Složka s DAGy musí být přístupná jak plánovači, tak pracovníkům.
- To samé platí i pro všechny třetí strany knihoven — všechny musí být nainstalovány na strojích s plánovačem a pracovníky.
A teď jednoduše:
$ docker-compose up --scale worker=3Jakmile vše spustíte, můžete se podívat na webové rozhraní:
- Airflow:
- Flower:
Základní pojmy
Pokud jste v těchto "dagech" nic nepochopili, zde je krátký slovník:
- Plánovač — nejdůležitější postava v Airflow, kontrolující, aby pracovaly roboty, nikoli člověk: dohlíží na plán, aktualizuje dagy, spouští úkoly.
Obecně, ve starších verzích, měl problémy s pamětí (ne, ne amnézie, ale úniky) a v konfiguracích zůstal dokonce legacy parametr
run_duration— interval jeho restartu. Ale teď je vše v pořádku. - DAG (také "dag") — "smerový acyklický graf", ale toto určení moc lidem neřekne, ve skutečnosti je to kontejner pro vzájemně spolupracující úkoly (viz níže) nebo analog balíčku v SSIS a Workflow v Informatica.
Kromě dagů mohou být také subdagy, ale k nim se pravděpodobně nedostaneme.
- DAG Run — inicializovaný dag, kterému byl přidělen jeho
execution_date. Dagrany jednoho daga mohou zcela fungovat paralelně (pokud jste samozřejmě udělali své úkoly idempotentní). - Operator — to jsou kousky kódu zodpovědné za provádění konkrétní akce. Existují tři typy operátorů:
- akce, jako například náš oblíbený
PythonOperator, který dokáže provést jakýkoli (platný) Python kód; - přenos, které převážejí data z místa na místo, řekněme,
MsSqlToHiveTransfer; - senzor nám dovolí reagovat nebo zpomalit další provádění daga do doby, kdy dojde k určité události.
HttpSensormůže volat zadaný endpoint, a když dostane potřebnou odpověď, spustí přenosGoogleCloudStorageToS3Operator. Zvídavá mysl se zeptá: "proč? Vždyť opakování lze udělat rovnou v operátoru!" A pak, aby se nezaplnil pool úkolů visícími operátory. Senzor se spouští, kontroluje a umírá do dalšího pokusu.
- akce, jako například náš oblíbený
- Úkol — deklarované operátory bez ohledu na typ a připojené k daga se povyšují na úroveň úkolu.
- Instance úkolu — když generální plánovač rozhodl, že úkoly je čas poslat do akce k vykonavatelům-pracovníkům (přímo na místě, pokud používáme
LocalExecutornebo na vzdáleném uzlu v případěCeleryExecutor), jmenuje jim kontext (tj. sadu proměnných – parametrů provádění), rozbalí šablony příkazů nebo dotazů a vloží je do poolu.
Generujeme úkoly
Nejdříve vyznačíme obecnou schéma našeho daga, a pak se stále více a více ponořujeme do detailů, protože používáme některá netradiční řešení.
Takže, v nejjednodušší podobě bude takový dag vypadat takto:
z datetime import timedelta, datetime

z airflow import DAG
z airflow.operators.python_operator import PythonOperator

z commons.datasources import sql_server_ds

dag = DAG('orders',
          schedule_interval=timedelta(hours=6),
          start_date=datetime(2020, 7, 8, 0))

def workflow(**context):
    print(context)

for conn_id, schema in sql_server_ds:
    PythonOperator(
        task_id=schema,
        python_callable=workflow,
        provide_context=True,
        dag=dag)
Pojďme se do toho pustit:
- Nejprve importujeme potřebné knihovny a něco dalšího;
sql_server_ds— to jeList[namedtuple[str, str]]s názvy připojení z Airflow Connections a databázemi, ze kterých budeme získávat naši tabulku;dag— definice našeho DAGu, která musí být umístěna vglobals(), jinak ho Airflow nenajde. DAGu je také potřeba říct:- jak se jmenuje
orders— toto jméno se pak objeví v webovém rozhraní, - že začne fungovat od půlnoci osmého července,
- a měl by se spouštět přibližně každých 6 hodin (pro ty odvážnější je zde místo
timedelta()povolenacron.-řetězec0 0 0/6 ? * * *, pro méně odvážné – výraz jako@daily);
- jak se jmenuje
workflow()bude vykonávat hlavní práci, ale ne teď. Teď jen vypíšeme náš kontext do logu.- A teď jednoduchá magie vytváření úloh:
- procházíme naše zdroje;
- inicializujeme
PythonOperator, který vykoná naši prázdnou úlohuworkflow(). Nezapomeňte uvést unikátní (v rámci DAGu) jméno úlohy a propojit ji s DAGem. Příznakprovide_contextzase předá do funkce další argumenty, které pečlivě shromáždíme pomocí**context.
Na tom zatím končíme. Co jsme získali:
- nový DAG v webovém rozhraní,
- přes sto padesát úloh, které budou vykonávány paralelně (pokud to nastavení Airflow, Celery a výkonnost serverů pozwolí).
No, téměř jsme to získali.
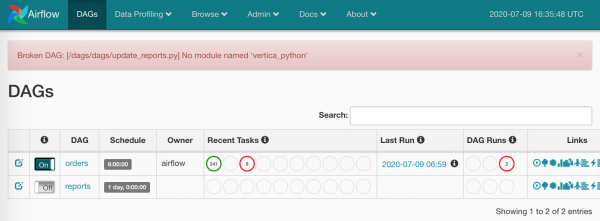
Kdo se postará o závislosti?
Abych to celé zjednodušil, zařadil jsem do docker-compose.yml zpracování requirements.txt na všech nodů.
Teď už to jede:
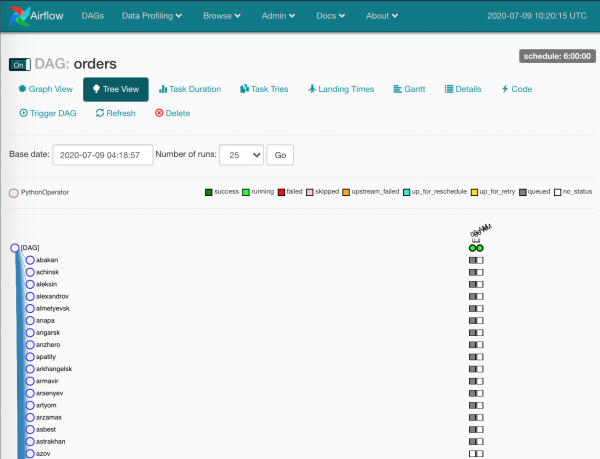
Šedé čtverce – instance úloh, zpracované plánovačem.
Chvíli čekáme, úkoly se uchytí pracovníky:
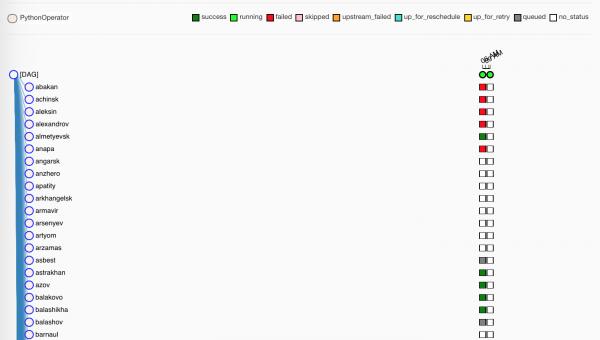
Zelené, samozřejmě, – úspěšně proběhnuvší. Červené – s neúspěchem.
Mimochodem, na našich produkčních serverech žádná složka
./dags, synchronizující se mezi stroj M, neexistuje — všechny DAGy leží vgitnašem Gitlabu, a Gitlab CI rozkládá aktualizace na stroje při sloučení domaster.
Trochu o Flower
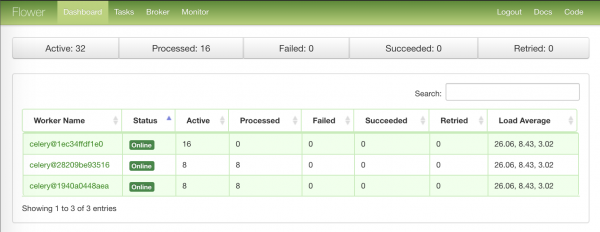
Zatímco pracovníci odvedou naše prázdné úkoly, vzpomeňme na další nástroj, který nám může něco ukázat — Flower.
První stránka s celkovými informacemi o nodách-pracovnících:
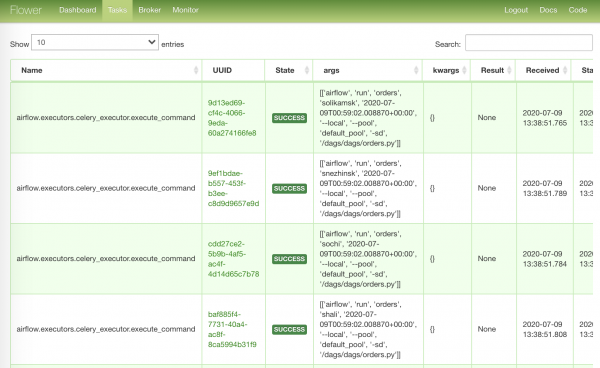
Nejbohatší stránka se úkoly, které byly odeslány do práce:
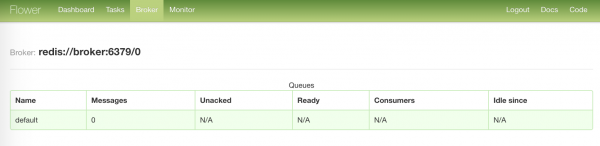
Nejzajímavější stránka se stavem našeho brokera:
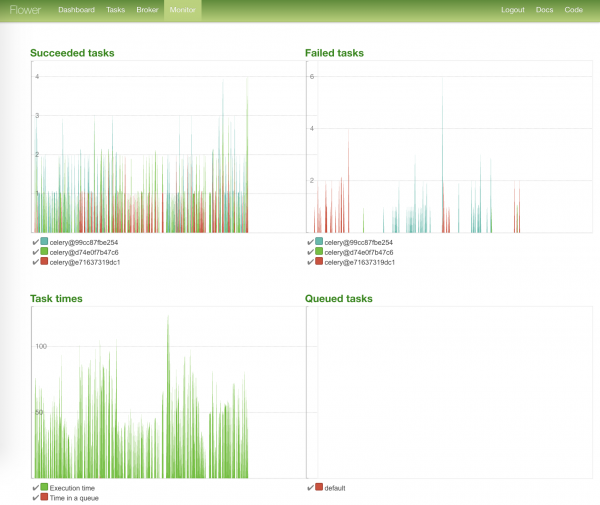
Nejbarevnější stránka – s grafy stavu úloh a jejich dobou provedení:
Dohraňujeme nedohrazené
Takže všechny úlohy proběhly, můžeme odnést raněné.
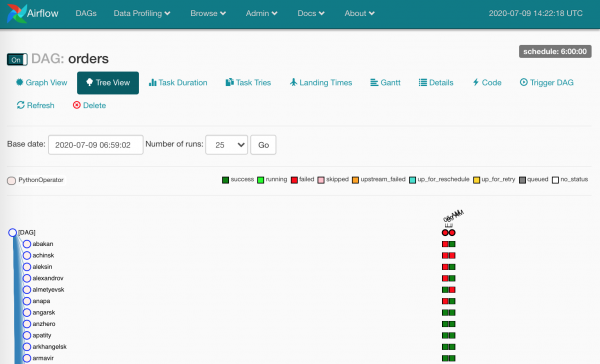
A raněných bylo celkem dost – z různých důvodů. Při správném použití Airflow tyto čtverce naznačují, že data určitě nedorazila.
Musíme se podívat do logu a restartovat selhané úlohy.
Když kliknete na jakýkoli čtverec, uvidíme dostupné akce:
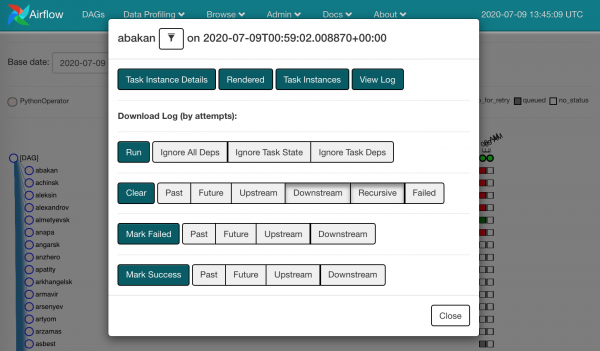
Můžeme vzít a provést Clear pro selhanou úlohu. To znamená, že zapomeneme na to, že tam něco selhalo, a stejná úloha se odešle plánovači.
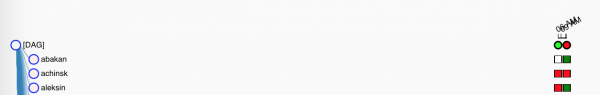
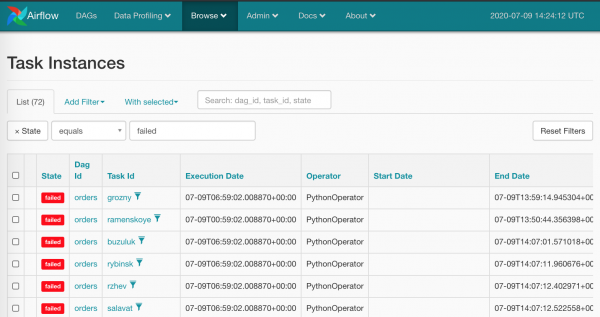
Je jasné, že dělat to myší se všemi červenými čtverci není moc lidské – tohle od Airflow neočekáváme. Samozřejmě máme zbraň hromadného ničení: Procházení / Instance úloh
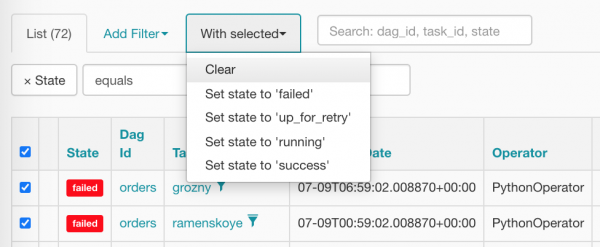
Vybereme vše najednou a resetujeme stisknutím správného bodu:
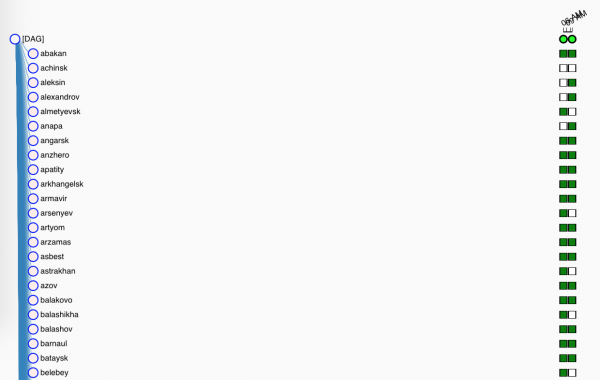
Po vyčištění naše úlohy vypadají takto (už se nemohou dočkat, až je plánovač naplánuje):
Připojení, hooky a další proměnné
Je nejvyšší čas podívat se na další DAG, update_reports.py:
from collections import namedtuple
from datetime import datetime, timedelta
from textwrap import dedent

from airflow import DAG
from airflow.contrib.operators.vertica_operator import VerticaOperator
from airflow.operators.email_operator import EmailOperator
from airflow.utils.trigger_rule import TriggerRule

from commons.operators import TelegramBotSendMessage

dag = DAG('update_reports',
          start_date=datetime(2020, 6, 7, 6),
          schedule_interval=timedelta(days=1),
          default_args={'retries': 3, 'retry_delay': timedelta(seconds=10)})

Report = namedtuple('Report', 'source target')
reports = [Report(f'{table}_view', table) for table in [
    'reports.city_orders',
    'reports.client_calls',
    'reports.client_rates',
    'reports.daily_orders',
    'reports.order_duration']]

email = EmailOperator(
    task_id='email_success', dag=dag,
    to='{{ var.value.all_the_kings_men }}',
    subject='DWH Reports updated',
    html_content=dedent("""Vážení, zprávy byly aktualizovány"""),
    trigger_rule=TriggerRule.ALL_SUCCESS)

tg = TelegramBotSendMessage(
    task_id='telegram_fail', dag=dag,
    tg_bot_conn_id='tg_main',
    chat_id='{{ var.value.failures_chat }}',
    message=dedent("""
         Natáš, probuď se, spadli jsme {{ dag.dag_id }}
        """),
    trigger_rule=TriggerRule.ONE_FAILED)

for source, target in reports:
    queries = [f"TRUNCATE TABLE {target}",
               f"INSERT INTO {target} SELECT * FROM {source}"]

    report_update = VerticaOperator(
        task_id=target.replace('reports.', ''),
        sql=queries, vertica_conn_id='dwh',
        task_concurrency=1, dag=dag)

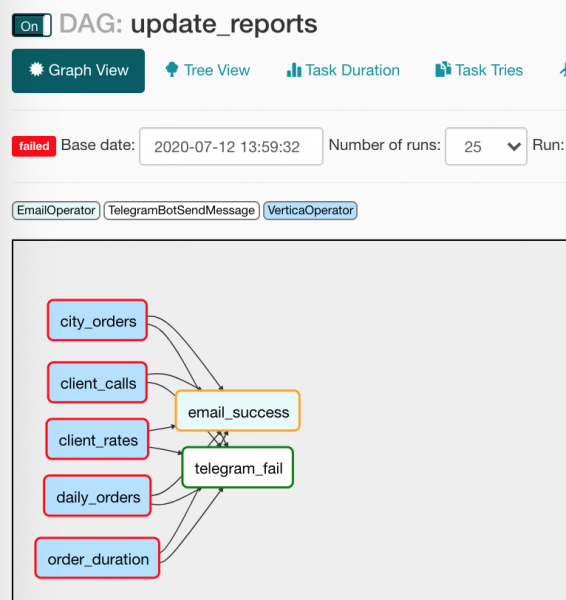
    report_update >> [email, tg]
Všichni jsme někdy dělali aktualizaci zpráv, že? To je ona znovu: je tu seznam zdrojů, odkud vzít data; je tu seznam, kam je uložit; nezapomeňme dát vědět, když se všechno stalo nebo se něco pokazilo (no, to se nás netýká, že ne).
Pojďme se znovu podívat na soubor a zkontrolovat nové nejasnosti:
from commons.operators import TelegramBotSendMessage— nic nám nebrání vytvořit si vlastní operátory, což jsme udělali, když jsme vytvořili malý wrapper pro odesílání zpráv do Rozblokovaného. (O tomto operátoru si ještě povíme níže);default_args={}— DAG může poskytovat stejné argumenty všem svým operátorům;to='{{ var.value.all_the_kings_men }}'— poletonebude u nás hardcodováno, ale dynamicky generováno pomocí Jinja a proměnné se seznamem emailů, kterou jsem pečlivě uložil doAdmin/Variables;trigger_rule=TriggerRule.ALL_SUCCESS— podmínka spuštění operátoru. V našem případě bude email odeslán šéfům pouze tehdy, pokud všechny závislosti úspěšně zpracovaly úspěšně;tg_bot_conn_id='tg_main'— argumentyconn_idobsahují identifikátory připojení, které vytváříme vAdmin/Connections;trigger_rule=TriggerRule.ONE_FAILED— zprávy na Telegram budou odeslány pouze v případě, že se vyskytnou selhávající úkoly;task_concurrency=1— zakazujeme současné spuštění několika instancí jednoho úkolu. Jinak se setkáme se souběžným spuštěním několikaVerticaOperator(sledujících jednu tabulku);report_update >> [email, tg]— všechnyVerticaOperatorse spojí při odesílání emailu a zprávy, takto:

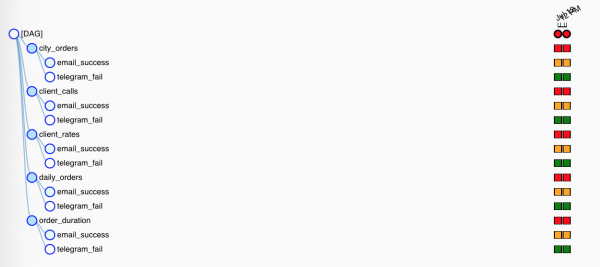
Ale protože operátory notifikací mají různé podmínky spuštění, bude fungovat pouze jeden. V Tree View to vypadá o něco méně přehledně:

Pár slov o makrech a jejich přátelích — proměnných.
Makra jsou Jinja placeholdery, které mohou vkládat různé užitečné informace do argumentů operátorů. Například takto:
SELECT
    id,
    payment_dtm,
    payment_type,
    client_id
FROM orders.payments
WHERE
    payment_dtm::DATE = '{{ ds }}'::DATE
{{ ds }} se rozbalí do obsahu proměnné kontextu execution_date ve formátu YYYY-MM-DD: 2020-07-14. Nejlepší na tom je, že kontextové proměnné jsou přibity k určité instanci úkolu (čtverci v Tree View) a při restartu se placeholdery rozbalí na stejné hodnoty.
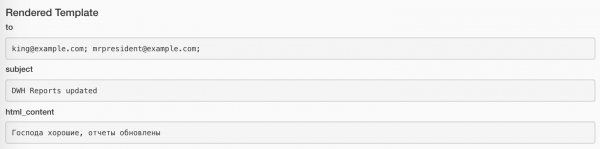
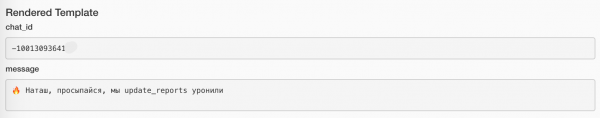
Přiřazené hodnoty můžete zobrazit pomocí tlačítka Rendered na každé instanci úkolu. Takto u úkolu s odesláním emailu:
A takto u úkolu s odesláním zprávy:
Úplný seznam vestavěných maker pro poslední dostupnou verzi je k dispozici zde:
Navíc pomocí pluginů můžeme deklarovat vlastní makra, ale to už je úplně jiná pohádka.
Kromě předdefinovaných položek můžeme dosazovat hodnoty našich proměnných (už jsem to v kódu využil výše). Vytvoříme v Admin/Variables pár položek:
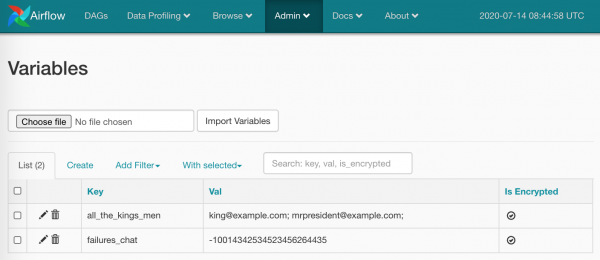
To je ono, můžeme používat:
TelegramBotSendMessage(chat_id='{{ var.value.failures_chat }}')Ve formátu může být škalar, nebo může obsahovat i JSON. V případě JSON:
bot_config

{
    "bot": {
        "token": 881hskdfASDA16641,
        "name": "Verter"
    },
    "service": "TG"
}
jednoduše použijeme cestu k potřebnému klíči: {{ var.json.bot_config.bot.token }}.
Řeknu doslova jedno slovo a ukážu jeden screenshot o připojení. Tady je to všechno elementární: na stránce Admin/Connections vytváříme připojení, ukládáme tam naše přihlášení/hesla a další specifické parametry. Takhle:
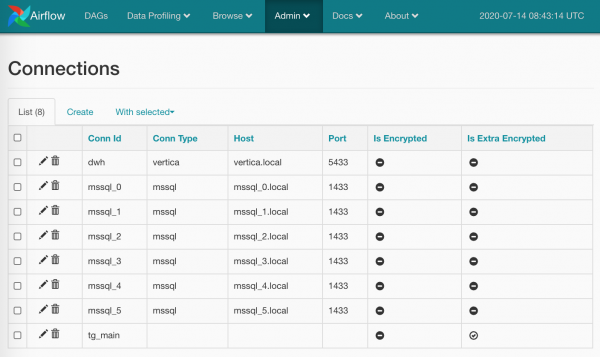
Hesla lze šifrovat (podrobněji než v defaultním nastavení), nebo nemusíme uvádět typ připojení (jak jsem to udělal pro tg_main) — věc je v tom, že seznam typů je pečlivě ukryt v modelech Airflow a bez zásahu do zdrojového kódu se k němu nedostaneme (pokud náhodou něco nevím, prosím, opravte mě), ale získat kredity jednoduše podle jména nám nic nebrání.
A také můžeme vytvořit několik připojení se stejným názvem: v takovém případě metoda BaseHook.get_connection(), která nám poskytuje připojení podle názvu, vrátí náhodné ze několika dvojčat (bylo by logičtější udělat Round Robin, ale to necháme na svědomí vývojářů Airflow).
Proměnné a Připojení jsou bezpochyby skvélé nástroje, ale je důležité neztratit rovnováhu: které části vašich toků uchováváte přímo v kódu, a které ukládáte na náklady Airflow. Na jedné straně může být pohodlné rychle změnit hodnotu, například email pro zasílání, prostřednictvím UI. Na druhé straně — je to v každém případě návrat k myšlenkovému myšlení, od kterého jsme (já) chtěli uniknout.
Práce s připojeními je jedním z úkolů hooků. Všechny hooky Airflow jsou body připojení k externím službám a knihovnám. Například JiraHook nám otevře klienta pro interakci s Jira (můžeme tam posouvat úkoly tam a zpět), a pomocí SambaHook můžeme poslat místní soubor na smb-bod.
Procházíme vlastní operátor
A dostali jsme se blízko k tomu, abychom se podívali na to, jak je vytvořen TelegramBotSendMessage
Kód commons/operators.py s vlastním operátorem:
from typing import Union

from airflow.operators import BaseOperator

from commons.hooks import TelegramBotHook, TelegramBot

class TelegramBotSendMessage(BaseOperator):
    """Odeslat zprávu do chat_id pomocí TelegramBotHook

    Příklad:
        >>> TelegramBotSendMessage(
        ...     task_id='telegram_fail', dag=dag,
        ...     tg_bot_conn_id='tg_bot_default',
        ...     chat_id='{{ var.value.all_the_young_dudes_chat }}',
        ...     message='{{ dag.dag_id }} failed :(',
        ...     trigger_rule=TriggerRule.ONE_FAILED)
    """
    template_fields = ['chat_id', 'message']

    def __init__(self,
                 chat_id: Union[int, str],
                 message: str,
                 tg_bot_conn_id: str = 'tg_bot_default',
                 *args, **kwargs):
        super().__init__(*args, **kwargs)

        self._hook = TelegramBotHook(tg_bot_conn_id)
        self.client: TelegramBot = self._hook.client
        self.chat_id = chat_id
        self.message = message

    def execute(self, context):
        print(f'Odesílám "{self.message}" do chatu {self.chat_id}')
        self.client.send_message(chat_id=self.chat_id,
                                 message=self.message)
Zde, jako všechno ostatní v Airflow, je to velmi jednoduché:
- Dědíme z
BaseOperator, který implementuje poměrně hodně Airflow-specifických funkcí (podívejte se na to v klidu) - Definovali jsme pole
template_fields, ve kterých Jinja bude hledat makra pro zpracování. - Zajistili jsme správné argumenty pro
__init__(), nastavili jsme výchozí hodnoty tam, kde bylo potřeba. - Na inicializaci předka jsme také nezapomněli.
- Otevřeli jsme odpovídající hook
TelegramBotHook, získali jsme od něj klientský objekt. - Přepsali jsme metodu
BaseOperator.execute(), kterou Airflow zavolá, když nastane čas spustit operátor — v ní realizujeme hlavní akci, aniž bychom zapomněli na logování. (Logujeme se, mimochodem, přímo dostdoutastderr— Airflow to vše zachytí, krásně zabalí a rozloží, kam je třeba.)
Podívejme se, co máme v commons/hooks.py. První část souboru, s hookem:
from typing import Union

from airflow.hooks.base_hook import BaseHook
from requests_toolbelt.sessions import BaseUrlSession

class TelegramBotHook(BaseHook):
    """Hook pro Telegram Bot API

    Poznámka: přidejte připojení bez typu připojení a nezapomeňte
    vyplnit Extra:

        {"bot_token": "YOuRAwEsomeBOtToKen"}
    """
    def __init__(self,
                 tg_bot_conn_id='tg_bot_default'):
        super().__init__(tg_bot_conn_id)

        self.tg_bot_conn_id = tg_bot_conn_id
        self.tg_bot_token = None
        self.client = None
        self.get_conn()

    def get_conn(self):
        extra = self.get_connection(self.tg_bot_conn_id).extra_dejson
        self.tg_bot_token = extra['bot_token']
        self.client = TelegramBot(self.tg_bot_token)
        return self.client
Ani nevím, co bych zde mohl vysvětlit, jednoduše zdůrazním důležité body:
- Dědíme, zamyslíme se nad argumenty — v drtivé většině případů jich bude pouze jeden:
conn_id; - Přepisujeme standardní metody: omezil jsem se na
get_conn(), ve které získám parametry připojení podle názvu a prostě vyndám sekciextra(toto pole pro JSON), do kterého jsem (podle své vlastní instrukce!) vložil token pro Telegram bota:{"bot_token": "YOuRAwEsomeBOtToKen"}. - Vytvářím instanci našeho
TelegramBot, přičemž mu již předávám konkrétní token.
To je vše. Získat klienta z hooku lze pomocí TelegramBotHook().clent nebo TelegramBotHook().get_conn().
A druhá část souboru, ve kterém jsem udělal mikroobal pro Telegram REST API, abych nemusel tahat ten samý kvůli jedné metodě sendMessage.
class TelegramBot:
    """Obal pro Telegram Bot API

    Příklady:
        >>> TelegramBot('YOuRAwEsomeBOtToKen', '@myprettydebugchat').send_message('Ahoj, miláčku')
        >>> TelegramBot('YOuRAwEsomeBOtToKen').send_message('Ahoj, miláčku', chat_id=-1762374628374)
    """
    API_ENDPOINT = 'https://api.telegram.org/bot{}/'

    def __init__(self, tg_bot_token: str, chat_id: Union[int, str] = None):
        self._base_url = TelegramBot.API_ENDPOINT.format(tg_bot_token)
        self.session = BaseUrlSession(self._base_url)
        self.chat_id = chat_id

    def send_message(self, message: str, chat_id: Union[int, str] = None):
        method = 'sendMessage'

        payload = {'chat_id': chat_id or self.chat_id,
                   'text': message,
                   'parse_mode': 'MarkdownV2'}

        response = self.session.post(method, data=payload).json()
        if not response.get('ok'):
            raise TelegramBotException(response)

class TelegramBotException(Exception):
    def __init__(self, *args, **kwargs):
        super().__init__((args, kwargs))
Správná cesta je všechno tohle spojit:
TelegramBotSendMessage,TelegramBotHook,TelegramBot— do pluginu, vložit do veřejného repozitáře a poskytnout k Open Source.
Zatímco jsme to všechno zkoumali, naše aktualizace zpráv se úspěšně zhroutily a poslaly mi do kanálu zprávu o chybě. Jdu zkontrolovat, co je opět špatně...
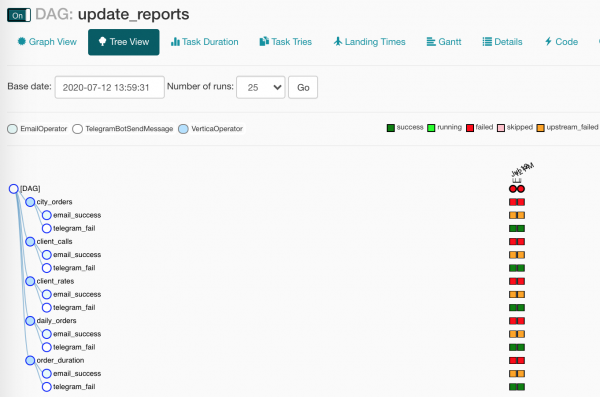
Něco se v našem dagu pokazilo! A to jsme přeci čekali? Přesně tak!
Budeš nalévat?
Cítíte, že jsem něco vynechal? Zdá se, že jsem slíbil přenášet data ze SQL Serveru do Vertica, a teď jsem se od tématu odklonil, lotr!
Tenhle přečin byl záměrný, musel jsem vám přeložit některé terminologie. Teď můžeme pokračovat dál.
Náš plán byl následující:
- Vytvořit dag
- Generovat úkoly
- Podívat se, jak to všechno vypadá hezky
- Přiřadit relacím čísla sezení
- Získat data ze SQL Serveru
- Uložit data do Vertica
- Shromáždit statistiky
Abychom to všechno spustili, udělal jsem malé doplnění k našemu docker-compose.yml:
docker-compose.db.yml
verze: '3.4'

x-mssql-base: &mssql-base
  image: mcr.microsoft.com/mssql/server:2017-CU21-ubuntu-16.04
  restart: always
  environment:
    ACCEPT_EULA: Y
    MSSQL_PID: Express
    SA_PASSWORD: SayThanksToSatiaAt2020
    MSSQL_MEMORY_LIMIT_MB: 1024

services:
  dwh:
    image: jbfavre/vertica:9.2.0-7_ubuntu-16.04

  mssql_0:
    <<: *mssql-base

  mssql_1:
    <<: *mssql-base

  mssql_2:
    <<: *mssql-base

  mssql_init:
    image: mio101/py3-sql-db-client-base
    command: python3 ./mssql_init.py
    depends_on:
      - mssql_0
      - mssql_1
      - mssql_2
    environment:
      SA_PASSWORD: SayThanksToSatiaAt2020
    volumes:
      - ./mssql_init.py:/mssql_init.py
      - ./dags/commons/datasources.py:/commons/datasources.py
Zde spouštíme:
- Vertica jako host
dwhs výchozími nastaveními, - tři instance SQL Serveru,
- naplňujeme databáze nejnovějšími daty (nikdy nekoukejte do
mssql_init.py!)
Nastartujeme všechno pomocí trochu složitějšího příkazu než minule:
$ docker-compose -f docker-compose.yml -f docker-compose.db.yml up --scale worker=3Co vygeneroval náš zázračný randomizér, lze využít pomocí položky Data Profiling/Ad Hoc Query:
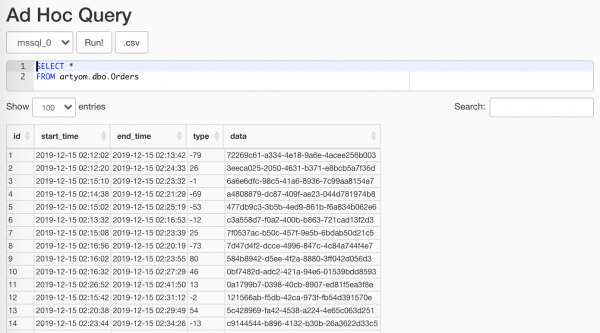
Hlavně to neukazovat analytikům
Podrobně se věnovat ETL relacím nebudu, vše je triviální: vytvoříme databázi, v ní tabulku, obalíme to správcem kontextu a nyní to provádíme takto:
with Session(task_name) as session:
    print('Load', session.id, 'started')

    # Load workflow
    ...

    session.successful = True
    session.loaded_rows = 15
session.py
ze sys import stderr

class Session:
    """ETL pracovní tok relace

    Příklad:
        s relací Session(task_name) jako relací:
            print(relace.id)
            relace.successful = True
            relace.loaded_rows = 15
            relace.comment = 'Dobrá práce'
    """

    def __init__(self, connection, task_name):
        self.connection = connection
        self.connection.autocommit = True

        self._task_name = task_name
        self._id = None

        self.loaded_rows = None
        self.successful = None
        self.comment = None

    def __enter__(self):
        return self.open()

    def __exit__(self, exc_type, exc_val, exc_tb):
        if any(exc_type, exc_val, exc_tb):
            self.successful = False
            self.comment = f'{exc_type}: {exc_val}n{exc_tb}'
            print(exc_type, exc_val, exc_tb, file=stderr)
        self.close()

    def __repr__(self):
        return (f'')

    @property
    def task_name(self):
        return self._task_name

    @property
    def id(self):
        return self._id

    def _execute(self, query, *args):
        with self.connection.cursor() as cursor:
            cursor.execute(query, args)
            return cursor.fetchone()[0]

    def _create(self):
        query = """
            CREATE TABLE IF NOT EXISTS sessions (
                id          SERIAL       NOT NULL PRIMARY KEY,
                task_name   VARCHAR(200) NOT NULL,

                started     TIMESTAMPTZ  NOT NULL DEFAULT current_timestamp,
                finished    TIMESTAMPTZ           DEFAULT current_timestamp,
                successful  BOOL,

                loaded_rows INT,
                comment     VARCHAR(500)
            );
            """
        self._execute(query)

    def open(self):
        query = """
            INSERT INTO sessions (task_name, finished)
            VALUES (%s, NULL)
            RETURNING id;
            """
        self._id = self._execute(query, self.task_name)
        print(self, 'otevřeno')
        return self

    def close(self):
        if not self._id:
            raise SessionClosedError('Relace není otevřená')
        query = """
            UPDATE sessions
            SET
                finished    = DEFAULT,
                successful  = %s,
                loaded_rows = %s,
                comment     = %s
            WHERE
                id = %s
            RETURNING id;
            """
        self._execute(query, self.successful, self.loaded_rows,
                      self.comment, self.id)
        print(self, 'uzavřeno',
              ', úspěšně: ', self.successful,
              ', Nahráno: ', self.loaded_rows,
              ', komentář:', self.comment)

class SessionError(Exception):
    pass

class SessionClosedError(SessionError):
    pass
Nastal čas vyzvednout naše data z našich více než sto padesáti tabulek. Uděláme to pomocí velmi jednoduchých řádků:
source_conn = MsSqlHook(mssql_conn_id=src_conn_id, schema=src_schema).get_conn()

query = f"""
    SELECT
        id, start_time, end_time, type, data
    FROM dbo.Orders
    WHERE
        CONVERT(DATE, start_time) = '{dt}'
    """

df = pd.read_sql_query(query, source_conn)- Pomocí hooku získáme z Airflow
pymssql-konexi - Do dotazu vložíme omezení ve formě data — do funkce ji podstrčí šablonizátor.
- Podáváme náš dotaz
pandas, který nám vytáhneDataFrame— ten se nám bude hodit dál.
Používám substituci
{dt}místo parametru dotazu%sne proto, že bych byl zlovolný Buraťák, ale proto, žepandasnedokáže se vypořádat spymssqla podstrkuje to poslednímuparams: Seznam, i když ten moc chcen-tice.
Také si všimněte, že vývojářpymssqlse rozhodl ho již dále nepodporovat, a je čas přejít napyodbc.
Podívejme se, čím Airflow naplnil argumenty našich funkcí:
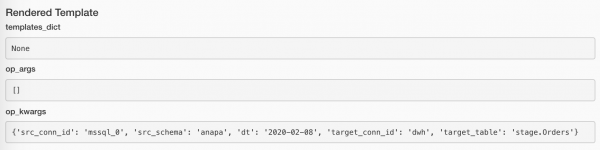
Pokud data neexistují, nemá smysl pokračovat. Ale tvrdit, že nahrávání bylo úspěšné, je také podivné. Ale to není chyba. A-a-a, co teď?! A co takhle:
if df.empty:
    raise AirflowSkipException('Žádné řádky k načtení')
AirflowSkipException řekne Airflow, že vlastně žádná chyba není, a úkol přeskočíme. V rozhraní nebude zelený ani červený čtverec, ale barva růžová.
Přihodíme našim datům několik sloupců:
df['etl_source'] = src_schema
df['etl_id'] = session.id
df['hash_id'] = hash_pandas_object(df[['etl_source', 'id']])
A to konkrétně:
- DB, ze které jsme vzali objednávky,
- Identifikátor naší zahrnující relace (ten bude jiný pro každý úkol),
- Hash ze zdroje a identifikátoru objednávky - abychom měli v konečné databázi (kde se všechno seřadí do jedné tabulky) unikátní identifikátor objednávky.
Zůstal předposlední krok: nahrát všechno do Vertica. A, jak překvapivé, jeden z nejefektivnějších způsobů, jak to udělat — je přes CSV!
# Export data to CSV buffer
buffer = StringIO()
df.to_csv(buffer,
          index=False, sep='|', na_rep='NUL', quoting=csv.QUOTE_MINIMAL,
          header=False, float_format='%.8f', doublequote=False, escapechar='\')
buffer.seek(0)

# Push CSV
target_conn = VerticaHook(vertica_conn_id=target_conn_id).get_conn()

copy_stmt = f"""
    COPY {target_table}({df.columns.to_list()})
    FROM STDIN
    DELIMITER '|'
    ENCLOSED '"'
    ABORT ON ERROR
    NULL 'NUL'
    """

cursor = target_conn.cursor()
cursor.copy(copy_stmt, buffer)- Vytváříme speciální příjemce
StringIO. pandasochotně do něho uloží nášDataFrameve forměCSV-řádků.- Otevřeme spojení s naším oblíbeným Vertica hookem.
- A nyní pomocí
copy()odešleme naše data přímo do Verticy!
Z ovladače vezmeme, kolik řádků bylo nahráno, a řekneme manažerovi relace, že vše je v pořádku:
session.loaded_rows = cursor.rowcount
session.successful = True
A to je všechno.
Na produkci vytváříme cílovou tabulku ručně. Tady jsem si dovolil malou automatizaci:
create_schema_query = f'CREATE SCHEMA IF NOT EXISTS {target_schema};'
create_table_query = f"""
    CREATE TABLE IF NOT EXISTS {target_schema}.{target_table} (
         id         INT,
         start_time TIMESTAMP,
         end_time   TIMESTAMP,
         type       INT,
         data       VARCHAR(32),
         etl_source VARCHAR(200),
         etl_id     INT,
         hash_id    INT PRIMARY KEY
     );"""

create_table = VerticaOperator(
    task_id='create_target',
    sql=[create_schema_query,
         create_table_query],
    vertica_conn_id=target_conn_id,
    task_concurrency=1,
    dag=dag)
Pomocí příkazu
VerticaOperator()vytvářím schéma DB a tabulku (pokud ještě neexistují, samozřejmě). Hlavní je správně nastavit závislosti:
for conn_id, schema in sql_server_ds:
    load = PythonOperator(
        task_id=schema,
        python_callable=workflow,
        op_kwargs={
            'src_conn_id': conn_id,
            'src_schema': schema,
            'dt': '{{ ds }}',
            'target_conn_id': target_conn_id,
            'target_table': f'{target_schema}.{target_table}'},
        dag=dag)

    create_table >> load
Shrnutí
— No tak, — řekl myšák, — není to pravda, teď?
Uvěřil jsi, že v lese jsem nejděsivější zvíře?
Julia Donaldson, „Gruffalo“
Myslím, že kdybychom s mými kolegy uspořádali soutěž: kdo rychleji vytvoří a spustí ETL proces od nuly: oni se svým SSIS a myší a já s Airflow… A pak bychom ještě porovnali pohodlí údržby… Uf, myslím, že se shodneme, že je předejdu ve všech ohledech!
Pokud se na to podíváme trochu vážněji, tak Apache Airflow — díky popisu procesů ve formě programového kódu — udělal moji práci mnohem pohodlnější a příjemnější.
Jeho neomezená rozšiřitelnost: jak v oblasti pluginů, tak i predispozice k škálovatelnosti — vám umožňuje použít Airflow prakticky v jakékoliv oblasti: ať už v plném cyklu shromažďování, přípravy a zpracování dat, nebo při startu raket (na Mars, samozřejmě).
Závěrečná, informačně-referenční část
Nějaké překážky, které jsme za vás nasbírali
start_date. Ano, to už je lokální meme. Skrze hlavní argument DAGstart_dateprochází všemi. Zkrátka, pokud uvedetestart_dateaktuální datum, a vschedule_interval— jeden den, pak se DAG spustí zítra nejdříve.start_date = datetime(2020, 7, 7, 0, 1, 2)A žádné další problémy.
S ním je také spojen ještě jeden typ chyby:
Task is missing the start_date parameter, který většinou říká, že jste zapomněli připojit k operátorovi DAG.- Všechno na jednom stroji. Ano, a databáze (jak Airflow, tak naše pokrytí), webový server, plánovač a pracovníci. A dokonce to fungovalo. Ale s časem počet úloh u služeb rostl, a když PostgreSQL začal vracet odpověď podle indexu za 20 ms místo 5 ms, vzali jsme ho a přesunuli.
- LocalExecutor. Ano, používáme ho stále, a už jsme se dostali na okraj propasti. LocalExecutor nám dosud stačil, ale teď nastal čas rozšířit se minimálně o jednoho pracovníka, a bude potřeba se snažit, abychom přešli na CeleryExecutor. A vzhledem k tomu, že s ním lze pracovat i na jednom stroji, nic nebrání použití Celery na serveru, který „samozřejmě nikdy nepůjde do produkce, přísahám!“
- Nepoužívání integrovaných nástrojů:
- Connections pro uchování pověření služeb,
- SLA Misses pro reakci na úkoly, které neproběhly včas,
- XCom pro výměnu metadat (řekl jsem metadata!) mezi úkoly DAG.
- Zneužívání e-mailu. Co k tomu říct? Byla nastavena upozornění na všechny opakující se selhání úkolů. Teď mám ve své pracovní Gmailu >90 tisíc e-mailů od Airflow a webové rozhraní e-mailu odmítá zpracovat a smazat více než 100 najednou.
Více úskalí:
Nástroje pro ještě větší automatizaci
Abychom mohli více pracovat hlavou a ne rukama, Airflow nám připravilo toto:
- — stále má status experimentálního, což mu nebrání v tom, aby fungoval. S jeho pomocí lze nejen získávat informace o DAGS a úkolech, ale také zastavovat/spouštět DAG, vytvářet DAG Run nebo pool.
- — přes příkazovou řádku je dostupných mnoho nástrojů, které nejsou jen nepohodlné pro použití přes WebUI, ale často jsou zcela nedostupné. Například:
backfillje potřeba pro opětovné spuštění instancí úkolů.
Například, analytici přijdou a říkají: „A máte, pane, tímto data od 1. do 13. ledna! Opravit, opravit, opravit!“. A vy uděláte hups:airflow backfill -s '2020-01-01' -e '2020-01-13' orders- Údržba databáze:
initdb,resetdb,upgradedb,checkdb. run, který umožňuje spustit jednu instanci úkolu, a ještě ignorovat všechny závislosti. Navíc lze ho spustit přesLocalExecutor, i když máte Celery cluster.- Zhruba to samé dělá
test, jen to do databáze nic nepíše. connectionsumožňuje hromadně vytvářet připojení z shellu.
- — docela hardcore způsob interakce, určený pro pluginy, a ne pro hrabání v něm rukama. Ale kdo nám brání jít do
/home/airflow/dags, spustitipythona začít se zmocňovat? Můžete například exportovat všechny připojení tímto kódem:from airflow import settings from airflow.models import Connection fields = 'conn_id conn_type host port schema login password extra'.split() session = settings.Session() for conn in session.query(Connection).order_by(Connection.conn_id): d = {field: getattr(conn, field) for field in fields} print(conn.conn_id, '=', d) - Připojení k databázi metadat Airflow. Psát do ní nedoporučuji, ale získat stavy úkolů pro různé specifické metriky lze podstatně rychleji a jednodušeji, než prostřednictvím kterékoli API.
Řekněme, že zdaleka ne všechny naše úkoly jsou idempotentní, a občas mohou selhávat, a to je v pořádku. Ale několik selhání už je podezřelé, a je potřeba to ověřit.
Pozor, SQL!
S posledními_exekucemi JAKO (
VYBERTE
    task_id,
    dag_id,
    execution_date,
    state,
        row_number()
        OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC) JAKO rn
Z public.task_instance
KDE
    execution_date > nyní() - INTERVAL '2' DEN
),
neúspěch JAKO (
    VYBERTE
        task_id,
        dag_id,
        execution_date,
        state,
        POKUD rn = row_number() OVER (
            PARTITION BY task_id, dag_id
            ORDER BY execution_date DESC)
                 POTOM PRAVDA KONEC JAKO poslední_neúspěch_sekvence
    Z poslední_exekucí
    KDE
        state IN ('failed', 'up_for_retry')
)
VYBERTE
    task_id,
    dag_id,
    count(poslední_neúspěch_sekvence)                       JAKO neúspěchy,
    count(POKUD poslední_neúspěch_sekvence
        A state = 'failed' POTOM 1 KONEC)       JAKO neúspěšné,
    count(POKUD poslední_neúspěch_sekvence
        A state = 'up_for_retry' POTOM 1 KONEC) JAKO opět_za_zkusit
Z neúspěch
GROUP BY
    task_id,
    dag_id
HAVING
    count(poslední_neúspěch_sekvence) > 0
Odkazy
A samozřejmě prvních deset odkazů z Googlu obsahuje složku Airflow z mých záložek.
- — samozřejmě, je třeba začít s oficiální dokumentací, ale kdo čte instrukce?
- — alespoň si přečtěte doporučení od tvůrců.
- — začátek: uživatelské rozhraní na obrázcích
- — dobře jsou popsány základní pojmy, pokud (náhodou!) jste něco nepochopili u mě.
- — stručný průvodce nastavením klastru Airflow.
- — téměř stejně zajímavý článek, akorát více formálnosti a méně příkladů.
- — o práci v kombinaci s Celery.
- — o idempotentnosti úkolů, načítání podle ID místo data, transformacích, struktuře souborů a dalších zajímavých věcech.
- — závislosti úkolů a Trigger Rule, které jsem zmínil jen okrajově.
- — jak překonávat některé "funguje to, jak má" v plánovači, načítat ztracená data a stanovovat priority úkolů.
- — užitečné SQL dotazy na metadat Airflow.
- — je zde užitečná sekce o vytváření vlastního senzoru.
- — zajímavá krátká poznámka o budování infrastruktury na AWS pro datovou vědu.
- — běžné chyby (když někdo přesto nečte instrukce).
- — usmějte se, jak lidé obcházejí ukládání hesel, i když stačí použít Connections.
- — implicit transmission of DAG, context injection in functions, again about dependencies, and also about skipping task runs.
- — o použití
výchozí argumentyaparamsv šablonách, jakož i o proměnných a připojeních. - — vyprávění o tom, jak je plánovač připraven na Airflow 2.0.
- — poněkud zastaralý článek o nasazení našeho klastru v
docker-compose. - — dynamické úkoly pomocí šablon a přenosu kontextu.
- — standardní a vlastní upozornění e-mailem a Slackem.
- — větvení úkolů, makra a XCom.
A odkazy, které byly použity v článku:
- — dostupné pro použití v šablonách jako zástupné symboly.
- — Rozšířené chyby při vytváření DAGů.
- —
docker-composepro experimentování, ladění a nejen to. - — Python obálka pro REST API Telegramu.
Zdroj: habr.com
