

V roce 2017 jsme vyhráli soutěž na vývoj transakčního jádra investičního byznysu Alfa-Bank a začali jsme pracovat (na HighLoad++ 2018 s prezentací o jádru investičního byznysu Vladimir Drynkin, vedoucí oddělení transakčního jádra investičního byznysu Alfa-Banku). Tento systém měl agregovat data o transakcích z různých zdrojů v různých formátech, upravovat tato data do jednotné podoby, uchovávat je a poskytovat k nim přístup.
V průběhu vývoje systém evolvoval a získával nové funkce, a v určitém okamžiku jsme si uvědomili, že se formuje něco mnohem většího než jen aplikační software vytvořený pro řešení konkrétního souboru úkolů: vytvořili jsme systém pro budování distribuovaných aplikací s perzistentním úložištěm. Získané zkušenosti se staly základem nového produktu — (TDG).
Chci se podělit o architekturu TDG a o řešeních, ke kterým jsme dospěli během vývoje, seznámit vás s hlavními funkcemi a ukázat, jak může náš produkt sloužit jako základ pro vytvoření kompletních řešení.
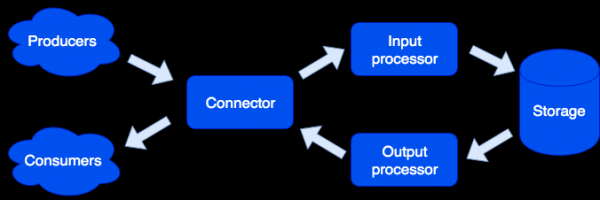
Architektonicky jsme rozdělili systém na jednotlivé role, z nichž každá je odpovědná za řešení určité skupiny úkolů. Jeden spuštěný instance aplikace realizuje jeden nebo několik typů rolí. V clusteru může být několik rolí jednoho typu:
Connector
Connector zajišťuje spojení se vnějším světem; jeho úkolem je přijmout žádost, rozparsovat ji, a pokud to bylo úspěšné, odeslat data k zpracování do input processoru. Podporujeme formáty HTTP, SOAP, Kafka, FIX. Architektura umožňuje snadné přidávání podpory pro nové formáty, brzy bude k dispozici podpora IBM MQ. Pokud se parsování žádosti nezdaří, connector vrátí chybu; v opačném případě odpoví, že žádost byla úspěšně zpracována, i když při dalším zpracování došlo k chybě. To bylo navrženo speciálně pro práci se systémy, které nedokážou opakovat žádosti – nebo naopak, dělají to příliš usilovně. Abychom neztratili data, používá se opravná fronta: objekt nejprve putuje do ní a pouze po úspěšném zpracování je z ní odstraněn. Administrator může dostávat upozornění o objektech, které zůstaly v opravné frontě, a po odstranění softwarové chyby nebo hardwarového selhání provést opakovaný pokus.
Input processor
Input processor klasifikuje přijata data podle charakteristických rysů a vyvolává vhodné zpracovatele. Zpracovatelé jsou kód v jazyce Lua, spouštěný v pískovišti, takže nemohou ovlivnit fungování systému. V této fázi lze data upravit do požadovaného tvaru a také spustit libovolný počet úloh, které mohou realizovat požadovanou logiku. Například v produktu MDM (Master Data Management), postaveném na Tarantool Data Grid, při přidávání nového uživatele spouštíme jednu samostatnou úlohu pro vytvoření zlatého záznamu, abychom nezpomalili zpracování žádosti. Pískoviště podporuje operace pro čtení, změnu a přidání dat, umožňuje vykonávat určitou funkci na všech rolích typu storage a agregovat výsledek (map/reduce).
Zpracovatelé mohou být popsáni v souborech:
sum.lua

local x, y = unpack(...)
return x + y
A pak, deklarováni v konfiguraci:
functions:
  sum: { __file: sum.lua }
Proč Lua? Lua je velmi jednoduchý jazyk. Na základě našich zkušeností, po pár hodinách seznámení s ním lidé začínají psát kód, který řeší jejich úkol. A to nejen profesionální vývojáři, ale například i analytici. Kromě toho, díky jit-kompilačnímu systému, Lua funguje velmi rychle.
Úložiště
Úložiště uchovává trvalá data. Před uložením data procházejí validací podle schématu dat. K popisu schématu používáme rozšířený formát. . Příklad:
{
    "name": "User",
    "type": "record",
    "logicalType": "Aggregate",
    "fields": [
        { "name": "id", "type": "string"},
        {"name": "first_name", "type": "string"},
        {"name": "last_name", "type": "string"}
    ],
    "indexes": ["id"]
}
Na základě tohoto popisu se automaticky generuje DDL (Data Definition Language) pro databázový systém Tarantool a schéma pro přístup k datům.
Podporována je asynchronní replikace dat (v plánu je přidání synchronní replikace).
Output processor
Někdy je třeba informovat externí spotřebitele o příchodu nových dat, k tomu slouží role Output processor. Po uložení dat mohou být předány příslušnému zpracovateli (například aby je převedl do formátu, který vyžaduje spotřebitel) — a poté odeslány do konektoru. I zde se používá opravná fronta: pokud objekt nikdo nepřijal, administrátor může pokus zopakovat později.
Škálování
Role konektoru, input processor a output processor nemají stav, což nám umožňuje horizontálně škálovat systém, jednoduše přidáváním nových instancí aplikace s aktivovanou rolí požadovaného typu. Pro horizontální škálování storage se používá k organizaci clusteru s využitím virtuálních bucketů. Po přidání nového serveru část bucketů ze starých serverů se na pozadí přesune na nový server; to probíhá transparentně pro uživatele a nemá to vliv na fungování celého systému.
Vlastnosti dat
Objekty mohou být velmi velké a obsahovat další objekty. Zajistíme atomickost přidání a aktualizace dat, přičemž uložíme objekt se všemi závislostmi na jednom virtuálním bucketu. Tímto způsobem se vylučuje "rozmázání" objektu na několik fyzických serverů.
Podporováno verzování: každá aktualizace objektu vytváří novou verzi, a vždy můžeme vytvořit časový průřez a podívat se, jak svět tehdy vypadal. Pro data, která nepotřebují dlouhou historii, můžeme omezit počet verzí nebo dokonce uchovávat pouze jednu — poslední, což fakticky znamená vypnout verzování pro určitý typ. Také můžeme omezit historii podle času: například odstranit všechny objekty určitého typu starší než 1 rok. Podporována je i archivace: můžeme exportovat objekty starší než daný čas, čímž uvolníme místo v clusteru.
Úkoly
Mezi zajímavými funkcemi stojí za zmínku možnost spouštění úloh podle plánu, na žádost uživatele nebo programově z písečného prostoru:
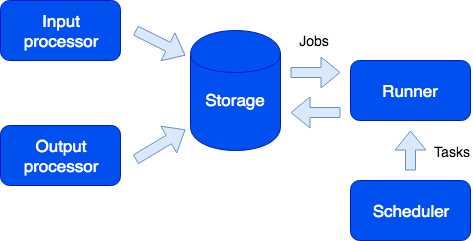
Zde vidíme další roli — runner. Tato role nemá stav, a v případě potřeby lze do clusteru přidat další instance aplikace s touto rolí. Odpovědností runnera je provádět úlohy. Jak bylo zmíněno, z písečného prostoru je možné vytvářet nové úlohy; ty se ukládají do fronty na storage a později se vykonávají na runneru. Tento typ úloh se nazývá Job. Také máme typ úloh nazvaný Task — to jsou úlohy definované uživateli a spouštěné podle plánu (používá se syntaxe cron) nebo na požádání. Pro spuštění a sledování takových úloh máme pohodlného správce úloh. Aby byla tato funkcionalita dostupná, je třeba zapnout roli scheduler; tato role má stav, proto se neskaluje, což v každém případě není potřeba; přitom může mít jako všechny ostatní role repliku, která začne pracovat, pokud master náhle selže.
Logger
Další rolí je logger. Ten sbírá logy ze všech členů clusteru a poskytuje rozhraní pro jejich export a zobrazení prostřednictvím webového rozhraní.
Služby
Je třeba zmínit, že systém umožňuje snadno vytvářet služby. V konfiguračním souboru lze specifikovat, které požadavky směřovat na zpracovatele uživatelem napsaného, který se vykonává v písečném prostoru. V tomto zpracovateli je možné například provést nějaký analytický dotaz a vrátit výsledek.
Služba je popsána v konfiguračním souboru:
services:
   sum:
      doc: "přidá dvě čísla"
      function: sum
      return_type: int
      args:
         x: int
         y: int
GraphQL API se automaticky generuje a služba je dostupná pro volání:
dotaz {
   součet(x: 1, y: 2)
}
Toto vyvolá zpracovatele sum, který vrátí výsledek:
3
Profilování dotazů a metriky
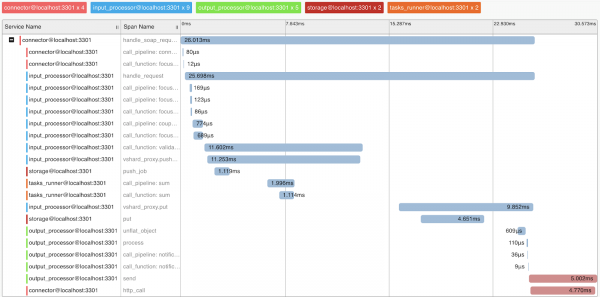
Pro pochopení fungování systému a profilování dotazů jsme implementovali podporu protokolu OpenTracing. Systém může na požádání posílat informace nástrojům, které tento protokol podporují, například Zipkin, což pomůže pochopit, jak byl dotaz proveden:
Samozřejmě, systém poskytuje interní metriky, které lze shromažďovat pomocí Prometheus a vizualizovat pomocí Grafana.
Nasazení
Tarantool Data Grid může být nasazen z RPM balíčků nebo archivu, pomocí dodané utility nebo Ansible, také je podporován Kubernetes ().
Aplikace implementující obchodní logiku (konfigurace, zpracovatelé) jsou nahrávány do nasazeného clusteru Tarantool Data Grid ve formě archivu přes UI nebo pomocí skriptu, skrze námi poskytované API.
Příklady aplikací
Jaké aplikace lze vytvořit pomocí Tarantool Data Grid? Většina obchodních úloh je spojena se zpracováním datových proudů, jejich ukládáním a přístupem k nim. Pokud máte velké datové toky, které potřebujete bezpečně uchovávat a mít k nim přístup, náš produkt vám může ušetřit spoustu času při vývoji a soustředit se na svou obchodní logiku.
Například chceme sbírat informace o trhu s nemovitostmi, abychom následně měli informace o nejvýhodnějších nabídkách. V tomto případě vymezíme následující úkoly:
- Roboti sbírající informace z otevřených zdrojů – to budou naše datové zdroje. Tento úkol můžete vyřešit pomocí hotových řešení nebo napsáním kódu v jakémkoli jazyce.
- Poté Tarantool Data Grid přijme a uloží data. Pokud se formát dat z různých zdrojů liší, můžete napsat kód v jazyce Lua, který provede převod na jednotný formát. Ve fázi předzpracování budete také moci například filtrovat duplicitní nabídky nebo dodatečně aktualizovat v databázi informace o agentech, kteří pracují na trhu.
- Nyní máte škálovatelné řešení v clusteru, které můžete naplnit daty a provádět dotazy. Dále můžete implementovat nové funkce, například napsat službu, která provede dotaz na data a vrátí nejvýhodnější nabídku za den — to si bude vyžadovat několik řádků v konfiguračním souboru a trochu kódu v Lua.
Co dál?
Naší prioritou je zvyšování pohodlí vývoje prostřednictvím . Například to je IDE s podporou profilování a ladění zpracovatelů, které běží v pískovišti.
Také věnujeme velkou pozornost otázkám bezpečnosti. Právě teď procházíme certifikací FSTEK Ruska, abychom potvrdili vysokou úroveň bezpečnosti a splnili požadavky na certifikaci softwarových produktů používaných v informačních systémech osobních údajů a státních informačních systémech.
Zdroj: habr.com
