

od St-Pete
Ahoj všichni! Jsem Mons Anderson, architekt platformy , povím vám, jak jsme vybudovali naše úložiště S3, jak funguje, jaká řešení se osvědčila a co bychom změnili, kdybychom začínali takový projekt znovu.
Článek byl připraven na základě prezentace na od Mail.ru Cloud Solutions & Tarantool. V článku se budeme věnovat:
- jak bylo uspořádáno úložiště Mail.ru, na jehož základě jsme vybudovali úložiště S3;
- co jsme přidali, abychom vytvořili Mail.ru Cloud Storage;
- jak funguje objektový model ukládání a jaké byly kroky k nasazení do produkce;
- o úpravách provozního systému: failover a škálování;
- jak jsme implementovali shardování a resharing;
- a také o práci s SSL certifikáty.
Pokud nechcete číst, můžete .
Jak bylo uspořádáno úložiště Mail.ru, na jehož základě jsme vybudovali úložiště S3
Vývoj našeho S3 začal na základě úložiště Cloud Mail.ru, takže je nejprve potřeba říci, jak je uspořádáno a co umí.
Úložiště Cloud Mail.ru se skládá ze serverů s disky. V průměru moderní storage server má 36 disků po 12–14 terabajtech. Dříve byly disky menší, ale za tři roky se objemy disků zvýšily a dnes jde téměř o půl petabajtu syrových dat.
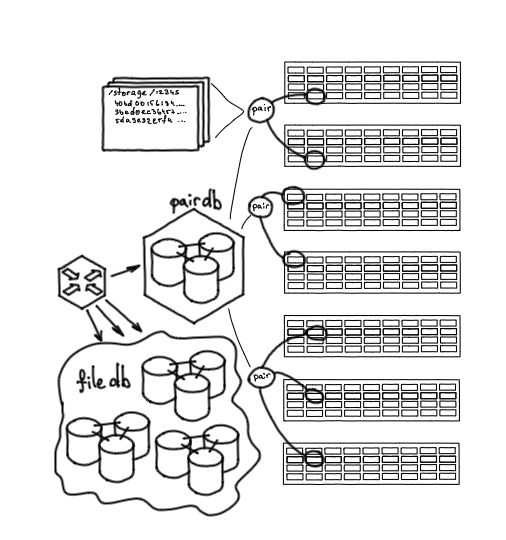
Disky z různých serverů úložiště jsou spojeny do tzv. "párů" (pair). Pár je jedinou jednotkou ukládání souborů. V podstatě jde o disk namontovaný do určitého oddílu na určité cestě, kde mohou ležet soubory identifikované hash hodnotami.
Pár je historický název, který se uchoval až do dnešních dnů, i když dnes pár nemusí mít jen dva disky. Může jich být tři, a také mohou existovat různé hybridní úložiště, například 3/2.
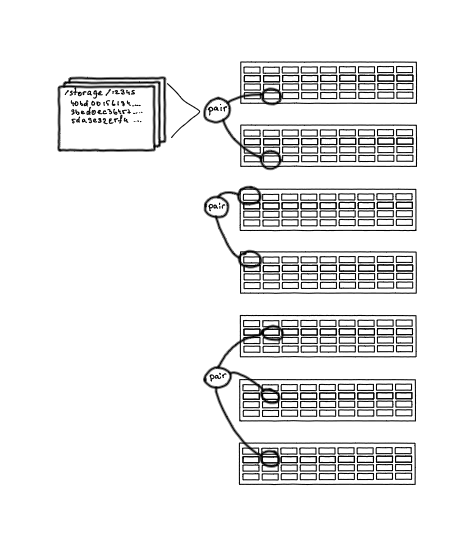
Páry (pair) — jednotky ukládání objektů
Všechny páry jsou uchovávány v PairDB — to je aplikace na bázi Tarantool. Všechny databáze v našem úložišti, počínaje těmi nejstaršími, jsou založeny na Tarantool, jiných databází nepoužíváme.
PairDB uchovává všechny páry, jejich stavy, volné místo, možnosti selhání, poslední chyby. Také může sama kontrolovat páry, aktualizovat jejich stav, kontrolovat, zda fungují nebo ne. To znamená, že PairDB je jakýmsi obecným snímkem stavu všech disků naší systému.
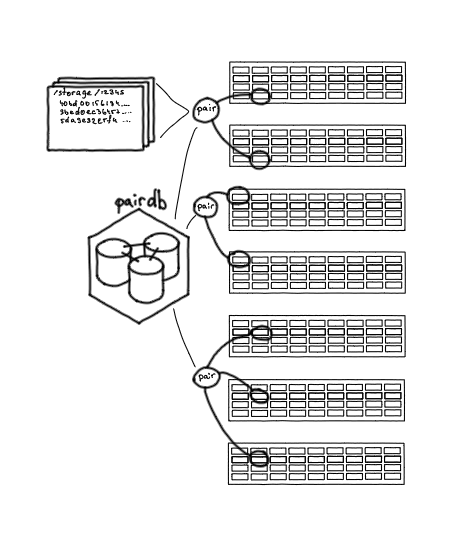
Pair DB: databáze se stavem párů
Na párech se ukládají soubory, a abychom věděli, na které páře se jaký soubor nachází, je potřeba další databáze — FileDB. Ta uchovává mapování, definici souvislosti: tento soubor se ukládá na této páře, stejně jako malé množství potřebných atributů.
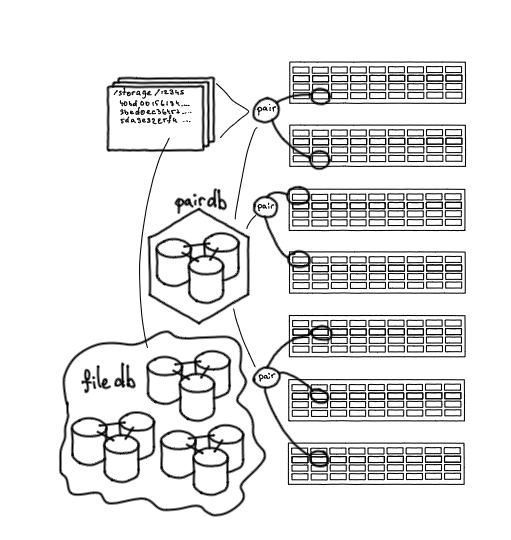 File DB: místo, kde se ukládá soubor
Další důležitý prvek — služba Nylon, směrovač pro práci s databázemi. Je to jediné vstupní místo, které umožňuje pracovat prostřednictvím jednotného rozhraní jak s PairDB, tak s FileDB. Je to stateless služba, provádí vyvažování požadavků, rozumí, na který shard FileDB je potřeba jít, ví, které páry jsou aktivní a které ne.
Nylon: směrovač pro práci s databázemi
Také je potřeba nějakým způsobem ukládat obsah do úložiště. K tomu existuje služba — Streamer. Nabízí dvě HTTP metody: metodu PUT pro nahrání obsahu do úložiště a metodu GET pro jeho stažení. HTTP je poměrně populární a pohodlný protokol pro přenos dat.
Když se obracíme na Streamer, ten se přes Nylon obrací na PairDB, zjišťuje, na kterou páru je možné nahrát soubor, a poté předává data přes WebDAV na tuto páru.
V podstatě je každý storage server — to je nginx plus disky, které jsou připojeny na stanovené cesty. Můžeme ze Streamer nahrát do úložiště soubor, odstranit ho, přejmenovat nebo zkontrolovat jeho integritu. To znamená, že to je pohodlné rozhraní pro nízkoúrovňovou interakci s úložištěm.
Streamer: vstupní bod do úložiště
Co jsme přidali, abychom vytvořili S3 úložiště
Takže jsme se podívali na základní strukturu úložiště v době, kdy jsme se chystali spustit S3 úložiště. Pomocí metody PUT jsme mohli umístit jakýkoliv obsah a jako identifikátor těchto dat získat hash. S tímto identifikátorem bylo později možné přijít a vyzvednout původní soubor. Ale to nestačí pro realizaci S3. V protokolu S3, kromě samotného ukládání objektů, existuje:
- úložiště metadat — dodatečných vlastností objektů;
- organizace přístupu k objektům prostřednictvím HTTP;
- skupinování objektů do kolekcí — bucketů;
- HTTP-S3 Endpoint. S3 organizuje data do určitých struktur — bucketů, z nichž každý poskytuje vstupní bod pro ukládání souborů.
Pro realizaci této logiky potřebujeme samostatnou službu. Také jsme chtěli ihned předpokládat architekturu pro budoucí růst služby s lineární škálovatelností.
První komponenty
Démon implementující S3 API. To je standardní S3 API Amazonu, které podporuje práci přes XML pro metadata a umožňuje přímý přenos obsahu. Nemuseli jsme nic vymýšlet, vše je popsáno a zdokumentováno.
Před službou jsme také nasadili Nginx. Ten jsme použili pro terminaci SSL, vyvažování zátěže, a také pro určitou logiku na Lua (metriky, logování a trasování).
Pro ukládání metadat S3 jsme také zvolili Tarantool. V první verzi za metadaty démon S3 chodil do této databáze, samotný obsah byl uchováván ve velkém úložišti přes Streamer.
Nginx + S3 API + metadata
Objektový model ukládání
Podívejme se, jak funguje S3. Uživatel může vytvořit bucket — kolekci objektů. Bucket je adresován názvem hostitele a je subdoménou služby. V rámci bucketu může uživatel vytvářet objekty. Identifikátorem objektu bude URL. Obsah objektu — blob, pole binárních dat, které budeme uchovávat ve skladu. Objekty mají také atributy: jméno — to je ono URL, ACL (seznam řízení přístupu), a další dodatečné nebo libovolné atributy — to vše je uchováváno v metadatech.
Normalizovaná schéma těchto dat může vypadat takto: jsou projekty, kterým patří buckety, kterým patří objekty, a objekty mohou být složené. Protože jedním ze způsobů, jak lze objekt nahrávat, je po částech, pro nahrávání existují dvě pomocné tabulky: uploads a chunks. Projekty také mají přihlašovací údaje pro přístup a billing.
Schéma dat
Protože jsme vytvářeli B2B službu s placeným přístupem, byla v této schémě potřebná billing.
Službu billing jsme také realizovali na Tarantool.
Dokončení S3 úložiště: kroky k produkci
Již jsme vytvořili funkční model, který lze použít: objekty a metadata byla uchovávána, ale pro přechod do produkce chybělo několik aspektů.
Za prvé, systém limitů přenosu. Pokud spustíme službu bez něj, mohli bychom při špičkové zátěži nepředvídatelně přetížit nějakou část systému. Limit přenosu by měl fungovat takto: jakýkoli S3 požadavek přichází na konkrétní hostitele, tento hostitel je identifikátorem bucketu a bucket patří nějakému klientovi. Musíme určit nějakou funkci pro bucket, která by umožnila vypočítat limit přenosu.
Kromě toho musí být systém limitů přenosu dostatečně výkonný, aby zvládl zatížení, které přichází na S3.
Zde jsme opět použili Tarantool. Limity přenosu jsou klastr 21 instancí, které jsou rozděleny do skupin, rozloženy na třech fyzických uzlech a spojeny do velkého topologického klastru. Konfigurační změny se automaticky šíří: nastavují se limity přenosu, defaulty a konfigurace. Každý bucket je obsluhován přesně jednou instancí. Když na konkrétní bucket dorazí požadavek, vypočítá se instance odpovídající tomuto bucketu. V rámci toho uzlu se počítá aktuální přenosový rate podle algoritmu podobného Token Bucket. Dále systém limitů přenosu, na základě aktuálních ukazatelů zátěže a vlastností nastavených pro konkrétní bucket, říká, zda lze požadavek provést nebo ne. Kontrola limitů se provádí v nejranější fázi vykonání S3 požadavku, chrání všechny ostatní prvky systému před nadměrným zatížením.
Také je při zátěži docela obtížné se obejít bez cache. V S3 se předpokládá opakované přístup k těm samým objektům, tedy jde o horké úložiště. V běžném případě je přístup k jednotkovému souboru obsluhován celým řetězcem: Streamer, FileDB, PairDB, Storage. Ale při opakovaném přístupu k souboru optimalizujeme přístup k tomuto obsahu pomocí lokální cache.
Cache je vícestupňová a je realizována pomocí nginx, lokálních, SSD a RAM disků. Zde jsme nepoužili Tarantool, protože je pohodlnější předávat objekty z file systému, tak můžeme udělat tiering cache. Navíc máme velké objekty s maximální velikostí 32 gigabajtů, a v Tarantool lze cache pouze malé objekty.
Tento první systém, se kterým jsme začali, měl určitou vypočtenou kapacitu, která stačila pro prozkoumání a pochopení produktu a toho, že bude fungovat.
Úpravy bojového systému: failover a škálovatelnost
Systém byl již v provozu, ale při spuštění jsme něco přehlédli — bylo třeba přidat failover a škálovatelnost.
Náš S3 démon získával metadata přes protokol Tarantool. Na místo původní databáze jsme nasadili Tarantool, který fungoval jako proxy-router pro dotazy na metadata. Z pohledu aplikace, která implementovala API, se nic nezměnilo — nadále komunikovala s databází přes protokol Tarantool, ale router měl schopnost aktivního failoveru. To znamenalo, že jsme mohli kontrolovat dostupnost uzlu, vydržet pauzu během přepínání a selhání atd. Aplikaci jsme přitom nemodifikovali.
Více informací o tom, jak jsme implementovali šardování
Další otázka, kterou jsme museli řešit, byla šardování. Systém rostl, zvyšovalo se množství objektů a bylo třeba zajistit možnosti pro další růst.
Vraťme se ke schématu dat: jsou projekty, jsou buckety, kredity a billing. To jsou objekty, které s vysokou pravděpodobností v dohledné době nepřekročí hranice jednoho instance ani co do objemu, ani co do dotazů. To znamená, že nemá smysl je shardovat, a proto jsme je dali do samostatného instance, který zůstane nešardovaný. To umožňuje konzistentnější správu projektů a bucketů, protože existuje jedna nešardovaná jednotka.
Ve schématu jsou také objekty, které rostou lineárně — zpočátku jich bylo stovky tisíc, nyní se jejich počet měří v několika miliardách. Takové objekty a jejich části bylo třeba přenést do shardovaného clustera.
Schéma jsme rozdělili, ale objekty musí pracovat s buckety: objekt vždy patří konkrétnímu bucketu, navíc na bucketu funguje ACL. Proto pro každý shard s objekty uchováváme stínovou kopii každého bucketu. Kromě toho, během modifikace objektů a provádění dotazů, je třeba počítat objem pro účely billing, proto na každém shardu existují počítadla pro billing.
Také jsme přidali několik dalších tabulek a komponent:
- koš pro eliminaci starých projektů, které jsou mazány nebo zmraženy;
- fronta pro pozadí úloh, což znamená, že hlavní úložiště může vykonávat pozadí úkoly, které je třeba provést v clusteru;
- podpora lifecycle — mechanizmus, který umožňuje pracovat s objekty a spravovat jejich životní cyklus.
Jelikož jsme část dat přesunuli na shardy, bylo potřeba sharding proxy. Mohli jsme znovu využít router pro tuto roli, ale samostatná sharding proxy, která se zabývá pouze shardováním dat, umožňuje routeru získávat data v celku, aniž by se staral o sharding.
Samostatně vysvětlím, proč jsme nevzali hotové řešení, ale chtěli jsme vytvořit vlastní funkci shardingu.
Podívejme se, jak je to uspořádáno. Máme 256 dostupných shardů. Pro každý bucket vymezujeme rozsah pomocí určité konzistentní funkce. Je to jednoduché — stejně jako určujete pomocí konzistentní funkce příslušnost k jednomu shardu, určujete výchozí shard a vymezujete rozsah:
f(bucket, shards) = subset
To znamená, že pokud vezmete bucket, můžete říci, že on a jeho data budou vždy ležet v konkrétním podmnožství všech shardů. To snižuje vliv některých bucketů na jiné a zjednodušuje práci dotazů map-reduce, kdy je třeba například provést výpis objektů bucketu. K tomu je třeba dotazovat všechny shardy, kde jsou tyto objekty uloženy. Kdyby objekty byly na všech shardech, jakýkoli výpis by zasáhl celý systém, ale tady zasáhne pouze konkrétní podmnožství.
Dále — každý objekt patří konkrétnímu bucketu, takže když se obracíme na objekt, obracíme se na něj podle jména v konkrétním bucketu. To znamená, že můžeme definovat funkci pro objekt, nikoli z celého dostupného rozsahu shardů, ale pouze z podmnožství jeho bucketu:
f(object, subset) = shard
Vezmeme konkrétní objekt, jako argumenty funkce předáváme ne všechny shardy, ale podmnožinu jeho bucketu — a dostáváme konkrétní shard.
Takže, sharding je realizován, máme sharding proxy. Dále zbývá, aby router a databáze s metadaty chodily do sharding proxy. Například pro vytváření objektů stínových kopií — když vytváříme bucket, hlavní úložiště musí vytvořit zástupce tohoto bucketu na všech shartech, kde by měl být přítomen.
Jak jsme implementovali resharding
Největším problémem shardování je reshardování. Bylo pro nás důležité provést to bez výpadku, protože systém byl již v provozu. Ukážu, jak jsme tento problém vyřešili na příkladu podobného úkolu s živou migrací dat z jednoho projektu do druhého.
Níže je schéma našeho klastru, které vzniklo po zavedení shardování. Máme tu nginx, S3 API, router, primární databázi s projekty, shardující proxy a samotné shardy.
V předchozím textu jsem opomněl zmínit, že v určité fázi projektu byla produktová úloha: "Spustit další úložiště, Icebox, — jako Hotbox, jen pro studená data." V podstatě to bylo stejné úložiště, ale na jiných URL a bez cache.
Icebox byl využíván méně než Hotbox, proto se dlouho obešel bez jakéhokoli shardování. Nakonec jsme se rozhodli ho zrušit a sloučit Hotbox a Icebox do jedné služby, jednoduše rozdělením tříd úložiště.
Bucket v úložištích se nepřekrývaly, bylo je snadné sloučit a přesunout, ale klienti používali obě úložiště, což znamenalo, že bylo třeba vyřešit problém s nedostatkem výpadku. Nebylo možné jednoduše vypnout a zkopírovat. Migraci jsme realizovali ve více krocích.
Nejprve jsme synchronizovali primární úložiště. Měli jsme Tarantool a při vytváření objektu jsme mohli udělat následující:
- do databáze přichází požadavek na vytvoření bucketu, například v Hotbox;
- Tarantool kontroluje v jiné databázi (v tomto případě v Icebox), že takový bucket neexistuje;
- pokud bucket existuje, databáze říká, že ho není možné vytvořit, a on byl synchronizován jako existující.

Synchronizace bucketů
V tom úložišti, které mělo přijímat všechna data, jsme pro projekty a buckety zaviedli znak, který říká, kde se tento objekt nachází. Mohl být uložen lokálně, tedy v Hotbox, v Icebox — pak v novém úložišti není žádný z jeho dat, nebo mohl být ve stavu migrace.
Pokud měl projekt nebo bucket znak Migrating, pak během migrace se požadavek nejprve vykonával v novém úložišti, kde měly být data, a pokud tam nebyla, byly požadavky chybovány na alternativní úložiště.
Dále jsme přepnuli provoz. Protože API může obsluhovat jak požadavky Icebox, tak požadavky Hotbox, dokázali jsme přepnout provoz bez výpadku jednoduše přesunem hostitelů a přidáním odpovídajících záznamů do Nginxu.
Po přesměrování provozu jsme mohli odstranit Nginx a API od Icebox.
Pak jsme odstranili Icebox Nginx a S3 API — a vše začalo fungovat:
Dále jsme spustili proces migrace na pozadí, který pracuje uvnitř databáze — prochází jednotlivé projekty a jejich bucket a nastavuje pro ně označení Migrating, přenáší data a po dokončení převedení nastavuje označení Local.
Po přenesení dat již nepotřebujeme staré úložiště, takže odstraníme zbývající části starého systému a také vyjmeme podporu statusu migrace z kódu.
Podobně bylo realizováno také resharding ze starého úložiště do shardovaného:
- Ozmarkedli jsme všechny buckety jako
Non-sharded. Všechny žádosti k nim směřovaly do původního, nešardovaného úložiště. - Nové buckety byly okamžitě vytvářeny v statusu
Sharded. - Po jednom jsme brali buckety, nastavovali status
Migratinga přenášeli data.
Žádosti byly obsluhovány podle principu:
- Čteme nejprve v novém, pak ve starém.
- Vytváříme pouze v novém.
- Aktualizujeme dvoufázově: pokud v novém není, přeneseme ze starého do nového, pak aktualizujeme.
Práce s SSL certifikáty
Na front-endu používáme Nginx. V našem případě to není běžný Nginx, ale OpenResty, Nginx s podporou LuaJIT.
Další část systému — práce s SSL certifikáty. V S3 úložišti můžete nastavit vlastní doménu pro přístup k určitému bucketu, jednoduše pomocí CNAME. Ale bez HTTPS to dnes už nejde: vlastní doména předpokládá vlastní SSL certifikát.
Jak jsem už řekl, za vyvažování a terminaci SSL odpovídá Nginx. V našem případě to není běžný Nginx, ale OpenResty, Nginx s podporou LuaJIT.
To nám umožnilo relativně snadno naučit náš Nginx předávat libovolné certifikáty. Bylo třeba certifikáty vydávat dynamicky (bez nutnosti je zapisovat do konfiguračního souboru). Využili jsme rozšíření ssl_certificate_by_lua, které umožňuje přečíst certifikát z libovolného zdroje přímo během TLS handshake. Jako úložiště certifikátů jsme rovněž použili Tarantool: to umožňuje spravovat certifikáty zvnějšku a zajišťuje velmi rychlé dodání.
Byl také realizován samostatný démon, jehož úkolem je pravidelně aktualizovat certifikáty, které byly vydány pomocí Let’s Encrypt.
Co bych zachoval a co udělal jinak, kdybych vyvíjel úložiště od začátku
Co bylo třeba použít hned na začátku
Šardování hned. Příliš mnoho problémů způsobilo reshardování. Je to snadné udělat, ale pokud začínáte projekty, které je třeba škálovat, je lepší hned vzít shardovaný cluster, i kdyby na minimálním počtu uzlů. Realizace šardování na začátku je téměř zdarma ve srovnání s zaváděním šardování do funkčního systému.
Práce s Tarantool přes vyrovnávače zátěže. Nyní všechny nové databáze okamžitě připojujeme do práce přes vyrovnávače zátěže. To umožňuje rozšiřovat funkcionalitu a dosahovat vyšší odolnosti proti výpadkům.
Automatické přepínání. Nainstaloval bych všechny nástroje potřebné pro automatické přepínání, protože první neúspěchy po spuštění byly spojené s jeho absencí. Po zkušenostech s S3 byly všechny následující produkty spuštěny s ohledem na to.
Funkce S3 "Verzování". Původně se zdálo, že to není příliš žádaná funkčnost. Integrovat tuto možnost do architektury fungujícího systému je velmi obtížné.
Samostatné fakturace. Způsob, jakým jsme integrovali fakturaci do našeho systému, se na začátku osvědčil, ale později se stal překážkou, bylo by lepší mít ji jako naprosto samostatnou službu.
Co bylo úspěšným rozhodnutím
Model dat. Historie ukázala, že v rámci rozvoje služby se docela přesně shodujeme s modelem dat Amazonu, takže můžeme implementovat ty funkce, které tam jsou.
Schéma šardování. Podporoval bych stejné rozsahové šardování podle bucketů, protože to umožňuje dobře rozdělovat dotazy z různých bucketů po velkém clusteru.
Použití Tarantool. Tarantool velmi pomohl při rozvoji služby a její modifikaci, snadno jsme pracovali s daty, transformovali a šardovali úložiště, aniž bychom potřebovali přecházet na vrstvu aplikace.
Tento referát byl poprvé představen na by Mail.ru Cloud Solutions&Tarantool. Podívejte se na další vystoupení a přihlaste se k oznámením akcí na Telegramu .
Také můžete vidět moji starou přednášku o S3 nebo si přečíst článek mého kolegy o blokovém úložišti.
- .
- .
Zdroj: habr.com
